
Les agents IA, MCP et le paysage moderne des frameworks
Écouter l'article (expérimental) · 20:16
Comment fonctionnent les agents IA
Un agent IA est un système piloté par un LLM qui fonctionne en boucle :
- Planifier : décomposer un objectif en sous-tâches.
- Agir : sélectionner et invoquer un ou plusieurs outils.
- Observer : lire les résultats des outils et mettre à jour l'état interne.
- Itérer : répéter jusqu'à ce que l'objectif soit atteint ou qu'une condition d'arrêt soit remplie.
L'exemple le plus fondamental de cette boucle est ReAct (Reasoning + Acting). Présenté par Yao et al. en 2022, ReAct entrelace des traces de raisonnement en chaîne de pensée avec des étapes d'action. L'agent réfléchit à voix haute à ce qu'il doit faire, appelle un outil, observe le résultat, et raisonne à nouveau. C'est, en somme, le « Hello World » des architectures d'agents : presque tous les frameworks modernes (LangChain, Semantic Kernel, ADK, Agents SDK) embarquent une boucle de type ReAct comme mode d'agent par défaut. Comprendre ReAct est le prérequis pour comprendre tout le reste de cet article.
En option, les agents intègrent une mémoire (contexte à court et long terme) et des points de contrôle avec intervention humaine (human-in-the-loop) pour les décisions critiques pour la sécurité.
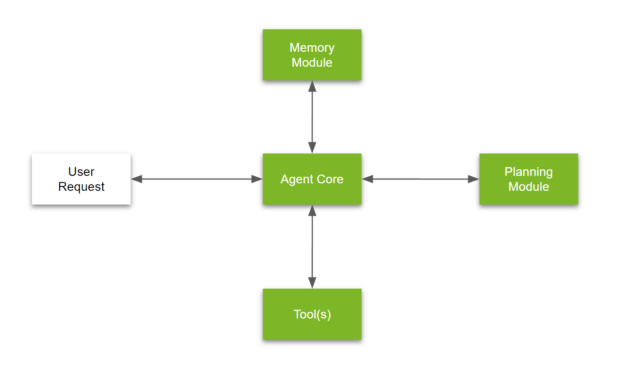
La décomposition canonique de NVIDIA reste un modèle mental utile :
| Composant | Rôle |
|---|---|
| Cœur de l'agent | Moteur de raisonnement LLM qui pilote la boucle |
| Module de mémoire | Persiste le contexte entre les tours et les sessions |
| Outils | Capacités externes que l'agent peut invoquer |
| Module de planification | Choix de stratégie, décomposition des tâches, replanification |
Agents vs. workflows (la distinction d'Anthropic)
| Dimension | Workflows | Agents |
|---|---|---|
| Flux de contrôle | DAG codé en dur | Décidé par le LLM à l'exécution |
| Prévisibilité | Élevée | Plus faible, avec une variance plus forte |
| Auditabilité | Simple | Nécessite du traçage |
| Quand l'utiliser | Processus connus et répétables | Tâches ouvertes ou exploratoires |
Les deux appartiennent à la même famille des systèmes agentiques. Les systèmes en production combinent fréquemment des étapes de workflow déterministes avec des sous-tâches pilotées par des agents là où de la flexibilité est nécessaire.
Les outils sont des contrats sémantiques
Les outils sont des contrats sémantiques. Un agent lit le nom, la description et le schéma d'un outil pour décider s'il doit l'appeler et comment. Si l'un de ces signaux est vague, l'agent peut :
- Appeler le mauvais outil.
- Transmettre des entrées mal formées.
- Mal interpréter les sorties et halluciner par la suite.
La recherche d'Anthropic sur l'écriture d'outils pour les agents montre que traiter les outils comme des produits destinés aux développeurs améliore de façon mesurable les taux de réussite et réduit le gaspillage de tokens :
| Principe | Ce que cela signifie en pratique |
|---|---|
| Schémas stricts | Entrées/sorties typées, avec une distinction claire entre champs requis et facultatifs |
| Troncature utile | Les charges utiles volumineuses sont résumées ; les appelants peuvent demander le détail à la demande |
| Indications d'erreur claires | Les messages d'erreur indiquent à l'agent ce qu'il doit faire ensuite, pas seulement ce qui a échoué |
| Espaces de noms | Des noms d'outils rattachés à un domaine (par ex. legal.searchCases) pour éviter les collisions |
| Pagination | Des jeux de résultats bornés avec curseurs, qui évitent les débordements de la fenêtre de contexte |
| Évaluations | Des suites de tests automatisées qui mesurent le taux de réussite de l'agent par outil |
Patrons : du workflow à l'autonomie complète
Ces patrons se situent sur un spectre allant du totalement déterministe au totalement autonome. Choisissez selon le niveau de contrôle et de variance que votre cas d'usage exige :
| Patron | Description | Niveau de contrôle |
|---|---|---|
| Chaînage de prompts | Séquence d'appels LLM ; la sortie de chaque étape alimente la suivante. Contrôles qualité optionnels entre les étapes. | Élevé |
| Routage | Un classifieur dirige l'entrée vers des prompts ou des ensembles d'outils spécialisés. | Élevé |
| Parallélisation | Plusieurs appels LLM s'exécutent simultanément, soit par sectionnement (tâche découpée), soit par vote (même tâche, consensus). | Moyen |
| Orchestrateur et travailleurs | Un agent gestionnaire décompose dynamiquement une tâche, la délègue à des agents travailleurs, et synthétise les résultats. | Moyen à faible |
| Évaluateur et optimiseur | Un agent génère ; un autre critique ; la boucle affine jusqu'à ce que les critères de qualité soient remplis. | Faible |
Règle empirique (Anthropic) : Commencez par le patron le plus simple qui résout le problème. Ne passez à des boucles d'agent complètes que lorsque la tâche exige réellement une prise de décision dynamique.
Exemple concret : GitHub Copilot dans VS Code
L'agent de codage de GitHub Copilot dans VS Code illustre bien la façon dont ces patrons se combinent dans un produit livré :
- Routage. Quand vous tapez un message, Copilot classe l'intention : s'agit-il d'une complétion en ligne, d'une question dans le chat, ou d'une modification multi-fichiers ? Chacune est routée vers un pipeline différent.
- Orchestrateur et travailleurs. En mode agent, Copilot reçoit une tâche de haut niveau (par ex. « ajouter une validation des entrées au formulaire d'inscription »), la décompose en sous-tâches, et délègue chacune à des appels d'outils spécialisés : lire des fichiers, rechercher des symboles avec grep, exécuter des commandes dans le terminal, appliquer des modifications, lancer des tests.
- Évaluateur et optimiseur. Après avoir apporté des modifications, l'agent lance des linters, des tests ou des vérificateurs de types. Si quelque chose échoue, il lit la sortie d'erreur, raisonne sur la correction, et itère dans une boucle générer, évaluer, affiner.
- Chaînage de prompts avec contrôles. La sortie de chaque étape conditionne la suivante. Si la lecture d'un fichier renvoie un contenu inattendu, l'agent replanifie plutôt que de poursuivre à l'aveugle.
Sous le capot, il s'agit d'une boucle ReAct adossée à une intégration d'outils de type MCP : Copilot découvre les outils disponibles (système de fichiers, terminal, recherche, API de l'éditeur), les appelle via des schémas structurés, observe les résultats, et raisonne sur les étapes suivantes. C'est un exemple concret de système en production qui mêle workflows déterministes et flexibilité pilotée par agent.
Copilot vous laisse aussi modifier deux leviers clés qui influent directement sur le comportement :
Modèle. Passer, disons, de GPT-4o à Claude Sonnet ou Gemini change le moteur de raisonnement. Les modèles ont des forces différentes : certains sont meilleurs pour planifier des modifications en plusieurs étapes, d'autres pour suivre les instructions avec précision, d'autres encore pour minimiser les hallucinations. Les mêmes outils et le même prompt peuvent produire des résultats sensiblement différents selon le modèle, et c'est pourquoi les évaluations (la phase 4 du plan de mise en œuvre ci-dessous) comptent.
Mode. Copilot propose trois modes intégrés, situés à différents points du spectre d'autonomie :
- Ask : un pipeline question-réponse (chaînage de prompts). Pas de modification de fichiers, pas d'appels d'outils, juste du raisonnement sur le contexte que vous fournissez.
- Agent : la boucle complète orchestrateur-travailleurs. Il peut lire votre base de code, exécuter des commandes dans le terminal, installer des dépendances, créer des fichiers, et itérer de façon autonome sur les échecs. C'est la boucle ReAct en action.
- Plan : un entre-deux. L'agent raisonne sur la tâche et produit un plan étape par étape, mais attend votre validation avant d'exécuter la moindre modification. C'est essentiellement le patron du « point de contrôle avec intervention humaine » décrit plus haut.
Passer de Ask à Plan puis à Agent augmente la flexibilité, mais accroît aussi la variance, le coût, et l'importance de bons schémas d'outils. Vous pouvez également définir des agents personnalisés avec des instructions et des ensembles d'outils sur mesure, créant de fait une couche de routage spécialisée pour vos propres workflows.
Sessions. Copilot permet d'exécuter plusieurs sessions d'agent en parallèle, chacune avec son propre modèle, mode et contexte. Cela transforme le modèle mono-agent en un patron de parallélisation concret : vous pouvez avoir une session qui écrit des tests unitaires pour un composant, une autre qui implémente une nouvelle fonctionnalité, une autre qui génère de la documentation, le tout s'exécutant simultanément sur la même base de code. Cela fonctionne particulièrement bien dans les architectures aux frontières de modules nettes. Dans un projet Django, par exemple, chaque app (authentification, facturation, notifications) est largement indépendante, avec ses propres modèles, vues, URLs et tests. Vous pouvez sans risque lancer des sessions parallèles cantonnées à différentes apps, avec un risque minime de conflits de fusion, car les surfaces de fichiers se chevauchent à peine. Le même principe s'applique à toute base de code aux frontières de packages ou de services bien définies (microservices, packages de monorepo, modules Go, etc.). En pratique, les sessions parallèles vous permettent d'échanger du temps réel contre du débit, en compressant en travail concurrent ce qui serait du travail séquentiel, tant que les tâches sont suffisamment isolées.
L'écosystème des frameworks
L'écosystème se divise en trois couches. Les frameworks d'agents sont là où vous construisez des agents. MCP est le protocole qui les relie aux outils externes. Les couches de gouvernance gèrent des flottes d'agents à l'échelle de l'entreprise. Elles sont complémentaires, et non interchangeables.
Frameworks d'agents
Microsoft Agent Framework
- Actuellement en public preview (GitHub).
- Unifie Semantic Kernel (SK) et AutoGen sous un même modèle de programmation.
- Ajoute des workflows typés et orientés graphe, avec une forte observabilité (OpenTelemetry intégré).
- Intégration native des protocoles MCP et A2A.
- Prise en charge multi-fournisseurs : Azure OpenAI, OpenAI, Anthropic, Ollama, et plus.
- Livré avec une interface développeur (DevUI) pour inspecter les traces des agents.
OpenAI
La pile d'agents d'OpenAI est répartie sur plusieurs produits :
| Produit | Ce que c'est | Lancé |
|---|---|---|
| Responses API | Primitive d'API combinant la simplicité de Chat Completions avec un usage d'outils intégré (recherche web, recherche de fichiers, interpréteur de code, computer use, génération d'images). | Mars 2025 |
| Agents SDK | Bibliothèque Python/Node open-source pour orchestrer des workflows mono- et multi-agents (passations, garde-fous, traçage). Successeur de Swarm. | Mars 2025 |
| AgentKit | Boîte à outils de plus haut niveau réunissant Agent Builder (canevas visuel de workflows), ChatKit (interface de chat intégrable), et Connector Registry (gestion centralisée des sources de données). | Octobre 2025 |
La page Agent Platform est l'ombrelle marketing d'OpenAI pour tout ce qui précède.
Google Agent Development Kit (ADK)
- Framework open-source et modulaire, optimisé pour Gemini mais agnostique au modèle.
- Prend en charge les topologies mono-agent et multi-agents.
- Cibles de déploiement :
- Vertex AI Agent Engine : entièrement managé, auto-scalable.
- Cloud Run : conteneurisé, infrastructure que vous apportez.
- GKE : déploiement basé sur Kubernetes.
Protocole d'interopérabilité
MCP (Model Context Protocol)
- Standard ouvert créé à l'origine par Anthropic, désormais gouverné par The Linux Foundation et ouvert aux contributions de la communauté (protocole et SDKs, registre de serveurs).
- Les clients (Claude, ChatGPT, VS Code, IDE JetBrains, Cursor, etc.) se connectent à des serveurs MCP qui exposent des schémas d'outils.
- Devient rapidement la couche d'interopérabilité de facto des systèmes agentiques.
- Registre croissant de serveurs communautaires et éditeurs (GitHub, Azure DevOps, Notion, Playwright, Slack, bases de données, etc.).
- Valeur clé : écrivez vos outils une seule fois, exposez-les à n'importe quel client compatible MCP, sans aucun travail d'intégration par client.
- Les trois frameworks ci-dessus prennent en charge MCP nativement ou via des plugins.
Couches de gouvernance
MuleSoft Agent Fabric (Salesforce)
- Couche de gouvernance d'entreprise pour les flottes d'agents :
- Registre : catalogue des agents et outils disponibles.
- Courtier : achemine les requêtes vers le bon agent.
- Politiques : contrôle d'accès, limitation de débit, prévention des pertes de données.
- Observabilité : journalisation et traçage centralisés.
- Prend en charge MCP comme standard de connectivité.
- Conçu pour les organisations qui exploitent des dizaines à des centaines d'agents à l'échelle.
Équipes multi-agents
Un patron en plein essor est celui des équipes d'agents conteneurisées : des groupes d'agents spécialisés par domaine qui collaborent sous une même enveloppe de gouvernance :
- AgentCatalog sur Docker Hub en est un exemple précoce : des images d'agents prêtes à l'emploi pour des tâches courantes.
- Les équipes peuvent être composées dynamiquement (par ex. une équipe de « revue de contrats » avec un agent d'extraction de clauses, un agent de scoring de risque, et un agent de synthèse).
- L'orchestration de conteneurs (Kubernetes, Docker Compose) permet le passage à l'échelle, le versionnement et le rollback au niveau de l'agent.
- Les politiques internes de gouvernance et d'accès peuvent être appliquées par conteneur.
Architectures de référence
| # | Architecture | Composants clés |
|---|---|---|
| 1 | Azure d'abord, axée workflow | Orchestrateur Microsoft Agent Framework vers serveur MCP sur Azure Container Apps vers services Azure AI |
| 2 | OpenAI d'abord, axée builder | AgentKit / Agent Builder vers Agents SDK vers serveur MCP (n'importe quel hôte) |
| 3 | GCP d'abord, centrée ADK | Agent ADK sur Vertex AI Agent Engine vers serveur MCP sur Cloud Run |
| 4 | Flotte gouvernée | Courtier MuleSoft Agent Fabric vers plusieurs serveurs MCP vers couche d'application des politiques |
Les quatre convergent vers MCP comme standard de connectivité des outils. Le choix est dicté par l'empreinte cloud existante, les relations avec les éditeurs, et les exigences de gouvernance.
De zéro à la production : un plan de mise en œuvre
Chaque phase a un livrable clair et des critères de sortie, pour que vous sachiez quand passer à la suite (ou faire un retour en arrière).
Phase 1 : Définir la surface de vos outils
Objectif : Décider ce qu'il faut exposer avant d'écrire la moindre ligne de code.
- Auditez les API et workflows existants de votre système. Identifiez 3 à 5 opérations à forte valeur que des agents appelleraient de façon réaliste, par ex. rechercher des documents, extraire des entités, vérifier le statut d'un dossier, générer une synthèse.
- Pour chaque opération, répondez :
- Quelles sont les entrées requises vs. facultatives ? (Typez-les strictement.)
- À quoi ressemble la sortie du cas nominal ? Et la sortie d'erreur ?
- L'opération est-elle en lecture seule ou a-t-elle des effets de bord ?
- Écrivez les schémas d'outils (JSON Schema ou équivalent) avec :
- Une
descriptionclaire et lisible par l'agent. C'est ce que le LLM voit pour décider d'appeler l'outil. - Un paramètre
mode("concise"|"detailed") pour contrôler le niveau de détail de la sortie. - Une pagination par curseur (
cursor+limit) pour les endpoints de liste. - Un drapeau
truncated: truedans les réponses, pour que l'agent sache qu'il faut en récupérer davantage. - Des erreurs pédagogiques : des messages d'erreur qui disent à l'agent comment corriger l'appel, pas seulement qu'il a échoué.
- Une
Livrable : Un document de schémas (définitions OpenAPI ou d'outils MCP) relu par au moins une personne qui ne l'a pas écrit.
Critère de sortie : Un collègue peut lire les schémas à froid et prédire correctement ce que fait chaque outil, quelles entrées il requiert, et à quoi ressemble la sortie.
Phase 2 : Construire le serveur MCP
Objectif : Transformer les schémas en un serveur en fonctionnement auquel tout client MCP peut se connecter.
- Implémentez chaque outil derrière un serveur conforme à MCP (SDK TypeScript ou Python).
- Choisissez votre transport selon le cas d'usage :
| Transport | Quand l'utiliser |
|---|---|
| stdio | Développement local, intégrations IDE (VS Code, Cursor) |
| Streamable HTTP | Déploiement distant / hébergé dans le cloud, scénarios multi-tenants |
- Intégrez la sécurité dès le premier jour :
- Les outils à effets de bord doivent prendre en charge un mode
dry_run(renvoie ce qui se passerait) et un modecommit(exécute l'action). - Les opérations destructrices exigent une étape de confirmation humaine avant que
commitne se poursuive.
- Les outils à effets de bord doivent prendre en charge un mode
- Validez l'interopérabilité avec au moins deux clients MCP (par ex. Claude Desktop + VS Code Copilot). Si tous deux peuvent découvrir et appeler correctement chaque outil, le serveur est prêt.
Livrable : Un serveur MCP déployé (ou exécutable localement) avec des tests d'intégration réussis face à deux clients.
Critère de sortie : Les deux clients peuvent accomplir de bout en bout une tâche réaliste en plusieurs étapes en n'utilisant que les outils exposés.
Phase 3 : Brancher un framework d'agents
Objectif : Prouver que le serveur MCP fonctionne avec un vrai agent. Choisissez un seul framework pour commencer.
Choisissez le framework qui correspond à la pile de votre équipe :
| Si votre pile est… | Commencez par… |
|---|---|
| Azure / .NET | Microsoft Agent Framework |
| Axée OpenAI / Python | Agents SDK + Agent Builder |
| GCP / Gemini | Google ADK sur Vertex AI Agent Engine |
Construisez deux choses :
- Un workflow déterministe : une séquence fixe d'appels d'outils (par ex. « rechercher, extraire, résumer »). Cela valide que les outils se composent correctement.
- Un agent libre : les mêmes outils, mais c'est le LLM qui décide du plan à l'exécution. Cela met vos schémas à l'épreuve : si l'agent choisit le mauvais outil ou transmet de mauvaises entrées, vos descriptions ou vos messages d'erreur ont besoin d'être retravaillés.
En option, répétez avec un second framework pour confirmer que le serveur MCP est réellement agnostique au framework.
Livrable : Un agent fonctionnel (workflow + libre) qui accomplit de vraies tâches en utilisant le serveur MCP.
Critère de sortie : L'agent accomplit ≥ 80 % des tâches de test sans intervention humaine.
Phase 4 : Évaluer et itérer
Objectif : Mesurer la qualité avec laquelle les agents utilisent vos outils, et corriger ce qui est cassé.
- Créez 10 à 20 tâches réalistes avec des sorties de référence attendues (par ex. « Trouver tous les contrats expirant au T2 et résumer les obligations clés »).
- Faites passer chaque tâche à la fois par le workflow et par l'agent libre. Pour chaque exécution, mesurez :
| Métrique | Pourquoi c'est important |
|---|---|
| Taux de réussite | L'agent est-il arrivé à la bonne réponse ? |
| Nombre d'appels d'outils | Des appels en excès signalent un schéma déroutant |
| Consommation de tokens | Indicateur indirect du coût |
| Latence | De bout en bout et par outil |
| Taux d'erreur par catégorie | Révèle des problèmes systématiques de conception d'outils |
- Triez les échecs :
- Mauvais outil sélectionné : améliorez la
descriptionde l'outil. - Mauvais paramètres : resserrez le schéma, ajoutez des contraintes
enum, améliorez les indications d'erreur. - Appel correct, mauvaise interprétation du résultat : simplifiez le format de sortie ou ajoutez un champ
summary.
- Mauvais outil sélectionné : améliorez la
- Relancez la suite d'évaluation après chaque correction. Suivez l'amélioration au fil des itérations.
Livrable : Une suite d'évaluation (automatisée, ré-exécutable) et un journal des modifications de schémas avec les taux de réussite avant/après.
Critère de sortie : ≥ 90 % de taux de réussite sur la suite d'évaluation avec les deux modes d'agent.
Phase 5 : Durcir et passer à l'échelle
Objectif : Se préparer au trafic de production et au déploiement à l'échelle de l'organisation.
- Observabilité. Instrumentez le serveur MCP avec du traçage distribué (OpenTelemetry) et de la journalisation structurée. Chaque appel d'outil devrait être traçable, de la requête du client jusqu'au système back-end.
- Limitation de débit et contrôle d'accès. Décidez qui (quels agents, quels utilisateurs) peut appeler quels outils, et à quel débit.
- Gouvernance à l'échelle. Si vous prévoyez plusieurs serveurs MCP ou équipes d'agents, adoptez une couche de courtier/fabric (par ex. MuleSoft Agent Fabric) pour :
- L'application centralisée des politiques.
- La journalisation d'audit (qui a appelé quoi, quand, avec quelles entrées).
- La supervision au niveau de la flotte et les coupe-circuits.
- Documentation. Publiez un catalogue d'outils (descriptions lisibles par un humain, exemples d'appels, limitations connues) pour que d'autres équipes puissent construire des agents face à votre serveur MCP sans avoir à le rétro-concevoir.
Livrable : Un serveur MCP prêt pour la production, avec des tableaux de bord de supervision, des politiques d'accès, et un catalogue d'outils publié.
Critère de sortie : Une équipe qui n'a pas participé à la construction du serveur peut mettre en place un nouvel agent face à lui en n'utilisant que le catalogue et les schémas publics.
Les questions auxquelles cet article répond
Quelle est la différence entre un agent IA et un workflow ?
Le flux de contrôle. Un workflow exécute un DAG codé en dur, donc prévisible et simple à auditer, tandis qu'un agent laisse le LLM décider du chemin à l'exécution, ce qui apporte de la flexibilité au prix d'une variance plus forte et d'un besoin de traçage. Les deux appartiennent à la même famille des systèmes agentiques, et les systèmes en production les mélangent le plus souvent, en gardant les étapes déterministes là où le processus est connu et en confiant aux agents les sous-tâches ouvertes. La règle empirique d'Anthropic tient toujours : commencez par le patron le plus simple qui résout le problème et ne montez en puissance que lorsque la tâche exige réellement une prise de décision dynamique.
Pourquoi mon agent appelle-t-il toujours le mauvais outil ?
C'est en général la description qui est en cause, pas le modèle. L'agent ne lit que le nom, la description et le schéma d'un outil pour décider s'il l'appelle et comment, si bien que des signaux vagues donnent le mauvais outil, des entrées mal formées, ou des sorties mal lues qui deviennent des hallucinations par la suite. Le tri est direct : mauvais outil sélectionné veut dire améliorer la description ; mauvais paramètres veulent dire resserrer le schéma, ajouter des contraintes enum et écrire des messages d'erreur qui disent comment corriger l'appel ; un appel correct mal interprété veut dire simplifier le format de sortie ou ajouter un champ summary.
MCP n'est-il pas juste une couche de plus par-dessus les API que j'ai déjà ?
C'est une couche avec un gain précis : vous écrivez l'outil une seule fois et n'importe quel client compatible MCP peut l'utiliser, sans aucun travail d'intégration par client. Les clients comprennent déjà Claude, ChatGPT, VS Code, les IDE JetBrains et Cursor, et Microsoft Agent Framework, la pile OpenAI et Google ADK le prennent en charge nativement ou via des plugins. C'est un standard ouvert créé par Anthropic et désormais gouverné par The Linux Foundation, l'adopter n'est donc pas un pari sur un seul éditeur.
Comment savoir si mon serveur MCP est vraiment prêt pour la production ?
Servez-vous des critères de sortie de chaque phase plutôt que d'une impression. Deux clients MCP différents, par exemple Claude Desktop et VS Code Copilot, doivent chacun accomplir de bout en bout une tâche réaliste en plusieurs étapes en n'utilisant que vos outils ; l'agent libre doit accomplir au moins 80 % des tâches de test sans intervention humaine, et au moins 90 % d'une suite d'évaluation de 10 à 20 tâches réalistes. Le dernier critère n'est pas technique : une équipe qui n'a rien eu à voir avec la construction du serveur doit pouvoir mettre en place un nouvel agent avec le seul catalogue publié et les schémas.
À lire ensuite
 AI Agents
J'ai construit une couche d'IA qui ne répond jamais. Voici ce qu'exige vraiment une bonne question
Notes de terrain sur OrbitSpec, un moteur de clarification qui transforme les demandes vagues en Context Bundles typés et auditables avant qu'aucun modèle ne tourne, et pourquoi la fiabilité commence avant la réponse. AI Agents
J'ai construit le pipeline qui a construit mon produit. Voici ce que déléguer exige vraiment
Notes de terrain sur plan-to-pr, un pipeline qui transforme une demande de fonctionnalité en tickets, en un point de contrôle d'approbation et en pull requests en brouillon, et pourquoi déléguer à des agents de code demande des artefacts, pas du chat.