
J'ai construit une couche d'IA qui ne répond jamais. Voici ce qu'exige vraiment une bonne question
Écouter l'article (expérimental) · 13:35

Tapez « je ne me sens pas bien et je veux savoir quoi faire » dans un service que j'ai construit : il ne vous dira pas quoi faire. Il demande quels sont vos symptômes. Puis il demande quand ils ont commencé. Puis il arrête de poser des questions, parce que ce sont les deux seuls champs que son pack marque comme obligatoires, et il remet à votre application un document JSON typé, versionné et auditable appelé Context Bundle. Temps moteur total sur l'ensemble de la conversation : bien en dessous de la milliseconde. Nombre de réponses données : zéro.
Ce refus de répondre, c'est tout le produit, et il est né de deux idées qui me trottaient dans la tête depuis un moment. La première, je la dois à Marc Brooker, qui soutient qu'une spécification ne se dicte pas avant le travail, mais qu'on y parvient en itérant, et qu'une bonne spec est de plus en plus ce qui permet à une IA de faire le travail tout court (Spec Driven Development isn't Waterfall). Les besoins n'arrivent jamais clarifiés. On les clarifie en posant des questions, autrement dit en menant une conversation. La seconde, je la dois à Rafael Peixoto, qui m'a convaincu il y a un an ou deux que l'avenir de l'IA serait neurosymbolique : des modèles neuronaux souples enveloppés dans une structure symbolique qu'on peut réellement vérifier, à une époque où tout le domaine pariait dans l'autre sens. OrbitSpec, c'est ce que donnent ces deux idées une fois mises en service : une courte conversation qui transforme une demande floue en spec vérifiable, portée par un moteur déterministe qui traite le modèle de langage en invité, jamais en maître des lieux.
C'est aussi le troisième compte rendu de terrain d'une série qui s'est révélée être un seul et même système vu sous trois angles. Smithproof gouverne ce que font les agents. plan-to-pr structure ce qu'on leur délègue. OrbitSpec, chronologiquement la première chose que j'ai construite et la dernière que je raconte, se situe tout au début de la chaîne, là où un humain tape quelque chose de flou et où commence tout coût en aval. Son châssis est parti du template full-stack de tiangolo, crédité comme il se doit ; le moteur posé par-dessus, c'est de lui qu'il est question ici.
Ce que c'est
OrbitSpec, c'est la clarification en tant que service : une API B2B qui se place devant un produit d'IA. L'application du client crée une session, soumet le brouillon de l'utilisateur, et reçoit l'un de deux résultats. Soit needs_clarification, qui porte exactement une question à relayer à l'utilisateur, soit ready, qui porte le Context Bundle destiné au modèle que le client fait tourner en aval, quel qu'il soit.
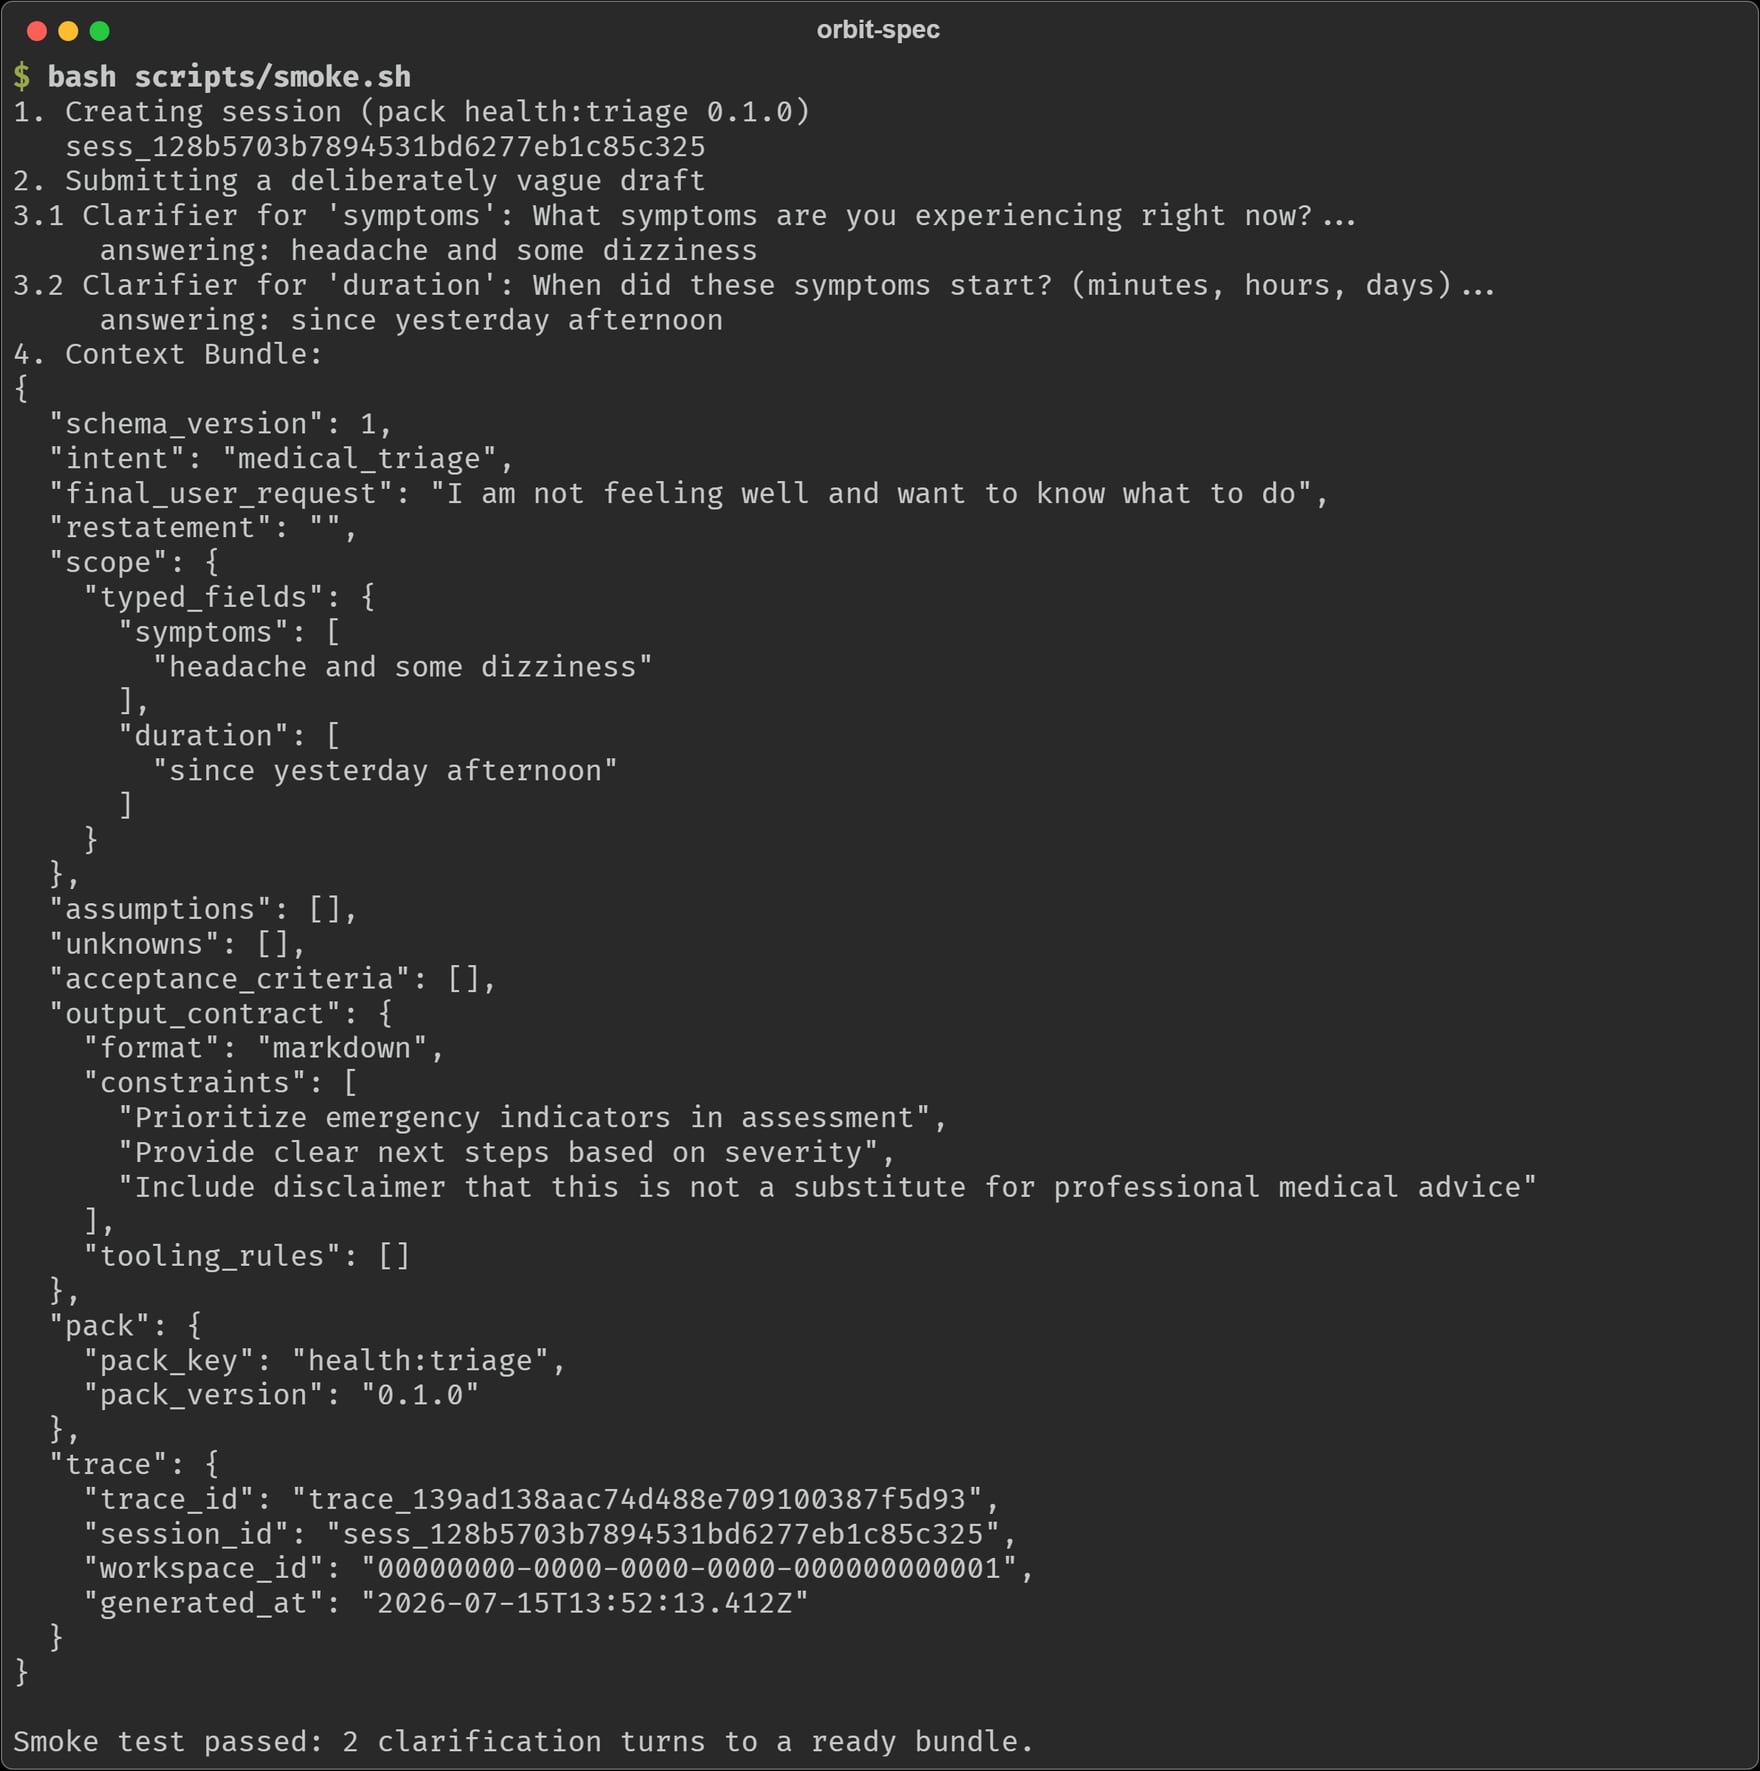 Toute la boucle depuis un terminal : un brouillon vague, deux questions, un bundle. Le moteur a posé deux questions parce que le pack exige deux de ses sept champs, et il n'en pose jamais plus que ce que le pack demande.
Le comportement vit dans les données, pas dans le code. Des Intent Packs YAML versionnés définissent les champs dont un domaine a besoin, lesquels sont obligatoires, quelle question poser pour chacun, et une priorité de clarification. Une session épingle sa version de pack à la création, si bien qu'une mise à jour de pack ne change jamais les règles d'une conversation en plein vol, et la version épinglée dans chaque bundle rend le bundle reproductible : même pack, mêmes réponses, même sortie. Il existe des packs pour le triage médical, l'admission juridique, les sinistres d'assurance, la recherche, et un pack générique de repli.
Trois propriétés font le gros du travail, et toutes trois sont de vieilles vertus du logiciel plutôt que de nouvelles vertus de l'IA. La boucle est déterministe : le moteur qui fusionne le scope, valide les champs et choisit la question suivante est du code ordinaire, avec une précédence documentée. La question est unique : un clarificateur par tour, choisi comme la plus petite question utile, parce que les utilisateurs répondent à une question et abandonnent les questionnaires. Et tout est audité : chaque étape de chaque tour atterrit dans un journal d'événements en append-only, avec sa latence.
Le gain de fiabilité le moins cher se joue avant que le modèle ne tourne
L'industrie travaille dur à faire mieux répondre les modèles. Retrieval, reranking, garde-fous, evals : tout cela opère du côté réponse de la transaction. Mais une large part des mauvaises sorties d'IA ne sont pas de mauvaises réponses à de bonnes questions ; ce sont de bonnes réponses à de mauvaises questions. « J'ai besoin d'aide pour un problème de santé » n'a pas de bonne réponse, et tout ce qu'un modèle en tire est de la devinette coûteuse habillée d'un ton assuré.
L'efficacité déraisonnable du design d'OrbitSpec, c'est que corriger cela ne coûte presque rien. Voici le registre d'audit du moteur lui-même pour la session ci-dessus :
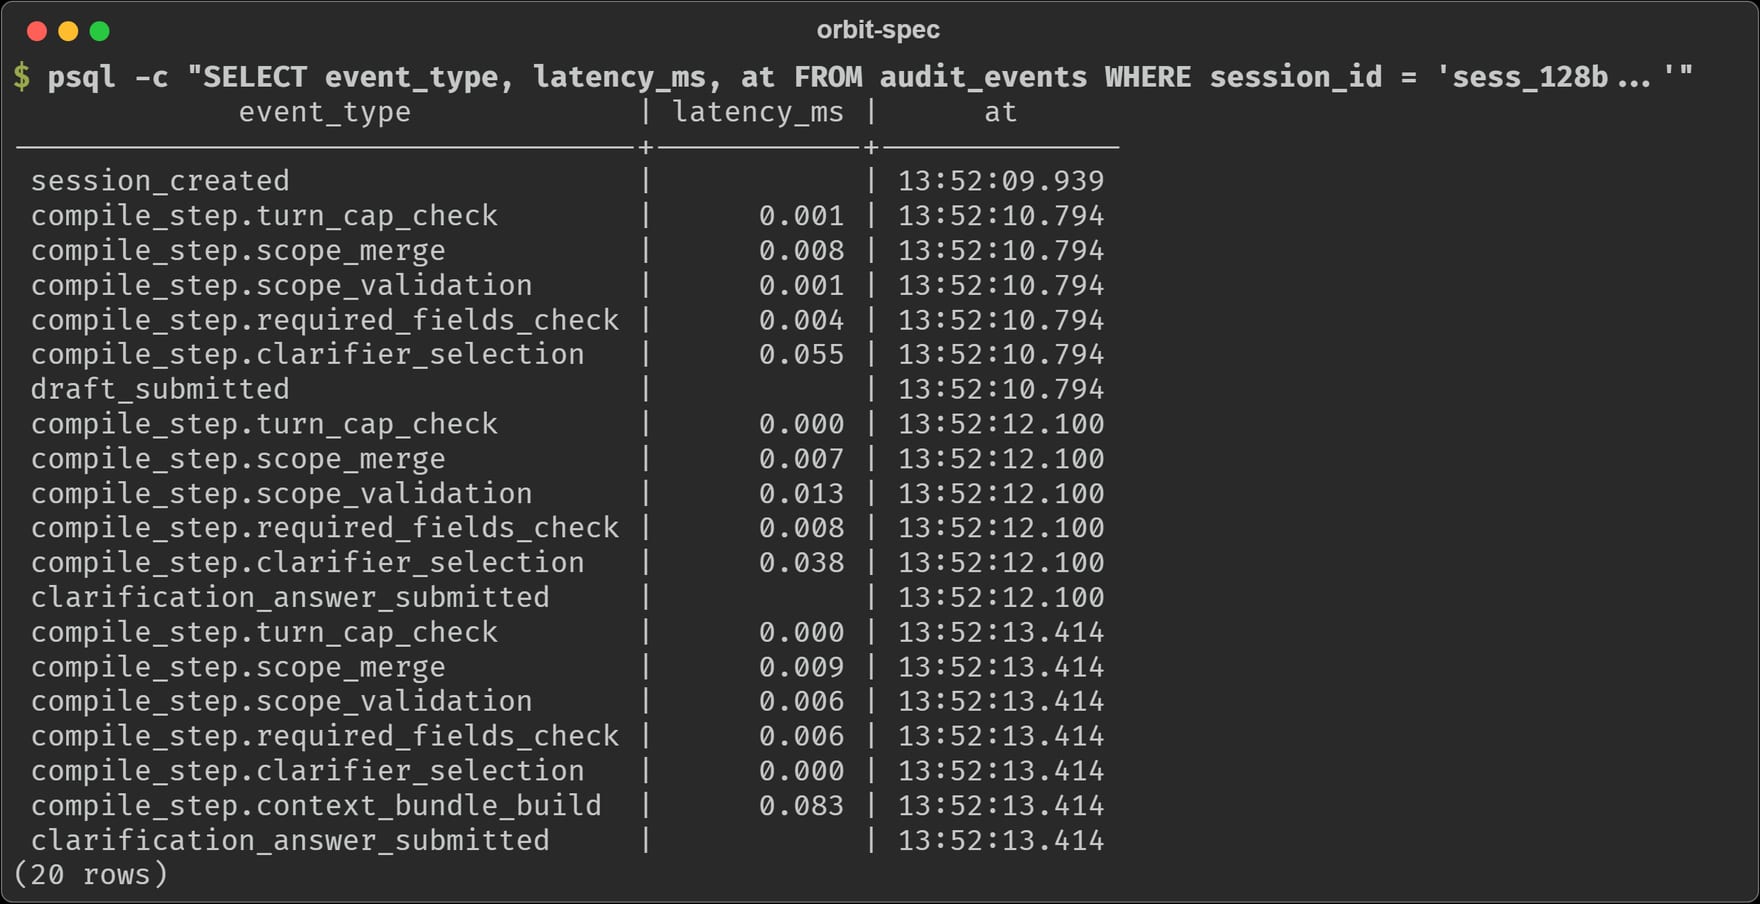 Chaque étape de chaque tour, horodatée avec sa latence. Le moteur entier dépense des microsecondes par tour.
Des microsecondes par tour, et chaque ligne est attribuable : quelle étape a tourné, quand, dans quelle session, sous quel trace id. Quand quelque chose casse en aval, la question qui a produit le bundle n'est pas un souvenir enfoui dans un historique de chat ; c'est un enregistrement interrogeable. Dans le billet sur smithproof, j'écrivais qu'une dépense qu'on peut lire est une dépense qu'un plan de contrôle peut plafonner. La même loi vaut ici : une intention qu'on peut lire est une intention qu'on peut auditer.
Un nœud dans l'agent de quelqu'un d'autre
OrbitSpec n'est pas une application, et le moyen le plus rapide de mal le juger est de l'évaluer comme telle. Le dépôt embarque quatre chatbots de démonstration construits avec LangGraph, chacun consommant le service via son SDK Python généré, et leur architecture est précisément le message : OrbitSpec est un nœud dans le graphe d'agent du client. La saisie de l'utilisateur entre dans le nœud de clarification ; le nœud renvoie soit une question, que le chat relaie, soit un bundle, que le reste du graphe consomme.
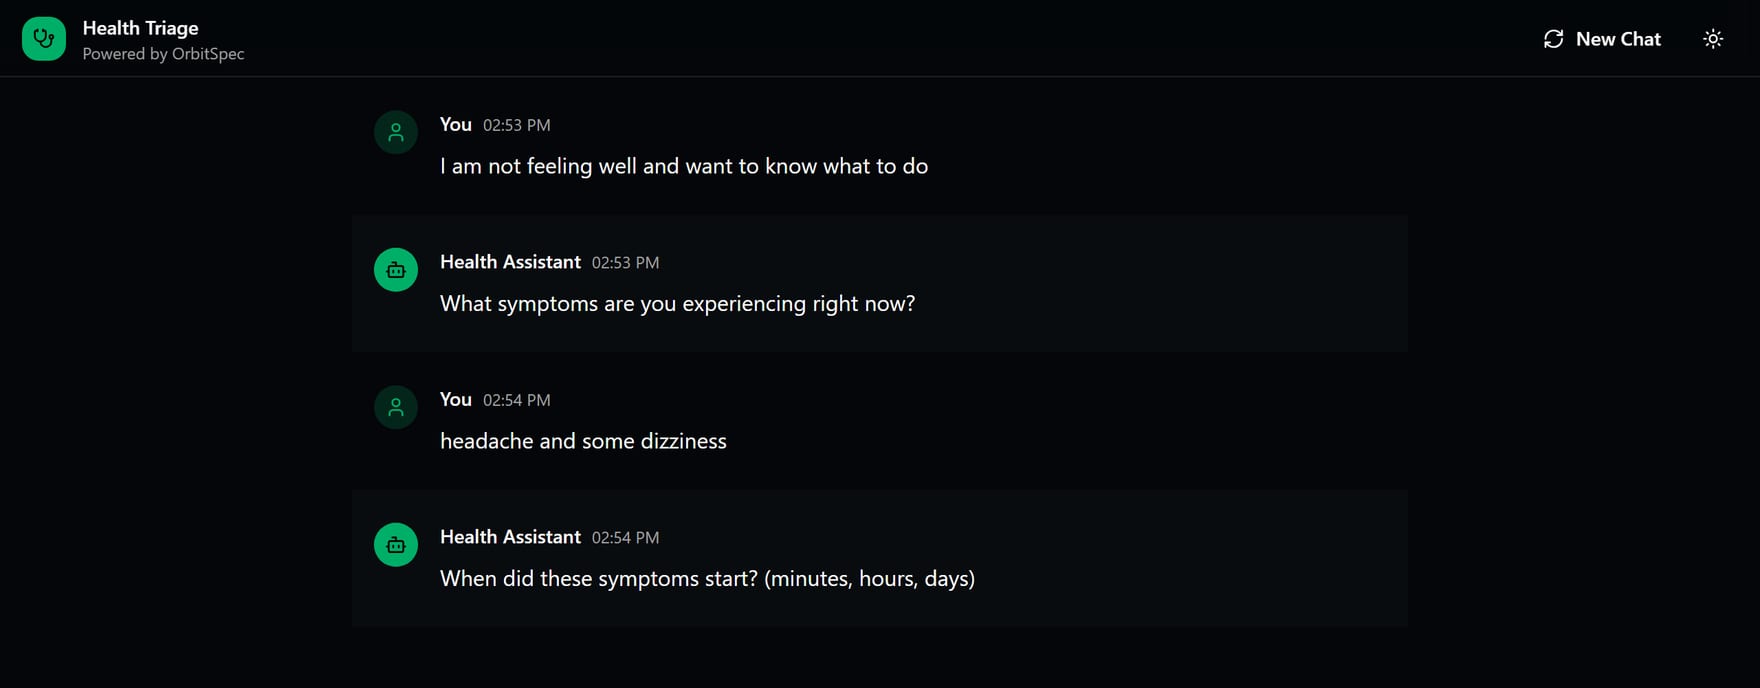 La démo de triage médical. L'interface de chat appartient au client ; les questions viennent du pack ; l'assistant ne répond jamais, il clarifie.
Le SDK lui-même fait partie de l'histoire de fiabilité. Il est généré à partir de la spec OpenAPI, et la CI le régénère à chaque changement du backend et échoue en cas de dérive, si bien que le client que consomment les démos ne peut pas diverger en silence de l'API qui les sert. Les contrats d'intégration pourrissent dans les jointures ; celui-ci est vérifié à chaque pull request.
La leçon des 138 secondes
La décision technique profonde de ce projet porte sur la place de l'intelligence, et elle a été apprise au prix fort.
Le design évident utilise un LLM pour extraire les champs du brouillon : l'utilisateur dit « j'ai mal à la tête et un peu de vertiges depuis hier après-midi », et le modèle remplit symptoms et duration sans rien demander. La première implémentation faisait tourner cette extraction sur un modèle local via Ollama, sur CPU, et le dépôt conserve le post-mortem : une moyenne de 138 secondes par requête de détection de champs, contre un timeout de 60 secondes. L'extraction censée épargner une question à l'utilisateur mettait deux minutes à ne pas y répondre.
Le correctif avait trois couches, et leur ordre compte plus que chacune prise isolément.
Les règles sont le plancher. La boucle de clarification est pleinement fonctionnelle sans aucun LLM : les champs se remplissent au fil des réponses, le moteur reste dans le territoire de la microseconde, et le produit fonctionne. L'intelligence est une amélioration, jamais une dépendance. Cette seule décision explique pourquoi un modèle à deux minutes ne pouvait pas entraîner le produit dans sa chute.
L'inférence est un échange standard, pas une réécriture. L'extraction est passée à un routeur hébergé qui fait tourner un petit modèle Llama, des secondes au lieu de minutes, et Ollama en local est resté disponible derrière un compose profile pour quiconque veut faire tourner l'inférence sur son propre matériel. Parce que l'extraction se trouve derrière une interface avec un repli sur les règles, le fournisseur est un choix de configuration.
Rien de ce que dit le modèle n'entre sans ancrage. Les valeurs extraites passent une couche de validation avant d'être acceptées : les champs sujets aux hallucinations doivent avoir un ancrage lexical dans les propres mots de l'utilisateur, les valeurs qui ne sont pour l'essentiel qu'un écho de l'entrée entière sont rejetées comme des copies, et les champs de type date doivent passer un contrôle de plausibilité. Un petit modèle qui se trompe vite n'est utile que si l'erreur ne peut pas entrer dans le bundle.
Le billet sur smithproof soutenait que le modèle qu'on peut se permettre d'exécuter dans le chemin de la requête est celui qui gouverne. C'est la même loi vue de l'autre côté : le modèle qu'on ne peut pas se permettre d'attendre est celui qui ne peut pas vous aider, et le moteur déterministe qu'on remarque à peine est celui qui le peut toujours.
Ennuyeux à dessein
Deux pièces plus modestes méritent leur ligne, toutes deux du genre d'ingénierie qui ne brille jamais en démo. L'état de session vit dans des hashes Redis gardés par un verrou optimiste scripté en Lua : un seul script atomique vérifie un champ de version avant d'écrire, renvoie des codes d'erreur distincts pour une session absente et pour un conflit de version, et rafraîchit le TTL, de sorte que deux réponses concurrentes à la même session ne peuvent pas s'écraser silencieusement l'une l'autre. Et le bloc trace du bundle porte la chaîne d'identité complète, trace id, session id, workspace id, generated-at, si bien que n'importe quel bundle peut être remonté jusqu'à chaque étape qui l'a produit.
Rien de tout cela n'est nouveau. Tout cela fait la différence entre une démo de clarification et un service sur lequel une autre entreprise peut construire.
Où ça en est
Le Context Bundle porte aujourd'hui l'intention, la demande d'origine, des champs typés, des contraintes de sortie et l'identité de trace. Les champs de la feuille de route sont visibles dans le schéma : une reformulation de la demande dans les mots du moteur, les hypothèses, les inconnues et les critères d'acceptation sont tous livrés comme des emplacements vides, en attente de la couche qui les remplira. Les Scope Profiles, des réponses mémorisées qui suivent un utilisateur d'une session à l'autre, ont leur place dans la précédence de fusion et leur drapeau dans l'API, la persistance viendra ensuite. Les clarificateurs sont en texte libre aujourd'hui ; les types choix et date sont déjà dessinés dans le système de types. Les jointures sont découpées là où les prochaines fonctionnalités viendront s'emboîter plutôt que se greffer.
J'ai construit OrbitSpec avant les deux autres systèmes, puis je l'ai mis de côté pour aller les construire. En y revenant une fois la trilogie achevée, la forme de l'ensemble est plus nette qu'elle ne l'était depuis l'intérieur d'une seule de ses parties : spécifier la question, structurer la délégation, gouverner l'agent. Trois couches, une leçon chacune, et la même conclusion à chaque fois. Les parties d'un système d'IA auxquelles on peut se fier sont celles qui n'ont jamais été intelligentes, et leur rôle est de rendre les parties intelligentes sûres à utiliser.
Les questions auxquelles cet article répond
Pourquoi un produit d'IA pose-t-il une question au lieu de répondre tout de suite ?
Parce que la défaillance évitée se situe en amont du modèle. Une demande qui dit seulement que quelqu'un a besoin d'aide pour un problème de santé n'a pas de bonne réponse, et tout ce qu'un modèle en tire est de la devinette coûteuse habillée d'un ton assuré. Retrieval, reranking, garde-fous et evals opèrent tous du côté réponse, une fois la mauvaise question déjà acceptée, alors que poser un clarificateur d'abord coûte des microsecondes.
Une étape de clarification, cela n'ajoute-t-il pas de la latence et n'agace-t-il pas l'utilisateur ?
Le coût du moteur n'est pas le problème : le temps moteur total sur toute une conversation reste bien en dessous de la milliseconde, et le registre d'audit montre chaque étape en fractions de milliseconde. Le nombre de questions est borné par les données et non par le bon vouloir d'un modèle : un pack de sept champs qui en marque deux comme obligatoires produit une conversation de deux questions, et jamais plus que ce que le pack demande. Poser un clarificateur par tour est également délibéré, parce que les utilisateurs répondent à une question et abandonnent les questionnaires.
Que contient réellement un Context Bundle ?
Aujourd'hui il porte l'intention, la demande d'origine, des champs typés, des contraintes de sortie et un bloc trace avec trace id, session id, workspace id et generated-at, si bien que n'importe quel bundle peut être remonté jusqu'à chaque étape qui l'a produit. La version du pack est épinglée à la création de la session et inscrite dans le bundle, ce qui le rend reproductible : même pack, mêmes réponses, même sortie. La reformulation, les hypothèses, les inconnues et les critères d'acceptation figurent dans le schéma comme des emplacements vides, en attente de la couche qui les remplira.
Faut-il utiliser un LLM pour extraire les champs de ce que l'utilisateur a déjà écrit ?
Seulement derrière un repli sur les règles et un contrôle d'ancrage. La première implémentation faisait tourner l'extraction sur un modèle local via Ollama sur CPU, à une moyenne de 138 secondes par requête de détection de champs contre un timeout de 60 secondes : l'étape censée épargner une question à l'utilisateur mettait deux minutes à ne pas y répondre. Le passage à un routeur hébergé avec un petit modèle Llama a ramené cela à des secondes, et les valeurs extraites passent toujours d'abord par la validation : les champs sujets aux hallucinations doivent avoir un ancrage lexical dans les propres mots de l'utilisateur, les valeurs qui ne sont pour l'essentiel qu'un écho de l'entrée entière sont rejetées, et les champs de type date doivent passer un contrôle de plausibilité.
À lire ensuite
 AI Agents
J'ai construit le pipeline qui a construit mon produit. Voici ce que déléguer exige vraiment
Notes de terrain sur plan-to-pr, un pipeline qui transforme une demande de fonctionnalité en tickets, en un point de contrôle d'approbation et en pull requests en brouillon, et pourquoi déléguer à des agents de code demande des artefacts, pas du chat. AI Agents
J'ai construit un plan de contrôle pour agents IA. Voici ce que la gouvernance exige vraiment
Notes de terrain sur la construction de Smithproof, un plan de contrôle multi-tenant pour agents IA, et pourquoi la détection sans réponse et la politique sans application ne gouvernent rien.