
Agentes de IA, MCP e o Panorama Atual das Frameworks
Ouvir o artigo (experimental) · 20:22
Como funcionam os agentes de IA
Um agente de IA é um sistema conduzido por um LLM que opera em ciclo:
- Planear: decompor um objetivo em subtarefas.
- Agir: selecionar e invocar uma ou mais ferramentas.
- Observar: ler os resultados das ferramentas e atualizar o estado interno.
- Iterar: repetir até o objetivo ser cumprido ou ser atingida uma condição de paragem.
O exemplo mais fundamental deste ciclo é o ReAct (Reasoning + Acting). Apresentado por Yao et al. em 2022, o ReAct intercala traços de raciocínio em cadeia de pensamento com passos de ação. O agente pensa em voz alta sobre o que fazer, chama uma ferramenta, observa o resultado e raciocina de novo. É, na prática, o "Hello World" das arquiteturas de agentes: praticamente todas as frameworks modernas (LangChain, Semantic Kernel, ADK, Agents SDK) trazem um ciclo ao estilo ReAct como modo de agente por omissão. Perceber o ReAct é o requisito prévio para perceber tudo o resto neste artigo.
Opcionalmente, os agentes incorporam memória (contexto de curto e longo prazo) e pontos de verificação com humano no ciclo para decisões críticas em termos de segurança.
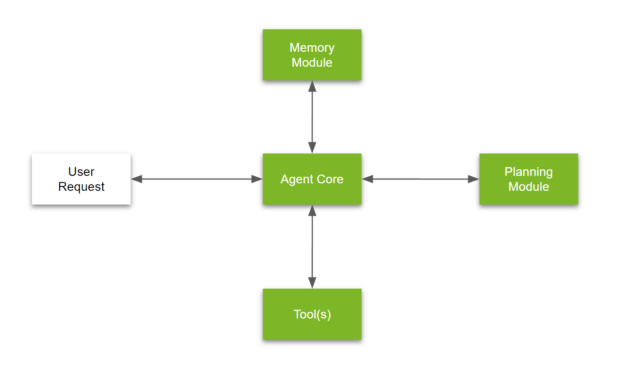
A decomposição canónica da NVIDIA continua a ser um modelo mental útil:
| Componente | Papel |
|---|---|
| Núcleo do Agente | Motor de raciocínio LLM que conduz o ciclo |
| Módulo de Memória | Persiste o contexto ao longo de turnos e sessões |
| Ferramentas | Capacidades externas que o agente pode invocar |
| Módulo de Planeamento | Seleção de estratégia, decomposição de tarefas, replaneamento |
Agentes vs. fluxos de trabalho (A distinção da Anthropic)
| Dimensão | Fluxos de trabalho | Agentes |
|---|---|---|
| Controlo de fluxo | DAG codificado à mão | Decidido pelo LLM em tempo de execução |
| Previsibilidade | Alta | Mais baixa, com maior variância |
| Auditabilidade | Direta | Exige rastreio |
| Quando usar | Processos conhecidos e repetíveis | Tarefas abertas ou exploratórias |
Ambos pertencem à mesma família de sistemas agênticos. Os sistemas em produção combinam com frequência passos determinísticos de fluxo de trabalho com subtarefas conduzidas por agentes onde é precisa flexibilidade.
As ferramentas são contratos semânticos
As ferramentas são contratos semânticos. Um agente lê o nome, a descrição e o esquema de uma ferramenta para decidir se e como a deve chamar. Se algum desses sinais for vago, o agente pode:
- Chamar a ferramenta errada.
- Passar entradas mal formadas.
- Interpretar mal as saídas e alucinar a jusante.
A investigação da Anthropic sobre como escrever ferramentas para agentes mostra que tratar as ferramentas como produtos orientados ao programador melhora de forma mensurável as taxas de conclusão e reduz o desperdício de tokens:
| Princípio | O que significa na prática |
|---|---|
| Esquemas rígidos | Entradas/saídas tipadas com campos obrigatórios vs. opcionais claramente assinalados |
| Truncagem útil | Cargas grandes são resumidas; quem chama pode pedir detalhe a pedido |
| Pistas de erro claras | As mensagens de erro dizem ao agente o que fazer a seguir, não apenas o que falhou |
| Espaços de nomes | Nomes de ferramentas circunscritos a um domínio (ex.: legal.searchCases) para evitar colisões |
| Paginação | Conjuntos de resultados limitados com cursores, evitando o estouro da janela de contexto |
| Avaliações | Suites de testes automatizados que medem a taxa de sucesso do agente por ferramenta |
Padrões: dos fluxos de trabalho à autonomia total
Estes padrões situam-se num espectro que vai do totalmente determinístico ao totalmente autónomo. Escolha consoante o nível de controlo e de variância que o seu caso de uso exige:
| Padrão | Descrição | Nível de controlo |
|---|---|---|
| Encadeamento de prompts | Sequência de chamadas a LLM; a saída de cada passo alimenta o seguinte. Portões de qualidade opcionais entre passos. | Alto |
| Encaminhamento | Um classificador dirige a entrada para prompts ou conjuntos de ferramentas especializados. | Alto |
| Paralelização | Várias chamadas a LLM correm em simultâneo, seja por seccionamento (dividir a tarefa) ou por votação (mesma tarefa, consenso). | Médio |
| Orquestrador-Trabalhadores | Um agente gestor decompõe dinamicamente uma tarefa, delega em agentes trabalhadores e sintetiza os resultados. | Médio-Baixo |
| Avaliador-Otimizador | Um agente gera; outro critica; o ciclo refina até os critérios de qualidade serem cumpridos. | Baixo |
Regra prática (Anthropic): Comece com o padrão mais simples que resolva o problema. Escale para ciclos completos de agente apenas quando a tarefa exigir genuinamente uma tomada de decisão dinâmica.
Exemplo do mundo real: GitHub Copilot no VS Code
O agente de programação do GitHub Copilot no VS Code é uma boa ilustração de como estes padrões se combinam num produto em produção:
- Encaminhamento. Quando escreve uma mensagem, o Copilot classifica a intenção: trata-se de uma conclusão em linha, de uma pergunta de chat ou de uma edição em múltiplos ficheiros? Cada uma segue para um pipeline diferente.
- Orquestrador-Trabalhadores. Em modo de agente, o Copilot recebe uma tarefa de alto nível (ex.: "adicionar validação de entradas ao formulário de registo"), parte-a em subtarefas e delega cada uma em chamadas a ferramentas especializadas: ler ficheiros, fazer grep de símbolos, correr comandos no terminal, aplicar edições, correr testes.
- Avaliador-Otimizador. Depois de fazer alterações, o agente corre linters, testes ou verificadores de tipos. Se algo falhar, lê a saída de erro, raciocina sobre a correção e itera num ciclo de gerar, avaliar e refinar.
- Encadeamento de prompts com portões. A saída de cada passo condiciona o seguinte. Se a leitura de um ficheiro devolver conteúdo inesperado, o agente replaneia em vez de prosseguir às cegas.
Por baixo, isto é um ciclo ReAct apoiado numa integração de ferramentas ao estilo MCP: o Copilot descobre as ferramentas disponíveis (sistema de ficheiros, terminal, pesquisa, APIs do editor), chama-as através de esquemas estruturados, observa os resultados e raciocina sobre os passos seguintes. É um exemplo concreto de um sistema em produção que mistura fluxos de trabalho determinísticos com a flexibilidade conduzida por agentes.
O Copilot deixa-o também trocar duas alavancas-chave que afetam diretamente o comportamento:
Modelo. Mudar, por exemplo, de GPT-4o para Claude Sonnet ou Gemini altera o motor de raciocínio. Modelos diferentes têm forças diferentes: uns são melhores a planear edições em vários passos, outros a seguir instruções com precisão, outros a minimizar alucinações. As mesmas ferramentas e o mesmo prompt podem produzir resultados visivelmente diferentes consoante o modelo, e é por isso que as avaliações (a Fase 4 no plano de implementação mais abaixo) são importantes.
Modo. O Copilot oferece três modos integrados que se situam em pontos diferentes do espectro de autonomia:
- Ask: um pipeline de pergunta-resposta (encadeamento de prompts). Sem edições de ficheiros, sem chamadas a ferramentas, apenas raciocínio sobre o contexto que fornece.
- Agent: o ciclo completo de orquestrador-trabalhadores. Pode ler a sua base de código, correr comandos no terminal, instalar dependências, criar ficheiros e iterar sobre falhas de forma autónoma. É o ciclo ReAct em ação.
- Plan: um meio-termo. O agente raciocina ao longo da tarefa e produz um plano passo a passo, mas aguarda a sua aprovação antes de executar qualquer alteração. É, no fundo, o padrão de "ponto de verificação com humano no ciclo" descrito atrás.
Passar de Ask para Plan e para Agent aumenta a flexibilidade, mas também aumenta a variância, o custo e a importância de bons esquemas de ferramentas. Pode ainda definir Agentes Personalizados com instruções e conjuntos de ferramentas à medida, criando na prática uma camada de encaminhamento especializada para os seus próprios fluxos de trabalho.
Sessões. O Copilot suporta correr várias sessões de agente em paralelo, cada uma com o seu próprio modelo, modo e contexto. Isto transforma o modelo de agente único num padrão prático de paralelização: pode ter uma sessão a escrever testes unitários para um componente, outra a implementar uma nova funcionalidade, outra a gerar documentação, todas a correr em simultâneo sobre a mesma base de código. Isto funciona especialmente bem em arquiteturas com fronteiras de módulos bem definidas. Num projeto Django, por exemplo, cada app (autenticação, faturação, notificações) é em grande medida independente, com os seus próprios modelos, vistas, URLs e testes. Pode com segurança arrancar sessões paralelas circunscritas a apps diferentes, com risco mínimo de conflitos de merge, porque as superfícies de ficheiros mal se sobrepõem. O mesmo princípio aplica-se a qualquer base de código com fronteiras de pacote ou de serviço bem definidas (microsserviços, pacotes de monorepo, módulos Go, etc.). Na prática, as sessões paralelas permitem-lhe trocar tempo de relógio por débito, comprimindo aquilo que seria trabalho sequencial em trabalho concorrente, desde que as tarefas estejam suficientemente isoladas.
O ecossistema de frameworks
O ecossistema divide-se em três camadas. As frameworks de agentes são onde se constroem agentes. O MCP é o protocolo que os liga a ferramentas externas. As camadas de governação gerem frotas de agentes à escala empresarial. São complementares, não alternativas.
Frameworks de agentes
Microsoft Agent Framework
- Atualmente em public preview (GitHub).
- Unifica o Semantic Kernel (SK) e o AutoGen sob um único modelo de programação.
- Acrescenta fluxos de trabalho tipados e baseados em grafos, com forte observabilidade (OpenTelemetry incorporado).
- Integração nativa dos protocolos MCP e A2A.
- Suporte multi-fornecedor: Azure OpenAI, OpenAI, Anthropic, Ollama e mais.
- Vem com uma UI para programadores (DevUI) para inspecionar os traços dos agentes.
OpenAI
A stack de agentes da OpenAI está repartida por vários produtos:
| Produto | O que é | Lançamento |
|---|---|---|
| Responses API | Primitiva de API que combina a simplicidade do Chat Completions com uso de ferramentas incorporado (pesquisa na web, pesquisa em ficheiros, interpretador de código, uso de computador, geração de imagens). | Março de 2025 |
| Agents SDK | Biblioteca open-source em Python/Node para orquestrar fluxos de trabalho de um e de vários agentes (handoffs, guardrails, rastreio). Sucessora do Swarm. | Março de 2025 |
| AgentKit | Conjunto de ferramentas de nível mais alto que agrega o Agent Builder (tela visual de fluxos de trabalho), o ChatKit (UI de chat embutível) e o Connector Registry (gestão centralizada de fontes de dados). | Outubro de 2025 |
A página Agent Platform é o chapéu de marketing da OpenAI para tudo o que foi referido acima.
Google Agent Development Kit (ADK)
- Framework open-source e modular, otimizada para o Gemini mas agnóstica quanto ao modelo.
- Suporta topologias de um e de vários agentes.
- Alvos de implementação:
- Vertex AI Agent Engine: totalmente gerido, com escalabilidade automática.
- Cloud Run: em contentores, com infraestrutura própria.
- GKE: implementação baseada em Kubernetes.
Protocolo de interoperabilidade
MCP (Model Context Protocol)
- Norma aberta originalmente criada pela Anthropic, agora governada pela The Linux Foundation e aberta a contribuições da comunidade (protocolo e SDKs, registo de servidores).
- Os clientes (Claude, ChatGPT, VS Code, IDEs da JetBrains, Cursor, etc.) ligam-se a servidores MCP que expõem esquemas de ferramentas.
- Está rapidamente a tornar-se a camada de interoperabilidade de facto para os sistemas agênticos.
- Registo em crescimento de servidores da comunidade e de fornecedores (GitHub, Azure DevOps, Notion, Playwright, Slack, bases de dados, etc.).
- Valor-chave: escreva as suas ferramentas uma vez e exponha-as a qualquer cliente compatível com MCP, sem trabalho de integração por cliente.
- As três frameworks acima suportam MCP nativamente ou através de plugins.
Camadas de governação
MuleSoft Agent Fabric (Salesforce)
- Camada de governação empresarial para frotas de agentes:
- Registo: catálogo dos agentes e ferramentas disponíveis.
- Broker: encaminha os pedidos para o agente certo.
- Políticas: controlo de acessos, limitação de débito, prevenção de perda de dados.
- Observabilidade: registo e rastreio centralizados.
- Suporta MCP como norma de conectividade.
- Pensado para organizações que correm dezenas a centenas de agentes em escala.
Equipas de múltiplos agentes
Um padrão em crescimento são as equipas de agentes em contentores: grupos de agentes especializados por domínio que colaboram sob um envelope de governação partilhado:
- O AgentCatalog no Docker Hub é um exemplo precoce: imagens de agentes pré-construídas para tarefas comuns.
- As equipas podem ser compostas dinamicamente (ex.: uma equipa de "revisão de contratos" com um agente de extração de cláusulas, um agente de pontuação de risco e um agente de sumarização).
- A orquestração de contentores (Kubernetes, Docker Compose) permite escalar, versionar e reverter ao nível do agente.
- As políticas internas de governação e de acessos podem ser aplicadas por contentor.
Arquiteturas de referência
| # | Arquitetura | Componentes-chave |
|---|---|---|
| 1 | Azure primeiro, com forte peso de fluxos de trabalho | Orquestrador do Microsoft Agent Framework para servidor MCP em Azure Container Apps para serviços de Azure AI |
| 2 | OpenAI primeiro, com forte peso de builder | AgentKit / Agent Builder para Agents SDK para servidor MCP (qualquer host) |
| 3 | GCP primeiro, centrado em ADK | Agente ADK no Vertex AI Agent Engine para servidor MCP no Cloud Run |
| 4 | Frota governada | Broker do MuleSoft Agent Fabric para vários servidores MCP para camada de aplicação de políticas |
As quatro convergem no MCP como norma de conectividade de ferramentas. A escolha é guiada pela pegada de nuvem existente, pelas relações com fornecedores e pelos requisitos de governação.
De zero a produção: um plano de implementação
Cada fase tem um resultado claro e critérios de saída, para que saiba quando avançar (ou recuar).
Fase 1: Definir a superfície de ferramentas
Objetivo: Decidir o que expor antes de escrever qualquer código.
- Audite as APIs e os fluxos de trabalho que o seu sistema já tem. Identifique 3 a 5 operações de alto valor que os agentes chamariam de forma realista, por exemplo, pesquisar documentos, extrair entidades, verificar o estado de um processo, gerar um resumo.
- Para cada operação, responda:
- Quais são as entradas obrigatórias vs. opcionais? (Tipe-as de forma rígida.)
- Como é a saída no caminho feliz? E a saída de erro?
- A operação é só de leitura ou tem efeitos secundários?
- Escreva os esquemas das ferramentas (JSON Schema ou equivalente) com:
- Uma
descriptionclara e legível pelo agente. É o que o LLM vê para decidir se chama a ferramenta. - Um parâmetro
mode("concise"|"detailed") para controlar a verbosidade da saída. - Paginação baseada em cursor (
cursor+limit) para os endpoints de lista. - Uma flag
truncated: truenas respostas, para que o agente saiba que deve obter mais. - Erros pedagógicos: mensagens de erro que dizem ao agente como corrigir a chamada, não apenas que falhou.
- Uma
Resultado: Um documento de esquema (definições de ferramentas em OpenAPI ou MCP) revisto por pelo menos uma pessoa que não o escreveu.
Critério de saída: Um colega consegue ler os esquemas a frio e prever corretamente o que cada ferramenta faz, que entradas precisa e como é a saída.
Fase 2: Construir o servidor MCP
Objetivo: Transformar os esquemas num servidor a correr a que qualquer cliente MCP se possa ligar.
- Implemente cada ferramenta atrás de um servidor compatível com MCP (SDK de TypeScript ou Python).
- Escolha o transporte consoante o caso de uso:
| Transporte | Quando usar |
|---|---|
| stdio | Desenvolvimento local, integrações com IDE (VS Code, Cursor) |
| Streamable HTTP | Implementação remota / alojada na nuvem, cenários multi-inquilino |
- Integre a segurança desde o primeiro dia:
- As ferramentas com efeitos secundários têm de suportar um modo
dry_run(devolve o que aconteceria) e um modocommit(executa a ação). - As operações destrutivas exigem um passo de confirmação humana antes de o
commitprosseguir.
- As ferramentas com efeitos secundários têm de suportar um modo
- Valide a interoperabilidade com pelo menos dois clientes MCP (ex.: Claude Desktop + VS Code Copilot). Se ambos conseguirem descobrir e chamar corretamente todas as ferramentas, o servidor está pronto.
Resultado: Um servidor MCP implementado (ou executável localmente) com testes de integração a passar contra dois clientes.
Critério de saída: Ambos os clientes conseguem concluir, de ponta a ponta, uma tarefa realista de vários passos usando apenas as ferramentas expostas.
Fase 3: Ligar uma framework de agentes
Objetivo: Provar que o servidor MCP funciona com um agente real. Escolha uma framework para começar.
Escolha a framework que combina com a stack da sua equipa:
| Se a sua stack é… | Comece com… |
|---|---|
| Azure / .NET | Microsoft Agent Framework |
| Forte em OpenAI / Python | Agents SDK + Agent Builder |
| GCP / Gemini | Google ADK no Vertex AI Agent Engine |
Construa duas coisas:
- Um fluxo de trabalho determinístico: uma sequência fixa de chamadas a ferramentas (ex.: "pesquisar, extrair, resumir"). Isto valida que as ferramentas compõem corretamente.
- Um agente de forma livre: as mesmas ferramentas, mas com o LLM a decidir o plano em tempo de execução. Isto põe os seus esquemas à prova: se o agente escolher a ferramenta errada ou passar entradas más, as suas descrições ou mensagens de erro precisam de trabalho.
Opcionalmente, repita com uma segunda framework para confirmar que o servidor MCP é realmente agnóstico quanto à framework.
Resultado: Um agente funcional (fluxo de trabalho + forma livre) que conclui tarefas reais usando o servidor MCP.
Critério de saída: O agente conclui ≥ 80% das tarefas de teste sem intervenção humana.
Fase 4: Avaliar e iterar
Objetivo: Medir o quão bem os agentes usam as suas ferramentas e corrigir o que está partido.
- Crie 10 a 20 tarefas realistas com saídas de referência esperadas (ex.: "Encontrar todos os contratos que expiram no 2.º trimestre e resumir as obrigações principais").
- Corra cada tarefa tanto pelo fluxo de trabalho como pelo agente de forma livre. Para cada execução, registe:
| Métrica | Porque importa |
|---|---|
| Taxa de sucesso | O agente chegou à resposta correta? |
| Número de chamadas a ferramentas | Chamadas a mais sinalizam um esquema confuso |
| Uso de tokens | Indicador indireto do custo |
| Latência | De ponta a ponta e por ferramenta |
| Taxa de erro por categoria | Revela problemas sistemáticos de desenho das ferramentas |
- Faça a triagem das falhas:
- Ferramenta errada selecionada: melhore a
descriptionda ferramenta. - Parâmetros errados: aperte o esquema, adicione restrições
enum, melhore as pistas de erro. - Chamada correta, interpretação errada do resultado: simplifique o formato da saída ou adicione um campo
summary.
- Ferramenta errada selecionada: melhore a
- Volte a correr a suite de avaliação após cada correção. Acompanhe a melhoria ao longo das iterações.
Resultado: Uma suite de avaliação (automatizada, re-executável) e um registo das alterações de esquema com taxas de sucesso antes/depois.
Critério de saída: ≥ 90% de taxa de sucesso na suite de avaliação com ambos os modos de agente.
Fase 5: Robustecer e escalar
Objetivo: Preparar para o tráfego de produção e para a adoção organizacional.
- Observabilidade. Instrumente o servidor MCP com rastreio distribuído (OpenTelemetry) e registo estruturado. Cada chamada a uma ferramenta deve ser rastreável desde o pedido do cliente até ao sistema de backend.
- Limitação de débito e controlo de acessos. Decida quem (que agentes, que utilizadores) pode chamar que ferramentas, e a que débito.
- Governação à escala. Se prevê vários servidores MCP ou equipas de agentes, adote uma camada de broker/fabric (ex.: MuleSoft Agent Fabric) para:
- Aplicação centralizada de políticas.
- Registo de auditoria (quem chamou o quê, quando e com que entradas).
- Monitorização ao nível da frota e interruptores de emergência.
- Documentação. Publique um catálogo de ferramentas (descrições legíveis, exemplos de chamadas, limitações conhecidas), para que outras equipas possam construir agentes contra o seu servidor MCP sem terem de o fazer por engenharia inversa.
Resultado: Um servidor MCP pronto para produção, com painéis de monitorização, políticas de acesso e um catálogo de ferramentas publicado.
Critério de saída: Uma equipa que não esteve envolvida na construção do servidor consegue pôr de pé um novo agente contra ele usando apenas o catálogo e os esquemas públicos.
Perguntas a que este artigo responde
Qual é a diferença entre um agente de IA e um fluxo de trabalho?
O controlo de fluxo. Um fluxo de trabalho corre um DAG codificado à mão, por isso é previsível e de auditoria direta, enquanto um agente deixa o LLM decidir o caminho em tempo de execução, o que compra flexibilidade ao preço de maior variância e da necessidade de rastreio. Ambos pertencem à mesma família de sistemas agênticos, e os sistemas em produção costumam misturá-los, mantendo os passos determinísticos onde o processo é conhecido e entregando aos agentes as subtarefas abertas. A regra prática da Anthropic mantém-se: comece pelo padrão mais simples que resolva o problema e escale apenas quando a tarefa exigir genuinamente uma tomada de decisão dinâmica.
Porque é que o meu agente chama sempre a ferramenta errada?
Normalmente a culpa é da descrição, não do modelo. O agente lê apenas o nome, a descrição e o esquema de uma ferramenta para decidir se e como a chama, por isso sinais vagos produzem a escolha da ferramenta errada, entradas mal formadas ou saídas mal interpretadas que alucinam a jusante. A triagem é direta: ferramenta errada selecionada significa melhorar a descrição; parâmetros errados significam apertar o esquema, adicionar restrições enum e escrever mensagens de erro que digam como corrigir a chamada; uma chamada correta mal interpretada significa simplificar o formato da saída ou acrescentar um campo summary.
O MCP é só mais uma camada por cima das APIs que já tenho?
É uma camada com um retorno específico: escreve-se a ferramenta uma vez e qualquer cliente compatível com MCP a pode usar, sem trabalho de integração por cliente. Os clientes já incluem o Claude, o ChatGPT, o VS Code, os IDEs da JetBrains e o Cursor, e o Microsoft Agent Framework, a stack da OpenAI e o Google ADK suportam-no nativamente ou através de plugins. É uma norma aberta criada pela Anthropic e hoje governada pela The Linux Foundation, pelo que adotá-la não é apostar num único fornecedor.
Como sei que o meu servidor MCP está mesmo pronto para produção?
Use os critérios de saída de cada fase em vez de uma sensação. Dois clientes MCP diferentes, por exemplo o Claude Desktop e o VS Code Copilot, devem conseguir concluir de ponta a ponta uma tarefa realista de vários passos usando apenas as suas ferramentas; o agente de forma livre deve concluir pelo menos 80% das tarefas de teste sem intervenção humana e pelo menos 90% de uma suite de avaliação de 10 a 20 tarefas realistas. O critério final não é técnico: uma equipa que nada teve a ver com a construção do servidor deve conseguir pôr de pé um novo agente usando apenas o catálogo publicado e os esquemas.
Ler a seguir
 AI Agents
Construí uma camada de IA que nunca responde. Eis o que uma boa pergunta realmente exige
Notas de campo do OrbitSpec, um motor de clarificação que transforma pedidos vagos em Context Bundles tipados e auditáveis antes de qualquer modelo correr, e porque é que a fiabilidade começa antes da resposta. AI Agents
Construí o pipeline que construiu o meu produto. Eis o que delegar realmente exige
Notas de campo do plan-to-pr, um pipeline que transforma um pedido de funcionalidade em tickets, num gate de aprovação e em draft pull requests, e a razão pela qual delegar em agentes de código exige artefactos, não conversa.