
KI-Agenten, MCP und die moderne Framework-Landschaft
Artikel anhören (experimentell) · 20:56
Wie KI-Agenten funktionieren
Ein KI-Agent ist ein LLM-gesteuertes System, das in einer Schleife arbeitet:
- Planen: ein Ziel in Teilaufgaben zerlegen.
- Handeln: ein oder mehrere Tools auswählen und aufrufen.
- Beobachten: Tool-Ergebnisse lesen und den internen Zustand aktualisieren.
- Iterieren: wiederholen, bis das Ziel erreicht ist oder eine Abbruchbedingung eintritt.
Das grundlegendste Beispiel für diese Schleife ist ReAct (Reasoning + Acting). 2022 von Yao et al. vorgestellt, verschränkt ReAct Reasoning-Spuren im Sinne einer Gedankenkette mit Action-Schritten. Der Agent denkt laut darüber nach, was zu tun ist, ruft ein Tool auf, beobachtet das Ergebnis und überlegt erneut. Es ist faktisch das "Hello World" der Agentenarchitekturen: Nahezu jedes moderne Framework (LangChain, Semantic Kernel, ADK, Agents SDK) liefert eine Schleife im ReAct-Stil als Standard-Agentenmodus mit. ReAct zu verstehen ist die Voraussetzung, um alles Weitere in diesem Artikel zu verstehen.
Optional binden Agenten Memory (Kurz- und Langzeitkontext) und Human-in-the-Loop-Checkpoints für sicherheitskritische Entscheidungen ein.
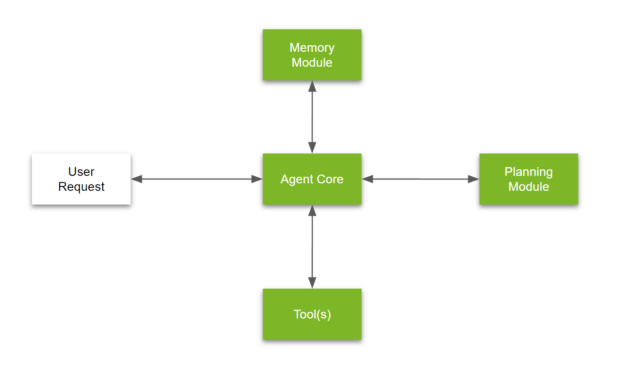
NVIDIAs kanonische Zerlegung bleibt ein nützliches mentales Modell:
| Komponente | Rolle |
|---|---|
| Agent Core | LLM-Reasoning-Engine, die die Schleife antreibt |
| Memory Module | Bewahrt den Kontext über Turns und Sitzungen hinweg |
| Tools | Externe Fähigkeiten, die der Agent aufrufen kann |
| Planning Module | Strategieauswahl, Aufgabenzerlegung, Neuplanung |
Agenten vs. Workflows (Anthropics Unterscheidung)
| Dimension | Workflows | Agenten |
|---|---|---|
| Kontrollfluss | Fest verdrahteter DAG | Zur Laufzeit vom LLM entschieden |
| Vorhersagbarkeit | Hoch | Geringer, mit höherer Varianz |
| Auditierbarkeit | Unkompliziert | Erfordert Tracing |
| Wann einsetzen | Bekannte, wiederholbare Prozesse | Offene oder explorative Aufgaben |
Beide gehören zur selben Familie der agentischen Systeme. Produktionssysteme kombinieren häufig deterministische Workflow-Schritte mit agentengesteuerten Teilaufgaben, wo Flexibilität nötig ist.
Tools sind semantische Verträge
Tools sind semantische Verträge. Ein Agent liest Name, Beschreibung und Schema eines Tools, um zu entscheiden, ob und wie er es aufruft. Sind eines dieser Signale unklar, kann der Agent:
- das falsche Tool aufrufen.
- fehlerhafte Eingaben übergeben.
- Ausgaben falsch interpretieren und nachgelagert halluzinieren.
Anthropics Forschung zum Schreiben von Tools für Agenten zeigt, dass es die Abschlussraten messbar verbessert und Token-Verschwendung reduziert, wenn man Tools wie an Entwickler gerichtete Produkte behandelt:
| Prinzip | Was es in der Praxis bedeutet |
|---|---|
| Strenge Schemata | Typisierte Ein-/Ausgaben mit klar gekennzeichneten Pflicht- und optionalen Feldern |
| Hilfreiche Kürzung | Große Payloads werden zusammengefasst; Aufrufer können bei Bedarf Details anfordern |
| Klare Fehlerhinweise | Fehlermeldungen sagen dem Agenten, was als Nächstes zu tun ist, nicht nur, was fehlschlug |
| Namespacing | Tool-Namen auf eine Domäne begrenzt (z. B. legal.searchCases), um Kollisionen zu vermeiden |
| Pagination | Begrenzte Ergebnismengen mit Cursors, die ein Überlaufen des Kontextfensters verhindern |
| Evaluations | Automatisierte Testsuiten, die die Erfolgsrate des Agenten je Tool messen |
Muster: Von Workflows zur vollen Autonomie
Diese Muster bewegen sich auf einem Spektrum von vollständig deterministisch bis vollständig autonom. Wählen Sie nach dem Maß an Kontrolle und Varianz, das Ihr Anwendungsfall verlangt:
| Muster | Beschreibung | Kontrollebene |
|---|---|---|
| Prompt Chaining | Folge von LLM-Aufrufen; die Ausgabe jedes Schritts speist den nächsten. Optionale Qualitätsschranken zwischen den Schritten. | Hoch |
| Routing | Ein Klassifikator leitet die Eingabe an spezialisierte Prompts oder Tool-Sets. | Hoch |
| Parallelization | Mehrere LLM-Aufrufe laufen gleichzeitig, entweder sectioning (Aufgabe aufteilen) oder voting (gleiche Aufgabe, Konsens). | Mittel |
| Orchestrator-Workers | Ein Manager-Agent zerlegt eine Aufgabe dynamisch, delegiert an Worker-Agenten und führt die Ergebnisse zusammen. | Mittel bis niedrig |
| Evaluator-Optimizer | Ein Agent generiert; ein anderer kritisiert; die Schleife verfeinert, bis die Qualitätskriterien erfüllt sind. | Niedrig |
Faustregel (Anthropic): Beginnen Sie mit dem einfachsten Muster, das das Problem löst. Steigen Sie nur dann zu vollen Agentenschleifen auf, wenn die Aufgabe wirklich dynamische Entscheidungen verlangt.
Praxisbeispiel: GitHub Copilot in VS Code
Der Coding-Agent von GitHub Copilot in VS Code veranschaulicht gut, wie diese Muster in einem ausgelieferten Produkt zusammenspielen:
- Routing. Wenn Sie eine Nachricht eingeben, klassifiziert Copilot die Absicht: Ist das eine Inline-Vervollständigung, eine Chat-Frage oder eine Bearbeitung über mehrere Dateien? Jede führt zu einer anderen Pipeline.
- Orchestrator-Workers. Im Agentenmodus erhält Copilot eine übergeordnete Aufgabe (z. B. "Eingabevalidierung zum Anmeldeformular hinzufügen"), zerlegt sie in Teilaufgaben und delegiert jede an spezialisierte Tool-Aufrufe: Dateien lesen, nach Symbolen grep-en, Terminalbefehle ausführen, Änderungen anwenden, Tests laufen lassen.
- Evaluator-Optimizer. Nach Änderungen führt der Agent Linter, Tests oder Typechecker aus. Schlägt etwas fehl, liest er die Fehlerausgabe, überlegt sich die Korrektur und iteriert in einer Schleife aus Generieren, Bewerten, Verfeinern.
- Prompt Chaining mit Schranken. Die Ausgabe jedes Schritts schränkt den nächsten ein. Liefert ein Dateizugriff unerwarteten Inhalt, plant der Agent neu, statt blind weiterzumachen.
Im Inneren ist dies eine ReAct-Schleife, gestützt auf eine Tool-Integration im MCP-Stil: Copilot entdeckt verfügbare Tools (Dateisystem, Terminal, Suche, Editor-APIs), ruft sie über strukturierte Schemata auf, beobachtet Ergebnisse und überlegt die nächsten Schritte. Es ist ein konkretes Beispiel für ein Produktionssystem, das deterministische Workflows mit agentengesteuerter Flexibilität verbindet.
Copilot lässt Sie außerdem zwei zentrale Stellschrauben austauschen, die das Verhalten direkt beeinflussen:
Modell. Der Wechsel etwa von GPT-4o zu Claude Sonnet oder Gemini ändert die Reasoning-Engine. Verschiedene Modelle haben unterschiedliche Stärken: Manche planen mehrstufige Änderungen besser, andere folgen Anweisungen präziser, wieder andere minimieren Halluzinationen. Dieselben Tools und derselbe Prompt können je nach Modell merklich unterschiedliche Ergebnisse liefern, weshalb Evals (Phase 4 im Umsetzungsplan weiter unten) wichtig sind.
Modus. Copilot bietet drei eingebaute Modi, die an unterschiedlichen Punkten des Autonomiespektrums sitzen:
- Ask: eine Frage-Antwort-Pipeline (Prompt Chaining). Keine Dateibearbeitungen, keine Tool-Aufrufe, nur Reasoning über den von Ihnen bereitgestellten Kontext.
- Agent: die volle Orchestrator-Workers-Schleife. Er kann Ihre Codebasis lesen, Terminalbefehle ausführen, Abhängigkeiten installieren, Dateien anlegen und bei Fehlern eigenständig iterieren. Das ist die ReAct-Schleife in Aktion.
- Plan: ein Mittelweg. Der Agent durchdenkt die Aufgabe und erstellt einen Schritt-für-Schritt-Plan, wartet aber auf Ihre Freigabe, bevor er Änderungen ausführt. Das entspricht im Wesentlichen dem zuvor beschriebenen Muster des "Human-in-the-Loop-Checkpoints".
Der Übergang von Ask über Plan zu Agent erhöht die Flexibilität, steigert aber auch Varianz, Kosten und die Bedeutung guter Tool-Schemata. Sie können außerdem Custom Agents mit maßgeschneiderten Anweisungen und Tool-Sets definieren und so faktisch eine spezialisierte Routing-Ebene für Ihre eigenen Workflows schaffen.
Sessions. Copilot unterstützt mehrere parallel laufende Agenten-Sitzungen, jede mit eigenem Modell, eigenem Modus und eigenem Kontext. Das verwandelt das Einzelagentenmodell in ein praktisches Parallelization-Muster: Eine Sitzung kann Unit-Tests für eine Komponente schreiben, eine andere ein neues Feature umsetzen, eine weitere Dokumentation generieren, alle gleichzeitig gegen dieselbe Codebasis. Das funktioniert besonders gut in Architekturen mit klaren Modulgrenzen. In einem Django-Projekt etwa ist jede App (Authentifizierung, Abrechnung, Benachrichtigungen) weitgehend eigenständig, mit eigenen Models, Views, URLs und Tests. Sie können gefahrlos parallele Sitzungen aufsetzen, die auf verschiedene Apps zugeschnitten sind, mit minimalem Risiko von Merge-Konflikten, weil sich die Dateiflächen kaum überschneiden. Dasselbe Prinzip gilt für jede Codebasis mit klar definierten Paket- oder Servicegrenzen (Microservices, Monorepo-Pakete, Go-Module usw.). In der Praxis erlauben Ihnen parallele Sitzungen, Wanduhrzeit gegen Durchsatz zu tauschen und das, was sequenzielle Arbeit wäre, zu nebenläufiger Arbeit zu verdichten, solange die Aufgaben hinreichend isoliert sind.
Das Framework-Ökosystem
Das Ökosystem teilt sich in drei Schichten. Agenten-Frameworks sind der Ort, an dem Sie Agenten bauen. MCP ist das Protokoll, das sie mit externen Tools verbindet. Governance-Schichten verwalten Flotten von Agenten im Unternehmensmaßstab. Sie ergänzen sich, sie sind keine Alternativen.
Agenten-Frameworks
Microsoft Agent Framework
- Derzeit in der Public Preview (GitHub).
- Vereint Semantic Kernel (SK) und AutoGen unter einem einzigen Programmiermodell.
- Ergänzt typisierte, graphbasierte Workflows mit starker Beobachtbarkeit (eingebautes OpenTelemetry).
- Native Integration von MCP und dem A2A-Protokoll.
- Multi-Provider-Unterstützung: Azure OpenAI, OpenAI, Anthropic, Ollama und mehr.
- Wird mit einer Entwickler-UI (DevUI) zum Inspizieren von Agenten-Traces ausgeliefert.
OpenAI
Der Agenten-Stack von OpenAI verteilt sich über mehrere Produkte:
| Produkt | Was es ist | Veröffentlicht |
|---|---|---|
| Responses API | API-Primitive, die die Einfachheit der Chat Completions mit eingebauter Tool-Nutzung verbindet (Websuche, Dateisuche, Code Interpreter, Computer Use, Bildgenerierung). | März 2025 |
| Agents SDK | Quelloffene Python/Node-Bibliothek zum Orchestrieren von Workflows mit einem oder mehreren Agenten (Handoffs, Guardrails, Tracing). Nachfolger von Swarm. | März 2025 |
| AgentKit | Übergeordnetes Toolkit, das Agent Builder (visuelle Workflow-Leinwand), ChatKit (einbettbare Chat-UI) und Connector Registry (zentrale Verwaltung von Datenquellen) bündelt. | Oktober 2025 |
Die Agent-Platform-Seite ist OpenAIs Marketing-Dach für all das oben Genannte.
Google Agent Development Kit (ADK)
- Quelloffenes, modulares Framework, optimiert für Gemini, aber modellagnostisch.
- Unterstützt Topologien mit einem oder mehreren Agenten.
- Deployment-Ziele:
- Vertex AI Agent Engine: vollständig verwaltet, automatisch skalierend.
- Cloud Run: containerisiert, mit eigener Infrastruktur.
- GKE: Kubernetes-basiertes Deployment.
Interoperabilitätsprotokoll
MCP (Model Context Protocol)
- Offener Standard, ursprünglich von Anthropic geschaffen, inzwischen von der Linux Foundation verwaltet und offen für Beiträge der Community (Protokoll & SDKs, Server-Registry).
- Clients (Claude, ChatGPT, VS Code, JetBrains-IDEs, Cursor usw.) verbinden sich mit MCP-Servern, die Tool-Schemata bereitstellen.
- Wird rasch zur De-facto-Interoperabilitätsschicht für agentische Systeme.
- Wachsende Registry an Community- und Anbieter-Servern (GitHub, Azure DevOps, Notion, Playwright, Slack, Datenbanken usw.).
- Zentraler Nutzen: Schreiben Sie Ihre Tools einmal und stellen Sie sie jedem MCP-kompatiblen Client bereit, ohne Integrationsaufwand je Client.
- Alle drei oben genannten Frameworks unterstützen MCP nativ oder über Plugins.
Governance-Schichten
MuleSoft Agent Fabric (Salesforce)
- Unternehmens-Governance-Schicht für Agentenflotten:
- Registry: Katalog verfügbarer Agenten und Tools.
- Broker: leitet Anfragen an den richtigen Agenten.
- Policies: Zugriffskontrolle, Rate Limiting, Schutz vor Datenverlust.
- Observability: zentrales Logging und Tracing.
- Unterstützt MCP als Konnektivitätsstandard.
- Konzipiert für Organisationen, die Dutzende bis Hunderte Agenten im großen Maßstab betreiben.
Multi-Agenten-Teams
Ein wachsendes Muster sind containerisierte Agenten-Teams: Gruppen domänenspezialisierter Agenten, die unter einer gemeinsamen Governance-Hülle zusammenarbeiten:
- AgentCatalog auf Docker Hub ist ein frühes Beispiel: vorgefertigte Agenten-Images für gängige Aufgaben.
- Teams lassen sich dynamisch zusammenstellen (z. B. ein Team zur "Vertragsprüfung" mit einem Agenten zur Klauselextraktion, einem zur Risikobewertung und einem zur Zusammenfassung).
- Container-Orchestrierung (Kubernetes, Docker Compose) ermöglicht Skalierung, Versionierung und Rollback auf Agentenebene.
- Interne Governance- und Zugriffsregeln können pro Container durchgesetzt werden.
Referenzarchitekturen
| # | Architektur | Kernkomponenten |
|---|---|---|
| 1 | Azure-first, workflow-lastig | Microsoft-Agent-Framework-Orchestrator zu MCP-Server auf Azure Container Apps zu Azure-AI-Diensten |
| 2 | OpenAI-first, builder-lastig | AgentKit / Agent Builder zu Agents SDK zu MCP-Server (beliebiger Host) |
| 3 | GCP-first, ADK-zentriert | ADK-Agent auf Vertex AI Agent Engine zu MCP-Server auf Cloud Run |
| 4 | Verwaltete Flotte | MuleSoft-Agent-Fabric-Broker zu mehreren MCP-Servern zu Policy-Durchsetzungsebene |
Alle vier laufen auf MCP als Standard für die Tool-Konnektivität zusammen. Die Wahl richtet sich nach dem bestehenden Cloud-Fußabdruck, den Anbieterbeziehungen und den Governance-Anforderungen.
Von null bis zur Produktion: Ein Umsetzungsplan
Jede Phase hat ein klares Ergebnis und Ausstiegskriterien, damit Sie wissen, wann es weitergeht (oder eine Schleife zurück nötig ist).
Phase 1: Definieren Sie Ihre Tool-Oberfläche
Ziel: Entscheiden, was bereitgestellt wird, bevor Code geschrieben wird.
- Prüfen Sie die bestehenden APIs und Workflows Ihres Systems. Bestimmen Sie 3 bis 5 hochwertige Operationen, die Agenten realistischerweise aufrufen würden, z. B. Dokumente suchen, Entitäten extrahieren, einen Fallstatus prüfen, eine Zusammenfassung erstellen.
- Beantworten Sie für jede Operation:
- Was sind die Pflicht- und was die optionalen Eingaben? (Typisieren Sie sie streng.)
- Wie sieht die Ausgabe im Erfolgsfall aus? Und wie die Fehlerausgabe?
- Ist die Operation schreibgeschützt oder hat sie Nebenwirkungen?
- Schreiben Sie Tool-Schemata (JSON Schema oder Äquivalent) mit:
- Einer klaren, agentenlesbaren
description. Das sieht das LLM, um zu entscheiden, ob es das Tool aufruft. - Einem
mode-Parameter ("concise"|"detailed"), um die Ausführlichkeit der Ausgabe zu steuern. - Cursor-basierter Pagination (
cursor+limit) für Listen-Endpunkte. - Einem
truncated: true-Flag in den Antworten, damit der Agent weiß, dass er mehr abrufen muss. - Lehrenden Fehlern: Fehlermeldungen, die dem Agenten sagen, wie er den Aufruf korrigiert, nicht nur, dass er fehlschlug.
- Einer klaren, agentenlesbaren
Ergebnis: Ein Schema-Dokument (OpenAPI oder MCP-Tool-Definitionen), geprüft von mindestens einer Person, die es nicht geschrieben hat.
Ausstiegskriterium: Ein Teammitglied kann die Schemata ohne Vorwissen lesen und korrekt vorhersagen, was jedes Tool tut, welche Eingaben es braucht und wie die Ausgabe aussieht.
Phase 2: Bauen Sie den MCP-Server
Ziel: Die Schemata in einen laufenden Server verwandeln, mit dem sich jeder MCP-Client verbinden kann.
- Implementieren Sie jedes Tool hinter einem MCP-konformen Server (TypeScript- oder Python-SDK).
- Wählen Sie den Transport nach Anwendungsfall:
| Transport | Wann einsetzen |
|---|---|
| stdio | Lokale Entwicklung, IDE-Integrationen (VS Code, Cursor) |
| Streamable HTTP | Remote- / cloud-gehostetes Deployment, mandantenfähige Szenarien |
- Bauen Sie Sicherheit von Tag eins an ein:
- Tools mit Nebenwirkungen müssen einen
dry_run-Modus (gibt zurück, was passieren würde) und einencommit-Modus (führt die Aktion aus) unterstützen. - Destruktive Operationen erfordern einen Schritt zur menschlichen Bestätigung, bevor
commitfortfährt.
- Tools mit Nebenwirkungen müssen einen
- Validieren Sie die Interoperabilität mit mindestens zwei MCP-Clients (z. B. Claude Desktop + VS Code Copilot). Wenn beide jedes Tool entdecken und korrekt aufrufen können, ist der Server bereit.
Ergebnis: Ein bereitgestellter (oder lokal lauffähiger) MCP-Server mit bestandenen Integrationstests gegen zwei Clients.
Ausstiegskriterium: Beide Clients können eine realistische, mehrstufige Aufgabe durchgängig erledigen, allein mit den bereitgestellten Tools.
Phase 3: Schließen Sie ein Agenten-Framework an
Ziel: Beweisen, dass der MCP-Server mit einem echten Agenten funktioniert. Wählen Sie zu Beginn ein Framework.
Wählen Sie das Framework, das zum Stack Ihres Teams passt:
| Wenn Ihr Stack … ist | Beginnen Sie mit … |
|---|---|
| Azure / .NET | Microsoft Agent Framework |
| OpenAI-lastig / Python | Agents SDK + Agent Builder |
| GCP / Gemini | Google ADK auf Vertex AI Agent Engine |
Bauen Sie zwei Dinge:
- Einen deterministischen Workflow: eine feste Folge von Tool-Aufrufen (z. B. "suchen, extrahieren, zusammenfassen"). Das validiert, dass die Tools korrekt zusammenspielen.
- Einen freien Agenten: dieselben Tools, aber das LLM entscheidet den Plan zur Laufzeit. Das prüft Ihre Schemata unter Belastung: Wählt der Agent das falsche Tool oder übergibt schlechte Eingaben, müssen Sie an Ihren Beschreibungen oder Fehlermeldungen arbeiten.
Optional wiederholen Sie es mit einem zweiten Framework, um zu bestätigen, dass der MCP-Server wirklich framework-agnostisch ist.
Ergebnis: Ein funktionierender Agent (Workflow + frei), der mit dem MCP-Server echte Aufgaben erledigt.
Ausstiegskriterium: Der Agent erledigt mindestens 80% der Testaufgaben ohne menschliches Eingreifen.
Phase 4: Bewerten und iterieren
Ziel: Messen, wie gut Agenten Ihre Tools nutzen, und beheben, was kaputt ist.
- Erstellen Sie 10 bis 20 realistische Aufgaben mit erwarteten Ground-Truth-Ausgaben (z. B. "Finde alle in Q2 auslaufenden Verträge und fasse die wichtigsten Pflichten zusammen").
- Lassen Sie jede Aufgabe sowohl durch den Workflow als auch durch den freien Agenten laufen. Erfassen Sie bei jedem Durchlauf:
| Metrik | Warum sie wichtig ist |
|---|---|
| Erfolgsrate | Hat der Agent die richtige Antwort erreicht? |
| Anzahl der Tool-Aufrufe | Überzählige Aufrufe deuten auf ein verwirrendes Schema hin |
| Token-Verbrauch | Stellvertreter für Kosten |
| Latenz | Durchgängig und je Tool |
| Fehlerrate nach Kategorie | Deckt systematische Probleme im Tool-Design auf |
- Triagieren Sie Fehlschläge:
- Falsches Tool gewählt: verbessern Sie die
descriptiondes Tools. - Falsche Parameter: verschärfen Sie das Schema, fügen Sie
enum-Beschränkungen hinzu, verbessern Sie die Fehlerhinweise. - Korrekter Aufruf, falsche Interpretation des Ergebnisses: vereinfachen Sie das Ausgabeformat oder fügen Sie ein
summary-Feld hinzu.
- Falsches Tool gewählt: verbessern Sie die
- Lassen Sie die Eval-Suite nach jeder Korrektur erneut laufen. Verfolgen Sie die Verbesserung über die Iterationen.
Ergebnis: Eine Eval-Suite (automatisiert, wiederholbar) und ein Protokoll der Schema-Änderungen mit Erfolgsraten vor und nach.
Ausstiegskriterium: Mindestens 90% Erfolgsrate auf der Eval-Suite mit beiden Agentenmodi.
Phase 5: Härten und skalieren
Ziel: Auf Produktionslast und organisationsweiten Rollout vorbereiten.
- Observability. Instrumentieren Sie den MCP-Server mit verteiltem Tracing (OpenTelemetry) und strukturiertem Logging. Jeder Tool-Aufruf sollte von der Client-Anfrage bis zum Backend-System nachvollziehbar sein.
- Rate Limiting und Zugriffskontrolle. Entscheiden Sie, wer (welche Agenten, welche Nutzer) welche Tools aufrufen darf und mit welchem Durchsatz.
- Governance im großen Maßstab. Wenn Sie mehrere MCP-Server oder Agenten-Teams erwarten, führen Sie eine Broker-/Fabric-Schicht ein (z. B. MuleSoft Agent Fabric) für:
- Zentrale Durchsetzung von Policies.
- Audit-Logging (wer rief was, wann, mit welchen Eingaben).
- Überwachung auf Flottenebene und Not-Aus-Schalter.
- Dokumentation. Veröffentlichen Sie einen Tool-Katalog (menschenlesbare Beschreibungen, Beispielaufrufe, bekannte Einschränkungen), damit andere Teams Agenten gegen Ihren MCP-Server bauen können, ohne ihn rückentwickeln zu müssen.
Ergebnis: Ein produktionsreifer MCP-Server mit Monitoring-Dashboards, Zugriffsregeln und einem veröffentlichten Tool-Katalog.
Ausstiegskriterium: Ein Team, das nicht am Bau des Servers beteiligt war, kann allein anhand des Katalogs und der öffentlichen Schemata einen neuen Agenten dagegen aufsetzen.
Fragen, die dieser Artikel beantwortet
Was ist der Unterschied zwischen einem KI-Agenten und einem Workflow?
Der Kontrollfluss. Ein Workflow führt einen fest verdrahteten DAG aus und ist damit vorhersagbar und unkompliziert zu auditieren, während ein Agent das LLM den Weg zur Laufzeit entscheiden lässt, was Flexibilität bringt, aber höhere Varianz und Tracing erfordert. Beide gehören zur selben Familie der agentischen Systeme, und Produktionssysteme mischen sie in der Regel, mit deterministischen Schritten dort, wo der Prozess bekannt ist, und Agenten für die offenen Teilaufgaben. Die Faustregel von Anthropic gilt weiterhin: Beginnen Sie mit dem einfachsten Muster, das das Problem löst, und steigen Sie erst dann auf, wenn die Aufgabe wirklich dynamische Entscheidungen verlangt.
Warum ruft mein Agent ständig das falsche Tool auf?
Meist liegt es an der Beschreibung, nicht am Modell. Der Agent liest nur Name, Beschreibung und Schema eines Tools, um zu entscheiden, ob und wie er es aufruft, deshalb führen unklare Signale zur Wahl des falschen Tools, zu fehlerhaften Eingaben oder zu falsch gelesenen Ausgaben, die nachgelagert zu Halluzinationen werden. Die Triage ist eindeutig: falsches Tool gewählt heißt Beschreibung verbessern; falsche Parameter heißen Schema verschärfen, enum-Beschränkungen ergänzen und Fehlermeldungen schreiben, die sagen, wie der Aufruf zu korrigieren ist; ein korrekter, aber falsch gedeuteter Aufruf heißt Ausgabeformat vereinfachen oder ein summary-Feld ergänzen.
Ist MCP nicht nur eine weitere Hülle um die APIs, die ich schon habe?
Es ist eine Hülle mit einem konkreten Gewinn: Sie schreiben das Tool einmal und jeder MCP-kompatible Client kann es nutzen, ohne Integrationsaufwand je Client. Zu den Clients zählen bereits Claude, ChatGPT, VS Code, die JetBrains-IDEs und Cursor, und das Microsoft Agent Framework, der OpenAI-Stack und Google ADK unterstützen MCP nativ oder über Plugins. Es ist ein offener Standard, ursprünglich von Anthropic geschaffen und inzwischen von der Linux Foundation verwaltet, die Einführung ist also keine Wette auf einen einzelnen Anbieter.
Woran erkenne ich, dass mein MCP-Server wirklich produktionsreif ist?
Nutzen Sie die Ausstiegskriterien der einzelnen Phasen statt eines Bauchgefühls. Zwei verschiedene MCP-Clients, etwa Claude Desktop und VS Code Copilot, sollten je eine realistische, mehrstufige Aufgabe durchgängig allein mit Ihren Tools erledigen; der freie Agent sollte mindestens 80% der Testaufgaben ohne menschliches Eingreifen schaffen und mindestens 90% einer Eval-Suite aus 10 bis 20 realistischen Aufgaben. Die letzte Hürde ist nicht technisch: Ein Team, das mit dem Bau des Servers nichts zu tun hatte, sollte allein anhand des veröffentlichten Katalogs und der Schemata einen neuen Agenten dagegen aufsetzen können.
Weiterlesen
 AI Agents
Ich habe eine KI-Schicht gebaut, die nie antwortet. Was eine gute Frage wirklich braucht
Feldnotizen zu OrbitSpec, einer Klärungs-Engine, die vage Anfragen in typisierte, auditierbare Context Bundles verwandelt, bevor irgendein Modell läuft, und warum Zuverlässigkeit vor der Antwort beginnt. AI Agents
Ich habe die Pipeline gebaut, die mein Produkt gebaut hat. Was Delegieren wirklich verlangt
Feldnotizen zu plan-to-pr, einer Pipeline, die aus einem Feature-Wunsch Tickets, ein Freigabe-Gate und Draft Pull Requests macht, und warum Delegieren an Coding-Agents Artefakte braucht, keinen Chat.