
Agenti IA, MCP e il panorama dei framework moderni
Ascolta l'articolo (sperimentale) · 19:19
Come funzionano gli agenti IA
Un agente IA è un sistema guidato da un LLM che opera in un ciclo:
- Pianificare: scomporre un obiettivo in sotto-attività.
- Agire: selezionare e invocare uno o più strumenti.
- Osservare: leggere i risultati degli strumenti e aggiornare lo stato interno.
- Iterare: ripetere finché l'obiettivo non è raggiunto o non si verifica una condizione di arresto.
L'esempio più fondamentale di questo ciclo è ReAct (Reasoning + Acting). Introdotto da Yao et al. nel 2022, ReAct intreccia tracce di ragionamento chain-of-thought con passi di azione. L'agente ragiona ad alta voce su cosa fare, chiama uno strumento, osserva il risultato e ragiona di nuovo. È di fatto l'"Hello World" delle architetture ad agenti: quasi ogni framework moderno (LangChain, Semantic Kernel, ADK, Agents SDK) offre un ciclo in stile ReAct come modalità agente predefinita. Comprendere ReAct è il prerequisito per comprendere tutto il resto di questo articolo.
Facoltativamente, gli agenti integrano la memoria (contesto a breve e lungo termine) e checkpoint human-in-the-loop per le decisioni critiche per la sicurezza.
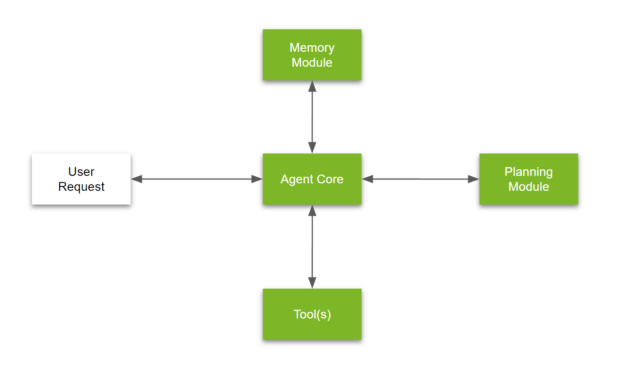
La decomposizione canonica di NVIDIA resta un modello mentale utile:
| Componente | Ruolo |
|---|---|
| Agent Core | Motore di ragionamento LLM che guida il ciclo |
| Memory Module | Conserva il contesto tra turni e sessioni |
| Tools | Capacità esterne che l'agente può invocare |
| Planning Module | Selezione della strategia, scomposizione delle attività, ri-pianificazione |
Agenti vs. workflow (la distinzione di Anthropic)
| Dimensione | Workflow | Agenti |
|---|---|---|
| Flusso di controllo | DAG hard-coded | Deciso dall'LLM a runtime |
| Prevedibilità | Alta | Più bassa, con maggiore varianza |
| Verificabilità | Immediata | Richiede tracing |
| Quando usarli | Processi noti e ripetibili | Attività aperte o esplorative |
Entrambi appartengono alla stessa famiglia di sistemi agentici. I sistemi in produzione spesso combinano passi di workflow deterministici con sotto-attività guidate da agenti dove serve flessibilità.
Gli strumenti sono contratti semantici
Gli strumenti sono contratti semantici. Un agente legge il nome, la descrizione e lo schema di uno strumento per decidere se e come chiamarlo. Se uno qualsiasi di questi segnali è vago, l'agente potrebbe:
- Chiamare lo strumento sbagliato.
- Passare input malformati.
- Interpretare male gli output e produrre allucinazioni a valle.
La ricerca di Anthropic sulla scrittura di strumenti per agenti mostra che trattare gli strumenti come prodotti rivolti agli sviluppatori migliora in modo misurabile i tassi di completamento e riduce lo spreco di token:
| Principio | Cosa significa in pratica |
|---|---|
| Schemi rigorosi | Input/output tipizzati con campi obbligatori e facoltativi chiaramente indicati |
| Troncamento utile | I payload di grandi dimensioni vengono riassunti; i chiamanti possono richiedere il dettaglio su richiesta |
| Suggerimenti di errore chiari | I messaggi di errore dicono all'agente cosa fare dopo, non solo cosa è fallito |
| Namespacing | Nomi degli strumenti ricondotti a un dominio (es. legal.searchCases) per evitare collisioni |
| Paginazione | Set di risultati limitati con cursori, per prevenire l'overflow della finestra di contesto |
| Valutazioni | Suite di test automatizzati che misurano il tasso di successo dell'agente per strumento |
Pattern: dai workflow alla piena autonomia
Questi pattern si collocano su uno spettro che va dal completamente deterministico al completamente autonomo. Scegli in base al livello di controllo e di varianza richiesto dal tuo caso d'uso:
| Pattern | Descrizione | Livello di controllo |
|---|---|---|
| Prompt Chaining | Sequenza di chiamate LLM; l'output di ogni passo alimenta il successivo. Quality gate facoltativi tra i passi. | Alto |
| Routing | Un classificatore indirizza l'input verso prompt o set di strumenti specializzati. | Alto |
| Parallelization | Più chiamate LLM vengono eseguite in concorrenza, tramite sectioning (suddivisione dell'attività) o voting (stessa attività, consenso). | Medio |
| Orchestrator-Workers | Un agente manager scompone dinamicamente un'attività, la delega ad agenti worker e sintetizza i risultati. | Medio-basso |
| Evaluator-Optimizer | Un agente genera; un altro critica; il ciclo affina finché non vengono soddisfatti i criteri di qualità. | Basso |
Regola pratica (Anthropic): Inizia con il pattern più semplice che risolve il problema. Passa a cicli agente completi solo quando l'attività richiede davvero un processo decisionale dinamico.
Esempio reale: GitHub Copilot in VS Code
L'agente di coding di GitHub Copilot in VS Code è una buona illustrazione di come questi pattern si combinano in un prodotto reale:
- Routing. Quando scrivi un messaggio, Copilot classifica l'intento: si tratta di un completamento inline, di una domanda in chat o di una modifica multi-file? Ognuno viene instradato verso una pipeline diversa.
- Orchestrator-Workers. In modalità agente, Copilot riceve un'attività di alto livello (es. "aggiungi la validazione dell'input al modulo di registrazione"), la suddivide in sotto-attività e delega ciascuna a chiamate di strumenti specializzati: leggere file, fare grep di simboli, eseguire comandi da terminale, applicare modifiche, eseguire test.
- Evaluator-Optimizer. Dopo aver apportato le modifiche, l'agente esegue linter, test o type-checker. Se qualcosa fallisce, legge l'output dell'errore, ragiona sulla correzione e itera in un ciclo di generazione, valutazione e affinamento.
- Prompt Chaining con gate. L'output di ogni passo fa da gate al successivo. Se la lettura di un file restituisce contenuti inattesi, l'agente ri-pianifica invece di procedere alla cieca.
Sotto il cofano, questo è un ciclo ReAct supportato da un'integrazione di strumenti in stile MCP: Copilot scopre gli strumenti disponibili (file system, terminale, ricerca, API dell'editor), li chiama tramite schemi strutturati, osserva i risultati e ragiona sui passi successivi. È un esempio concreto di un sistema in produzione che fonde workflow deterministici con la flessibilità guidata dall'agente.
Copilot ti permette anche di scambiare due leve chiave che influiscono direttamente sul comportamento:
Modello. Passare, ad esempio, da GPT-4o a Claude Sonnet o Gemini cambia il motore di ragionamento. Modelli diversi hanno punti di forza diversi: alcuni sono migliori nel pianificare modifiche multi-step, altri nel seguire le istruzioni con precisione, altri ancora nel ridurre al minimo le allucinazioni. Gli stessi strumenti e lo stesso prompt possono produrre risultati sensibilmente diversi a seconda del modello, ed è per questo che le eval (Fase 4 nel piano di implementazione qui sotto) contano.
Modalità. Copilot offre tre modalità integrate che si collocano in punti diversi dello spettro dell'autonomia:
- Ask: una pipeline domanda-risposta (prompt chaining). Nessuna modifica ai file, nessuna chiamata a strumenti, solo ragionamento sul contesto che fornisci.
- Agent: il ciclo orchestrator-workers completo. Può leggere il tuo codice, eseguire comandi da terminale, installare dipendenze, creare file e iterare in autonomia sui fallimenti. Questo è il ciclo ReAct in azione.
- Plan: una via di mezzo. L'agente ragiona sull'attività e produce un piano passo per passo, ma attende la tua approvazione prima di eseguire qualsiasi modifica. Questo è in sostanza il pattern del "checkpoint human-in-the-loop" descritto prima.
Passare da Ask a Plan ad Agent aumenta la flessibilità, ma aumenta anche la varianza, il costo e l'importanza di buoni schemi degli strumenti. Puoi anche definire Custom Agent con istruzioni e set di strumenti su misura, creando di fatto un livello di routing specializzato per i tuoi workflow.
Sessioni. Copilot supporta l'esecuzione di più sessioni agente in parallelo, ognuna con il proprio modello, modalità e contesto. Questo trasforma il modello a singolo agente in un pattern di parallelization pratico: puoi avere una sessione che scrive test unitari per un componente, un'altra che implementa una nuova funzionalità, un'altra che genera documentazione, tutte in esecuzione in concorrenza sullo stesso codice. Funziona particolarmente bene nelle architetture con confini di modulo netti. In un progetto Django, ad esempio, ogni app (autenticazione, fatturazione, notifiche) è in gran parte indipendente, con i propri modelli, viste, URL e test. Puoi tranquillamente avviare sessioni parallele circoscritte ad app diverse con un rischio minimo di conflitti di merge, perché le superfici dei file si sovrappongono a malapena. Lo stesso principio vale per qualsiasi codice con confini di package o servizio ben definiti (microservizi, package monorepo, moduli Go, ecc.). In pratica, le sessioni parallele ti permettono di scambiare tempo di calendario con throughput, comprimendo in lavoro concorrente ciò che sarebbe lavoro sequenziale, purché le attività siano sufficientemente isolate.
L'ecosistema dei framework
L'ecosistema si divide in tre livelli. I framework per agenti sono dove costruisci gli agenti. MCP è il protocollo che li connette a strumenti esterni. I livelli di governance gestiscono flotte di agenti su scala aziendale. Sono complementari, non alternativi.
Framework per agenti
Microsoft Agent Framework
- Attualmente in public preview (GitHub).
- Unifica Semantic Kernel (SK) e AutoGen sotto un unico modello di programmazione.
- Aggiunge workflow tipizzati e basati su grafi con forte osservabilità (OpenTelemetry integrato).
- Integrazione nativa dei protocolli MCP e A2A.
- Supporto multi-provider: Azure OpenAI, OpenAI, Anthropic, Ollama e altri.
- Include una UI per sviluppatori (DevUI) per ispezionare le tracce degli agenti.
OpenAI
Lo stack per agenti di OpenAI è distribuito su diversi prodotti:
| Prodotto | Cos'è | Lancio |
|---|---|---|
| Responses API | Primitiva API che combina la semplicità delle Chat Completions con l'uso integrato di strumenti (ricerca web, ricerca file, code interpreter, computer use, generazione di immagini). | Marzo 2025 |
| Agents SDK | Libreria Python/Node open-source per orchestrare workflow a singolo e multi-agente (handoff, guardrail, tracing). Successore di Swarm. | Marzo 2025 |
| AgentKit | Toolkit di più alto livello che raggruppa Agent Builder (canvas visuale per workflow), ChatKit (UI di chat integrabile) e Connector Registry (gestione centralizzata delle sorgenti dati). | Ottobre 2025 |
La pagina Agent Platform è l'ombrello di marketing di OpenAI per tutto quanto sopra.
Google Agent Development Kit (ADK)
- Framework open-source e modulare, ottimizzato per Gemini ma agnostico rispetto al modello.
- Supporta topologie a singolo agente e multi-agente.
- Target di deployment:
- Vertex AI Agent Engine: completamente gestito, con auto-scaling.
- Cloud Run: containerizzato, infrastruttura BYO.
- GKE: deployment basato su Kubernetes.
Protocollo di interoperabilità
MCP (Model Context Protocol)
- Standard aperto creato originariamente da Anthropic, ora governato dalla The Linux Foundation e aperto ai contributi della community (protocollo e SDK, registro dei server).
- I client (Claude, ChatGPT, VS Code, IDE JetBrains, Cursor, ecc.) si collegano a server MCP che espongono schemi di strumenti.
- Sta rapidamente diventando il livello di interoperabilità de facto per i sistemi agentici.
- Registro in crescita di server della community e dei vendor (GitHub, Azure DevOps, Notion, Playwright, Slack, database, ecc.).
- Valore chiave: scrivi i tuoi strumenti una volta, esponili a qualsiasi client compatibile con MCP, senza lavoro di integrazione per ogni client.
- Tutti e tre i framework sopra supportano MCP nativamente o tramite plugin.
Livelli di governance
MuleSoft Agent Fabric (Salesforce)
- Livello di governance aziendale per flotte di agenti:
- Registry: catalogo degli agenti e degli strumenti disponibili.
- Broker: instrada le richieste verso l'agente giusto.
- Policies: controllo degli accessi, rate limiting, prevenzione della perdita di dati.
- Observability: logging e tracing centralizzati.
- Supporta MCP come standard di connettività.
- Progettato per organizzazioni che gestiscono da decine a centinaia di agenti su scala.
Team multi-agente
Un pattern in crescita sono i team di agenti containerizzati: gruppi di agenti specializzati per dominio che collaborano sotto un involucro di governance condiviso:
- AgentCatalog su Docker Hub è un primo esempio: immagini di agenti pre-costruite per attività comuni.
- I team possono essere composti dinamicamente (es. un team di "revisione contratti" con un agente per l'estrazione delle clausole, un agente per il punteggio di rischio e un agente per la sintesi).
- L'orchestrazione dei container (Kubernetes, Docker Compose) abilita scalabilità, versioning e rollback a livello di agente.
- Le policy di governance e di accesso interne possono essere applicate per ciascun container.
Architetture di riferimento
| # | Architettura | Componenti chiave |
|---|---|---|
| 1 | Azure-first, orientata ai workflow | Orchestratore Microsoft Agent Framework verso server MCP su Azure Container Apps verso servizi Azure AI |
| 2 | OpenAI-first, orientata al builder | AgentKit / Agent Builder verso Agents SDK verso server MCP (qualsiasi host) |
| 3 | GCP-first, centrata su ADK | Agente ADK su Vertex AI Agent Engine verso server MCP su Cloud Run |
| 4 | Flotta governata | Broker MuleSoft Agent Fabric verso più server MCP verso livello di applicazione delle policy |
Tutte e quattro convergono su MCP come standard di connettività degli strumenti. La scelta è guidata dall'impronta cloud esistente, dalle relazioni con i vendor e dai requisiti di governance.
Da zero alla produzione: un piano di implementazione
Ogni fase ha un deliverable chiaro e criteri di uscita, così sai quando passare alla successiva (o tornare indietro).
Fase 1: Definisci la tua superficie di strumenti
Obiettivo: Decidere cosa esporre prima di scrivere qualsiasi riga di codice.
- Esamina le API e i workflow esistenti del tuo sistema. Individua da 3 a 5 operazioni di alto valore che gli agenti chiamerebbero realisticamente, es. cercare documenti, estrarre entità, controllare lo stato di un caso, generare una sintesi.
- Per ogni operazione, rispondi:
- Quali sono gli input obbligatori e quali quelli facoltativi? (Tipizzali in modo rigoroso.)
- Com'è l'output del percorso felice? E l'output di errore?
- L'operazione è read-only oppure ha effetti collaterali?
- Scrivi gli schemi degli strumenti (JSON Schema o equivalente) con:
- Una
descriptionchiara e leggibile dall'agente. È ciò che l'LLM vede per decidere se chiamare lo strumento. - Un parametro
mode("concise"|"detailed") per controllare la verbosità dell'output. - Paginazione basata su cursore (
cursor+limit) per gli endpoint che restituiscono liste. - Un flag
truncated: truenelle risposte, così l'agente sa di dover recuperare altri dati. - Errori che insegnano: messaggi di errore che dicono all'agente come correggere la chiamata, non solo che è fallita.
- Una
Deliverable: Un documento di schemi (OpenAPI o definizioni di strumenti MCP) rivisto da almeno una persona che non lo ha scritto.
Criteri di uscita: Un collega può leggere gli schemi a freddo e prevedere correttamente cosa fa ogni strumento, quali input richiede e com'è l'output.
Fase 2: Costruisci il server MCP
Obiettivo: Trasformare gli schemi in un server in esecuzione a cui qualsiasi client MCP possa connettersi.
- Implementa ogni strumento dietro un server conforme a MCP (SDK TypeScript o Python).
- Scegli il transport in base al caso d'uso:
| Transport | Quando usarlo |
|---|---|
| stdio | Sviluppo locale, integrazioni con IDE (VS Code, Cursor) |
| Streamable HTTP | Deployment remoto / in cloud, scenari multi-tenant |
- Integra la sicurezza fin dal primo giorno:
- Gli strumenti con effetti collaterali devono supportare una modalità
dry_run(restituisce ciò che accadrebbe) e una modalitàcommit(esegue l'azione). - Le operazioni distruttive richiedono un passo di conferma umana prima che
commitproceda.
- Gli strumenti con effetti collaterali devono supportare una modalità
- Verifica l'interoperabilità con almeno due client MCP (es. Claude Desktop + VS Code Copilot). Se entrambi riescono a scoprire e chiamare correttamente ogni strumento, il server è pronto.
Deliverable: Un server MCP distribuito (o eseguibile in locale) con test di integrazione superati su due client.
Criteri di uscita: Entrambi i client riescono a completare un'attività realistica multi-step da capo a fine usando solo gli strumenti esposti.
Fase 3: Connetti un framework per agenti
Obiettivo: Dimostrare che il server MCP funziona con un agente reale. Scegli un framework per iniziare.
Scegli il framework che corrisponde allo stack del tuo team:
| Se il tuo stack è… | Inizia con… |
|---|---|
| Azure / .NET | Microsoft Agent Framework |
| Orientato a OpenAI / Python | Agents SDK + Agent Builder |
| GCP / Gemini | Google ADK su Vertex AI Agent Engine |
Costruisci due cose:
- Un workflow deterministico: una sequenza fissa di chiamate a strumenti (es. "cerca, estrai, sintetizza"). Questo verifica che gli strumenti si compongano correttamente.
- Un agente a forma libera: gli stessi strumenti, ma è l'LLM a decidere il piano a runtime. Questo mette sotto stress i tuoi schemi: se l'agente sceglie lo strumento sbagliato o passa input errati, le tue descrizioni o i messaggi di errore vanno migliorati.
Facoltativamente, ripeti con un secondo framework per confermare che il server MCP sia davvero agnostico rispetto al framework.
Deliverable: Un agente funzionante (workflow + forma libera) che completa attività reali usando il server MCP.
Criteri di uscita: L'agente completa ≥ 80% delle attività di test senza intervento umano.
Fase 4: Valuta e itera
Obiettivo: Misurare quanto bene gli agenti usano i tuoi strumenti e correggere ciò che non funziona.
- Crea da 10 a 20 attività realistiche con output ground-truth attesi (es. "Trova tutti i contratti in scadenza nel Q2 e sintetizza gli obblighi principali").
- Esegui ogni attività sia attraverso il workflow sia attraverso l'agente a forma libera. Per ogni esecuzione, registra:
| Metrica | Perché conta |
|---|---|
| Tasso di successo | L'agente ha raggiunto la risposta corretta? |
| Numero di chiamate a strumenti | Chiamate in eccesso segnalano uno schema confuso |
| Uso di token | Indicatore del costo |
| Latenza | End-to-end e per singolo strumento |
| Tasso di errore per categoria | Rivela problemi sistematici di progettazione degli strumenti |
- Esegui il triage dei fallimenti:
- Strumento sbagliato selezionato: migliora la
descriptiondello strumento. - Parametri sbagliati: irrigidisci lo schema, aggiungi vincoli
enum, migliora i suggerimenti di errore. - Chiamata corretta, interpretazione sbagliata del risultato: semplifica il formato di output o aggiungi un campo
summary.
- Strumento sbagliato selezionato: migliora la
- Riesegui la suite di eval dopo ogni correzione. Traccia il miglioramento tra le iterazioni.
Deliverable: Una suite di eval (automatizzata, rieseguibile) e un registro delle modifiche agli schemi con i tassi di successo prima/dopo.
Criteri di uscita: Tasso di successo ≥ 90% sulla suite di eval con entrambe le modalità agente.
Fase 5: Irrobustisci e scala
Obiettivo: Prepararsi al traffico di produzione e al rollout organizzativo.
- Observability. Strumenta il server MCP con tracing distribuito (OpenTelemetry) e logging strutturato. Ogni chiamata a uno strumento dovrebbe essere tracciabile dalla richiesta del client fino al sistema di backend.
- Rate limiting e controllo degli accessi. Decidi chi (quali agenti, quali utenti) può chiamare quali strumenti, e con quale throughput.
- Governance su scala. Se prevedi più server MCP o team di agenti, adotta un livello broker/fabric (es. MuleSoft Agent Fabric) per:
- Applicazione centralizzata delle policy.
- Audit logging (chi ha chiamato cosa, quando, con quali input).
- Monitoraggio a livello di flotta e kill-switch.
- Documentazione. Pubblica un catalogo degli strumenti (descrizioni leggibili, esempi di chiamate, limitazioni note) così altri team possono costruire agenti contro il tuo server MCP senza doverlo decodificare.
Deliverable: Un server MCP pronto per la produzione, con dashboard di monitoraggio, policy di accesso e un catalogo di strumenti pubblicato.
Criteri di uscita: Un team che non è stato coinvolto nella costruzione del server riesce a mettere in piedi un nuovo agente contro di esso usando solo il catalogo e gli schemi pubblici.
Le domande a cui questo articolo risponde
Qual è la differenza tra un agente IA e un workflow?
Il flusso di controllo. Un workflow esegue un DAG hard-coded, quindi è prevedibile e di verifica immediata, mentre un agente lascia che sia l'LLM a decidere il percorso a runtime, cosa che dà flessibilità al prezzo di una varianza maggiore e della necessità di tracing. Entrambi appartengono alla stessa famiglia dei sistemi agentici e i sistemi in produzione di solito li mescolano, tenendo i passi deterministici dove il processo è noto e affidando agli agenti le sotto-attività aperte. La regola pratica di Anthropic resta valida: inizia con il pattern più semplice che risolve il problema e passa oltre solo quando l'attività richiede davvero un processo decisionale dinamico.
Perché il mio agente chiama sempre lo strumento sbagliato?
Di solito la colpa è della descrizione, non del modello. L'agente legge solo il nome, la descrizione e lo schema di uno strumento per decidere se e come chiamarlo, quindi segnali vaghi producono la scelta dello strumento sbagliato, input malformati oppure output letti male che a valle diventano allucinazioni. Il triage è diretto: strumento sbagliato selezionato vuol dire migliorare la descrizione; parametri sbagliati vogliono dire irrigidire lo schema, aggiungere vincoli enum e scrivere messaggi di errore che spieghino come correggere la chiamata; una chiamata corretta ma interpretata male vuol dire semplificare il formato di output o aggiungere un campo summary.
MCP non è solo l'ennesimo livello sopra le API che ho già?
È un livello con un vantaggio preciso: scrivi lo strumento una volta e qualsiasi client compatibile con MCP può usarlo, senza lavoro di integrazione per ogni client. Tra i client ci sono già Claude, ChatGPT, VS Code, gli IDE JetBrains e Cursor, e Microsoft Agent Framework, lo stack OpenAI e Google ADK lo supportano nativamente o tramite plugin. È uno standard aperto creato da Anthropic e oggi governato dalla The Linux Foundation, quindi adottarlo non è una scommessa su un singolo vendor.
Come faccio a sapere se il mio server MCP è davvero pronto per la produzione?
Usa i criteri di uscita di ogni fase invece di una sensazione. Due client MCP diversi, per esempio Claude Desktop e VS Code Copilot, devono completare ciascuno da capo a fine un'attività realistica multi-step usando solo i tuoi strumenti; l'agente a forma libera deve chiudere almeno l'80% delle attività di test senza intervento umano e almeno il 90% di una suite di eval da 10 a 20 attività realistiche. L'ultimo criterio non è tecnico: un team che non è stato coinvolto nella costruzione del server deve riuscire a mettere in piedi un nuovo agente usando solo il catalogo pubblicato e gli schemi.
Da leggere dopo
 AI Agents
Ho costruito un livello AI che non risponde mai. Ecco cosa serve davvero a una buona domanda
Appunti dal campo su OrbitSpec, un motore di chiarimento che trasforma richieste vaghe in Context Bundle tipizzati e verificabili prima che qualsiasi modello giri, e perché l'affidabilità comincia prima della risposta. AI Agents
Ho costruito la pipeline che ha costruito il mio prodotto. Ecco cosa serve davvero per delegare
Appunti dal campo su plan-to-pr, una pipeline che trasforma una richiesta di funzionalità in ticket, un gate di approvazione e pull request in bozza, e perché delegare agli agenti di coding richiede artefatti, non chat.