
Agentes de IA, MCP y el panorama moderno de frameworks
Escuchar el artículo (experimental) · 20:04
Cómo funcionan los agentes de IA
Un agente de IA es un sistema impulsado por un LLM que opera en bucle:
- Planificar: descomponer un objetivo en subtareas.
- Actuar: seleccionar e invocar una o varias herramientas.
- Observar: leer los resultados de las herramientas y actualizar el estado interno.
- Iterar: repetir hasta alcanzar el objetivo o llegar a una condición de parada.
El ejemplo más fundamental de este bucle es ReAct (Reasoning + Acting). Presentado por Yao et al. en 2022, ReAct intercala trazas de razonamiento en cadena de pensamiento con pasos de acción. El agente piensa en voz alta sobre qué hacer, llama a una herramienta, observa el resultado y vuelve a razonar. Es, en la práctica, el "Hola Mundo" de las arquitecturas de agentes: casi todos los frameworks modernos (LangChain, Semantic Kernel, ADK, Agents SDK) incorporan un bucle de estilo ReAct como su modo de agente por defecto. Entender ReAct es el requisito previo para entender todo lo demás de este artículo.
Opcionalmente, los agentes incorporan memoria (contexto a corto y largo plazo) y puntos de control con intervención humana para decisiones críticas en cuanto a seguridad.
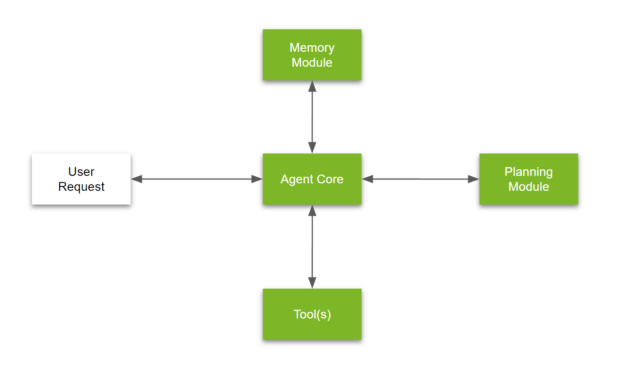
La descomposición canónica de NVIDIA sigue siendo un modelo mental útil:
| Componente | Función |
|---|---|
| Núcleo del agente | Motor de razonamiento LLM que impulsa el bucle |
| Módulo de memoria | Conserva el contexto entre turnos y sesiones |
| Herramientas | Capacidades externas que el agente puede invocar |
| Módulo de planificación | Selección de estrategia, descomposición de tareas, replanificación |
Agentes frente a workflows (la distinción de Anthropic)
| Dimensión | Workflows | Agentes |
|---|---|---|
| Flujo de control | DAG codificado a mano | Decidido por el LLM en tiempo de ejecución |
| Previsibilidad | Alta | Más baja, con mayor varianza |
| Auditabilidad | Directa | Requiere trazabilidad |
| Cuándo usarlos | Procesos conocidos y repetibles | Tareas abiertas o exploratorias |
Ambos pertenecen a la misma familia de sistemas agénticos. Los sistemas en producción a menudo combinan pasos de workflow deterministas con subtareas impulsadas por agentes allí donde hace falta flexibilidad.
Las herramientas son contratos semánticos
Las herramientas son contratos semánticos. Un agente lee el nombre, la descripción y el esquema de una herramienta para decidir si y cómo llamarla. Si cualquiera de esas señales es vaga, el agente puede:
- Llamar a la herramienta equivocada.
- Pasar entradas mal formadas.
- Malinterpretar las salidas y alucinar más adelante.
La investigación de Anthropic sobre cómo escribir herramientas para agentes demuestra que tratar las herramientas como productos orientados al desarrollador mejora de forma medible las tasas de finalización y reduce el desperdicio de tokens:
| Principio | Qué significa en la práctica |
|---|---|
| Esquemas estrictos | Entradas/salidas tipadas con los campos obligatorios y opcionales claramente marcados |
| Truncado útil | Las cargas grandes se resumen; quien las consume puede pedir detalle bajo demanda |
| Pistas de error claras | Los mensajes de error le dicen al agente qué hacer a continuación, no solo qué falló |
| Espacios de nombres | Nombres de herramientas acotados a un dominio (p. ej., legal.searchCases) para evitar colisiones |
| Paginación | Conjuntos de resultados acotados con cursores, que evitan desbordar la ventana de contexto |
| Evaluaciones | Suites de pruebas automatizadas que miden la tasa de éxito del agente por herramienta |
Patrones: de los workflows a la autonomía total
Estos patrones se sitúan en un espectro que va de lo totalmente determinista a lo totalmente autónomo. Elige según el nivel de control y de varianza que exija tu caso de uso:
| Patrón | Descripción | Nivel de control |
|---|---|---|
| Encadenamiento de prompts | Secuencia de llamadas al LLM; la salida de cada paso alimenta al siguiente. Controles de calidad opcionales entre pasos. | Alto |
| Enrutamiento | Un clasificador dirige la entrada a prompts o conjuntos de herramientas especializados. | Alto |
| Paralelización | Varias llamadas al LLM se ejecutan de forma concurrente, ya sea por secciones (dividir la tarea) o por votación (la misma tarea, por consenso). | Medio |
| Orquestador-Trabajadores | Un agente gestor descompone una tarea de forma dinámica, la delega en agentes trabajadores y sintetiza los resultados. | Medio-Bajo |
| Evaluador-Optimizador | Un agente genera; otro critica; el bucle refina hasta cumplir los criterios de calidad. | Bajo |
Regla general (Anthropic): Empieza con el patrón más sencillo que resuelva el problema. Escala a bucles de agente completos solo cuando la tarea requiera de verdad una toma de decisiones dinámica.
Ejemplo del mundo real: GitHub Copilot en VS Code
El agente de programación de GitHub Copilot en VS Code es una buena ilustración de cómo se combinan estos patrones en un producto en producción:
- Enrutamiento. Cuando escribes un mensaje, Copilot clasifica la intención: ¿es una autocompletación en línea, una pregunta de chat o una edición de varios archivos? Cada una se enruta a una canalización distinta.
- Orquestador-Trabajadores. En modo agente, Copilot recibe una tarea de alto nivel (p. ej., "añade validación de entrada al formulario de registro"), la divide en subtareas y delega cada una en llamadas a herramientas especializadas: leer archivos, buscar símbolos con grep, ejecutar comandos de terminal, aplicar ediciones, ejecutar pruebas.
- Evaluador-Optimizador. Tras hacer cambios, el agente ejecuta linters, pruebas o verificadores de tipos. Si algo falla, lee la salida de error, razona sobre la solución e itera en un bucle de generar, evaluar, refinar.
- Encadenamiento de prompts con controles. La salida de cada paso condiciona al siguiente. Si la lectura de un archivo devuelve contenido inesperado, el agente vuelve a planificar en lugar de seguir a ciegas.
Por debajo, esto es un bucle ReAct respaldado por una integración de herramientas de estilo MCP: Copilot descubre las herramientas disponibles (sistema de archivos, terminal, búsqueda, API del editor), las llama mediante esquemas estructurados, observa los resultados y razona sobre los siguientes pasos. Es un ejemplo concreto de un sistema en producción que mezcla workflows deterministas con la flexibilidad impulsada por agentes.
Copilot también te deja cambiar dos palancas clave que afectan directamente al comportamiento:
Modelo. Cambiar de, pongamos, GPT-4o a Claude Sonnet o Gemini cambia el motor de razonamiento. Distintos modelos tienen distintas fortalezas: algunos son mejores planificando ediciones de varios pasos, otros siguiendo instrucciones con precisión, otros minimizando alucinaciones. Las mismas herramientas y el mismo prompt pueden producir resultados notablemente distintos según el modelo, y por eso importan las evaluaciones (la Fase 4 del plan de implementación más abajo).
Modo. Copilot ofrece tres modos integrados que se sitúan en puntos distintos del espectro de autonomía:
- Ask: una canalización de pregunta-respuesta (encadenamiento de prompts). Sin ediciones de archivos, sin llamadas a herramientas, solo razonamiento sobre el contexto que aportas.
- Agent: el bucle completo de orquestador-trabajadores. Puede leer tu base de código, ejecutar comandos de terminal, instalar dependencias, crear archivos e iterar sobre los fallos de forma autónoma. Este es el bucle ReAct en acción.
- Plan: un punto intermedio. El agente razona sobre la tarea y produce un plan paso a paso, pero espera tu aprobación antes de ejecutar ningún cambio. Es, en esencia, el patrón de "punto de control con intervención humana" descrito antes.
Pasar de Ask a Plan a Agent aumenta la flexibilidad, pero también aumenta la varianza, el coste y la importancia de tener buenos esquemas de herramientas. También puedes definir Agentes Personalizados con instrucciones y conjuntos de herramientas a medida, creando en la práctica una capa de enrutamiento especializada para tus propios workflows.
Sesiones. Copilot permite ejecutar varias sesiones de agente en paralelo, cada una con su propio modelo, modo y contexto. Esto convierte el modelo de un solo agente en un patrón práctico de paralelización: puedes tener una sesión escribiendo pruebas unitarias para un componente, otra implementando una nueva funcionalidad, otra generando documentación, todas ejecutándose de forma concurrente sobre la misma base de código. Esto funciona especialmente bien en arquitecturas con límites de módulo claros. En un proyecto Django, por ejemplo, cada app (autenticación, facturación, notificaciones) es en gran medida independiente, con sus propios modelos, vistas, URLs y pruebas. Puedes lanzar con seguridad sesiones paralelas acotadas a apps distintas con un riesgo mínimo de conflictos de fusión, porque las superficies de archivos apenas se solapan. El mismo principio se aplica a cualquier base de código con límites de paquete o servicio bien definidos (microservicios, paquetes de monorepo, módulos de Go, etc.). En la práctica, las sesiones paralelas te permiten cambiar tiempo de reloj por rendimiento, comprimiendo en trabajo concurrente lo que de otro modo sería trabajo secuencial, siempre que las tareas estén lo bastante aisladas.
El ecosistema de frameworks
El ecosistema se divide en tres capas. Los frameworks de agentes son donde construyes agentes. MCP es el protocolo que los conecta con herramientas externas. Las capas de gobierno gestionan flotas de agentes a escala empresarial. Son complementarios, no alternativas.
Frameworks de agentes
Microsoft Agent Framework
- Actualmente en vista previa pública (GitHub).
- Unifica Semantic Kernel (SK) y AutoGen bajo un único modelo de programación.
- Añade workflows tipados y basados en grafos con una sólida observabilidad (OpenTelemetry integrado).
- Integración nativa de los protocolos MCP y A2A.
- Soporte multiproveedor: Azure OpenAI, OpenAI, Anthropic, Ollama y más.
- Incluye una interfaz para desarrolladores (DevUI) para inspeccionar las trazas de los agentes.
OpenAI
La pila de agentes de OpenAI se reparte entre varios productos:
| Producto | Qué es | Lanzamiento |
|---|---|---|
| Responses API | Primitiva de API que combina la sencillez de Chat Completions con uso de herramientas integrado (búsqueda web, búsqueda de archivos, intérprete de código, uso del ordenador, generación de imágenes). | Marzo de 2025 |
| Agents SDK | Biblioteca de código abierto en Python/Node para orquestar workflows de uno o varios agentes (transferencias, salvaguardas, trazabilidad). Sucesora de Swarm. | Marzo de 2025 |
| AgentKit | Kit de herramientas de más alto nivel que agrupa Agent Builder (lienzo visual de workflows), ChatKit (interfaz de chat embebible) y Connector Registry (gestión centralizada de fuentes de datos). | Octubre de 2025 |
La página de Agent Platform es el paraguas de marketing de OpenAI para todo lo anterior.
Google Agent Development Kit (ADK)
- Framework de código abierto y modular, optimizado para Gemini pero agnóstico respecto al modelo.
- Admite topologías de uno y de varios agentes.
- Destinos de despliegue:
- Vertex AI Agent Engine: totalmente gestionado, con autoescalado.
- Cloud Run: en contenedores, con tu propia infraestructura.
- GKE: despliegue basado en Kubernetes.
Protocolo de interoperabilidad
MCP (Model Context Protocol)
- Estándar abierto creado originalmente por Anthropic, ahora gobernado por The Linux Foundation y abierto a contribuciones de la comunidad (protocolo y SDKs, registro de servidores).
- Los clientes (Claude, ChatGPT, VS Code, IDEs de JetBrains, Cursor, etc.) se conectan a servidores MCP que exponen esquemas de herramientas.
- Se está convirtiendo rápidamente en la capa de interoperabilidad de facto para los sistemas agénticos.
- Registro creciente de servidores de la comunidad y de proveedores (GitHub, Azure DevOps, Notion, Playwright, Slack, bases de datos, etc.).
- Valor clave: escribe tus herramientas una vez, exponlas a cualquier cliente compatible con MCP, sin trabajo de integración por cliente.
- Los tres frameworks anteriores admiten MCP de forma nativa o mediante plugins.
Capas de gobierno
MuleSoft Agent Fabric (Salesforce)
- Capa de gobierno empresarial para flotas de agentes:
- Registro: catálogo de agentes y herramientas disponibles.
- Broker: enruta las peticiones al agente adecuado.
- Políticas: control de acceso, limitación de tasa, prevención de pérdida de datos.
- Observabilidad: registro y trazabilidad centralizados.
- Admite MCP como estándar de conectividad.
- Diseñada para organizaciones que ejecutan de docenas a cientos de agentes a escala.
Equipos multiagente
Un patrón en auge son los equipos de agentes en contenedores: grupos de agentes especializados por dominio que colaboran bajo un mismo marco de gobierno:
- AgentCatalog en Docker Hub es un ejemplo temprano: imágenes de agentes preconstruidas para tareas habituales.
- Los equipos se pueden componer de forma dinámica (p. ej., un equipo de "revisión de contratos" con un agente de extracción de cláusulas, un agente de puntuación de riesgos y un agente de resumen).
- La orquestación de contenedores (Kubernetes, Docker Compose) permite escalar, versionar y revertir a nivel de agente.
- Las políticas internas de gobierno y de acceso se pueden aplicar por contenedor.
Arquitecturas de referencia
| # | Arquitectura | Componentes clave |
|---|---|---|
| 1 | Azure primero, con mucho workflow | Orquestador de Microsoft Agent Framework a servidor MCP en Azure Container Apps a servicios de Azure AI |
| 2 | OpenAI primero, con mucho builder | AgentKit / Agent Builder a Agents SDK a servidor MCP (cualquier host) |
| 3 | GCP primero, centrada en ADK | Agente ADK en Vertex AI Agent Engine a servidor MCP en Cloud Run |
| 4 | Flota gobernada | Broker de MuleSoft Agent Fabric a varios servidores MCP a capa de aplicación de políticas |
Las cuatro convergen en MCP como estándar de conectividad de herramientas. La elección viene determinada por la huella cloud existente, las relaciones con proveedores y los requisitos de gobierno.
De cero a producción: un plan de implementación
Cada fase tiene un entregable claro y unos criterios de salida para que sepas cuándo avanzar (o volver atrás).
Fase 1: Define tu superficie de herramientas
Objetivo: Decidir qué exponer antes de escribir nada de código.
- Audita las API y los workflows existentes de tu sistema. Identifica 3 a 5 operaciones de alto valor que los agentes llamarían de forma realista, p. ej., buscar documentos, extraer entidades, comprobar el estado de un caso, generar un resumen.
- Para cada operación, responde:
- ¿Cuáles son las entradas obligatorias frente a las opcionales? (Tipálas estrictamente.)
- ¿Cómo es la salida del camino feliz? ¿Y la salida de error?
- ¿La operación es de solo lectura o tiene efectos secundarios?
- Escribe esquemas de herramientas (JSON Schema o equivalente) con:
- Una
descriptionclara y legible para el agente. Es lo que el LLM ve para decidir si llama a la herramienta. - Un parámetro
mode("concise"|"detailed") para controlar el nivel de detalle de la salida. - Paginación basada en cursor (
cursor+limit) para los endpoints de listado. - Un indicador
truncated: trueen las respuestas para que el agente sepa que debe pedir más. - Errores didácticos: mensajes de error que le dicen al agente cómo corregir la llamada, no solo que falló.
- Una
Entregable: Un documento de esquemas (definiciones OpenAPI o de herramientas MCP) revisado por al menos una persona que no lo haya escrito.
Criterios de salida: Un compañero puede leer los esquemas en frío y predecir correctamente qué hace cada herramienta, qué entradas necesita y cómo es la salida.
Fase 2: Construye el servidor MCP
Objetivo: Convertir los esquemas en un servidor en funcionamiento al que cualquier cliente MCP pueda conectarse.
- Implementa cada herramienta detrás de un servidor compatible con MCP (SDK de TypeScript o Python).
- Elige tu transporte según el caso de uso:
| Transporte | Cuándo usarlo |
|---|---|
| stdio | Desarrollo local, integraciones con IDE (VS Code, Cursor) |
| HTTP en streaming | Despliegue remoto / en la nube, escenarios multiinquilino |
- Integra la seguridad desde el primer día:
- Las herramientas con efectos secundarios deben admitir un modo
dry_run(devuelve lo que ocurriría) y un modocommit(ejecuta la acción). - Las operaciones destructivas requieren un paso de confirmación humana antes de que
commitproceda.
- Las herramientas con efectos secundarios deben admitir un modo
- Valida la interoperabilidad con al menos dos clientes MCP (p. ej., Claude Desktop + VS Code Copilot). Si ambos pueden descubrir y llamar correctamente a todas las herramientas, el servidor está listo.
Entregable: Un servidor MCP desplegado (o ejecutable localmente) con pruebas de integración que pasan contra dos clientes.
Criterios de salida: Ambos clientes pueden completar de principio a fin una tarea realista de varios pasos usando solo las herramientas expuestas.
Fase 3: Conecta un framework de agentes
Objetivo: Demostrar que el servidor MCP funciona con un agente real. Elige un framework para empezar.
Elige el framework que encaje con la pila de tu equipo:
| Si tu pila es… | Empieza con… |
|---|---|
| Azure / .NET | Microsoft Agent Framework |
| Con mucho OpenAI / Python | Agents SDK + Agent Builder |
| GCP / Gemini | Google ADK en Vertex AI Agent Engine |
Construye dos cosas:
- Un workflow determinista: una secuencia fija de llamadas a herramientas (p. ej., "buscar, extraer, resumir"). Esto valida que las herramientas se componen correctamente.
- Un agente de forma libre: las mismas herramientas, pero el LLM decide el plan en tiempo de ejecución. Esto pone a prueba tus esquemas: si el agente elige la herramienta equivocada o pasa entradas malas, tus descripciones o mensajes de error necesitan trabajo.
Opcionalmente, repite con un segundo framework para confirmar que el servidor MCP es realmente agnóstico respecto al framework.
Entregable: Un agente en funcionamiento (workflow + forma libre) que completa tareas reales usando el servidor MCP.
Criterios de salida: El agente completa ≥ 80 % de las tareas de prueba sin intervención humana.
Fase 4: Evalúa e itera
Objetivo: Medir cómo de bien usan los agentes tus herramientas y arreglar lo que esté roto.
- Crea 10 a 20 tareas realistas con salidas de referencia esperadas (p. ej., "Encuentra todos los contratos que vencen en el segundo trimestre y resume las obligaciones clave").
- Pasa cada tarea por el workflow y por el agente de forma libre. En cada ejecución, captura:
| Métrica | Por qué importa |
|---|---|
| Tasa de éxito | ¿El agente llegó a la respuesta correcta? |
| Número de llamadas a herramientas | El exceso de llamadas indica un esquema confuso |
| Uso de tokens | Indicador indirecto del coste |
| Latencia | De extremo a extremo y por herramienta |
| Tasa de error por categoría | Revela problemas sistemáticos de diseño de herramientas |
- Clasifica los fallos:
- Herramienta equivocada seleccionada: mejora la
descriptionde la herramienta. - Parámetros equivocados: ajusta el esquema, añade restricciones
enum, mejora las pistas de error. - Llamada correcta, interpretación equivocada del resultado: simplifica el formato de salida o añade un campo
summary.
- Herramienta equivocada seleccionada: mejora la
- Vuelve a ejecutar la suite de evaluación tras cada arreglo. Sigue la mejora a lo largo de las iteraciones.
Entregable: Una suite de evaluación (automatizada y reejecutable) y un registro de los cambios de esquema con las tasas de éxito antes/después.
Criterios de salida: Tasa de éxito ≥ 90 % en la suite de evaluación con ambos modos de agente.
Fase 5: Refuerza y escala
Objetivo: Prepararse para el tráfico de producción y el despliegue en la organización.
- Observabilidad. Instrumenta el servidor MCP con trazabilidad distribuida (OpenTelemetry) y registro estructurado. Cada llamada a una herramienta debería ser trazable desde la petición del cliente hasta el sistema de backend.
- Limitación de tasa y control de acceso. Decide quién (qué agentes, qué usuarios) puede llamar a qué herramientas, y a qué rendimiento.
- Gobierno a escala. Si prevés varios servidores MCP o equipos de agentes, adopta una capa de broker/fabric (p. ej., MuleSoft Agent Fabric) para:
- Aplicación centralizada de políticas.
- Registro de auditoría (quién llamó a qué, cuándo y con qué entradas).
- Monitorización a nivel de flota e interruptores de emergencia.
- Documentación. Publica un catálogo de herramientas (descripciones legibles para humanos, ejemplos de llamadas, limitaciones conocidas) para que otros equipos puedan construir agentes contra tu servidor MCP sin tener que aplicarle ingeniería inversa.
Entregable: Un servidor MCP listo para producción con paneles de monitorización, políticas de acceso y un catálogo de herramientas publicado.
Criterios de salida: Un equipo que no participó en construir el servidor puede levantar un nuevo agente contra él usando solo el catálogo y los esquemas públicos.
Preguntas que responde este artículo
¿Cuál es la diferencia entre un agente de IA y un workflow?
El flujo de control. Un workflow ejecuta un DAG codificado a mano, por eso es previsible y de auditoría directa, mientras que un agente deja que el LLM decida el camino en tiempo de ejecución, lo que gana flexibilidad a cambio de más varianza y de necesitar trazabilidad. Ambos pertenecen a la misma familia de sistemas agénticos y los sistemas en producción suelen mezclarlos, dejando los pasos deterministas donde el proceso ya se conoce y entregando a los agentes las subtareas abiertas. La regla general de Anthropic sigue valiendo: empieza con el patrón más sencillo que resuelva el problema y escala solo cuando la tarea requiera de verdad una toma de decisiones dinámica.
¿Por qué mi agente llama siempre a la herramienta equivocada?
Normalmente la culpa es de la descripción, no del modelo. El agente lee solo el nombre, la descripción y el esquema de una herramienta para decidir si la llama y cómo, así que las señales vagas producen la herramienta equivocada, entradas mal formadas o salidas malinterpretadas que acaban en alucinación más adelante. La clasificación es directa: herramienta equivocada seleccionada significa mejorar la descripción; parámetros equivocados significan ajustar el esquema, añadir restricciones enum y escribir mensajes de error que digan cómo corregir la llamada; una llamada correcta mal interpretada significa simplificar el formato de salida o añadir un campo summary.
¿MCP no es solo otra capa sobre las API que ya tengo?
Es una capa con una ventaja concreta: escribes la herramienta una vez y cualquier cliente compatible con MCP puede usarla, sin trabajo de integración por cliente. Entre los clientes ya están Claude, ChatGPT, VS Code, los IDEs de JetBrains y Cursor, y Microsoft Agent Framework, la pila de OpenAI y Google ADK lo admiten de forma nativa o mediante plugins. Es un estándar abierto creado por Anthropic y hoy gobernado por The Linux Foundation, así que adoptarlo no es apostar por un único proveedor.
¿Cómo sé si mi servidor MCP está listo de verdad para producción?
Usa los criterios de salida de cada fase en lugar de una intuición. Dos clientes MCP distintos, por ejemplo Claude Desktop y VS Code Copilot, deben completar cada uno de principio a fin una tarea realista de varios pasos usando solo tus herramientas; el agente de forma libre debe terminar al menos el 80 % de las tareas de prueba sin intervención humana y al menos el 90 % de una suite de evaluación de 10 a 20 tareas realistas. El último criterio no es técnico: un equipo que no tuvo nada que ver con construir el servidor debería poder levantar un nuevo agente usando solo el catálogo publicado y los esquemas.
Leer a continuación
 AI Agents
He construido una capa de IA que nunca responde. Esto es lo que exige de verdad una buena pregunta
Notas de campo de OrbitSpec, un motor de clarificación que convierte peticiones vagas en Context Bundles tipados y auditables antes de que se ejecute ningún modelo, y por qué la fiabilidad empieza antes de la respuesta. AI Agents
Construí el pipeline que construyó mi producto. Esto es lo que exige delegar de verdad
Notas de campo sobre plan-to-pr, un pipeline que convierte una petición de funcionalidad en tickets, una puerta de aprobación y pull requests en borrador, y por qué delegar en agentes de código exige artefactos, no chat.