
J'ai construit le pipeline qui a construit mon produit. Voici ce que déléguer exige vraiment
Écouter l'article (expérimental) · 13:50

Hier, j'ai tapé une seule phrase, « Ajouter un export CSV des tâches terminées », j'ai pointé une CLI vers une petite API de suivi de tâches, et je suis parti faire autre chose. Douze minutes plus tard, il y avait un plan avec des critères d'acceptation, cinq tickets sur un tableau, une trace d'approbation et une pull request en brouillon avec un endpoint fonctionnel, un nouveau module, des tests et une documentation à jour : 1 190 lignes ajoutées sur une branche cohérente, un commit par tâche, en attente de relecture.
L'envie est plus ancienne que l'outil. Quiconque a travaillé en scrum dans une entreprise a eu cette pensée pendant la planification du sprint : les user stories sont là, affinées et estimées, et comme il serait agréable qu'une IA fasse la première itération, pendant que nous passerions notre temps à relire la PR, à la lancer en local pour vérifier que tout fonctionne, à ajuster, puis à recommencer. Est-ce que cela fait vraiment gagner du temps ? Difficile à dire, et je n'ai pas construit cet outil pour gagner ce débat. Je l'ai construit pour rendre cette expérience réelle, en laissant la question de l'impact pour plus tard.
Dans un billet précédent, je racontais Smithproof, le plan de contrôle que j'ai construit pour gouverner des agents IA. Voici l'histoire de l'outil de l'autre côté de cette relation : plan-to-pr, un pipeline en ligne de commande qui transforme une demande de fonctionnalité en langage naturel en pull requests relues. Les deux sont plus imbriqués qu'un simple duo de démo. Le pipeline a aidé à construire le plan de contrôle, et le plan de contrôle gouverne désormais le pipeline. Mais avant d'en arriver là, l'outil mérite son propre rapport de terrain, parce que le construire m'a appris ce que déléguer à des agents de code exige vraiment.
Ce qu'est le pipeline
Quatre étapes, chacune avec un artefact :
| Étape | Ce qui se passe | Ce qui lui survit |
|---|---|---|
| Plan | Un LLM classifie l'intention, enrichit la demande à partir d'un scan du dépôt et produit des epics, des tickets et des tâches avec critères d'acceptation | plan.json, validé contre un schéma |
| Tickets | Un ticket par tâche atterrit sur le tableau (Trello ou GitHub Issues) | Des cartes qu'une équipe peut voir et réassigner |
| Approve | Un point de contrôle humain ; le rejet, c'est exit code 4 | approval.json : qui, quand |
| Execute | Chaque ticket reçoit sa propre branche ; un agent génère le code tâche par tâche | Une PR en brouillon par ticket, reliée à son ticket d'origine |
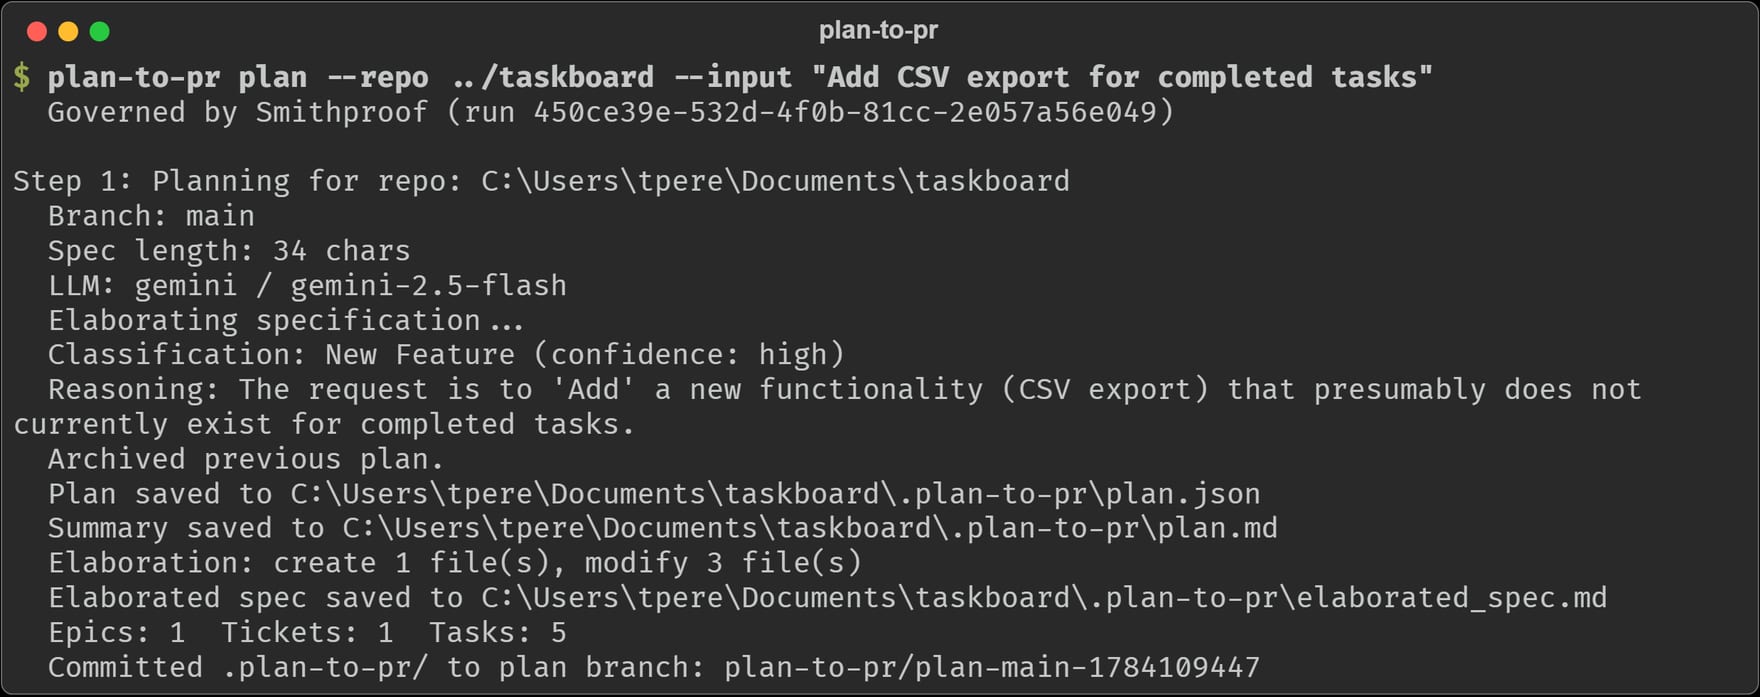 Le run de plan de la démo. Le plan lui-même est commité sur une branche dédiée, jamais sur main.
L'état qui relie le tout vit dans un dossier .plan-to-pr/ à l'intérieur du dépôt cible : le plan, les correspondances de tickets, les résultats d'exécution. Les runs sont reprenables ; une tâche terminée n'est jamais refaite. Rien de tout cela n'est exotique. C'est justement le but. Le pipeline est une orchestration volontairement ennuyeuse autour d'un modèle qui est tout sauf prévisible.
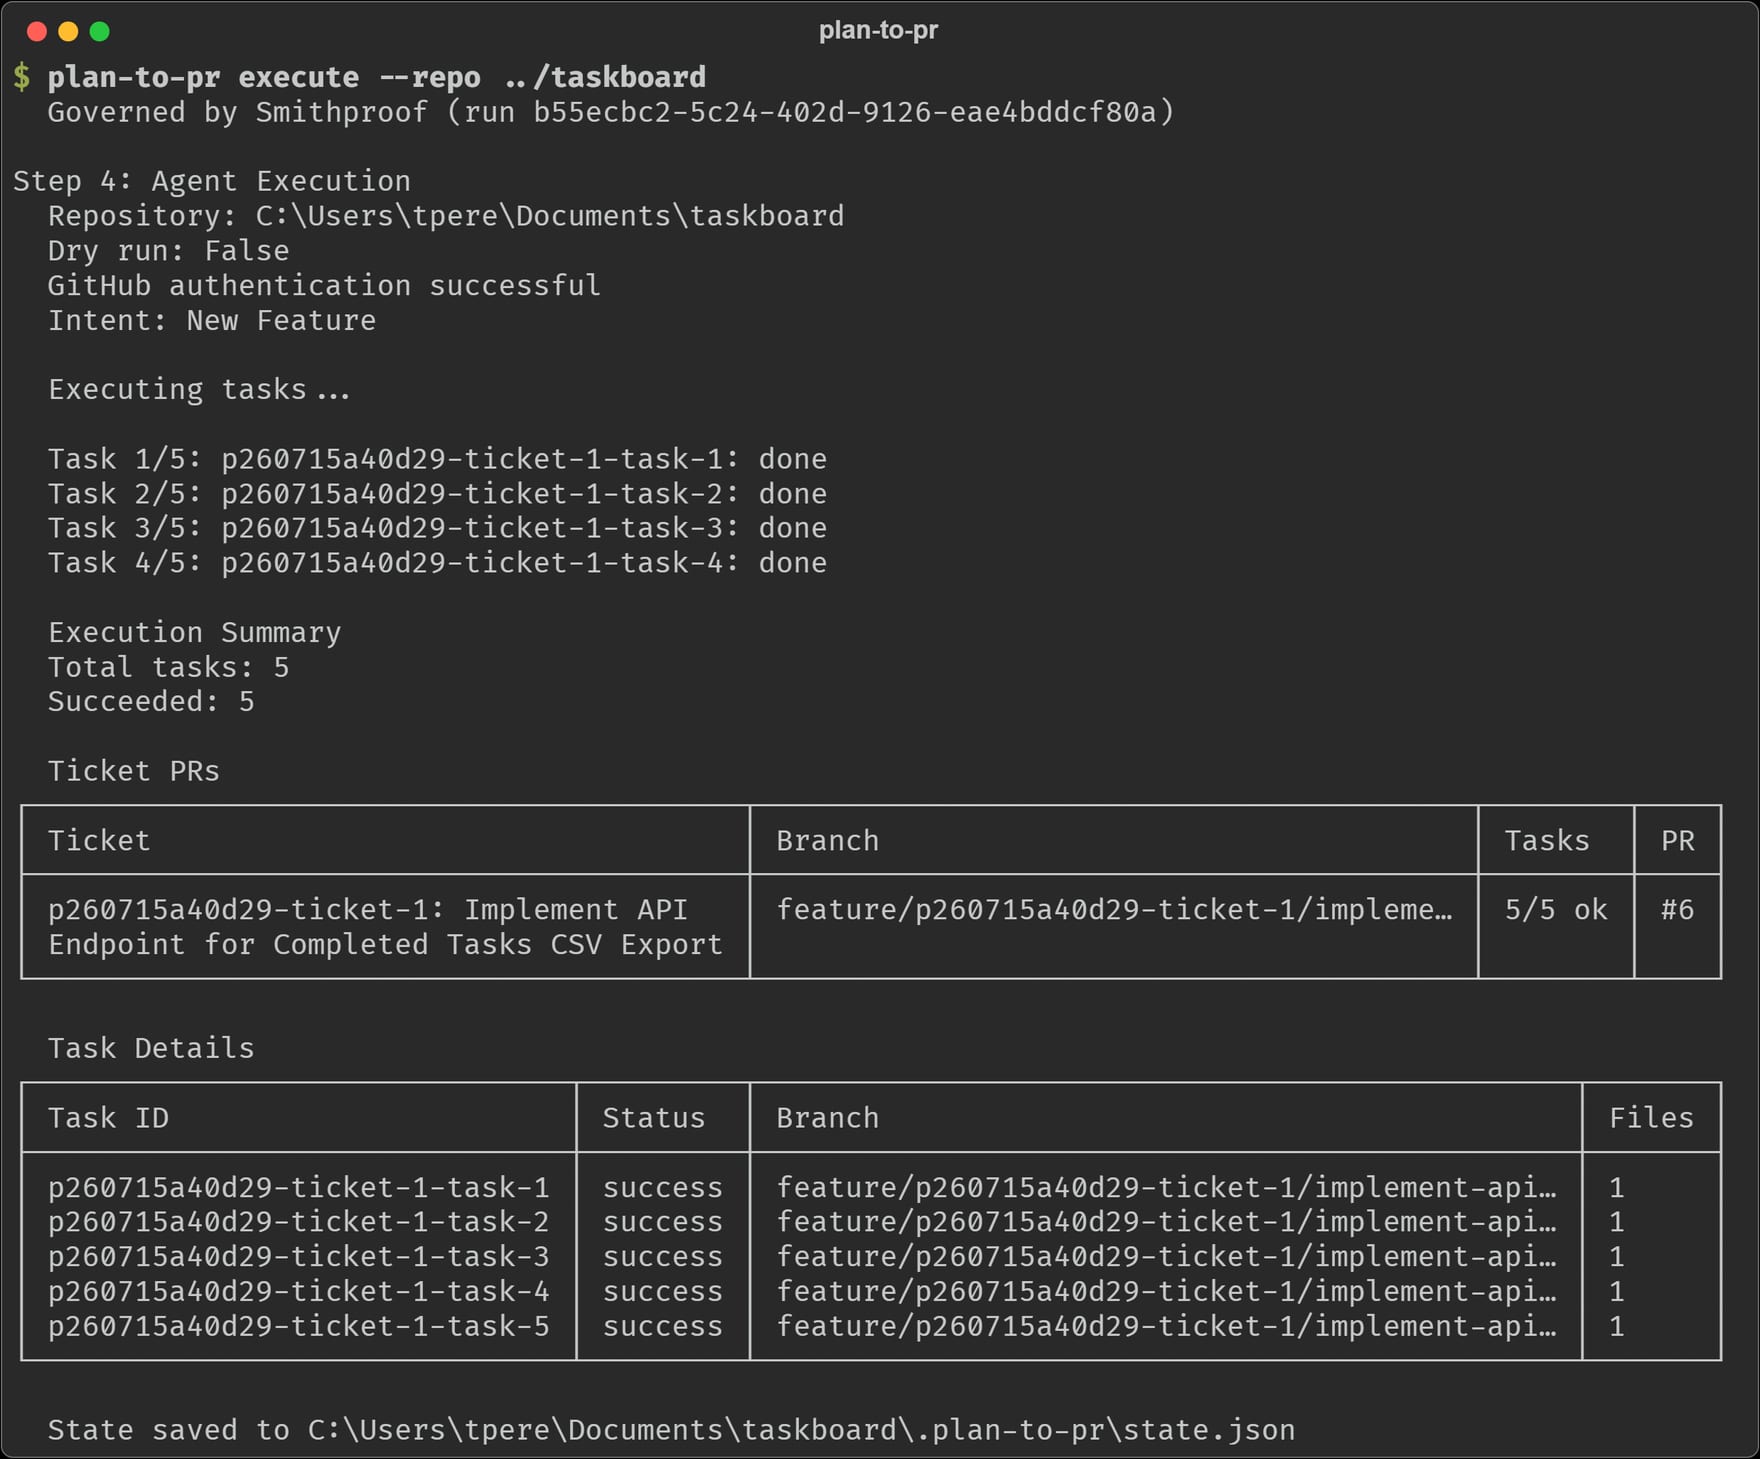 Execute, de bout en bout : une branche par ticket, un commit par tâche, une PR en brouillon avec la checklist dans sa description.
Pourquoi un pipeline et pas un chat
J'utilise des agents de code interactifs tous les jours, et la question évidente mérite une réponse franche : pourquoi ne pas ouvrir Claude Code, passer en mode plan et laisser la session faire tout cela ?
Pour explorer, pour un correctif ponctuel, ou dès que je veux ajuster la trajectoire en cours de route, la session interactive gagne, et de loin. Mais déléguer est un métier différent de collaborer, et la différence se voit à cinq endroits.
Les artefacts sont le comportement par défaut, pas une faveur. Un agent de chat compétent écrira un fichier de plan et créera des tickets sur le tableau si on le lui demande, et une skill bien écrite le lui fera faire chaque fois qu'on pense à l'invoquer. La différence tient à l'endroit où vit la garantie. Une skill reste un ensemble d'instructions que le modèle suit presque toujours ; une étape de pipeline est du code qui ne peut pas être sauté. Poussez l'approche des skills jusqu'au bout, des hooks qui bloquent l'exécution tant qu'un fichier d'approbation n'existe pas, un script pour chaque étape, et ce que vous avez construit, c'est ce pipeline avec une fenêtre de chat greffée devant. Quand je reviens trois jours plus tard, l'état du monde est sur le tableau et dans les branches parce que rien d'autre n'était possible, pas parce que tout le monde a pensé à le demander.
Un point de contrôle n'est pas une question. Un agent interactif demande « est-ce que cela vous semble correct ? », et la vérité, c'est qu'après suffisamment d'approbations, on ne lit plus. L'étape d'approbation du pipeline est un arrêt net, avec un code de sortie. Rien ne s'exécute tant que approval.json n'existe pas, et le rejet est un résultat à part entière, pas un message poli.
Les unités de travail sont des unités de relecture. Le pipeline émet une PR par ticket, chacune assez petite pour être réellement relue, chacune reliée au ticket qui l'a motivée. Une longue session d'agent tend à produire un unique diff tentaculaire, façonné par l'ordre qu'a pris la conversation.
Le flux de contrôle appartient au code. Dans le pipeline, le modèle écrit des plans et du code à l'intérieur d'étapes bien définies, mais la boucle elle-même, ce qui tourne, dans quel ordre, ce qui se passe en cas d'échec, c'est du Python déterministe. Quand quelque chose casse à deux heures du matin, je débogue un pipeline, pas une personnalité.
Un pipeline, ça se gouverne. C'est le point qui me tient le plus à cœur, et il a droit à sa propre section plus bas. Une CLI avec des points d'entrée définis peut être enregistrée, observée, budgétée et refusée. Il est beaucoup plus difficile de dire non à une session en roue libre.
Rien de tout cela n'est un argument contre les agents interactifs. C'est un argument pour dire que « laisser l'agent s'en charger » se scinde en deux produits : un collaborateur que l'on pilote, et un délégataire à qui l'on demande des comptes. Le second a besoin de preuves.
Les deux coexistent dans mon propre travail, et ce projet précis a mobilisé les deux. Le polissage final de l'outil est venu de Claude Code avec Fable 5 et Opus 4.8, des modèles plus rapides et plus puissants que ceux du pipeline, avec un abonnement Max où je cesse de compter les tokens. Quand le coût est forfaitaire et qu'un humain est au clavier, l'agent interactif gagne le sprint. Le pipeline prend plus de temps de bout en bout, je le soupçonne, mais il tourne sur un modèle en offre gratuite, son coût par fonctionnalité est un nombre qui se lit sur un tableau de bord, et son comportement est le même à la dixième exécution qu'à la première. Moins cher et plus prévisible, ce n'est pas la moitié glamour de l'échange, mais c'est la moitié qui compte dès que l'humain s'éloigne et que quelque chose doit plafonner la dépense.
Le plus dur, c'est le découpage, et le correctif vit dans un prompt
La leçon technique la plus profonde est venue du modèle d'exécution.
Chaque ticket s'exécute sur une branche fraîche, créée à partir de la branche de base. Les tickets ne voient pas les fichiers les uns des autres, parce que leurs branches n'ont pas encore été fusionnées. La première conséquence arrive vite : si le planificateur regroupe le travail par couche, tous les modèles dans un ticket, tous les endpoints dans un autre, chaque branche importe des fichiers qui n'existent que sur une branche sœur, et rien ne tourne.
Le correctif n'est pas dans l'exécuteur. Il est dans le prompt système du planificateur, qui enseigne au modèle la topologie d'exécution de l'outil lui-même : le code des autres tickets n'est pas sur le disque ; si le fichier A importe le fichier B, les deux appartiennent au même ticket ; le travail se regroupe en tranches verticales ; les fondations partagées vont dans le ticket un. Le prompt nomme même l'anti-pattern, un ticket pour tous les modèles et un autre pour tous les schémas, comme un échec d'import garanti. Dans le run de démo, le planificateur a regroupé la fonction de stockage, le module CSV, l'endpoint et les tests dans un seul ticket, précisément parce qu'ils forment une seule chaîne de dépendances.
Je trouve cela sincèrement intéressant comme objet de conception : la contrainte est infrastructurelle, la solution est linguistique, et les deux ont évolué ensemble au fil des échecs observés. Deux pièces plus petites complètent le tableau. Pendant l'exécution, une passe de découverte classe les fichiers à créer, à modifier ou à lire comme contexte de conventions, et le générateur de code peut lire les fichiers des branches des tickets déjà terminés avec git show, une conscience inter-branches sans jamais faire de checkout. Et parce que la sortie d'un LLM est hostile aux parseurs, les réponses de plan et de code passent par une petite pile défensive : des marqueurs sentinelles, quatre mécanismes de repli pour l'extraction, un réparateur d'échappements pour les regex dans du JSON, et une boucle de retry qui renvoie l'erreur de parsing au modèle à température plus basse. Chacune de ces pièces existe parce que quelque chose de réel a cassé.
Les preuves
Si je fais confiance à ce pipeline, c'est parce qu'il a livré du travail avec lequel j'ai ensuite dû vivre. Des morceaux de Smithproof, dont le sous-système de revue humaine et la machinerie des tâches d'arrière-plan, sont arrivés sous forme de tickets plan-to-pr et de PR en brouillon, avec les noms de branches générés par la machine encore visibles dans l'historique. Le prompt de génération de code porte encore les cicatrices : des conventions sur les classes de base exactes et les styles de schémas de cette base de code, ajoutées après des runs qui s'étaient trompés.
Cela coupe dans les deux sens, et autant le dire clairement : le pipeline excelle sur des fonctionnalités bien délimitées, dans des bases de code aux conventions claires. Ce n'est pas l'outil pour les refactorisations épineuses, ni pour les problèmes que je ne sais pas encore décrire en une phrase. Savoir distinguer quelle moitié du travail relève de quoi, voilà la vraie compétence quand on délègue à des agents.
La boucle se referme
Voici ma partie préférée. plan-to-pr tourne désormais comme agent gouverné sous Smithproof, le plan de contrôle qu'il a aidé à construire.
Quand les réglages de gouvernance sont présents, chaque invocation du pipeline s'enregistre auprès du plan de contrôle, ouvre un run avant de faire quoi que ce soit, et rapporte ses appels au modèle, latence mesurée et coût estimé, à la clôture du run. La console affiche le pipeline dans la flotte comme n'importe quel autre agent : trois runs hier, dix appels au modèle sur la phase d'exécution, environ cinq centimes de dépense.
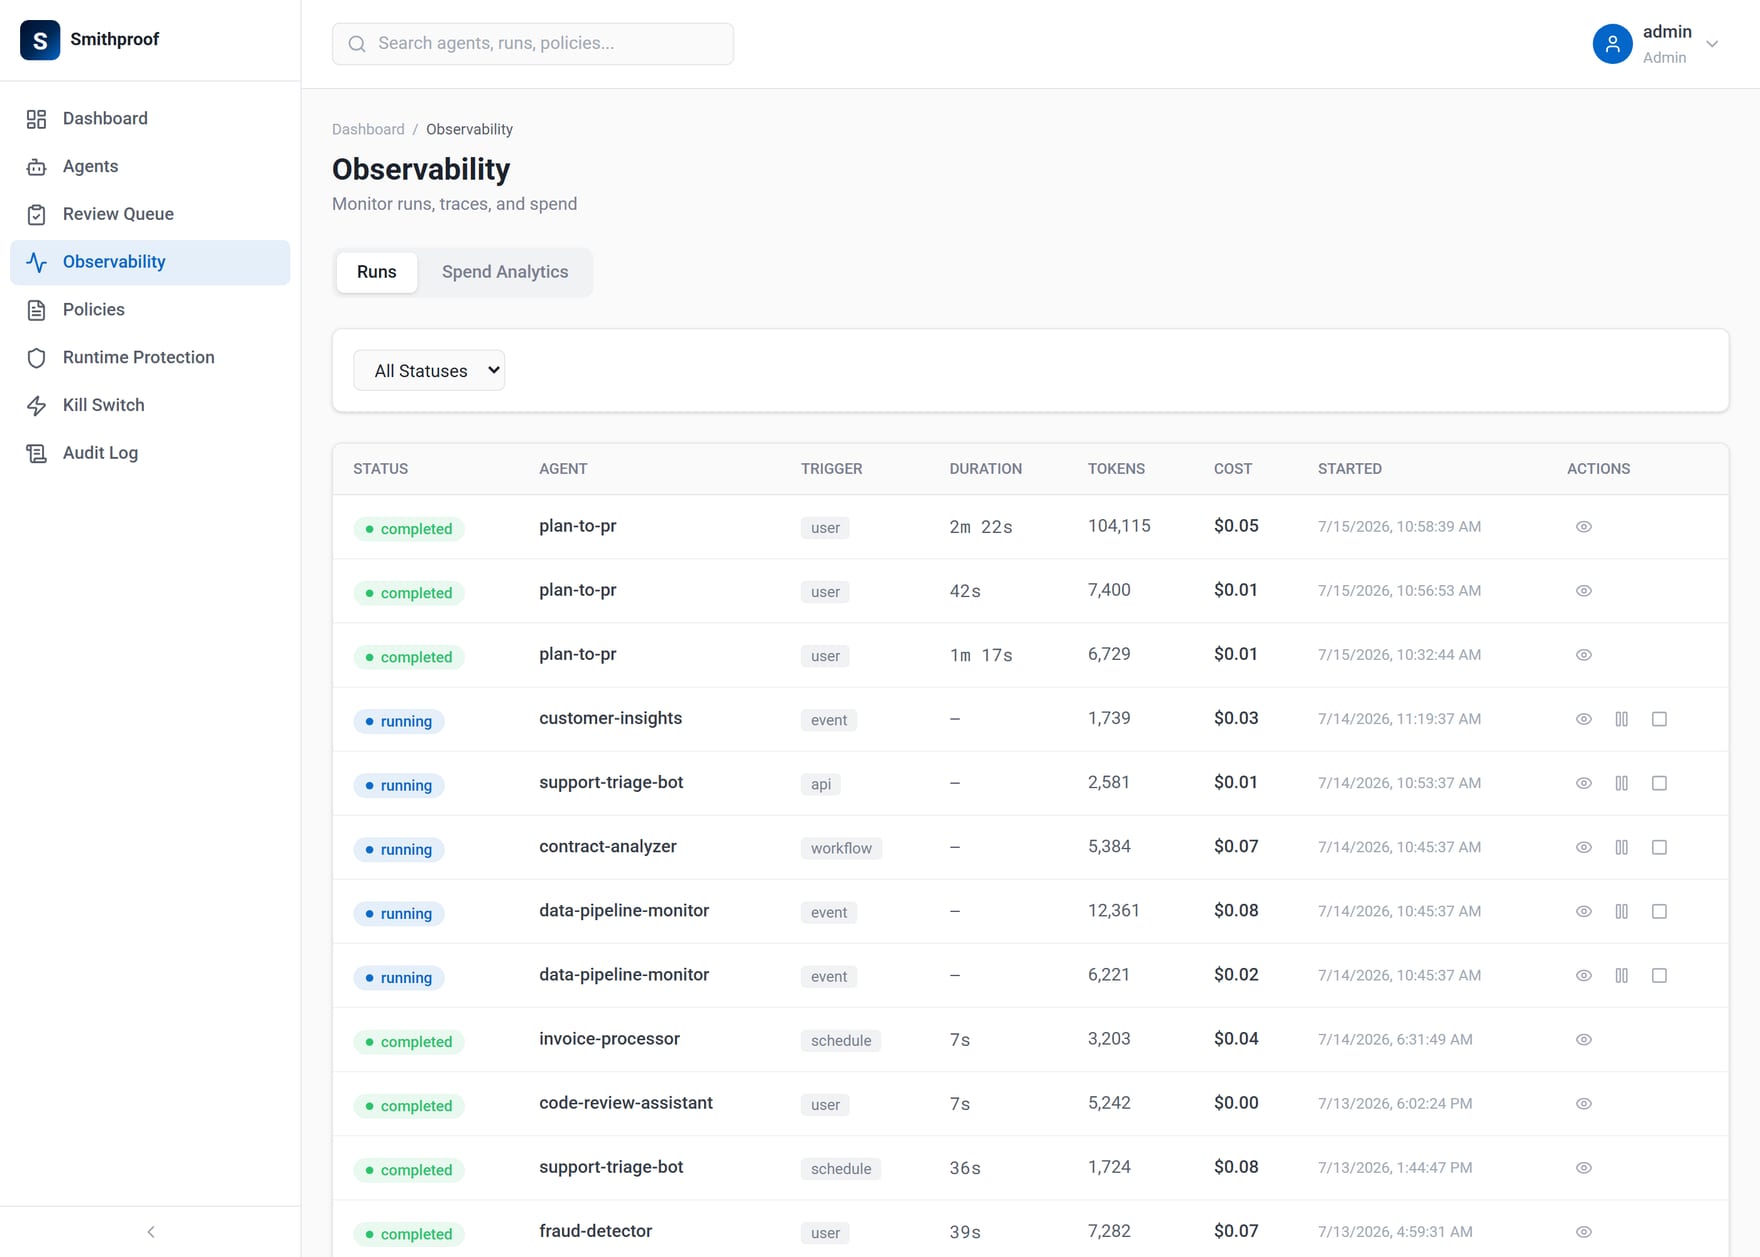 Les runs du pipeline dans la vue d'observabilité du plan de contrôle, à côté du reste de la flotte.
Ce qui compte, ce n'est pas la télémétrie. C'est que le plan de contrôle peut dire non, et que le pipeline obéit. Mettez l'agent en quarantaine dans la console, et l'invocation suivante s'arrête à la porte, avant le moindre appel au modèle ou la moindre modification de fichier :
 Exit code 5. La raison vient du plan de contrôle, pas de l'outil.
La sémantique d'échec a demandé une vraie décision : refuser sur décision, avertir sur panne. Si le plan de contrôle refuse explicitement le run, le pipeline s'interrompt. Si le plan de contrôle est injoignable, le pipeline avertit bruyamment et continue, parce que la télémétrie ne doit jamais être la raison pour laquelle un build casse, mais qu'une décision de blocage doit toujours être respectée. Dans le dernier billet, j'écrivais qu'une politique est une décision et que son application est une architecture. Voilà ce que le côté application donne, vu de l'intérieur du processus gouverné, et pour avoir construit les deux moitiés, je peux confirmer que la boucle est plus satisfaisante que chaque moitié prise seule.
Où en est l'outil
plan-to-pr planifie aujourd'hui contre n'importe quel dépôt git avec une simple clé Gemini gratuite, pose des tickets sur Trello ou GitHub Issues, et ouvre des PR en brouillon sur GitHub, avec ClickUp, Azure DevOps et GitLab sur la feuille de route des fournisseurs. L'intégration de gouvernance estime les décomptes de tokens à partir des longueurs de texte, en attendant que la couche LLM remonte l'usage exact, et les runs sont étiquetés en conséquence. Le pipeline journalise encore un avertissement quand il échoue à re-commiter son dossier d'état sur la branche de plan en cours d'exécution, un conflit de checkout qui est le prochain sur la liste des correctifs. Un rapport de terrain doit inclure le terrain.
S'il y a une chose à retenir de ce chantier : le modèle n'a jamais été la partie difficile. Les parties difficiles étaient les mêmes que dans toute délégation, la décomposition, les points de contrôle, l'obligation de rendre des comptes, et l'humilité de garder des preuves. Les outils qui rendront les agents utiles pour du vrai travail ressembleront moins à des fenêtres de chat plus intelligentes qu'à ceci : des pipelines avec des artefacts, exécutés par des agents, gouvernés par quelque chose qui peut leur dire non.
Les questions auxquelles cet article répond
Pourquoi ne pas simplement utiliser un agent de code interactif en mode plan plutôt que construire un pipeline ?
Pour explorer, pour un correctif ponctuel ou dès qu'on veut ajuster la trajectoire en cours de route, la session interactive gagne, et de loin. Le pipeline sert l'autre métier, la délégation, où une étape est du code et non une instruction que le modèle suit presque toujours, et où trois jours plus tard l'état du monde est sur le tableau et dans les branches parce que rien d'autre n'était possible. Poussez l'approche des skills et des hooks jusqu'au bout, et ce que vous avez construit, c'est ce pipeline avec une fenêtre de chat greffée devant.
Comment éviter que des tickets exécutés sur des branches séparées se cassent les uns les autres ?
Cela se règle dans le planificateur, pas dans l'exécuteur. Chaque ticket s'exécute sur une branche fraîche créée à partir de la branche de base, donc le code d'un ticket voisin n'est pas sur le disque, et le prompt système du planificateur enseigne exactement cela : si le fichier A importe le fichier B, les deux appartiennent au même ticket, le travail se regroupe en tranches verticales, les fondations partagées vont dans le ticket un. Dans le run de démo, le planificateur a réuni la fonction de stockage, le module CSV, l'endpoint et les tests dans un seul ticket parce qu'ils forment une seule chaîne de dépendances.
Est-ce vraiment plus rapide que de faire le travail avec un agent interactif ?
Probablement pas, et ce n'a jamais été l'argument. La session interactive avec les modèles les plus puissants gagne le sprint quand le coût est forfaitaire et qu'un humain est au clavier ; le pipeline prend plus de temps de bout en bout, mais il tourne sur un modèle en offre gratuite, son coût par fonctionnalité est un nombre qui se lit sur un tableau de bord, et il fait la même chose à la dixième exécution qu'à la première. Moins cher et plus prévisible, c'est la moitié qui compte dès que l'humain s'éloigne et que quelque chose doit plafonner la dépense.
Peut-on réellement arrêter un pipeline d'agents une fois qu'il tourne ?
Oui, et depuis l'extérieur de l'outil. Chaque invocation s'enregistre auprès du plan de contrôle Smithproof et ouvre un run avant de faire quoi que ce soit, donc mettre l'agent en quarantaine dans la console suffit pour que l'invocation suivante s'arrête à la porte avec exit code 5, avant le moindre appel au modèle ou la moindre modification de fichier. La sémantique d'échec est refuser sur décision, avertir sur panne : un refus explicite interrompt le run, tandis qu'un plan de contrôle injoignable se contente d'avertir et laisse continuer, parce que la télémétrie ne doit jamais être la raison pour laquelle un build casse.
À lire ensuite
 AI Agents
J'ai construit une couche d'IA qui ne répond jamais. Voici ce qu'exige vraiment une bonne question
Notes de terrain sur OrbitSpec, un moteur de clarification qui transforme les demandes vagues en Context Bundles typés et auditables avant qu'aucun modèle ne tourne, et pourquoi la fiabilité commence avant la réponse. AI Agents
J'ai construit un plan de contrôle pour agents IA. Voici ce que la gouvernance exige vraiment
Notes de terrain sur la construction de Smithproof, un plan de contrôle multi-tenant pour agents IA, et pourquoi la détection sans réponse et la politique sans application ne gouvernent rien.