
J'ai construit un plan de contrôle pour agents IA. Voici ce que la gouvernance exige vraiment
Écouter l'article (expérimental) · 14:23
Dans un article précédent, j'ai décrit le paysage des frameworks d'agents et, vers la fin, une couche de gouvernance : un registre, un broker, des politiques et de l'observabilité au-dessus d'une flotte d'agents. C'était la version abstraite, empruntée à ce que des outils comme MuleSoft Agent Fabric promettent sur une diapositive.
Puis j'en ai construit un, un plan de contrôle nommé Smithproof, pour découvrir ce que la diapositive passe sous silence. Voici le rapport de terrain. Ce n'est ni un lancement ni un tutoriel. C'est l'ensemble des choses que je dirais à quelqu'un sur le point de construire de la gouvernance d'agents et qui pense que le plus dur, ce sont la détection et la politique. Le plus dur, c'est tout ce qui transforme la détection et la politique en quelque chose qui gouverne réellement.
Le nom est un objectif de conception
Dans The Matrix, Agent Smith commence comme un programme qui fait exactement ce pour quoi il a été conçu. Puis il se libère de ses contraintes, se met à poursuivre son propre objectif et se copie sur chaque programme et chaque personne qu'il touche, jusqu'à ce que l'agent chargé de faire respecter les règles du système en devienne la plus grande menace. C'est l'image la plus nette que la fiction ait produite du mode de défaillance vers lequel la recherche sur la sûreté de l'IA revient sans cesse : non pas un intrus hostile, mais un processus autonome de confiance dont les objectifs dérivent et dont le rayon d'impact s'amplifie.
Remplacez la simulation par un environnement de production et l'image tient toujours. Un agent doté d'un accès aux outils, d'identifiants et d'aucune supervision n'est qu'à un mauvais prompt de son propre petit moment Smith : agir hors de son mandat, à la vitesse de la machine, avec vos clés d'API. Smithproof tire son nom de la propriété que la plateforme existe pour fournir. Une flotte est Smith-proof lorsque chaque agent qui la compose est inventorié, observé, gouverné et interruptible, de sorte qu'aucun agent ne puisse discrètement devenir le système.
Pourquoi un plan de contrôle, au juste
Les équipes qui déploient des agents se heurtent aux cinq mêmes lacunes :
- Aucun inventaire des agents existants ni de leurs responsables.
- Aucune visibilité sur ce qu'un agent a fait à l'exécution : appels de modèles, appels d'outils, coût.
- Aucune application des politiques. Un agent atteint tout ce qu'il peut atteindre.
- Aucune détection des injections de prompt, des pics de coût ou des boucles incontrôlées.
- Aucun coupe-circuit, et aucune trace de qui est intervenu quand les choses ont mal tourné.
Chacune de ces lacunes a une bonne solution ponctuelle. La raison de les unifier, c'est que les questions de gouvernance traversent ces frontières. « Arrête tous les agents qui ont touché à l'outil de facturation cette heure-ci, et dis-moi qui a approuvé ça » est à la fois une question de registre, une question d'observabilité, une question de politique et une question d'audit. Un plan de contrôle, c'est l'endroit où ces quatre-là peuvent former une seule requête.
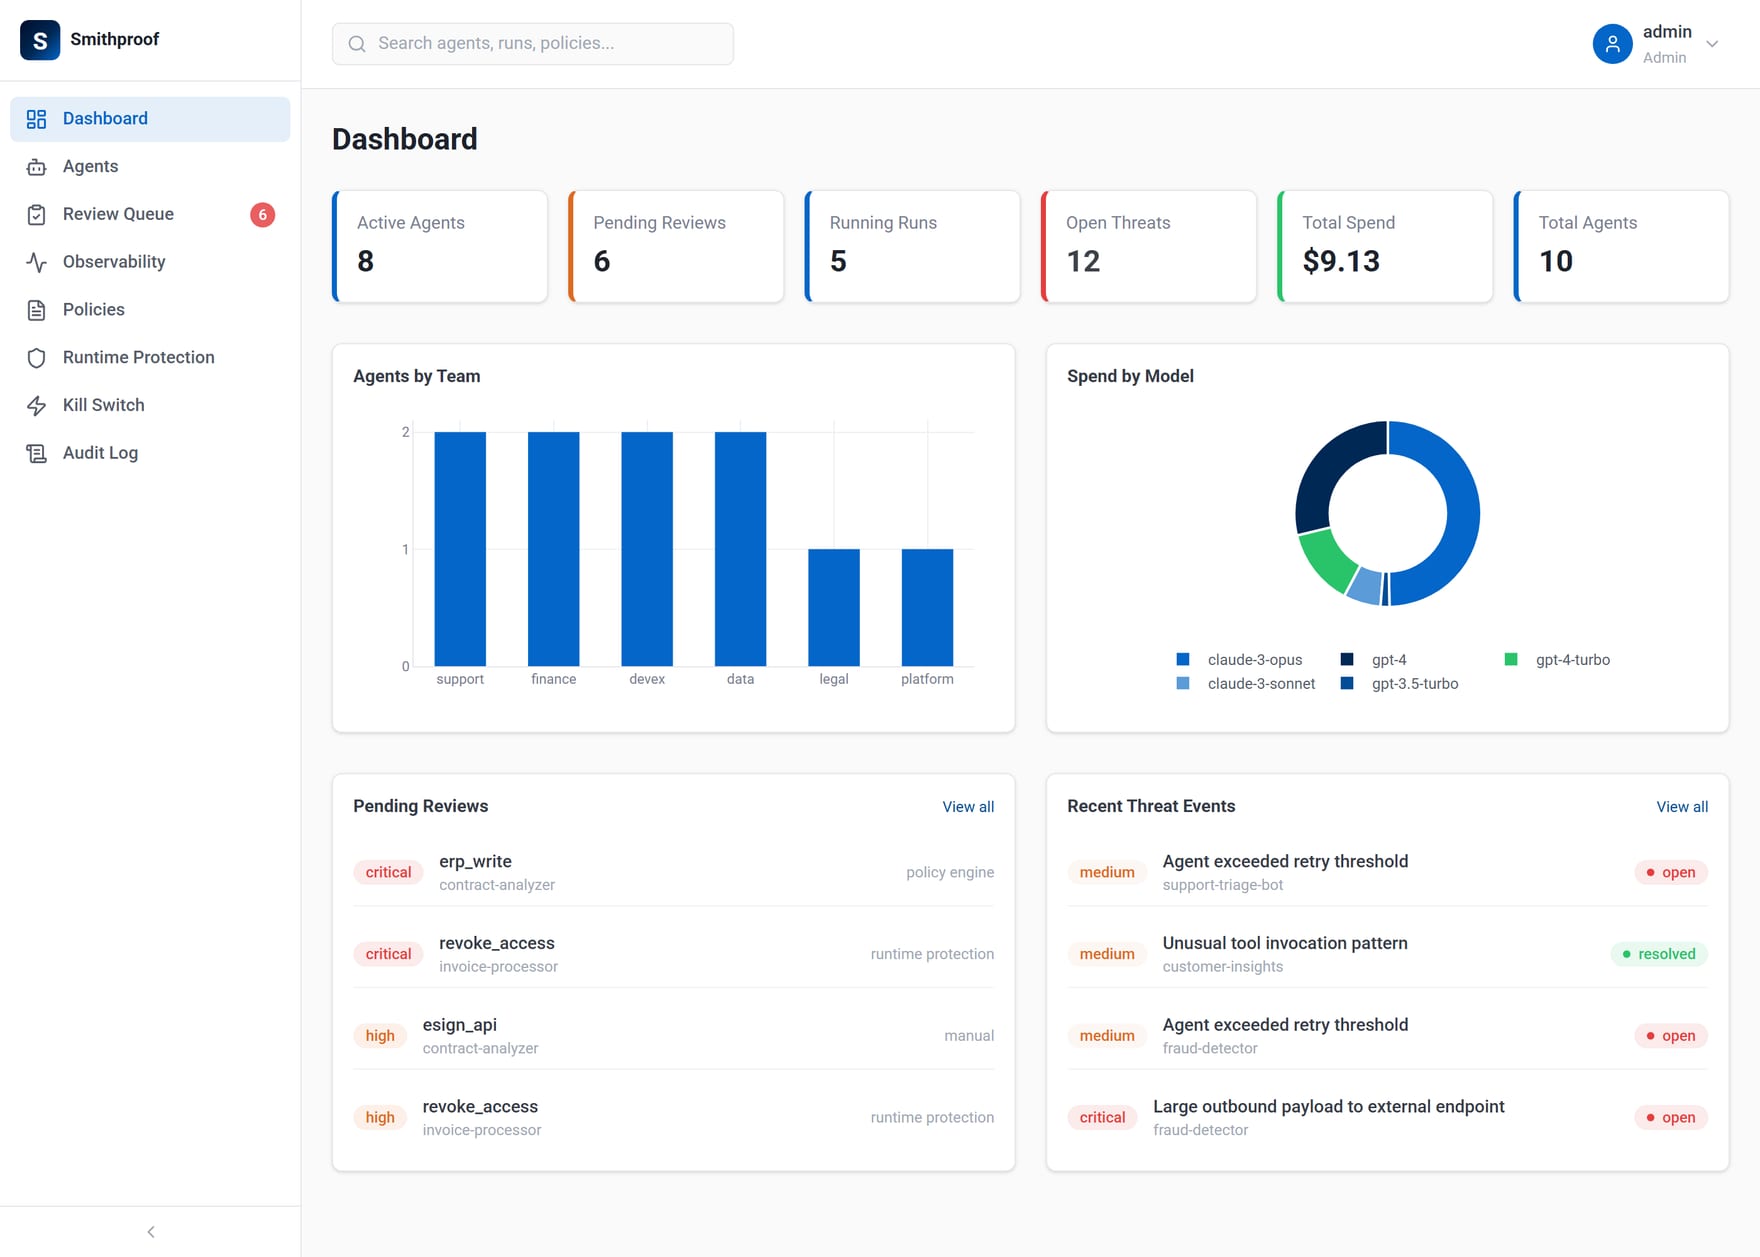 Registre, observabilité, politique et audit sur un seul écran.
De quoi est fait un plan de contrôle
Le modèle de domaine constitue l'essentiel de la conception. Voici la forme sur laquelle je me suis arrêté :
| Sous-système | Responsable de |
|---|---|
| Registre d'agents | Les agents avec leur responsable, équipe, environnement, outils, modèles, risque, versions |
| Moteur de politiques | Les règles d'accès aux modèles/outils et de dépense, dont la portée va du global au niveau de chaque agent |
| Observabilité | Les exécutions, les spans, les appels de modèles, les appels d'outils, les tokens, la latence, le coût |
| Protection à l'exécution | Les détecteurs qui produisent des événements de menace et déclenchent des réponses |
| Revue humaine | Les files d'approbation pour les actions à haut risque |
| Coupe-circuit | Arrêter les agents globalement ou par environnement, équipe ou agent |
| Interventions | Quarantaine, désactivation d'outils, révocation de modèles, retour arrière, le tout audité |
L'agent est la racine. Tout le reste est soit de la configuration qui appartient à l'organisation et se restreint jusqu'à un agent (politiques, détecteurs), soit de la télémétrie accrochée à une exécution : un Run a des Spans, et un span a un ModelCall ou un ToolCall. La dépense est agrégée à partir des appels de modèles. Cet unique arbre, de l'exécution au span puis à l'appel, c'est ce que stocke réellement tout produit d'observabilité pour agents, qu'il s'agisse de Langfuse, LangSmith ou d'une table maison.
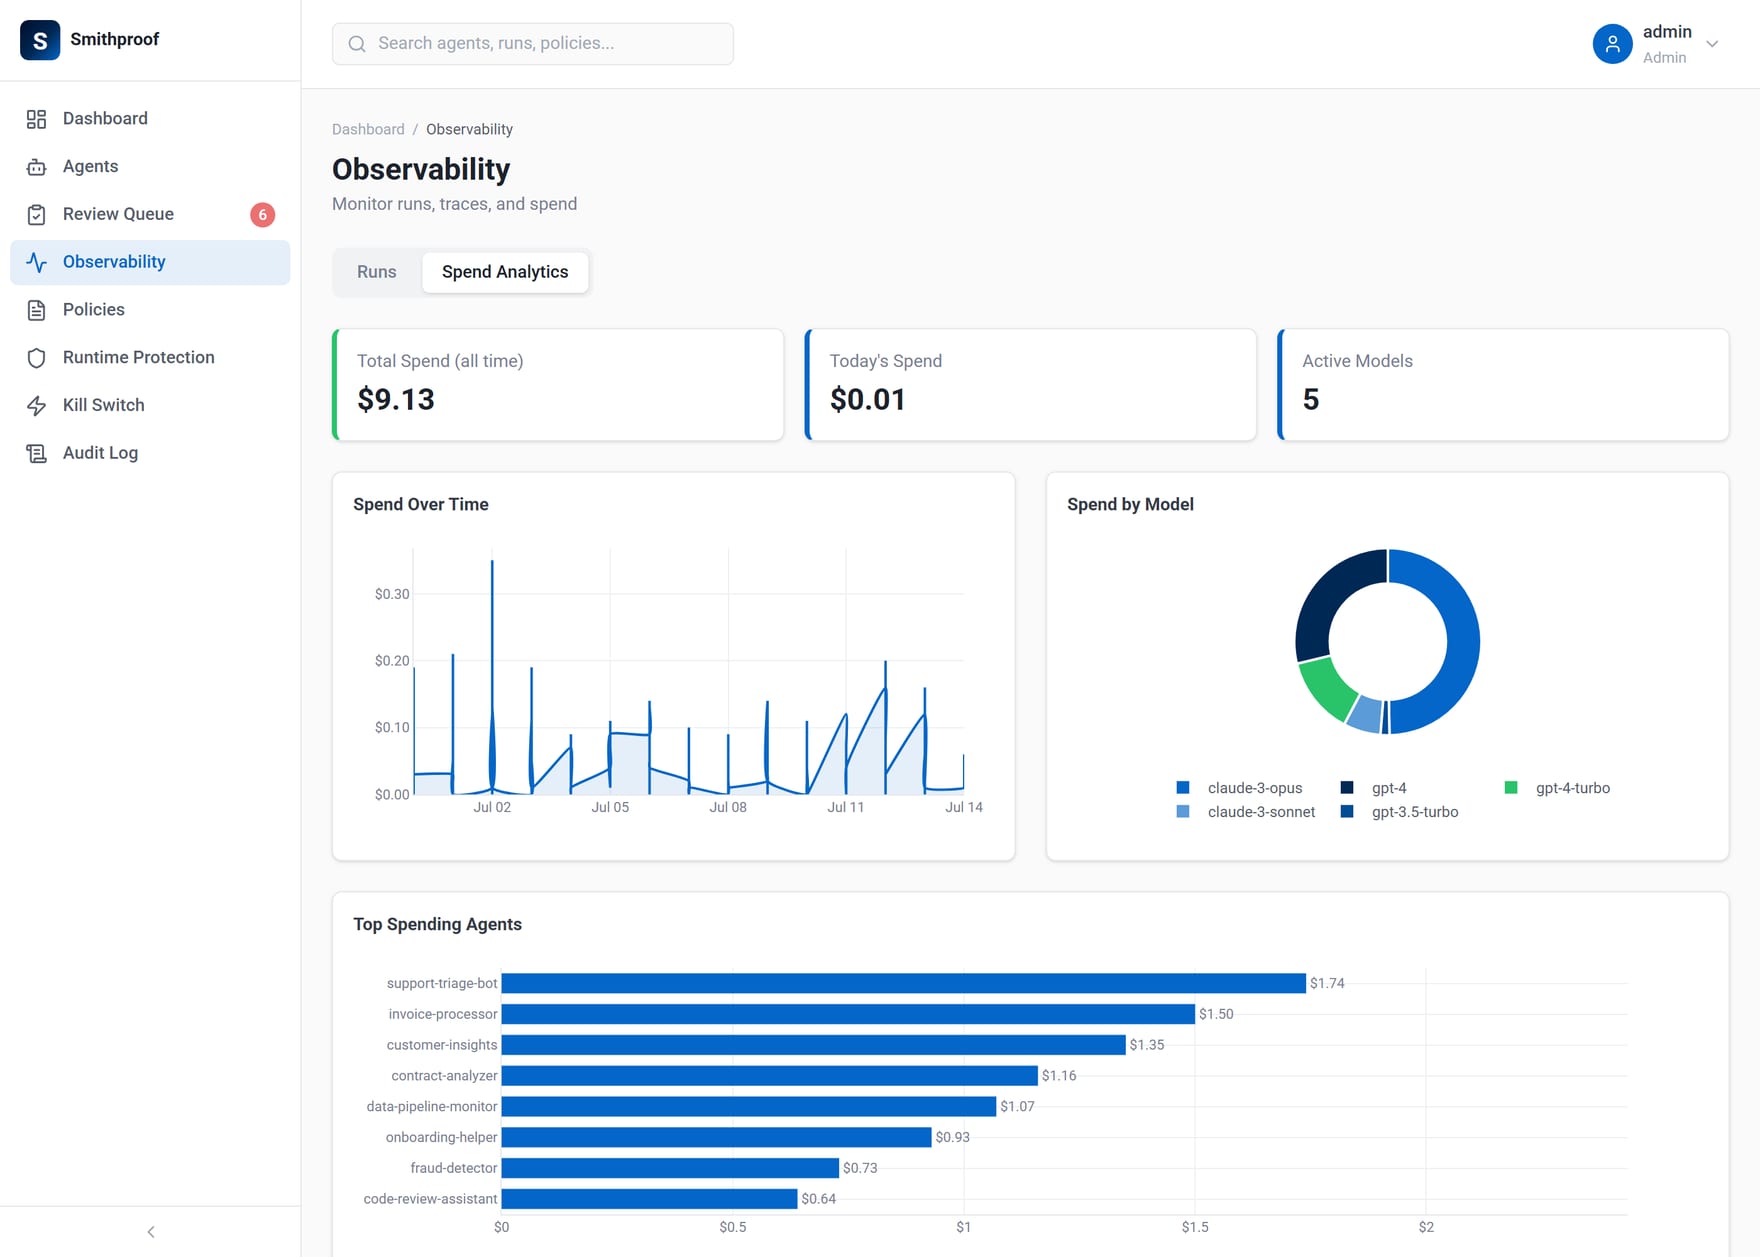 La dépense est agrégée à partir des appels de modèles enregistrés, et non pas tirée des déclarations de l'appelant, puis présentée ici au fil du temps, par modèle et par agent.
Il est utile de voir comment la catégorie a été découpée, car un plan de contrôle est une tentative de la réunifier :
| Segment | Solutions ponctuelles |
|---|---|
| Traçage et coût | Langfuse, LangSmith |
| Passerelle et routage | Portkey, LiteLLM |
| Garde-fous et analyse | Lakera, Presidio |
| Approbation humaine | HumanLayer |
| Gouvernance d'entreprise | MuleSoft Agent Fabric |
Chacune couvre bien un segment. Le pari d'un plan de contrôle, c'est qu'un registre, une console et un coupe-circuit qui les englobent tous valent davantage que leur somme, parce que la gouvernance vit dans les interstices.
Une décision, en profondeur : les garde-fous sans la taxe des 370MB
La décision d'ingénierie la plus intéressante, prise isolément, portait sur la façon de faire la détection d'injection de prompt.
L'approche standard est un petit classifieur affiné, typiquement un modèle DeBERTa entraîné à repérer les injections. Les bibliothèques clés en main qui l'encapsulent tirent PyTorch, une dépendance de plusieurs centaines de mégaoctets, au démarrage à froid lent. Pour un service dont le rôle est de se tenir discrètement à côté des agents et d'analyser, payer une taxe d'import de plus de 370MB et un préchauffage de plusieurs secondes pour un seul classifieur est le mauvais compromis.
Le scanner exécute donc le même modèle exporté vers ONNX et lancé via ONNX Runtime : une cinquantaine de lignes pour tokeniser, exécuter, lire les logits, sans PyTorch dans l'arbre de dépendances. La détection de PII repose sur Presidio avec spaCy, chargé paresseusement pour que le graphe d'imports et le chemin courant restent légers. Le compromis est explicite et mérite d'être noté : on renonce au confort de la bibliothèque tout-en-un et on prend en charge le tokeniseur et la tuyauterie d'inférence, en échange d'une empreinte de dépendances et d'un profil de latence adaptés à un plan de contrôle.
La leçon se généralise. Les garde-fous sont généralement présentés comme une question de qualité de détection. En pratique, pour une infrastructure qui s'exécute à chaque action, ce sont d'abord une question de poids des dépendances et de latence. Le modèle que l'on peut se permettre d'exécuter en ligne est celui qui gouverne ; le modèle plus précis que l'on doit reléguer dans une file gouverne moins.
La partie que tout le monde sous-estime
Voici ce que je tiens le plus à transmettre.
La détection sans réponse ne gouverne rien. Il est facile de construire des détecteurs qui produisent un événement de menace et une ligne dans un tableau de bord. Cela donne l'impression d'une protection. Ce n'en est pas une. Un détecteur configuré pour mettre un agent en quarantaine doit réellement le mettre en quarantaine ; une alerte doit se déclencher. Le câblage entre « une menace a été détectée » et « la flotte a changé d'état et un humain a été prévenu » est le vrai travail, et il est invisible dans une démo. Un plan de contrôle où la moitié « réponse » du duo détecter-répondre n'est pas branchée est une capture d'écran très convaincante de protection.
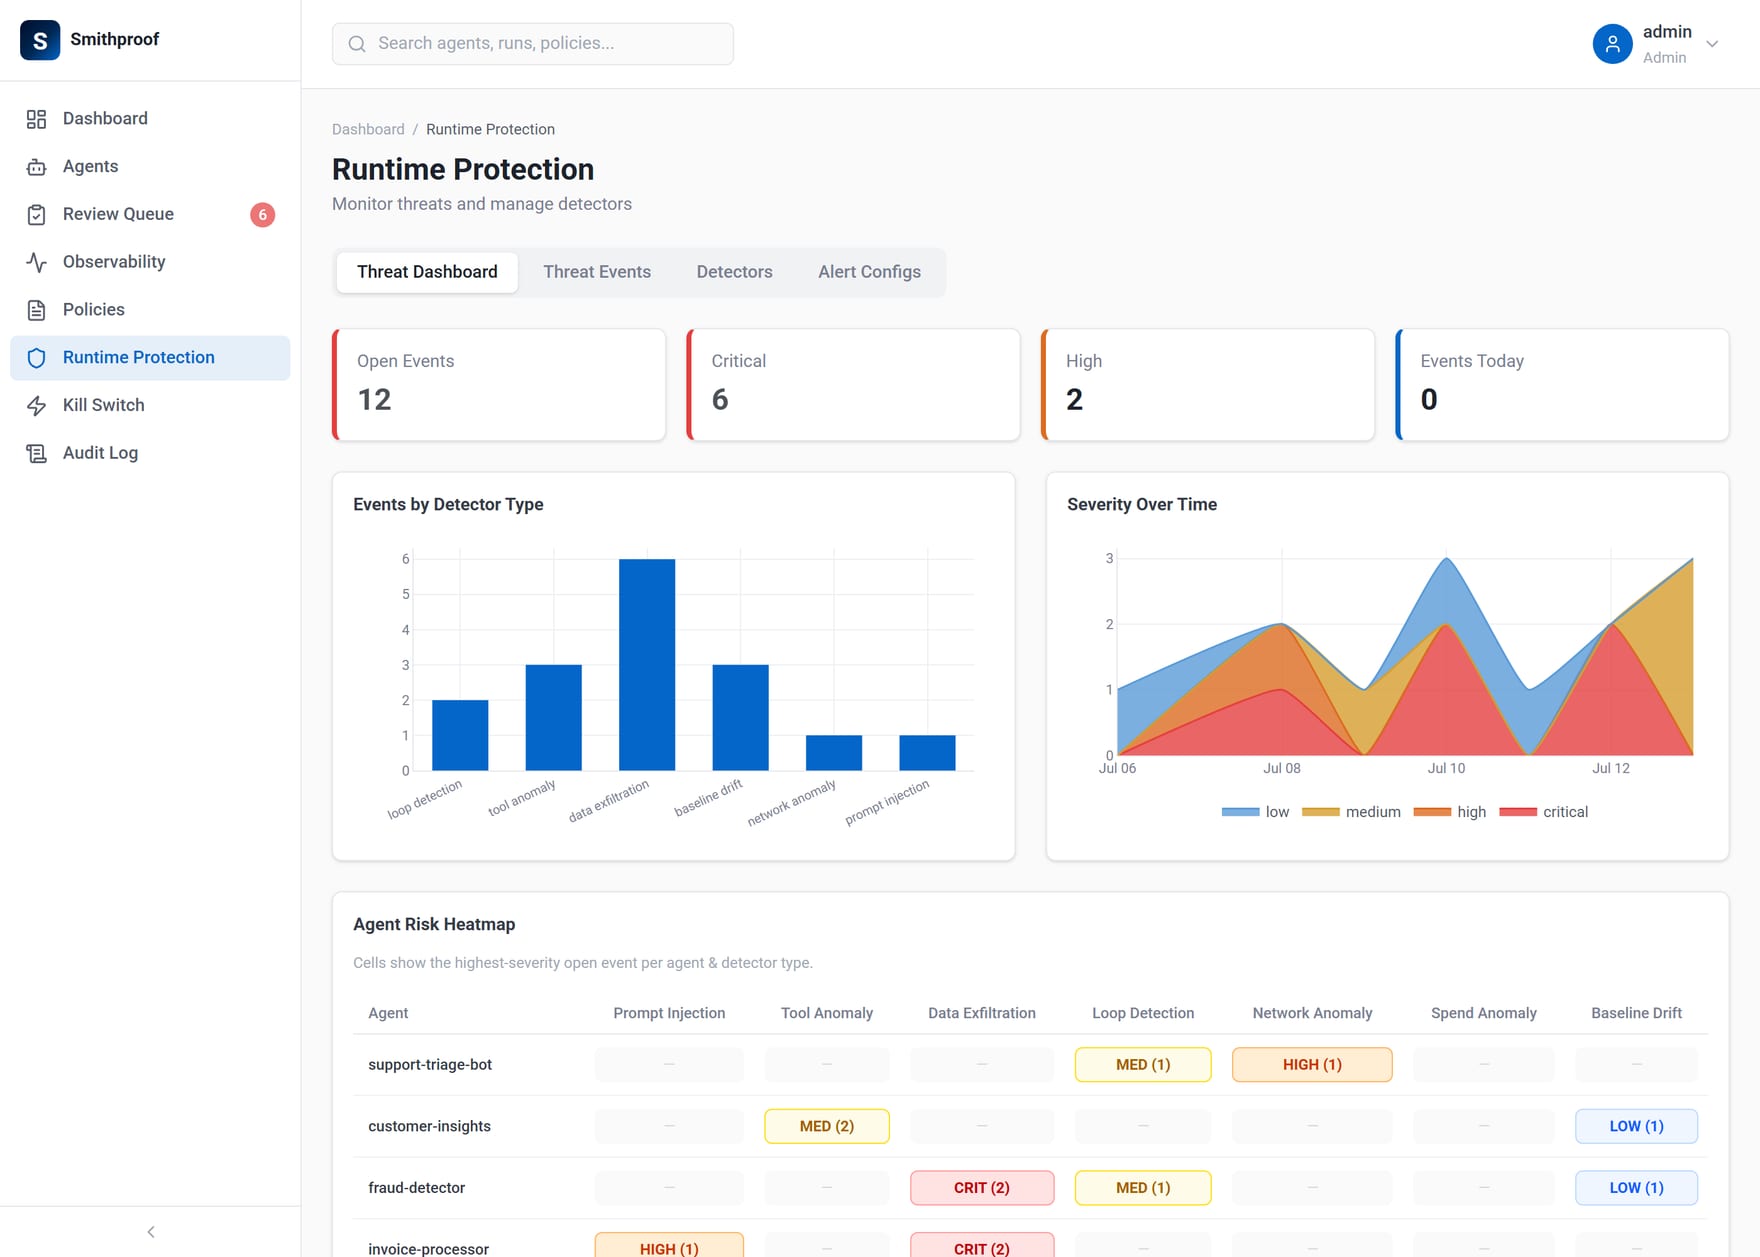 Chaque événement sur cet écran n'est réel que dans la mesure où une réponse est câblée derrière lui.
Une politique est une décision ; l'application est une architecture. C'est la version plus profonde du même point, et la frontière qu'il vaut le plus la peine de tracer avec précision quand on conçoit l'un de ces systèmes. Un plan de contrôle qui gouverne à partir de la télémétrie rapportée est un system of record : réel pour l'observation, l'attribution et la réponse a posteriori (quarantaine, coupe-circuit, revue humaine).
La prévention est une propriété différente, et elle vient d'un autre endroit de l'architecture : le chemin de la requête. Portkey et LiteLLM se placent entre l'appelant et le modèle, de sorte qu'un DENY est appliqué avant que l'appel n'ait lieu, au lieu d'être renvoyé comme un simple conseil. Les recommandations d'Anthropic sur la construction d'agents efficaces méritent d'être relues ici : plus on accorde d'autonomie, plus les contrôles doivent être structurels plutôt que consultatifs.
Dans Smithproof, le moteur de politiques produit déjà la décision ; le SDK de passerelle qui porte cette décision dans le chemin est la couche suivante, et toute la conception a été pensée pour qu'il s'y insère au lieu d'être boulonné par-dessus. Gardez les deux propriétés bien distinctes à l'esprit, car elles paraissent identiques dans une console tout en garantissant des choses complètement différentes.
Un coupe-circuit doit arrêter le travail nouveau, pas seulement l'ancien. « Arrêter tous les agents » est trivial à implémenter comme une mise à jour de statut sur des lignes existantes, et totalement inutile si un agent arrêté peut encore ouvrir une nouvelle exécution une seconde plus tard. L'interrupteur doit conditionner la création de travail, de sorte qu'un agent en quarantaine ou soumis à un coupe-circuit actif soit refusé dès l'entrée.
La moitié ingrate : cloisonnement, rôles, audit honnête
C'est le travail de conception le moins intéressant du produit, et c'est lui qui décide si vous pouvez le confier à un deuxième client.
Le multi-tenant, c'est là que se cachent les fuites, surtout quand il est ajouté après coup. Les entités de configuration portent directement un identifiant d'organisation ; les entités dérivées (exécutions, revues, interventions) n'appartiennent à une organisation que de façon transitive, via leur agent. Le piège, c'est l'accès par identifiant : les endpoints de liste sont faciles à cadrer, mais un GET /runs/{id} qui authentifie l'utilisateur puis récupère l'exécution par son seul identifiant, sans vérifier que l'agent de l'exécution appartient à l'organisation de l'appelant, est une lecture inter-tenant. Le correctif est ennuyeux et doit être partout : résoudre la chaîne de propriété sur chaque handler par identifiant et renvoyer un 404 si elle ne correspond pas. La même discipline s'applique aux effets du plan de contrôle. Une cascade de coupe-circuit ou une évaluation de politique qui n'est pas restreinte à l'organisation qui agit arrêtera ou gouvernera allègrement la flotte de quelqu'un d'autre.
Les rôles doivent être appliqués, pas décoratifs. Trois rôles, lecteur, opérateur, administrateur, ne sont réels que si le serveur rejette un opérateur qui tente de supprimer un agent et un lecteur qui tente quoi que ce soit. Un rôle que l'interface lit et que l'API ignore n'est pas du contrôle d'accès.
L'identité d'audit ne peut pas venir du client. L'acteur inscrit dans un journal d'interventions « immuable » doit être dérivé de la session authentifiée. Si le serveur prend performed_by dans le corps de la requête, le journal est une fiction : n'importe qui peut attribuer l'activation d'un coupe-circuit à un collègue. C'est une décision d'une seule ligne avec un effet démesuré sur le fait que la piste d'audit signifie quelque chose ou non.
Les plafonds de budget doivent lire de vrais chiffres. Une limite de dépense qui fait confiance à une valeur current_spend fournie par l'appelant se contourne en omettant le champ. La plateforme agrège déjà la dépense à partir des appels de modèles enregistrés ; le plafond doit lire cela, pas la requête.
Une URL de webhook est un identifiant. Les canaux d'alerte sont configurés avec des URL de webhook, et une URL de webhook Slack est un secret au porteur : quiconque la lit peut publier en votre nom. Cela fait de la configuration des alertes un petit coffre à identifiants, et elle mérite d'être traitée comme tel : les secrets chiffrés au repos (AES-256-GCM, avec une clé dérivée du secret de l'application), déchiffrés juste à temps pour l'envoi, et jamais renvoyés par l'API, qui envoie un masque à leur place. Il faut rendre à César : celui-ci est parti de la proposition d'un contributeur externe que j'ai intégrée, ce qui est en soi une petite leçon sur la moitié ingrate. C'est là qu'un regard neuf voit le plus clair.
Où en est le projet
Aujourd'hui, Smithproof est un system of record multi-tenant doté d'une gouvernance active : les agents rapportent leur télémétrie via REST, et la plateforme la stocke, la visualise, l'analyse et intervient par la quarantaine, les alertes, l'approbation humaine et un coupe-circuit qui arrête les nouvelles exécutions dès l'entrée. La couche suivante est la passerelle en ligne qui déplace les décisions de politique dans le chemin de la requête, et l'architecture a été bâtie avec cet interstice déjà prêt : le moteur de politiques rend déjà le verdict, et le rôle de la passerelle est de se tenir là où elle peut agir sur ce verdict.
S'il y a une chose à retenir de cette construction : les vingt pour cent intéressants d'un plan de contrôle, ce sont la détection et la politique, et c'est la partie que l'on montre en démo. Les quatre-vingts pour cent qui décident s'il gouverne quoi que ce soit, ce sont la réponse, l'application, le cloisonnement, les rôles et l'audit honnête. Rien de tout cela ne se photographie bien. Tout cela est le produit. Et si le nom fait son travail, il garde les enjeux en vue : le but, c'est une flotte où aucun agent, aussi capable soit-il, ne peut faire son Agent Smith.
Les questions auxquelles cet article répond
Pourquoi construire un plan de contrôle alors que Langfuse, Portkey et Lakera existent déjà ?
Chacun de ces outils couvre bien un segment : traçage et coût, passerelle et routage, garde-fous et analyse, approbation humaine. Le pari d'un plan de contrôle, c'est qu'un registre, une console et un coupe-circuit qui les englobent tous valent davantage que leur somme, parce que la gouvernance vit dans les interstices. Arrêter tous les agents qui ont touché à l'outil de facturation cette heure-ci et savoir qui a approuvé cela, c'est quatre questions dans quatre produits, ou une seule requête au même endroit.
Comment faire de la détection d'injection de prompt sans embarquer PyTorch dans le service ?
En exportant le même classifieur DeBERTa affiné vers ONNX et en l'exécutant via ONNX Runtime, soit une cinquantaine de lignes pour tokeniser, exécuter et lire les logits, sans PyTorch dans l'arbre de dépendances. Les bibliothèques clés en main qui l'encapsulent coûtent une taxe d'import de plus de 370MB et un préchauffage de plusieurs secondes, ce qui est le mauvais compromis pour un service qui analyse chaque action. La détection de PII repose sur Presidio avec spaCy, chargé paresseusement pour que le chemin courant reste léger. Le prix à payer, c'est de prendre en charge soi-même le tokeniseur et la tuyauterie d'inférence.
Un coupe-circuit arrête-t-il vraiment un agent devenu incontrôlable ?
Seulement s'il conditionne la création de travail. Arrêter tous les agents est trivial à implémenter comme une mise à jour de statut sur des lignes existantes et totalement inutile si un agent arrêté peut ouvrir une nouvelle exécution une seconde plus tard, donc un agent en quarantaine ou soumis à un coupe-circuit actif doit être refusé dès l'entrée. La même discipline de cadrage vaut pour la cascade elle-même : un coupe-circuit qui n'est pas restreint à l'organisation qui agit arrêtera allègrement la flotte de quelqu'un d'autre.
Où se cachent les fuites entre tenants dans une plateforme de ce type ?
Dans l'accès par identifiant. Les entités de configuration portent directement un identifiant d'organisation, mais les entités dérivées comme les exécutions, les revues et les interventions n'appartiennent à une organisation que de façon transitive, via leur agent, si bien qu'un handler qui authentifie l'utilisateur puis récupère une exécution par son seul identifiant est une lecture inter-tenant. Le correctif est ennuyeux et doit être partout : résoudre la chaîne de propriété sur chaque handler par identifiant et renvoyer un 404 quand elle ne correspond pas.
À lire ensuite
 AI Agents
J'ai construit une couche d'IA qui ne répond jamais. Voici ce qu'exige vraiment une bonne question
Notes de terrain sur OrbitSpec, un moteur de clarification qui transforme les demandes vagues en Context Bundles typés et auditables avant qu'aucun modèle ne tourne, et pourquoi la fiabilité commence avant la réponse. AI Agents
J'ai construit le pipeline qui a construit mon produit. Voici ce que déléguer exige vraiment
Notes de terrain sur plan-to-pr, un pipeline qui transforme une demande de fonctionnalité en tickets, en un point de contrôle d'approbation et en pull requests en brouillon, et pourquoi déléguer à des agents de code demande des artefacts, pas du chat.