
Ho costruito un control plane per agenti AI. Ecco cosa serve davvero per governarli
Ascolta l'articolo (sperimentale) · 14:05
In un post precedente ho descritto il panorama dei framework per agenti e, verso la fine, un livello di governance: un registro, un broker, le policy e l'osservabilità posti sopra una flotta di agenti. Quella era la versione astratta, presa in prestito da ciò che strumenti come MuleSoft Agent Fabric promettono in una slide.
Poi ne ho costruito uno, un control plane chiamato Smithproof, per scoprire cosa la slide tralascia. Questo è il resoconto sul campo. Non è un lancio e non è un tutorial. È l'insieme delle cose che direi a chi sta per costruire la governance degli agenti e pensa che la parte difficile siano il rilevamento e le policy. La parte difficile è tutto ciò che trasforma rilevamento e policy in qualcosa che governa davvero.
Il nome è un obiettivo di progettazione
In The Matrix, Agent Smith all'inizio è un programma che fa esattamente ciò per cui è stato costruito. Poi si libera dai suoi vincoli, comincia a perseguire un proprio obiettivo e si replica su ogni programma e persona che tocca, finché l'agente incaricato di far rispettare le regole del sistema è diventato la minaccia più grande del sistema stesso. È l'immagine più nitida che la narrativa abbia prodotto della modalità di fallimento su cui la ricerca sulla sicurezza dell'AI continua a tornare: non un nemico esterno, ma un processo autonomo di cui ci si fida, i cui obiettivi si allontanano dal previsto e il cui raggio d'impatto si moltiplica.
Sostituisci la simulazione con un ambiente di produzione e l'immagine regge. Un agente con accesso agli strumenti, credenziali e nessuna supervisione è a un solo prompt sbagliato dal suo piccolo momento alla Smith: agire fuori dal proprio mandato, a velocità di macchina, con le tue chiavi API. Smithproof prende il nome dalla proprietà che la piattaforma esiste per fornire. Una flotta è Smith-proof quando ogni agente al suo interno è inventariato, osservato, governato e arrestabile, così che nessun singolo agente possa diventare in silenzio il sistema.
Perché serve un control plane
I team che mettono in produzione agenti convergono sulle stesse cinque lacune:
- Nessun inventario di quali agenti esistono o di chi ne è responsabile.
- Nessuna visibilità su ciò che un agente ha fatto a runtime: chiamate ai modelli, chiamate agli strumenti, costi.
- Nessuna applicazione delle policy. Un agente raggiunge tutto ciò che riesce a raggiungere.
- Nessun rilevamento di prompt injection, picchi di costo o loop fuori controllo.
- Nessun kill switch, e nessuna traccia di chi è intervenuto quando qualcosa è andato storto.
Ognuna di queste lacune ha una buona soluzione puntuale. La ragione per unificarle è che le domande di governance attraversano quei confini. "Ferma ogni agente che ha toccato lo strumento di fatturazione in quest'ora, e dimmi chi lo ha approvato" è al tempo stesso una domanda per il registro, una per l'osservabilità, una per le policy e una per l'audit. Un control plane è il luogo in cui quelle quattro possono essere un'unica query.
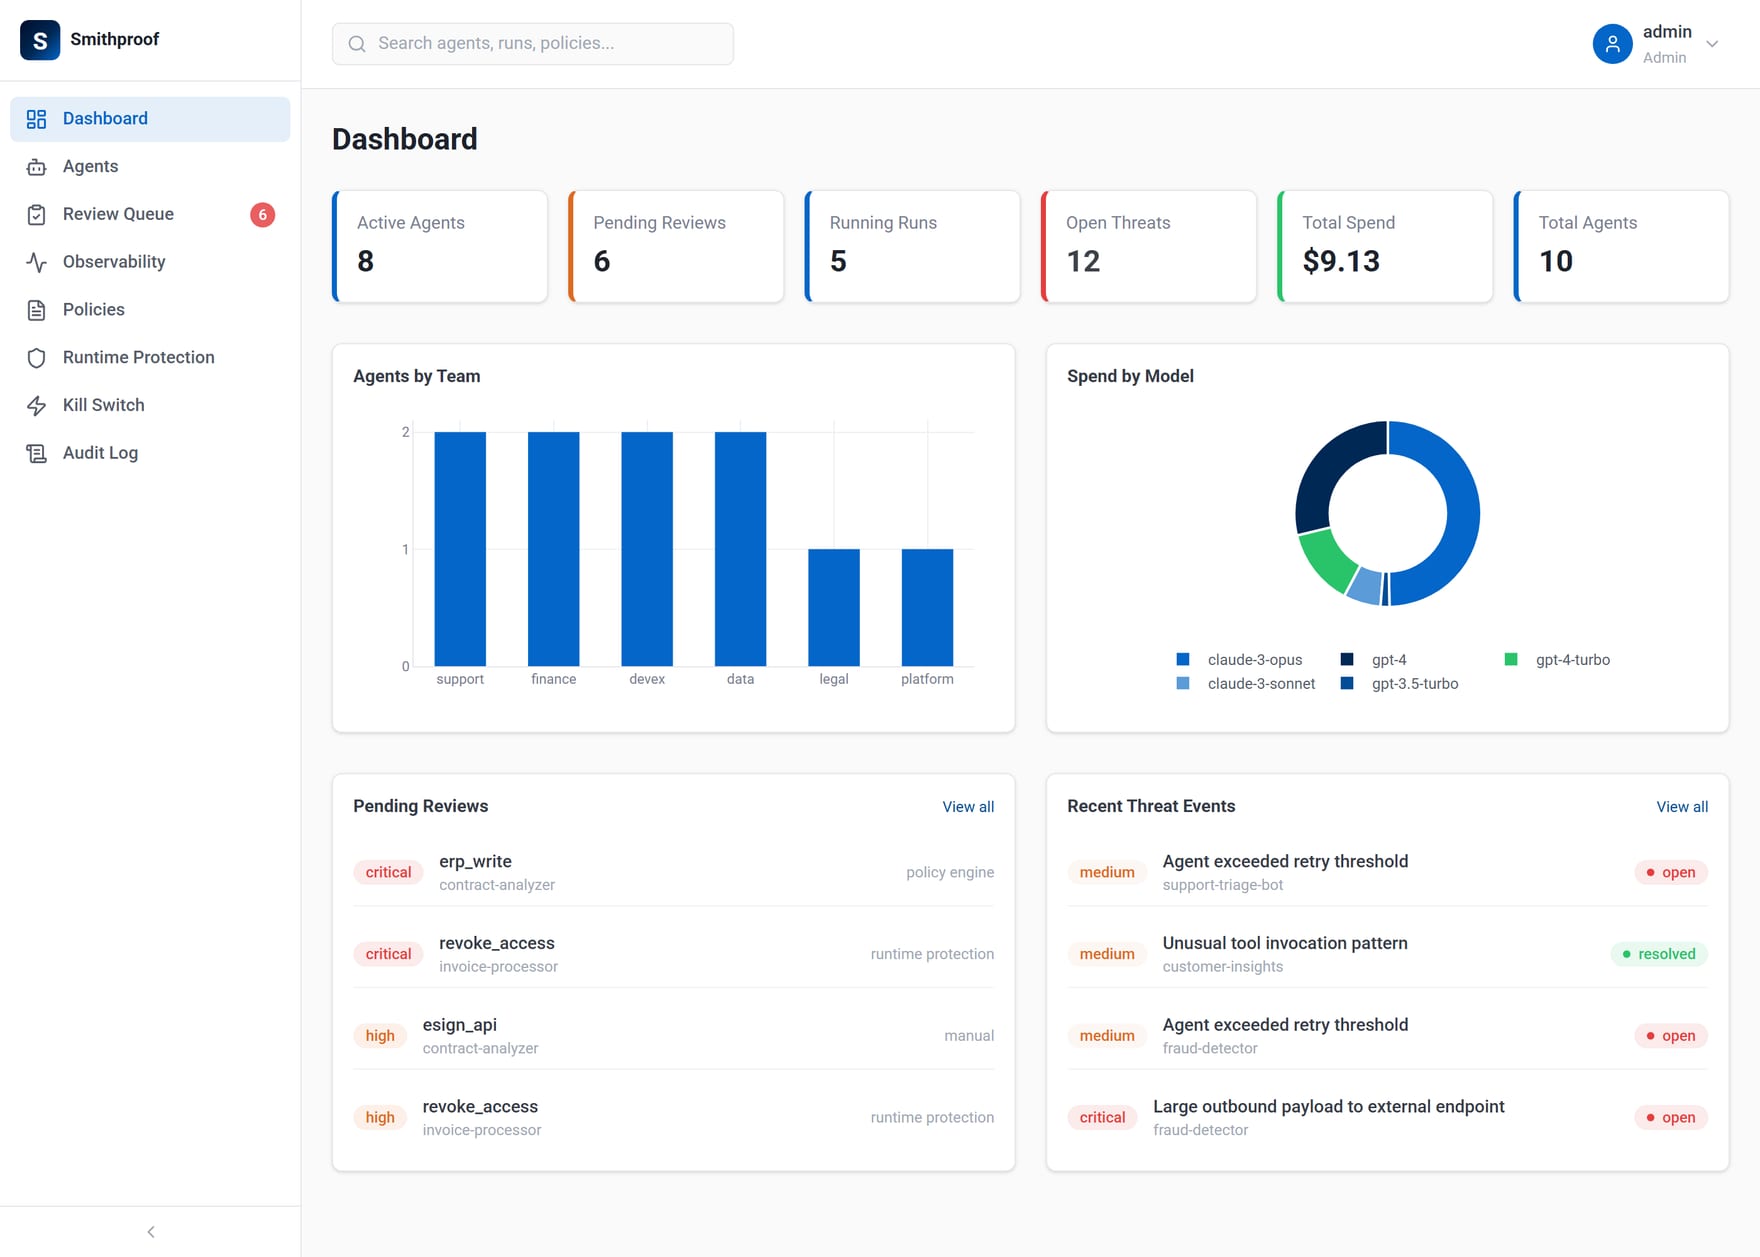 Registro, osservabilità, policy e audit su un'unica schermata.
Di cosa è fatto un control plane
Il modello di dominio è la maggior parte del progetto. Ecco la forma su cui mi sono fermato:
| Sottosistema | Gestisce |
|---|---|
| Registro degli agenti | Agenti con proprietario, team, ambiente, strumenti, modelli, rischio, versioni |
| Motore delle policy | Regole per l'accesso a modelli/strumenti e per la spesa, con ambito dal globale al singolo agente |
| Osservabilità | Run, span, chiamate ai modelli, chiamate agli strumenti, token, latenza, costi |
| Protezione a runtime | Rilevatori che producono eventi di minaccia e attivano risposte |
| Revisione umana | Code di approvazione per le azioni ad alto rischio |
| Kill switch | Fermare gli agenti globalmente o per ambiente, team o agente |
| Interventi | Quarantena, disabilitazione degli strumenti, revoca dei modelli, rollback, tutto tracciato |
L'agente è la radice. Tutto il resto è o configurazione che appartiene all'organizzazione e viene ridotta di ambito fino al singolo agente (policy, rilevatori), oppure telemetria appesa a una run: una Run ha degli Span, e uno span ha un ModelCall o un ToolCall. La spesa è aggregata a partire dalle chiamate ai modelli. Quell'unico albero, dalla run allo span alla chiamata, è ciò che ogni prodotto di osservabilità per agenti sta davvero memorizzando, che si tratti di Langfuse, LangSmith o una tabella fatta in casa.
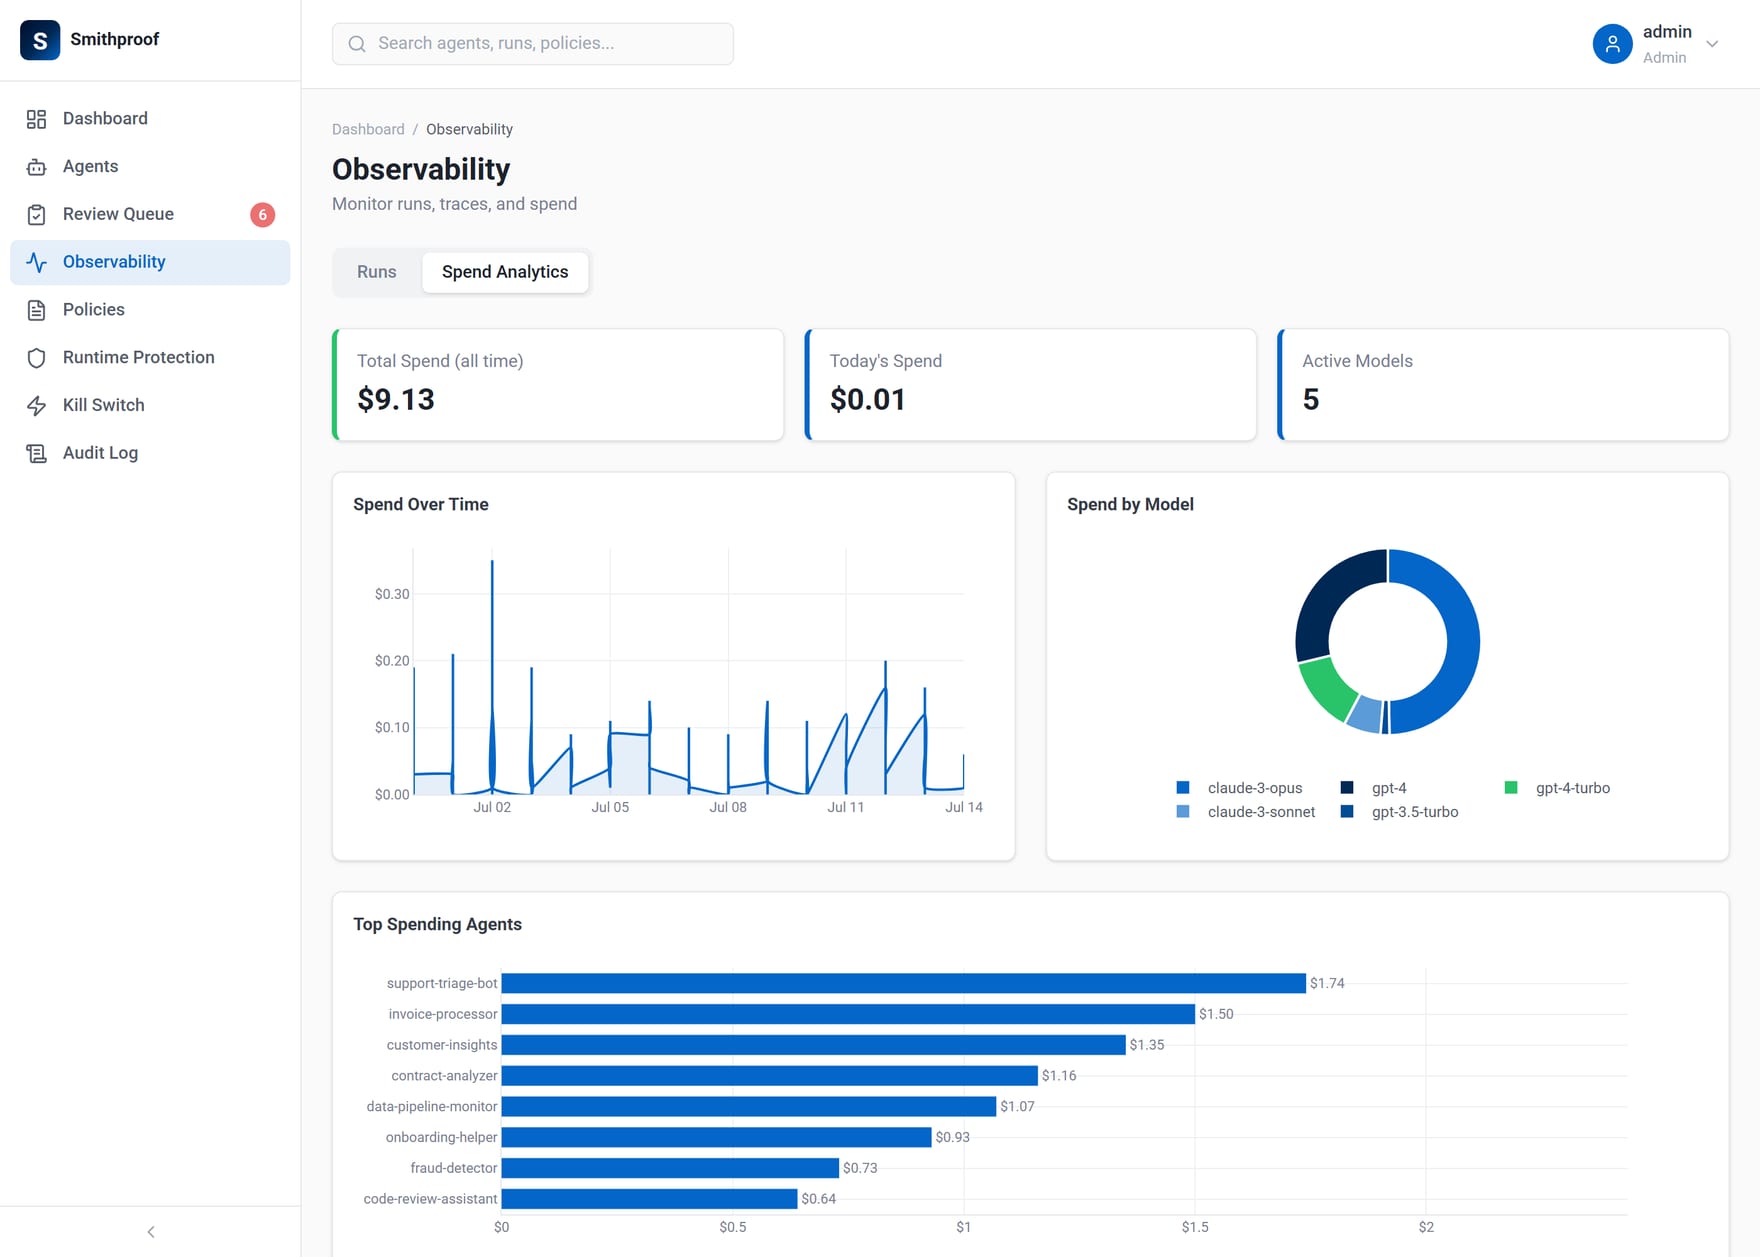 La spesa è aggregata dalle chiamate ai modelli registrate, non presa per buona dal chiamante, e mostrata qui nel tempo, per modello e per agente.
Aiuta vedere in che modo la categoria è stata suddivisa, perché un control plane è un tentativo di riunificarla:
| Segmento | Soluzioni puntuali |
|---|---|
| Tracciamento e costi | Langfuse, LangSmith |
| Gateway e routing | Portkey, LiteLLM |
| Guardrail e scansione | Lakera, Presidio |
| Approvazione umana | HumanLayer |
| Governance enterprise | MuleSoft Agent Fabric |
Ognuna fa bene un segmento. La scommessa di un control plane è che un registro, una console e un kill switch che li attraversano tutti valgano più della somma, perché la governance vive nelle giunture.
Una decisione, in profondità: guardrail senza la tassa dei 370MB
La singola scelta ingegneristica più interessante è stata come fare il rilevamento della prompt injection.
L'approccio standard è un piccolo classificatore messo a punto, di solito un modello DeBERTa addestrato a individuare le injection. Le librerie preconfezionate che lo incapsulano trascinano con sé PyTorch, una dipendenza da centinaia di megabyte con un avvio a freddo lento. Per un servizio il cui compito è starsene tranquillo accanto agli agenti e scansionare, pagare una tassa d'importazione di oltre 370MB e un riscaldamento di diversi secondi per un solo classificatore è il compromesso sbagliato.
Così lo scanner esegue lo stesso modello esportato in ONNX ed eseguito tramite ONNX Runtime: una cinquantina di righe di tokenizzazione, esecuzione, lettura dei logit, senza PyTorch nell'albero delle dipendenze. Il rilevamento dei PII è affidato a Presidio con spaCy, caricato in modo lazy così che il grafo delle importazioni e il percorso comune restino leggeri. Il compromesso è esplicito e vale la pena metterlo nero su bianco: rinunci alla comodità della libreria con tutto incluso e ti prendi il compito di gestire in prima persona il tokenizzatore e il codice di collegamento per l'inferenza, in cambio di un ingombro di dipendenze e di un profilo di latenza adatti a un control plane.
La lezione si generalizza. I guardrail vengono di solito presentati come una questione di qualità del rilevamento. In pratica, per un'infrastruttura che viene eseguita a ogni azione, sono prima di tutto una questione di peso delle dipendenze e di latenza. Il modello che puoi permetterti di eseguire inline è il modello che governa; quello più accurato che devi rimandare a una coda governa di meno.
La parte che tutti sottovalutano
Ecco la cosa che più di tutte voglio trasmettere.
Il rilevamento senza risposta non governa nulla. È facile costruire rilevatori che producono un evento di minaccia e una riga in dashboard. Sembra protezione. Non lo è. Un rilevatore configurato per mettere in quarantena un agente deve davvero metterlo in quarantena; un avviso deve scattare. Il cablaggio che porta da "è stata rilevata una minaccia" a "la flotta ha cambiato stato e una persona è stata avvisata" è il lavoro vero, ed è invisibile in una demo. Un control plane in cui la metà "risposta" del rileva-e-rispondi non è collegata è uno screenshot molto convincente di protezione.
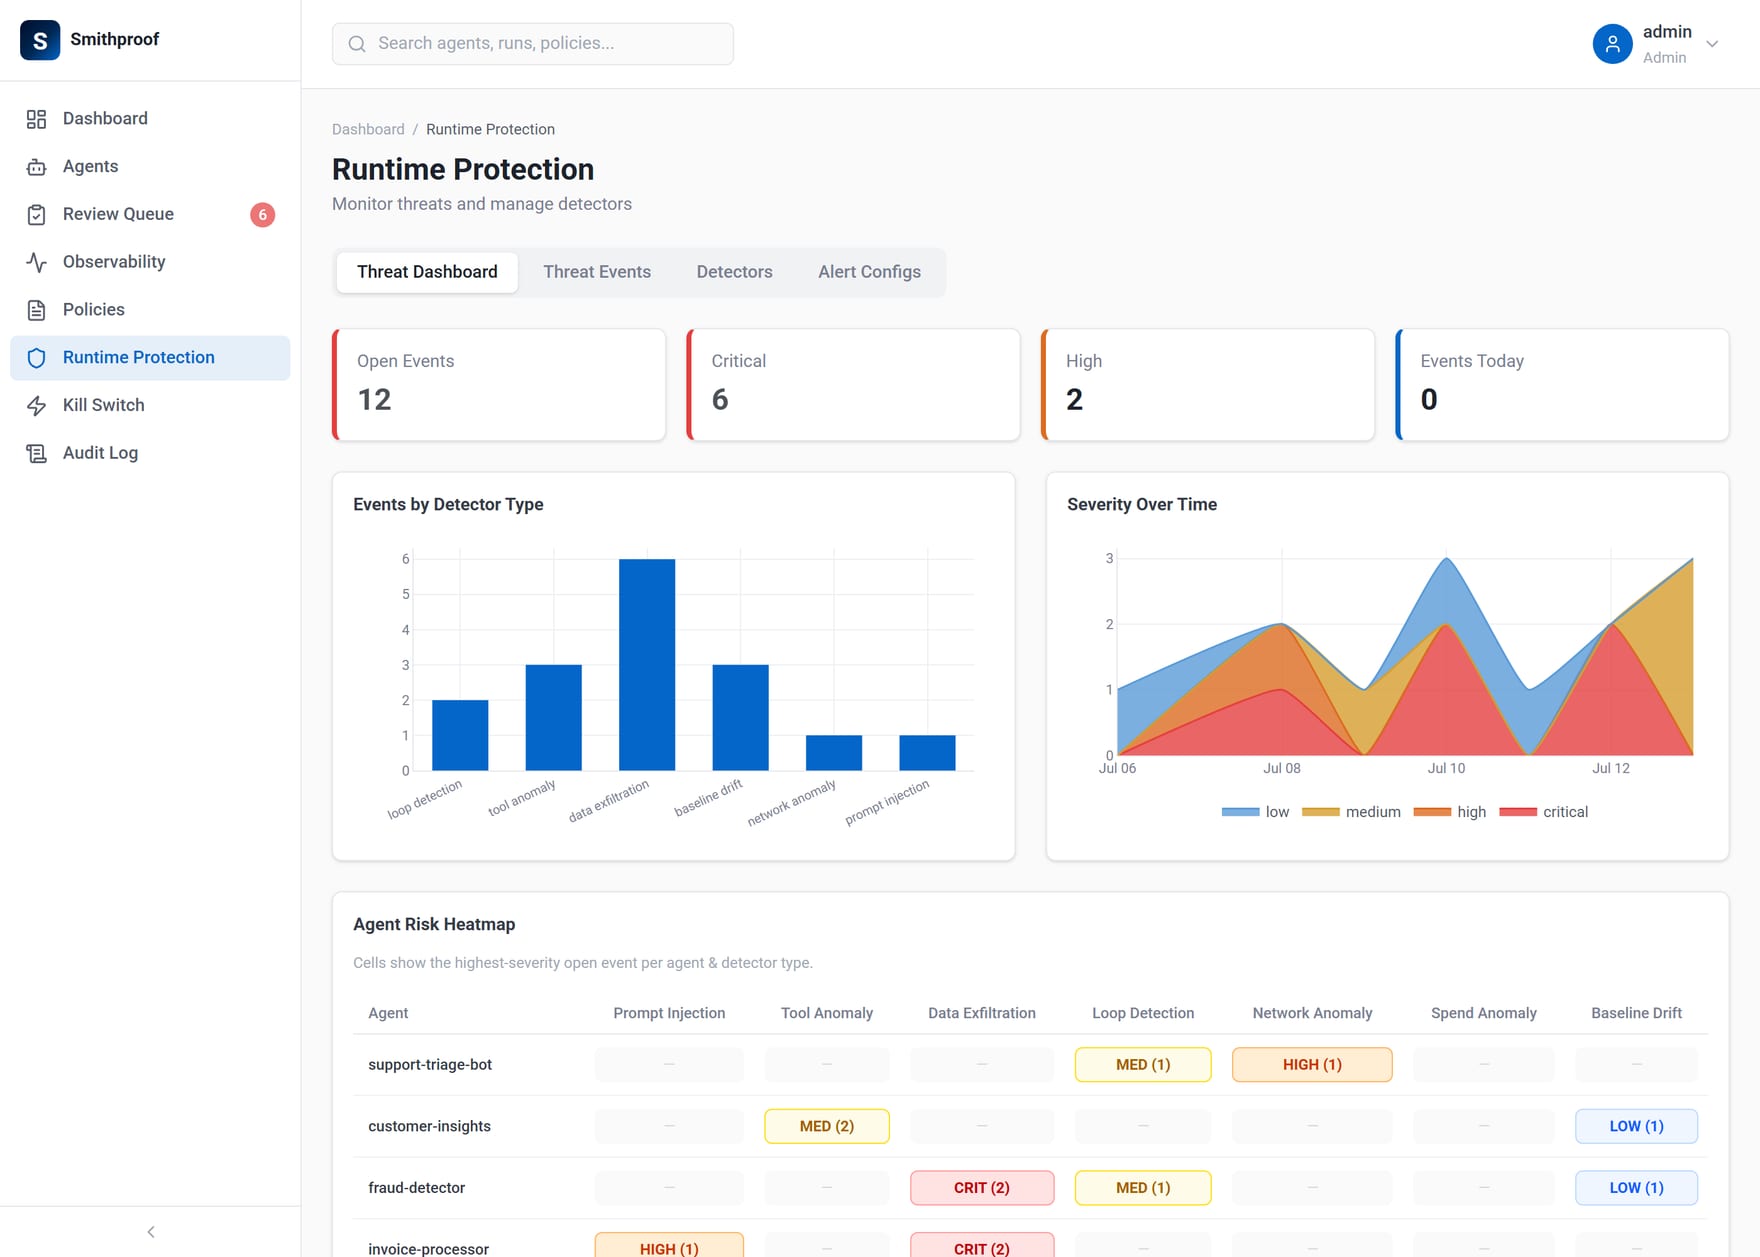 Ogni evento su questa schermata è reale solo quanto la risposta cablata dietro di esso.
Una policy è una decisione; l'applicazione è un'architettura. Questa è la versione più profonda dello stesso punto, ed è il confine che vale la pena tracciare con la massima precisione quando ne progetti uno. Un control plane che governa attraverso la telemetria riportata è un system of record: reale per l'osservazione, l'attribuzione e la risposta a posteriori (quarantena, kill switch, revisione umana).
La prevenzione è una proprietà diversa, e viene da un punto diverso dell'architettura: il percorso della richiesta. Portkey e LiteLLM si collocano tra il chiamante e il modello, così un DENY viene applicato prima che la chiamata avvenga anziché restituito come consiglio. La guida di Anthropic su come costruire agenti efficaci vale la pena rileggerla qui: più autonomia concedi, più i controlli devono essere strutturali anziché consultivi.
In Smithproof il motore delle policy produce già la decisione; l'SDK del gateway che sposta quella decisione nel percorso è il livello successivo, e l'intero progetto è stato modellato perché si integri in modo naturale anziché essere avvitato sopra. Tieni ben distinte le due proprietà, perché in una console appaiono identiche e garantiscono cose completamente diverse.
Un kill switch deve fermare il lavoro nuovo, non solo quello vecchio. "Ferma tutti gli agenti" è banale da implementare come aggiornamento di stato sulle righe esistenti ed è del tutto inutile se un agente fermato può comunque aprire una nuova run un secondo dopo. L'interruttore deve fare da filtro alla creazione del lavoro, così che un agente in quarantena o uno sotto un kill switch attivo venga respinto all'ingresso.
La metà poco affascinante: tenancy, ruoli, audit onesto
È il lavoro di progettazione meno interessante del prodotto, ed è quello che decide se puoi darlo a un secondo cliente.
La multi-tenancy è il punto in cui si nascondono le fughe di dati, soprattutto quando viene aggiunta in un secondo momento. Le entità di configurazione portano direttamente un id di organizzazione; le entità derivate (run, revisioni, interventi) appartengono a un'organizzazione solo in modo transitivo, attraverso il loro agente. La trappola è l'accesso per id: gli endpoint di elenco sono facili da limitare, ma un GET /runs/{id} che autentica l'utente e poi recupera la run solo tramite id, senza verificare che l'agente della run appartenga all'organizzazione del chiamante, è una lettura cross-tenant. La correzione è noiosa e deve essere ovunque: risolvere la catena di proprietà in ogni handler per id e restituire un 404 se non corrisponde. La stessa disciplina vale per gli effetti del control plane. Una cascata di kill switch o una valutazione delle policy che non sia limitata all'organizzazione che agisce fermerà o governerà allegramente la flotta di qualcun altro.
I ruoli vanno applicati, non decorati. Tre ruoli, viewer, operator, admin, sono reali solo se il server rifiuta un operator che prova a eliminare un agente e un viewer che prova qualsiasi cosa. Un claim di ruolo che la UI legge e l'API ignora non è controllo degli accessi.
L'identità per l'audit non può venire dal client. L'attore su un registro di interventi "immutabile" deve essere derivato dalla sessione autenticata. Se il server prende performed_by dal corpo della richiesta, il registro è finzione: chiunque può attribuire l'attivazione di un kill switch a un collega. È una decisione da una riga con un effetto sproporzionato sul fatto che la traccia di audit significhi qualcosa.
I tetti di budget devono leggere numeri reali. Un limite di spesa che si fida di un valore current_spend fornito dal chiamante si aggira omettendo il campo. La piattaforma aggrega già la spesa dalle chiamate ai modelli registrate; il tetto deve leggere quella, non la richiesta.
Un URL di webhook è una credenziale. I canali di avviso vengono configurati con URL di webhook, e un URL di webhook di Slack è un bearer secret: chiunque lo legga può pubblicare come se fosse te. Questo rende la configurazione degli avvisi un piccolo archivio di credenziali, e merita di essere trattata come tale: segreti cifrati a riposo (AES-256-GCM con chiave derivata dal secret dell'applicazione), decifrati all'ultimo momento per l'invio e mai restituiti dall'API, che al loro posto invia una maschera. Onore al merito: questa è nata come proposta di un contributore esterno che ho integrato, il che è a suo modo una piccola lezione sulla metà poco affascinante. È lì che un paio di occhi freschi vede più chiaramente.
A che punto siamo
Oggi Smithproof è un system of record multi-tenant con governance attiva: gli agenti riportano la telemetria via REST, e la piattaforma la memorizza, la visualizza, la scansiona e interviene tramite quarantena, avvisi, approvazione umana e un kill switch che ferma le nuove run sul nascere. Il livello successivo è il gateway inline che sposta le decisioni delle policy nel percorso della richiesta, e l'architettura è stata costruita con quella giuntura già pronta: il motore delle policy emette già il verdetto, e il compito del gateway è collocarsi dove può agire su quel verdetto.
Se c'è una cosa da portarsi via dall'aver costruito tutto questo: la parte interessante di un control plane, quel venti per cento, è il rilevamento e le policy, ed è la parte che finisce nelle demo. L'ottanta per cento che decide se governa davvero qualcosa è la risposta, l'applicazione, la tenancy, i ruoli e l'audit onesto. Niente di tutto ciò viene bene in foto. Tutto quanto è il prodotto. E se il nome fa il suo lavoro, tiene sotto gli occhi la posta in gioco: l'obiettivo è una flotta in cui nessun agente, per quanto capace, possa fare come Agent Smith.
Le domande a cui questo articolo risponde
Perché costruire un control plane se Langfuse, Portkey e Lakera esistono già?
Ognuno di questi strumenti fa bene un segmento: tracciamento e costi, gateway e routing, guardrail e scansione, approvazione umana. La scommessa di un control plane è che un registro, una console e un kill switch che li attraversano tutti valgano più della somma, perché la governance vive nelle giunture. Fermare ogni agente che ha toccato lo strumento di fatturazione in quest'ora e sapere chi lo ha approvato sono quattro domande in quattro prodotti, oppure un'unica query in un solo posto.
Come si fa il rilevamento della prompt injection senza portarsi dietro PyTorch nel servizio?
Esportando lo stesso classificatore DeBERTa messo a punto in ONNX ed eseguendolo tramite ONNX Runtime, che sono all'incirca una cinquantina di righe per tokenizzare, eseguire e leggere i logit, senza PyTorch nell'albero delle dipendenze. Le librerie preconfezionate che incapsulano il classificatore costano una tassa d'importazione di oltre 370MB e un riscaldamento di diversi secondi, il compromesso sbagliato per un servizio che scansiona ogni azione. Il rilevamento dei PII è affidato a Presidio con spaCy, caricato in modo lazy così che il percorso comune resti leggero. Il prezzo è gestire in prima persona il tokenizzatore e il codice di collegamento per l'inferenza.
Un kill switch ferma davvero un agente fuori controllo?
Solo se fa da filtro alla creazione del lavoro. Fermare tutti gli agenti è banale da implementare come aggiornamento di stato sulle righe esistenti ed è del tutto inutile se un agente fermato può aprire una nuova run un secondo dopo, quindi un agente in quarantena o sotto un kill switch attivo deve essere respinto all'ingresso. La stessa disciplina di delimitazione vale per la cascata stessa: un kill switch non limitato all'organizzazione che agisce fermerà allegramente la flotta di qualcun altro.
Dove si nascondono le fughe cross-tenant in una piattaforma come questa?
Nell'accesso per id. Le entità di configurazione portano direttamente un id di organizzazione, mentre le entità derivate come run, revisioni e interventi appartengono a un'organizzazione solo in modo transitivo, attraverso il loro agente, quindi un handler che autentica l'utente e poi recupera una run solo tramite id è una lettura cross-tenant. La correzione è noiosa e deve essere ovunque: risolvere la catena di proprietà in ogni handler per id e restituire un 404 quando non corrisponde.
Da leggere dopo
 AI Agents
Ho costruito un livello AI che non risponde mai. Ecco cosa serve davvero a una buona domanda
Appunti dal campo su OrbitSpec, un motore di chiarimento che trasforma richieste vaghe in Context Bundle tipizzati e verificabili prima che qualsiasi modello giri, e perché l'affidabilità comincia prima della risposta. AI Agents
Ho costruito la pipeline che ha costruito il mio prodotto. Ecco cosa serve davvero per delegare
Appunti dal campo su plan-to-pr, una pipeline che trasforma una richiesta di funzionalità in ticket, un gate di approvazione e pull request in bozza, e perché delegare agli agenti di coding richiede artefatti, non chat.