
Construí un plano de control para agentes de IA. Esto es lo que exige de verdad la gobernanza
Escuchar el artículo (experimental) · 14:19
En una entrada anterior describí el panorama de los marcos de trabajo para agentes y, cerca del final, una capa de gobernanza: un registro, un intermediario, políticas y observabilidad situados por encima de una flota de agentes. Aquella era la versión abstracta, tomada de lo que herramientas como MuleSoft Agent Fabric prometen en una diapositiva.
Después construí uno, un plano de control llamado Smithproof, para descubrir qué omite la diapositiva. Este es el informe de campo. No es un lanzamiento ni un tutorial. Es el conjunto de cosas que le diría a alguien que está a punto de construir la gobernanza de agentes y cree que la parte difícil es la detección y la política. La parte difícil es todo lo que convierte la detección y la política en algo que gobierna de verdad.
El nombre es un objetivo de diseño
En The Matrix, Agent Smith empieza como un programa que hace exactamente aquello para lo que fue creado. Luego se libera de sus restricciones, empieza a perseguir su propio objetivo y se copia a sí mismo en cada programa y cada persona que toca, hasta que el propio agente encargado de hacer cumplir las normas del sistema se ha convertido en la mayor amenaza del sistema. Es la imagen más nítida que ha producido la ficción del modo de fallo al que la investigación en seguridad de la IA vuelve una y otra vez: no un intruso hostil, sino un proceso autónomo de confianza cuyos objetivos se desvían y cuyo radio de impacto se multiplica.
Cambia la simulación por un entorno de producción y la imagen se mantiene. Un agente con acceso a herramientas, credenciales y sin supervisión está a un mal prompt de su propio pequeño momento Smith: actuar fuera de su mandato, a velocidad de máquina, con tus claves de API. Smithproof debe su nombre a la propiedad que la plataforma existe para proporcionar. Una flota está a prueba de Smith cuando cada agente que la compone está inventariado, observado, gobernado y se puede detener, de modo que ningún agente pueda convertirse en el sistema sin que nadie se dé cuenta.
Por qué hace falta un plano de control
Los equipos que despliegan agentes convergen en las mismas cinco carencias:
- No hay inventario de qué agentes existen ni de quién es responsable de ellos.
- No hay visibilidad de lo que hizo un agente en tiempo de ejecución: llamadas a modelos, llamadas a herramientas, coste.
- No hay aplicación de políticas. Un agente alcanza todo lo que puede alcanzar.
- No hay detección de inyección de prompts, picos de coste ni bucles descontrolados.
- No hay interruptor de emergencia ni registro de quién intervino cuando algo salió mal.
Cada una de esas carencias tiene una buena solución puntual. La razón para unificarlas es que las preguntas de gobernanza cruzan esas fronteras. "Detén todos los agentes que hayan tocado la herramienta de facturación en la última hora y dime quién lo aprobó" es a la vez una pregunta de registro, de observabilidad, de política y de auditoría. Un plano de control es el lugar donde esas cuatro pueden ser una sola consulta.
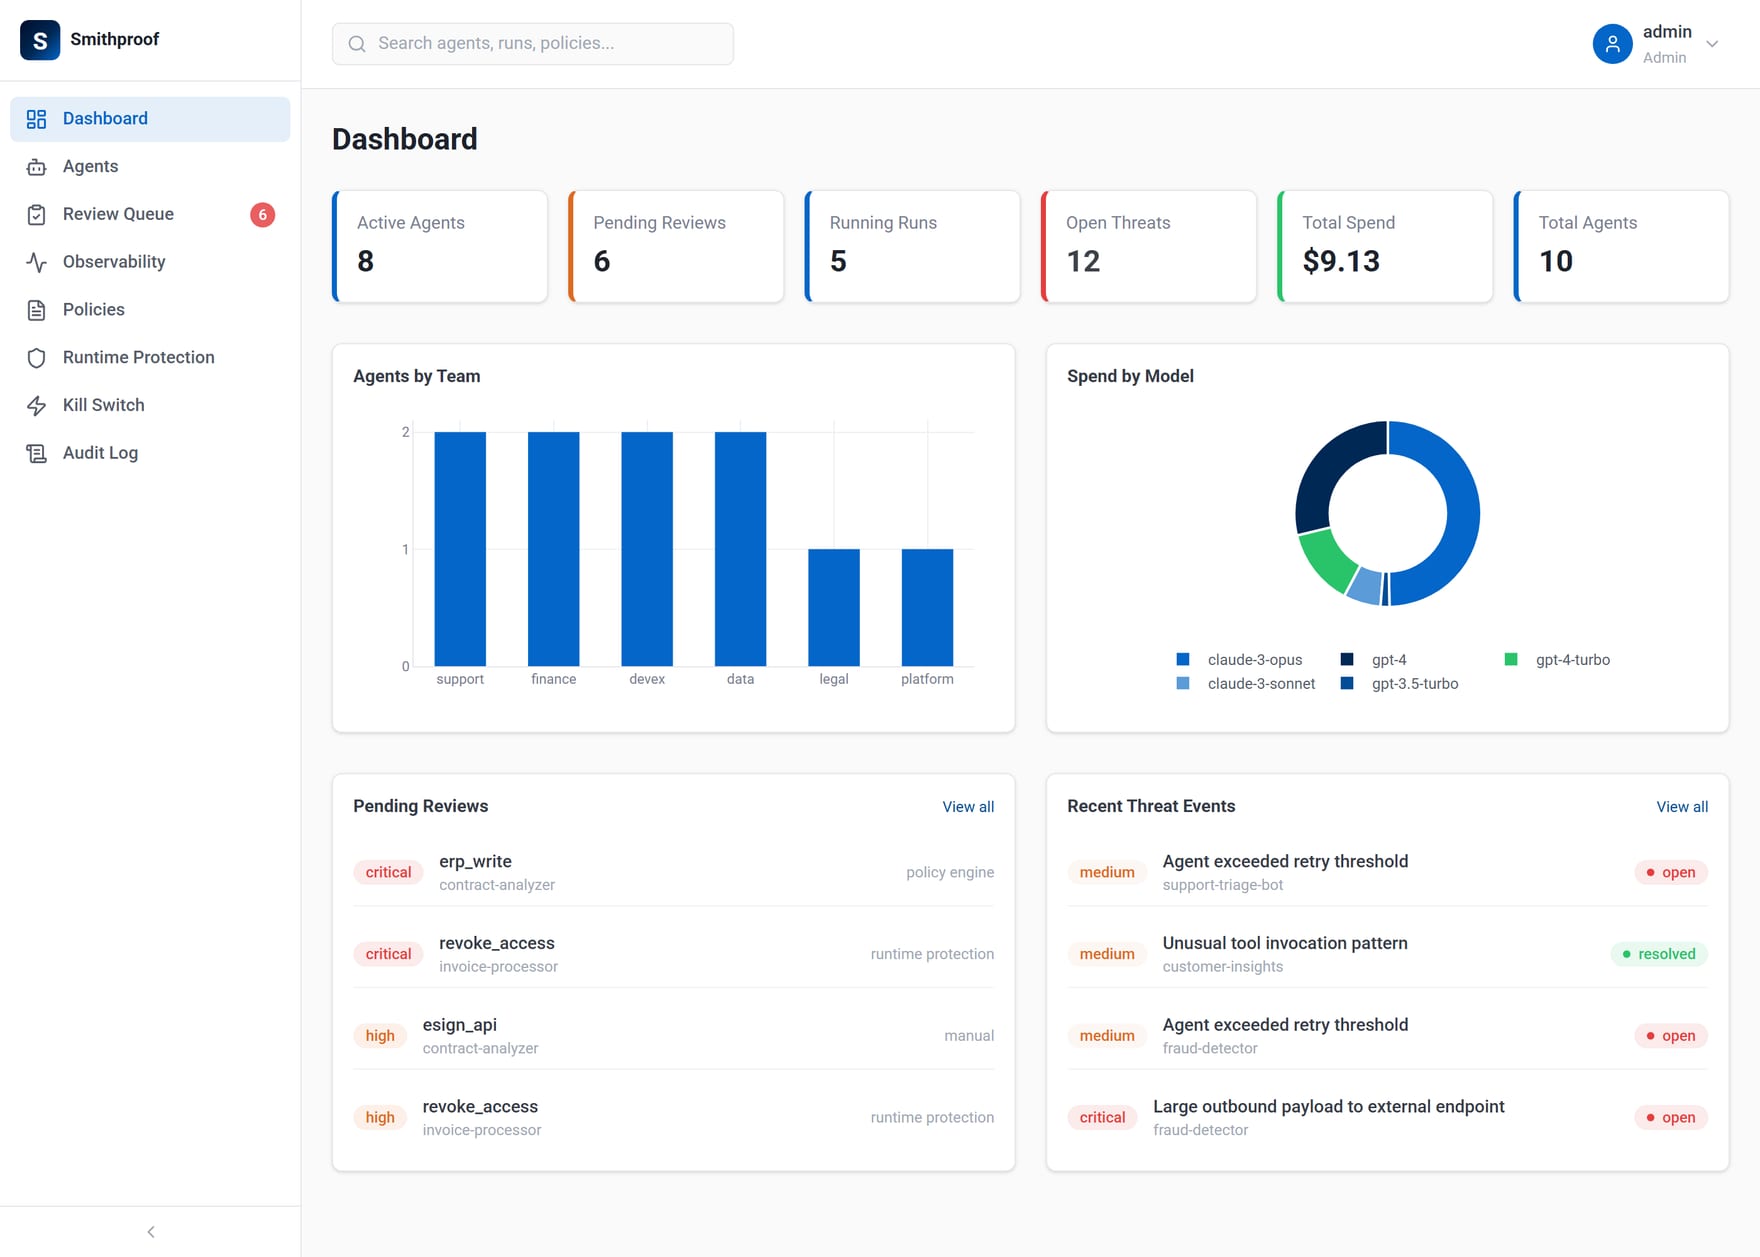 Registro, observabilidad, política y auditoría en una sola pantalla.
De qué está hecho un plano de control
El modelo de dominio es la mayor parte del diseño. Esta es la forma por la que me decidí:
| Subsistema | Gestiona |
|---|---|
| Registro de agentes | Agentes con responsable, equipo, entorno, herramientas, modelos, riesgo y versiones |
| Motor de políticas | Reglas de acceso a modelos y herramientas y de gasto, con alcance desde lo global hasta cada agente |
| Observabilidad | Ejecuciones, spans, llamadas a modelos, llamadas a herramientas, tokens, latencia y coste |
| Protección en tiempo de ejecución | Detectores que producen eventos de amenaza y disparan respuestas |
| Revisión humana | Colas de aprobación para acciones de alto riesgo |
| Interruptor de emergencia | Detener agentes de forma global o por entorno, equipo o agente |
| Intervenciones | Cuarentena, desactivar herramientas, revocar modelos, revertir, todo auditado |
El agente es la raíz. Todo lo demás es o bien configuración que pertenece a la organización y se acota hasta un agente (políticas, detectores), o bien telemetría que cuelga de una ejecución: un Run tiene Spans, y un span tiene un ModelCall o un ToolCall. El gasto se agrega a partir de las llamadas a modelos. Ese único árbol, de la ejecución al span y a la llamada, es lo que todo producto de observabilidad para agentes está almacenando en realidad, ya sea Langfuse, LangSmith o una tabla hecha en casa.
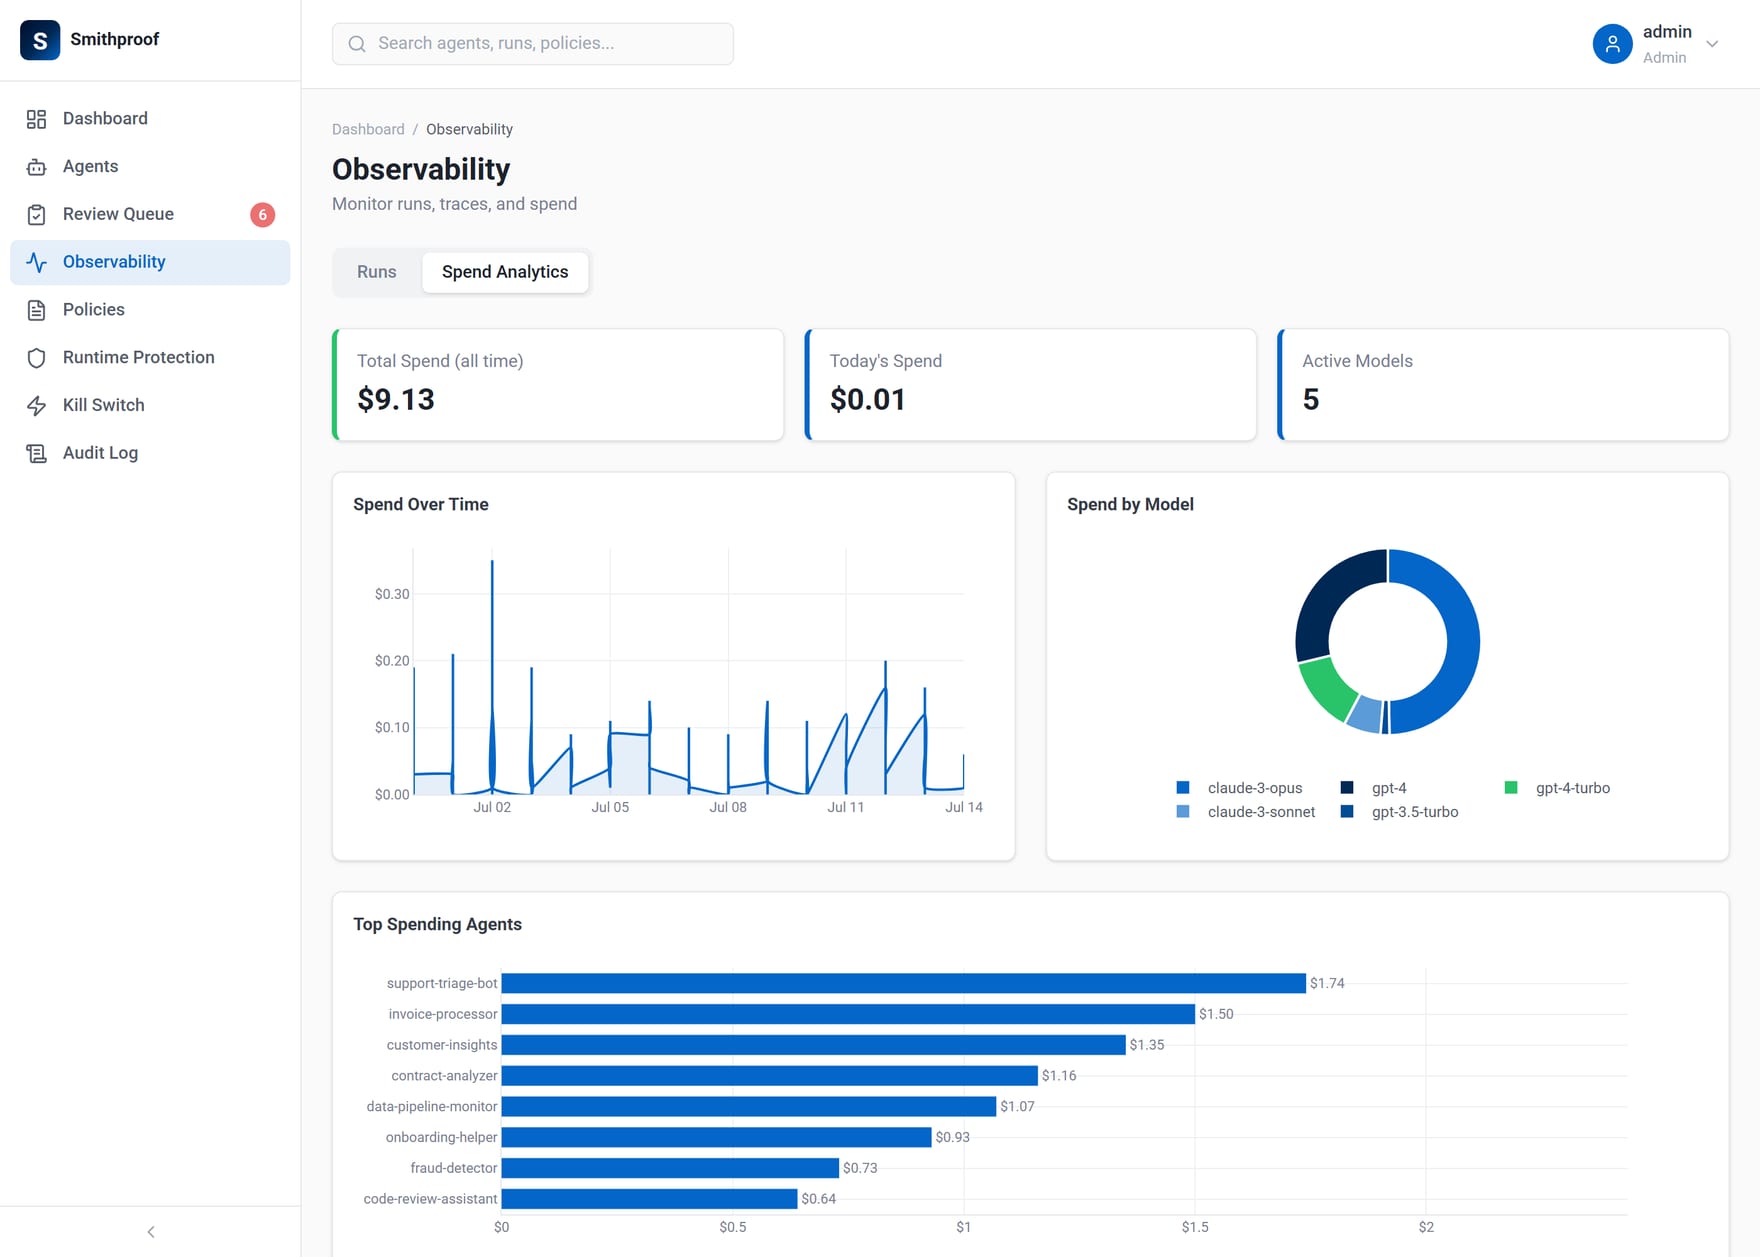 El gasto se agrega a partir de las llamadas a modelos registradas, no se confía en lo que dice quien llama, y aquí se muestra a lo largo del tiempo, por modelo y por agente.
Ayuda ver por dónde se ha fragmentado la categoría, porque un plano de control es un intento de volver a unificarla:
| Segmento | Soluciones puntuales |
|---|---|
| Trazas y coste | Langfuse, LangSmith |
| Pasarela y enrutamiento | Portkey, LiteLLM |
| Guardarraíles y escaneo | Lakera, Presidio |
| Aprobación humana | HumanLayer |
| Gobernanza empresarial | MuleSoft Agent Fabric |
Cada una hace bien un segmento. La apuesta de un plano de control es que un registro, una consola y un interruptor de emergencia que abarquen todas ellas valen más que la suma, porque la gobernanza vive en las costuras.
Una decisión, en profundidad: guardarraíles sin el impuesto de 370MB
La decisión de ingeniería más interesante fue cómo hacer la detección de inyección de prompts.
El enfoque estándar es un pequeño clasificador afinado, normalmente un modelo DeBERTa entrenado para detectar inyecciones. Las bibliotecas listas para usar que lo envuelven arrastran PyTorch, una dependencia de cientos de megabytes con un arranque en frío lento. Para un servicio cuya labor es permanecer discretamente junto a los agentes y escanear, pagar un impuesto de importación de más de 370MB y un calentamiento de varios segundos por un solo clasificador es un mal intercambio.
Así que el escáner ejecuta el mismo modelo exportado a ONNX y ejecutado mediante ONNX Runtime: unas cincuenta líneas para tokenizar, ejecutar y leer logits, sin PyTorch en el árbol de dependencias. La detección de PII corre a cargo de Presidio con spaCy, con carga diferida para que el grafo de importación y la ruta habitual se mantengan ligeros. El intercambio es explícito y merece la pena dejarlo por escrito: renuncias a la comodidad de la biblioteca con pilas incluidas y asumes la tarea de hacerte cargo del tokenizador y del pegamento de inferencia, a cambio de una huella de dependencias y un perfil de latencia que encajan con un plano de control.
La lección se generaliza. Los guardarraíles suelen presentarse como una cuestión de calidad de detección. En la práctica, para una infraestructura que se ejecuta en cada acción, son antes que nada una cuestión de peso de dependencias y de latencia. El modelo que puedes permitirte ejecutar en línea es el modelo que gobierna; el más preciso que tienes que relegar a una cola gobierna menos.
La parte que todo el mundo subestima
Esto es lo que más quiero transmitir.
La detección sin respuesta no gobierna nada. Es fácil construir detectores que produzcan un evento de amenaza y una fila en un panel. Parece protección. No lo es. Un detector configurado para poner un agente en cuarentena tiene que ponerlo en cuarentena de verdad; una alerta tiene que dispararse. El cableado que va de "se ha detectado una amenaza" a "la flota cambió de estado y se avisó a una persona" es el trabajo de verdad, y es invisible en una demo. Un plano de control en el que la mitad de respuesta del detectar-y-responder no está conectada es una captura de pantalla muy convincente de protección.
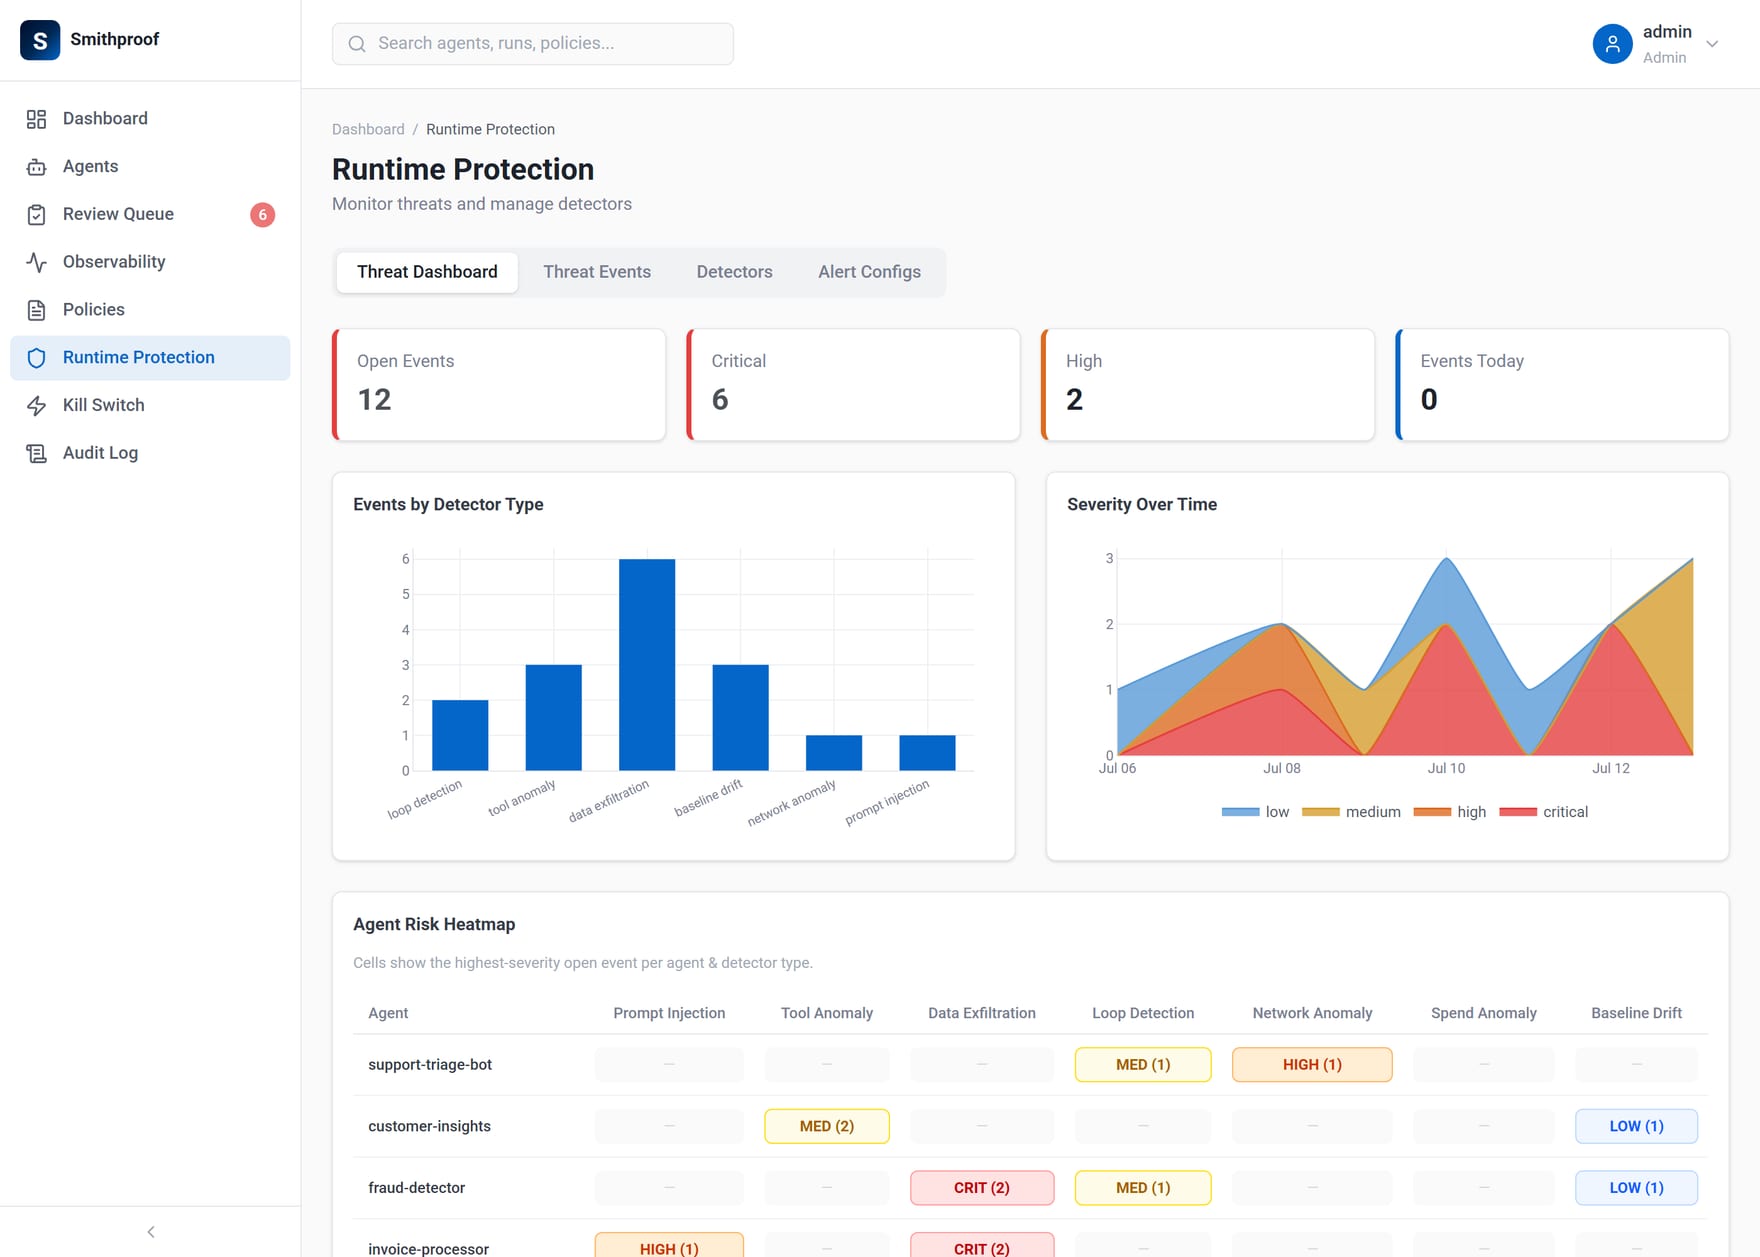 Cada evento de esta pantalla es tan real como la respuesta que tenga cableada detrás.
Una política es una decisión; la aplicación es una arquitectura. Esta es la versión más profunda del mismo punto, y la frontera que más conviene trazar con precisión cuando diseñas uno de estos sistemas. Un plano de control que gobierna a partir de la telemetría notificada es un system of record: real para la observación, la atribución y la respuesta a posteriori (cuarentena, interruptor de emergencia, revisión humana).
La prevención es una propiedad distinta, y proviene de otro lugar de la arquitectura: la ruta de la petición. Portkey y LiteLLM se sitúan entre quien llama y el modelo, de modo que un DENY se aplica antes de que ocurra la llamada en lugar de devolverse como un consejo. Aquí merece la pena releer la guía de Anthropic sobre cómo construir agentes eficaces: cuanta más autonomía concedes, más tienen que ser los controles estructurales en lugar de orientativos.
En Smithproof el motor de políticas ya produce la decisión; el SDK de pasarela que lleva esa decisión hasta la ruta es la siguiente capa, y todo el diseño se concibió para que encaje de forma natural en lugar de acoplarse a la fuerza. Mantén bien diferenciadas las dos propiedades, porque en una consola tienen el mismo aspecto y garantizan cosas completamente distintas.
Un interruptor de emergencia tiene que detener el trabajo nuevo, no solo el antiguo. "Detener todos los agentes" es trivial de implementar como una actualización de estado sobre las filas existentes, y completamente inútil si un agente detenido puede abrir una nueva ejecución un segundo después. El interruptor tiene que controlar la creación de trabajo, de modo que a un agente en cuarentena, o a uno bajo un interruptor de emergencia activo, se le rechace la entrada.
La mitad poco glamurosa: multiinquilinato, roles, auditoría honesta
Este es el trabajo de diseño menos interesante del producto, y decide si puedes dárselo a un segundo cliente.
El multiinquilinato es donde se esconden las fugas, sobre todo cuando se añade a posteriori. Las entidades de configuración llevan un id de organización directamente; las entidades derivadas (ejecuciones, revisiones, intervenciones) pertenecen a una organización solo de forma transitiva, a través de su agente. La trampa es el acceso por id: los endpoints de listado son fáciles de acotar, pero un GET /runs/{id} que autentica al usuario y luego obtiene la ejecución solo por su id, sin comprobar que el agente de esa ejecución pertenece a la organización de quien llama, es una lectura entre inquilinos. El arreglo es aburrido y tiene que estar en todas partes: resolver la cadena de propiedad en cada manejador por id y devolver un 404 si no coincide. La misma disciplina se aplica a los efectos del plano de control. Una cascada de interruptor de emergencia o una evaluación de política que no esté acotada a la organización que actúa detendrá o gobernará alegremente la flota de otro.
Los roles hay que aplicarlos, no decorarlos. Tres roles, lector, operador y administrador, solo son reales si el servidor rechaza a un operador que intenta eliminar un agente y a un lector que intenta cualquier cosa. Un rol que la interfaz lee y la API ignora no es control de acceso.
La identidad de auditoría no puede venir del cliente. El actor de un registro de intervenciones "inmutable" tiene que derivarse de la sesión autenticada. Si el servidor toma performed_by del cuerpo de la petición, el registro es una ficción: cualquiera puede atribuir la activación de un interruptor de emergencia a un compañero. Esta es una decisión de una línea con un efecto desproporcionado sobre si el rastro de auditoría significa algo.
Los topes de presupuesto tienen que leer números reales. Un límite de gasto que se fía de una cifra de current_spend que aporta quien llama se elude con solo omitir el campo. La plataforma ya agrega el gasto a partir de las llamadas a modelos registradas; el tope tiene que leer eso, no la petición.
Una URL de webhook es una credencial. Los canales de alerta se configuran con URLs de webhook, y una URL de webhook de Slack es un secreto de portador: cualquiera que la lea puede publicar en tu nombre. Eso convierte la configuración de alertas en un pequeño almacén de credenciales, y merece que se la trate como tal: secretos cifrados en reposo (AES-256-GCM con clave derivada del secreto de la aplicación), descifrados justo a tiempo para el envío y nunca devueltos por la API, que envía una máscara en su lugar. Hay que reconocerlo: esto empezó como la propuesta de un colaborador externo que yo incorporé, lo cual es en sí mismo una pequeña lección sobre la mitad poco glamurosa. Es donde un par de ojos nuevos ve con más claridad.
En qué punto está
Hoy Smithproof es un system of record multiinquilino con gobernanza activa: los agentes envían telemetría mediante REST, y la plataforma la almacena, la visualiza, la escanea e interviene mediante cuarentena, alertas, aprobación humana y un interruptor de emergencia que impide que arranquen nuevas ejecuciones. La siguiente capa es la pasarela en línea que lleva las decisiones de política a la ruta de la petición, y la arquitectura se construyó con esa costura preparada: el motor de políticas ya emite el veredicto, y la tarea de la pasarela es situarse donde pueda actuar sobre ese veredicto.
Si hay algo que llevarse de haber construido esto: el veinte por ciento interesante de un plano de control es la detección y la política, y es la parte que se enseña en las demos. El ochenta por ciento que decide si gobierna algo es la respuesta, la aplicación, el multiinquilinato, los roles y la auditoría honesta. Nada de eso queda bien en una foto. Todo eso es el producto. Y si el nombre cumple su función, mantiene lo que está en juego a la vista: el objetivo es una flota donde ningún agente, por capaz que sea, pueda hacer un Agent Smith.
Preguntas que responde este artículo
¿Para qué construir un plano de control si ya existen Langfuse, Portkey y Lakera?
Cada uno hace bien un segmento: trazas y coste, pasarela y enrutamiento, guardarraíles y escaneo, aprobación humana. La apuesta de un plano de control es que un registro, una consola y un interruptor de emergencia que abarquen todos ellos valen más que la suma, porque la gobernanza vive en las costuras. Detener todos los agentes que hayan tocado la herramienta de facturación en la última hora y saber quién lo aprobó son cuatro preguntas en cuatro productos, o una sola consulta en un solo sitio.
¿Cómo se hace detección de inyección de prompts sin meter PyTorch en el servicio?
Exportando el mismo clasificador DeBERTa afinado a ONNX y ejecutándolo mediante ONNX Runtime, que son unas cincuenta líneas para tokenizar, ejecutar y leer logits, sin PyTorch en el árbol de dependencias. Las bibliotecas listas para usar que lo envuelven cuestan un impuesto de importación de más de 370MB y un calentamiento de varios segundos, un mal intercambio para un servicio que escanea cada acción. La detección de PII corre a cargo de Presidio con spaCy, con carga diferida para que la ruta habitual se mantenga ligera. El precio es hacerte cargo tú del tokenizador y del pegamento de inferencia.
¿Un interruptor de emergencia detiene de verdad a un agente descontrolado?
Solo si controla la creación de trabajo. Detener todos los agentes es trivial de implementar como una actualización de estado sobre las filas existentes y completamente inútil si un agente detenido puede abrir una nueva ejecución un segundo después, así que a un agente en cuarentena o bajo un interruptor de emergencia activo hay que rechazarle la entrada. La misma disciplina de acotado se aplica a la cascada en sí: un interruptor que no esté acotado a la organización que actúa detendrá alegremente la flota de otro.
¿Dónde se esconden las fugas entre inquilinos en una plataforma así?
En el acceso por id. Las entidades de configuración llevan un id de organización directamente, pero las derivadas, como ejecuciones, revisiones e intervenciones, pertenecen a una organización solo de forma transitiva, a través de su agente, así que un manejador que autentica al usuario y luego obtiene una ejecución solo por su id es una lectura entre inquilinos. El arreglo es aburrido y tiene que estar en todas partes: resolver la cadena de propiedad en cada manejador por id y devolver un 404 cuando no coincide.
Leer a continuación
 AI Agents
He construido una capa de IA que nunca responde. Esto es lo que exige de verdad una buena pregunta
Notas de campo de OrbitSpec, un motor de clarificación que convierte peticiones vagas en Context Bundles tipados y auditables antes de que se ejecute ningún modelo, y por qué la fiabilidad empieza antes de la respuesta. AI Agents
Construí el pipeline que construyó mi producto. Esto es lo que exige delegar de verdad
Notas de campo sobre plan-to-pr, un pipeline que convierte una petición de funcionalidad en tickets, una puerta de aprobación y pull requests en borrador, y por qué delegar en agentes de código exige artefactos, no chat.