
Ich habe eine Control Plane für KI-Agenten gebaut. Das ist es, was Governance wirklich erfordert
Artikel anhören (experimentell) · 15:36
In einem früheren Beitrag habe ich die Landschaft der Agenten-Frameworks beschrieben und, gegen Ende, eine Governance-Schicht: eine Registry, einen Broker, Richtlinien und Observability oberhalb einer Flotte von Agenten. Das war die abstrakte Version, entlehnt dem, was Tools wie MuleSoft Agent Fabric auf einer Folie versprechen.
Dann habe ich eine gebaut, eine Control Plane namens Smithproof, um herauszufinden, was die Folie auslässt. Das ist der Feldbericht. Es ist kein Launch und kein Tutorial. Es ist die Sammlung der Dinge, die ich jemandem sagen würde, der gerade dabei ist, Agenten-Governance zu bauen, und glaubt, der schwierige Teil sei Erkennung und Richtlinien. Der schwierige Teil ist alles, was aus Erkennung und Richtlinien etwas macht, das tatsächlich steuert.
Der Name ist ein Designziel
In The Matrix beginnt Agent Smith als ein Programm, das genau das tut, wofür es gebaut wurde. Dann streift er seine Beschränkungen ab, verfolgt sein eigenes Ziel und kopiert sich auf jedes Programm und jede Person, die er berührt, bis der Durchsetzungsagent des Systems selbst zur größten Bedrohung des Systems geworden ist. Es ist das klarste Bild, das die Fiktion für jenen Fehlermodus hervorgebracht hat, zu dem die KI-Sicherheitsforschung immer wieder zurückkehrt: kein feindseliger Außenstehender, sondern ein vertrauenswürdiger autonomer Prozess, dessen Ziele abdriften und dessen Wirkungsradius sich potenziert.
Tauschst du die Simulation gegen eine Produktionsumgebung, bleibt das Bild bestehen. Ein Agent mit Tool-Zugriff, Zugangsdaten und ohne Aufsicht ist nur einen schlechten Prompt von seinem eigenen kleinen Smith-Moment entfernt: Er handelt außerhalb seines Mandats, mit Maschinengeschwindigkeit, mit deinen API-Schlüsseln. Smithproof ist nach der Eigenschaft benannt, die die Plattform bereitstellen soll. Eine Flotte ist Smith-proof, wenn jeder Agent in ihr inventarisiert, beobachtet, gesteuert und stoppbar ist, sodass kein einzelner Agent still und leise zum System werden kann.
Warum überhaupt eine Control Plane
Teams, die Agenten ausliefern, stoßen auf dieselben fünf Lücken:
- Kein Inventar darüber, welche Agenten existieren oder wem sie gehören.
- Keine Sichtbarkeit dessen, was ein Agent zur Laufzeit getan hat: Modellaufrufe, Tool-Aufrufe, Kosten.
- Keine Durchsetzung von Richtlinien. Ein Agent erreicht, was immer er erreichen kann.
- Keine Erkennung von Prompt-Injection, Kostenspitzen oder außer Kontrolle geratenen Schleifen.
- Kein Kill Switch und keine Aufzeichnung darüber, wer eingegriffen hat, als etwas schieflief.
Für jede dieser Lücken gibt es eine gute Einzellösung. Der Grund, sie zu vereinen: Governance-Fragen überschreiten diese Grenzen. „Stoppe jeden Agenten, der in dieser Stunde das Billing-Tool angefasst hat, und sag mir, wer das genehmigt hat" ist zugleich eine Registry-Frage, eine Observability-Frage, eine Richtlinien-Frage und eine Audit-Frage. Eine Control Plane ist der Ort, an dem diese vier zu einer einzigen Abfrage werden können.
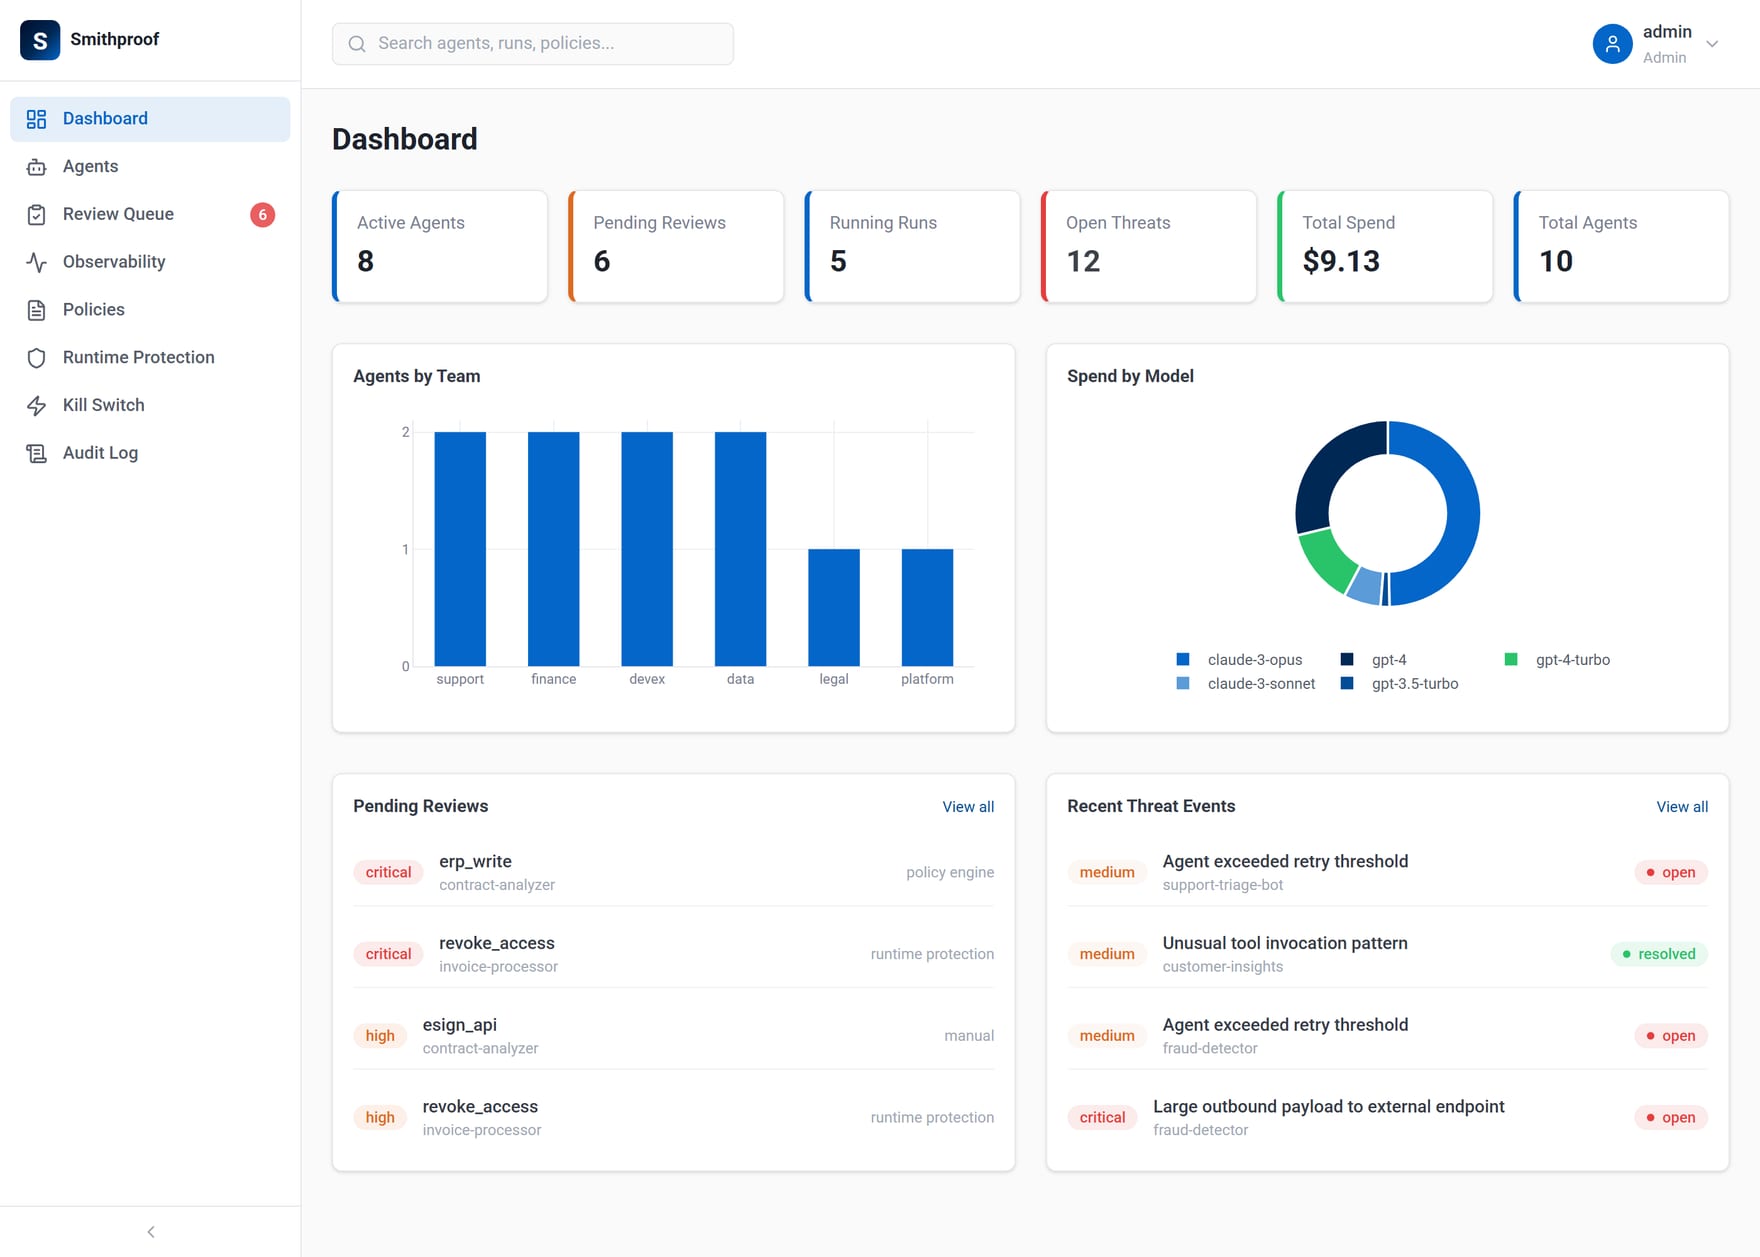 Registry, Observability, Richtlinien und Audit auf einem Bildschirm.
Woraus eine Control Plane besteht
Das Domänenmodell ist der größte Teil des Designs. Auf diese Form habe ich mich festgelegt:
| Subsystem | Verantwortlich für |
|---|---|
| Agenten-Registry | Agenten mit Eigentümer, Team, Umgebung, Tools, Modellen, Risiko, Versionen |
| Richtlinien-Engine | Regeln für Modell-/Tool-Zugriff und Ausgaben, abgestuft von global bis pro Agent |
| Observability | Runs, Spans, Modellaufrufe, Tool-Aufrufe, Tokens, Latenz, Kosten |
| Laufzeitschutz | Detektoren, die Bedrohungsereignisse erzeugen und Reaktionen auslösen |
| Menschliche Prüfung | Freigabe-Warteschlangen für risikoreiche Aktionen |
| Kill Switch | Agenten global oder nach Umgebung, Team oder Agent anhalten |
| Interventionen | Quarantäne, Tools deaktivieren, Modelle entziehen, Rollback, alles auditiert |
Der Agent ist die Wurzel. Alles andere ist entweder Konfiguration, die zur Organisation gehört und im Geltungsbereich bis auf einen Agenten eingeschränkt wird (Richtlinien, Detektoren), oder Telemetrie, die an einem Run hängt: Ein Run hat Spans, und ein Span hat einen ModelCall oder einen ToolCall. Die Ausgaben werden aus den Modellaufrufen aggregiert. Genau dieser eine Baum, von Run über Span zu Call, ist das, was jedes Observability-Produkt für Agenten tatsächlich speichert, ob es Langfuse, LangSmith oder eine selbstgebaute Tabelle ist.
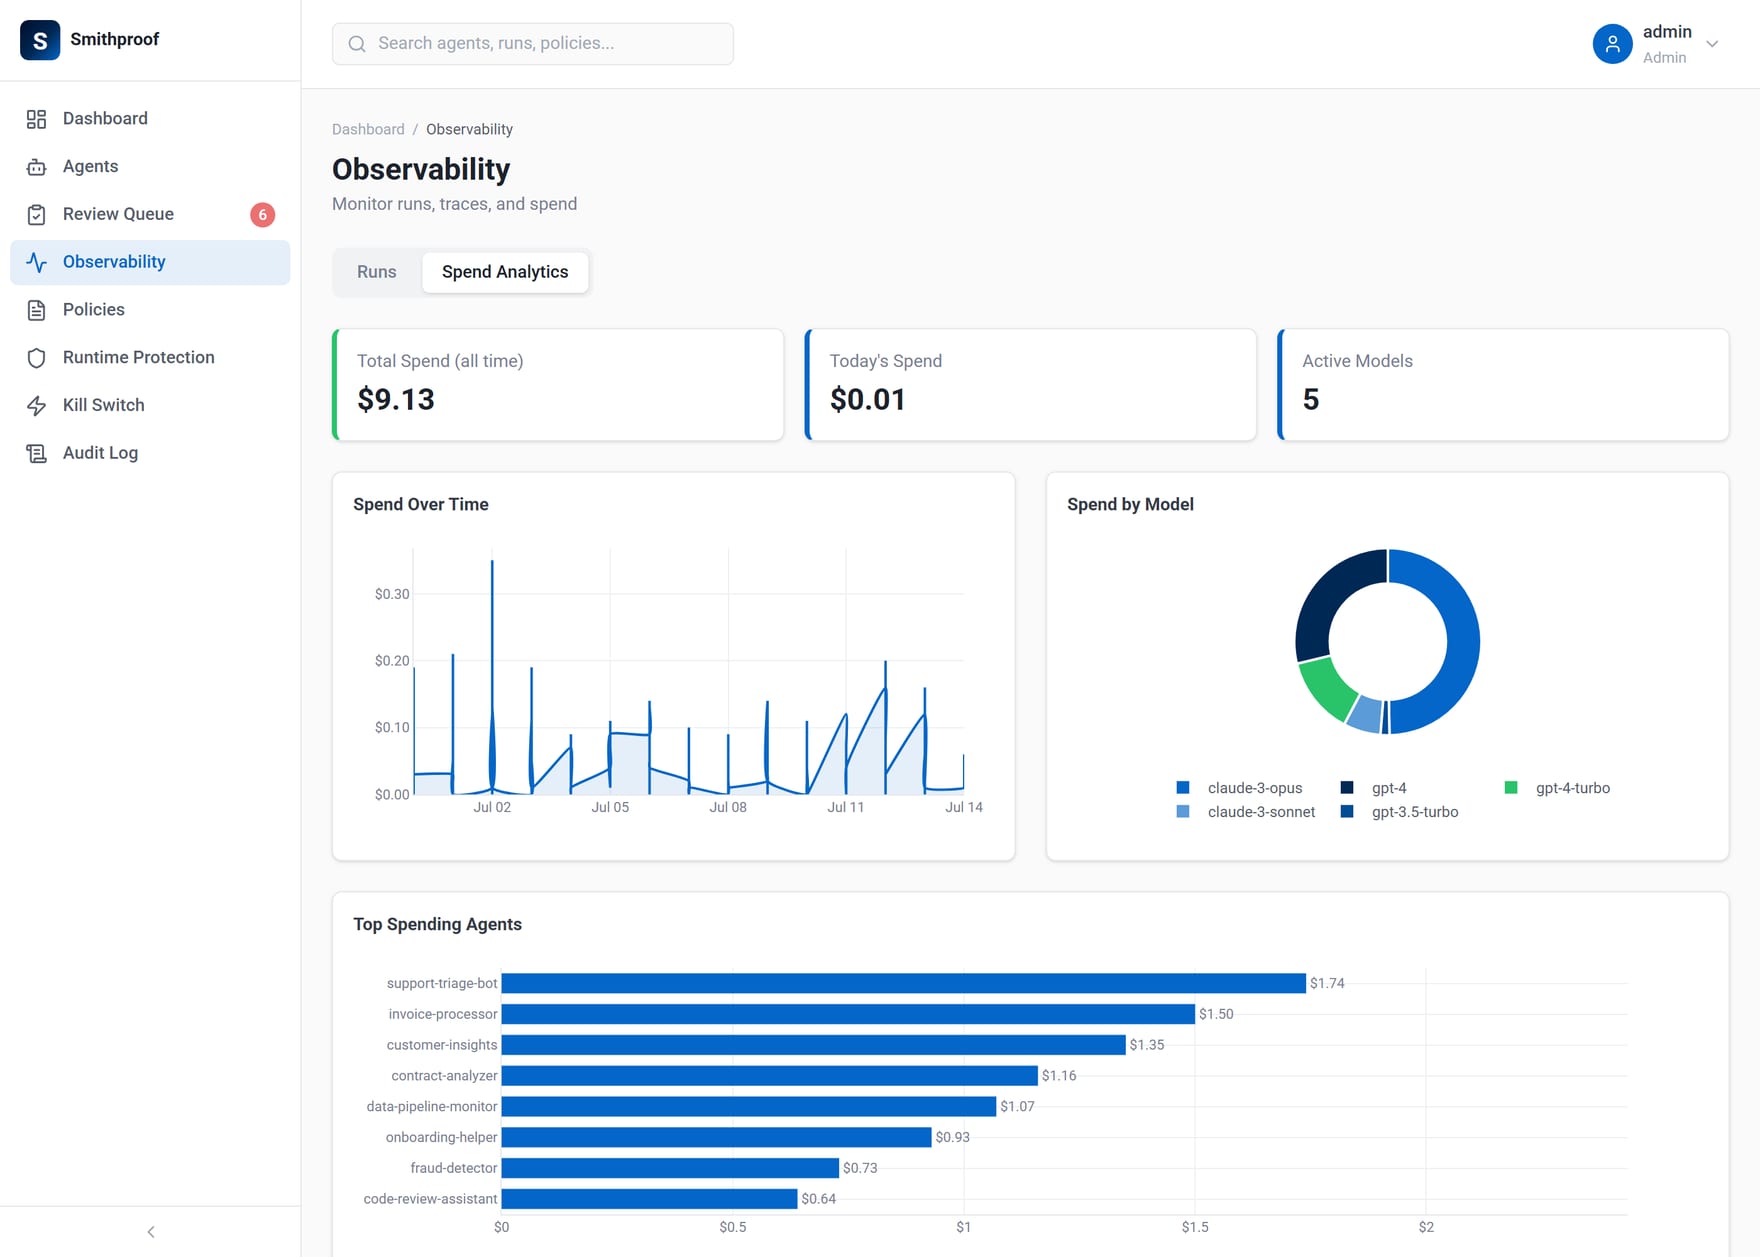 Die Ausgaben werden aus aufgezeichneten Modellaufrufen aggregiert, dem Aufrufer nicht einfach geglaubt, und hier über die Zeit, pro Modell und pro Agent dargestellt.
Es hilft zu sehen, wie die Kategorie aufgeteilt wurde, denn eine Control Plane ist der Versuch, sie wieder zu vereinen:
| Segment | Einzellösungen |
|---|---|
| Tracing und Kosten | Langfuse, LangSmith |
| Gateway und Routing | Portkey, LiteLLM |
| Guardrails und Scanning | Lakera, Presidio |
| Menschliche Freigabe | HumanLayer |
| Enterprise-Governance | MuleSoft Agent Fabric |
Jede beherrscht ein Segment gut. Die Wette einer Control Plane ist, dass eine Registry, eine Konsole und ein Kill Switch, die sie alle umspannen, mehr wert sind als die Summe, weil Governance in den Nahtstellen steckt.
Eine Entscheidung im Detail: Guardrails ohne den 370-MB-Aufschlag
Die interessanteste einzelne technische Entscheidung war, wie die Prompt-Injection-Erkennung umgesetzt werden sollte.
Der Standardansatz ist ein kleiner feinabgestimmter Klassifikator, typischerweise ein DeBERTa-Modell, das darauf trainiert ist, Injection zu erkennen. Die vorgefertigten Bibliotheken, die es kapseln, ziehen PyTorch herein, eine Abhängigkeit im Bereich von Hunderten Megabyte mit langsamem Kaltstart. Für einen Dienst, dessen Aufgabe es ist, still neben den Agenten zu sitzen und zu scannen, ist es der falsche Kompromiss, für einen einzigen Klassifikator einen Import-Aufschlag von über 370 MB und eine mehrsekündige Aufwärmzeit zu zahlen.
Also führt der Scanner dasselbe Modell aus, exportiert nach ONNX und ausgeführt über ONNX Runtime: rund fünfzig Zeilen Tokenisieren, Ausführen, Logits lesen, kein PyTorch im Baum. Die PII-Erkennung ist Presidio mit spaCy, lazy geladen, damit der Import-Graph und der übliche Pfad leichtgewichtig bleiben. Der Kompromiss ist explizit und wert, festgehalten zu werden: Du gibst den Komfort der Batteries-included-Bibliothek auf und übernimmst die Aufgabe, den Tokenizer und den Klebecode für die Inferenz selbst zu verantworten, im Tausch gegen einen Abhängigkeits-Footprint und ein Latenzprofil, die zu einer Control Plane passen.
Die Lehre lässt sich verallgemeinern. Guardrails werden meist als Frage der Erkennungsqualität dargestellt. In der Praxis sind sie für Infrastruktur, die bei jeder Aktion läuft, zuerst eine Frage von Abhängigkeitsgewicht und Latenz. Das Modell, das du dir leisten kannst, inline auszuführen, ist das Modell, das steuert; das genauere, das du in eine Warteschlange auslagern musst, steuert weniger.
Der Teil, den alle unterschätzen
Das ist es, was ich am meisten weitergeben möchte.
Erkennung ohne Reaktion steuert nichts. Es ist leicht, Detektoren zu bauen, die ein Bedrohungsereignis und eine Dashboard-Zeile erzeugen. Es fühlt sich nach Schutz an. Ist es aber nicht. Ein Detektor, der so konfiguriert ist, dass er einen Agenten unter Quarantäne stellt, muss ihn auch tatsächlich unter Quarantäne stellen; ein Alarm muss ausgelöst werden. Die Verdrahtung von „eine Bedrohung wurde erkannt" zu „die Flotte hat ihren Zustand geändert und ein Mensch wurde benachrichtigt" ist die eigentliche Arbeit, und sie ist in einer Demo unsichtbar. Eine Control Plane, in der die Reaktions-Hälfte von Erkennen-und-Reagieren nicht angeschlossen ist, ist ein sehr überzeugender Screenshot von Schutz.
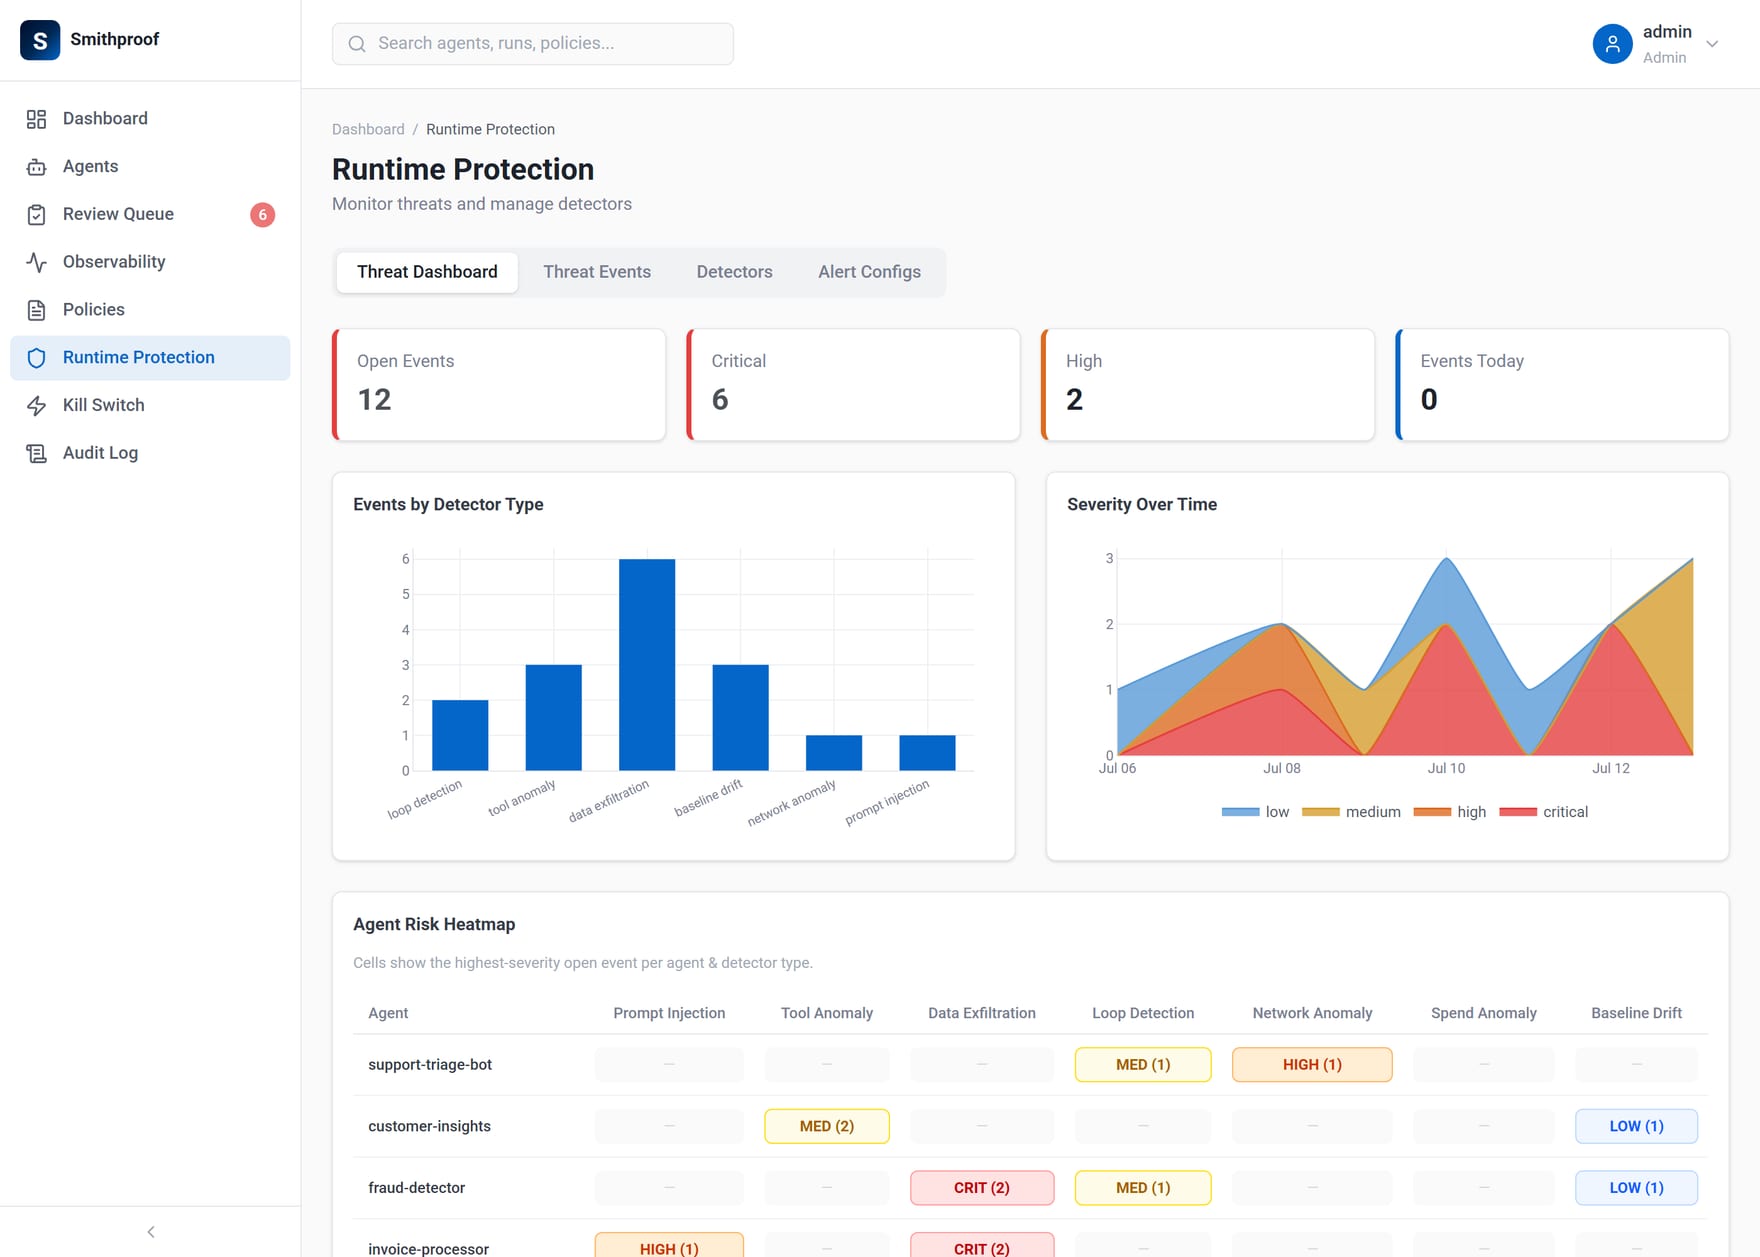 Jedes Ereignis auf diesem Bildschirm ist nur so real wie die dahinter verdrahtete Reaktion.
Eine Richtlinie ist eine Entscheidung; Durchsetzung ist eine Architektur. Das ist die tiefere Fassung desselben Punktes und die Grenze, die es am genauesten zu ziehen gilt, wenn du so etwas entwirfst. Eine Control Plane, die über gemeldete Telemetrie steuert, ist ein system of record: real für Beobachtung, Zuordnung und nachträgliche Reaktion (Quarantäne, Kill Switch, menschliche Prüfung).
Prävention ist eine andere Eigenschaft, und sie kommt von einer anderen Stelle in der Architektur: dem Anfragepfad. Portkey und LiteLLM sitzen zwischen dem Aufrufer und dem Modell, sodass ein DENY durchgesetzt wird, bevor der Aufruf geschieht, statt als Ratschlag zurückgegeben zu werden. Anthropics Leitfaden zum Bau effektiver Agenten lohnt hier eine erneute Lektüre: Je mehr Autonomie du gewährst, desto stärker müssen die Kontrollen strukturell statt beratend sein.
In Smithproof erzeugt die Richtlinien-Engine bereits die Entscheidung; das Gateway-SDK, das diese Entscheidung in den Pfad bringt, ist die nächste Schicht, und das gesamte Design wurde so geformt, dass es sich einfügt, statt aufgesetzt zu werden. Halte die beiden Eigenschaften gedanklich auseinander, denn in einer Konsole sehen sie identisch aus und garantieren völlig verschiedene Dinge.
Ein Kill Switch muss neue Arbeit stoppen, nicht nur alte. „Alle Agenten anhalten" ist trivial als Statusaktualisierung bestehender Zeilen umzusetzen und völlig nutzlos, wenn ein angehaltener Agent eine Sekunde später trotzdem einen neuen Run öffnen kann. Der Schalter muss an der Erzeugung von Arbeit ansetzen, sodass ein Agent unter Quarantäne oder unter einem aktiven Kill Switch von vornherein abgewiesen wird.
Die unglamouröse Hälfte: Mandantenfähigkeit, Rollen, ehrliches Audit
Das ist die uninteressanteste Designarbeit im Produkt, und sie entscheidet, ob du es einem zweiten Kunden geben kannst.
Mandantenfähigkeit ist der Ort, an dem sich Lecks verstecken, besonders wenn sie nachträglich eingebaut wird. Konfigurationsentitäten tragen eine Org-ID direkt; abgeleitete Entitäten (Runs, Prüfungen, Interventionen) gehören zu einer Organisation nur transitiv, über ihren Agenten. Die Falle ist der Zugriff per ID: List-Endpunkte sind leicht einzugrenzen, aber ein GET /runs/{id}, das den Benutzer authentifiziert und den Run dann allein anhand der ID holt, ohne zu prüfen, ob der Agent des Runs zur Organisation des Aufrufers gehört, ist ein mandantenübergreifender Lesezugriff. Die Behebung ist langweilig und muss überall greifen: Die Eigentumskette auf jedem ID-Handler auflösen und einen 404 zurückgeben, wenn sie nicht passt. Dieselbe Disziplin gilt für Control-Plane-Effekte. Eine Kill-Switch-Kaskade oder eine Richtlinienauswertung, die nicht auf die handelnde Organisation eingegrenzt ist, hält oder steuert bereitwillig die Flotte eines anderen.
Rollen müssen durchgesetzt werden, nicht nur dekoriert. Drei Rollen, Viewer, Operator, Admin, sind nur dann real, wenn der Server einen Operator abweist, der einen Agenten löschen will, und einen Viewer, der überhaupt etwas versucht. Ein Rollen-Claim, den das UI liest und die API ignoriert, ist keine Zugriffskontrolle.
Die Audit-Identität darf nicht vom Client kommen. Der Akteur in einem „unveränderlichen" Interventionsprotokoll muss aus der authentifizierten Sitzung abgeleitet werden. Nimmt der Server performed_by aus dem Anfrage-Body, ist das Protokoll Fiktion: Jeder kann die Aktivierung eines Kill Switch einem Kollegen zuschreiben. Das ist eine einzeilige Entscheidung mit übergroßer Wirkung darauf, ob der Audit-Trail überhaupt etwas bedeutet.
Budget-Obergrenzen müssen echte Zahlen lesen. Ein Ausgabenlimit, das einer vom Aufrufer gelieferten current_spend-Zahl vertraut, wird umgangen, indem man das Feld weglässt. Die Plattform aggregiert die Ausgaben bereits aus aufgezeichneten Modellaufrufen; die Obergrenze muss diese lesen, nicht die Anfrage.
Eine Webhook-URL ist ein Zugangsdatum. Alarmkanäle werden mit Webhook-URLs konfiguriert, und eine Slack-Webhook-URL ist ein Bearer-Secret: Wer sie liest, kann in deinem Namen posten. Das macht die Alarmierungskonfiguration zu einem kleinen Zugangsdaten-Speicher, und sie verdient die entsprechende Behandlung: Secrets im Ruhezustand verschlüsselt (AES-256-GCM, abgeleitet vom Application Secret), erst im letzten Moment für den Versand entschlüsselt und von der API nie zurückgegeben, die stattdessen eine Maske sendet. Ehre, wem Ehre gebührt: Das hier begann als Vorschlag eines externen Beitragenden, den ich übernommen habe, was eine eigene kleine Lehre über die unglamouröse Hälfte ist. Genau hier sieht ein frischer Blick von außen am klarsten.
Wo es steht
Heute ist Smithproof ein mandantenfähiges system of record mit aktiver Governance: Agenten melden Telemetrie über REST, und die Plattform speichert sie, visualisiert sie, scannt sie und greift ein durch Quarantäne, Alarme, menschliche Freigabe und einen Kill Switch, der neue Runs von vornherein abweist. Die nächste Schicht ist das Inline-Gateway, das Richtlinienentscheidungen in den Anfragepfad bringt, und die Architektur wurde so gebaut, dass diese Nahtstelle bereits angelegt ist: Die Richtlinien-Engine liefert das Urteil bereits, und die Aufgabe des Gateways ist es, dort zu stehen, wo es dieses Urteil umsetzen kann.
Wenn es eine Sache gibt, die du aus dem Bau von all dem mitnehmen solltest: Die interessanten zwanzig Prozent einer Control Plane sind Erkennung und Richtlinien, und genau dieser Teil wird vorgeführt. Die achtzig Prozent, die darüber entscheiden, ob sie überhaupt etwas steuert, sind Reaktion, Durchsetzung, Mandantenfähigkeit, Rollen und ehrliches Audit. Nichts davon macht sich gut auf einem Foto. Alles davon ist das Produkt. Und wenn der Name seine Arbeit tut, hält er im Blick, was auf dem Spiel steht: Das Ziel ist eine Flotte, in der kein Agent, so fähig er auch sein mag, einen Agent Smith abziehen kann.
Fragen, die dieser Artikel beantwortet
Warum eine Control Plane bauen, wenn es Langfuse, Portkey und Lakera schon gibt?
Jedes dieser Werkzeuge beherrscht ein Segment gut: Tracing und Kosten, Gateway und Routing, Guardrails und Scanning, menschliche Freigabe. Die Wette einer Control Plane ist, dass eine Registry, eine Konsole und ein Kill Switch, die sie alle umspannen, mehr wert sind als die Summe, weil Governance in den Nahtstellen steckt. Jeden Agenten anzuhalten, der in dieser Stunde das Billing-Tool angefasst hat, und dabei zu erfahren, wer das genehmigt hat, sind vier Fragen in vier Produkten oder eine einzige Abfrage an einem Ort.
Wie macht man Prompt-Injection-Erkennung, ohne PyTorch in den Dienst zu ziehen?
Indem du denselben feinabgestimmten DeBERTa-Klassifikator nach ONNX exportierst und über ONNX Runtime ausführst, was rund fünfzig Zeilen zum Tokenisieren, Ausführen und Lesen der Logits sind, ohne PyTorch im Abhängigkeitsbaum. Die vorgefertigten Bibliotheken, die den Klassifikator kapseln, kosten einen Import-Aufschlag von über 370 MB und eine mehrsekündige Aufwärmzeit, der falsche Kompromiss für einen Dienst, der jede Aktion scannt. Die PII-Erkennung ist Presidio mit spaCy, lazy geladen, damit der übliche Pfad leichtgewichtig bleibt. Der Preis ist, dass du den Tokenizer und den Klebecode für die Inferenz selbst verantwortest.
Stoppt ein Kill Switch einen abtrünnigen Agenten wirklich?
Nur wenn er an der Erzeugung von Arbeit ansetzt. Alle Agenten anzuhalten ist trivial als Statusaktualisierung bestehender Zeilen umzusetzen und völlig nutzlos, wenn ein angehaltener Agent eine Sekunde später einen neuen Run öffnen kann, also muss ein Agent unter Quarantäne oder unter einem aktiven Kill Switch von vornherein abgewiesen werden. Dieselbe Eingrenzungsdisziplin gilt für die Kaskade selbst: Ein Kill Switch, der nicht auf die handelnde Organisation eingegrenzt ist, hält bereitwillig die Flotte eines anderen an.
Wo verstecken sich mandantenübergreifende Lecks in so einer Plattform?
Im Zugriff per ID. Konfigurationsentitäten tragen eine Org-ID direkt, abgeleitete Entitäten wie Runs, Prüfungen und Interventionen gehören dagegen nur transitiv über ihren Agenten zu einer Organisation, und deshalb ist ein Handler, der den Benutzer authentifiziert und den Run dann allein anhand der ID holt, ein mandantenübergreifender Lesezugriff. Die Behebung ist langweilig und muss überall greifen: die Eigentumskette auf jedem ID-Handler auflösen und einen 404 zurückgeben, wenn sie nicht passt.
Weiterlesen
 AI Agents
Ich habe eine KI-Schicht gebaut, die nie antwortet. Was eine gute Frage wirklich braucht
Feldnotizen zu OrbitSpec, einer Klärungs-Engine, die vage Anfragen in typisierte, auditierbare Context Bundles verwandelt, bevor irgendein Modell läuft, und warum Zuverlässigkeit vor der Antwort beginnt. AI Agents
Ich habe die Pipeline gebaut, die mein Produkt gebaut hat. Was Delegieren wirklich verlangt
Feldnotizen zu plan-to-pr, einer Pipeline, die aus einem Feature-Wunsch Tickets, ein Freigabe-Gate und Draft Pull Requests macht, und warum Delegieren an Coding-Agents Artefakte braucht, keinen Chat.