
Construí um plano de controlo para agentes de IA. Eis o que a governança exige de facto
Ouvir o artigo (experimental) · 14:22
Num artigo anterior descrevi o panorama das frameworks de agentes e, perto do fim, uma camada de governança: um registo, um intermediário, políticas e observabilidade a assentar sobre uma frota de agentes. Essa era a versão abstrata, emprestada daquilo que ferramentas como o MuleSoft Agent Fabric prometem num slide.
Depois construí um, um plano de controlo chamado Smithproof, para descobrir o que o slide deixa de fora. Este é o relato de campo. Não é um lançamento nem um tutorial. É o conjunto de coisas que eu diria a alguém que está prestes a construir governança de agentes e julga que a parte difícil é a deteção e a política. A parte difícil é tudo o que transforma a deteção e a política em algo que governa de facto.
O nome é um objetivo de design
Em The Matrix, o Agent Smith começa como um programa a fazer exatamente aquilo para que foi criado. Depois liberta-se das suas restrições, começa a perseguir o seu próprio objetivo e copia-se para cada programa e pessoa em que toca, até o próprio agente que devia zelar pelo cumprimento das regras se tornar a maior ameaça do sistema. É o retrato mais nítido que a ficção já produziu do modo de falha ao qual a investigação em segurança de IA volta sempre: não um intruso hostil, mas um processo autónomo de confiança cujos objetivos se desviam e cujo raio de destruição se agrava.
Troque-se a simulação por um ambiente de produção e o retrato mantém-se. Um agente com acesso a ferramentas, credenciais e sem supervisão está a um mau prompt de distância do seu próprio pequeno momento Smith: a agir fora do seu mandato, à velocidade da máquina, com as suas chaves de API. O Smithproof tem o nome da propriedade que a plataforma existe para garantir. Uma frota é Smith-proof quando cada agente nela está inventariado, observado, governado e é passível de ser travado, de modo que nenhum agente isolado possa tornar-se silenciosamente o sistema.
Porquê um plano de controlo, afinal
As equipas que lançam agentes convergem para as mesmas cinco lacunas:
- Nenhum inventário de que agentes existem ou de quem é o seu dono.
- Nenhuma visibilidade sobre o que um agente fez em tempo de execução: chamadas a modelos, chamadas a ferramentas, custo.
- Nenhuma aplicação de políticas. Um agente alcança tudo aquilo que consegue alcançar.
- Nenhuma deteção de injeção de prompt, picos de custo ou ciclos descontrolados.
- Nenhum kill switch, e nenhum registo de quem interveio quando as coisas correram mal.
Cada uma dessas lacunas tem uma boa solução pontual. A razão para as unificar é que as perguntas de governança atravessam essas fronteiras. "Trave todos os agentes que tocaram na ferramenta de faturação nesta última hora, e diga-me quem aprovou isso" é ao mesmo tempo uma pergunta de registo, uma pergunta de observabilidade, uma pergunta de política e uma pergunta de auditoria. Um plano de controlo é o lugar onde essas quatro podem ser uma só consulta.
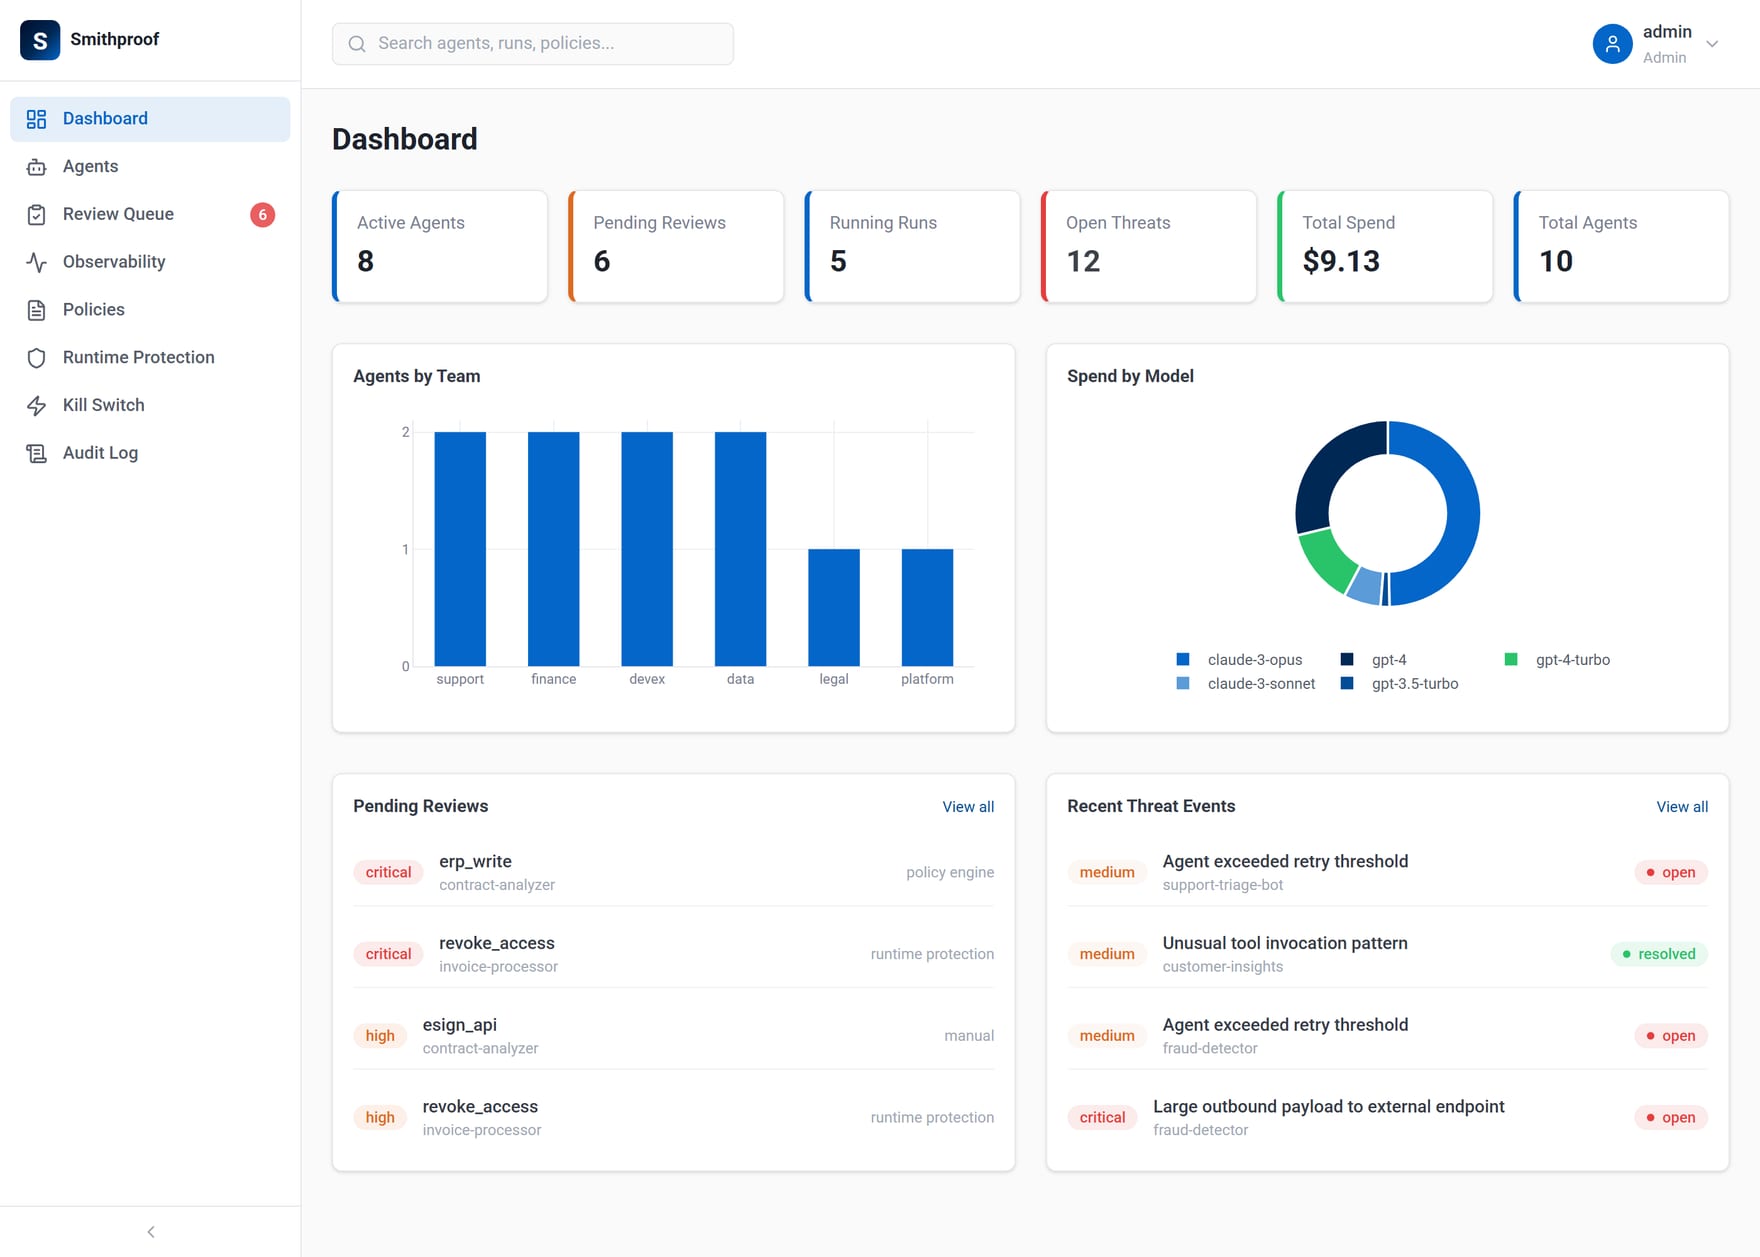 Registo, observabilidade, política e auditoria num único ecrã.
De que é feito um plano de controlo
O modelo de domínio é a maior parte do design. Eis a forma que acabei por adotar:
| Subsistema | Responsável por |
|---|---|
| Registo de agentes | Agentes com dono, equipa, ambiente, ferramentas, modelos, risco, versões |
| Motor de políticas | Regras de acesso a modelos/ferramentas e de gasto, com âmbito do global até ao nível de cada agente |
| Observabilidade | Execuções, spans, chamadas a modelos, chamadas a ferramentas, tokens, latência, custo |
| Proteção em tempo de execução | Detetores que produzem eventos de ameaça e desencadeiam respostas |
| Revisão humana | Filas de aprovação para ações de alto risco |
| Kill switch | Travar agentes globalmente ou por ambiente, equipa ou agente |
| Intervenções | Quarentena, desativar ferramentas, revogar modelos, rollback, tudo auditado |
O agente é a raiz. Tudo o resto é ou configuração que pertence à organização e é delimitada até ao agente (políticas, detetores), ou telemetria que fica pendurada numa execução: um Run tem Spans, e um span tem um ModelCall ou um ToolCall. O gasto é agregado a partir das chamadas a modelos. Essa árvore única, de execução a span a chamada, é o que todos os produtos de observabilidade para agentes estão de facto a guardar, seja o Langfuse, o LangSmith, ou uma tabela caseira.
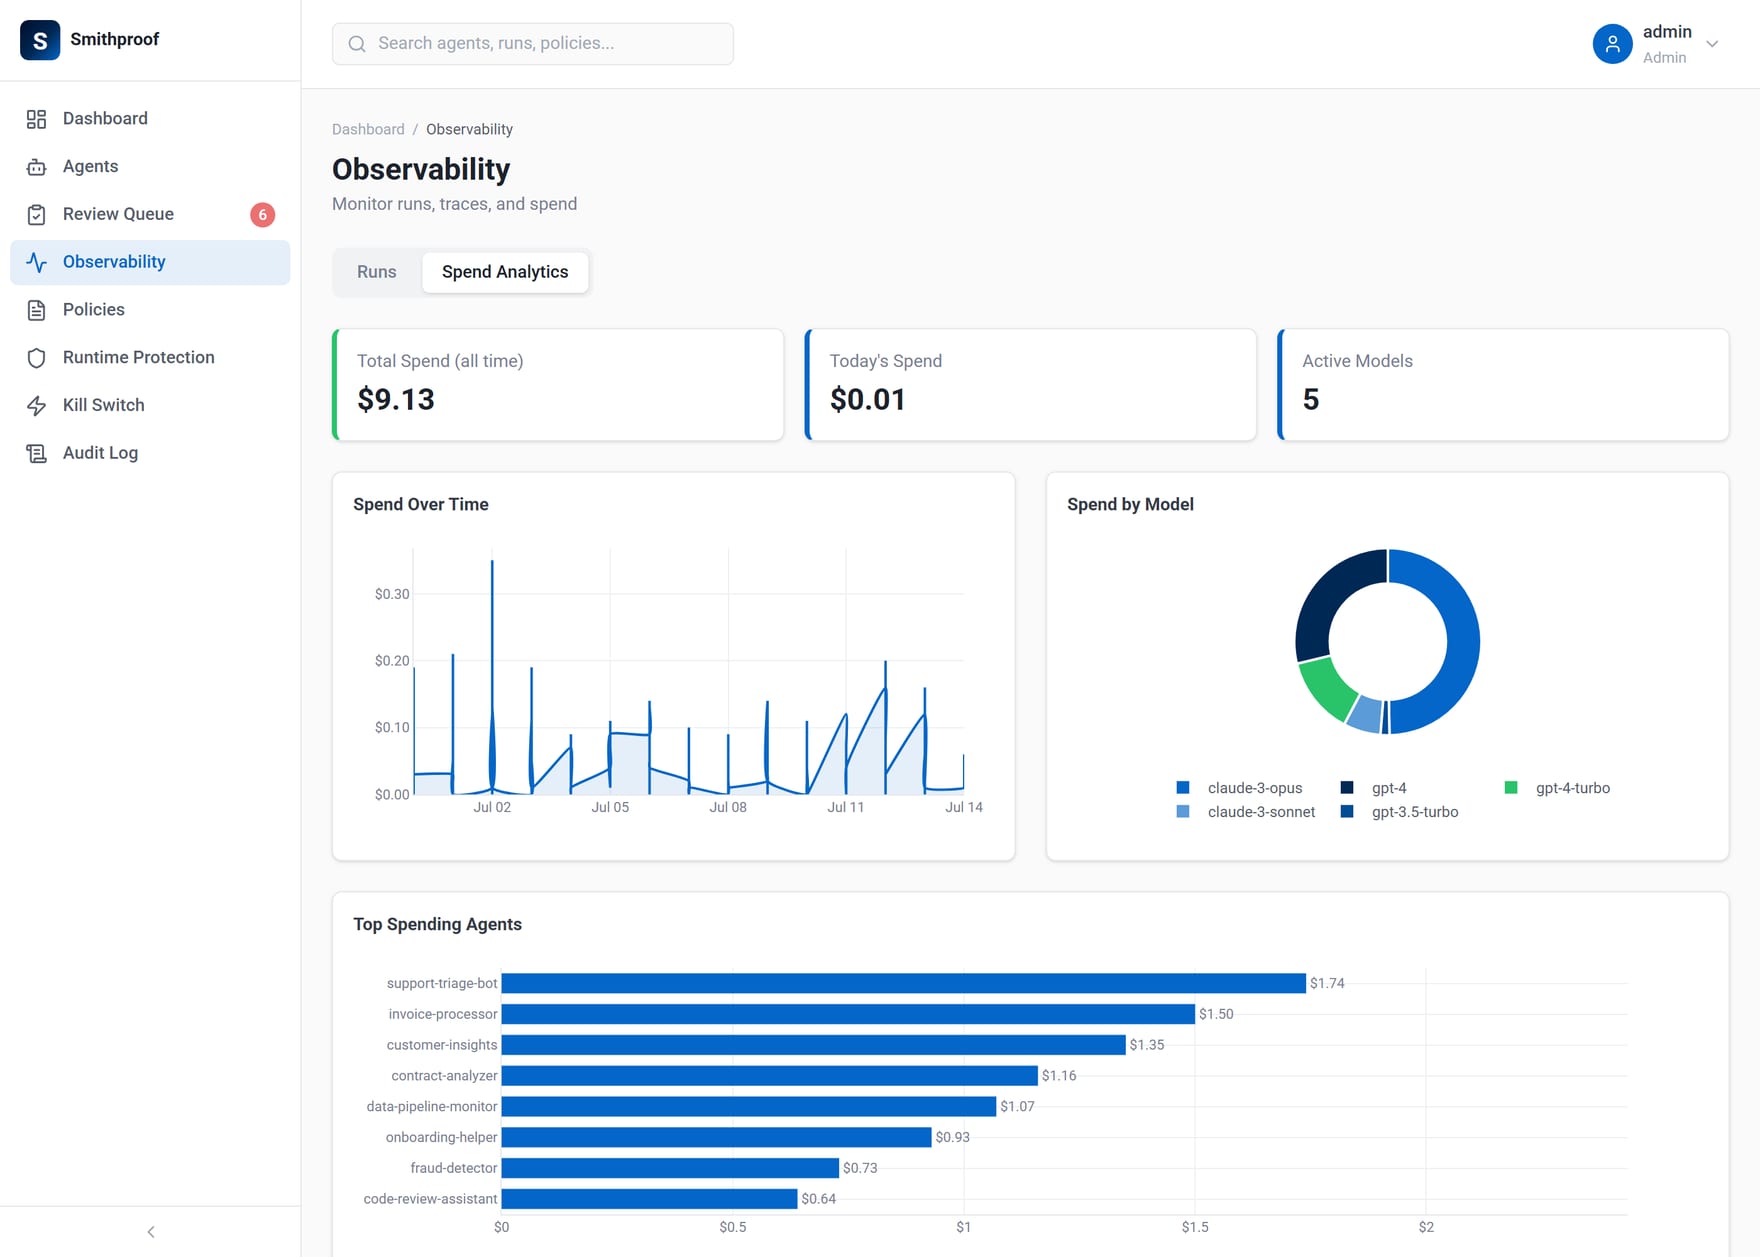 O gasto é agregado a partir das chamadas a modelos registadas, não a partir da palavra do chamador, e mostrado aqui ao longo do tempo, por modelo e por agente.
Ajuda ver onde a categoria foi retalhada, porque um plano de controlo é uma tentativa de a voltar a unificar:
| Fatia | Soluções pontuais |
|---|---|
| Rastreio e custo | Langfuse, LangSmith |
| Gateway e encaminhamento | Portkey, LiteLLM |
| Guardrails e análise | Lakera, Presidio |
| Aprovação humana | HumanLayer |
| Governança empresarial | MuleSoft Agent Fabric |
Cada uma faz bem uma fatia. A aposta de um plano de controlo é que um registo, uma consola e um kill switch que abrangem todas elas valem mais do que a soma, porque a governança vive nas costuras.
Uma decisão, a fundo: guardrails sem o imposto de 370MB
A decisão de engenharia mais interessante de todas foi como fazer a deteção de injeção de prompt.
A abordagem padrão é um pequeno classificador afinado, tipicamente um modelo DeBERTa treinado para detetar injeção. As bibliotecas prontas a usar que o encapsulam arrastam consigo o PyTorch, uma dependência com centenas de megabytes e um arranque a frio lento. Para um serviço cuja função é ficar discretamente ao lado dos agentes e analisar, pagar um imposto de importação de mais de 370MB e um aquecimento de vários segundos por um só classificador é o compromisso errado.
Por isso o scanner corre o mesmo modelo exportado para ONNX e executado através do ONNX Runtime: cerca de cinquenta linhas para tokenizar, correr, ler logits, sem PyTorch na árvore. A deteção de PII é o Presidio com spaCy, carregado de forma preguiçosa para que o grafo de importações e o caminho comum se mantenham leves. O compromisso é explícito e vale a pena registá-lo: abdica-se do conforto da biblioteca com tudo incluído e assume-se a tarefa de ser dono do tokenizador e da cola de inferência, em troca de uma pegada de dependências e de um perfil de latência que servem um plano de controlo.
A lição generaliza-se. Os guardrails são habitualmente apresentados como uma questão de qualidade de deteção. Na prática, para infraestrutura que corre a cada ação, são antes de mais uma questão de peso de dependências e de latência. O modelo que se pode dar ao luxo de correr em linha é o modelo que governa; o mais preciso, que tem de ser adiado para uma fila, governa menos.
A parte que toda a gente subestima
Eis a coisa que mais quero transmitir.
Deteção sem resposta não governa nada. É fácil construir detetores que produzem um evento de ameaça e uma linha num painel. Dá a sensação de proteção. Não é. Um detetor configurado para pôr um agente em quarentena tem mesmo de o pôr em quarentena; um alerta tem de disparar. A ligação entre "foi detetada uma ameaça" e "a frota mudou de estado e um humano foi avisado" é o trabalho a sério, e é invisível numa demonstração. Um plano de controlo em que a metade da resposta do detetar-e-responder não está ligada é uma captura de ecrã de proteção muito convincente.
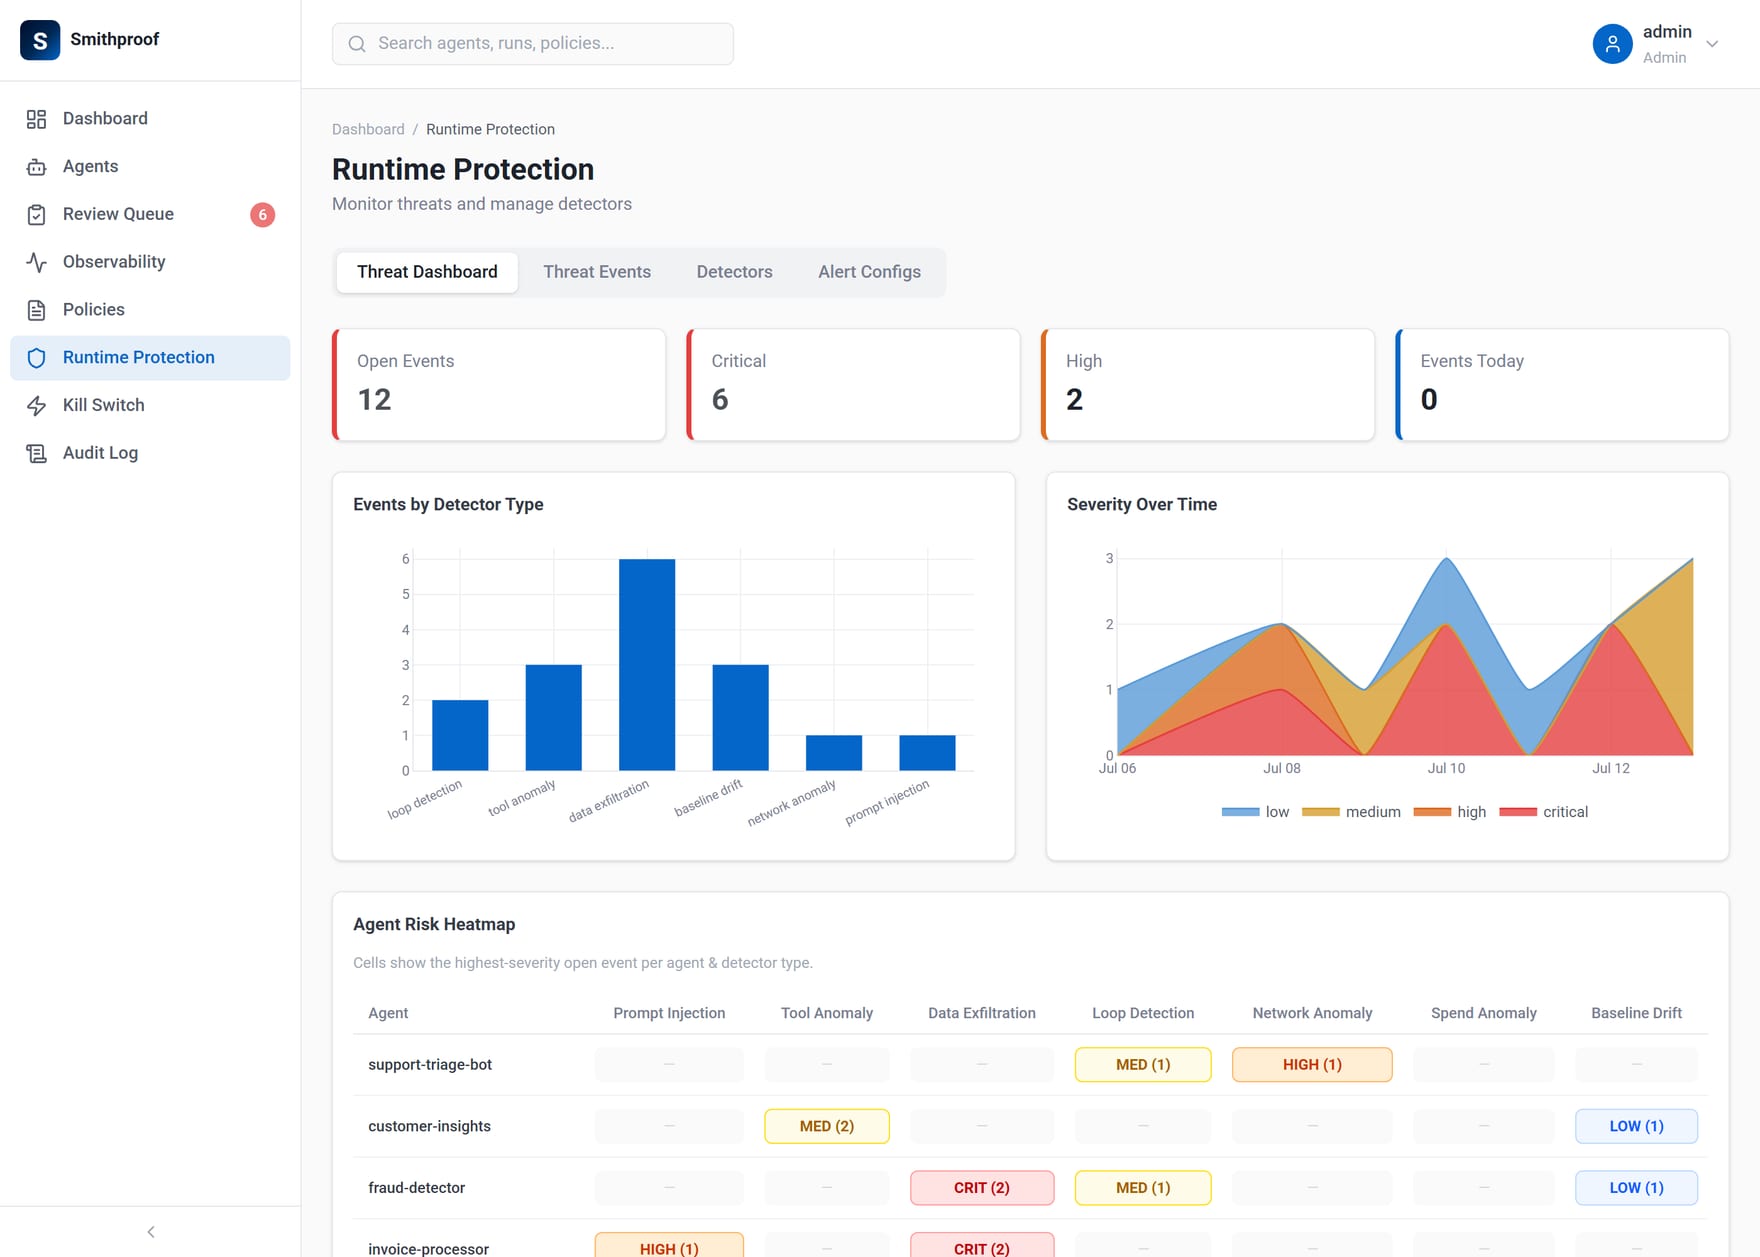 Cada evento neste ecrã é apenas tão real quanto a resposta ligada por trás dele.
Uma política é uma decisão; a aplicação é uma arquitetura. Esta é a versão mais profunda do mesmo ponto, e a fronteira que vale a pena traçar com mais precisão quando se desenha um destes sistemas. Um plano de controlo que governa através de telemetria reportada é um system of record: real para observação, atribuição e resposta a posteriori (quarentena, kill switch, revisão humana).
A prevenção é uma propriedade diferente, e vem de um lugar diferente da arquitetura: o caminho do pedido. O Portkey e o LiteLLM situam-se entre o chamador e o modelo, por isso um DENY é aplicado antes de a chamada acontecer, em vez de ser devolvido como conselho. Vale a pena reler aqui a orientação da Anthropic sobre a construção de agentes eficazes: quanto mais autonomia se concede, mais os controlos têm de ser estruturais em vez de meramente consultivos.
No Smithproof o motor de políticas já produz a decisão; o SDK de gateway que leva essa decisão para dentro do caminho é a camada seguinte, e todo o design foi moldado para que essa camada encaixe em vez de ser aparafusada por fora. Mantenha as duas propriedades bem distintas, porque numa consola parecem idênticas e garantem coisas completamente diferentes.
Um kill switch tem de parar trabalho novo, não apenas o antigo. "Travar todos os agentes" é trivial de implementar como uma atualização de estado em linhas existentes e completamente inútil se um agente travado ainda puder abrir uma nova execução um segundo depois. O interruptor tem de controlar a criação de trabalho, de modo que um agente em quarentena ou sob um kill switch ativo seja barrado à entrada.
A metade sem glamour: inquilinato, papéis, auditoria honesta
Este é o trabalho de design menos interessante do produto, e é ele que decide se o pode entregar a um segundo cliente.
A arquitetura multi-inquilino é onde as fugas se escondem, sobretudo quando é acrescentada a posteriori. As entidades de configuração carregam diretamente um id de organização; as entidades derivadas (execuções, revisões, intervenções) só pertencem a uma organização de forma transitiva, através do seu agente. A armadilha é o acesso por id: os endpoints de listagem são fáceis de delimitar, mas um GET /runs/{id} que autentica o utilizador e depois vai buscar a execução apenas pelo id, sem verificar se o agente da execução pertence à organização do chamador, é uma leitura entre inquilinos. A correção é aborrecida e tem de estar em todo o lado: resolver a cadeia de propriedade em cada handler por id e devolver um 404 se não corresponder. A mesma disciplina aplica-se aos efeitos do plano de controlo. Uma cascata de kill switch ou uma avaliação de política que não esteja delimitada à organização que age irá alegremente travar ou governar a frota de outra pessoa.
Os papéis têm de ser aplicados, não decorativos. Três papéis, visualizador, operador, administrador, só são reais se o servidor rejeitar um operador que tenta apagar um agente e um visualizador que tenta o que quer que seja. Um papel que a UI lê e a API ignora não é controlo de acesso.
A identidade de auditoria não pode vir do cliente. O ator num registo "imutável" de intervenções tem de ser derivado da sessão autenticada. Se o servidor tirar o performed_by do corpo do pedido, o registo é ficção: qualquer pessoa pode atribuir a ativação de um kill switch a um colega. Esta é uma decisão de uma linha com um efeito desproporcionado sobre se o rasto de auditoria significa alguma coisa.
Os limites de orçamento têm de ler números reais. Um limite de gasto que confia num valor de current_spend fornecido pelo chamador é contornado ao omitir o campo. A plataforma já agrega o gasto a partir das chamadas a modelos registadas; o limite tem de ler esse, não o pedido.
Um URL de webhook é uma credencial. Os canais de alerta são configurados com URLs de webhook, e um URL de webhook do Slack é um segredo ao portador: qualquer pessoa que o leia pode publicar em seu nome. Isso faz da configuração de alertas um pequeno cofre de credenciais, e ela merece o tratamento de um: segredos cifrados em repouso (AES-256-GCM com chave derivada do segredo da aplicação), decifrados mesmo a tempo do envio, e nunca devolvidos pela API, que envia uma máscara no lugar deles. Sejamos justos: este começou como a proposta de um colaborador externo que eu integrei, o que é, por si só, uma pequena lição sobre a metade sem glamour. É onde um novo par de olhos vê com mais clareza.
Ponto da situação
Hoje o Smithproof é um system of record multi-inquilino com governança ativa: os agentes reportam telemetria por REST, e a plataforma armazena-a, visualiza-a, analisa-a e intervém através de quarentena, alertas, aprovação humana e um kill switch que barra novas execuções à entrada. A camada seguinte é o gateway em linha que leva as decisões de política para o caminho do pedido, e a arquitetura foi construída com essa costura já pronta: o motor de políticas já emite o veredicto, e a função do gateway é posicionar-se onde possa agir sobre esse veredicto.
Se há uma coisa a reter da construção disto: os vinte por cento interessantes de um plano de controlo são a deteção e a política, e é essa a parte que aparece nas demonstrações. Os oitenta por cento que decidem se ele governa alguma coisa são a resposta, a aplicação, o inquilinato, os papéis e a auditoria honesta. Nada disto fica bem em fotografia. Tudo isto é o produto. E se o nome cumprir a sua função, mantém o que está em jogo à vista: o objetivo é uma frota onde nenhum agente, por mais capaz que seja, possa fazer um Agent Smith.
Perguntas a que este artigo responde
Porquê construir um plano de controlo se já existem o Langfuse, o Portkey e o Lakera?
Cada um deles faz bem uma fatia: rastreio e custo, gateway e encaminhamento, guardrails e análise, aprovação humana. A aposta de um plano de controlo é que um registo, uma consola e um kill switch que abrangem todas elas valem mais do que a soma, porque a governança vive nas costuras. Travar todos os agentes que tocaram na ferramenta de faturação nesta última hora e saber quem aprovou isso são quatro perguntas em quatro produtos, ou uma só consulta num só lugar.
Como se faz deteção de injeção de prompt sem arrastar o PyTorch para dentro do serviço?
Exportando o mesmo classificador DeBERTa afinado para ONNX e correndo-o através do ONNX Runtime, o que dá cerca de cinquenta linhas para tokenizar, correr e ler logits, sem PyTorch na árvore de dependências. As bibliotecas prontas a usar que encapsulam o classificador custam um imposto de importação de mais de 370MB e um aquecimento de vários segundos, o que é o compromisso errado para um serviço que analisa cada ação. A deteção de PII é o Presidio com spaCy, carregado de forma preguiçosa para que o caminho comum se mantenha leve. O preço é ficar dono do tokenizador e da cola de inferência.
Um kill switch trava mesmo um agente descontrolado?
Só se controlar a criação de trabalho. Travar todos os agentes é trivial de implementar como uma atualização de estado em linhas existentes e completamente inútil se um agente travado puder abrir uma nova execução um segundo depois, por isso um agente em quarentena ou sob um kill switch ativo tem de ser barrado à entrada. A mesma disciplina de delimitação aplica-se à própria cascata: um kill switch que não esteja delimitado à organização que age irá alegremente travar a frota de outra pessoa.
Onde se escondem as fugas entre inquilinos numa plataforma destas?
No acesso por id. As entidades de configuração carregam diretamente um id de organização, mas as entidades derivadas, como execuções, revisões e intervenções, só pertencem a uma organização de forma transitiva, através do seu agente, por isso um handler que autentica o utilizador e depois vai buscar uma execução apenas pelo id é uma leitura entre inquilinos. A correção é aborrecida e tem de estar em todo o lado: resolver a cadeia de propriedade em cada handler por id e devolver um 404 quando não corresponde.
Ler a seguir
 AI Agents
Construí uma camada de IA que nunca responde. Eis o que uma boa pergunta realmente exige
Notas de campo do OrbitSpec, um motor de clarificação que transforma pedidos vagos em Context Bundles tipados e auditáveis antes de qualquer modelo correr, e porque é que a fiabilidade começa antes da resposta. AI Agents
Construí o pipeline que construiu o meu produto. Eis o que delegar realmente exige
Notas de campo do plan-to-pr, um pipeline que transforma um pedido de funcionalidade em tickets, num gate de aprovação e em draft pull requests, e a razão pela qual delegar em agentes de código exige artefactos, não conversa.