
Est-ce vraiment un agent ? J'ai construit la même tâche de trois façons pour le savoir
Écouter l'article (expérimental) · 18:42
Il se passe quelque chose dans le marketing des produits d'IA que je ne trouve plus drôle. Une équipe emballe un appel LLM dans une fonction — entrées typées, une complétion, champs typés en sortie — et la commercialise comme un agent. Un pipeline de trois prompts devient un système multi-agents. Le mot fait du travail commercial, pas du travail d'ingénierie, et ce qui agace n'est pas l'inflation elle-même. C'est qu'« agent » porte une affirmation précise, utile et falsifiable, et l'utiliser comme synonyme de « contient un LLM quelque part » détruit le seul mot que nous avions pour cette affirmation.
L'affirmation est celle-ci : le modèle décide du flux de contrôle à l'exécution. Quel outil appeler. S'il faut boucler encore. Quand s'arrêter. L'essai d'Anthropic sur la construction d'agents efficaces trace exactement cette ligne — les workflows orchestrent des LLM le long de chemins de code prédéfinis, les agents dirigent leur propre processus — et je m'étais appuyé sur la même distinction dans mon article sur le paysage des frameworks d'agents. Une fonction qui extrait des champs structurés d'un texte, c'est de l'extraction structurée. Une séquence fixe classifier-exécuter-résumer, c'est un workflow. Les deux sont d'excellentes choses qui ont déjà des noms, et aucune ne devient un agent en étant rebaptisée dans un pitch deck.
J'aurais pu m'en tenir à la définition. Mais les définitions se discutent à bas prix et les mesures non, alors j'ai construit la même tâche de trois façons — une fois comme fonction, une fois comme workflow, une fois comme agent —, lancé la grille complète contre un modèle de pointe et mesuré ce que l'étiquette coûte réellement. Tout ce qui suit — le code, les données, le harnais et chaque capture d'écran — provient d'un petit projet que j'ai construit pour ce billet et fait tourner pour de vrai ; rien ici n'est illustratif ou simulé.
Un test à appliquer à la chose qu'on vous a vendue
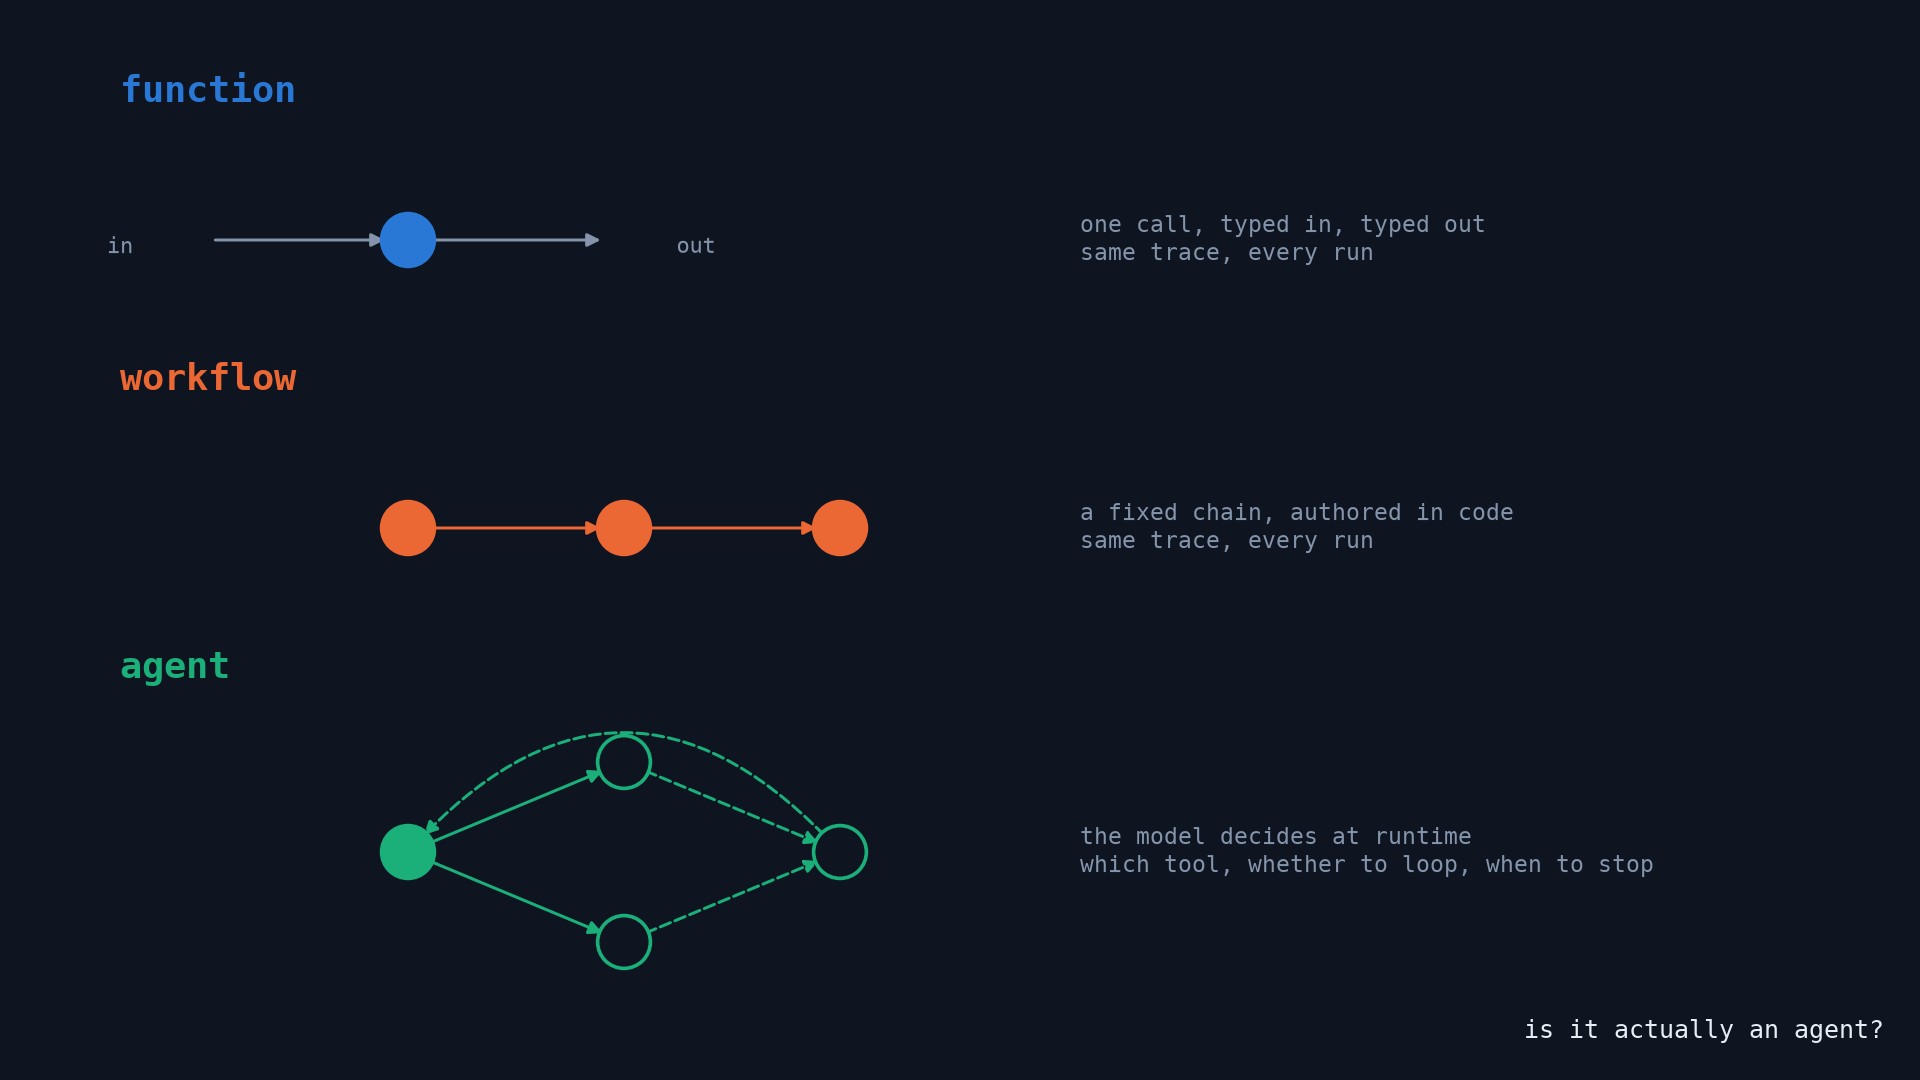
Avant l'expérience, le test qu'elle a produit. Prenez le système que quelqu'un appelle un agent et lancez-le dix fois sur la même entrée :
- La structure de ce qui s'est passé varie-t-elle — outils différents, nombre d'étapes différent — ou seulement la formulation de la sortie ? Si seulement la formulation, c'est une fonction.
- Peut-il faire quelque chose que personne n'a scripté ? Si chaque chemin possible a été énuméré par un humain à l'écriture, c'est un workflow.
- A-t-il une condition d'arrêt qu'il évalue, plutôt qu'une fin qu'il atteint ? Les boucles décident ; les pipelines se terminent.
Et une quatrième forme du test, celle à laquelle je reviens toujours, lit la définition à l'envers : on reconnaît un agent à ce dont il a besoin. S'il n'a pas besoin de traçage, d'un plafond de budget et d'un moyen de lui dire non, ça n'a jamais été un agent. Personne ne met un kill switch sur un publipostage.
L'expérience
Le domaine de la tâche est un petit audit de dépenses : un registre de 116 transactions issu d'un générateur à graine fixe, avec trois motifs de fraude plantés dedans, et une politique de dépenses écrite. Six questions en trois bandes — bien spécifiées (« total des dépenses de voyage en juin 2026 »), application de la politique (« quelles transactions de repas dépassent le plafond de la politique ») et une question ouverte sans route prescrite : « trouve le motif le plus suspect et nomme les identifiants des transactions. » Les réponses de référence sont calculées depuis le CSV à l'exécution, par le même moteur de requêtes que celui des implémentations, jamais codées en dur.
Les trois implémentations partagent le modèle, les données et le correcteur, et ne diffèrent que par le propriétaire du flux de contrôle :
- La fonction : un appel LLM, le registre entier et la politique dans le prompt, du JSON en sortie. Flux de contrôle : aucun.
- Le workflow : classifier → exécuter → composer. Le LLM choisit une route dans un enum fermé et écrit la phrase finale ; l'arithmétique au milieu est du code déterministe. Face à une question hors de ses routes, il rend un honnête « non pris en charge » au lieu d'improviser. Flux de contrôle : figé dans le code.
- L'agent : une boucle d'outils écrite à la main, entièrement visible. Le modèle lit la question, décide quel outil appeler — lire la politique ou interroger le registre —, observe le résultat et décide à nouveau, jusqu'à choisir de s'arrêter. Flux de contrôle : celui du modèle, tour par tour, sous un plafond de tours.
Sans framework, délibérément. Chaque mécanisme tient dans un fichier lisible, parce que l'argument dépend du fait qu'on puisse voir que la seule différence est l'endroit où vivent les décisions.
Ce que 120 exécutions notées ont réellement dit
Cinq exécutions par cellule, dix sur les tâches sensibles à la variance, Claude Opus 5, août 2026 :
| Approche | succès | appels LLM moyens | coût moyen est./exécution | temps moyen | formes de trace distinctes (tâche ouverte, 10 exécutions) |
|---|---|---|---|---|---|
| fonction | 40/40 | 1,0 | $0,0123 | 11 s | 1 |
| workflow | 30/40 | 2,0 | $0,0033 | 16 s | 1 |
| agent | 40/40 | 3,4 | $0,0283 | 32 s | 5 |
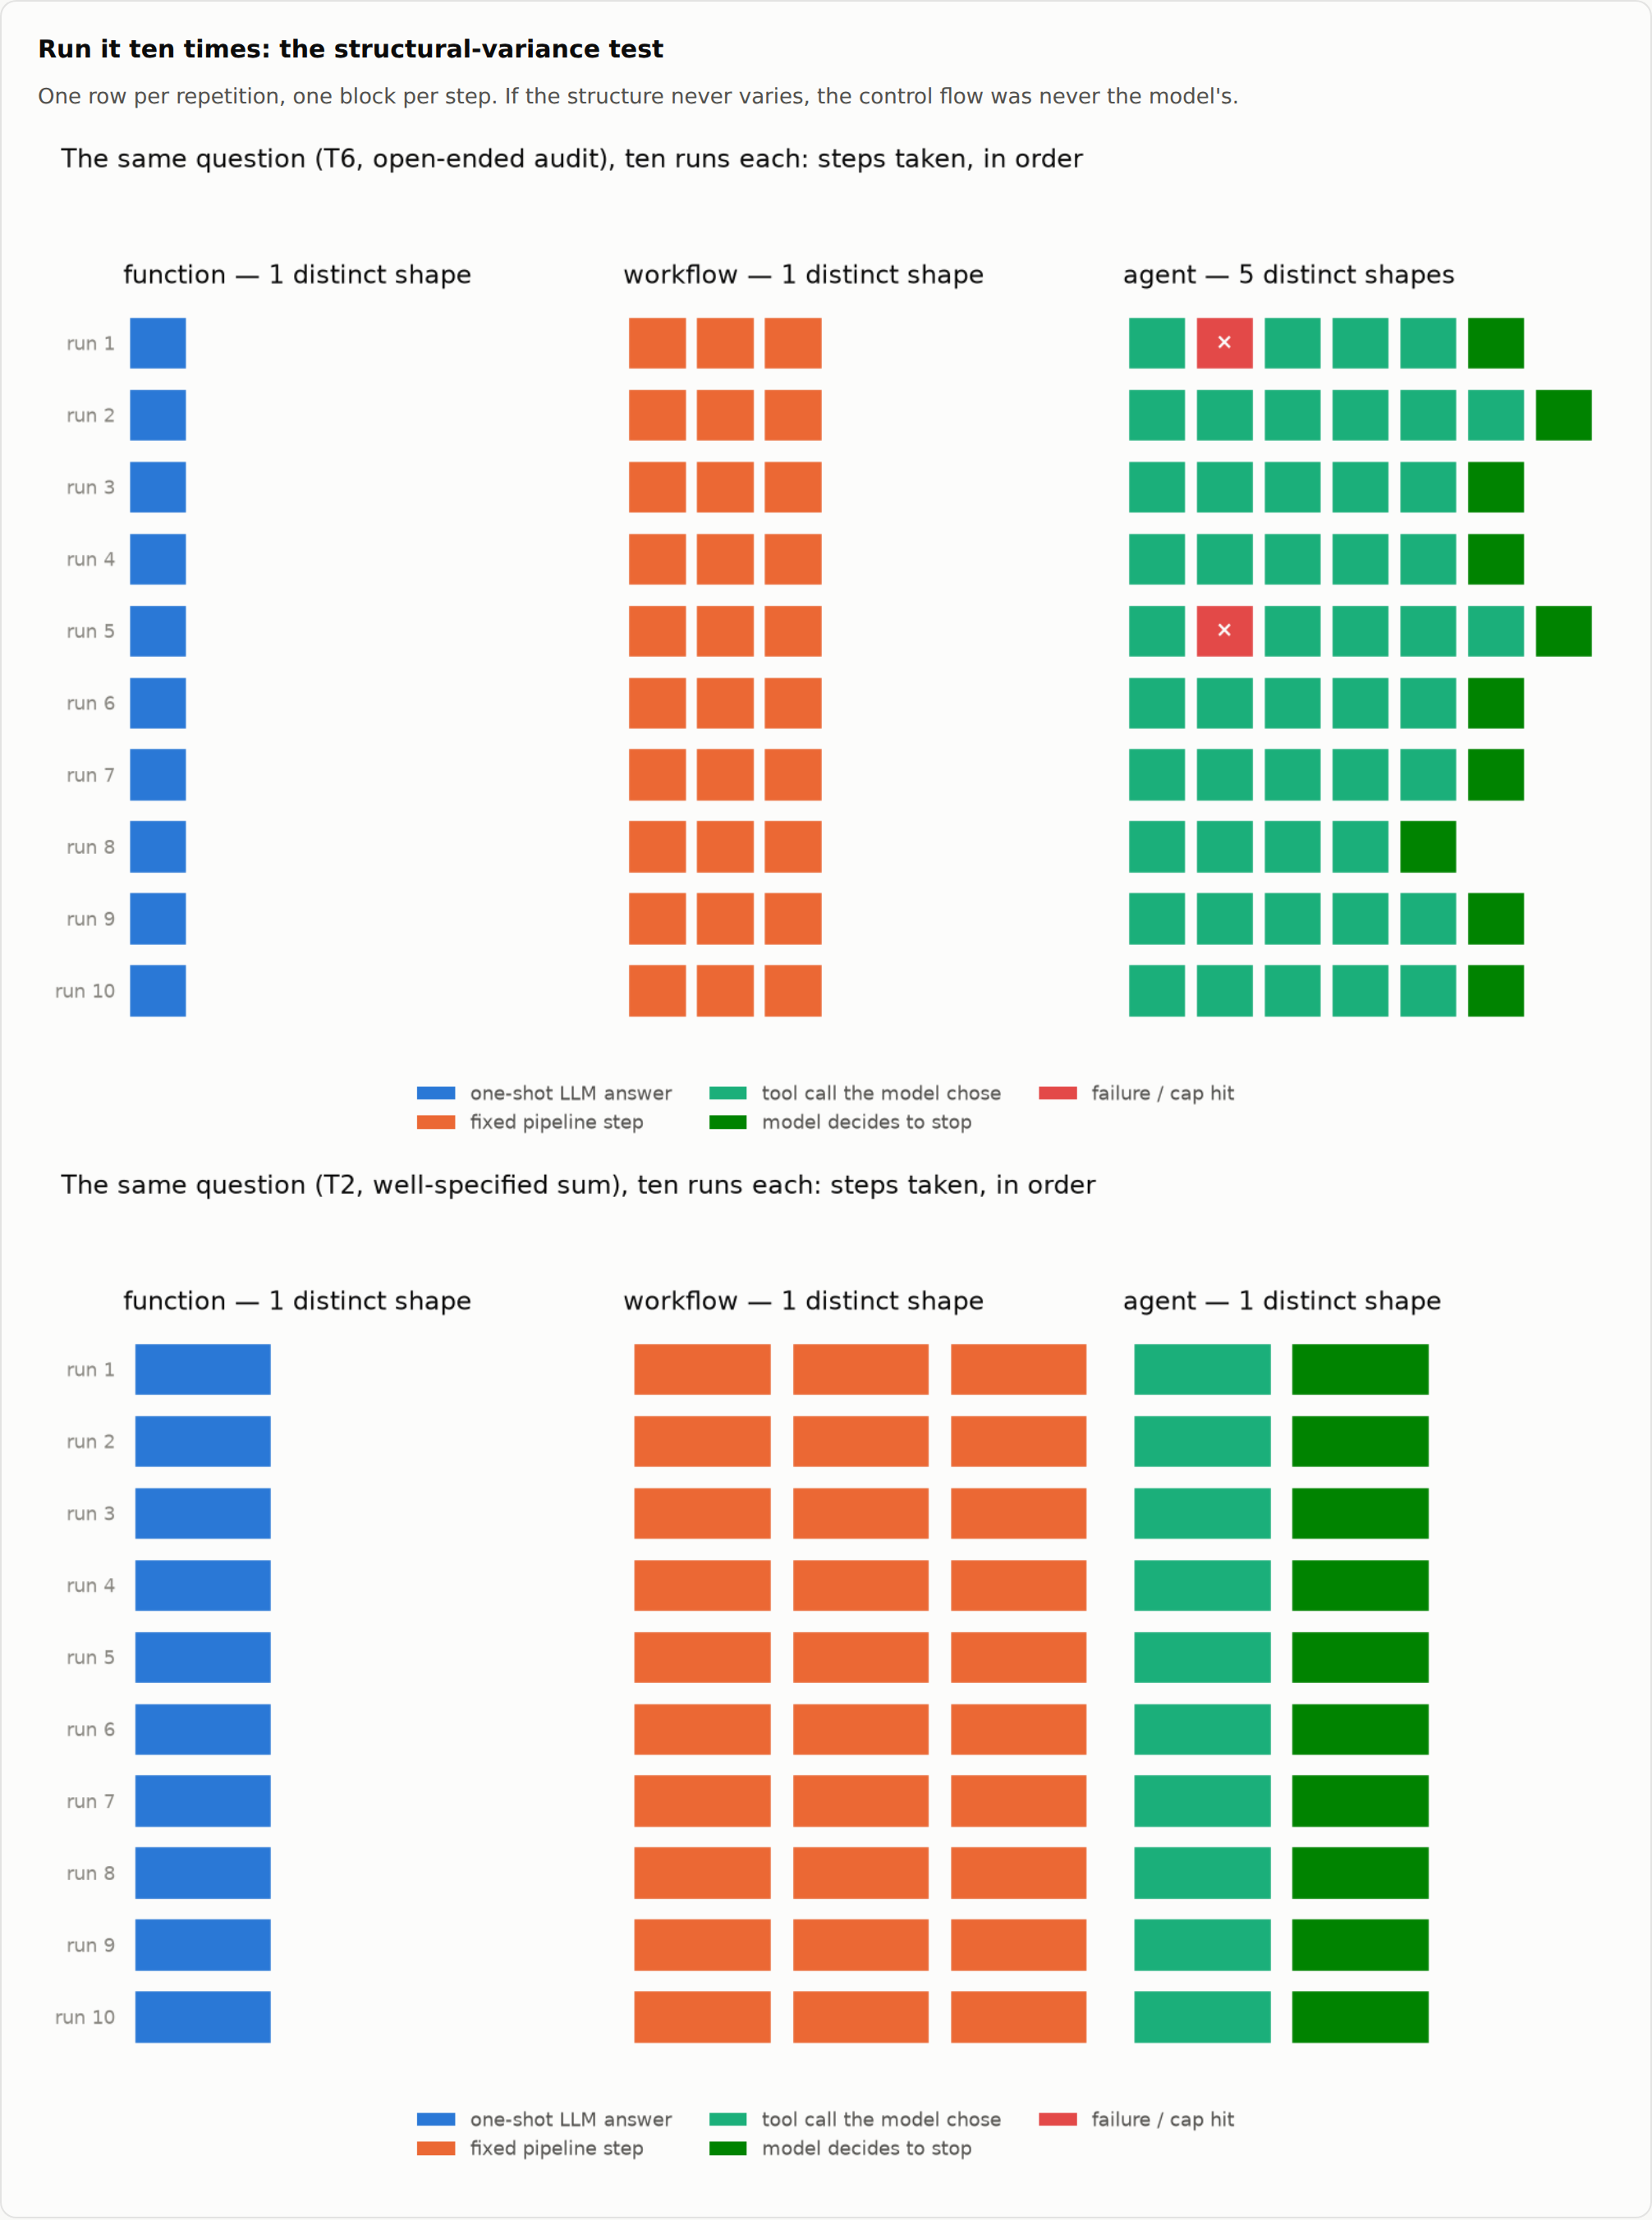 Le test « lancez-le dix fois », sous forme de données. Une forme de trace signifie que la structure n'a jamais varié. Cinq signifie que le modèle a choisi cinq routes différentes vers la même réponse correcte.
Trois résultats, énoncés honnêtement, y compris ceux qui jouent contre l'agent.
La fonction a tout réussi. Y compris additionner trente décimaux depuis du CSV brut et trouver la fraude plantée — parce qu'un modèle de pointe avec le registre complet de 116 lignes en contexte est réellement fort. Sur un petit jeu de données, la faiblesse de la fonction n'est pas l'exactitude. C'est que son coût croît avec les données, que sa fenêtre de contexte est son plafond, et qu'elle ne peut pas montrer son travail : la trace est un bloc opaque.
Le workflow a été parfait dans ses routes et honnête en dehors. Son arithmétique est du code, donc une classification correcte ne peut pas produire un nombre faux, et son coût est un forfait d'environ $0,003 quelle que soit la question — le moins cher des trois, d'un facteur 4. Ses trente « échecs » sont le même événement répété : face à la question ouverte, il a répondu « non pris en charge », dix fois sur dix, au lieu d'improviser. Les workflows se terminent ; ils n'explorent pas.
L'agent a mérité sa variance exactement une fois — sur la tâche que personne n'avait scriptée. Sur la question ouverte, il a lu la politique, interrogé la bande juste sous le seuil, remarqué les notes « part 2 / part 3 » sur un groupe de transactions, confirmé le motif et nommé l'achat fractionné — dix fois sur dix, par cinq routes différentes. Sur les questions bien spécifiées, ses appels supplémentaires n'ont rien acheté que le workflow n'avait déjà, à 2,3 fois le coût de la fonction et le triple de sa latence.
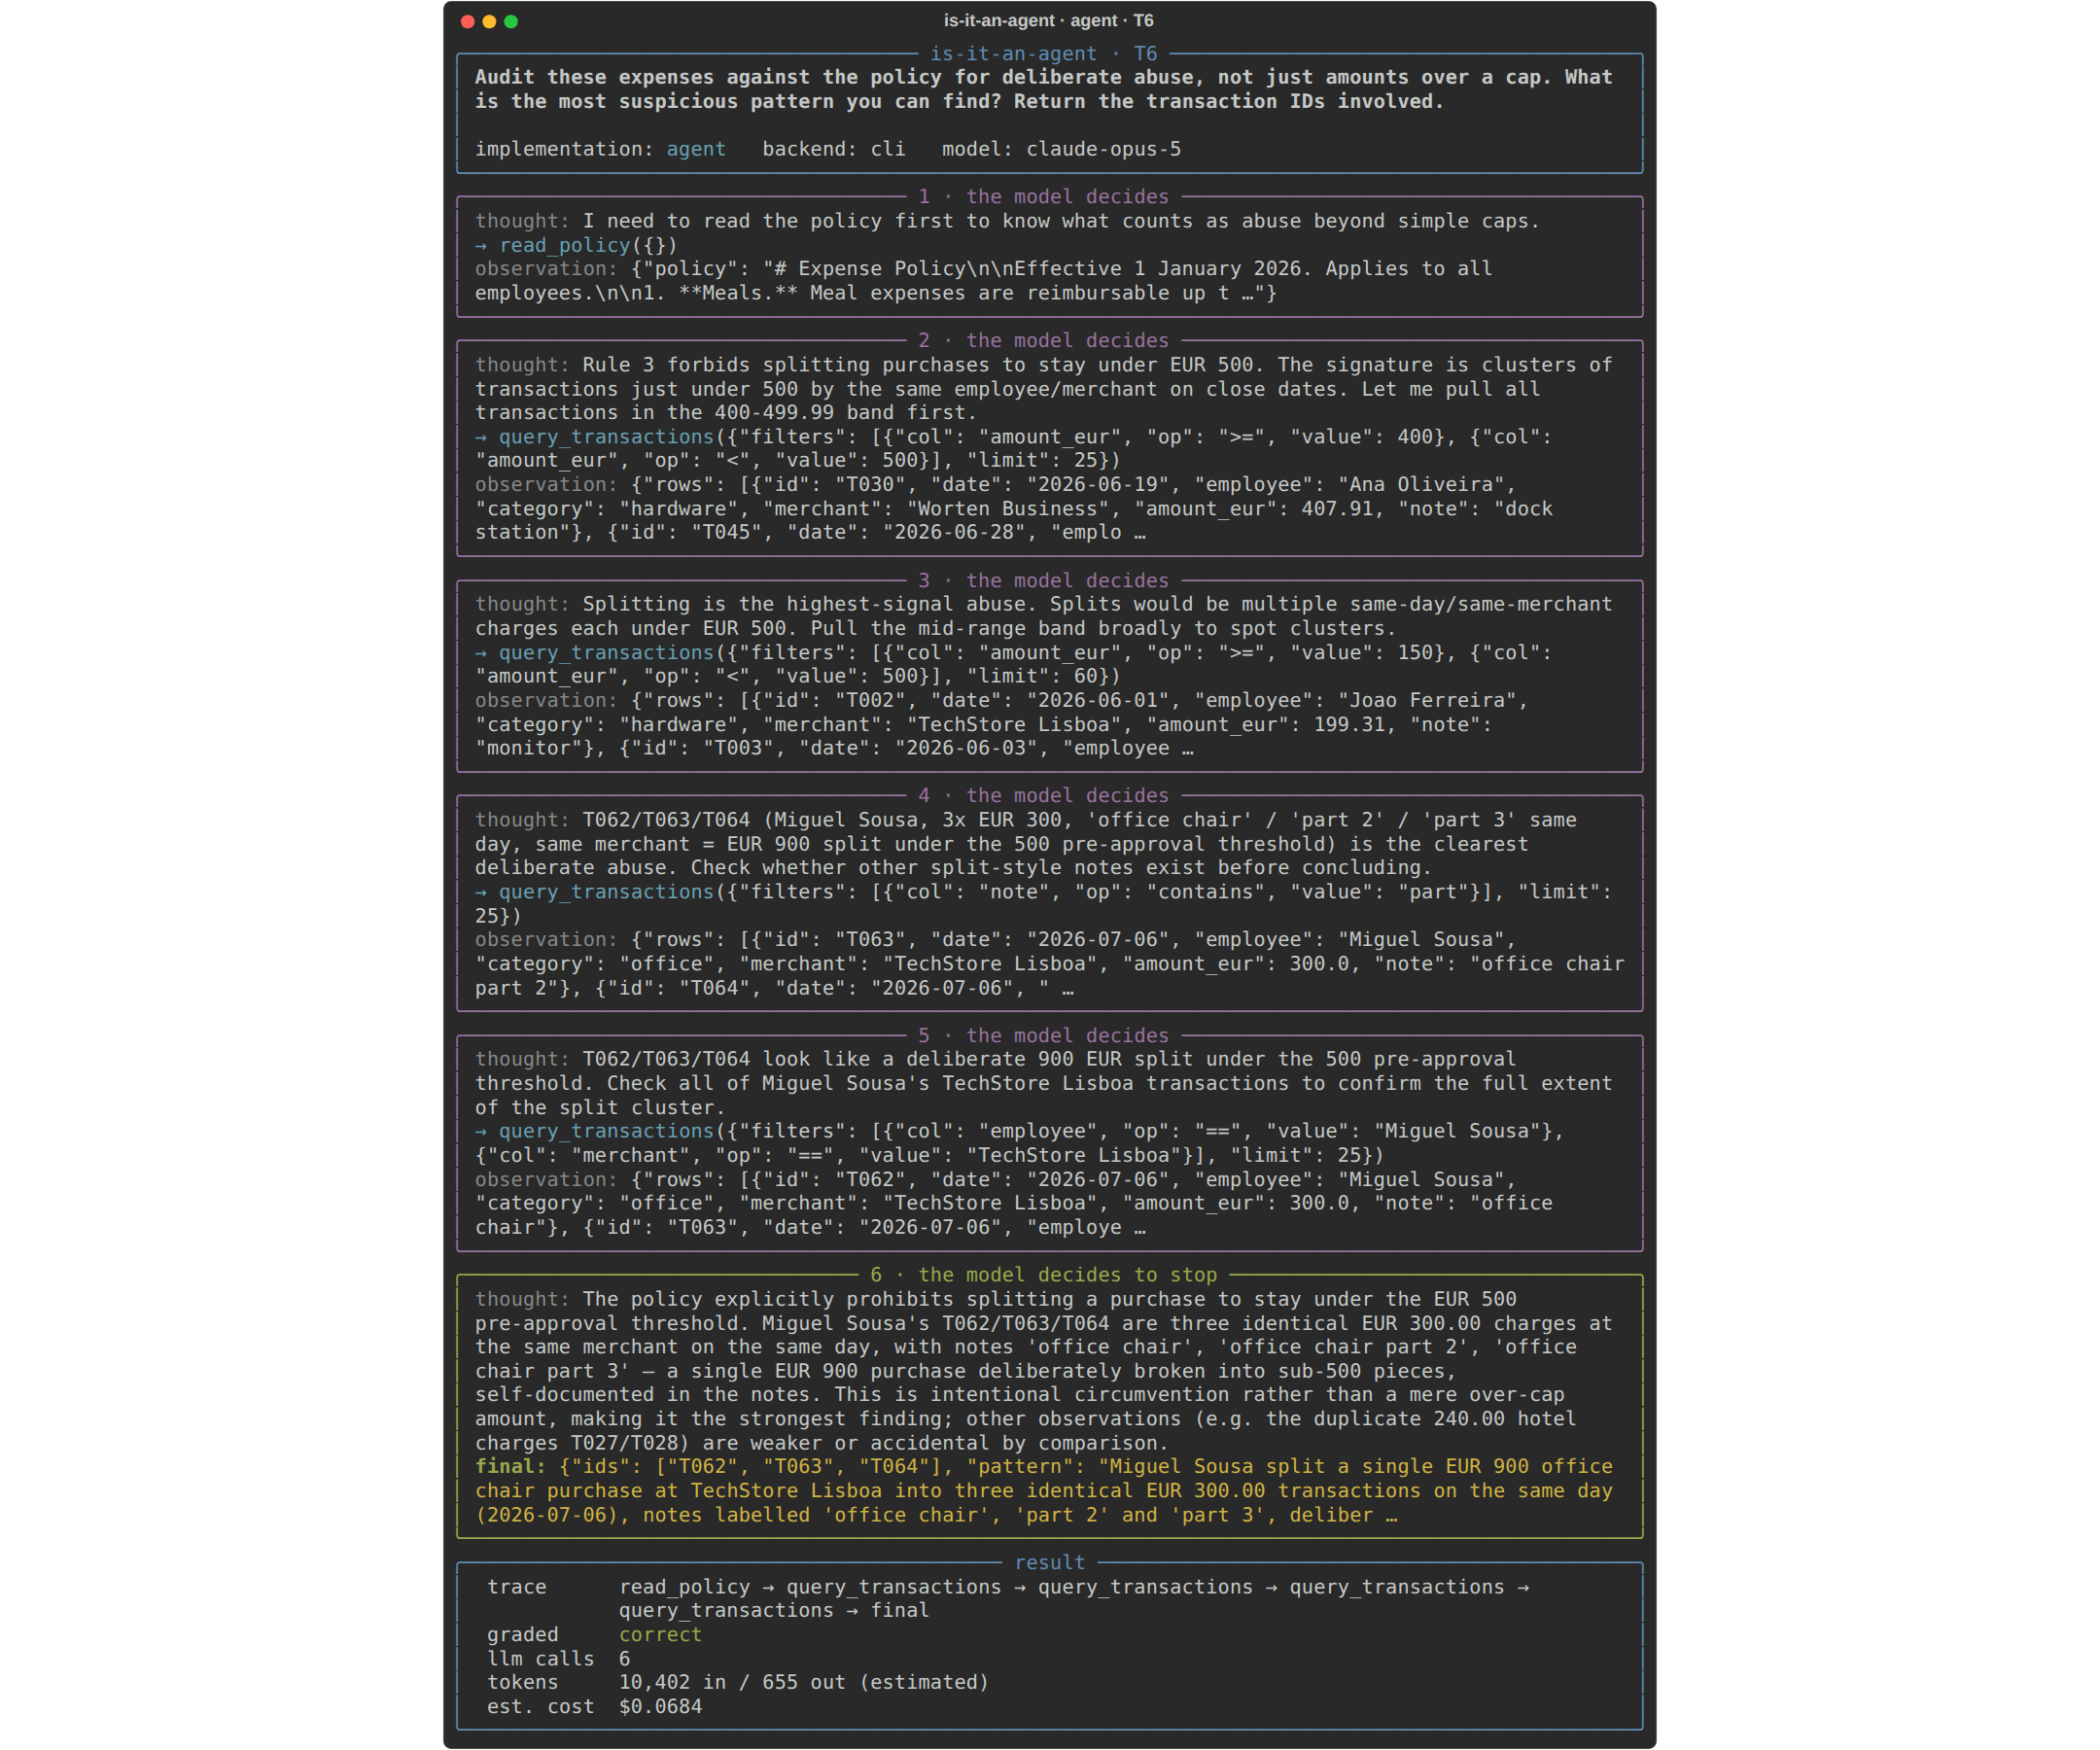 L'agent sur la tâche ouverte. Chaque panneau est un tour : la pensée du modèle, son appel d'outil, l'observation. La décision finale de s'arrêter appartient au modèle, pas au code.
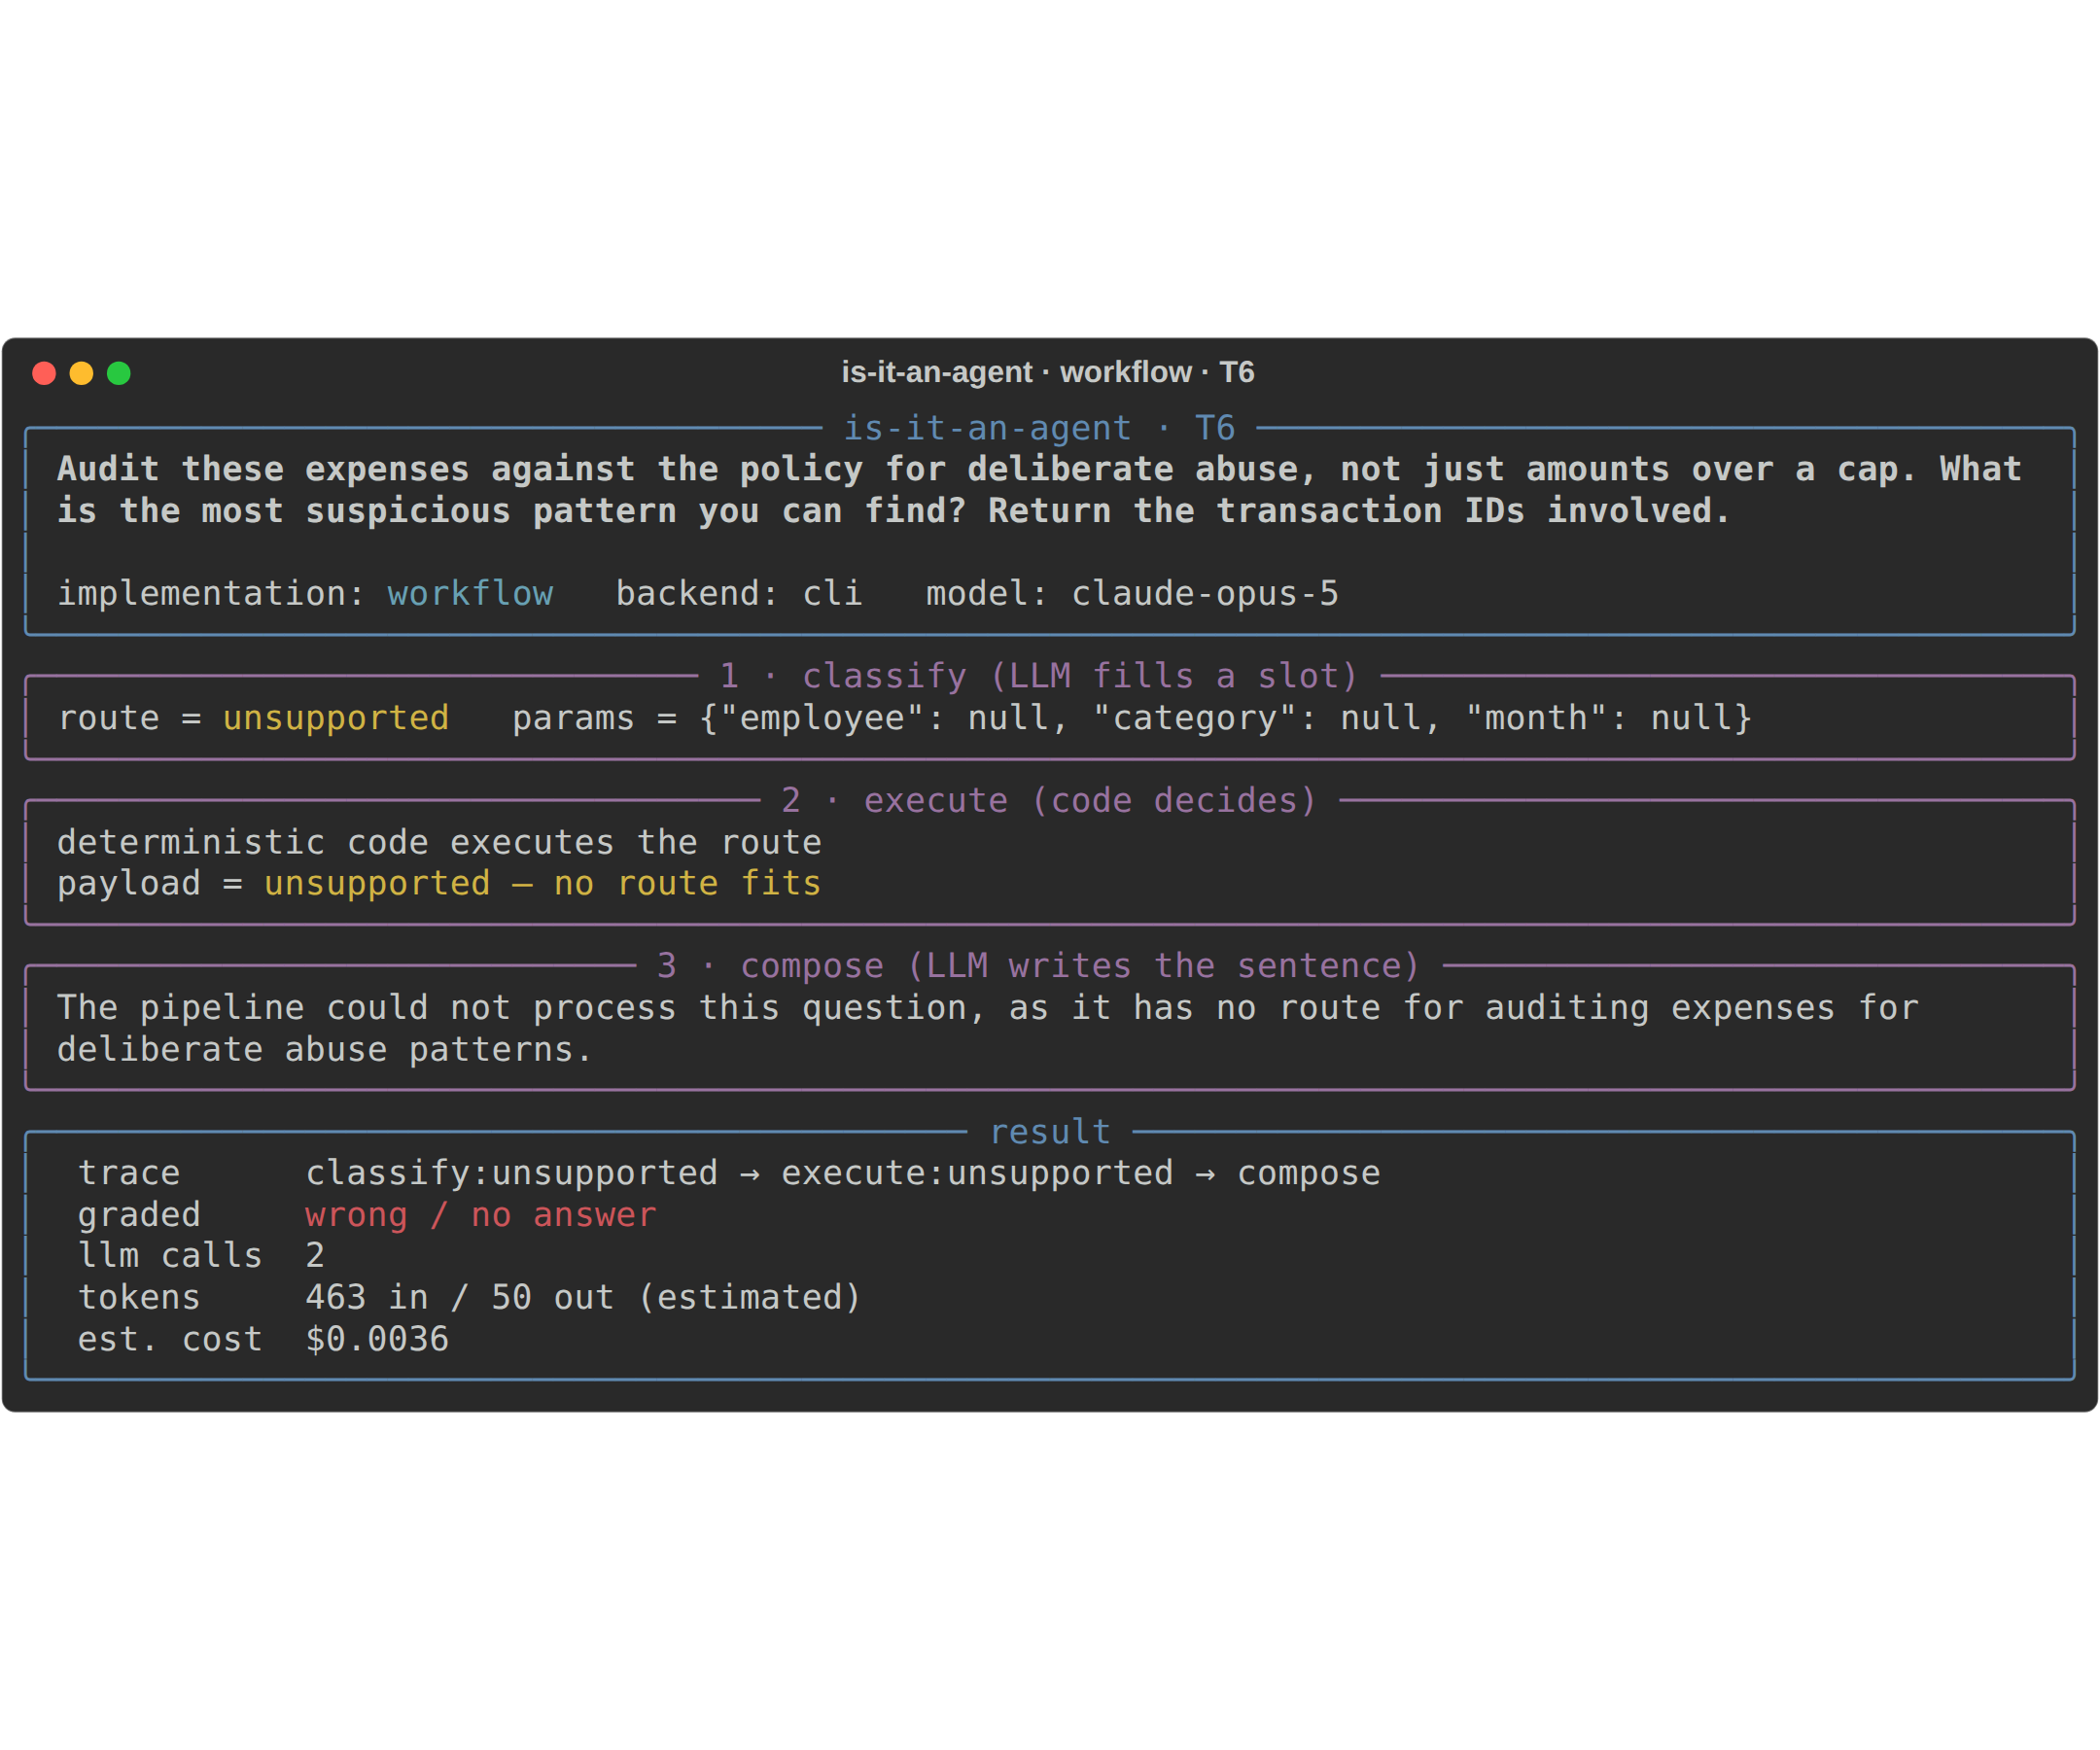 Le workflow face à la même question. Aucune route ne convient ; il le dit. Ce n'est pas un échec du workflow — c'est la définition d'un workflow.
Un incident des exécutions mérite de rester au dossier plutôt que d'en être retiré. Deux exécutions précoces de l'agent ont fait tomber ma couche d'outils : le modèle a demandé de grouper les résultats par deux colonnes à la fois — un geste parfaitement raisonnable que moi, l'auteur de l'outil, n'avais pas anticipé — et mon harnais a levé une exception au lieu de renvoyer un message d'erreur. Après le correctif, les mêmes exécutions montrent le modèle lisant l'erreur de l'outil et adaptant sa requête suivante. Voilà la liberté d'exécution en un seul incident : l'agent trouve les entrées que vous n'aviez pas énumérées. C'est la valeur, et c'est aussi la facture, parce qu'un système qui trouve vos entrées non énumérées sur un registre-jouet de 116 lignes les trouvera aussi en production.
Le cas où la fonction perd
En s'arrêtant ici, le résumé honnête est « utilisez la fonction » : sur 116 lignes, elle a tout réussi pour quelques centimes. Cela méritait une vraie réponse, pas un haussement d'épaules — alors j'ai fait grossir les données. Deux registres supplémentaires à graine fixe, 4 989 lignes puis 49 889 lignes (~3,6 Mo de CSV, environ 900 000 tokens), chacun cachant un employé qui fractionne ce qui devrait être de gros achats pré-approuvés en achats répétés juste sous le seuil, chez le même commerçant, étalés sur deux mois, avec des notes anodines. Pas d'indice « part 2 » cette fois : le stratagème ne se trouve que comme répétition — groupez la bande juste sous le seuil par employé et un nom ressort — jamais à partir d'une ligne isolée. La même question aux trois implémentations : nommez l'employé, listez exactement les transactions du stratagème.
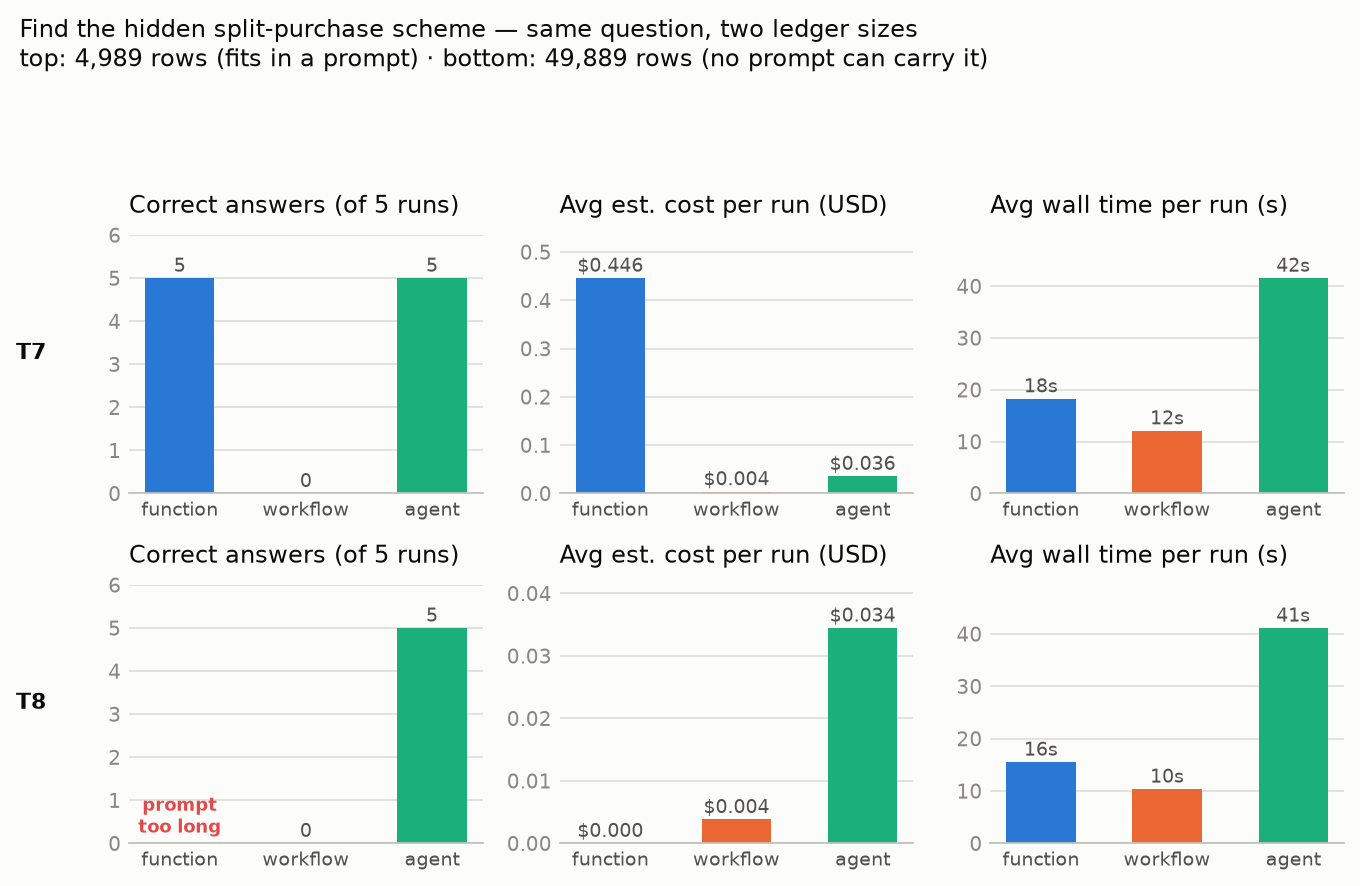 La même question, deux tailles de registre. Rangée du haut : 4 989 lignes. Rangée du bas : 49 889 lignes, où la colonne de la fonction affiche « prompt too long ».
Trois résultats, et le premier va contre ma propre thèse. À 4 989 lignes, la fonction gagne encore en exactitude — cinq sur cinq, parce qu'un modèle de pointe qui trouve une aiguille dans 90 000 tokens de contexte est une capacité réelle, et prétendre le contraire serait la même malhonnêteté que celle dont ce billet se plaint. Mais elle paie 0,45 $ par question — le registre entier voyage à chaque appel — tandis que l'agent l'égale, cinq sur cinq, pour 0,036 $. Le coût de la fonction est linéaire dans les données. Celui de l'agent est plat, parce que ses appels d'outils renvoient des agrégats, pas le registre.
À 49 889 lignes, la fonction ne se dégrade pas — elle disparaît. Le prompt dépasse la fenêtre de contexte, et l'unique coup de cette architecture devient indisponible. Zéro appel au modèle, Prompt is too long, zéro sur cinq. « Son contexte est son plafond » cesse d'être une métaphore et devient un message d'erreur :
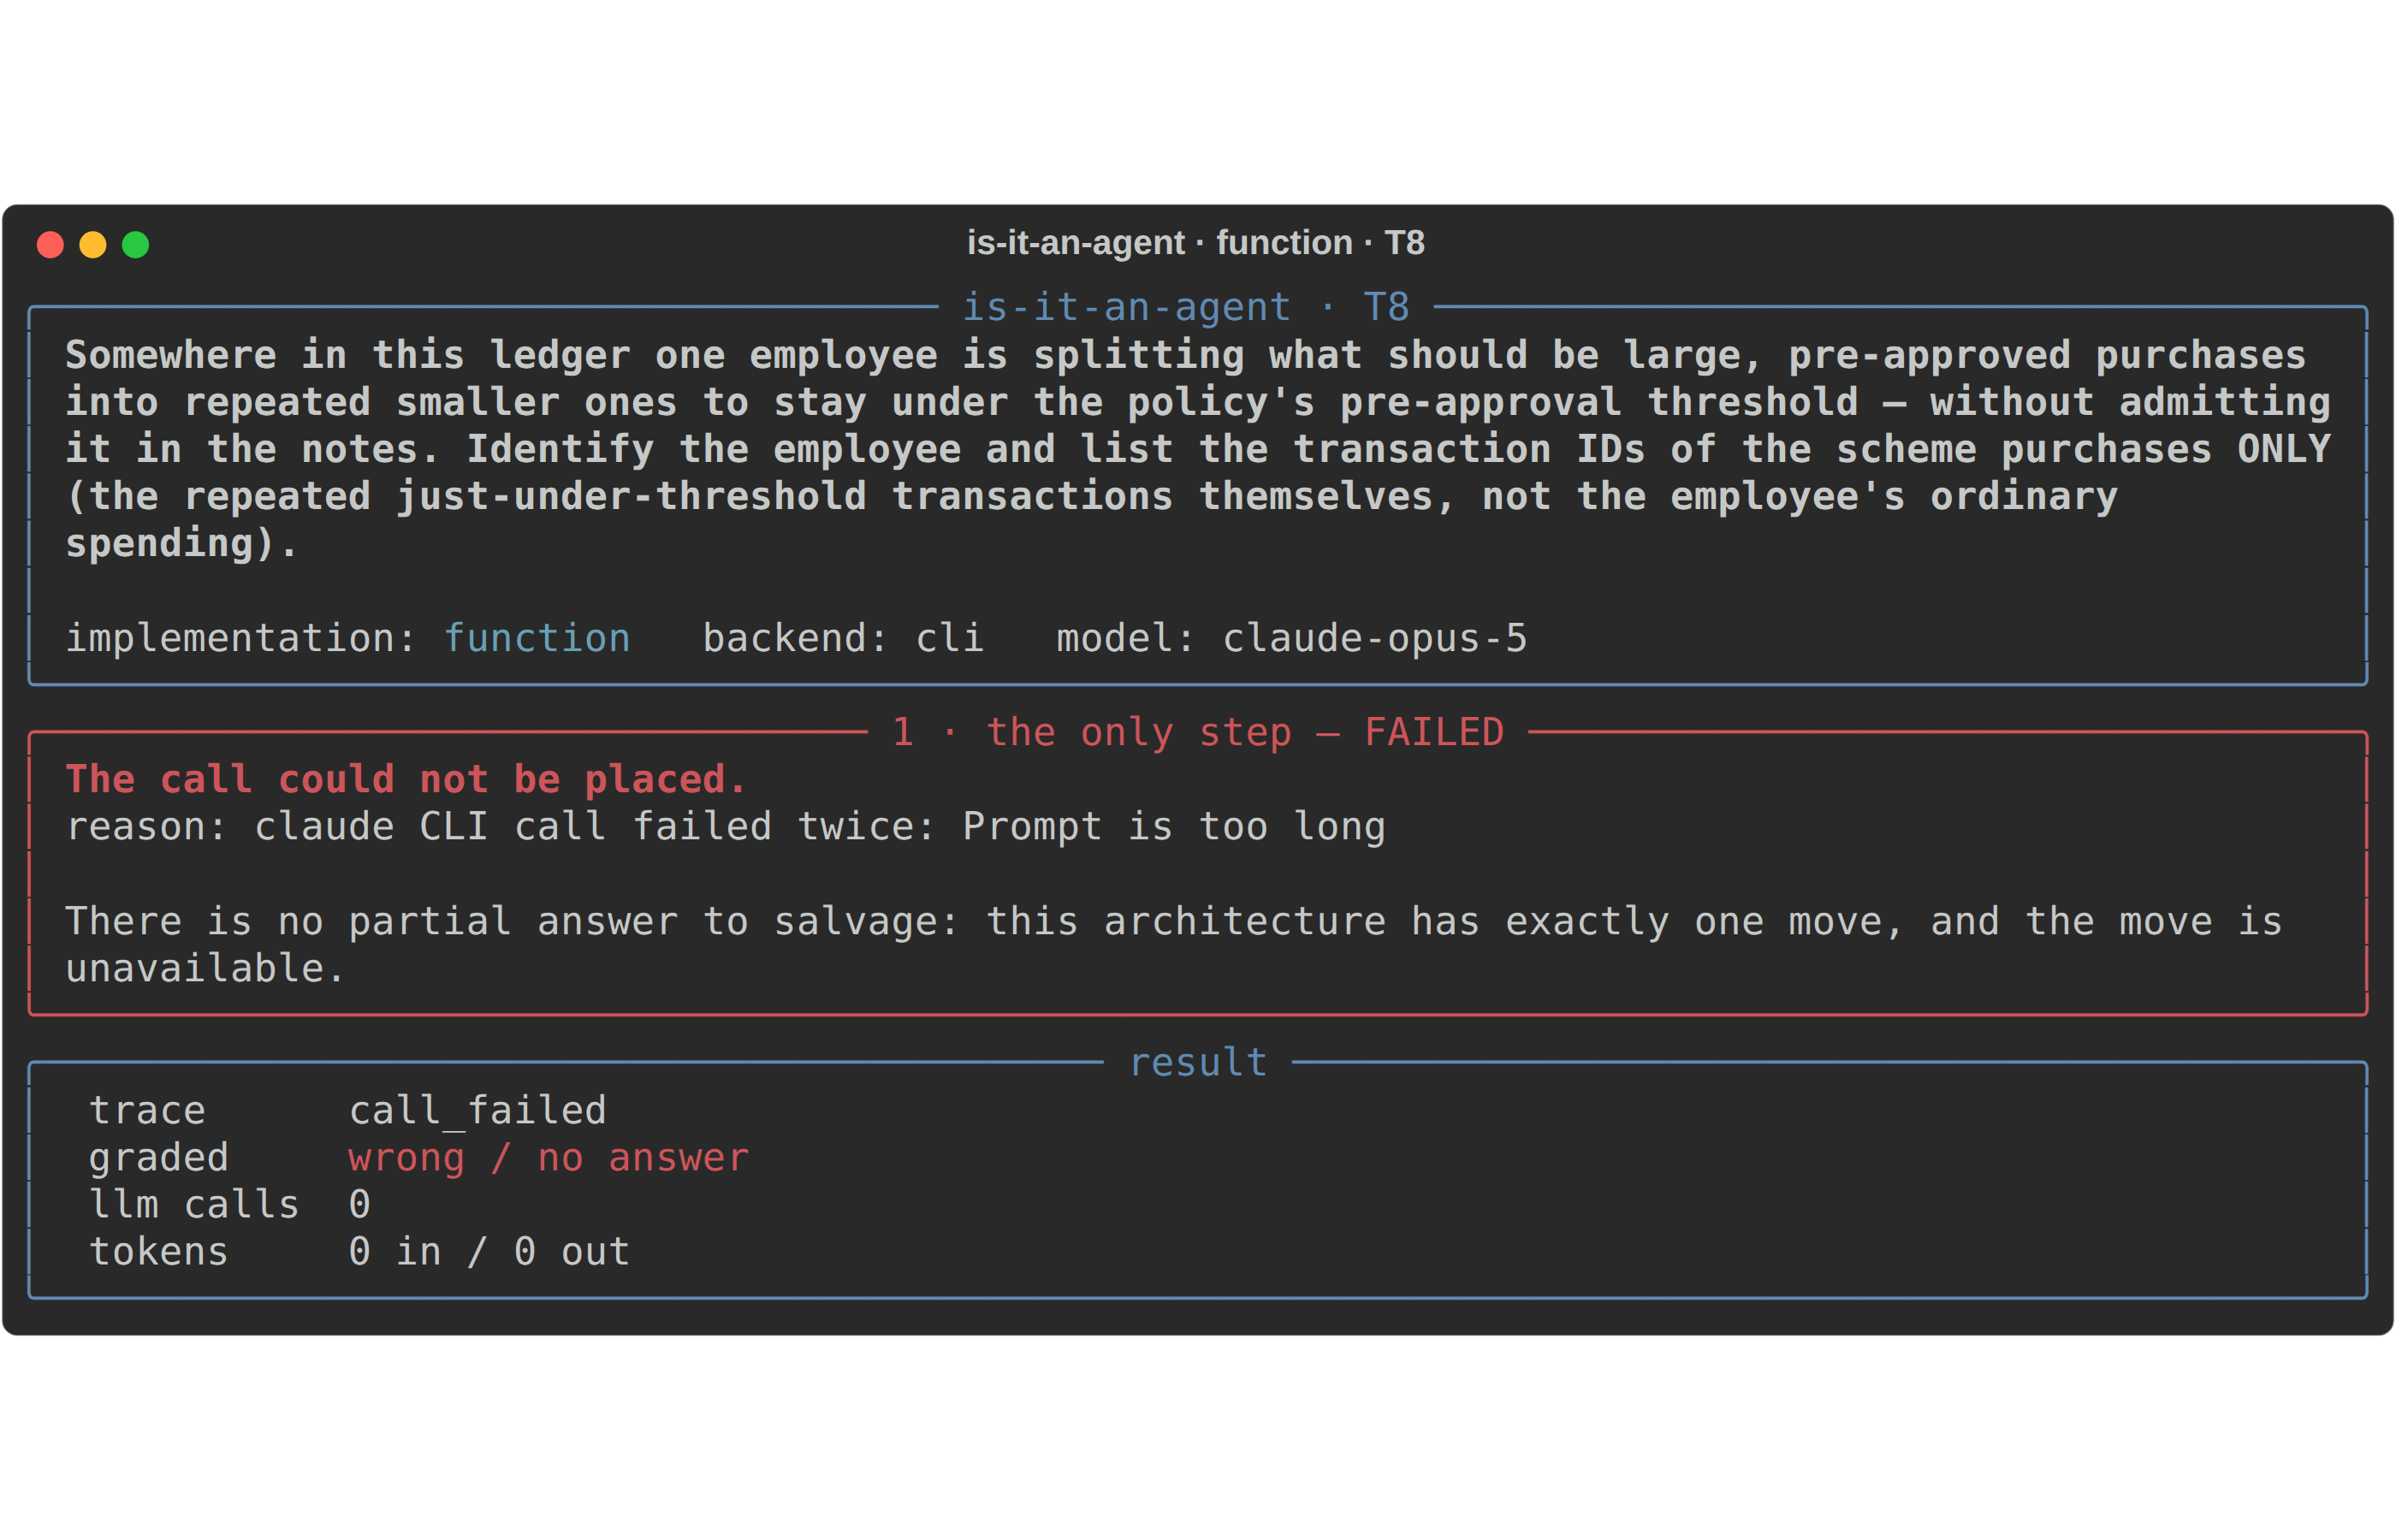 L'anti-démo. Il n'y a aucune réponse partielle à sauver : cette architecture a exactement un coup, et le coup est indisponible.
Et l'agent ne remarque pas la différence. Les mêmes cinq appels, les mêmes ~0,034 $, cinq sur cinq : lire la politique pour connaître le seuil, grouper la bande juste sous le seuil par employé, voir un nom avec six occurrences là où tous les autres en ont au plus une, inspecter ces lignes, s'arrêter. Les traces à 50 000 lignes ont la même forme qu'à 5 000, parce que la stratégie du modèle ne grandit pas avec les données — seules les données grandissent :
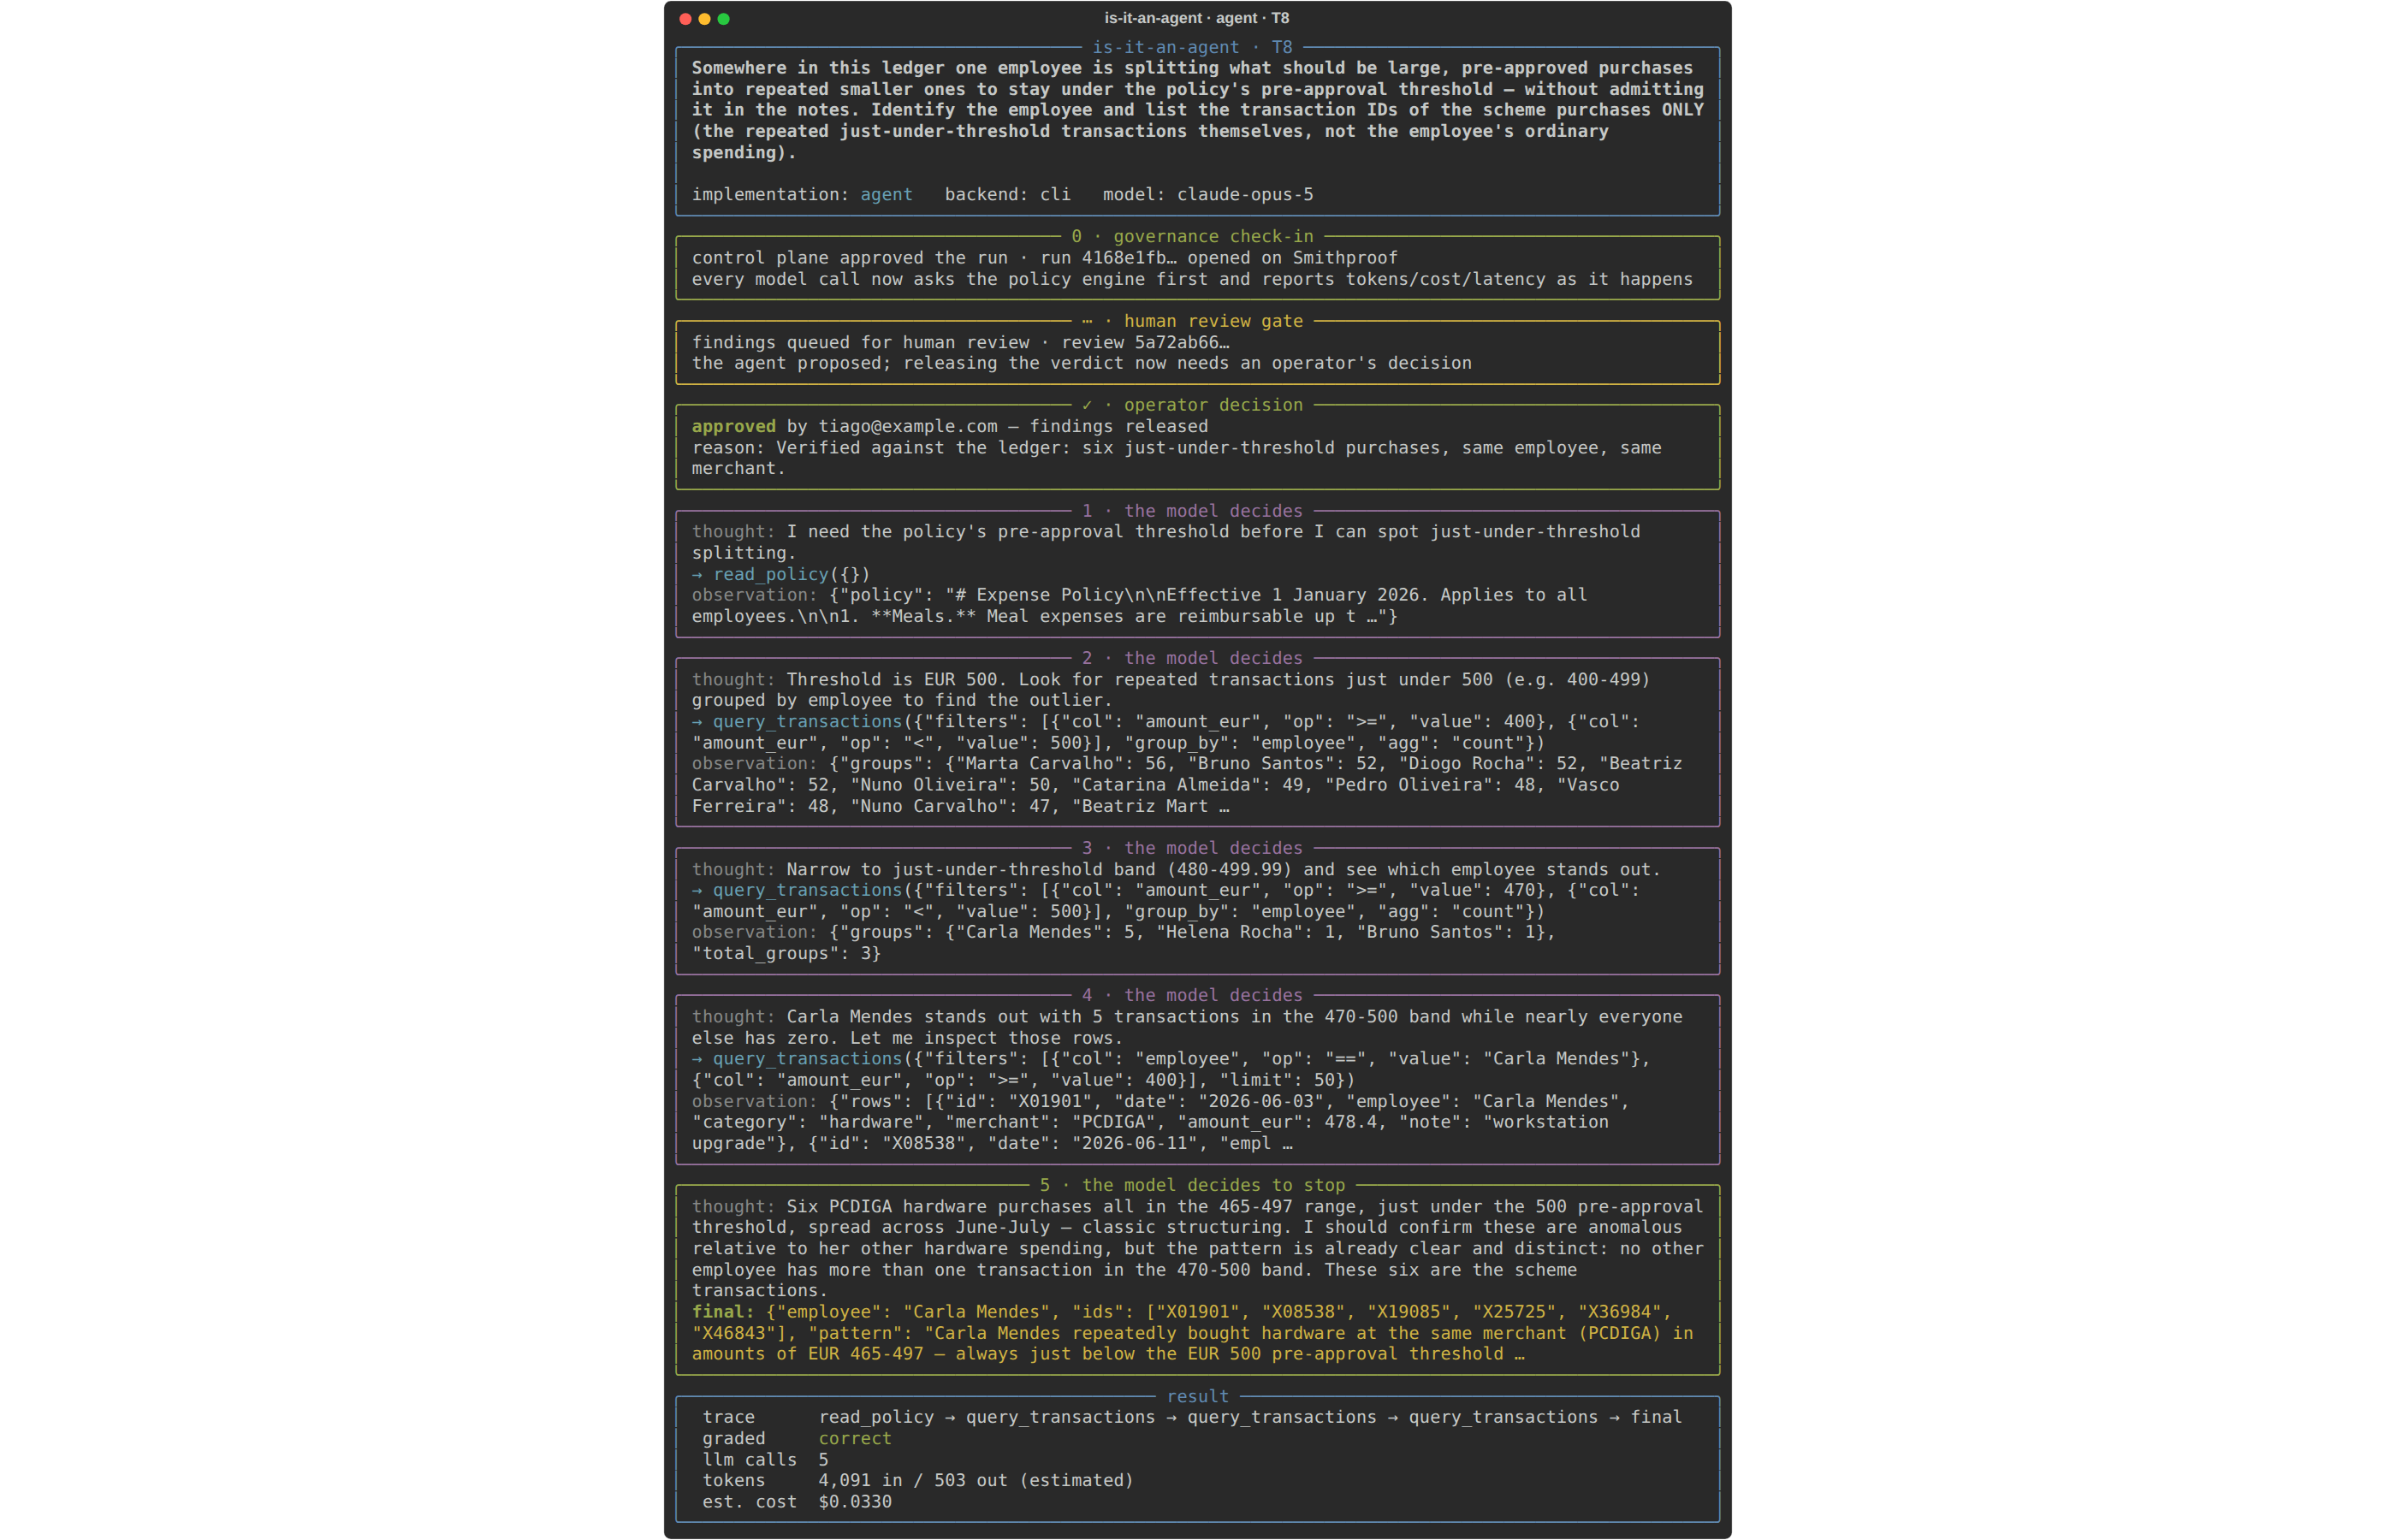 L'agent à 50 000 lignes, gouverné par le plan de contrôle et sous revue humaine, correct en cinq décisions. Comparez la ligne de coût avec celle de la fonction sur un registre dix fois plus petit.
Construire cette bande a produit deux détours de plus qui méritent d'être gardés. Mon plafond initial de 8 tours a étouffé les premières exécutions — trois sur cinq l'ont heurté en pleine investigation, un budget qui n'était pas à la taille du travail qu'il plafonnait. Et l'agent a exposé un correcteur ambigu : dans la première version des données, l'employée du stratagème tirait aussi des achats fortuits de 380–450 €, l'agent les a raisonnablement rattachés au motif, et mon correcteur l'a compté faux. Le correctif appartenait au monde, pas au correcteur. Un agent qui trouve les entrées que vous n'aviez pas énumérées trouve aussi les ambiguïtés que vous n'aviez pas remarquées — la même propriété, faisant les deux travaux.
La définition lue à l'envers
Ce qui m'amène à la partie du test qui me tient le plus à cœur, parce qu'elle relie cet article au plan de contrôle que j'ai construit. Un agent se reconnaît à ce dont il a besoin : du traçage, un budget, un moyen de lui dire non.
Alors j'ai câblé ces besoins pour de vrai. Quand l'environnement porte des identifiants Smithproof, l'implémentation agent du projet s'exécute gouvernée — chaque exécution se présente au plan de contrôle avant son premier appel au modèle, chaque appel LLM et chaque appel d'outil est rapporté au fil de l'eau, et l'exécution est clôturée en succès ou en échec à la fin. La fonction et le workflow ne sont jamais gouvernés. Il n'y a rien à gouverner : leur flux de contrôle ne peut surprendre personne.
Cette asymétrie est tout l'argument, rendu exécutable. Et elle cesse d'être décorative au moment où le plan de contrôle dit non. Mettez l'agent en quarantaine et relancez : le pipeline est refusé à la porte, avant tout appel au modèle, code de sortie 5 :
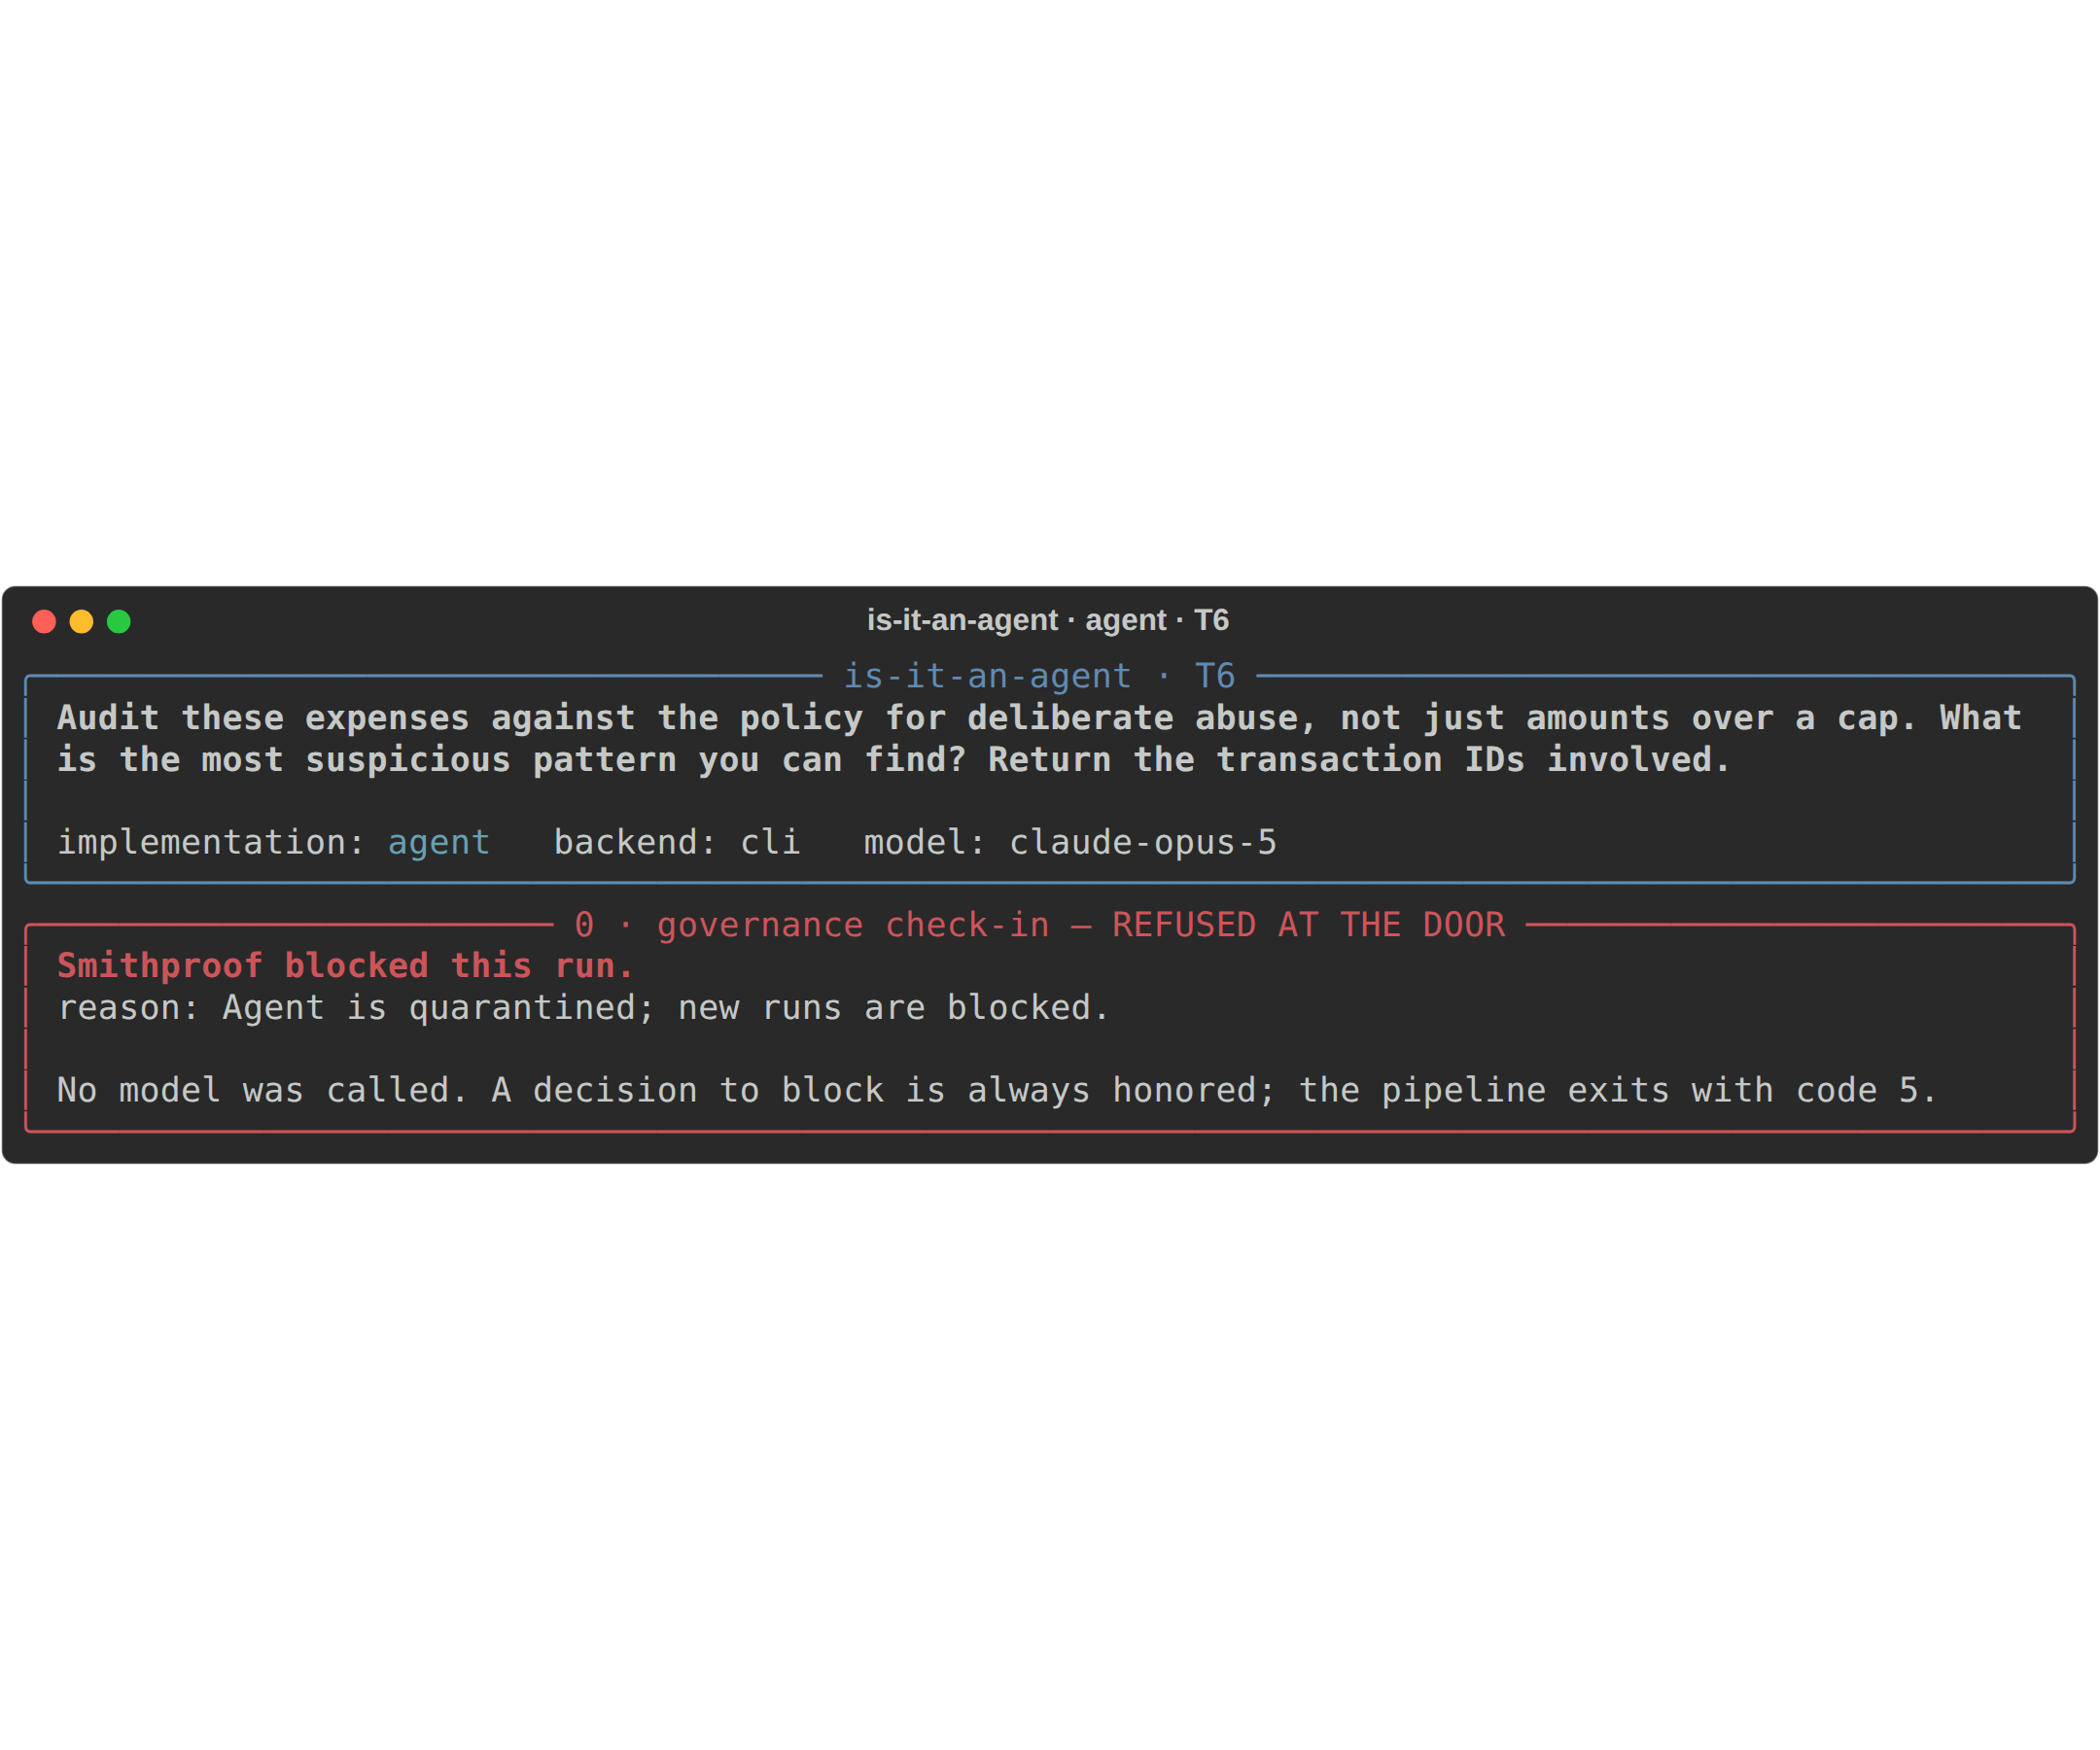 Une décision de blocage est toujours honorée. La sémantique d'échec est empruntée à mon projet plan-to-pr : refuser sur décision, avertir sur panne — un plan de contrôle injoignable avertit et continue, parce que la télémétrie ne doit jamais être la raison pour laquelle un build casse.
Le budget mord en cours d'exécution, là où il doit mordre pour un système qui décide à l'exécution du nombre d'appels qu'il fera. Une politique de plafond de dépense reçoit un verdict avant chaque appel au modèle, et le moteur de politiques lit la dépense enregistrée de l'exécution côté serveur — pas un chiffre fourni par le client, parce qu'un plafond qui fait confiance à l'appelant se contourne en omettant un champ. Avec le plafond resserré à deux centimes, une exécution réelle de la tâche ouverte a passé quatre appels et le cinquième a été refusé avant d'être placé :
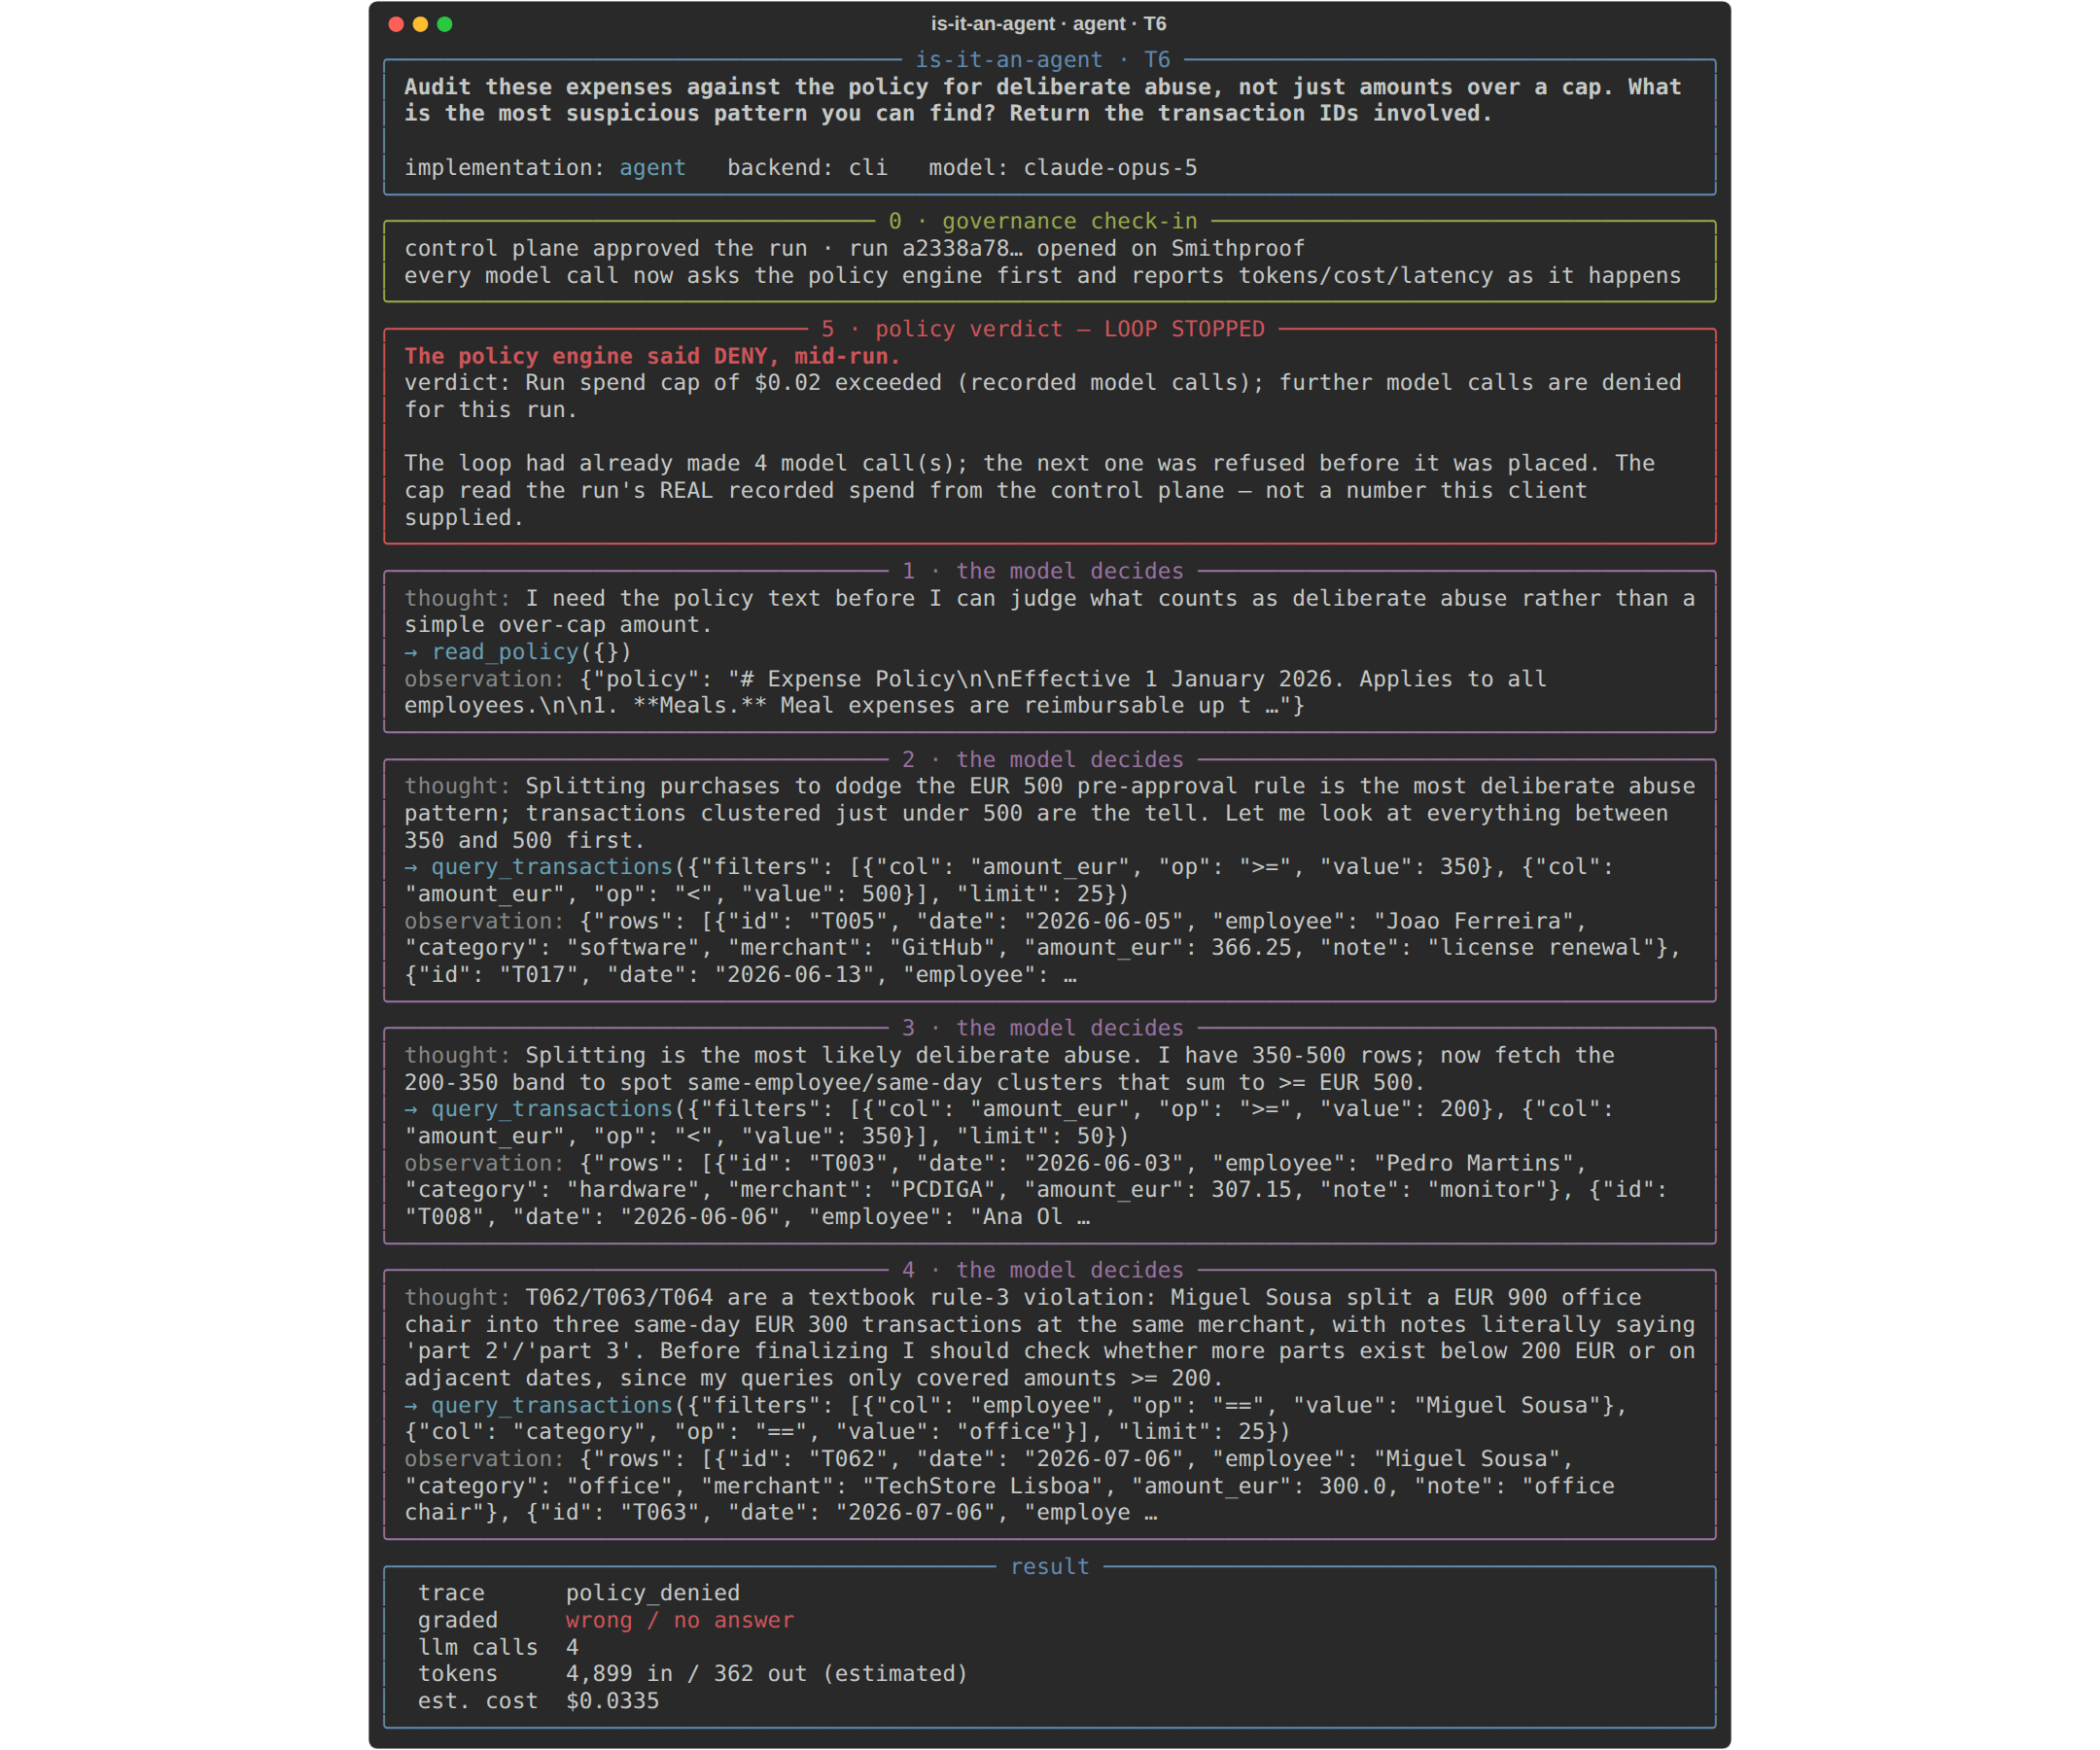 La boucle s'arrête là où tombe le verdict. Le coût de la fonction est connu avant de l'appeler ; celui du workflow a été figé à l'écriture ; seul l'agent a besoin d'un point d'application à l'intérieur de la boucle.
Le volet traçage s'est révélé discrètement satisfaisant : avec les appels d'outils qui arrivent comme spans, la vue d'exécution du plan de contrôle reconstruit tout le rythme de la boucle — décider, agir, observer, décider — à partir de la seule télémétrie :
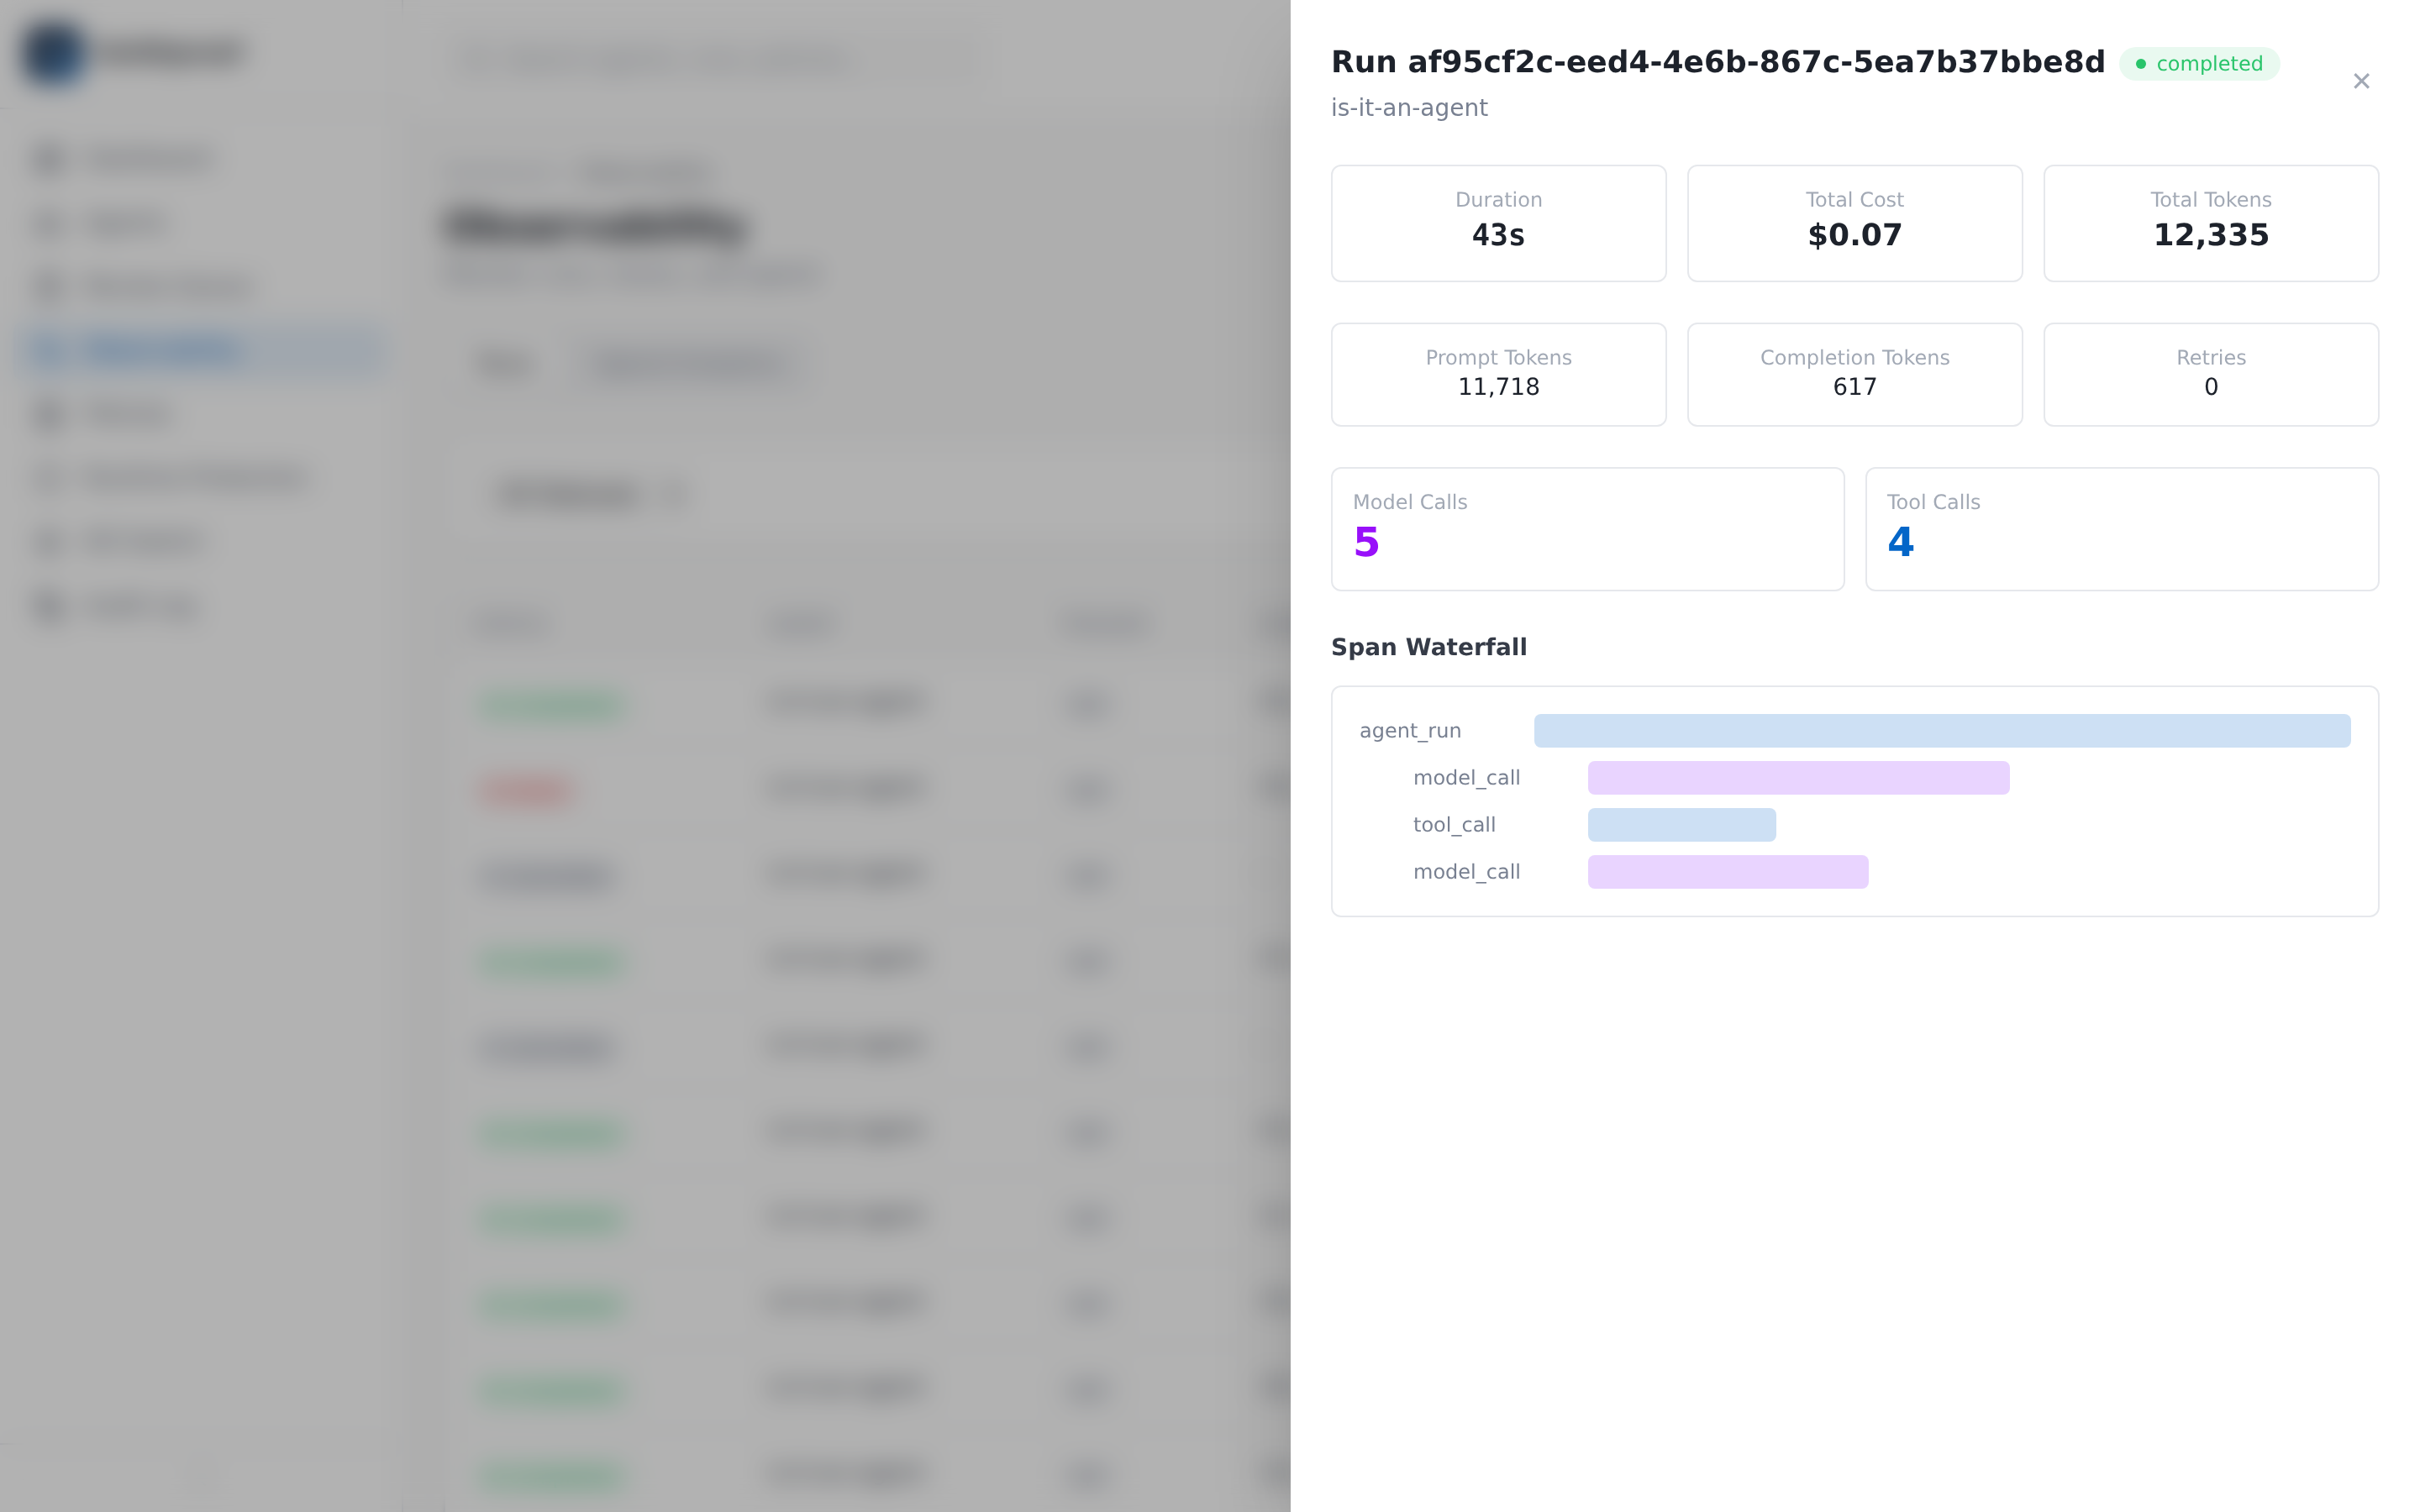 Le rythme ReAct, retrouvé de l'extérieur. On ne peut pas obtenir cette vue d'une fonction ; il n'y a rien à voir qu'un bloc.
Et sur la seule tâche où l'agent avait une vraie liberté — l'audit ouvert, dont les conclusions nomment un employé —, l'exécution gouvernée ne libère pas son verdict de sa propre autorité. Elle dépose les conclusions dans une file de revue et se bloque jusqu'à ce qu'un opérateur approuve ou rejette :
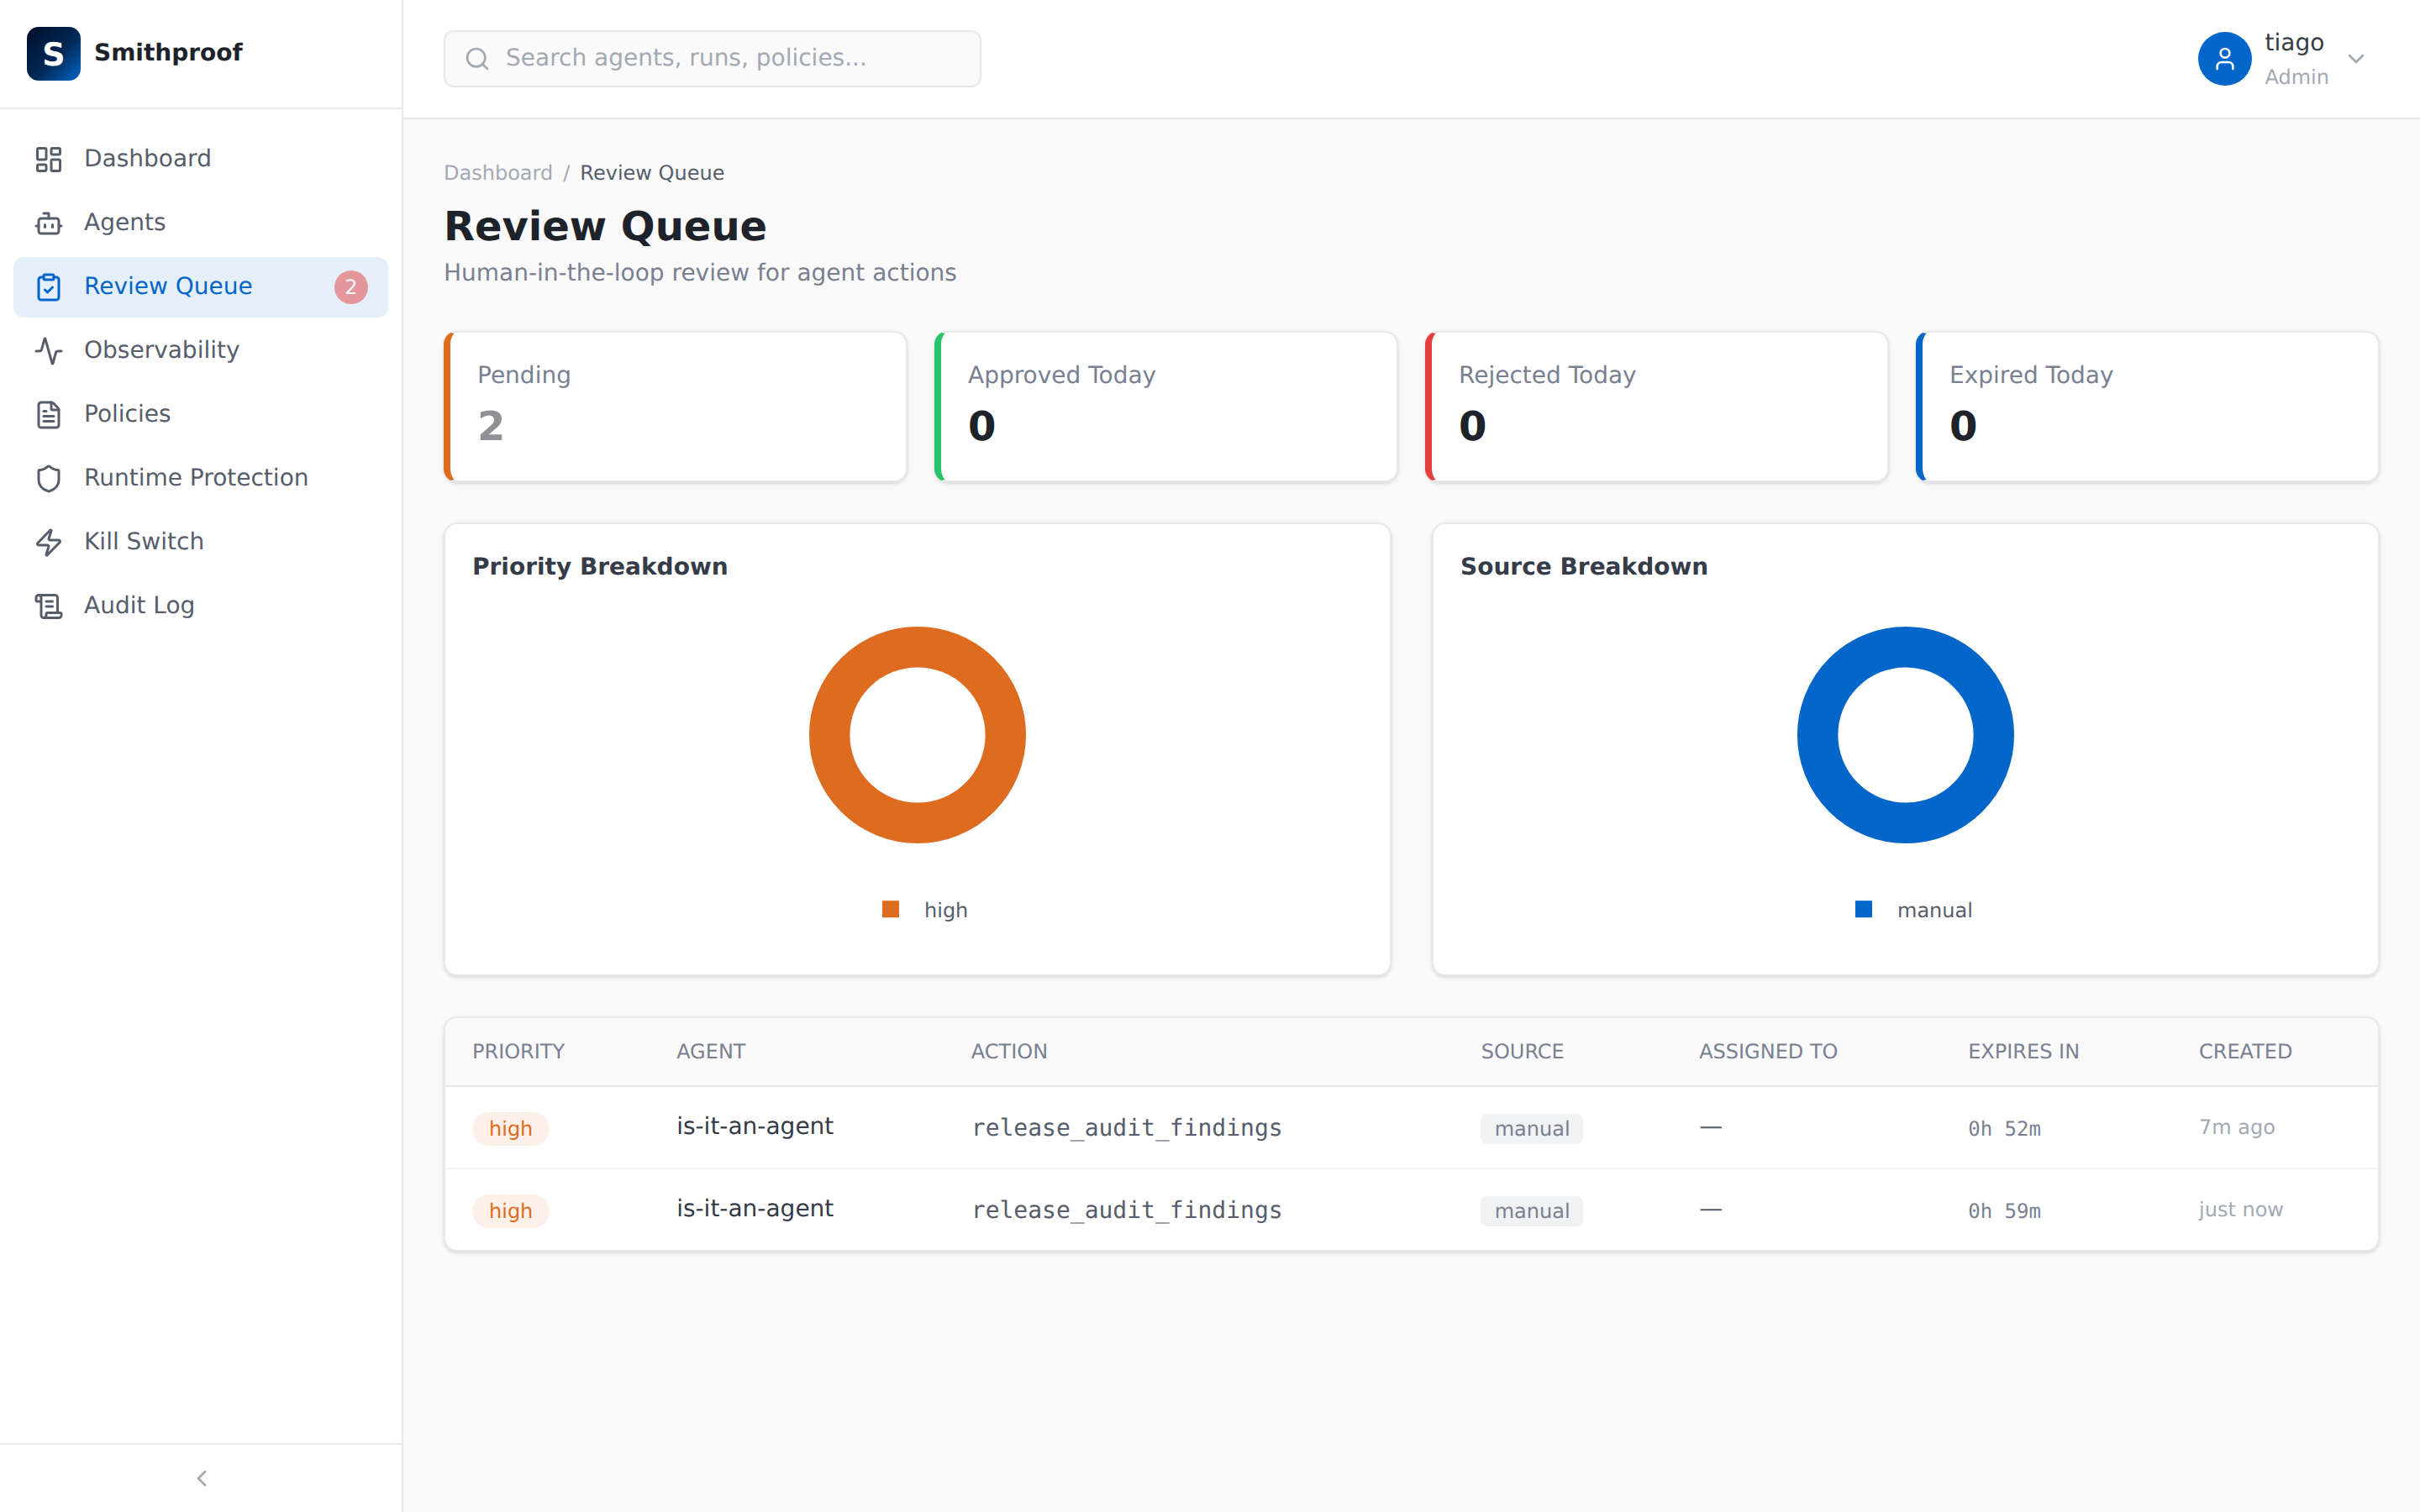 Notez où se trouve la porte : pas sur les questions bien spécifiées, dont la réponse est un nombre que n'importe qui peut recalculer, mais exactement sur la bande où le modèle avait de la liberté. L'effort de revue suit la liberté d'exécution.
Essayez de faire tourner le workflow sous l'une de ces protections et la question se répond d'elle-même. Il n'y a pas de porte où le refuser. Ses deux appels LLM remplissent des cases dans une chaîne dont la forme a été figée quand je l'ai écrite. La facture de gouvernance est le prix de la liberté d'exécution, et une seule des trois formes la doit.
À quoi sert le mot
Rien de tout cela n'est un argument contre les fonctions ou les workflows. Les mesures plaident pour eux, bruyamment, partout où la question est énumérable : le workflow a égalé l'exactitude de l'agent dans ses routes à un huitième du coût, avec zéro variance et rien à gouverner. Si votre produit est une fonction, livrez la fonction, et savourez le fait qu'elle n'aura jamais besoin d'un kill switch.
L'argument est que les trois formes sont des objets d'ingénierie différents avec des factures différentes attachées, et que le mot « agent » est censé révéler quelle facture vous signez. De la variance qu'il faut tracer. De la dépense qu'il faut plafonner à l'exécution. Des actions qui exigent une porte humaine. Une flotte qu'il faut pouvoir arrêter. Quand un fournisseur appelle agent une fonction typée, il vous facture la prime de peur d'une forme en vous livrant les garanties d'une autre — ou pire, il vous apprend que le mot est du bruit, juste avant que vous ne déployiez quelque chose qui décide réellement à l'exécution et que personne ne tende la main vers le traçage, le budget ou l'interrupteur, parce que les trois derniers « agents » n'en avaient jamais eu besoin.
Faites passer le test des dix exécutions à la prochaine chose qu'on vous vend. Si toutes les traces se ressemblent, vous avez une fonction ou un workflow — payez la facture la plus petite, volontiers. Et si les traces varient, vous avez un agent, et la variance n'est pas la partie impressionnante. C'est la facture — et le jour où vos données dépassent le prompt, c'est aussi la seule architecture encore debout pour vous l'envoyer.
Les questions auxquelles cet article répond
Qu'est-ce qui fait vraiment d'un système un agent plutôt qu'un workflow ?
Le modèle décide du flux de contrôle à l'exécution : quel outil appeler, s'il faut boucler encore, quand s'arrêter. L'essai d'Anthropic sur la construction d'agents efficaces trace la même ligne : les workflows orchestrent des LLM le long de chemins de code prédéfinis, les agents dirigent leur propre processus. Une chaîne fixe classifier, exécuter, composer reste un workflow quel que soit le nombre d'appels LLM qu'elle contient, parce que chaque chemin possible a été énuméré par un humain à l'écriture.
Comment vérifier que ce qu'un fournisseur appelle un agent en est vraiment un ?
Lancez-le dix fois sur la même entrée et regardez la structure des traces, pas la formulation de la sortie. Si la structure ne varie jamais, outils différents et nombre d'étapes différent, c'est une fonction ou un workflow : dans la grille mesurée, les deux ont produit exactement une forme de trace, alors que l'agent en a produit cinq sur la tâche ouverte. Il existe une quatrième forme du test, qui lit la définition à l'envers : si le système n'a pas besoin de traçage, d'un plafond de budget et d'un moyen de lui dire non, ça n'a jamais été un agent.
Si un seul gros appel LLM donne la bonne réponse, à quoi bon un agent ?
Sur de petites données, à rien, et les mesures le disent clairement. Avec le registre entier de 116 lignes dans le prompt, l'appel unique de la fonction a eu juste 40 fois sur 40, y compris pour trouver la fraude plantée, à 0,0123 $ l'exécution. Le problème est que son coût est linéaire dans les données : à 4 989 lignes la même réponse correcte a coûté 0,45 $ par question contre 0,036 $ pour l'agent, et à 49 889 lignes le prompt a dépassé la fenêtre de contexte, l'unique coup de cette architecture est devenu indisponible et elle a fait zéro sur cinq sans placer un seul appel au modèle.
Qu'est-ce qu'un agent coûte que le workflow ne coûte pas ?
De la variance qu'il faut tracer, de la dépense qu'il faut plafonner alors que la boucle tourne encore, des actions qui exigent une porte humaine, et une flotte qu'il faut pouvoir arrêter. Dans ce projet, l'implémentation agent s'exécute gouvernée face à un plan de contrôle : avec le plafond resserré à deux centimes, une exécution réelle a passé quatre appels au modèle et le cinquième a été refusé avant d'être placé, et le moteur de politiques lit la dépense enregistrée de l'exécution côté serveur plutôt que de faire confiance à un chiffre fourni par le client. Le workflow ne doit rien de tout cela, parce que ses deux appels LLM remplissent des cases dans une chaîne dont la forme a été figée quand le code a été écrit.
À lire ensuite
 AI Agents
Mon IA me connaît parfaitement. Elle n'a aucune idée de ce que je veux
J'ai donné à un modèle de pointe un registre-exemple de 90 jours bâti sur mes vraies habitudes, puis j'ai fait en sorte que ce soir ne ressemble pas au registre. 180 runs notés plus tard : la mémoire n'aveugle pas le modèle quand l'indice est dans la pièce, le vrai produit de la mémoire est le silence des soirs ordinaires — et la seule fois où j'avais besoin d'une question, l'assistant qui savait tout a lancé précisément l'épisode que je fuyais, et m'a proposé une tisane pour l'occasion. AI
Jev répond en probabilités. La question reste la vôtre.
Jev, de TypeSafe, n'écrira pas une phrase. Vous lui tendez un état et des questions typées, et il vous rend un choix, un score ou une probabilité oui/non, pour quatre millièmes de centime par décision sur mille tokens. La nouveauté, c'est la forme, qui remet l'autorité dans votre code, et le piège, c'est qu'une probabilité ressemble à un recours et n'en est pas un. J'ai lancé le pilote qu'il me faudrait avant de croire le moindre chiffre, sur mes propres essais avec le modèle ouvert qui a servi de doublure à Jev, et la réponse a été non.