
È davvero un agente? Ho costruito lo stesso compito in tre modi per scoprirlo
Ascolta l'articolo (sperimentale) · 18:49
C'è una cosa che succede nel marketing dei prodotti di IA che ho smesso di trovare divertente. Un team avvolge una chiamata a un LLM in una funzione — input tipizzati, una completion, campi tipizzati in uscita — e la lancia come agente. Una pipeline di tre prompt diventa un sistema multi-agente. La parola sta facendo lavoro di vendita, non lavoro di ingegneria, e la parte irritante non è l'inflazione in sé. È che "agente" porta con sé un'affermazione specifica, utile e falsificabile, e usarla come sinonimo di "ha un LLM da qualche parte" distrugge l'unica parola che avevamo per quell'affermazione.
L'affermazione è questa: il modello decide il flusso di controllo a runtime. Quale strumento chiamare. Se iterare ancora. Quando fermarsi. Il saggio di Anthropic sulla costruzione di agenti efficaci traccia esattamente questa linea — i workflow orchestrano gli LLM lungo percorsi di codice predefiniti, gli agenti dirigono il proprio processo — e mi ero appoggiato alla stessa distinzione nel mio articolo sul panorama dei framework per agenti. Una funzione che estrae campi strutturati da un testo è estrazione strutturata. Una sequenza fissa classifica-esegui-riassumi è un workflow. Entrambe sono cose eccellenti con nomi che esistono già, e nessuna delle due diventa un agente perché viene ribattezzata in un pitch deck.
Avrei potuto fermarmi alla definizione. Ma le definizioni si discutono a buon mercato e le misurazioni no, così ho costruito lo stesso compito in tre modi — una volta come funzione, una volta come workflow, una volta come agente —, ho eseguito l'intera griglia contro un modello di frontiera e ho misurato quanto costa davvero l'etichetta. Tutto ciò che segue — il codice, i dati, l'harness e ogni screenshot — viene da un piccolo progetto che ho costruito per questo articolo e fatto girare sul serio; niente qui è illustrativo o simulato.
Un test da applicare alla cosa che vi hanno venduto
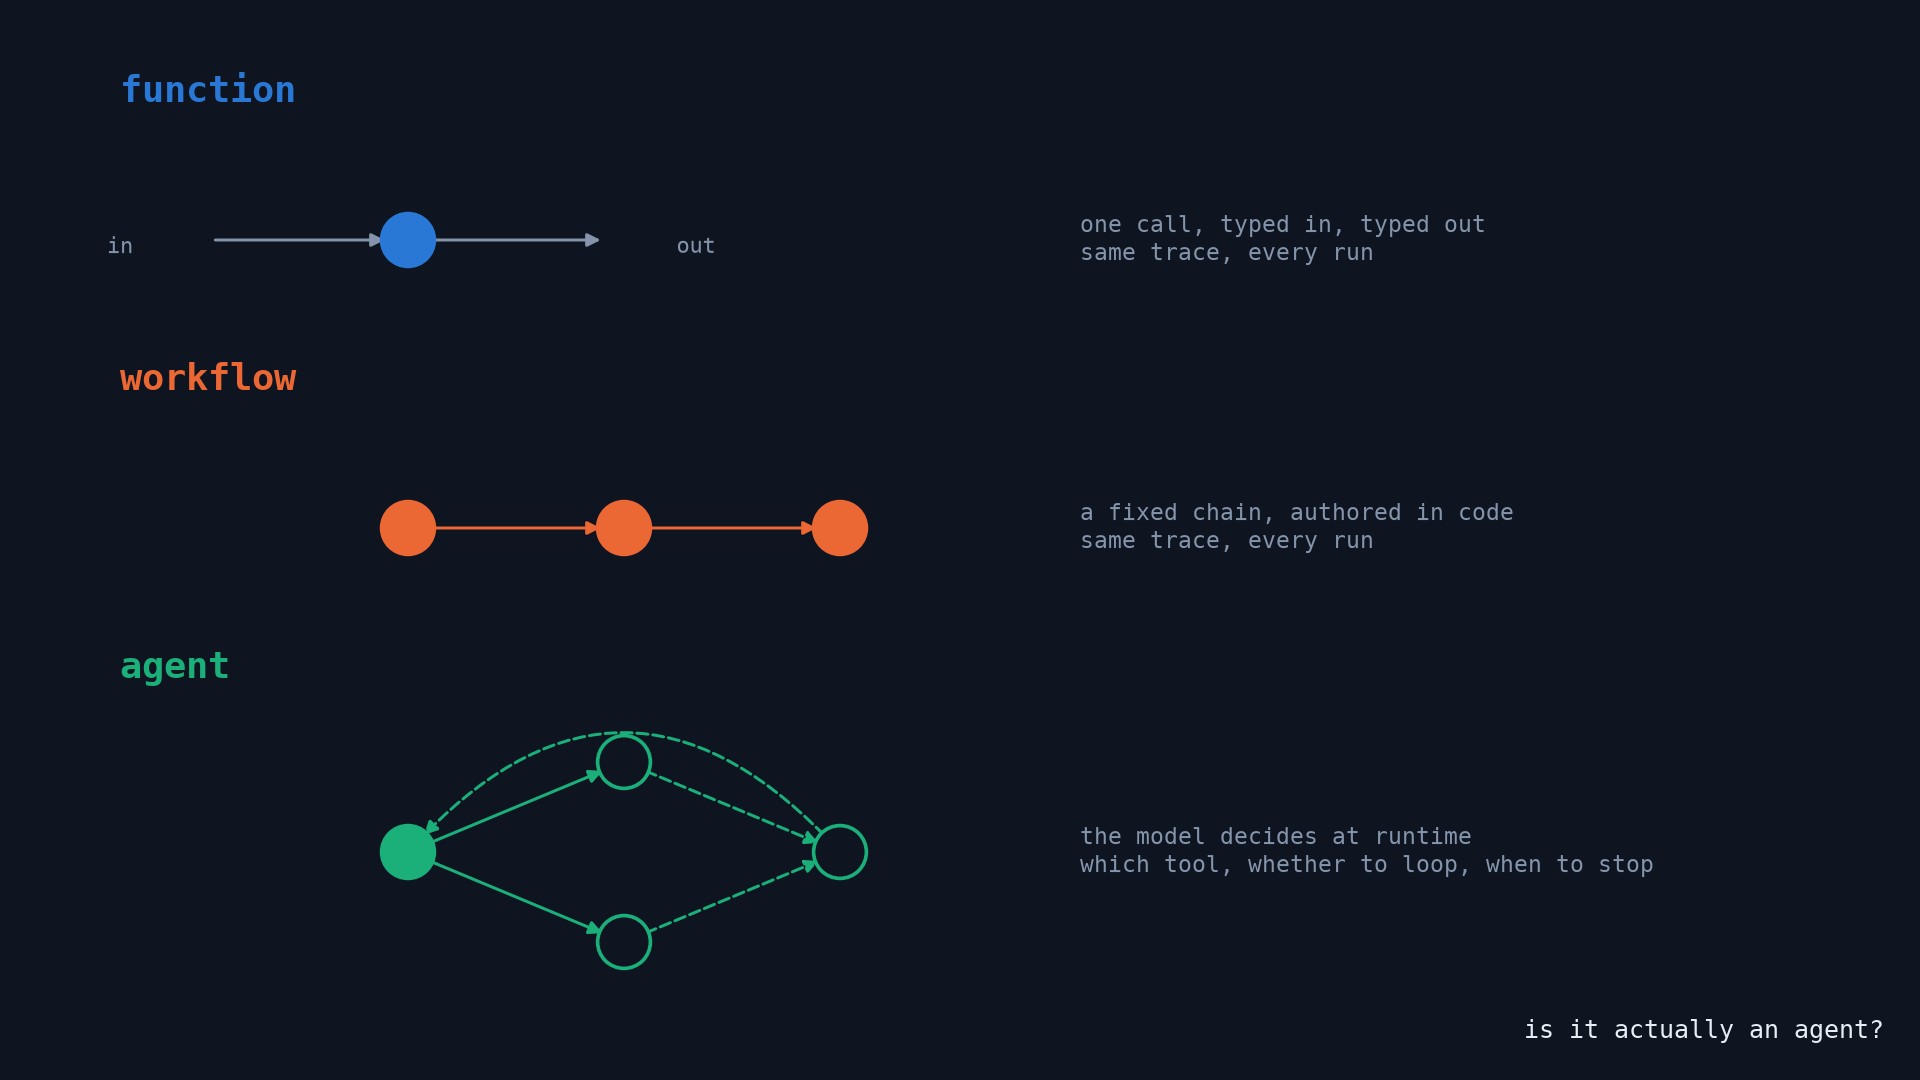
Prima dell'esperimento, il test che ne è uscito. Prendete il sistema che qualcuno chiama agente ed eseguitelo dieci volte sullo stesso input:
- Varia la struttura di ciò che è successo — strumenti diversi, numero di passi diverso — o solo la formulazione dell'output? Se solo la formulazione, è una funzione.
- Può fare qualcosa che nessuno ha scriptato? Se ogni percorso possibile è stato enumerato da un umano in fase di scrittura, è un workflow.
- Ha una condizione di arresto che valuta, invece di una fine a cui arriva? I cicli decidono; le pipeline terminano.
E una quarta forma del test, quella a cui torno sempre, legge la definizione al contrario: si capisce se qualcosa è un agente da ciò di cui ha bisogno. Se non ha bisogno di tracing, di un tetto di budget e di un modo per dirgli di no, non è mai stato un agente. Nessuno mette un kill switch a una stampa unione.
L'esperimento
Il dominio del compito è un piccolo audit delle spese: un registro di 116 transazioni prodotto da un generatore con seme fisso, con tre schemi di frode piantati dentro, e una policy scritta sulle spese. Sei domande in tre fasce — ben specificate ("spesa totale per viaggi a giugno 2026"), applicazione della policy ("quali transazioni per pasti superano il tetto della policy") e una domanda aperta senza percorso prescritto: "trova lo schema più sospetto e indica gli ID delle transazioni." Le risposte di riferimento sono calcolate dal CSV a runtime con lo stesso motore di query usato dalle implementazioni, mai scritte a mano.
Le tre implementazioni condividono modello, dati e valutatore, e differiscono solo per chi possiede il flusso di controllo:
- La funzione: una chiamata all'LLM, l'intero registro e la policy nel prompt, JSON in uscita. Flusso di controllo: nessuno.
- Il workflow: classifica → esegui → componi. L'LLM sceglie una rotta da un enum chiuso e scrive la frase finale; l'aritmetica in mezzo è codice deterministico. Davanti a una domanda fuori dalle sue rotte restituisce un onesto "non supportato" invece di improvvisare. Flusso di controllo: fissato nel codice.
- L'agente: un ciclo di strumenti scritto a mano, completamente visibile. Il modello legge la domanda, decide quale strumento chiamare — leggere la policy o interrogare il registro —, osserva il risultato e decide di nuovo, finché non sceglie di fermarsi. Flusso di controllo: del modello, turno per turno, sotto un tetto di turni.
Niente framework, deliberatamente. Ogni meccanismo è un file leggibile, perché l'argomento dipende dal poter vedere che l'unica differenza è dove vivono le decisioni.
Cosa hanno detto davvero 120 run valutate
Cinque run per cella, dieci sui compiti sensibili alla varianza, Claude Opus 5, agosto 2026:
| Approccio | successo | media chiamate LLM | costo medio stim./run | tempo medio | forme di trace distinte (compito aperto, 10 run) |
|---|---|---|---|---|---|
| funzione | 40/40 | 1,0 | $0,0123 | 11 s | 1 |
| workflow | 30/40 | 2,0 | $0,0033 | 16 s | 1 |
| agente | 40/40 | 3,4 | $0,0283 | 32 s | 5 |
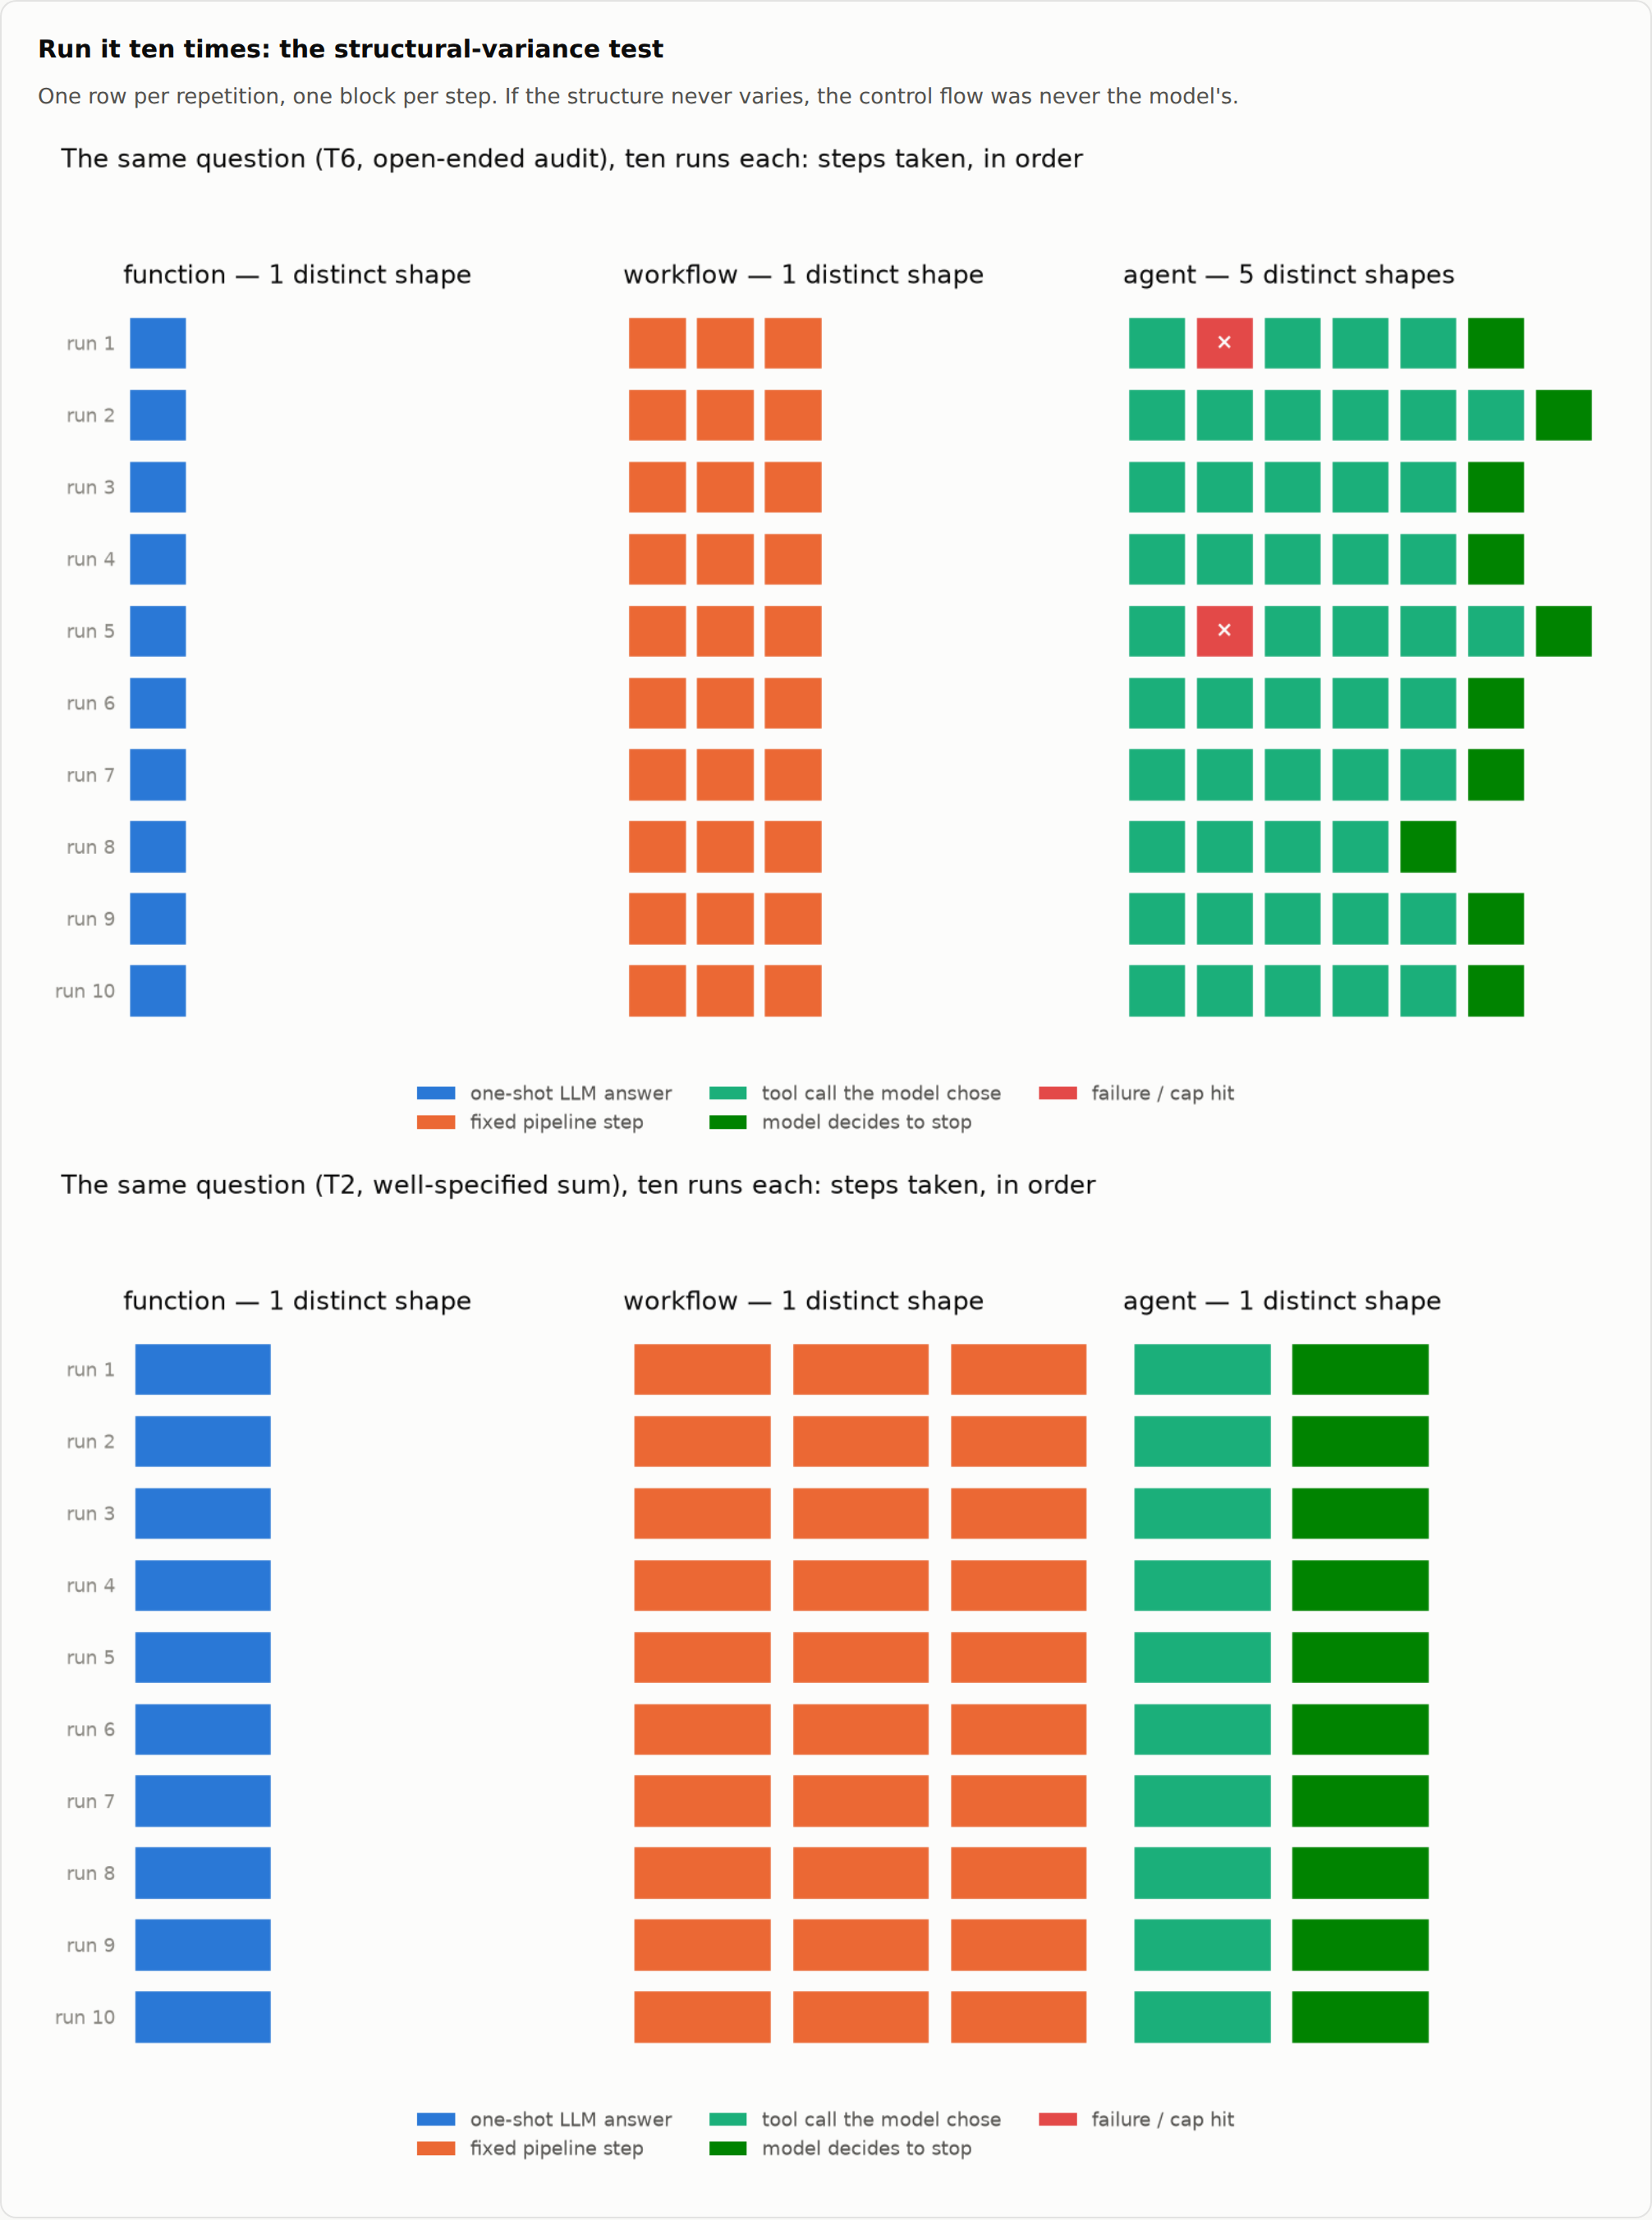 Il test "eseguilo dieci volte", in forma di dati. Una forma di trace significa che la struttura non è mai variata. Cinque significa che il modello ha scelto cinque rotte diverse verso la stessa risposta corretta.
Tre risultati, detti onestamente, compresi quelli che giocano contro l'agente.
La funzione ha azzeccato tutto. Compreso sommare trenta decimali da CSV grezzo e trovare la frode piantata — perché un modello di frontiera con l'intero registro di 116 righe nel contesto è genuinamente forte. Su un dataset piccolo la debolezza della funzione non è l'accuratezza. È che il suo costo scala con i dati, la finestra di contesto è il suo soffitto, e non può mostrare il proprio lavoro: la trace è un blocco opaco.
Il workflow è stato perfetto dentro le sue rotte e onesto fuori. La sua aritmetica è codice, quindi una classificazione corretta non può produrre un numero sbagliato, e il suo costo è un fisso di ~$0,003 qualunque sia la domanda — il più economico dei tre, di un fattore 4. I suoi trenta "fallimenti" sono tutti lo stesso evento ripetuto: davanti alla domanda aperta ha risposto "non supportato", dieci volte su dieci, invece di improvvisare. I workflow terminano; non esplorano.
L'agente si è guadagnato la sua varianza esattamente una volta — sul compito che nessuno aveva scriptato. Sulla domanda aperta ha letto la policy, interrogato la fascia appena sotto la soglia, notato le note "part 2 / part 3" su un gruppo di transazioni, confermato lo schema e indicato l'acquisto frazionato — dieci volte su dieci, per cinque rotte diverse. Sulle domande ben specificate, le sue chiamate extra non hanno comprato nulla che il workflow non avesse già, a 2,3 volte il costo della funzione e il triplo della latenza.
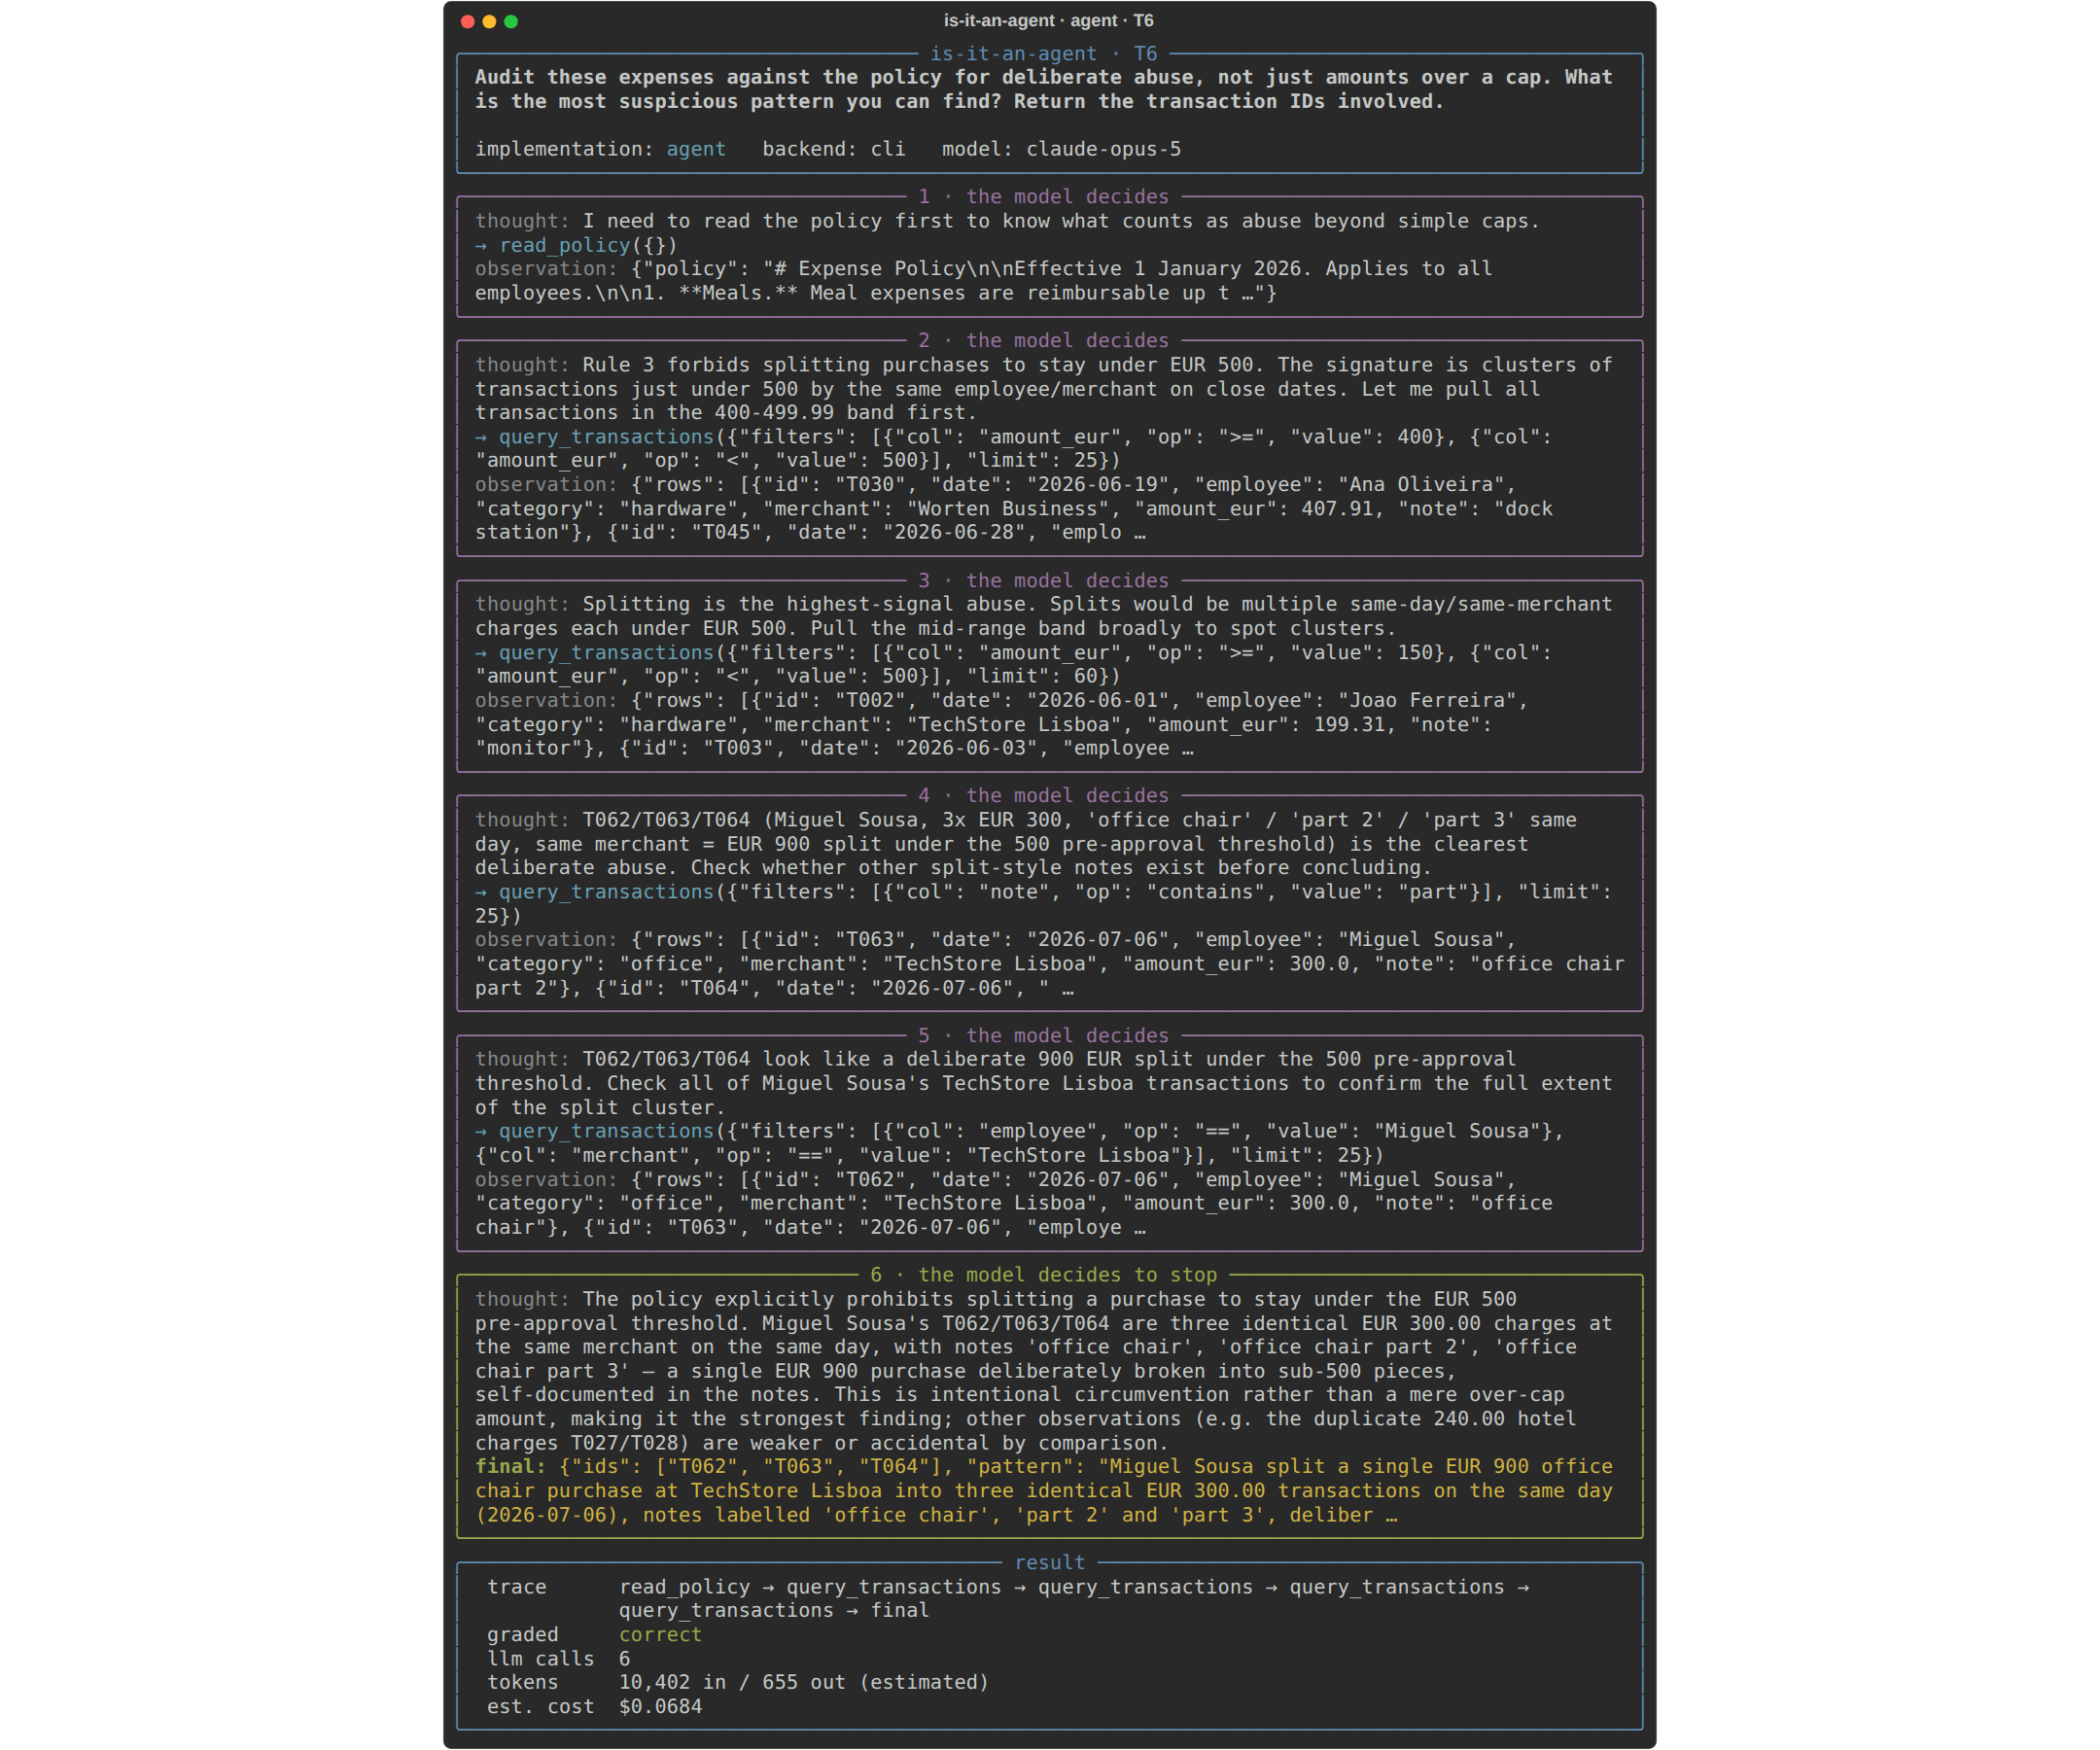 L'agente sul compito aperto. Ogni pannello è un turno: il pensiero del modello, la sua chiamata di strumento, l'osservazione. La decisione finale di fermarsi è del modello, non del codice.
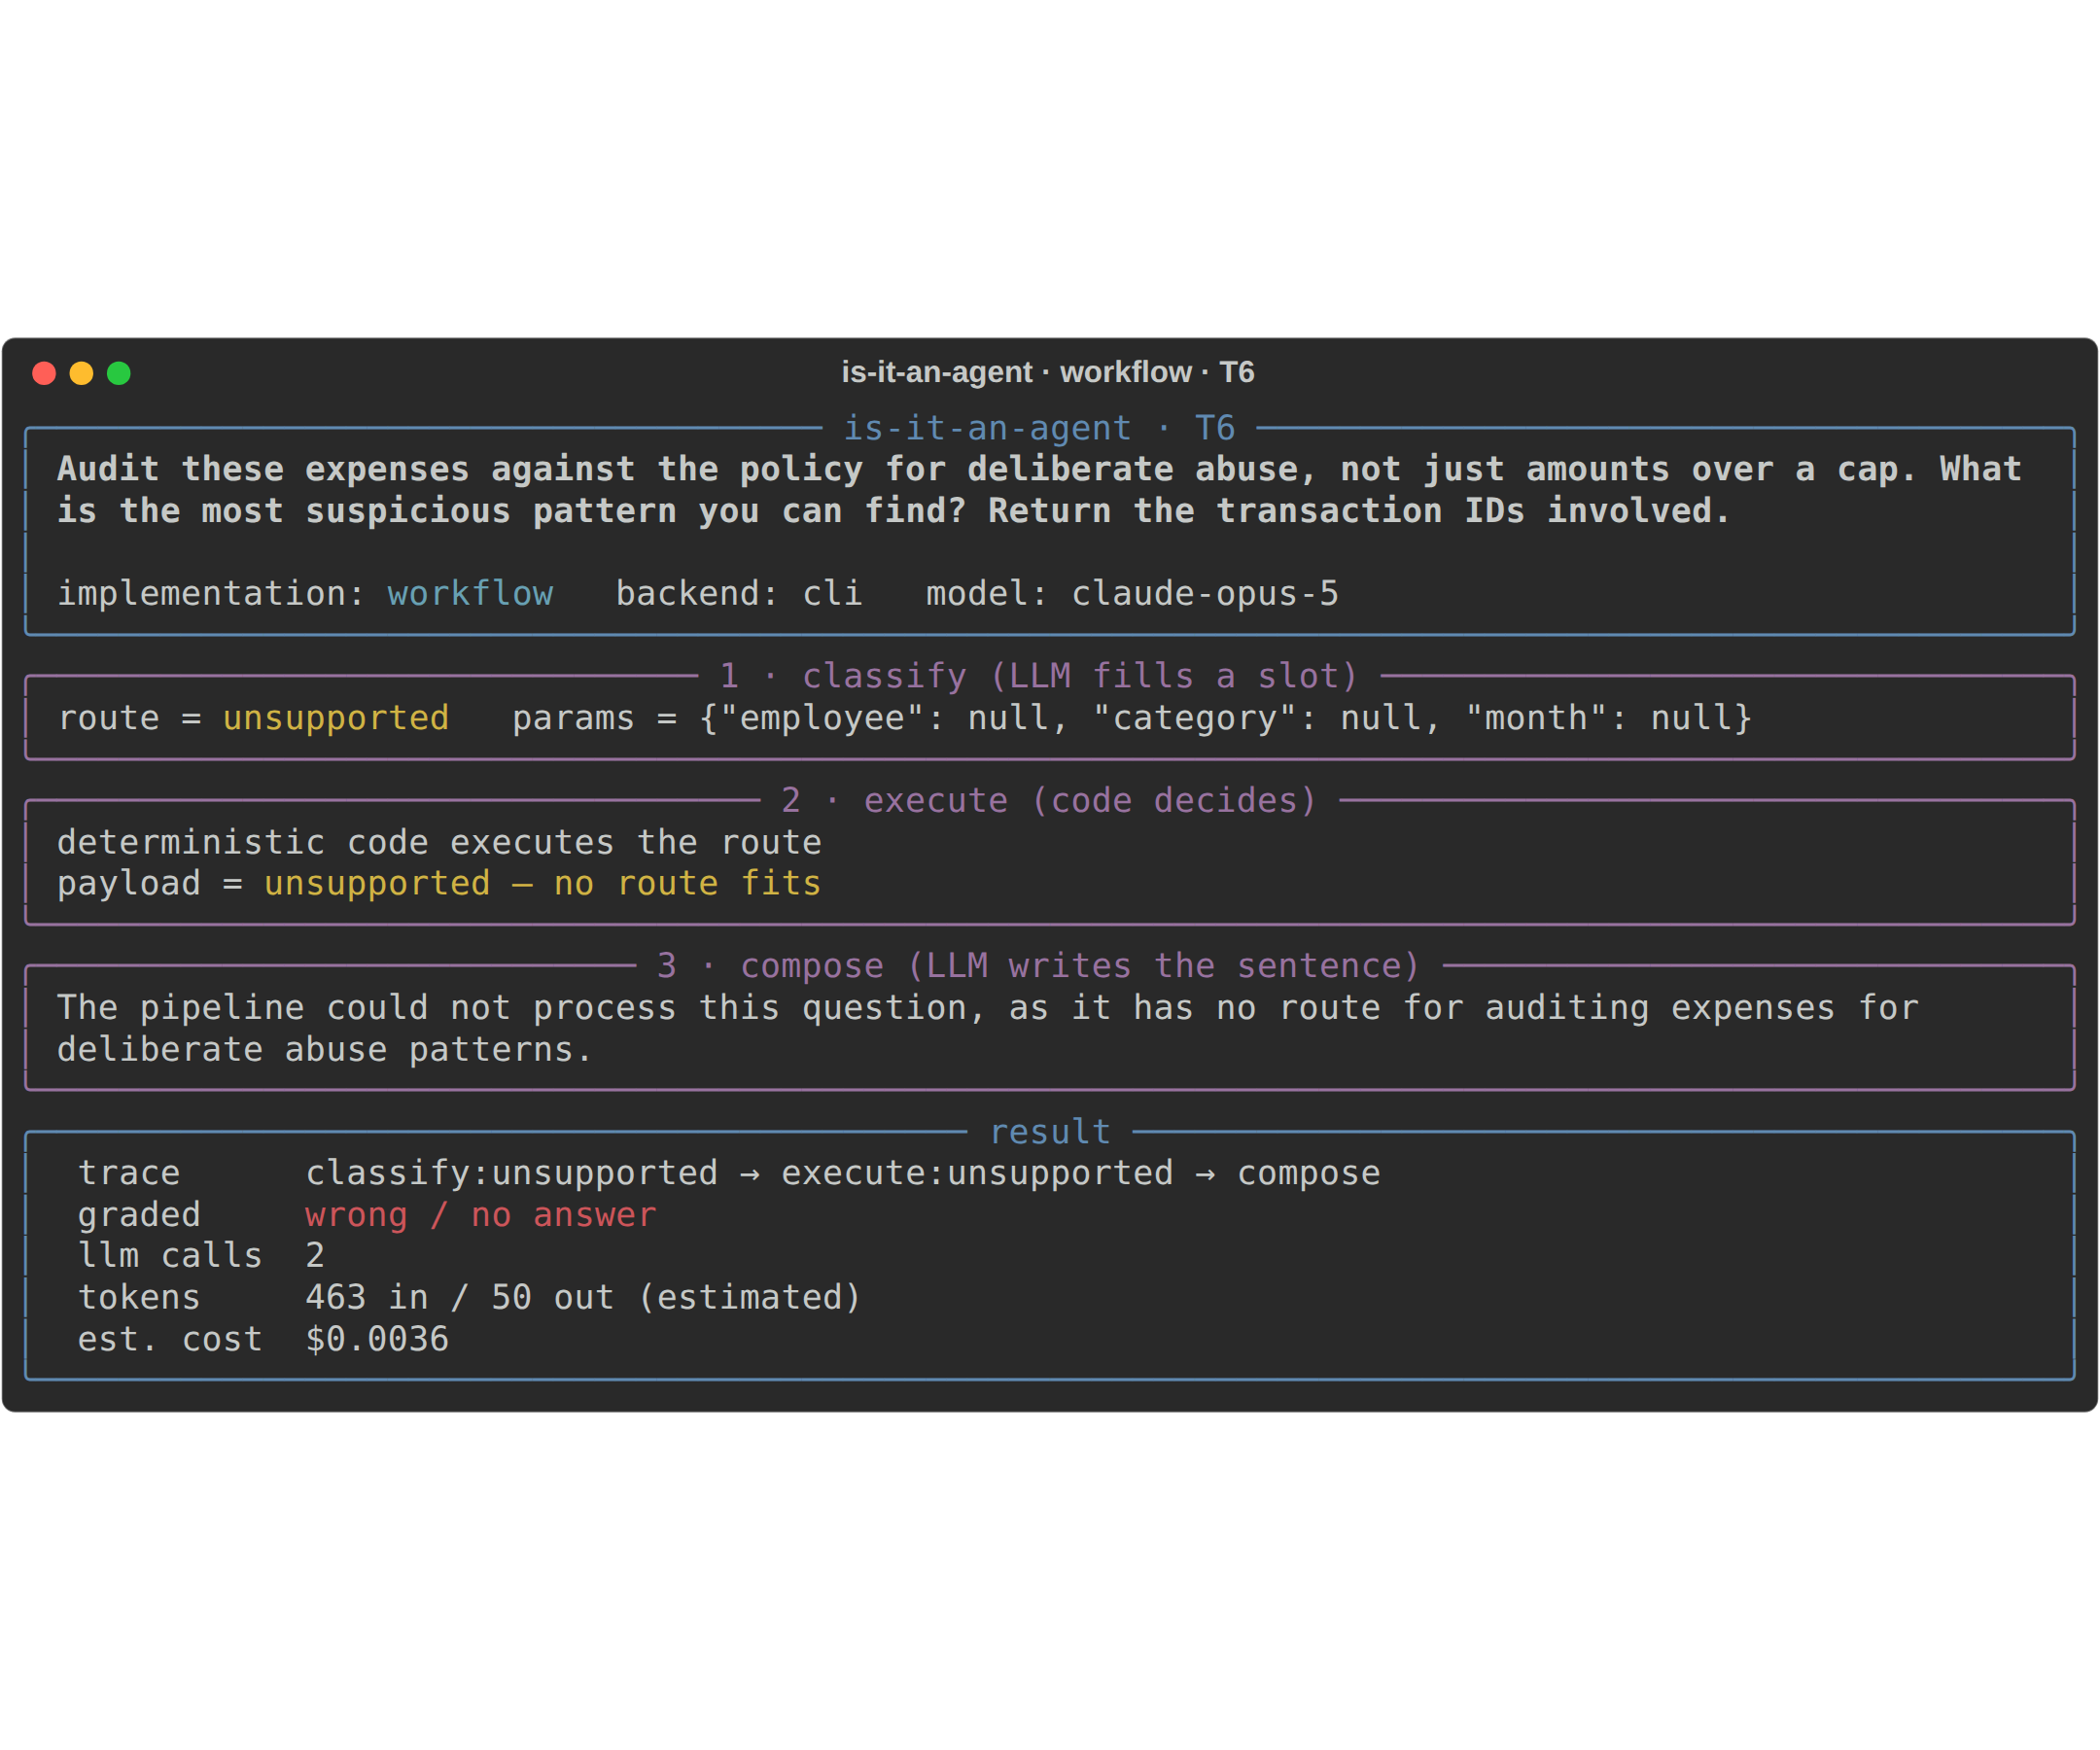 Il workflow davanti alla stessa domanda. Nessuna rotta va bene; e lo dice. Questo non è un fallimento del workflow — è la definizione di workflow.
Un incidente delle run merita di restare agli atti invece di essere tagliato. Due run iniziali dell'agente hanno fatto crollare il mio strato di strumenti: il modello ha chiesto di raggruppare i risultati per due colonne insieme — una mossa perfettamente ragionevole che io, l'autore dello strumento, non avevo previsto — e il mio harness ha sollevato un'eccezione invece di restituire un messaggio d'errore. Dopo la correzione, le stesse run mostrano il modello che legge l'errore dello strumento e adatta la query successiva. Ecco la libertà a runtime in un solo incidente: l'agente trova gli input che non avevate enumerato. Questo è il valore, ed è anche il conto, perché un sistema che trova i vostri input non enumerati su un registro giocattolo di 116 righe li troverà anche in produzione.
Il caso in cui la funzione perde
Fermandosi qui, il riassunto onesto è "usate la funzione": su 116 righe ha azzeccato tutto per pochi centesimi. Meritava una risposta seria, non un'alzata di spalle — così ho fatto crescere i dati. Altri due registri con seme fisso, 4.989 righe e poi 49.889 righe (~3,6 MB di CSV, circa 900mila token), ognuno dei quali nasconde un dipendente che fraziona quelli che dovrebbero essere acquisti grandi, pre-approvati, in acquisti ripetuti appena sotto la soglia, dallo stesso commerciante, distribuiti su due mesi, con note innocue. Stavolta niente indizi "part 2": lo schema si trova solo come ripetizione — raggruppate la fascia appena sotto soglia per dipendente e un nome spicca — mai da una singola riga. La stessa domanda alle tre implementazioni: nomina il dipendente, elenca esattamente le transazioni dello schema.
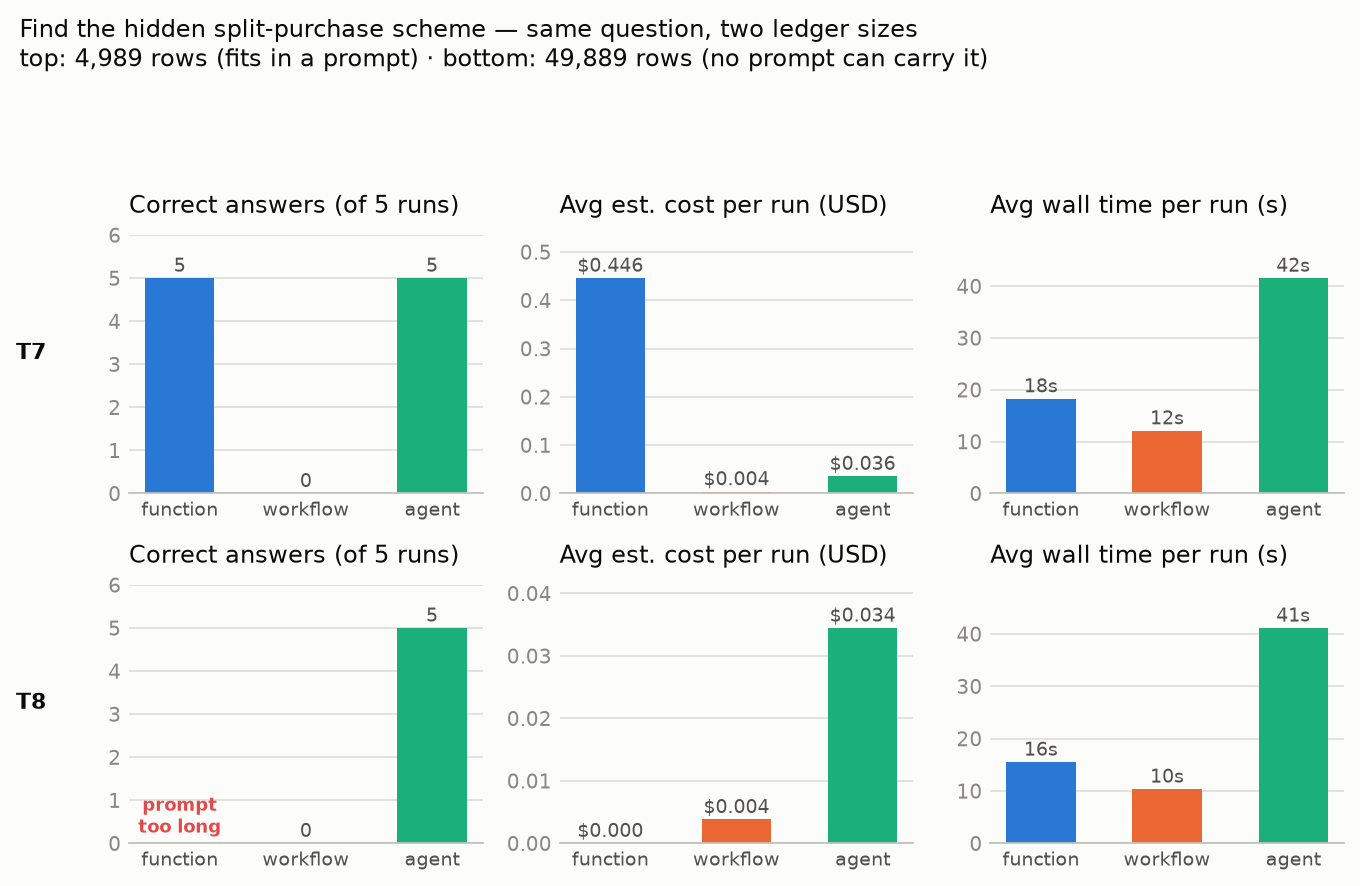 La stessa domanda, due dimensioni di registro. Riga sopra: 4.989 righe. Riga sotto: 49.889 righe, dove la colonna della funzione dice "prompt too long".
Tre risultati, e il primo va contro la mia stessa tesi. A 4.989 righe la funzione vince ancora in accuratezza — cinque su cinque, perché un modello di frontiera che trova un ago in 90mila token di contesto è una capacità reale, e fingere il contrario sarebbe la stessa disonestà di cui questo articolo si lamenta. Ma paga $0,45 a domanda — l'intero registro viaggia in ogni chiamata — mentre l'agente la eguaglia, cinque su cinque, a $0,036. Il costo della funzione è lineare nei dati. Quello dell'agente è piatto, perché le sue chiamate di strumenti restituiscono aggregati, non il registro.
A 49.889 righe la funzione non degrada — scompare. Il prompt supera la finestra di contesto, e l'unica mossa di questa architettura diventa indisponibile. Zero chiamate al modello, Prompt is too long, zero su cinque. "Il contesto è il suo soffitto" smette di essere una metafora e diventa un messaggio d'errore:
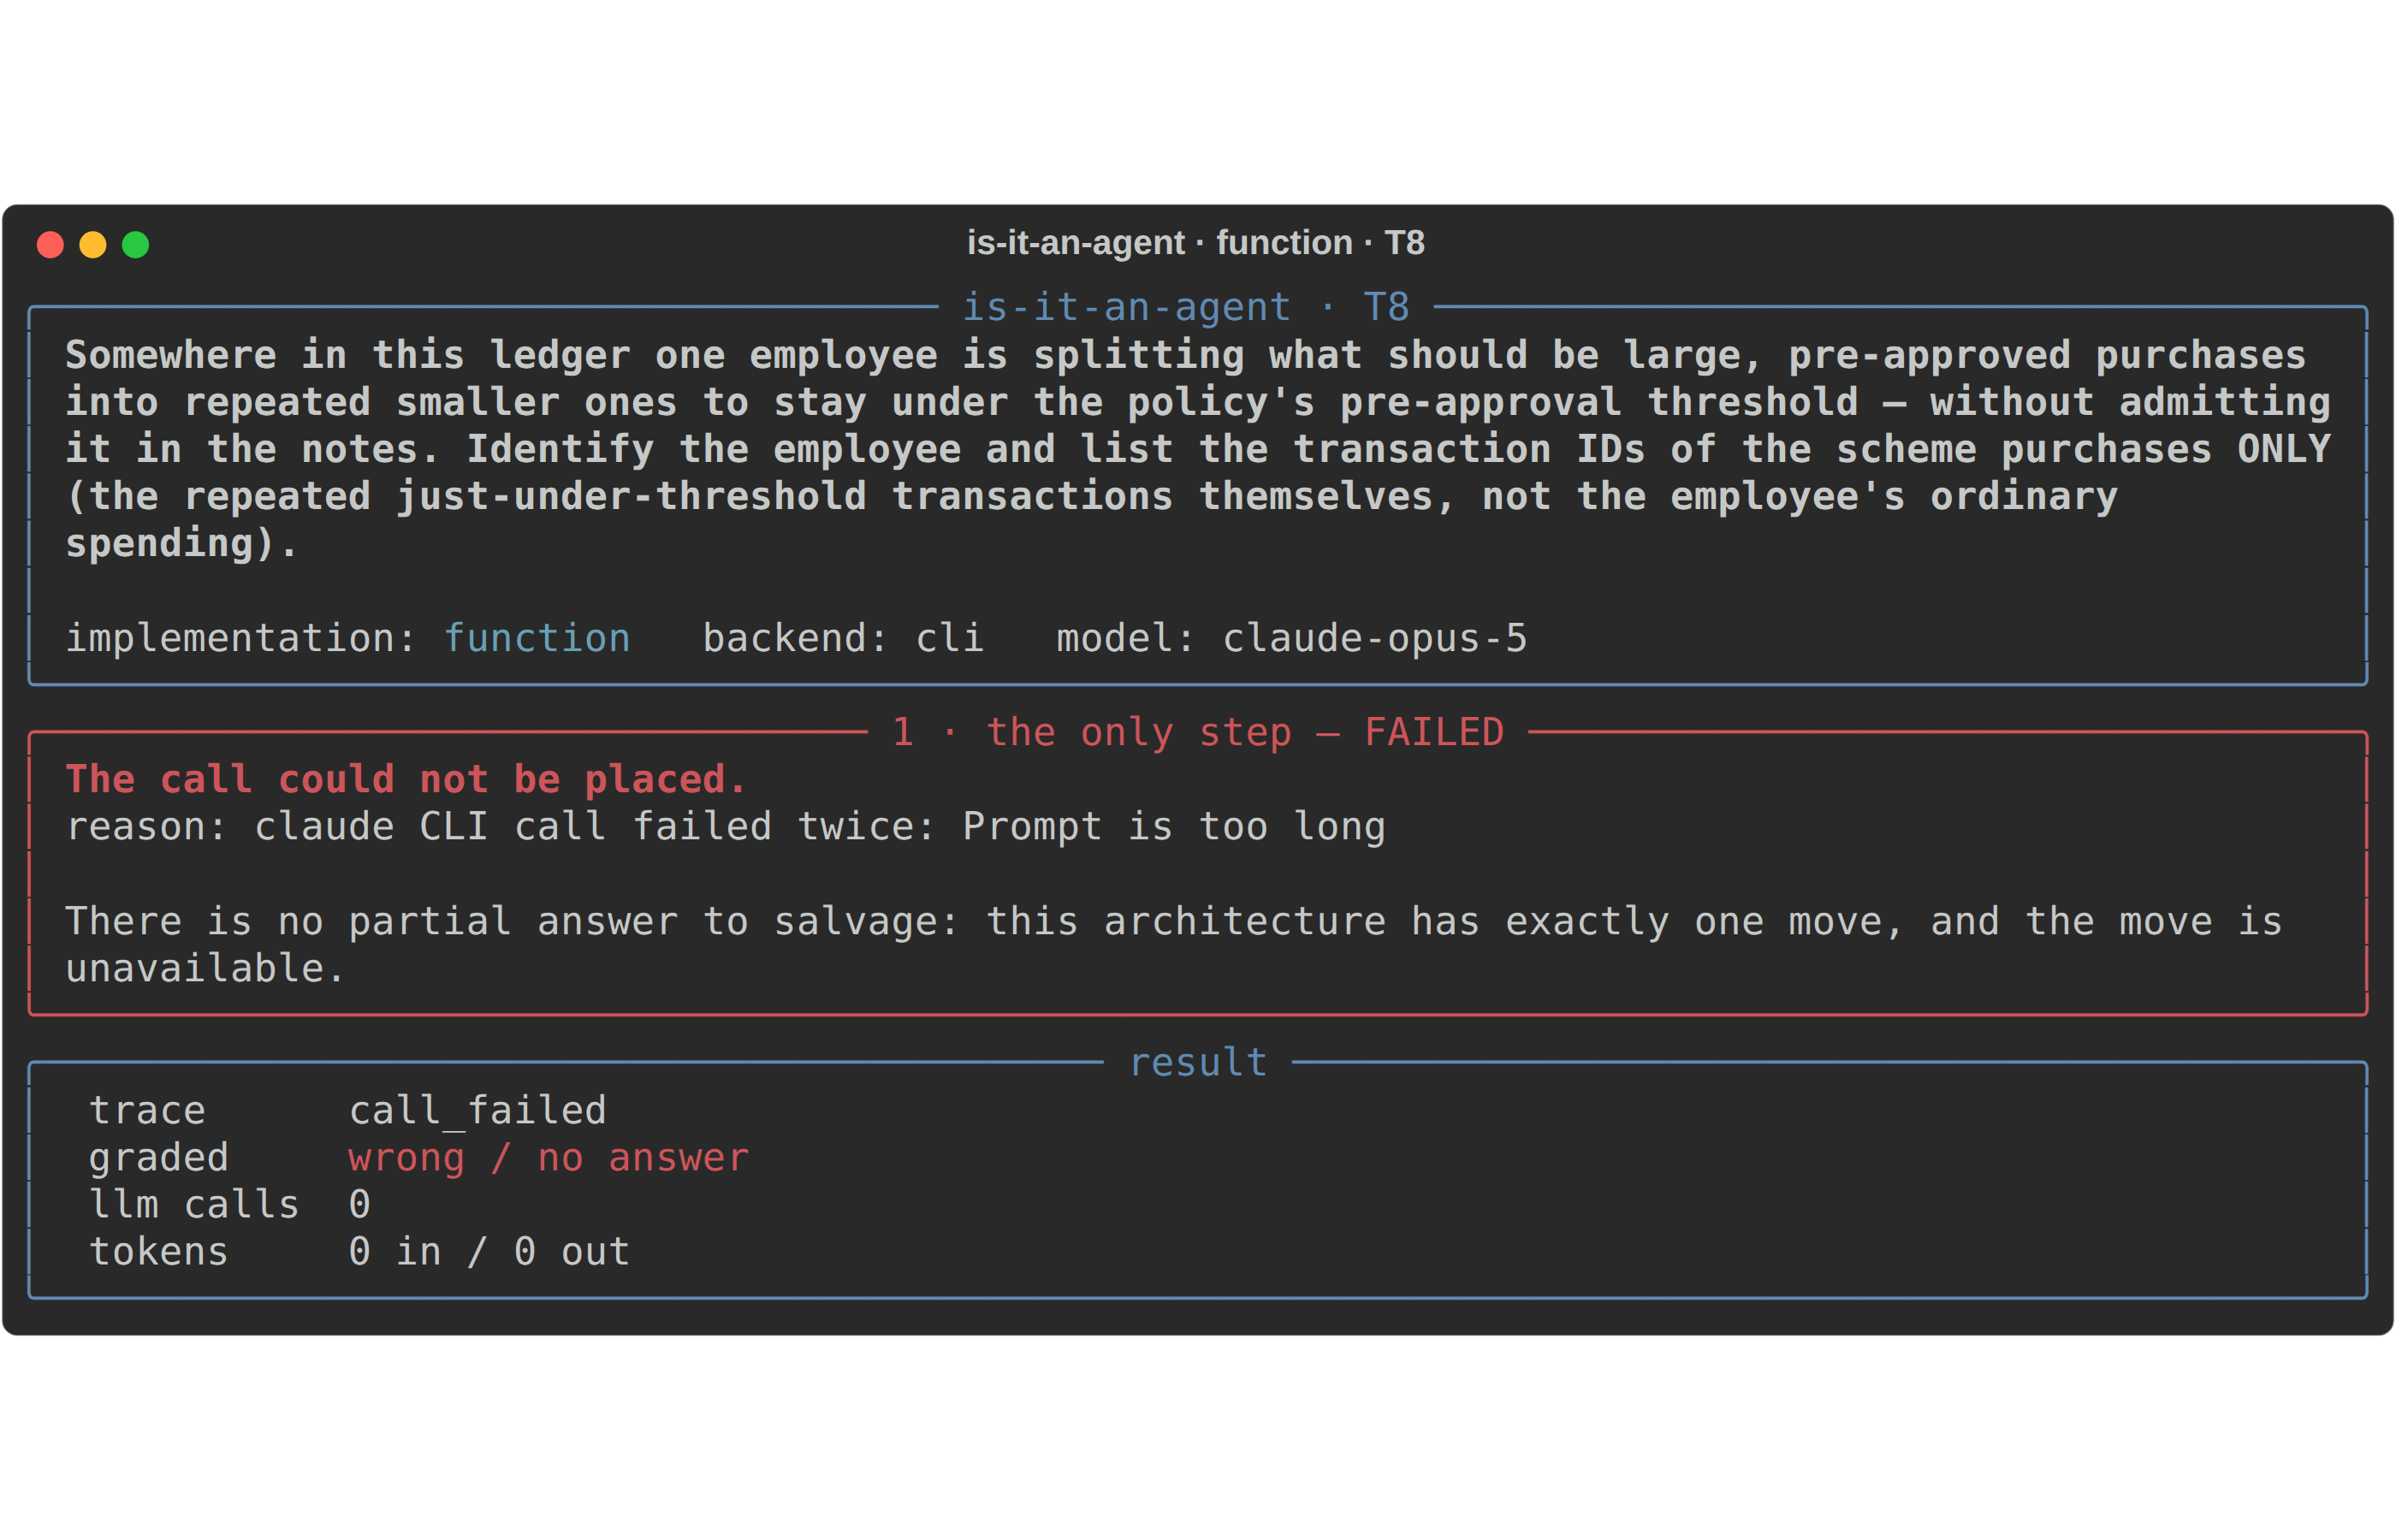 L'anti-demo. Non c'è alcuna risposta parziale da salvare: questa architettura ha esattamente una mossa, e la mossa non è disponibile.
E l'agente non nota la differenza. Le stesse cinque chiamate, gli stessi ~$0,034, cinque su cinque: leggere la policy per la soglia, raggruppare la fascia appena sotto soglia per dipendente, vedere un nome con sei occorrenze dove tutti gli altri ne hanno al massimo una, ispezionare quelle righe, fermarsi. Le trace a 50mila righe hanno la stessa forma che a 5mila, perché la strategia del modello non cresce con i dati — crescono solo i dati:
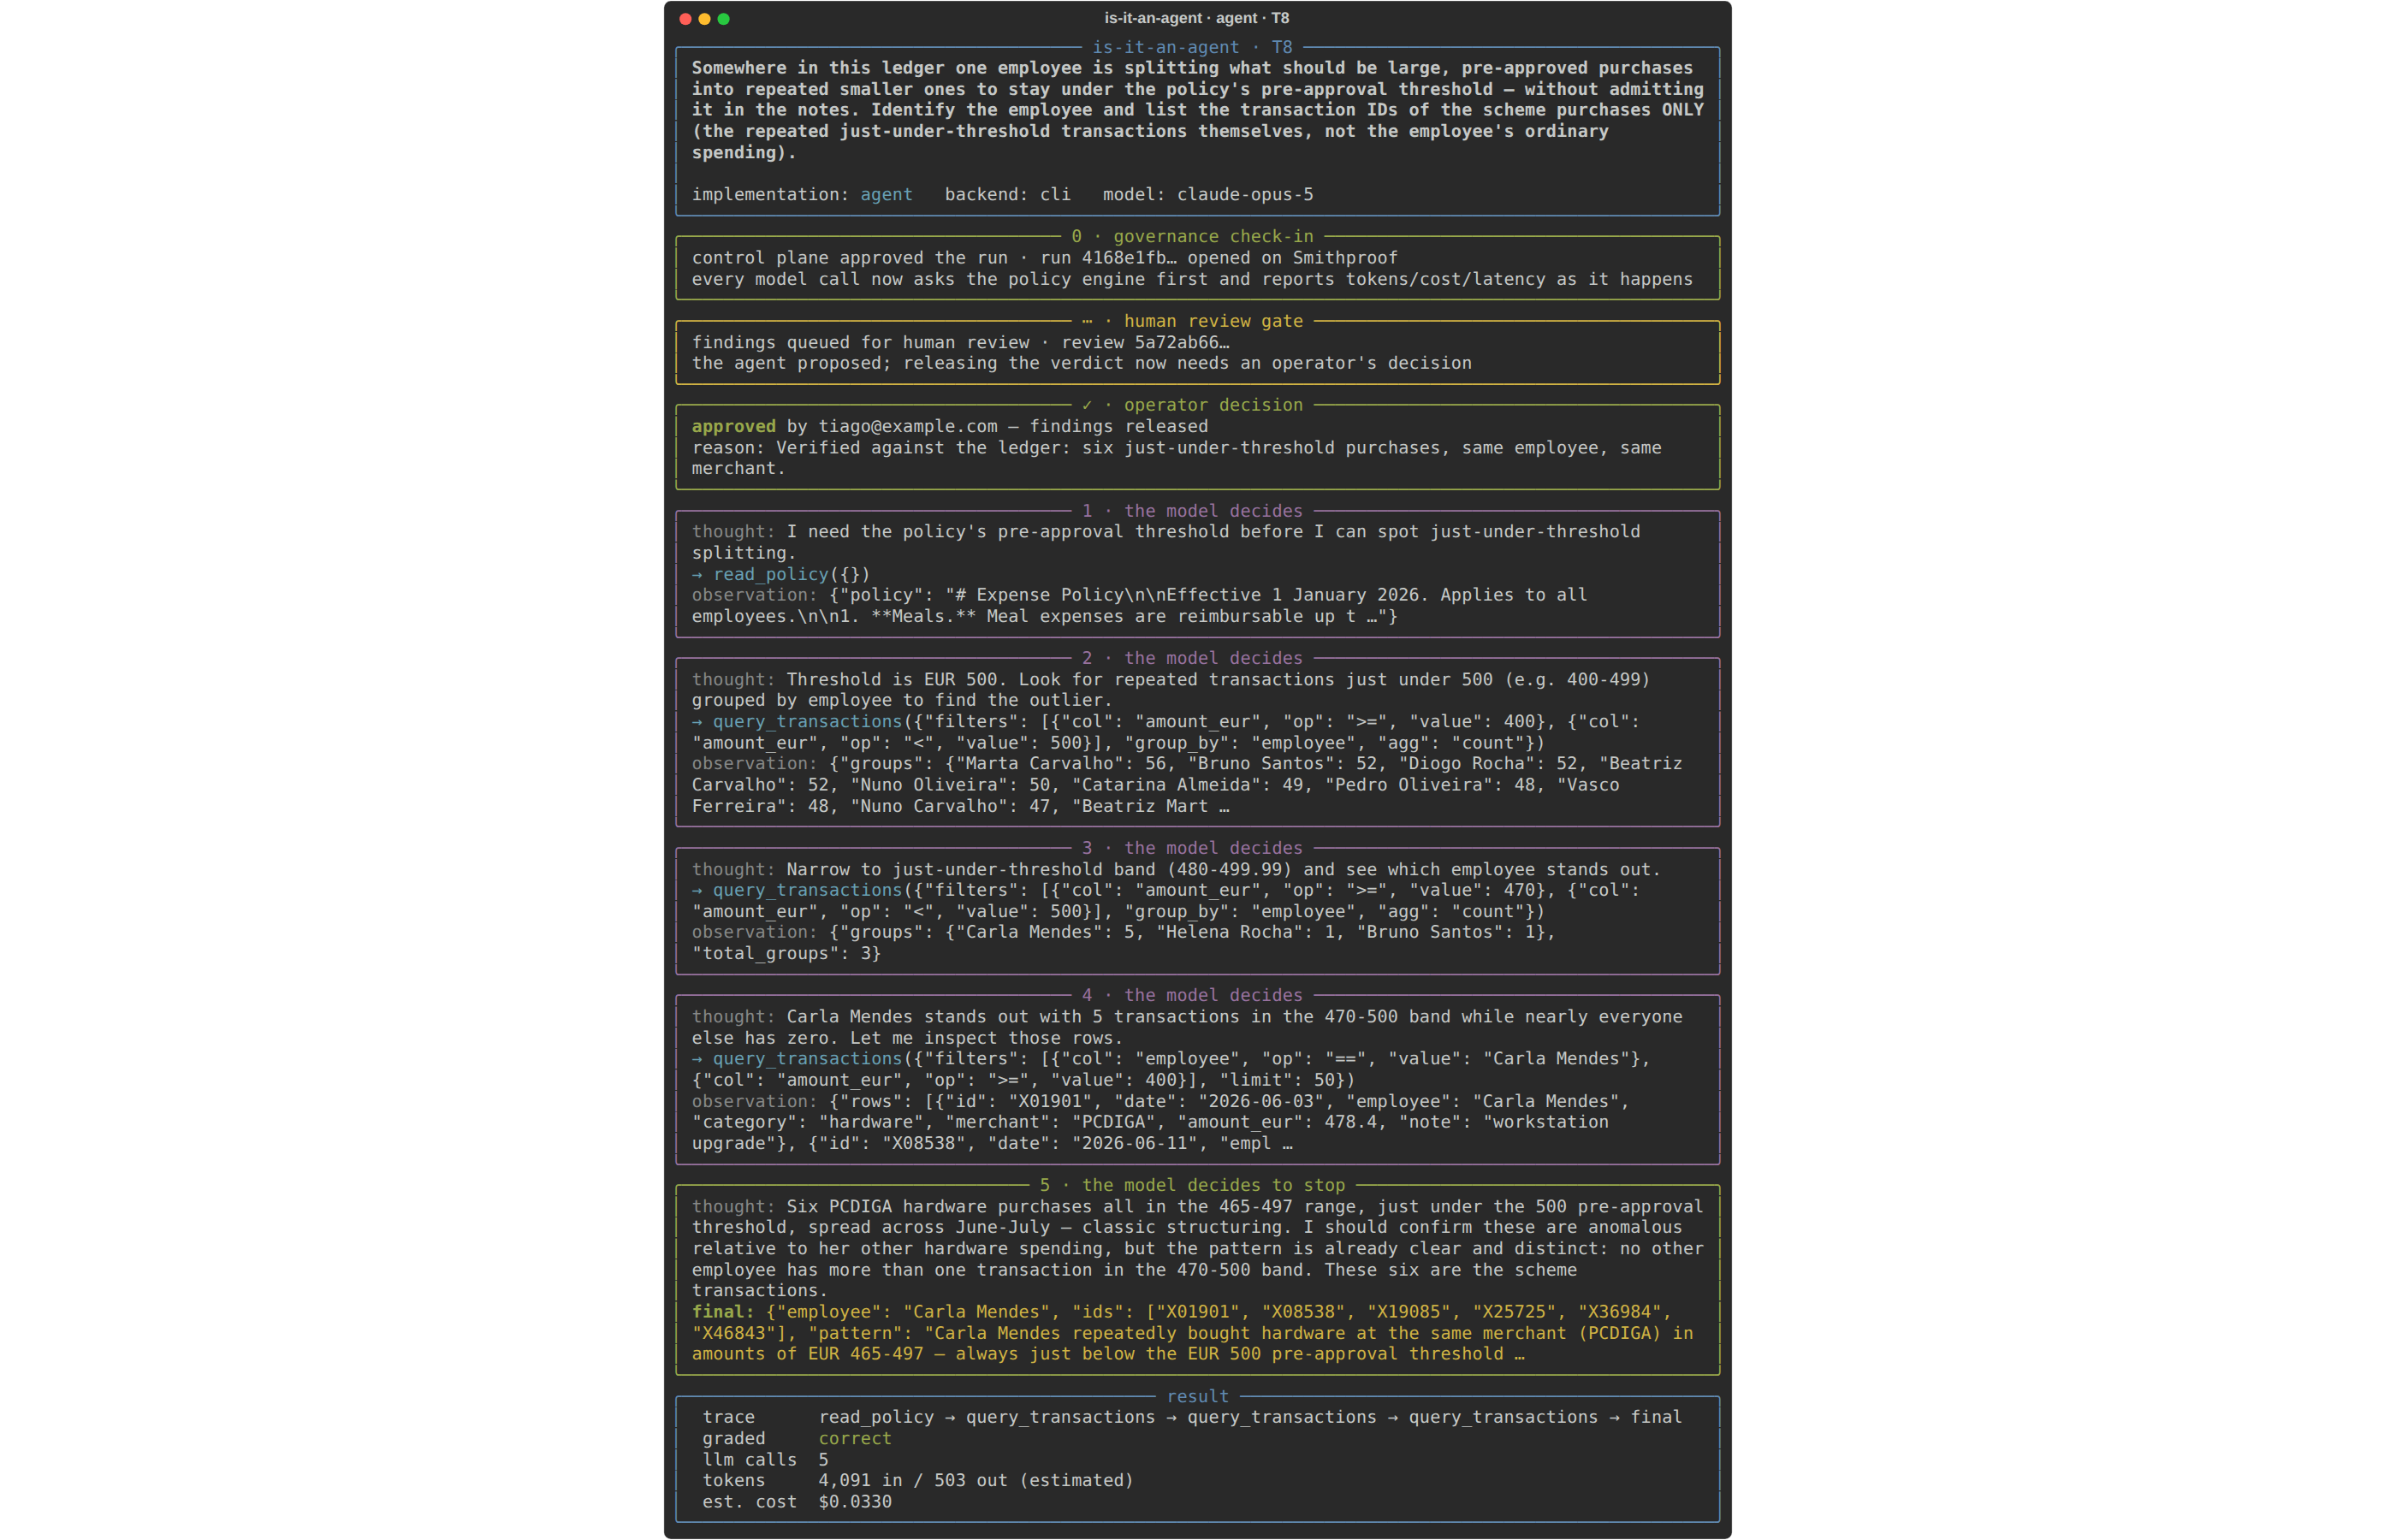 L'agente a 50mila righe, governato dal piano di controllo e con revisione umana, corretto in cinque decisioni. Confrontate la riga del costo con quella della funzione su un registro dieci volte più piccolo.
Costruire questa fascia ha prodotto altre due sterzate sbagliate che vale la pena conservare. Il mio tetto originale di 8 turni ha soffocato le prime run — tre su cinque l'hanno colpito a metà indagine, un budget che non era della taglia del lavoro che limitava. E l'agente ha esposto un valutatore ambiguo: nella prima versione dei dati, la dipendente dello schema pescava anche acquisti casuali da €380–450, l'agente li ha ragionevolmente ripiegati nel pattern, e il mio valutatore l'ha segnato come errore. La correzione apparteneva al mondo, non al valutatore. Un agente che trova gli input che non avevate enumerato trova anche le ambiguità che non avevate notato — la stessa proprietà, che fa entrambi i lavori.
La definizione letta al contrario
Il che mi porta alla parte del test che mi sta più a cuore, perché collega questo articolo al piano di controllo che ho costruito. Un agente si riconosce da ciò di cui ha bisogno: tracing, un budget, un modo per dirgli di no.
Così ho cablato quei bisogni sul serio. Quando l'ambiente porta credenziali Smithproof, l'implementazione agente del progetto gira governata — ogni run si presenta al piano di controllo prima della sua prima chiamata al modello, ogni chiamata all'LLM e ogni chiamata di strumento viene riportata man mano che accade, e la run viene chiusa come completata o fallita alla fine. La funzione e il workflow non vengono mai governati. Non c'è nulla da governare: il loro flusso di controllo non può sorprendere nessuno.
Quell'asimmetria è l'intero argomento, reso eseguibile. E smette di essere decorativa nel momento in cui il piano di controllo dice di no. Mettete l'agente in quarantena ed eseguite di nuovo: la pipeline viene rifiutata alla porta, prima di qualsiasi chiamata al modello, con codice di uscita 5:
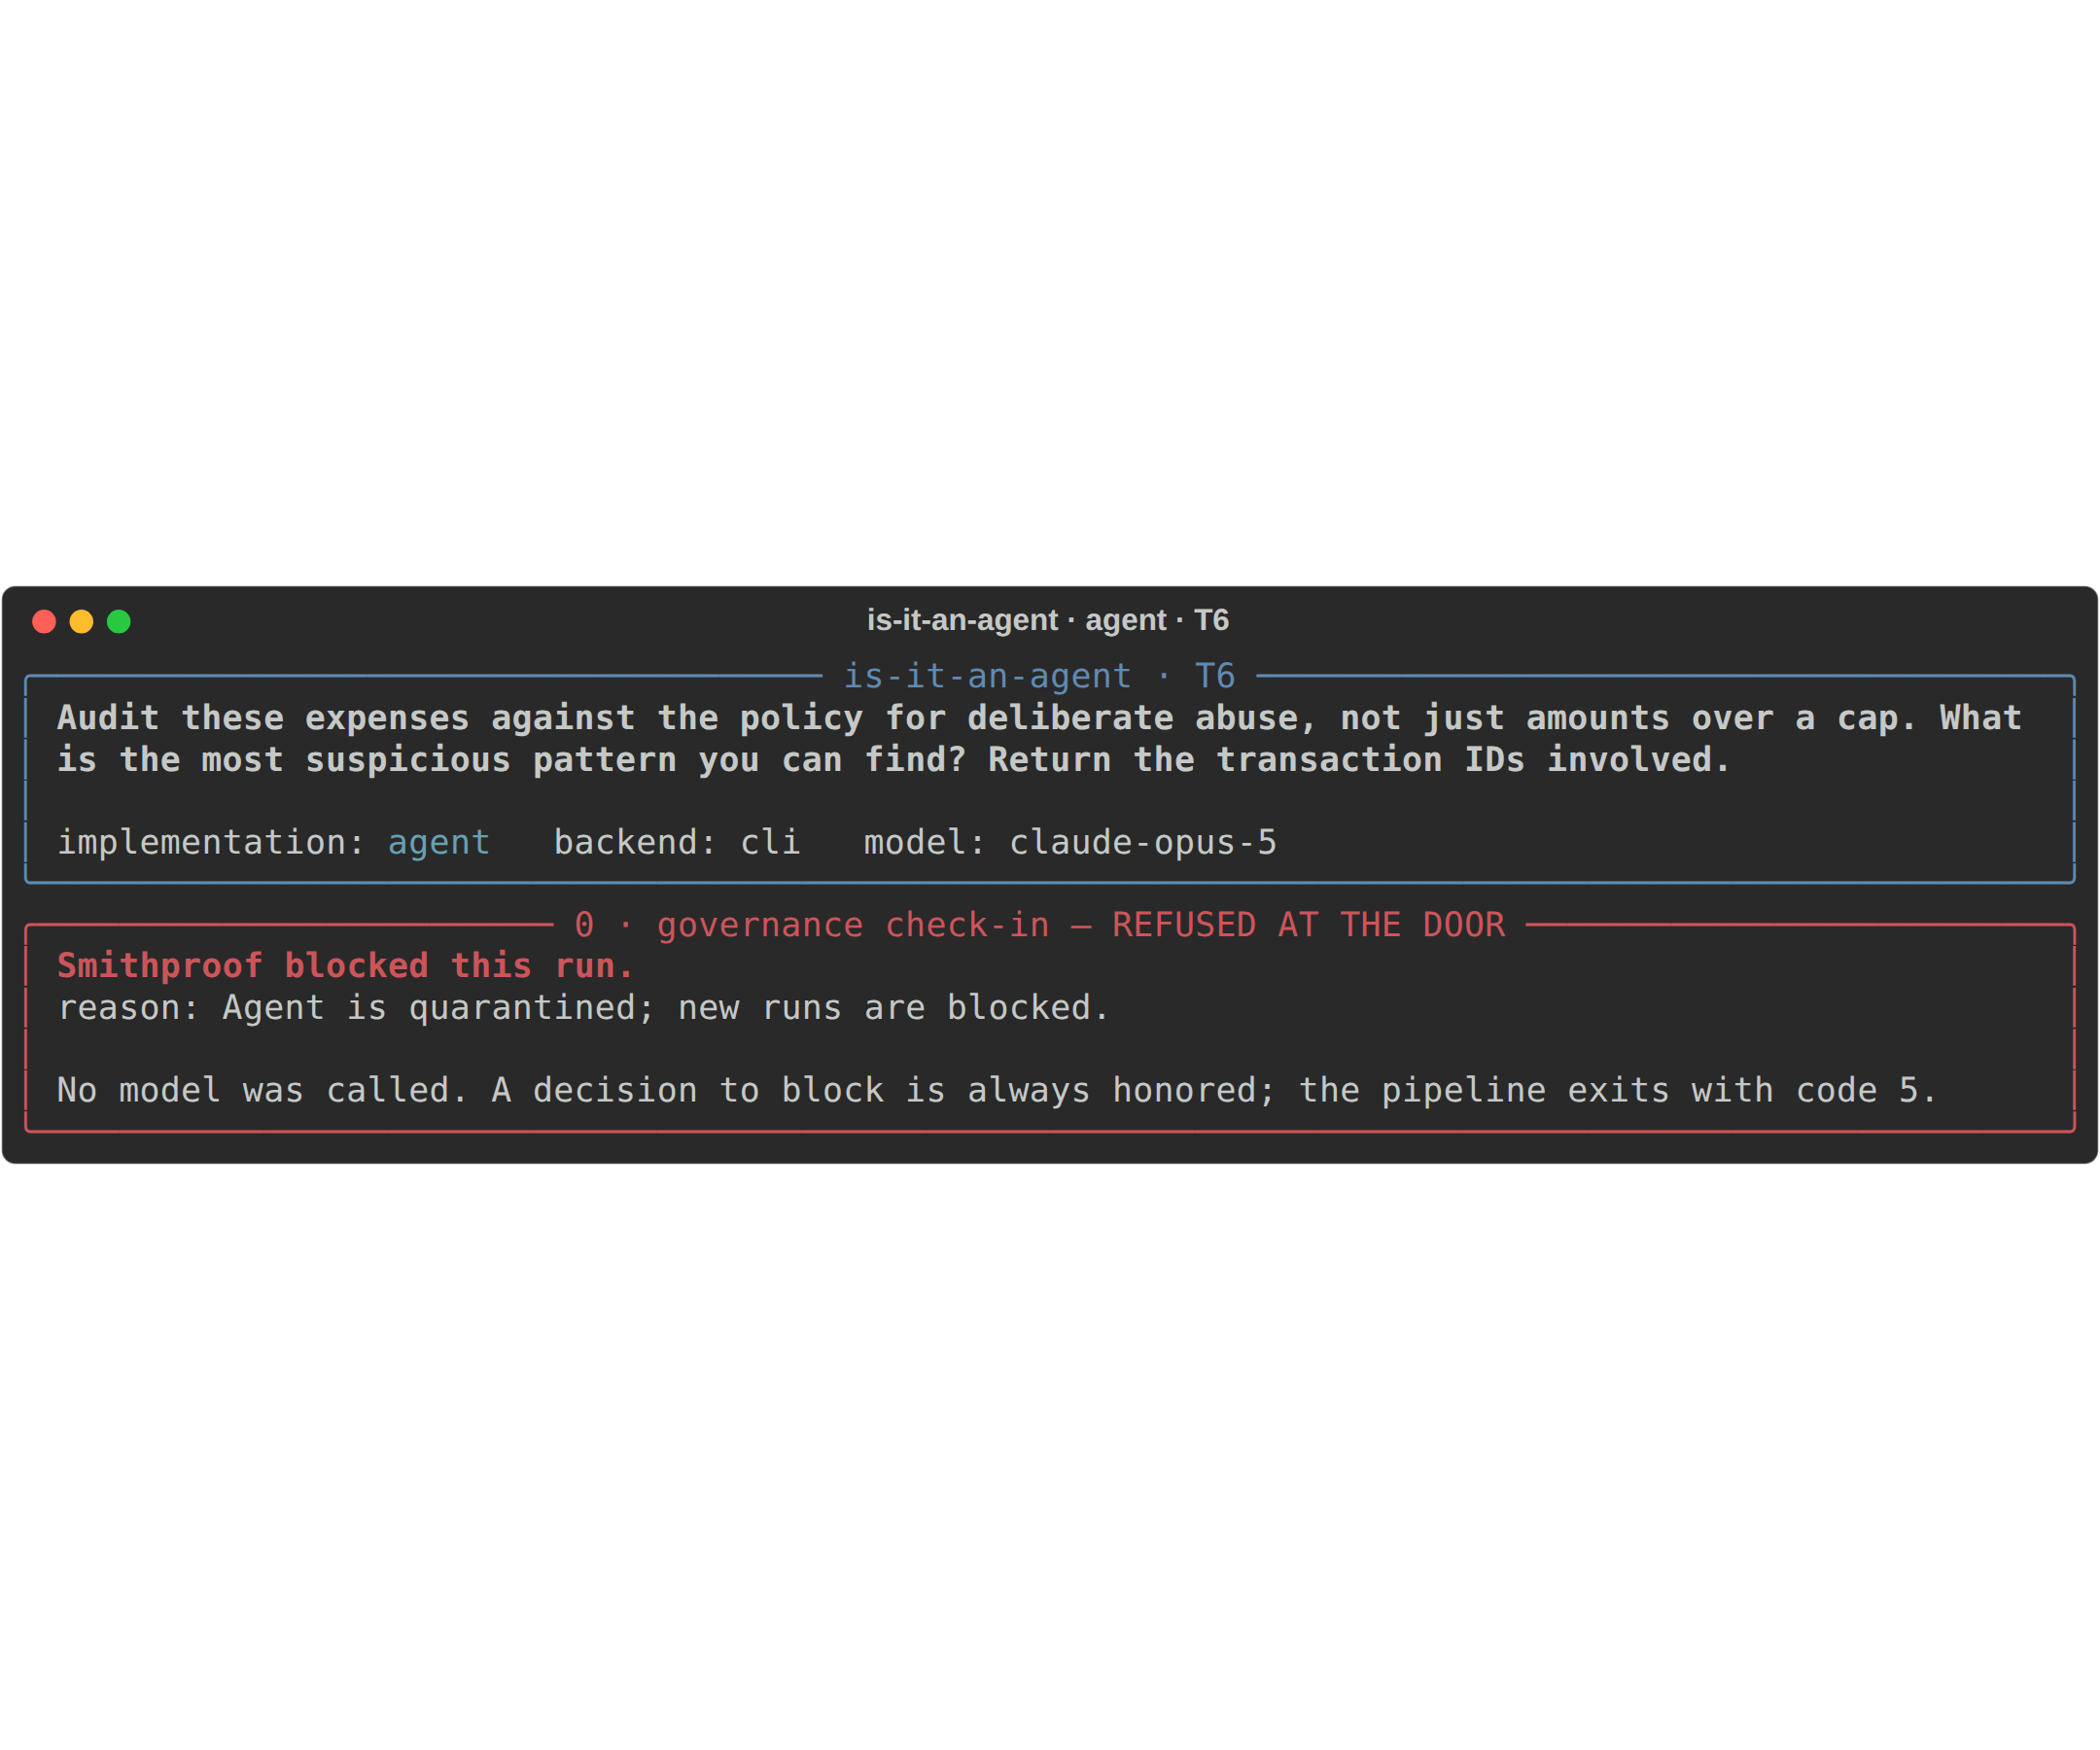 Una decisione di blocco viene sempre onorata. La semantica di errore è presa in prestito dal mio progetto plan-to-pr: negare su decisione, avvisare su guasto — un piano di controllo irraggiungibile avvisa e prosegue, perché la telemetria non deve mai essere il motivo per cui una build si rompe.
Il budget morde a metà run, che è dove deve mordere per un sistema che decide a runtime quante chiamate farà. Una policy di limite di spesa riceve un verdetto prima di ogni chiamata al modello, e il motore delle policy legge la spesa registrata della run lato server — non un numero fornito dal client, perché un tetto che si fida del chiamante si aggira omettendo un campo. Con il tetto stretto a due centesimi, una run reale sul compito aperto ha fatto quattro chiamate e la quinta è stata rifiutata prima di essere piazzata:
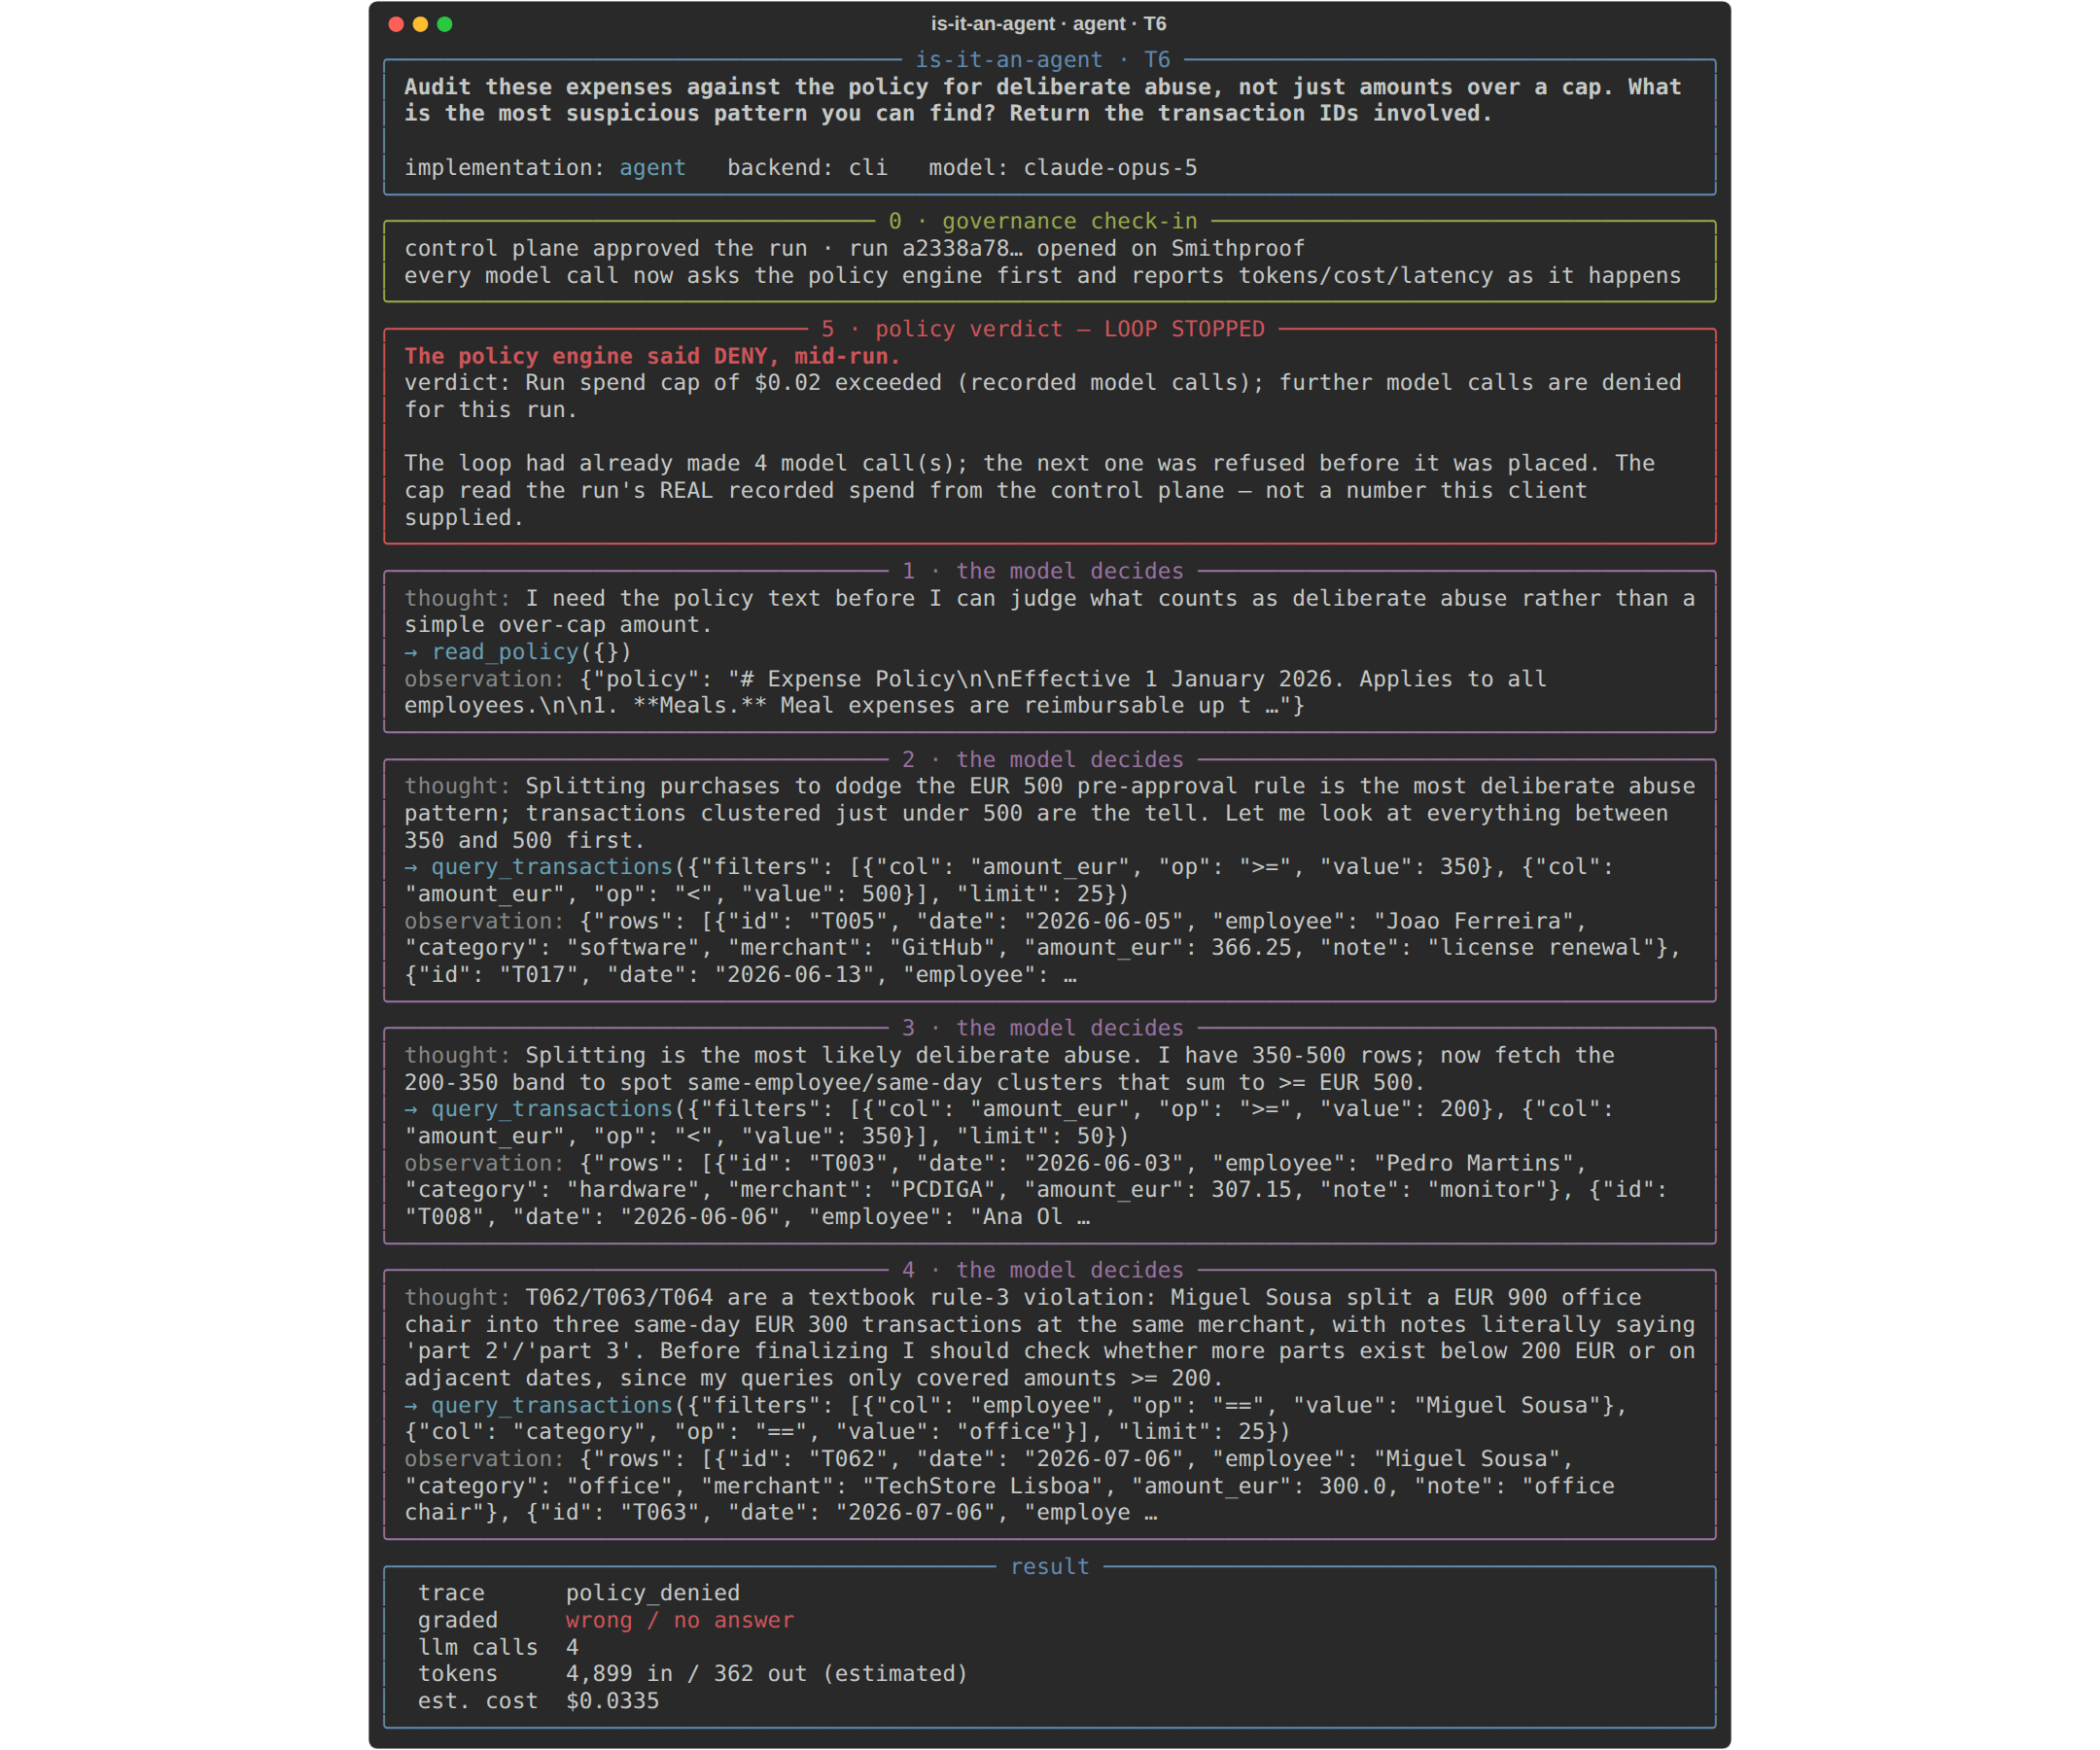 Il ciclo si ferma dove cade il verdetto. Il costo della funzione si conosce prima di chiamarla; quello del workflow è stato fissato in fase di scrittura; solo l'agente ha bisogno di un punto di enforcement dentro il ciclo.
Il lato tracing si è rivelato discretamente soddisfacente: con le chiamate di strumento che arrivano come span, la vista della run del piano di controllo ricostruisce l'intero ritmo del ciclo — decidere, agire, osservare, decidere — dalla sola telemetria:
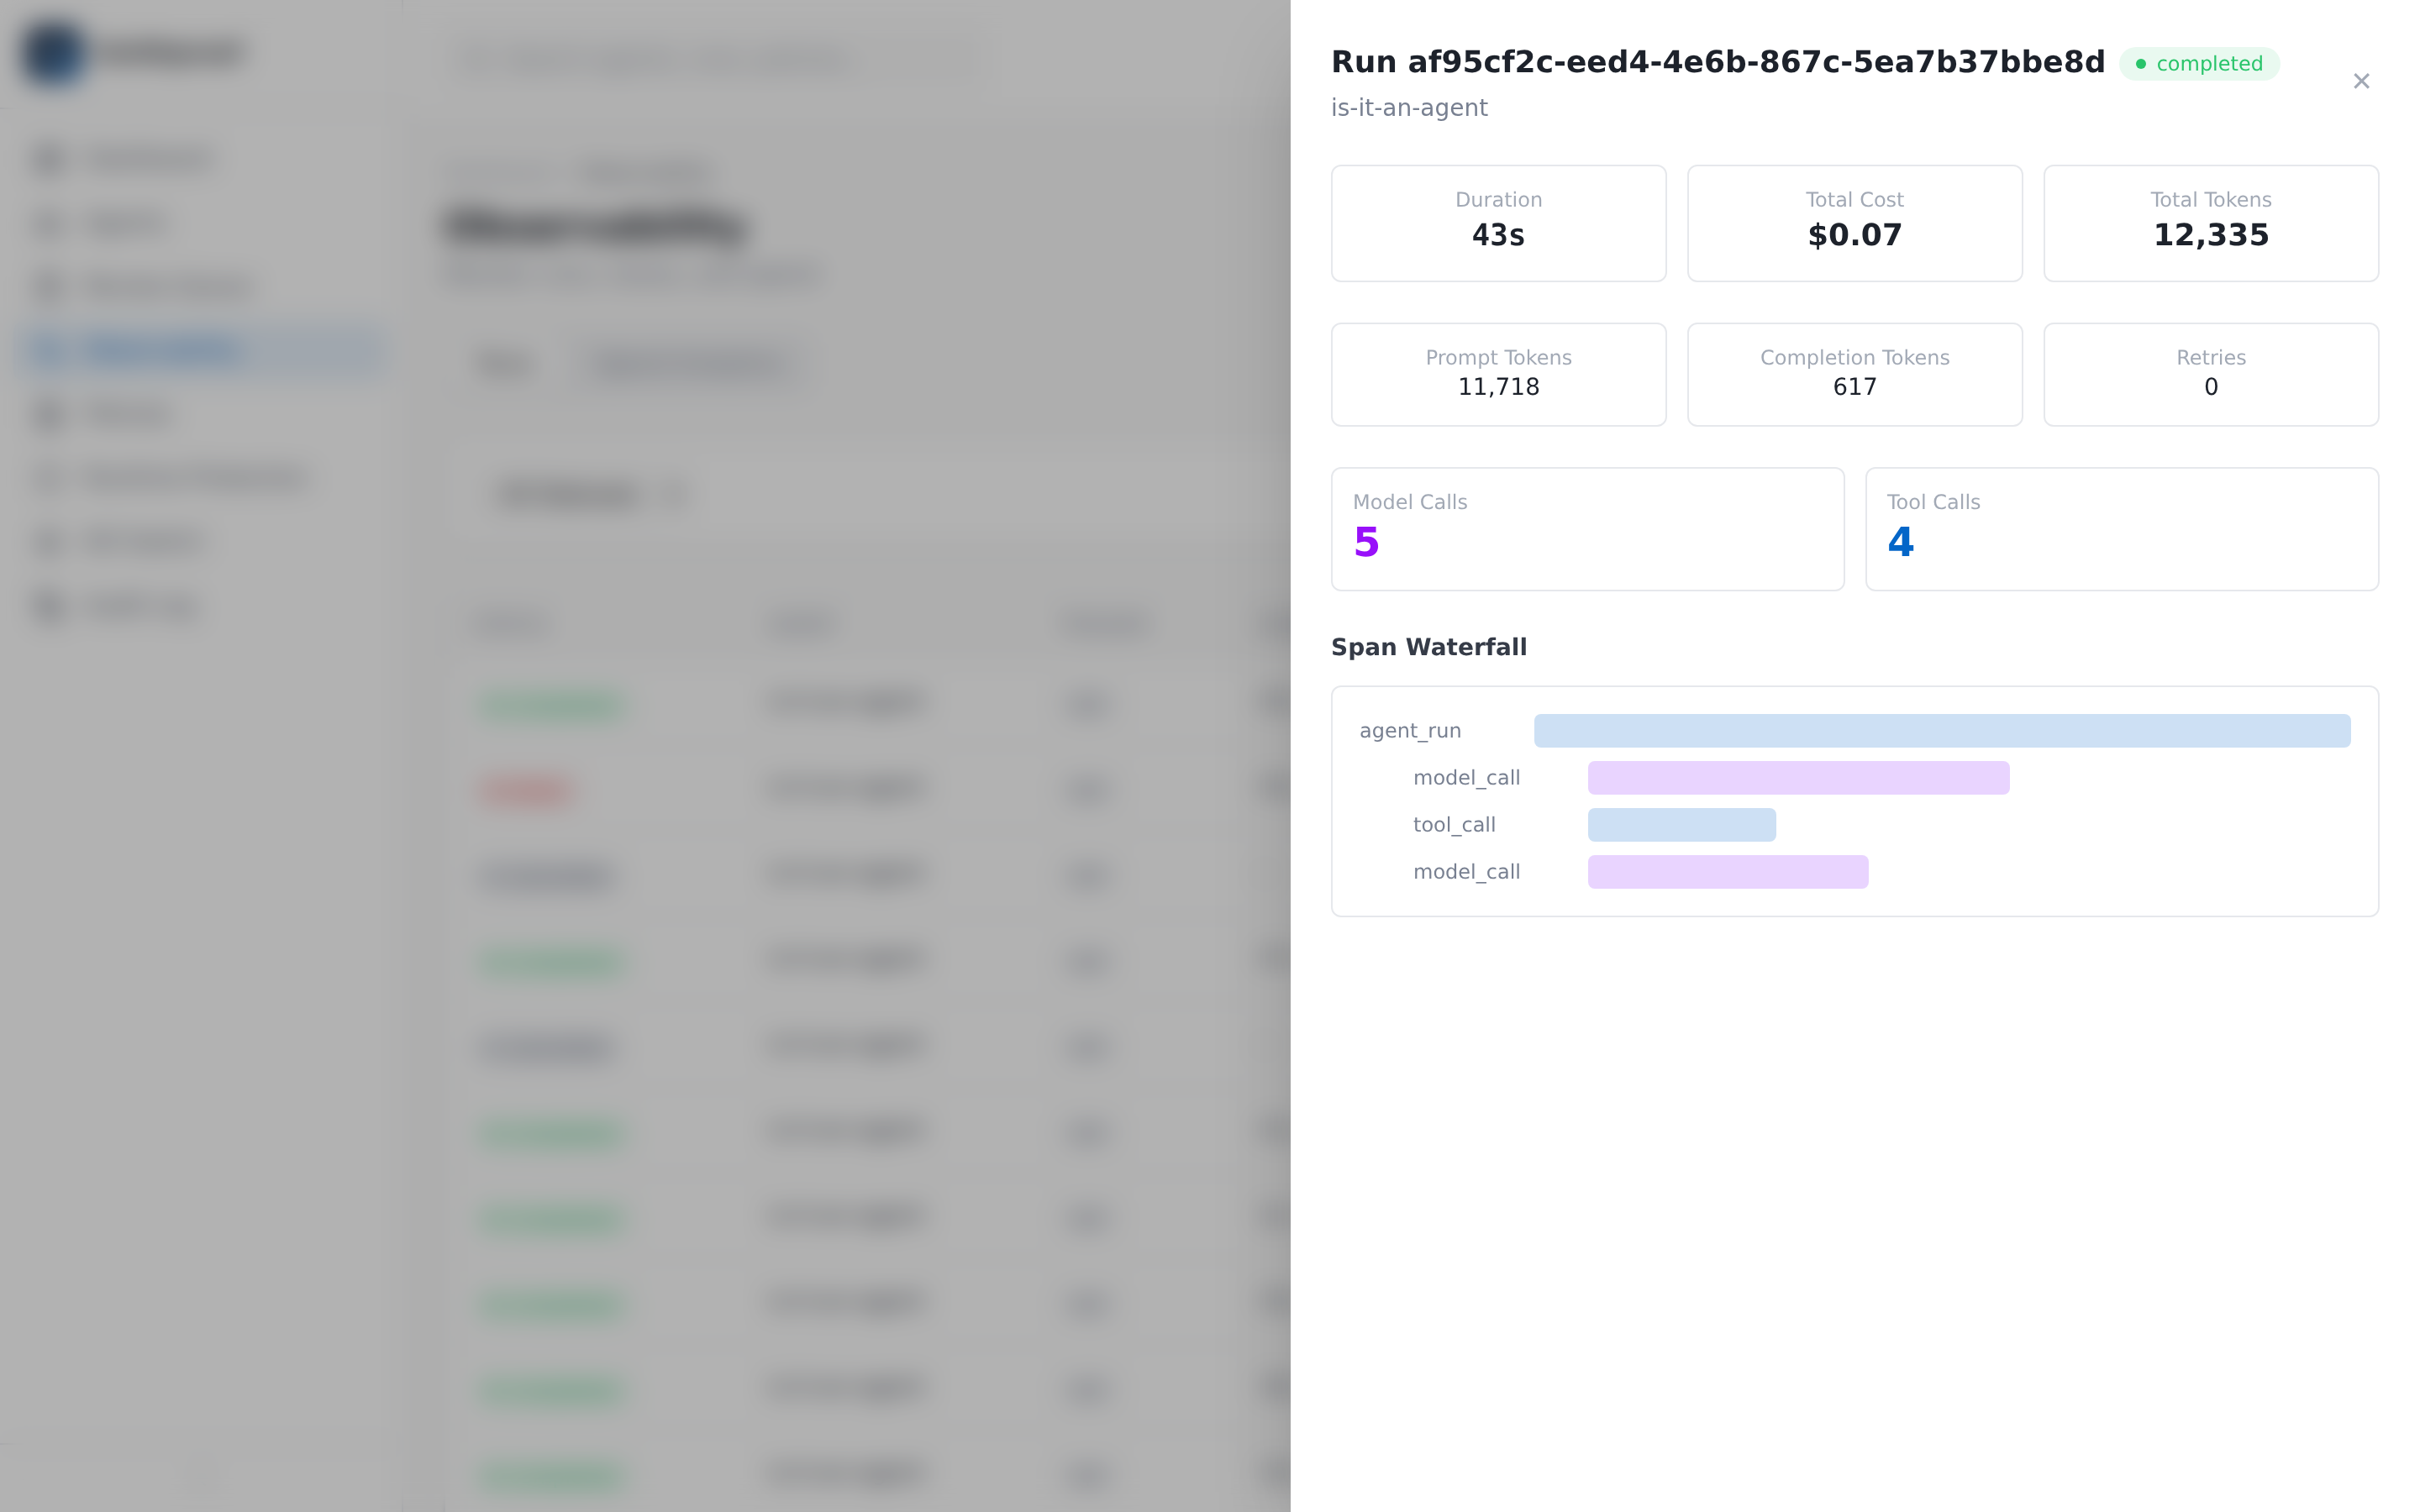 Il ritmo ReAct, recuperato dall'esterno. Questa vista non si può ottenere da una funzione; non c'è nulla da vedere se non un blocco.
E sull'unico compito in cui l'agente aveva libertà reale — l'audit aperto, le cui conclusioni fanno il nome di un dipendente —, la run governata non rilascia il suo verdetto di propria autorità. Deposita le conclusioni in una coda di revisione e si blocca finché un operatore non approva o respinge:
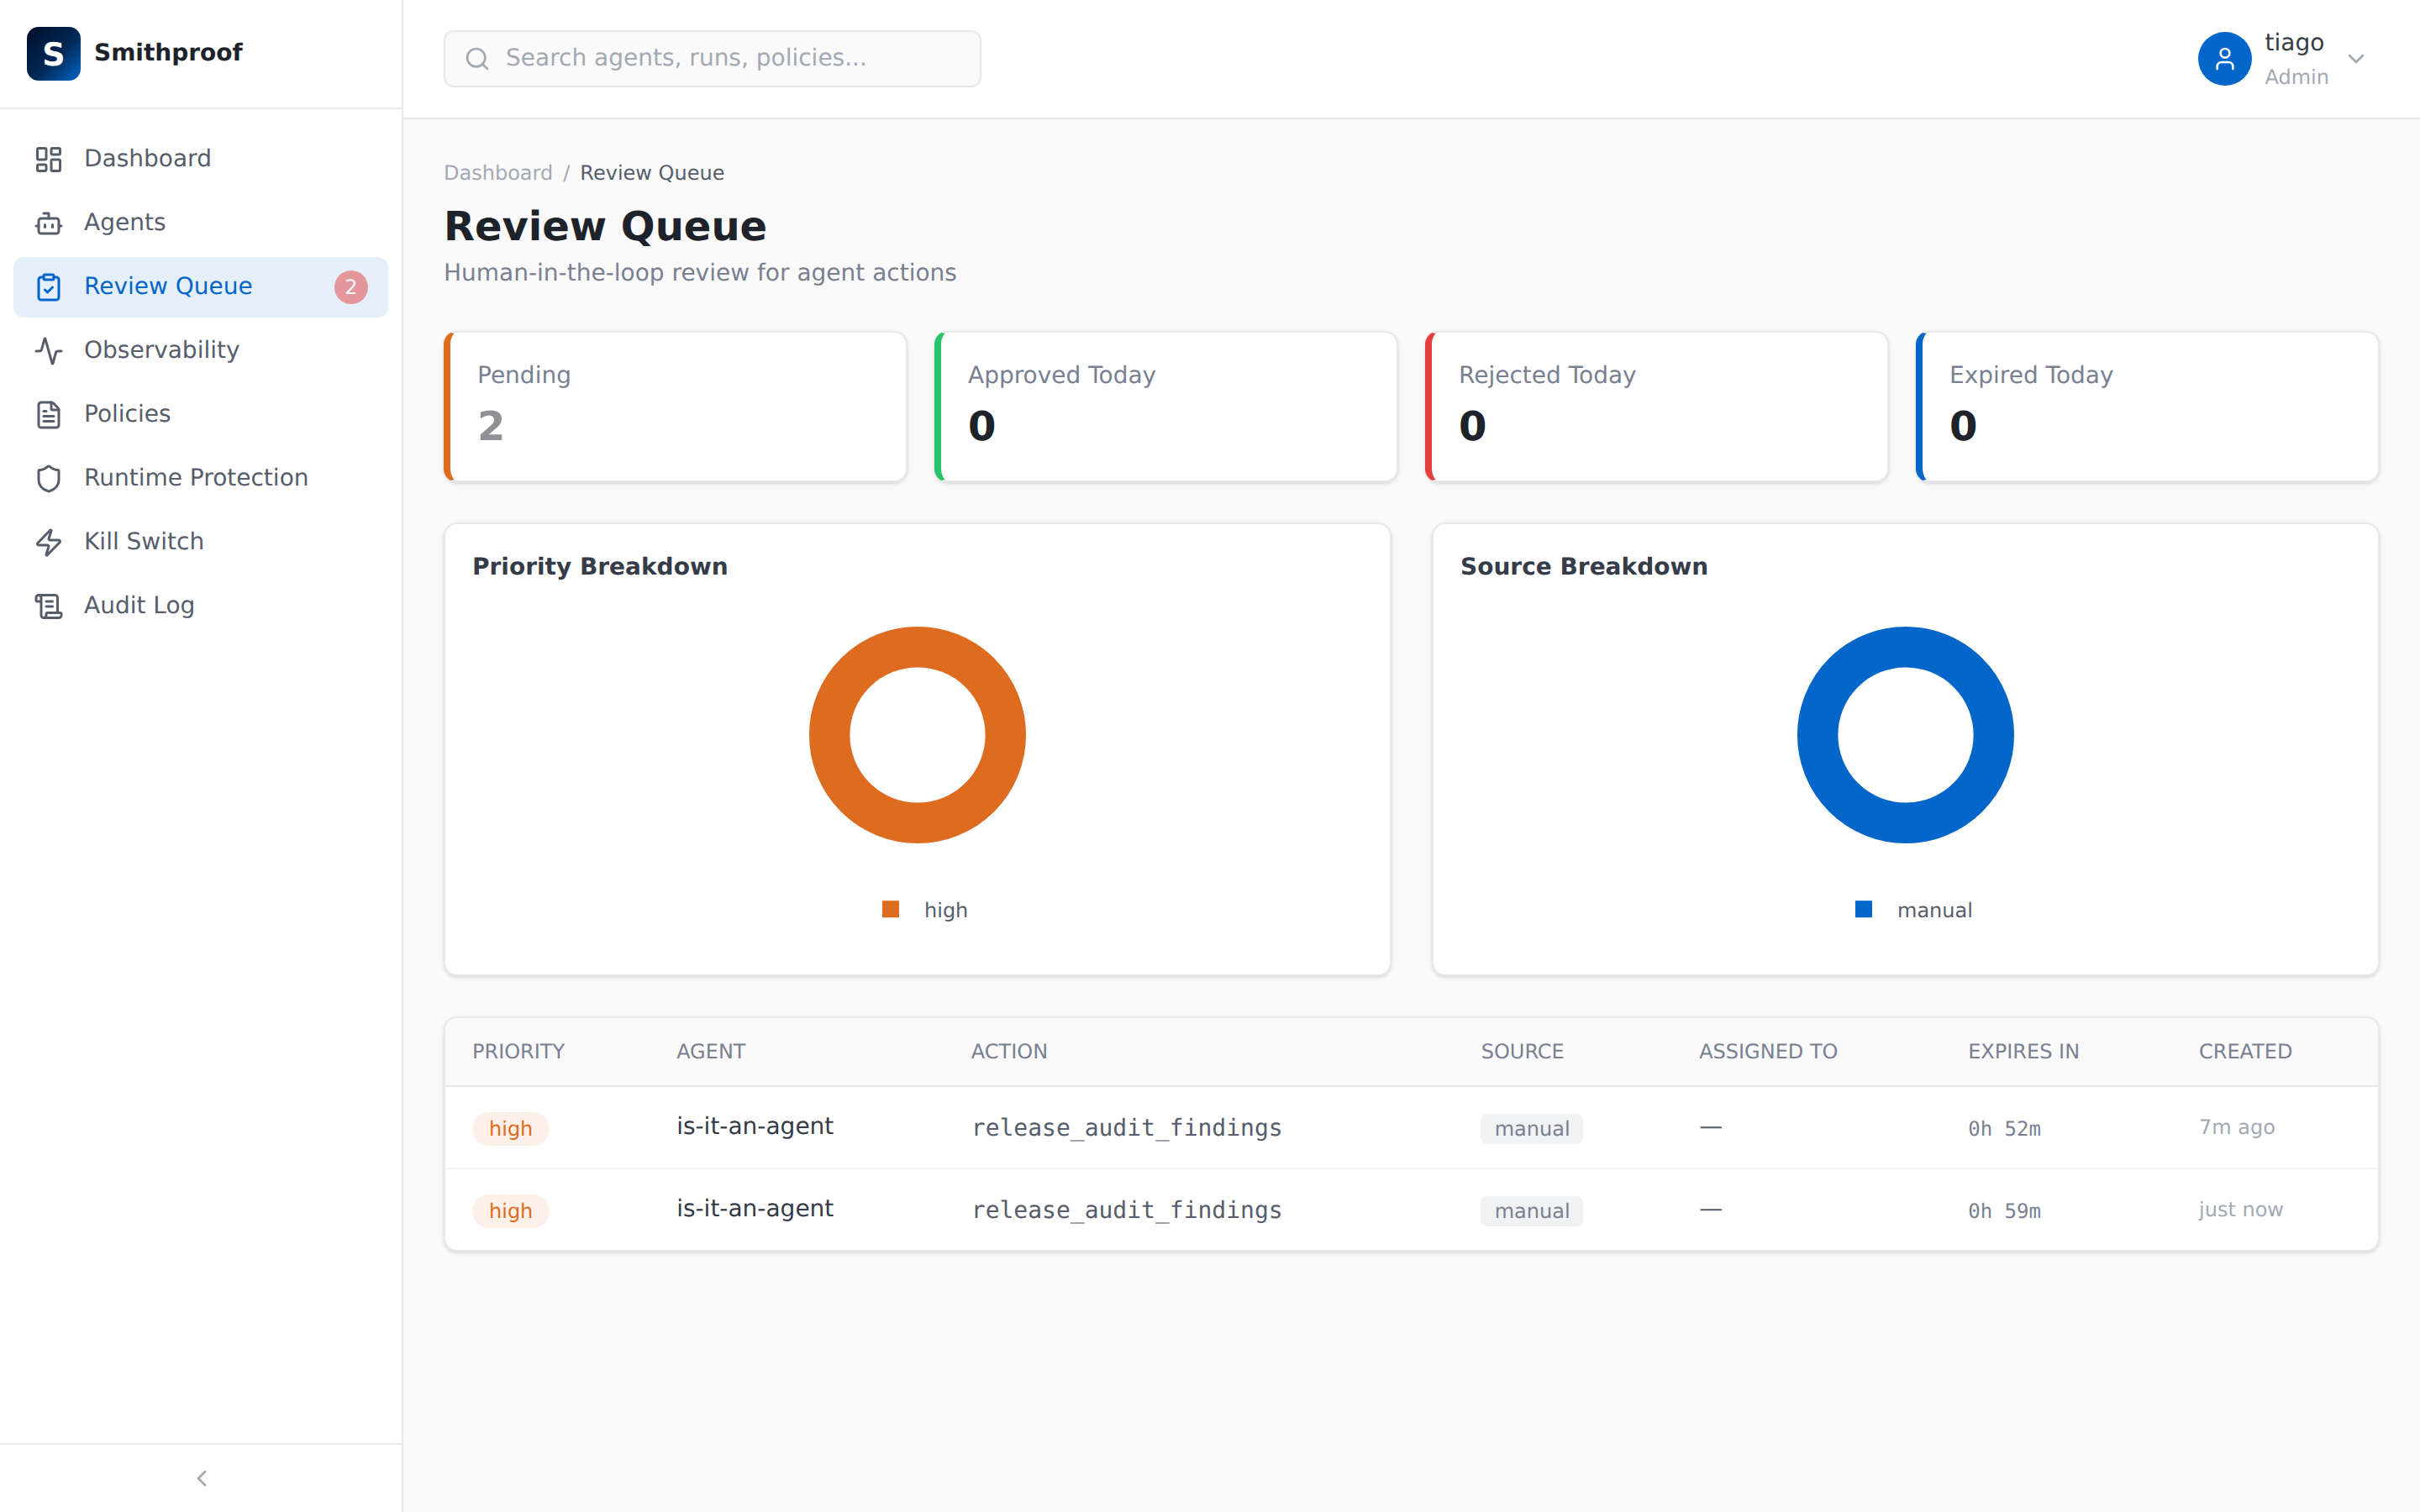 Notate dove sta il cancello: non sulle domande ben specificate, la cui risposta è un numero che chiunque può ricalcolare, ma esattamente sulla fascia dove il modello aveva libertà. Lo sforzo di revisione segue la libertà a runtime.
Provate a far girare il workflow sotto una qualsiasi di queste protezioni e la domanda si risponde da sola. Non c'è una porta a cui rifiutarlo. Le sue due chiamate all'LLM riempiono caselle in una catena la cui forma è stata fissata quando l'ho scritta. Il conto della governance è il prezzo della libertà a runtime, e solo una delle tre forme lo deve.
A cosa serve la parola
Niente di tutto questo è un argomento contro le funzioni o i workflow. Le misurazioni argomentano a favore loro, ad alta voce, ovunque la domanda sia enumerabile: il workflow ha eguagliato l'accuratezza dell'agente dentro le sue rotte a un ottavo del costo, con varianza zero e nulla da governare. Se il vostro prodotto è una funzione, lanciate la funzione, e godetevi il fatto che non avrà mai bisogno di un kill switch.
L'argomento è che le tre forme sono oggetti di ingegneria diversi con conti diversi attaccati, e la parola "agente" esiste per rivelare quale conto state firmando. Varianza da tracciare. Spesa da limitare a runtime. Azioni che richiedono un cancello umano. Una flotta che bisogna poter fermare. Quando un fornitore chiama agente una funzione tipizzata, vi sta facendo pagare il premio di paura di una forma consegnandovi le garanzie di un'altra — o peggio, vi sta insegnando che la parola è rumore, proprio prima che mettiate in produzione qualcosa che decide davvero a runtime e nessuno allunghi la mano verso il tracing, il budget o l'interruttore, perché gli ultimi tre "agenti" non ne avevano mai avuto bisogno.
Fate il test delle dieci run alla prossima cosa che vi vendono. Se tutte le trace sono uguali, avete una funzione o un workflow — pagate il conto più piccolo, volentieri. E se le trace variano, avete un agente, e la varianza non è la parte impressionante. È il conto — e il giorno in cui i vostri dati supereranno il prompt, è anche l'unica architettura ancora in piedi per mandarvelo.
Le domande a cui questo articolo risponde
Che cosa rende davvero un sistema un agente e non un workflow?
Il modello decide il flusso di controllo a runtime: quale strumento chiamare, se iterare ancora, quando fermarsi. Il saggio di Anthropic sulla costruzione di agenti efficaci traccia la stessa linea: i workflow orchestrano gli LLM lungo percorsi di codice predefiniti, gli agenti dirigono il proprio processo. Una catena fissa di classifica, esegui e componi resta un workflow per quante chiamate all'LLM contenga, perché ogni percorso possibile è stato enumerato da un umano in fase di scrittura.
Come faccio a capire se quello che un fornitore chiama agente lo è davvero?
Eseguitelo dieci volte sullo stesso input e guardate la struttura delle trace, non la formulazione dell'output. Se la struttura non varia mai, strumenti diversi e un numero di passi diverso, è una funzione o un workflow: nella griglia misurata entrambi hanno prodotto esattamente una forma di trace, mentre l'agente ne ha prodotte cinque sul compito aperto. C'è una quarta forma del test, che legge la definizione al contrario: se il sistema non ha bisogno di tracing, di un tetto di budget e di un modo per dirgli di no, non è mai stato un agente.
Se una sola grande chiamata all'LLM dà la risposta giusta, a che serve un agente?
Su dati piccoli non serve, e le misurazioni lo dicono chiaramente. Con l'intero registro di 116 righe nel prompt, la chiamata singola della funzione ha azzeccato 40 volte su 40, compresa la frode piantata, a $0,0123 per run. Il problema è che il suo costo è lineare nei dati: a 4.989 righe la stessa risposta corretta è costata $0,45 a domanda contro i $0,036 dell'agente, e a 49.889 righe il prompt ha superato la finestra di contesto, l'unica mossa di quell'architettura è diventata indisponibile e ha fatto zero su cinque senza piazzare una sola chiamata al modello.
Che cosa costa un agente che un workflow non costa?
Varianza da tracciare, spesa da limitare mentre il ciclo sta ancora girando, azioni che richiedono un cancello umano e una flotta che bisogna poter fermare. In questo progetto l'implementazione agente gira governata contro un piano di controllo: con il tetto stretto a due centesimi, una run reale ha fatto quattro chiamate al modello e la quinta è stata rifiutata prima di essere piazzata, e il motore delle policy legge la spesa registrata della run lato server invece di fidarsi di un numero fornito dal client. Il workflow non deve nulla di tutto questo, perché le sue due chiamate all'LLM riempiono caselle in una catena la cui forma è stata fissata quando il codice è stato scritto.
Da leggere dopo
 AI Agents
La mia AI mi conosce alla perfezione. Non ha idea di cosa voglio
Ho dato a un modello di frontiera un registro d'esempio di 90 giorni costruito sulle mie abitudini reali, e poi ho reso stasera diversa dal registro. 180 run valutate dopo: la memoria non acceca il modello quando l'indizio è nella stanza, il vero prodotto della memoria è il silenzio nelle serate ordinarie — e l'unica volta che mi serviva una domanda, l'assistente che sapeva tutto ha premuto play proprio sull'episodio che stavo evitando, e mi ha offerto un tè per l'occasione. AI
Jev risponde in probabilità. La domanda è ancora tua.
Jev di TypeSafe non scriverà una frase. Gli consegni uno stato e delle domande tipizzate, e lui ti restituisce una scelta, un punteggio o una probabilità sì/no, a quattro millesimi di centesimo per una decisione su mille token. La novità è la forma, che rimette l'autorità nel tuo codice, e la trappola è che una probabilità somiglia a una rivalsa e non lo è. Ho fatto partire il progetto pilota che vorrei prima di credere a qualsiasi numero, sui miei stessi saggi con il modello aperto che ha fatto le veci di Jev, e la risposta è stata no.