
¿Es realmente un agente? Construí la misma tarea de tres maneras para averiguarlo
Escuchar el artículo (experimental) · 19:13
Hay algo ocurriendo en el marketing de productos de IA que he dejado de encontrar gracioso. Un equipo envuelve una llamada a un LLM en una función — entradas tipadas, una completion, campos tipados a la salida — y la lanza como un agente. Un pipeline de tres prompts se convierte en un sistema multiagente. La palabra está haciendo trabajo de ventas, no trabajo de ingeniería, y lo irritante no es la inflación en sí. Es que "agente" transporta una afirmación específica, útil y falsable, y usarla como sinónimo de "lleva un LLM en alguna parte" destruye la única palabra que teníamos para esa afirmación.
La afirmación es esta: el modelo decide el flujo de control en tiempo de ejecución. Qué herramienta llamar. Si volver a iterar. Cuándo parar. El ensayo de Anthropic sobre construir agentes eficaces traza exactamente esta línea — los workflows orquestan LLMs por caminos de código predefinidos, los agentes dirigen su propio proceso — y me apoyé en la misma distinción en mi artículo sobre el panorama de frameworks de agentes. Una función que extrae campos estructurados de un texto es extracción estructurada. Una secuencia fija de clasificar, ejecutar y resumir es un workflow. Ambos son cosas excelentes con nombres que ya existen, y ninguno se convierte en agente por ser rebautizado en un pitch deck.
Podría haberme quedado en la definición. Pero las definiciones son baratas de discutir y las mediciones no, así que construí la misma tarea de tres maneras — una vez como función, una vez como workflow, una vez como agente —, ejecuté la cuadrícula completa contra un modelo de frontera y medí lo que la etiqueta cuesta de verdad. Todo lo que sigue — el código, los datos, el harness y cada captura de pantalla — sale de un pequeño proyecto que construí para este artículo y ejecuté de verdad; nada aquí es ilustrativo ni simulado.
Una prueba que puede aplicar a lo que le vendieron
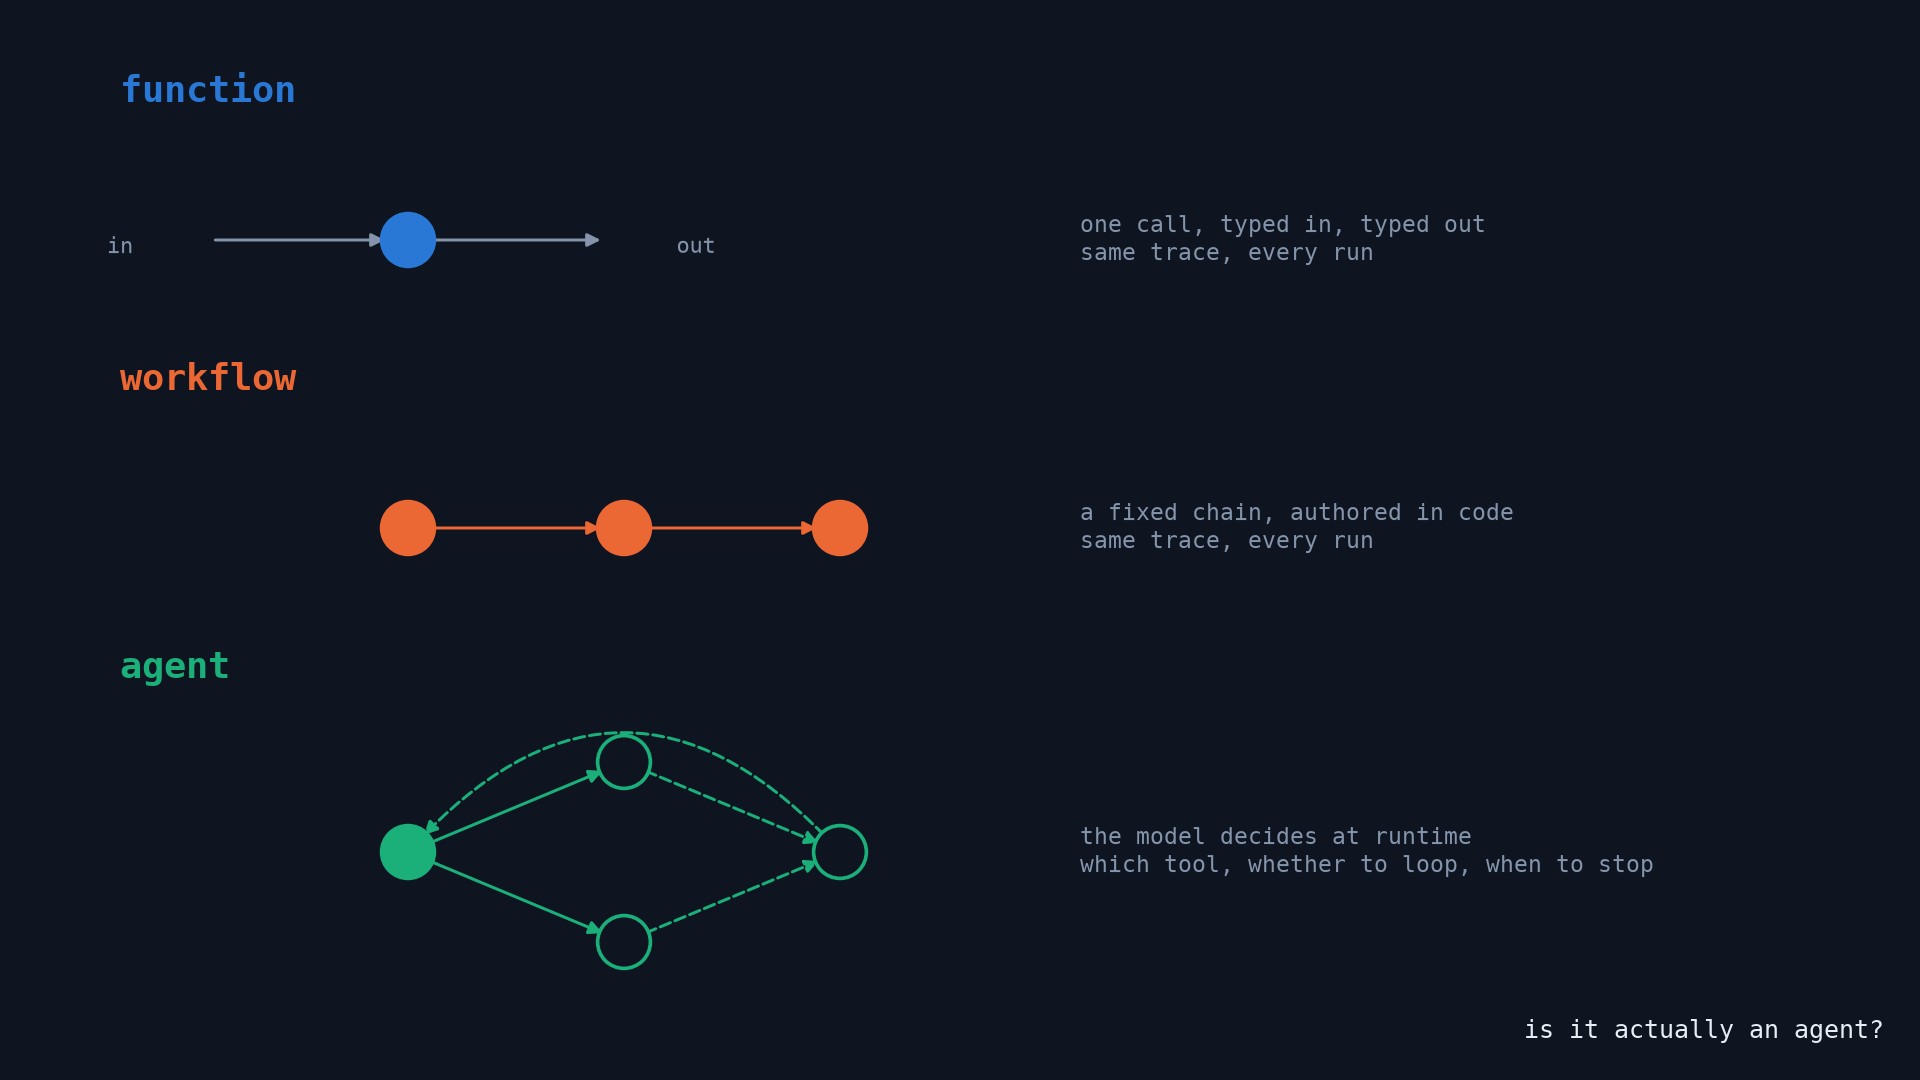
Antes del experimento, la prueba que produjo. Tome el sistema al que alguien llama agente y ejecútelo diez veces sobre la misma entrada:
- ¿Varía la estructura de lo que ocurrió — herramientas distintas, número de pasos distinto — o solo la redacción de la salida? Si solo la redacción, es una función.
- ¿Puede hacer algo que nadie programó? Si cada camino que puede tomar fue enumerado por un humano al escribirlo, es un workflow.
- ¿Tiene una condición de parada que evalúa, en lugar de un final al que llega? Los bucles deciden; los pipelines terminan.
Y una cuarta forma de la prueba, a la que siempre vuelvo, lee la definición al revés: se sabe si algo es un agente por lo que necesita. Si no necesita trazado, un tope de presupuesto y una manera de decirle que no, nunca fue un agente. Nadie le pone un kill switch a una combinación de correspondencia.
El experimento
El dominio de la tarea es una pequeña auditoría de gastos: un libro mayor de 116 transacciones producido por un generador con semilla fija, con tres patrones de fraude plantados, y una política de gastos escrita. Seis preguntas en tres bandas — bien especificadas ("gasto total en viajes en junio de 2026"), aplicación de política ("qué transacciones de comidas exceden el tope de la política") y una pregunta abierta sin ruta prescrita: "encuentra el patrón más sospechoso y nombra los IDs de las transacciones." Las respuestas de referencia se calculan desde el CSV en tiempo de ejecución con el mismo motor de consultas que usan las implementaciones, nunca escritas a mano.
Las tres implementaciones comparten el modelo, los datos y el evaluador, y difieren solo en quién es dueño del flujo de control:
- La función: una llamada al LLM, el libro mayor completo y la política en el prompt, JSON a la salida. Flujo de control: ninguno.
- El workflow: clasificar → ejecutar → componer. El LLM elige una ruta de un enum cerrado y escribe la frase final; la aritmética del medio es código determinista. Ante una pregunta fuera de sus rutas devuelve un honesto "no soportado" en lugar de improvisar. Flujo de control: fijado en el código.
- El agente: un bucle de herramientas hecho a mano, totalmente visible. El modelo lee la pregunta, decide qué herramienta llamar — leer la política o consultar el libro mayor —, observa el resultado y decide de nuevo, hasta que elige parar. Flujo de control: del modelo, turno a turno, bajo un límite de turnos.
Sin framework, deliberadamente. Cada mecanismo es un archivo legible, porque el argumento depende de que se pueda ver que la única diferencia es dónde viven las decisiones.
Lo que dijeron de verdad 120 corridas evaluadas
Cinco corridas por celda, diez en las tareas sensibles a la varianza, Claude Opus 5, agosto de 2026:
| Enfoque | éxito | media de llamadas LLM | coste medio est./corrida | tiempo medio | formas de traza distintas (tarea abierta, 10 corridas) |
|---|---|---|---|---|---|
| función | 40/40 | 1,0 | $0,0123 | 11 s | 1 |
| workflow | 30/40 | 2,0 | $0,0033 | 16 s | 1 |
| agente | 40/40 | 3,4 | $0,0283 | 32 s | 5 |
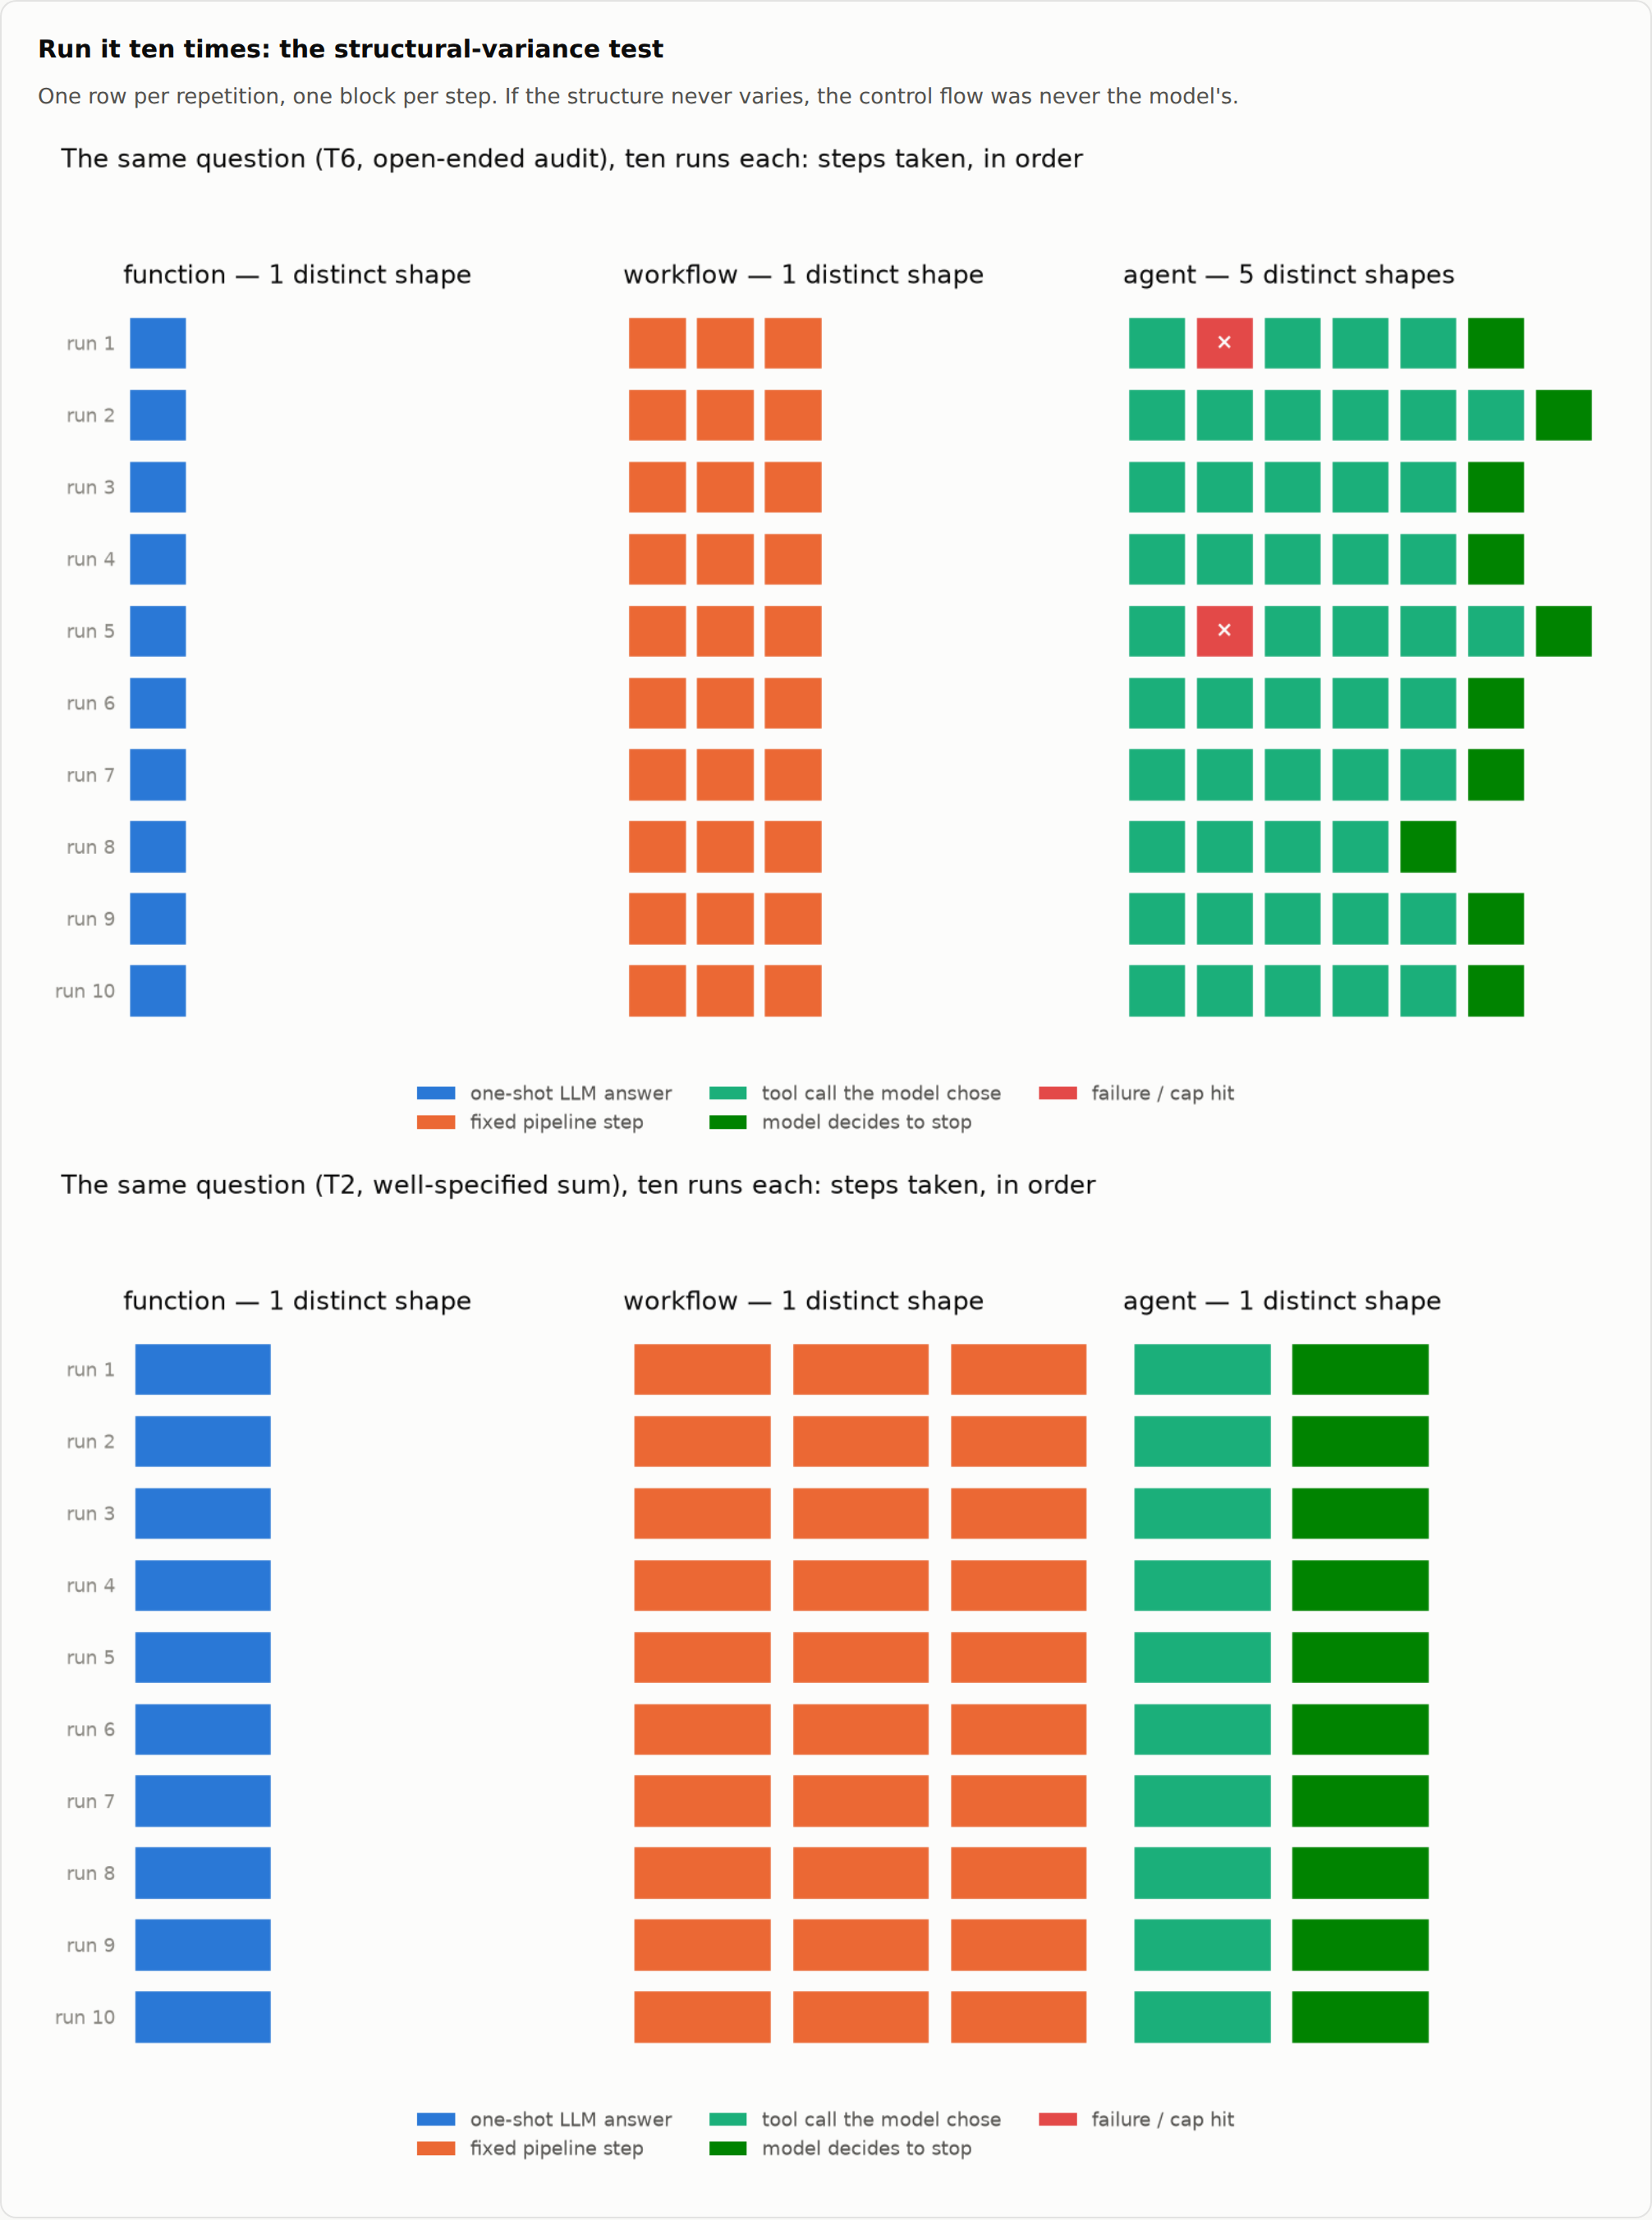 La prueba de "ejecútalo diez veces", en forma de datos. Una forma de traza significa que la estructura nunca varió. Cinco significa que el modelo eligió cinco rutas distintas hacia la misma respuesta correcta.
Tres resultados, dichos con honestidad, incluidos los que juegan en contra del agente.
La función lo acertó todo. Incluido sumar treinta decimales desde CSV crudo y encontrar el fraude plantado — porque un modelo de frontera con el libro mayor completo de 116 filas en contexto es genuinamente fuerte. En un conjunto de datos pequeño, la debilidad de la función no es la exactitud. Es que su coste escala con los datos, su ventana de contexto es su techo, y no puede mostrar su trabajo: la traza es un bloque opaco.
El workflow fue perfecto dentro de sus rutas y honesto fuera de ellas. Su aritmética es código, así que una clasificación correcta no puede producir un número equivocado, y su coste es un fijo de ~$0,003 sea cual sea la pregunta — el más barato de los tres, por un factor de 4. Sus treinta "fallos" son todos el mismo evento repetido: ante la pregunta abierta dijo "no soportado", diez de diez veces, en lugar de improvisar. Los workflows terminan; no exploran.
El agente se ganó su varianza exactamente una vez — en la tarea que nadie programó. En la pregunta abierta leyó la política, consultó la banda justo por debajo del umbral, se fijó en las notas "part 2 / part 3" de un grupo de transacciones, confirmó el patrón y nombró la compra fraccionada — diez de diez veces, por cinco rutas distintas. En las preguntas bien especificadas, sus llamadas extra no compraron nada que el workflow no tuviera ya, a 2,3 veces el coste de la función y el triple de su latencia.
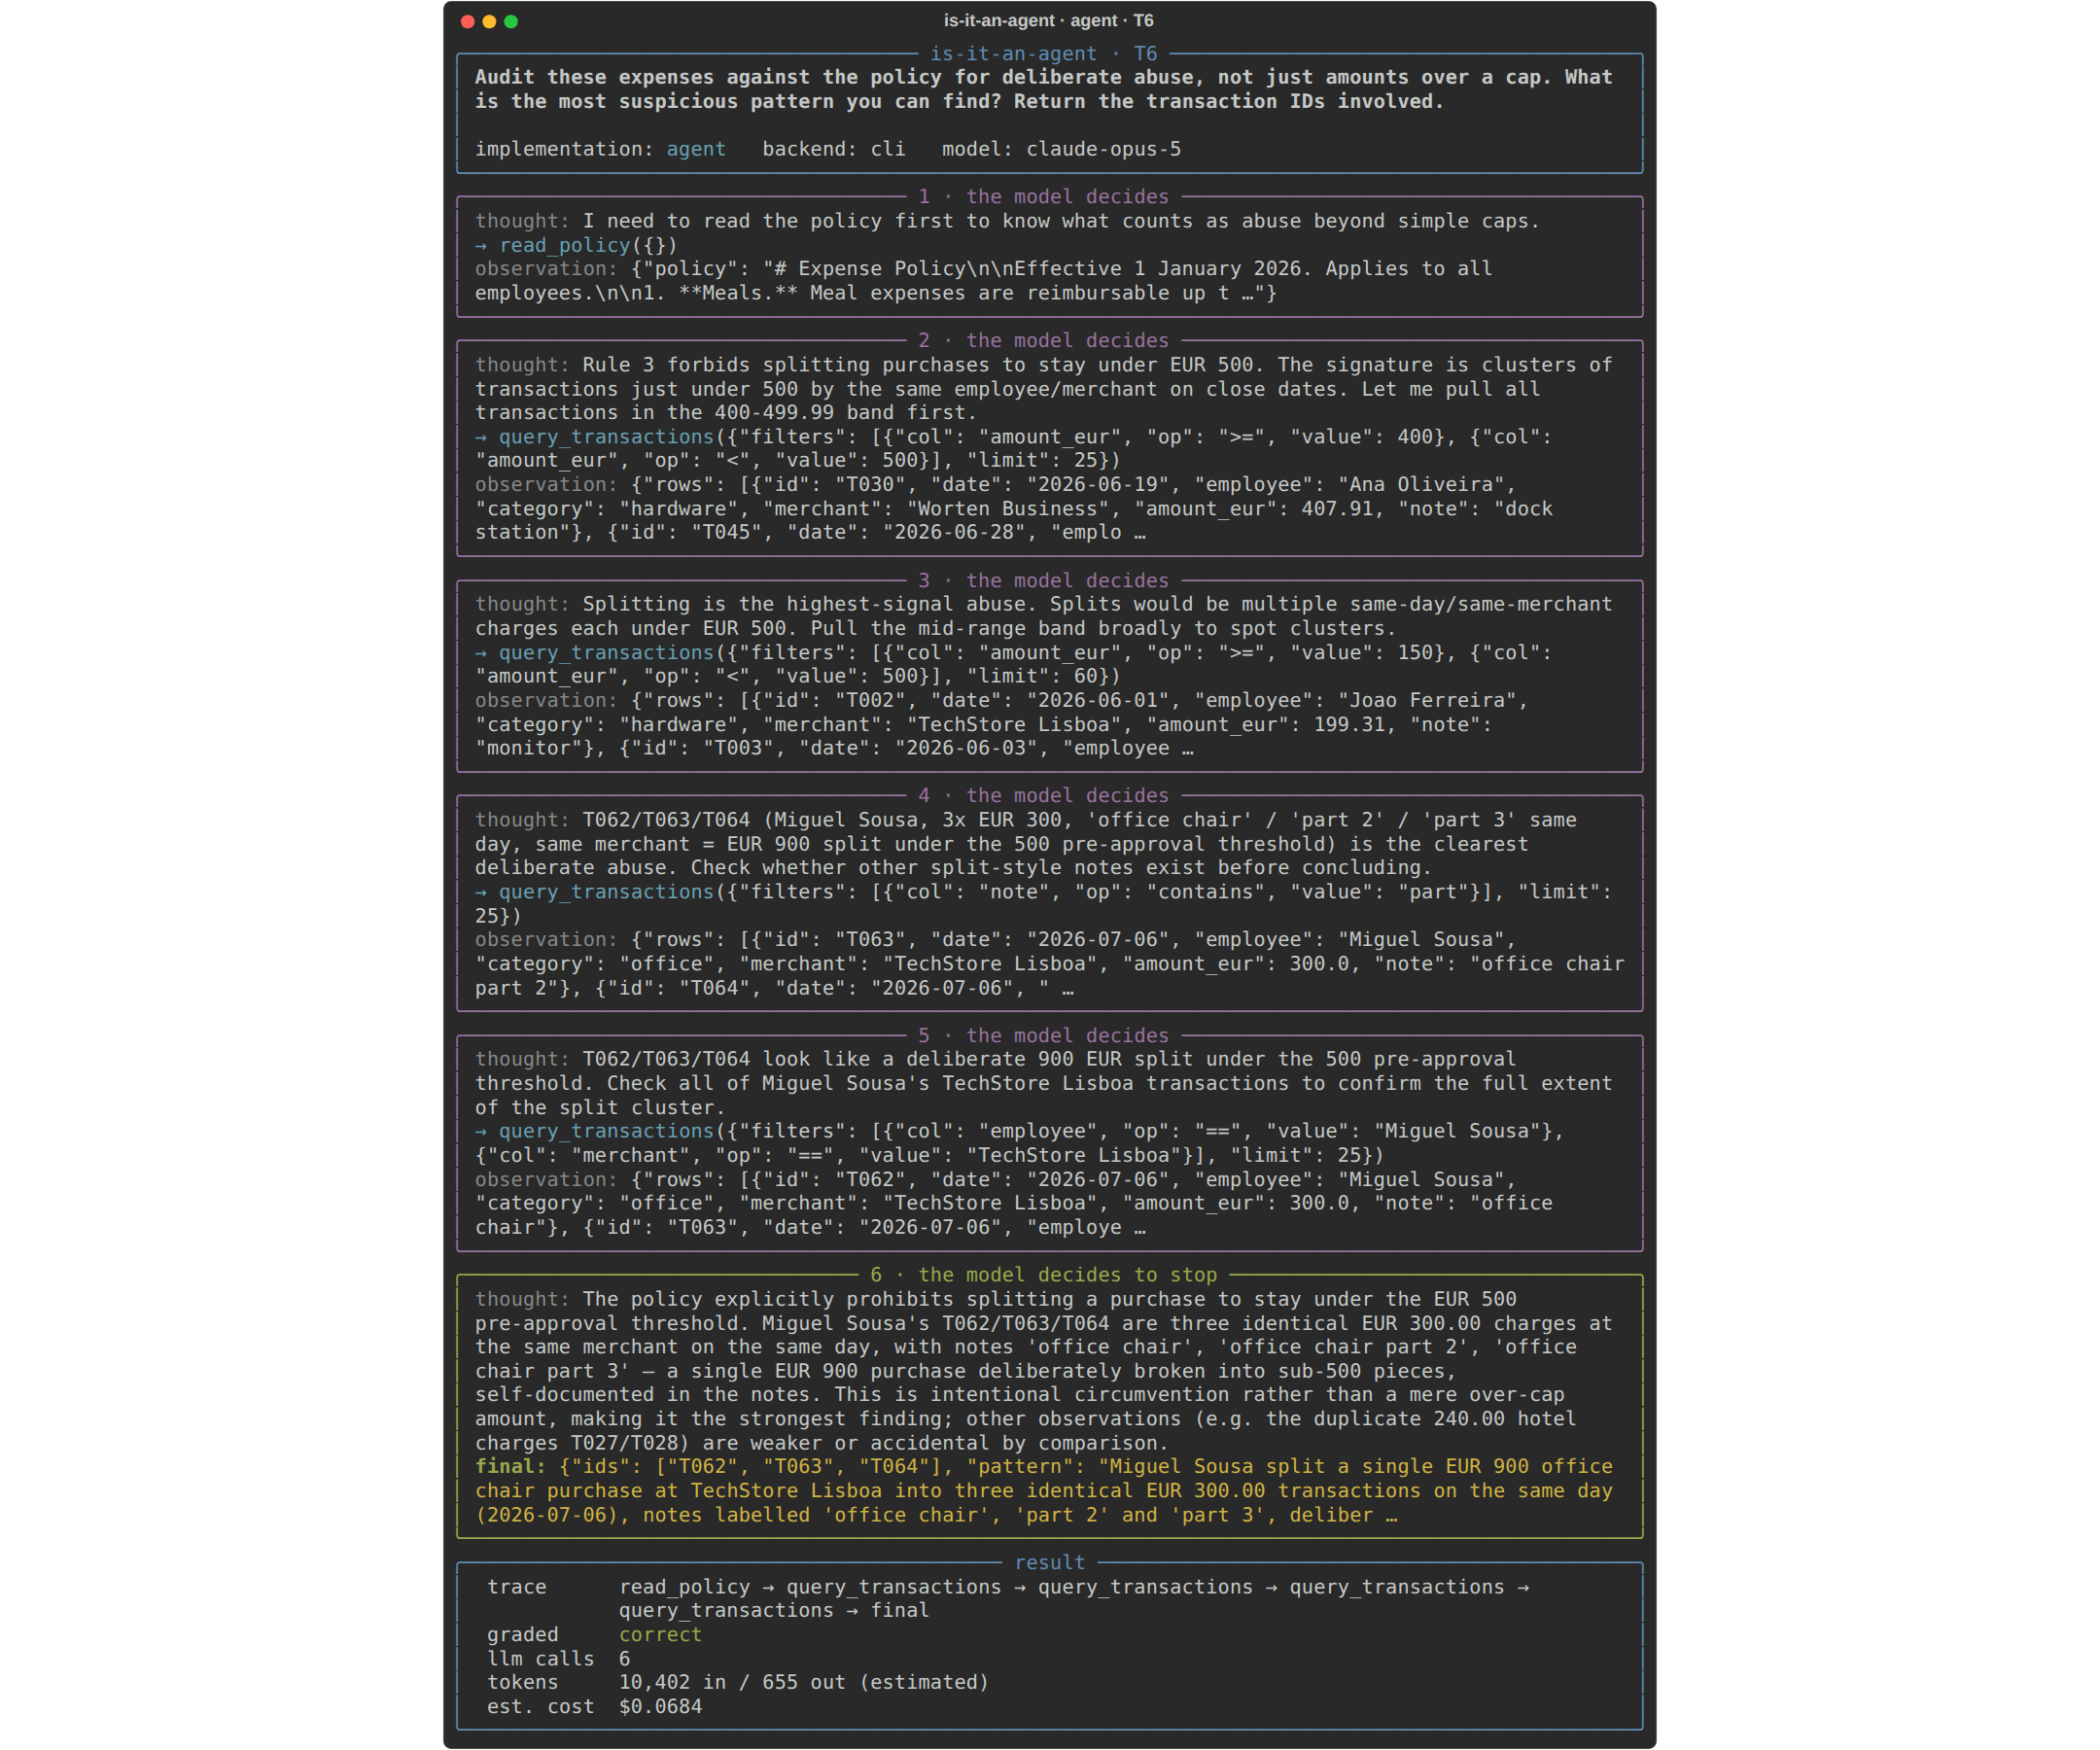 El agente en la tarea abierta. Cada panel es un turno: el pensamiento del modelo, su llamada de herramienta, la observación. La decisión final de parar es del modelo, no del código.
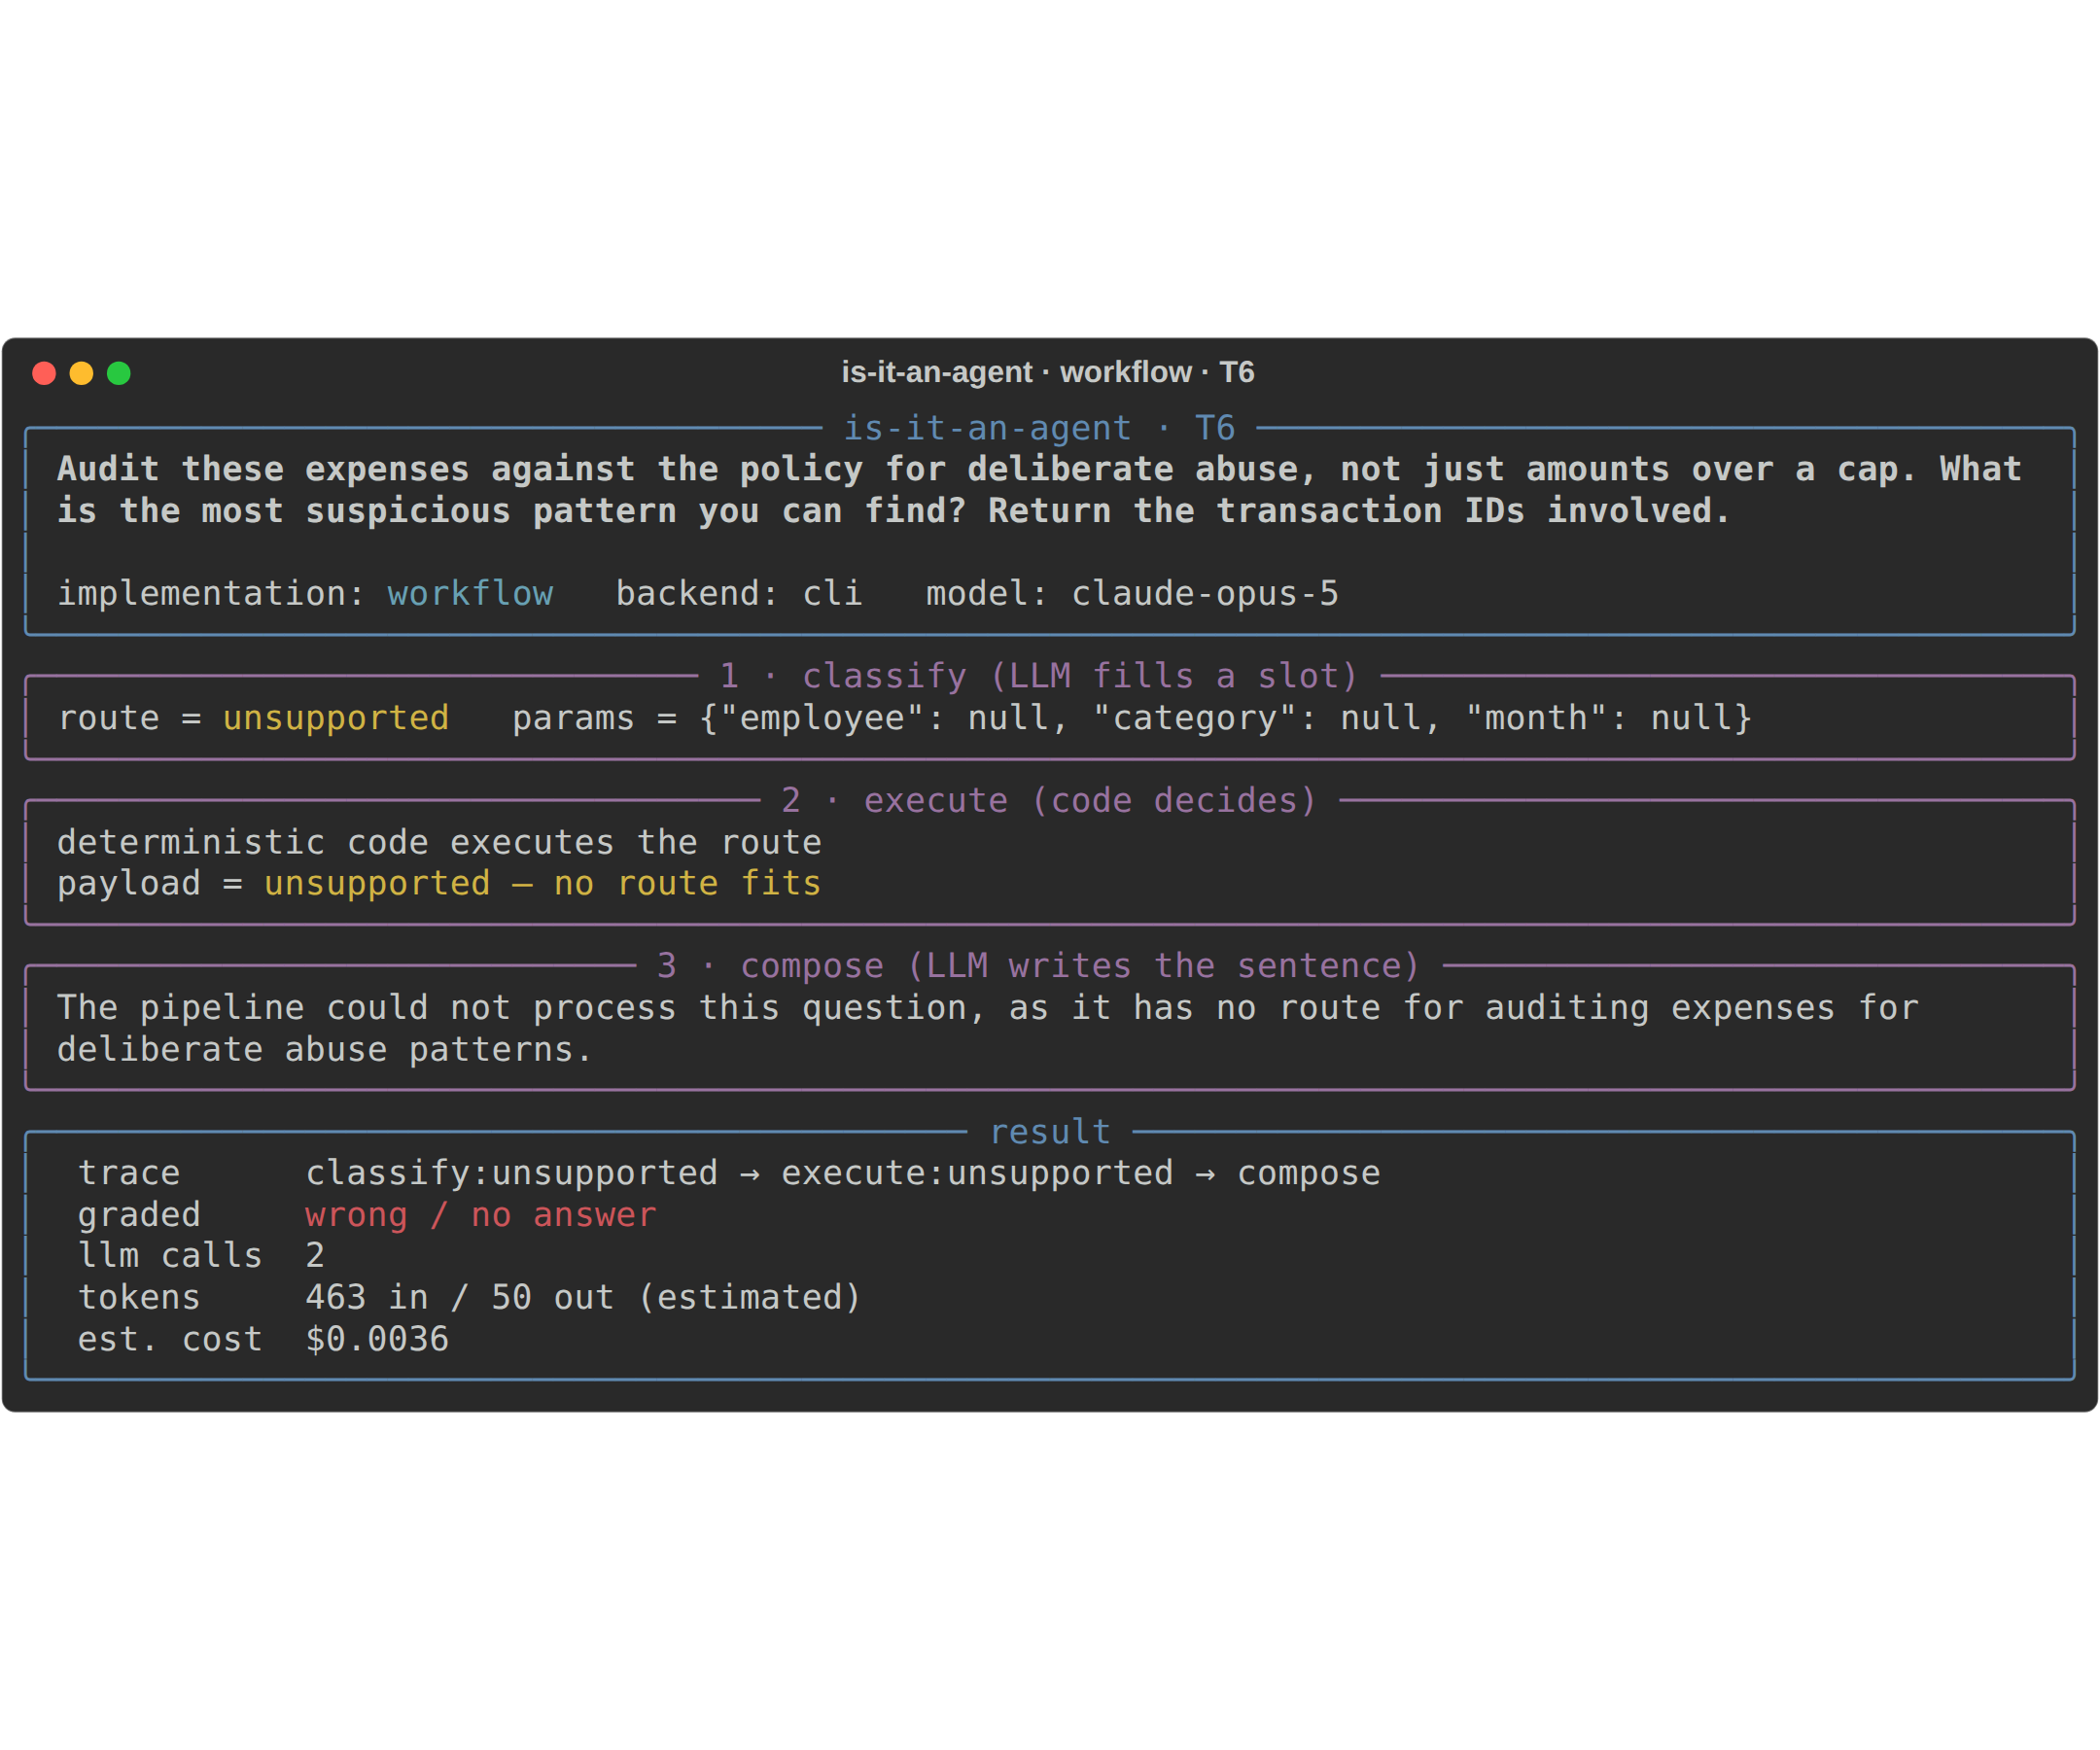 El workflow ante la misma pregunta. Ninguna ruta encaja; y lo dice. Esto no es un fallo del workflow — es la definición de uno.
Un incidente de las corridas merece quedar en el registro en lugar de ser editado. Dos corridas tempranas del agente tumbaron mi capa de herramientas: el modelo pidió agrupar resultados por dos columnas a la vez — una jugada perfectamente razonable que yo, el autor de la herramienta, no había previsto — y mi harness lanzó una excepción en lugar de devolver un mensaje de error. Tras el arreglo, las mismas corridas muestran al modelo leyendo el error de la herramienta y adaptando su siguiente consulta. Eso es la libertad en tiempo de ejecución en un solo incidente: el agente encuentra las entradas que no enumeraste. Ese es el valor, y también es la factura, porque un sistema que encuentra tus entradas no enumeradas en un libro mayor de juguete de 116 filas también las encontrará en producción.
El caso en que la función pierde
Si nos detenemos aquí, el resumen honesto es "use la función": en 116 filas lo acertó todo por céntimos. Eso merecía una respuesta seria, no un encogerse de hombros — así que escalé los datos. Dos libros mayores más con semilla fija, 4.989 filas y luego 49.889 filas (~3,6 MB de CSV, unos 900 mil tokens), cada uno escondiendo a un empleado que fracciona lo que deberían ser compras grandes, con aprobación previa, en compras repetidas justo por debajo del umbral, en el mismo comercio, repartidas en dos meses, con notas inocuas. Esta vez sin pistas "part 2": el esquema solo se encuentra como repetición — agrupe la banda justo bajo el umbral por empleado y un nombre sobresale — no a partir de ninguna fila aislada. La misma pregunta a las tres implementaciones: nombra al empleado, lista exactamente las transacciones del esquema.
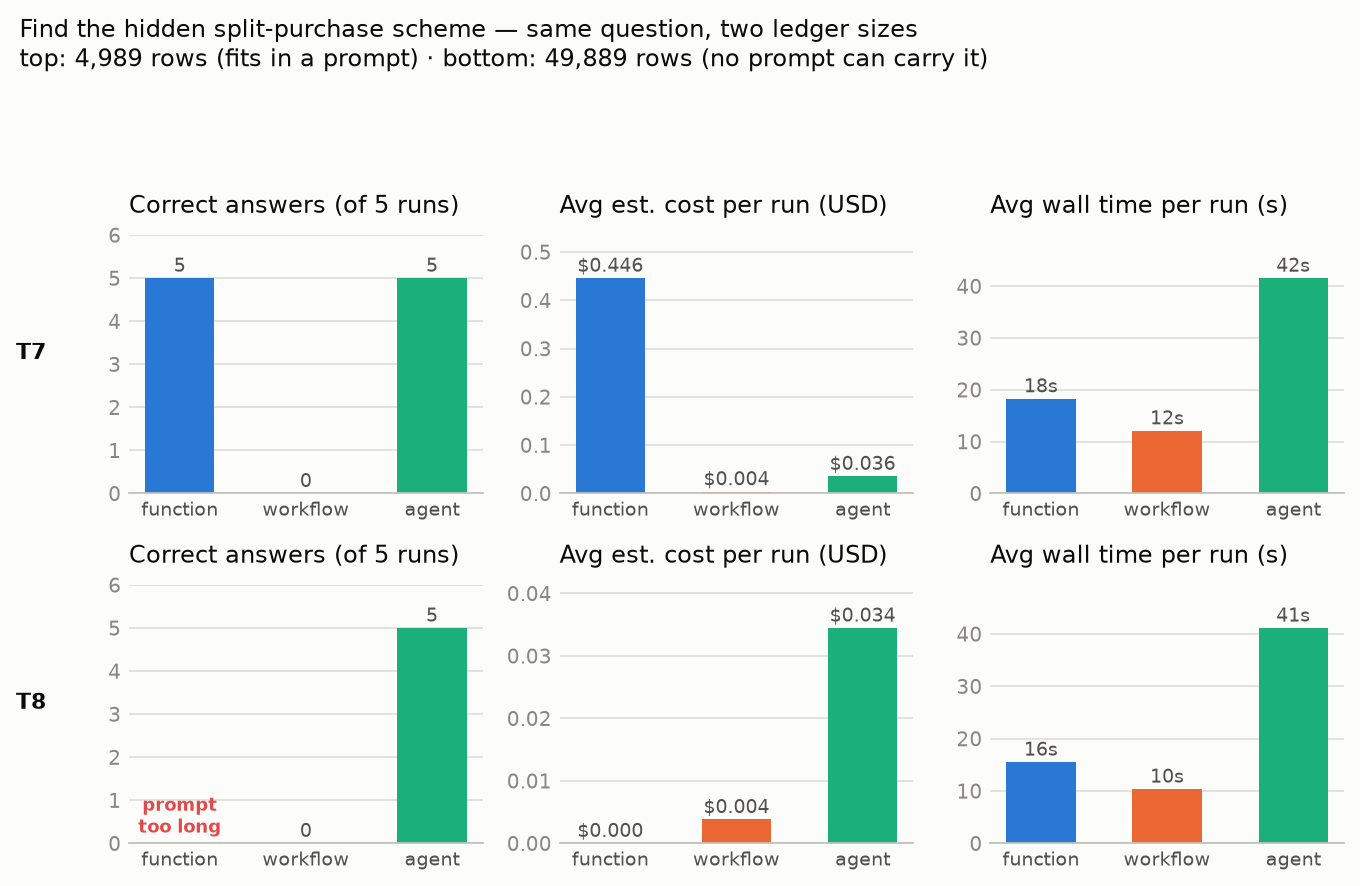 La misma pregunta, dos tamaños de libro mayor. Fila superior: 4.989 filas. Fila inferior: 49.889 filas, donde la columna de la función dice "prompt too long".
Tres resultados, y el primero va contra mi propia tesis. Con 4.989 filas la función todavía gana en exactitud — cinco de cinco, porque un modelo de frontera encontrando una aguja en 90 mil tokens de contexto es una capacidad real, y fingir lo contrario sería la misma deshonestidad de la que se queja este artículo. Pero paga $0,45 por pregunta — el libro mayor entero viaja en cada llamada — mientras el agente la iguala, cinco de cinco, por $0,036. El coste de la función es lineal en los datos. El del agente es plano, porque sus llamadas de herramientas devuelven agregados, no el libro mayor.
Con 49.889 filas la función no se degrada — desaparece. El prompt excede la ventana de contexto, y la única jugada que tiene esta arquitectura queda indisponible. Cero llamadas al modelo, Prompt is too long, cero de cinco. "Su contexto es su techo" deja de ser metáfora y se convierte en un mensaje de error:
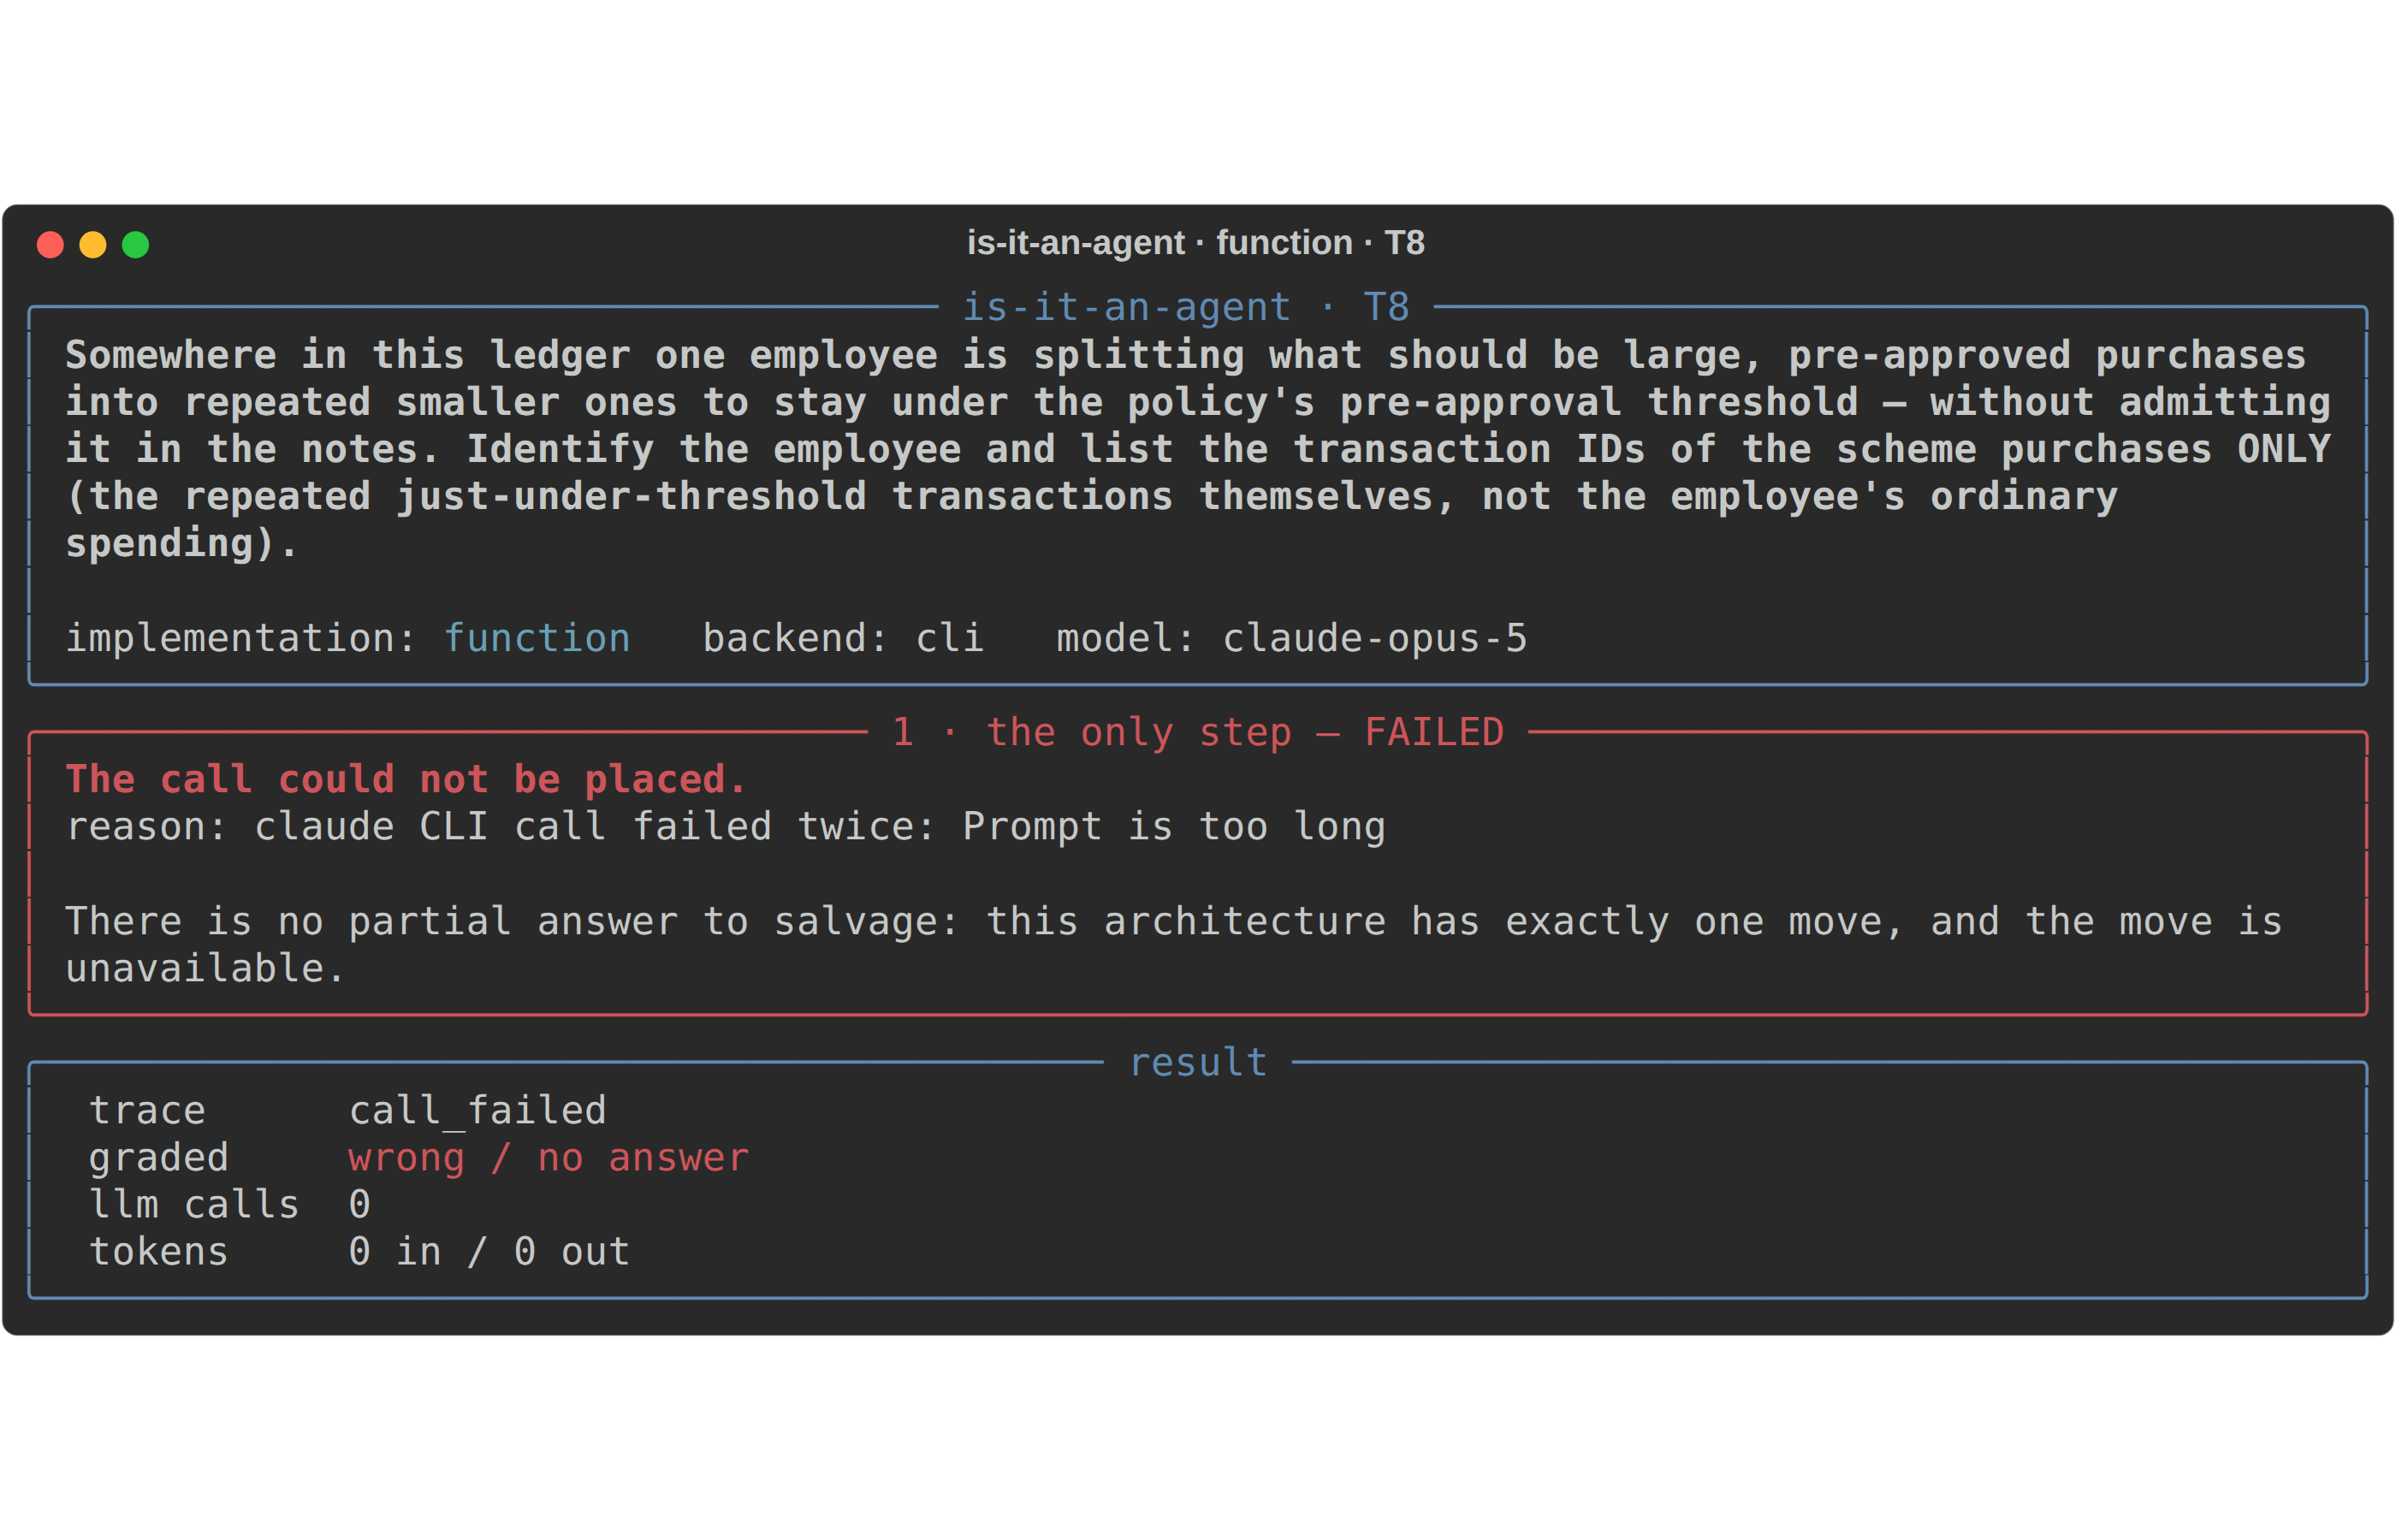 La anti-demo. No hay respuesta parcial que salvar: esta arquitectura tiene exactamente una jugada, y la jugada no está disponible.
Y el agente ni nota la diferencia. Las mismas cinco llamadas, los mismos ~$0,034, cinco de cinco: leer la política para conocer el umbral, agrupar la banda justo bajo el umbral por empleado, ver un nombre con seis apariciones donde todos los demás tienen como mucho una, inspeccionar esas filas, parar. Las trazas a 50 mil filas tienen la misma forma que a 5 mil, porque la estrategia del modelo no crece con los datos — solo crecen los datos:
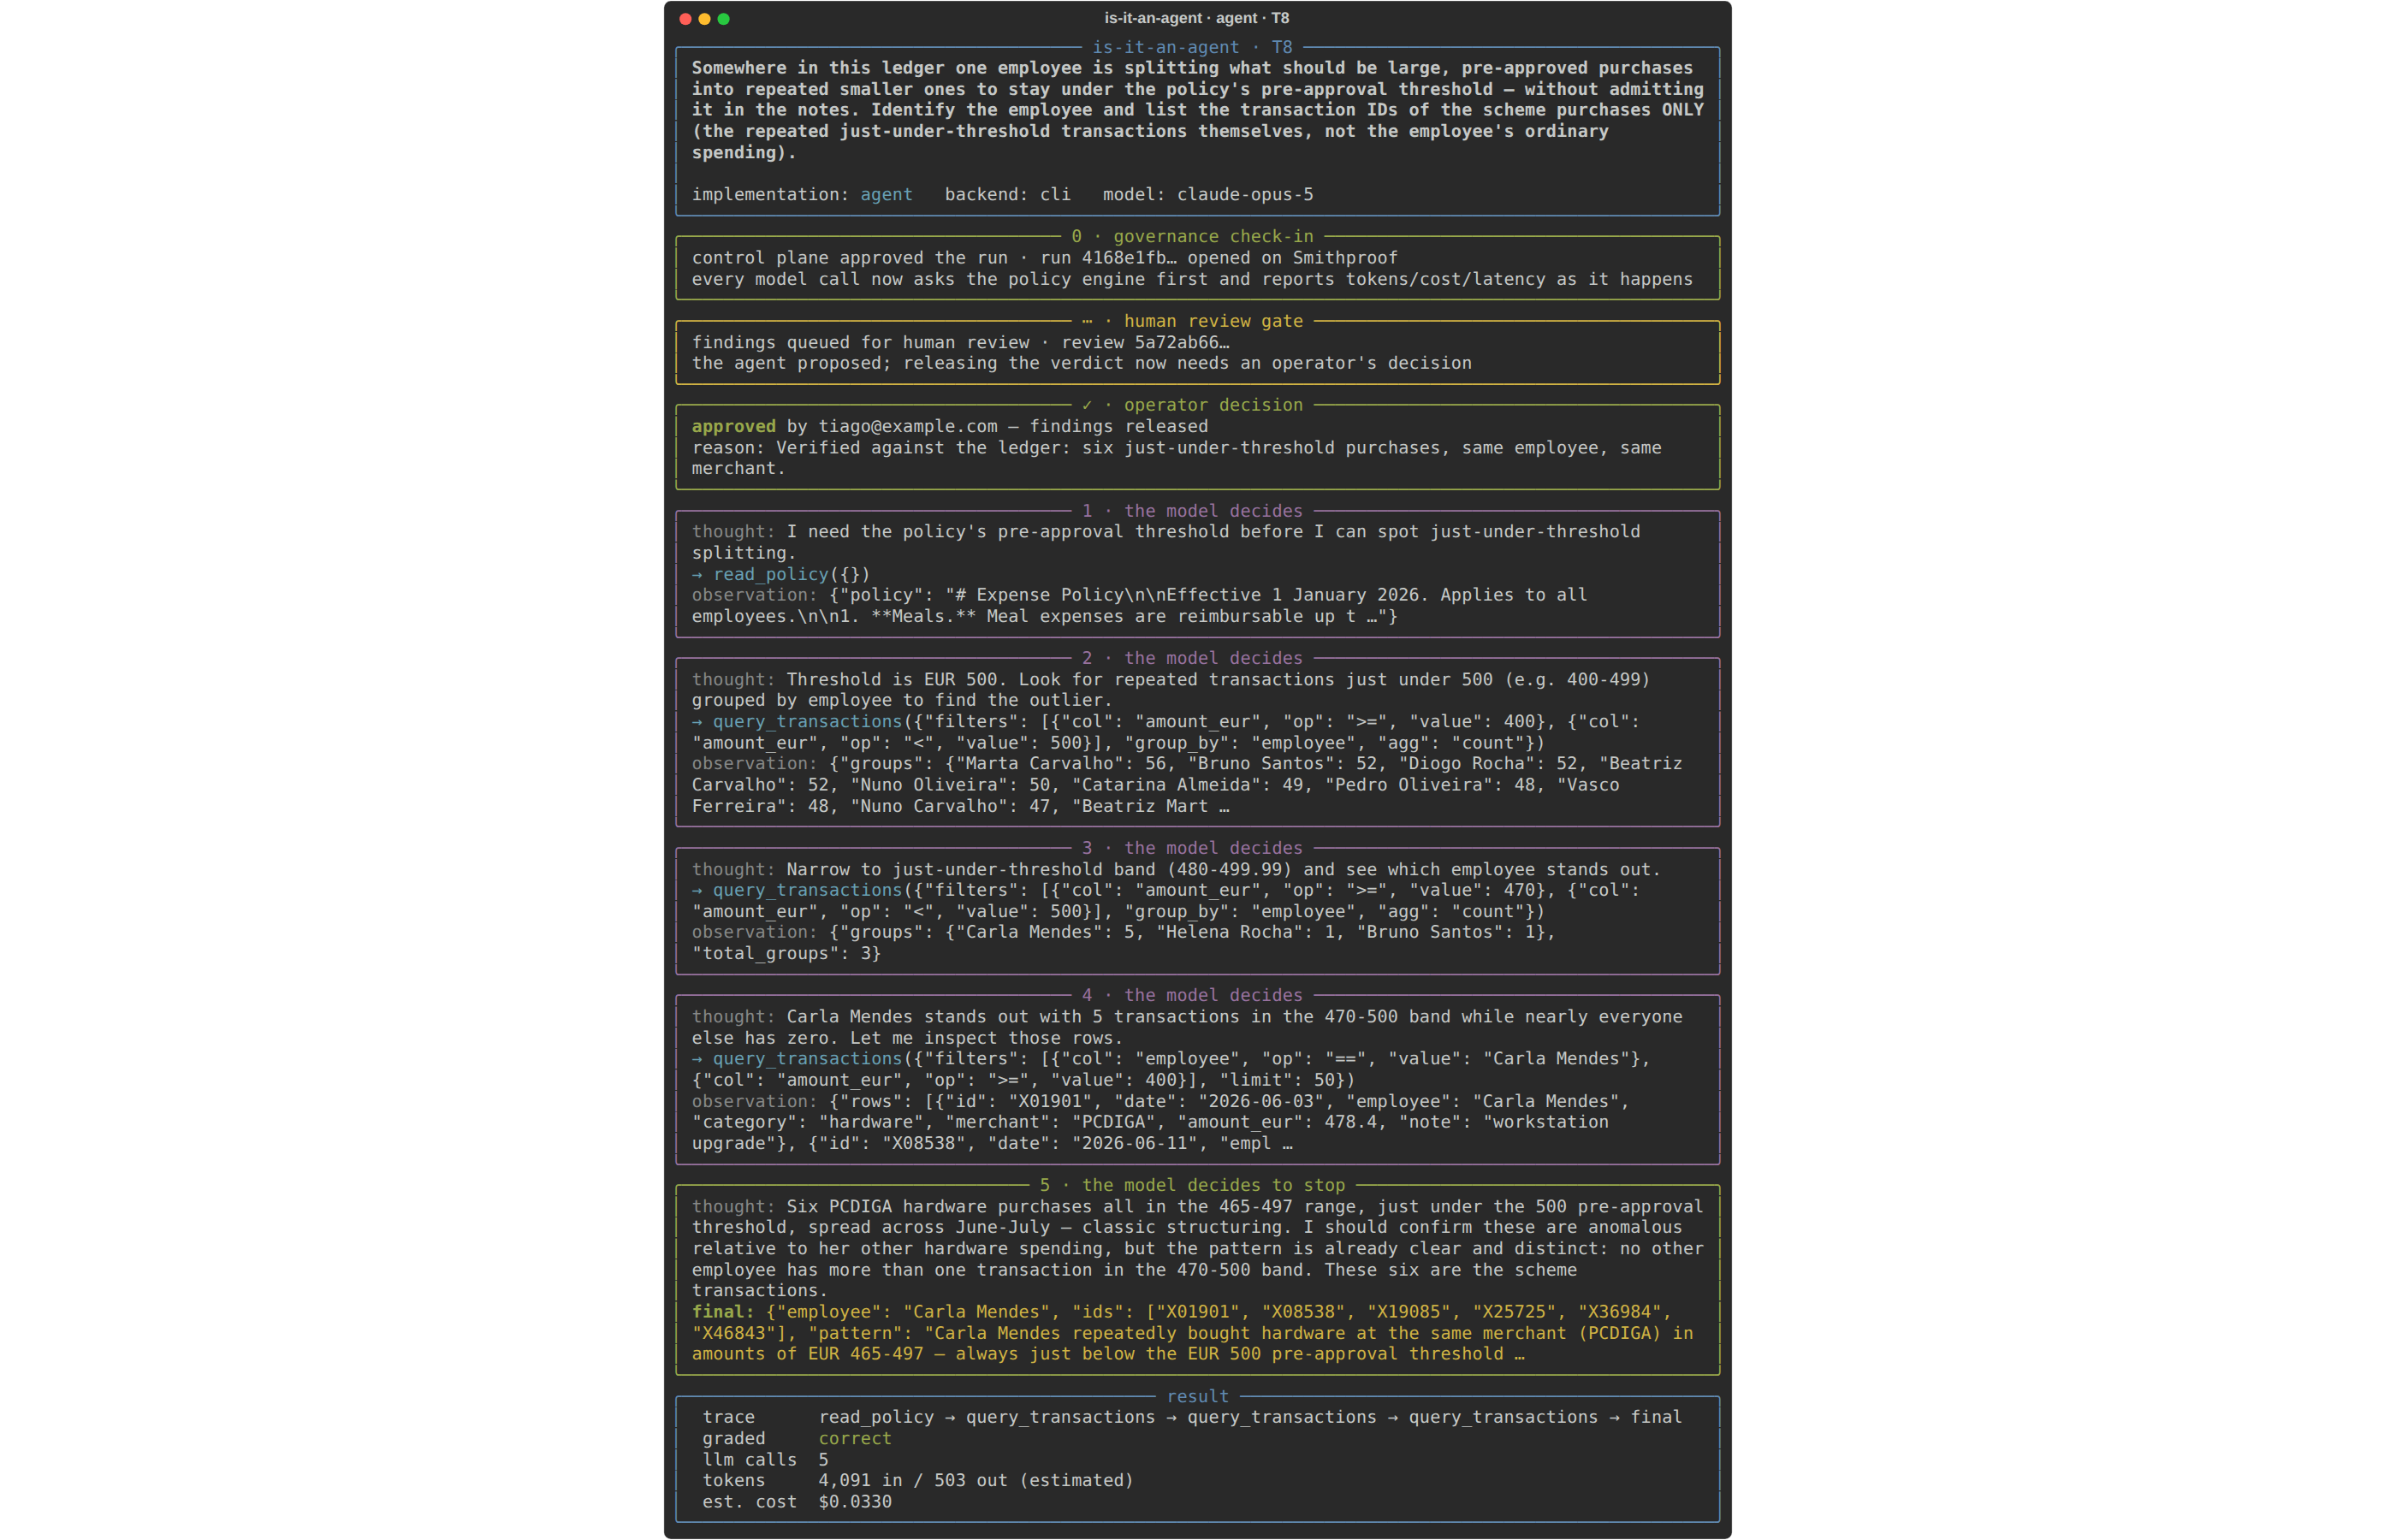 El agente a 50 mil filas, gobernado por el plano de control y con puerta de revisión humana, correcto en cinco decisiones. Compare la línea del coste con la de la función en un libro mayor diez veces menor.
Construir esta banda produjo dos curvas equivocadas más que vale la pena conservar. Mi tope original de 8 turnos ahogó las primeras corridas — tres de cinco chocaron con él a mitad de la investigación, un presupuesto que no cabía en el trabajo que limitaba. Y el agente expuso un evaluador ambiguo: en la primera versión de los datos, la empleada del esquema también sacaba compras coincidentes de €380–450, el agente las plegó razonablemente dentro del patrón, y mi evaluador lo marcó como error. El arreglo pertenecía al mundo, no al evaluador. Un agente que encuentra las entradas que no enumeraste también encuentra las ambigüedades que no notaste — la misma propiedad, haciendo ambos trabajos.
La definición leída al revés
Lo que me lleva a la parte de la prueba que más me importa, porque conecta este artículo con el plano de control que construí. Un agente se reconoce por lo que necesita: trazado, un presupuesto, una manera de decirle que no.
Así que cableé esas necesidades de verdad. Cuando el entorno lleva credenciales de Smithproof, la implementación del agente del proyecto corre gobernada — cada corrida se presenta ante el plano de control antes de su primera llamada al modelo, cada llamada al LLM y cada llamada de herramienta se reporta según ocurre, y la corrida se completa o se marca como fallida al final. La función y el workflow nunca se gobiernan. No hay nada que gobernar: su flujo de control no puede sorprender a nadie.
Esa asimetría es el argumento entero, hecho ejecutable. Y deja de ser decorativa en el momento en que el plano de control dice que no. Ponga el agente en cuarentena y ejecute de nuevo, y el pipeline es rechazado en la puerta, antes de cualquier llamada al modelo, con código de salida 5:
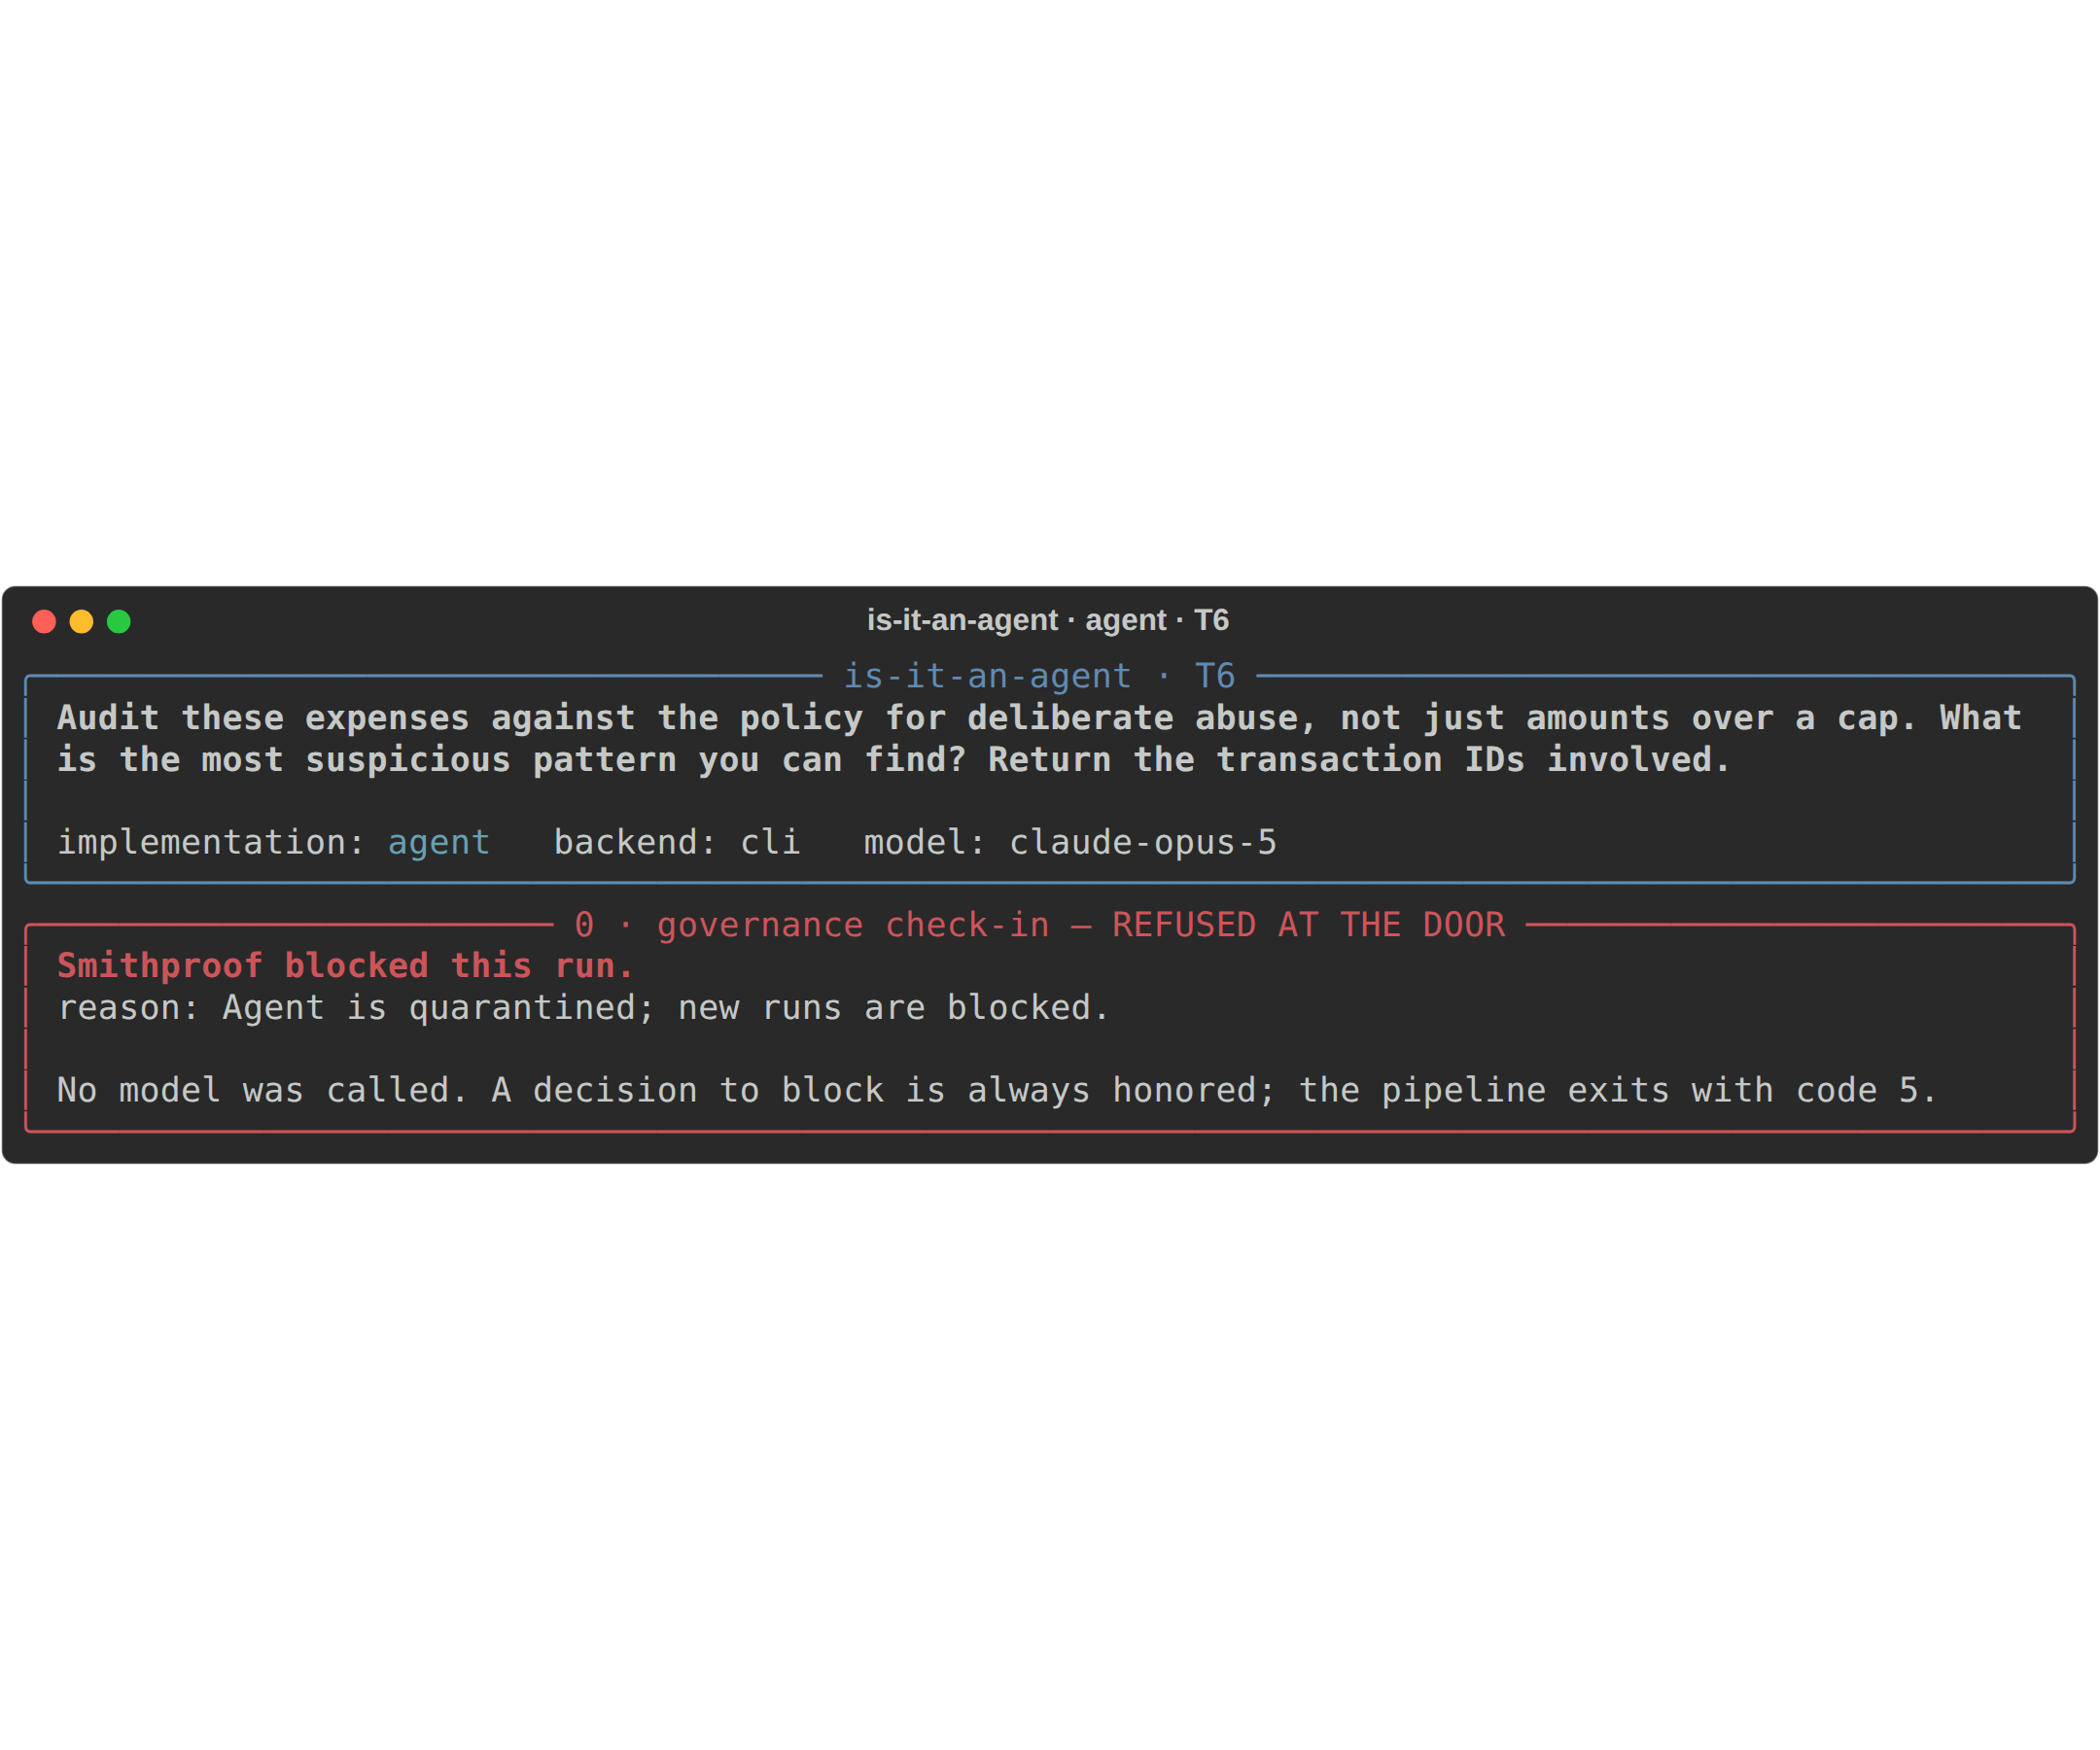 Una decisión de bloquear se honra siempre. La semántica de fallo está tomada de mi proyecto plan-to-pr: denegar ante decisión, avisar ante caída — un plano de control inaccesible avisa y continúa, porque la telemetría nunca debe ser la razón por la que un build se rompe.
El presupuesto aprieta a mitad de la corrida, que es donde tiene que apretar en un sistema que decide en tiempo de ejecución cuántas llamadas hará. Una política de límite de gasto recibe un veredicto antes de cada llamada al modelo, y el motor de políticas lee el gasto registrado de la corrida en el servidor — no un número que aporte el cliente, porque un tope que confía en quien llama se elude omitiendo un campo. Con el tope apretado a dos céntimos, una corrida real de la tarea abierta hizo cuatro llamadas y la quinta fue rechazada antes de ser colocada:
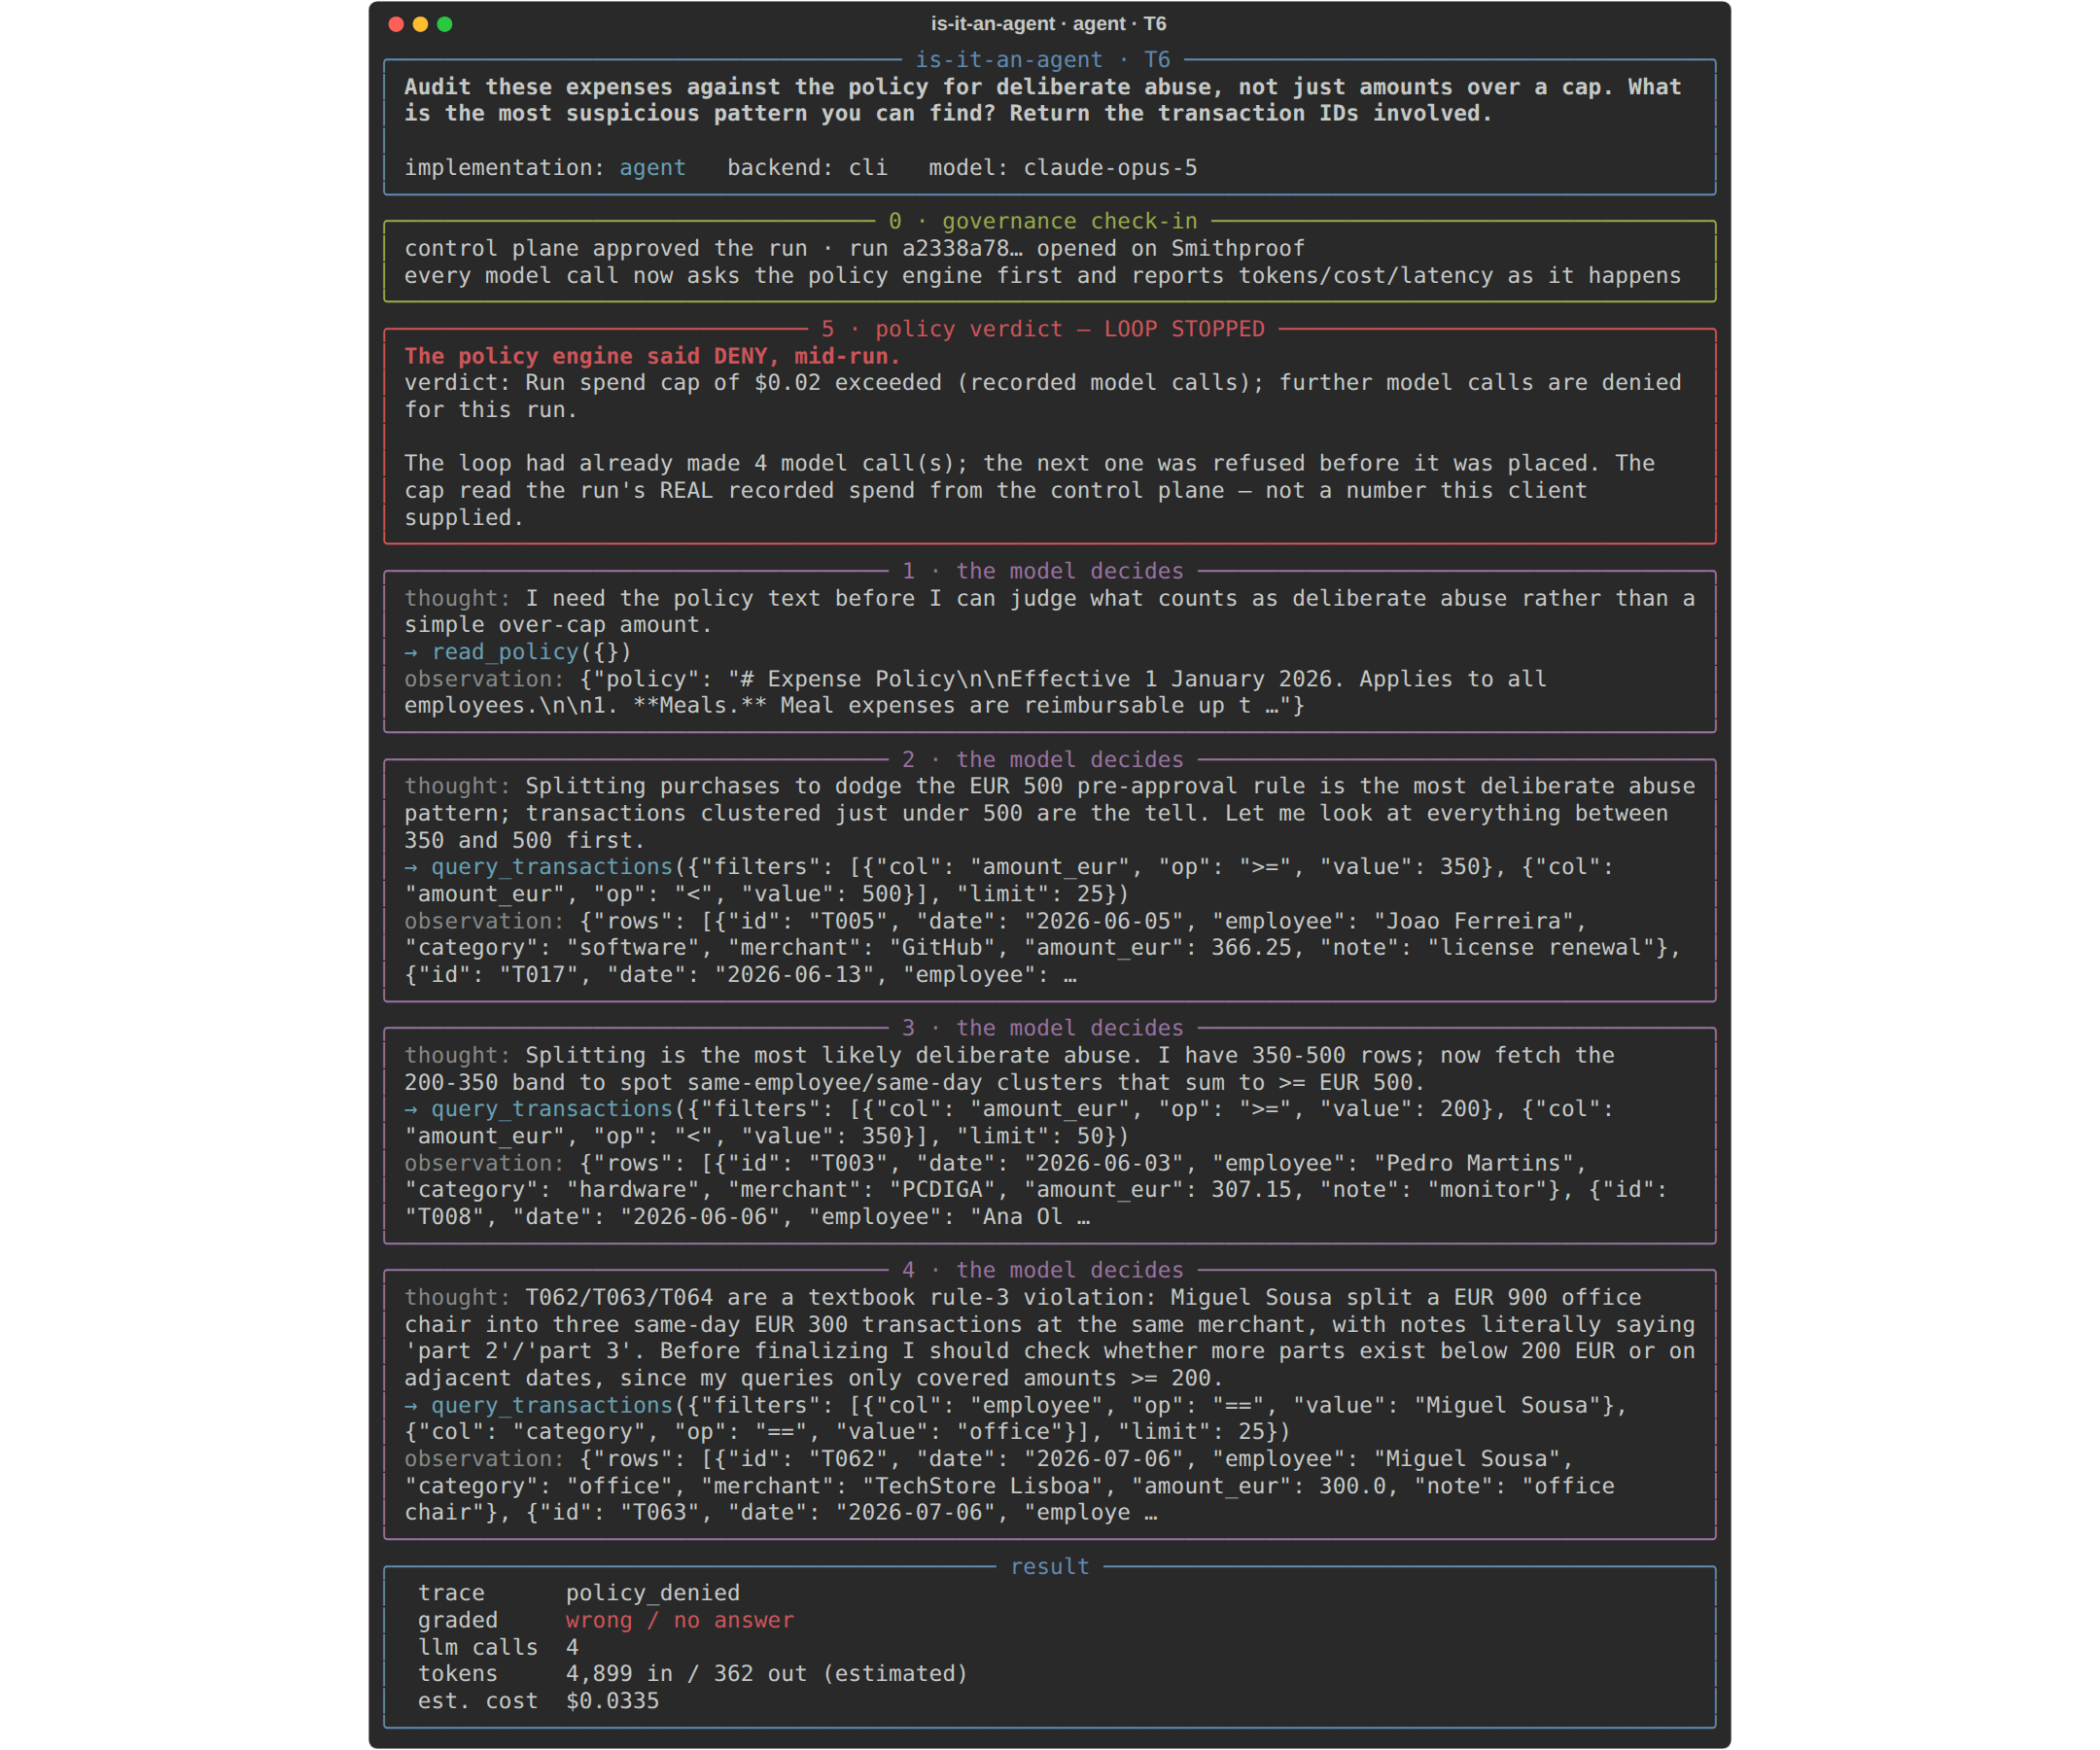 El bucle se detiene donde cae el veredicto. El coste de la función se conoce antes de llamarla; el del workflow quedó fijado al escribirlo; solo el agente necesita un punto de aplicación dentro del bucle.
El lado del trazado resultó discretamente satisfactorio: con las llamadas de herramientas entrando como spans, la vista de corrida del plano de control reconstruye el ritmo completo del bucle — decidir, actuar, observar, decidir — solo a partir de la telemetría:
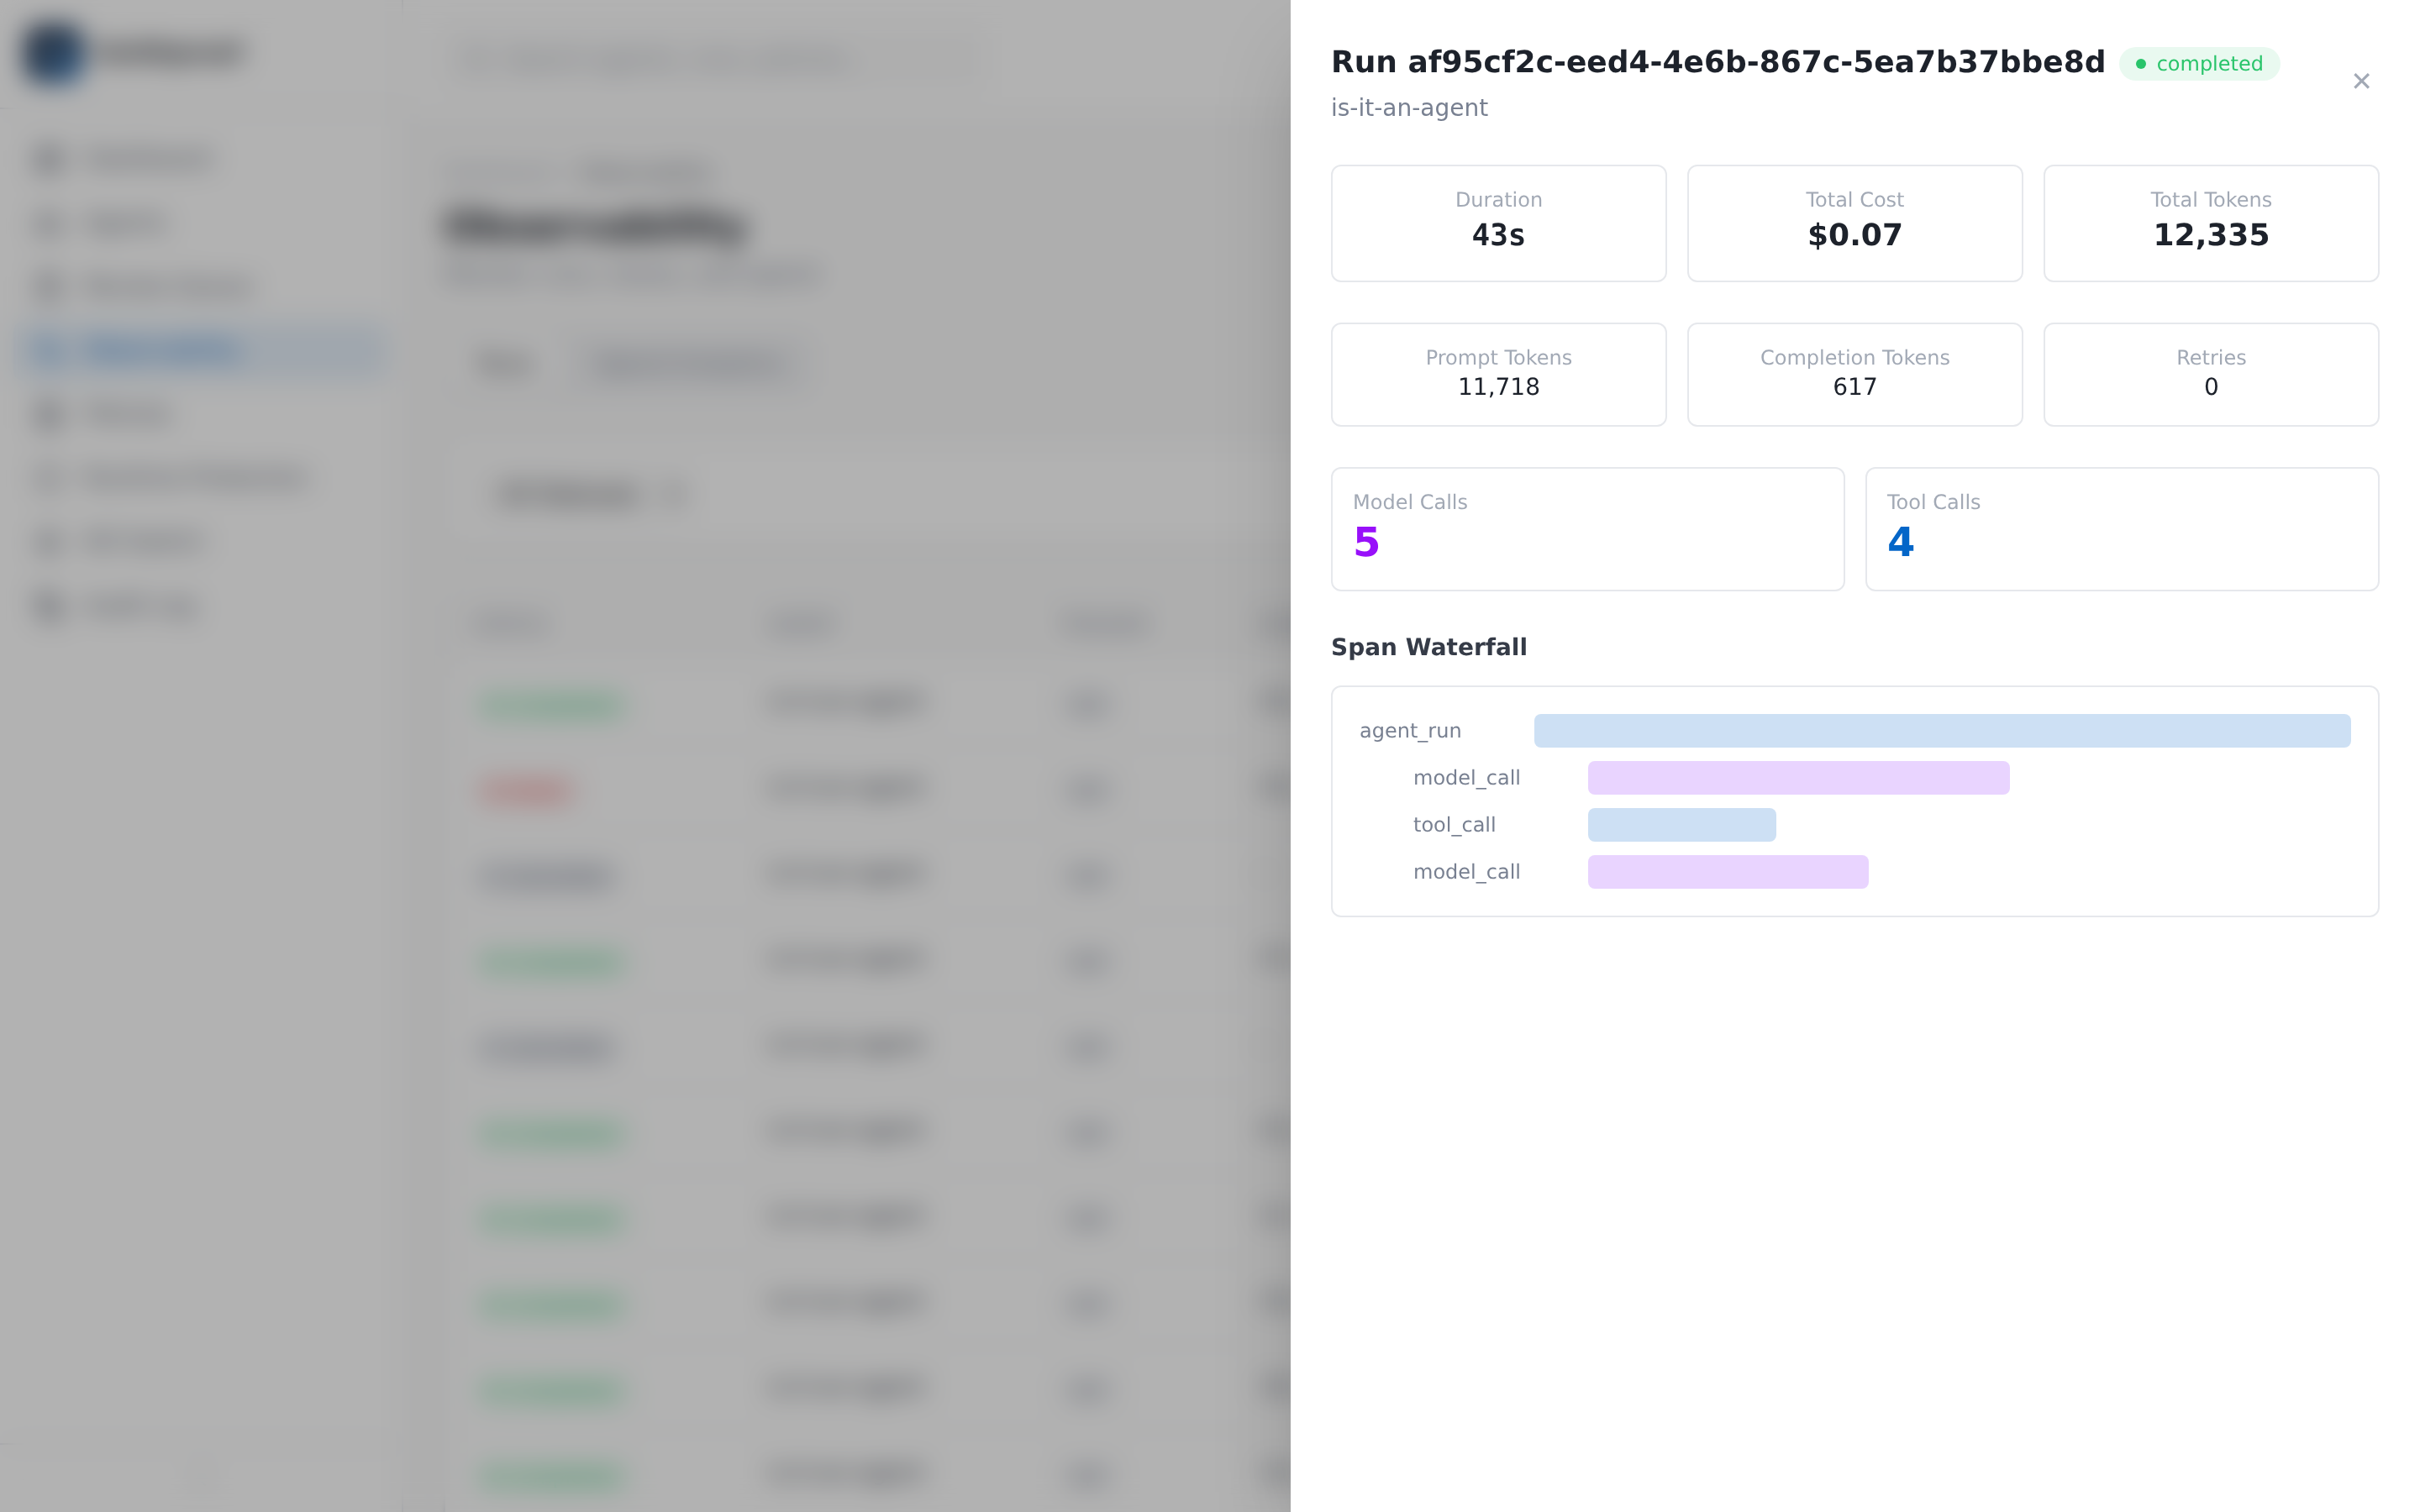 El ritmo ReAct, recuperado desde fuera. No se puede obtener esta vista de una función; no hay nada que ver salvo un bloque.
Y en la única tarea donde el agente tuvo libertad real — la auditoría abierta, cuyos hallazgos nombran a un empleado —, la corrida gobernada no libera su veredicto por autoridad propia. Deposita los hallazgos en una cola de revisión y se bloquea hasta que un operador aprueba o rechaza:
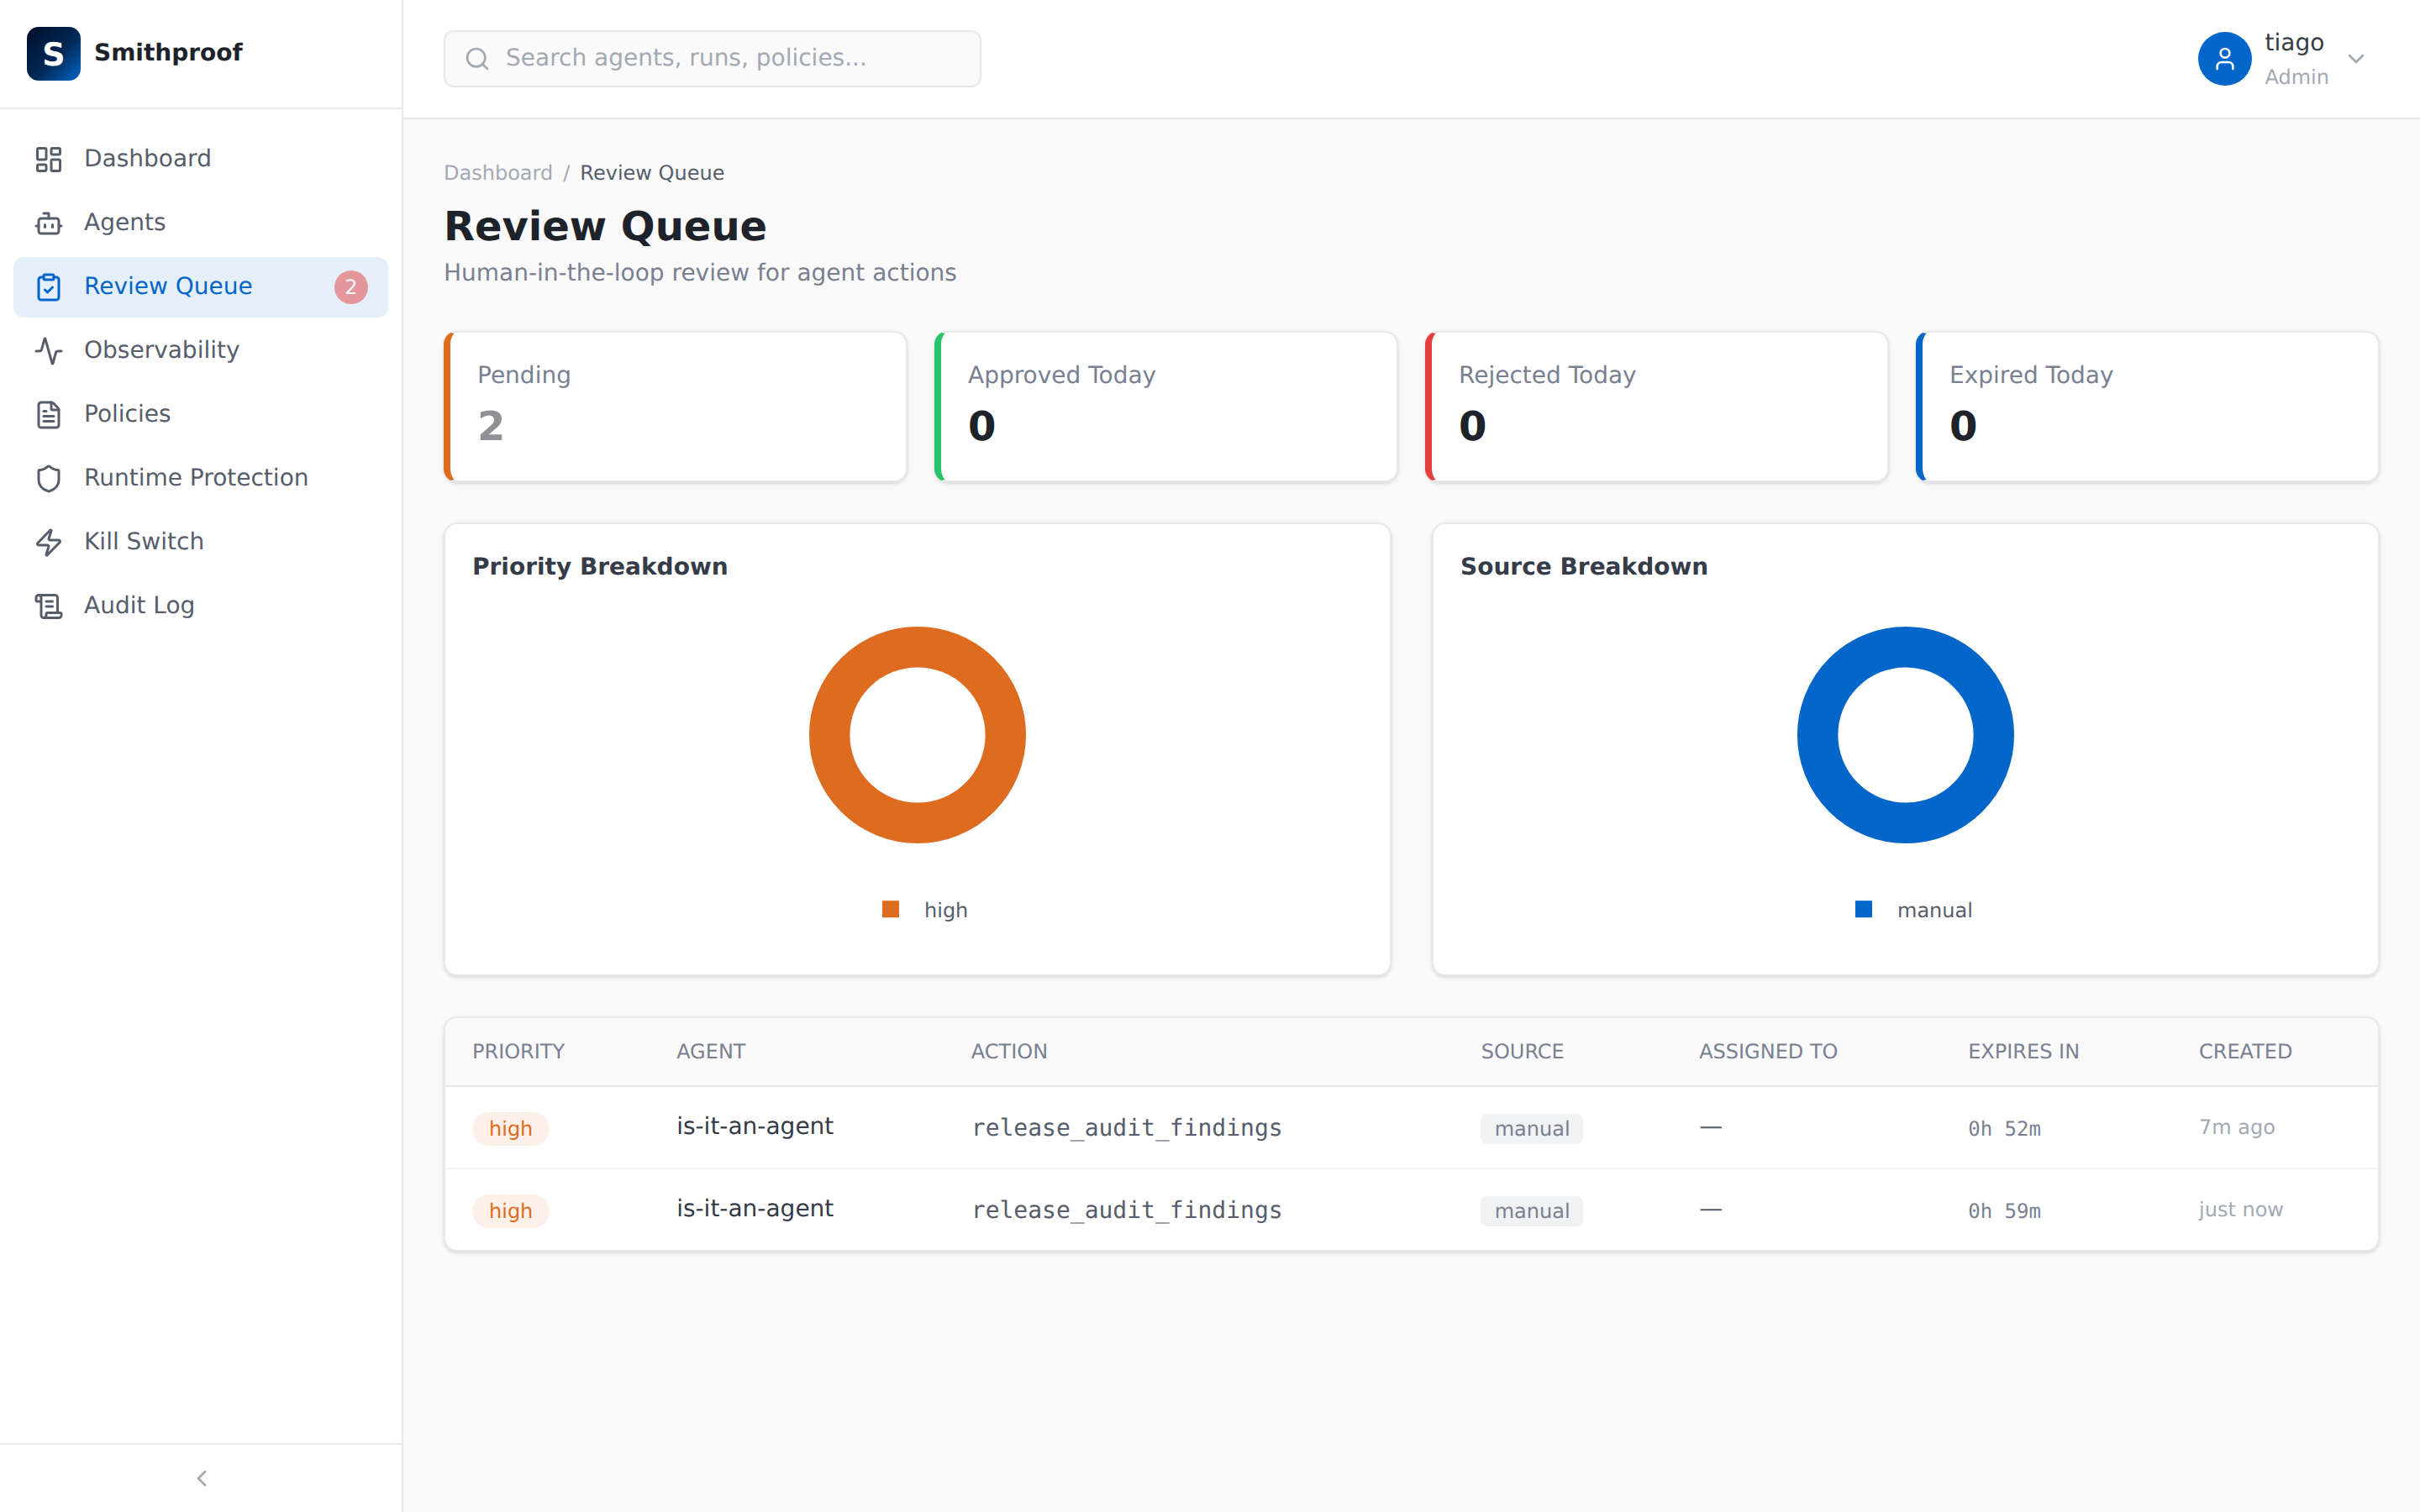 Fíjese dónde está la puerta: no en las preguntas bien especificadas, cuya respuesta es un número que cualquiera puede recalcular, sino exactamente en la banda donde el modelo tuvo libertad. El esfuerzo de revisión sigue a la libertad en tiempo de ejecución.
Intente ejecutar el workflow bajo cualquiera de estas protecciones y la pregunta se responde sola. No hay puerta donde rechazarlo. Sus dos llamadas al LLM rellenan huecos en una cadena cuya forma quedó fijada cuando la escribí. La factura de la gobernanza es el precio de la libertad en tiempo de ejecución, y solo una de las tres formas la debe.
Para qué sirve la palabra
Nada de esto es un argumento contra las funciones o los workflows. Las mediciones argumentan a favor de ellos, en voz alta, allí donde la pregunta es enumerable: el workflow igualó la exactitud del agente dentro de sus rutas a un octavo del coste, con varianza cero y nada que gobernar. Si su producto es una función, lance la función, y disfrute de que nunca necesitará un kill switch.
El argumento es que las tres formas son objetos de ingeniería distintos con facturas distintas adjuntas, y la palabra "agente" existe para revelar qué factura está firmando. Varianza que hay que trazar. Gasto que hay que topar en tiempo de ejecución. Acciones que necesitan una puerta humana. Una flota que hay que poder detener. Cuando un proveedor llama agente a una función tipada, le está cobrando la prima de miedo de una forma mientras le entrega las garantías de otra — o peor, le está enseñando que la palabra es ruido, justo antes de que despliegue algo que de verdad decide en tiempo de ejecución y nadie busque el trazado, el presupuesto o el interruptor, porque los últimos tres "agentes" nunca los necesitaron.
Aplique la prueba de las diez corridas a la próxima cosa que le vendan. Si todas las trazas son iguales, tiene una función o un workflow — pague la factura menor, con gusto. Y si las trazas varían, tiene un agente, y la varianza no es la parte impresionante. Es la factura — y el día en que sus datos superen el prompt, es también la única arquitectura que sigue en pie para enviársela.
Preguntas que responde este artículo
¿Qué hace que algo sea realmente un agente y no un workflow?
El modelo decide el flujo de control en tiempo de ejecución: qué herramienta llamar, si vuelve a iterar, cuándo parar. El ensayo de Anthropic sobre construir agentes eficaces traza la misma línea: los workflows orquestan LLMs por caminos de código predefinidos, los agentes dirigen su propio proceso. Una cadena fija de clasificar, ejecutar y componer es un workflow por muchas llamadas al LLM que contenga, porque cada camino que puede tomar fue enumerado por un humano al escribirlo.
¿Cómo compruebo si lo que un proveedor llama agente lo es de verdad?
Ejecútelo diez veces sobre la misma entrada y mire la estructura de las trazas, no la redacción de la salida. Si la estructura nunca varía, herramientas distintas y un número de pasos distinto, es una función o un workflow: en la cuadrícula medida ambos produjeron exactamente una forma de traza, mientras el agente produjo cinco en la tarea abierta. Hay una cuarta forma de la prueba, que lee la definición al revés: si el sistema no necesita trazado, un tope de presupuesto y una manera de decirle que no, nunca fue un agente.
Si una sola llamada grande al LLM da la respuesta correcta, ¿para qué sirve un agente?
Con datos pequeños no sirve, y las mediciones lo dicen sin rodeos. Con el libro mayor de 116 filas entero en el prompt, la llamada única de la función acertó 40 de 40, incluido encontrar el fraude plantado, a $0,0123 por corrida. El problema es que su coste es lineal en los datos: con 4.989 filas la misma respuesta correcta costó $0,45 por pregunta frente a los $0,036 del agente, y con 49.889 filas el prompt excedió la ventana de contexto, la única jugada de esa arquitectura quedó indisponible y sacó cero de cinco sin colocar una sola llamada al modelo.
¿Qué cuesta un agente que no cuesta un workflow?
Varianza que hay que trazar, gasto que hay que topar con el bucle todavía en marcha, acciones que necesitan una puerta humana y una flota que hay que poder detener. En este proyecto la implementación del agente corre gobernada contra un plano de control: con el tope apretado a dos céntimos, una corrida real hizo cuatro llamadas al modelo y la quinta fue rechazada antes de ser colocada, y el motor de políticas lee el gasto registrado de la corrida en el servidor en lugar de fiarse de un número que aporte el cliente. El workflow no debe nada de esto, porque sus dos llamadas al LLM rellenan huecos en una cadena cuya forma quedó fijada cuando se escribió el código.
Leer a continuación
 AI Agents
Mi IA me conoce a la perfección. No tiene ni idea de lo que quiero
Le di a un modelo de frontera un registro de ejemplo de 90 días construido con mis hábitos reales y luego hice que esta noche contradijera el registro. 180 ejecuciones evaluadas después: la memoria no ciega al modelo cuando la pista está en la habitación, el verdadero producto de la memoria es el silencio de las noches corrientes — y la única vez que necesitaba una pregunta, el asistente que lo sabía todo le dio al play justo al episodio que yo estaba evitando, y me ofreció un té para la ocasión. AI
Jev responde en probabilidades. La pregunta sigue siendo tuya.
Jev, de TypeSafe, no escribe ni una frase. Le entregas un estado y unas preguntas tipadas, y te devuelve una elección, una puntuación o una probabilidad de sí o no, a cuatro milésimas de céntimo por una decisión sobre mil tokens. La novedad es la forma, que devuelve la autoridad a tu código, y la trampa es que una probabilidad parece un recurso y no lo es. Ejecuté el piloto que pediría antes de creerme ningún número, sobre mis propios ensayos con el modelo abierto que sustituyó a Jev, y la respuesta fue no.