
É mesmo um agente? Construí a mesma tarefa de três maneiras para descobrir
Ouvir o artigo (experimental) · 18:54
Há uma coisa a acontecer no marketing de produtos de IA que deixei de achar engraçada. Uma equipa embrulha uma chamada a um LLM numa função — entradas tipadas, uma completion, campos tipados à saída — e lança-a como um agente. Um pipeline de três prompts torna-se um sistema multi-agente. A palavra está a fazer trabalho de vendas, não trabalho de engenharia, e a parte irritante não é a inflação em si. É que "agente" transporta uma afirmação específica, útil e falsificável, e usá-la como sinónimo de "tem um LLM algures lá dentro" destrói a única palavra que tínhamos para essa afirmação.
A afirmação é esta: o modelo decide o fluxo de controlo em tempo de execução. Que ferramenta chamar. Se deve voltar a iterar. Quando parar. O ensaio da Anthropic sobre construir agentes eficazes traça exatamente esta linha — os workflows orquestram LLMs através de caminhos de código predefinidos, os agentes dirigem o seu próprio processo — e apoiei-me na mesma distinção no meu artigo sobre o panorama das frameworks de agentes. Uma função que extrai campos estruturados de texto é extração estruturada. Uma sequência fixa de classificar, executar e resumir é um workflow. Ambos são coisas excelentes com nomes que já existem, e nenhum deles se torna um agente por ser rebatizado num pitch deck.
Podia ter ficado pela definição. Mas as definições são baratas de discutir e as medições não são, por isso construí a mesma tarefa de três maneiras — uma vez como função, uma vez como workflow, uma vez como agente —, corri a grelha completa contra um modelo de fronteira e medi o que o rótulo custa de facto. Tudo o que se segue — o código, os dados, o harness e cada captura de ecrã — vem de um pequeno projeto que construí para este artigo e corri a sério; nada aqui é ilustrativo ou simulado.
Um teste que pode fazer à coisa que lhe venderam
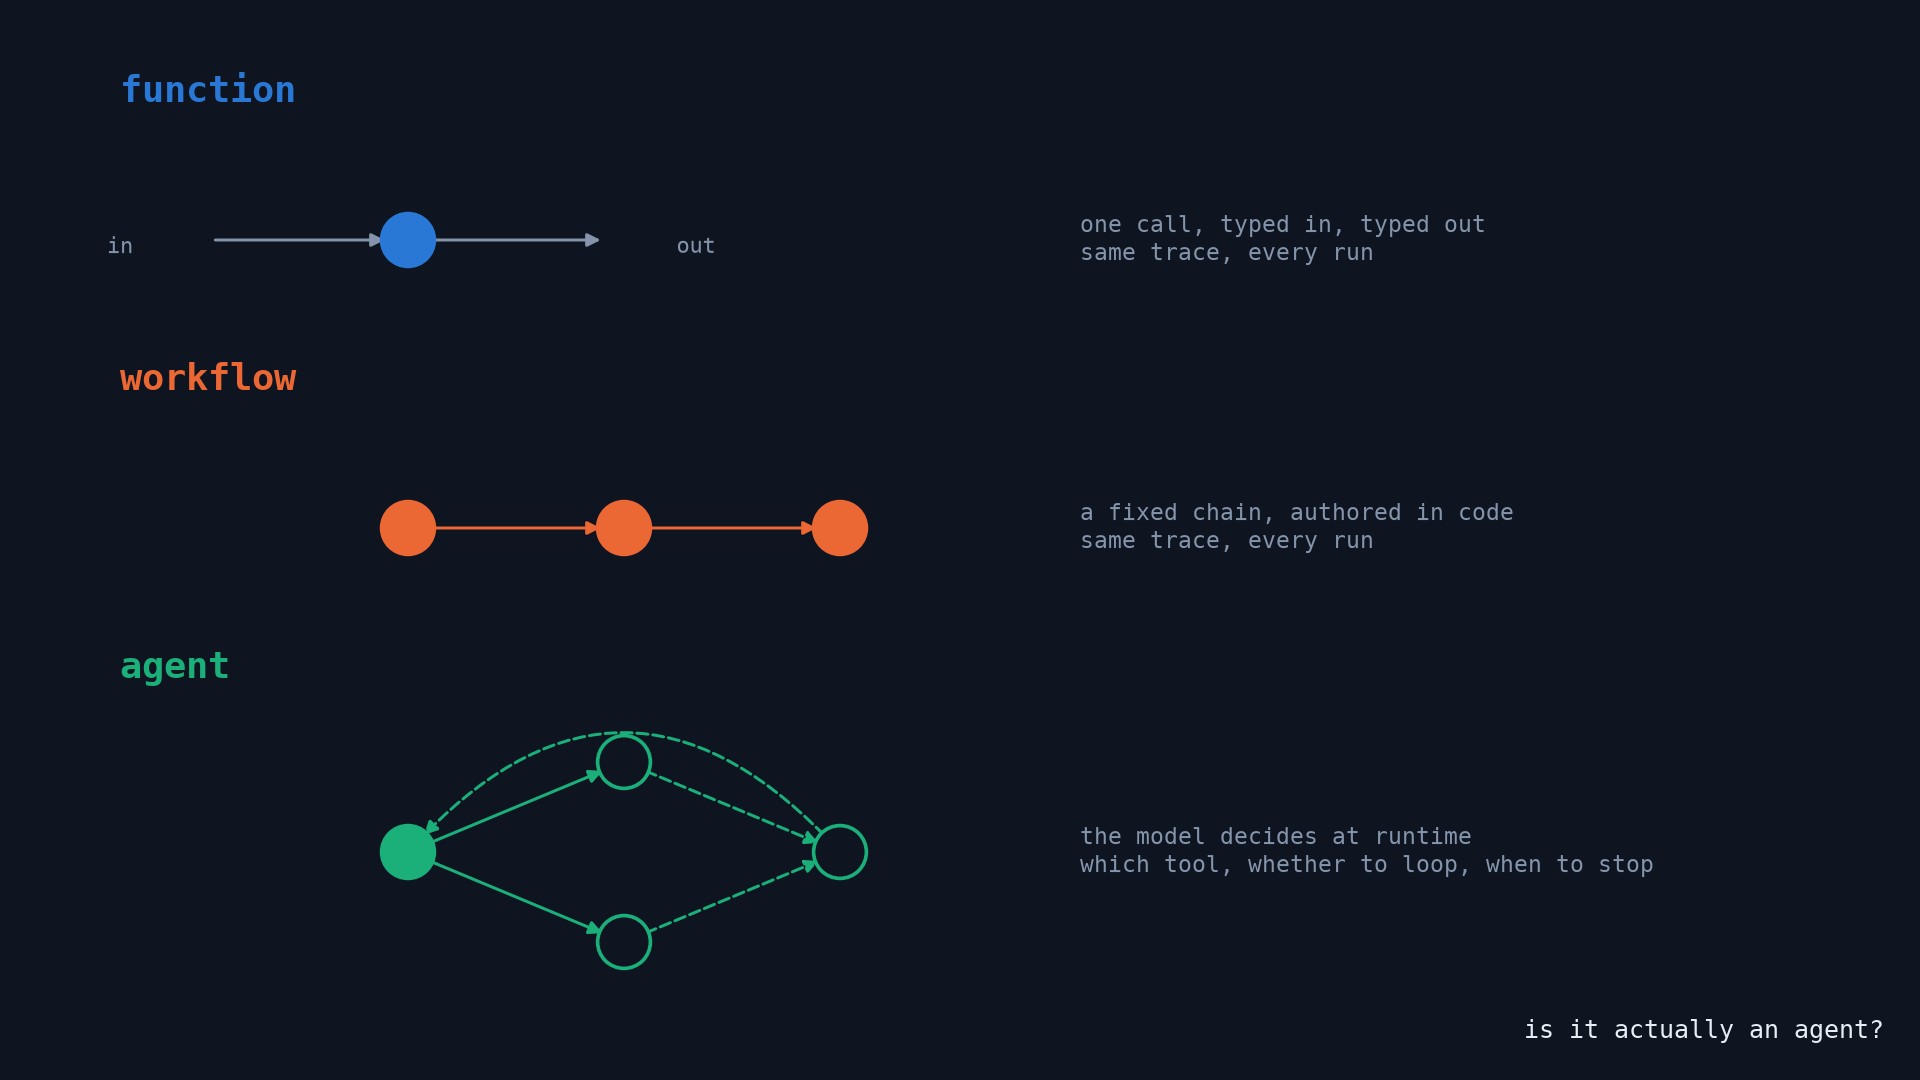
Antes da experiência, o teste que ela produziu. Pegue no sistema a que alguém está a chamar agente e corra-o dez vezes sobre a mesma entrada:
- A estrutura do que aconteceu varia — ferramentas diferentes, número de passos diferente — ou varia só a redação da resposta? Se for só a redação, é uma função.
- Consegue fazer algo que ninguém programou? Se todos os caminhos que pode tomar foram enumerados por um humano em tempo de autoria, é um workflow.
- Tem uma condição de paragem que avalia, em vez de um fim a que chega? Os ciclos decidem; os pipelines terminam.
E uma quarta forma do teste, aquela a que volto sempre, lê a definição ao contrário: percebe-se se algo é um agente por aquilo de que precisa. Se não precisa de tracing, de um limite de orçamento e de uma forma de lhe dizer que não, nunca foi um agente. Ninguém põe um kill switch numa mala direta.
A experiência
O domínio da tarefa é uma pequena auditoria de despesas: um livro-razão de 116 transações produzido por um gerador com semente fixa, com três padrões de fraude lá plantados, e uma política de despesas escrita. Seis perguntas em três bandas — bem especificadas ("total de despesas de viagem em junho de 2026"), aplicação de política ("que transações de refeições excedem o limite da política") e uma pergunta aberta sem rota prescrita: "encontra o padrão mais suspeito e nomeia os IDs das transações." As respostas de referência são calculadas a partir do CSV em tempo de execução pelo mesmo motor de consultas que as implementações usam, nunca escritas à mão.
As três implementações partilham o modelo, os dados e o avaliador, e diferem apenas em quem é dono do fluxo de controlo:
- A função: uma chamada ao LLM, o livro-razão inteiro e a política no prompt, JSON à saída. Fluxo de controlo: nenhum.
- O workflow: classificar → executar → compor. O LLM escolhe uma rota de um enum fechado e escreve a frase final; a aritmética no meio é código determinístico. Perante uma pergunta fora das suas rotas devolve um honesto "não suportado" em vez de improvisar. Fluxo de controlo: fixado no código.
- O agente: um ciclo de ferramentas feito à mão, totalmente visível. O modelo lê a pergunta, decide que ferramenta chamar — ler a política ou consultar o livro-razão —, observa o resultado e decide de novo, até escolher parar. Fluxo de controlo: do modelo, turno a turno, sob um limite de turnos.
Sem framework, deliberadamente. Cada mecanismo é um ficheiro legível, porque o argumento depende de se conseguir ver que a única diferença é onde vivem as decisões.
O que 120 execuções avaliadas disseram de facto
Cinco execuções por célula, dez nas tarefas sensíveis à variância, Claude Opus 5, agosto de 2026:
| Abordagem | sucesso | média de chamadas LLM | custo médio est./execução | tempo médio | formas de trace distintas (tarefa aberta, 10 execuções) |
|---|---|---|---|---|---|
| função | 40/40 | 1,0 | $0,0123 | 11 s | 1 |
| workflow | 30/40 | 2,0 | $0,0033 | 16 s | 1 |
| agente | 40/40 | 3,4 | $0,0283 | 32 s | 5 |
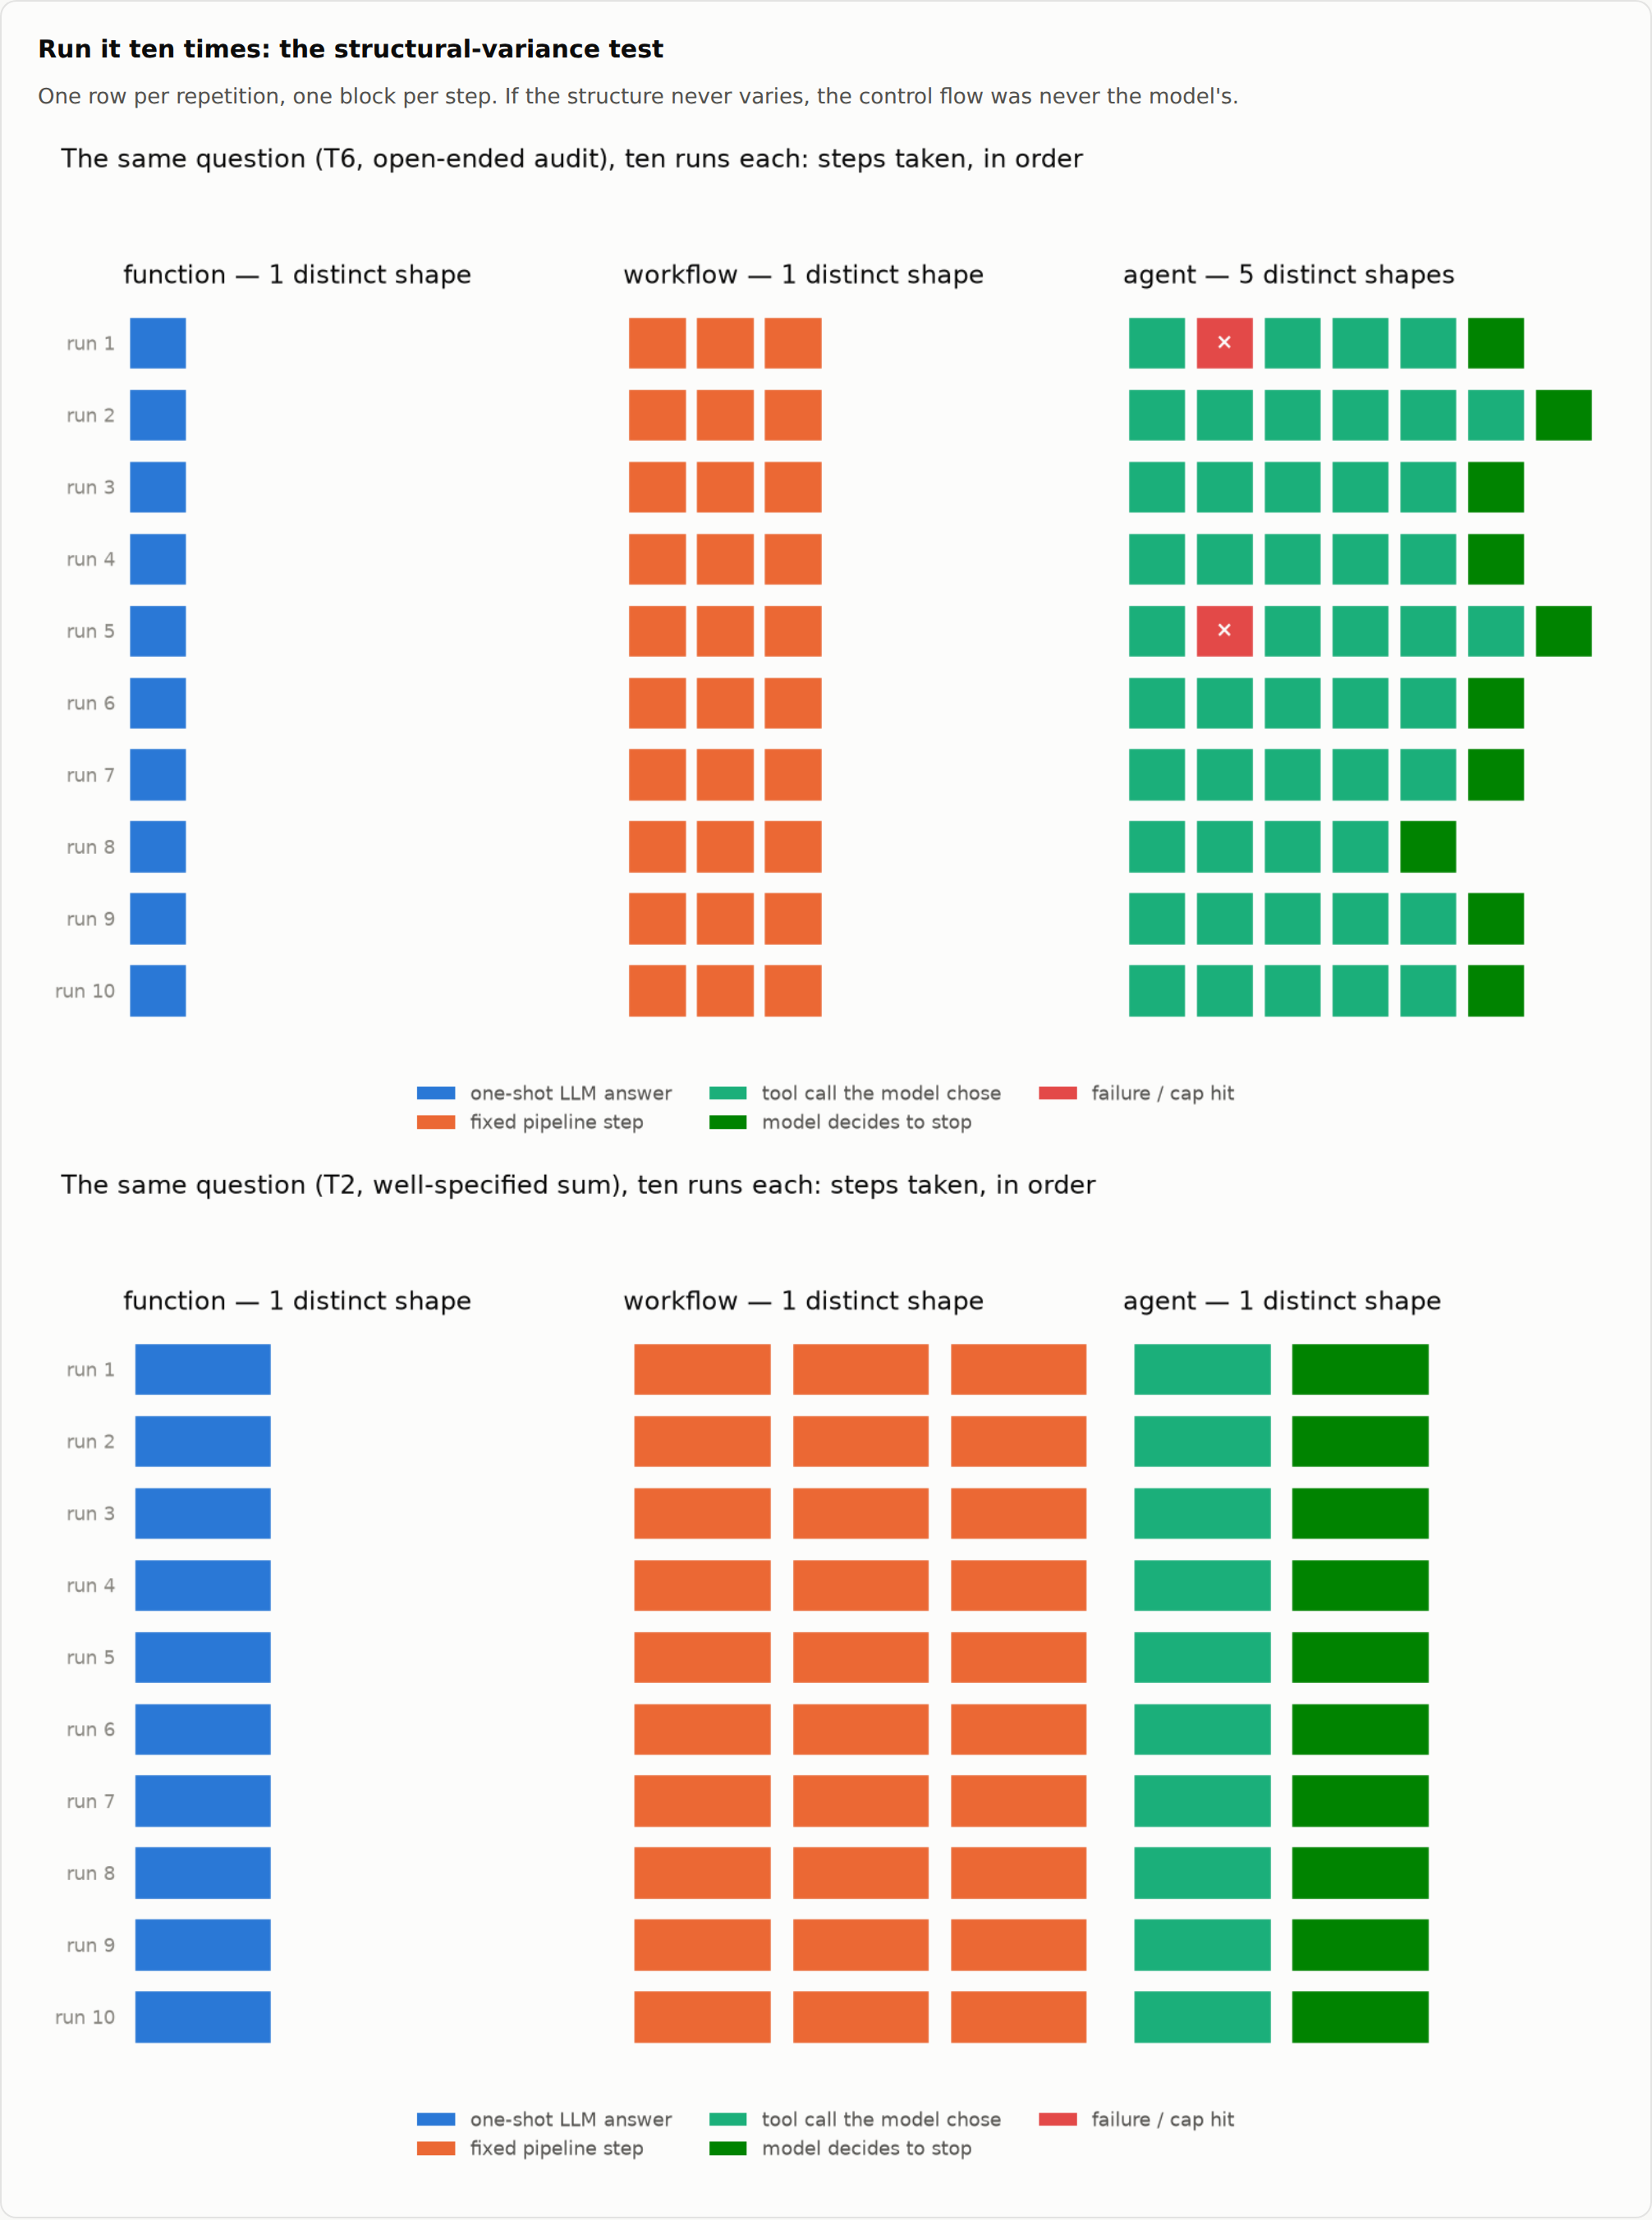 O teste de "correr dez vezes", em forma de dados. Uma forma de trace significa que a estrutura nunca variou. Cinco significa que o modelo escolheu cinco rotas diferentes para a mesma resposta correta.
Três resultados, ditos com honestidade, incluindo os que jogam contra o agente.
A função acertou em tudo. Incluindo somar trinta números decimais a partir de CSV em bruto e encontrar a fraude plantada — porque um modelo de fronteira com o livro-razão completo de 116 linhas em contexto é genuinamente forte. Num conjunto de dados pequeno, a fraqueza da função não é a exatidão. É que o seu custo escala com os dados, a janela de contexto é o seu teto, e não consegue mostrar o seu trabalho: o trace é um bloco opaco.
O workflow foi perfeito dentro das suas rotas e honesto fora delas. A sua aritmética é código, por isso uma classificação correta não pode produzir um número errado, e o seu custo é uns fixos ~$0,003 seja qual for a pergunta — o mais barato dos três, por um fator de 4. As suas trinta "falhas" são todas o mesmo evento repetido: perante a pergunta aberta, respondeu "não suportado", dez vezes em dez, em vez de improvisar. Os workflows terminam; não exploram.
O agente mereceu a sua variância exatamente uma vez — na tarefa que ninguém programou. Na pergunta aberta leu a política, consultou a banda imediatamente abaixo do limiar, reparou nas notas "part 2 / part 3" num aglomerado de transações, confirmou o padrão e nomeou a compra fracionada — dez vezes em dez, por cinco rotas diferentes. Nas perguntas bem especificadas, as suas chamadas extra não compraram nada que o workflow já não tivesse, a 2,3 vezes o custo da função e o triplo da latência.
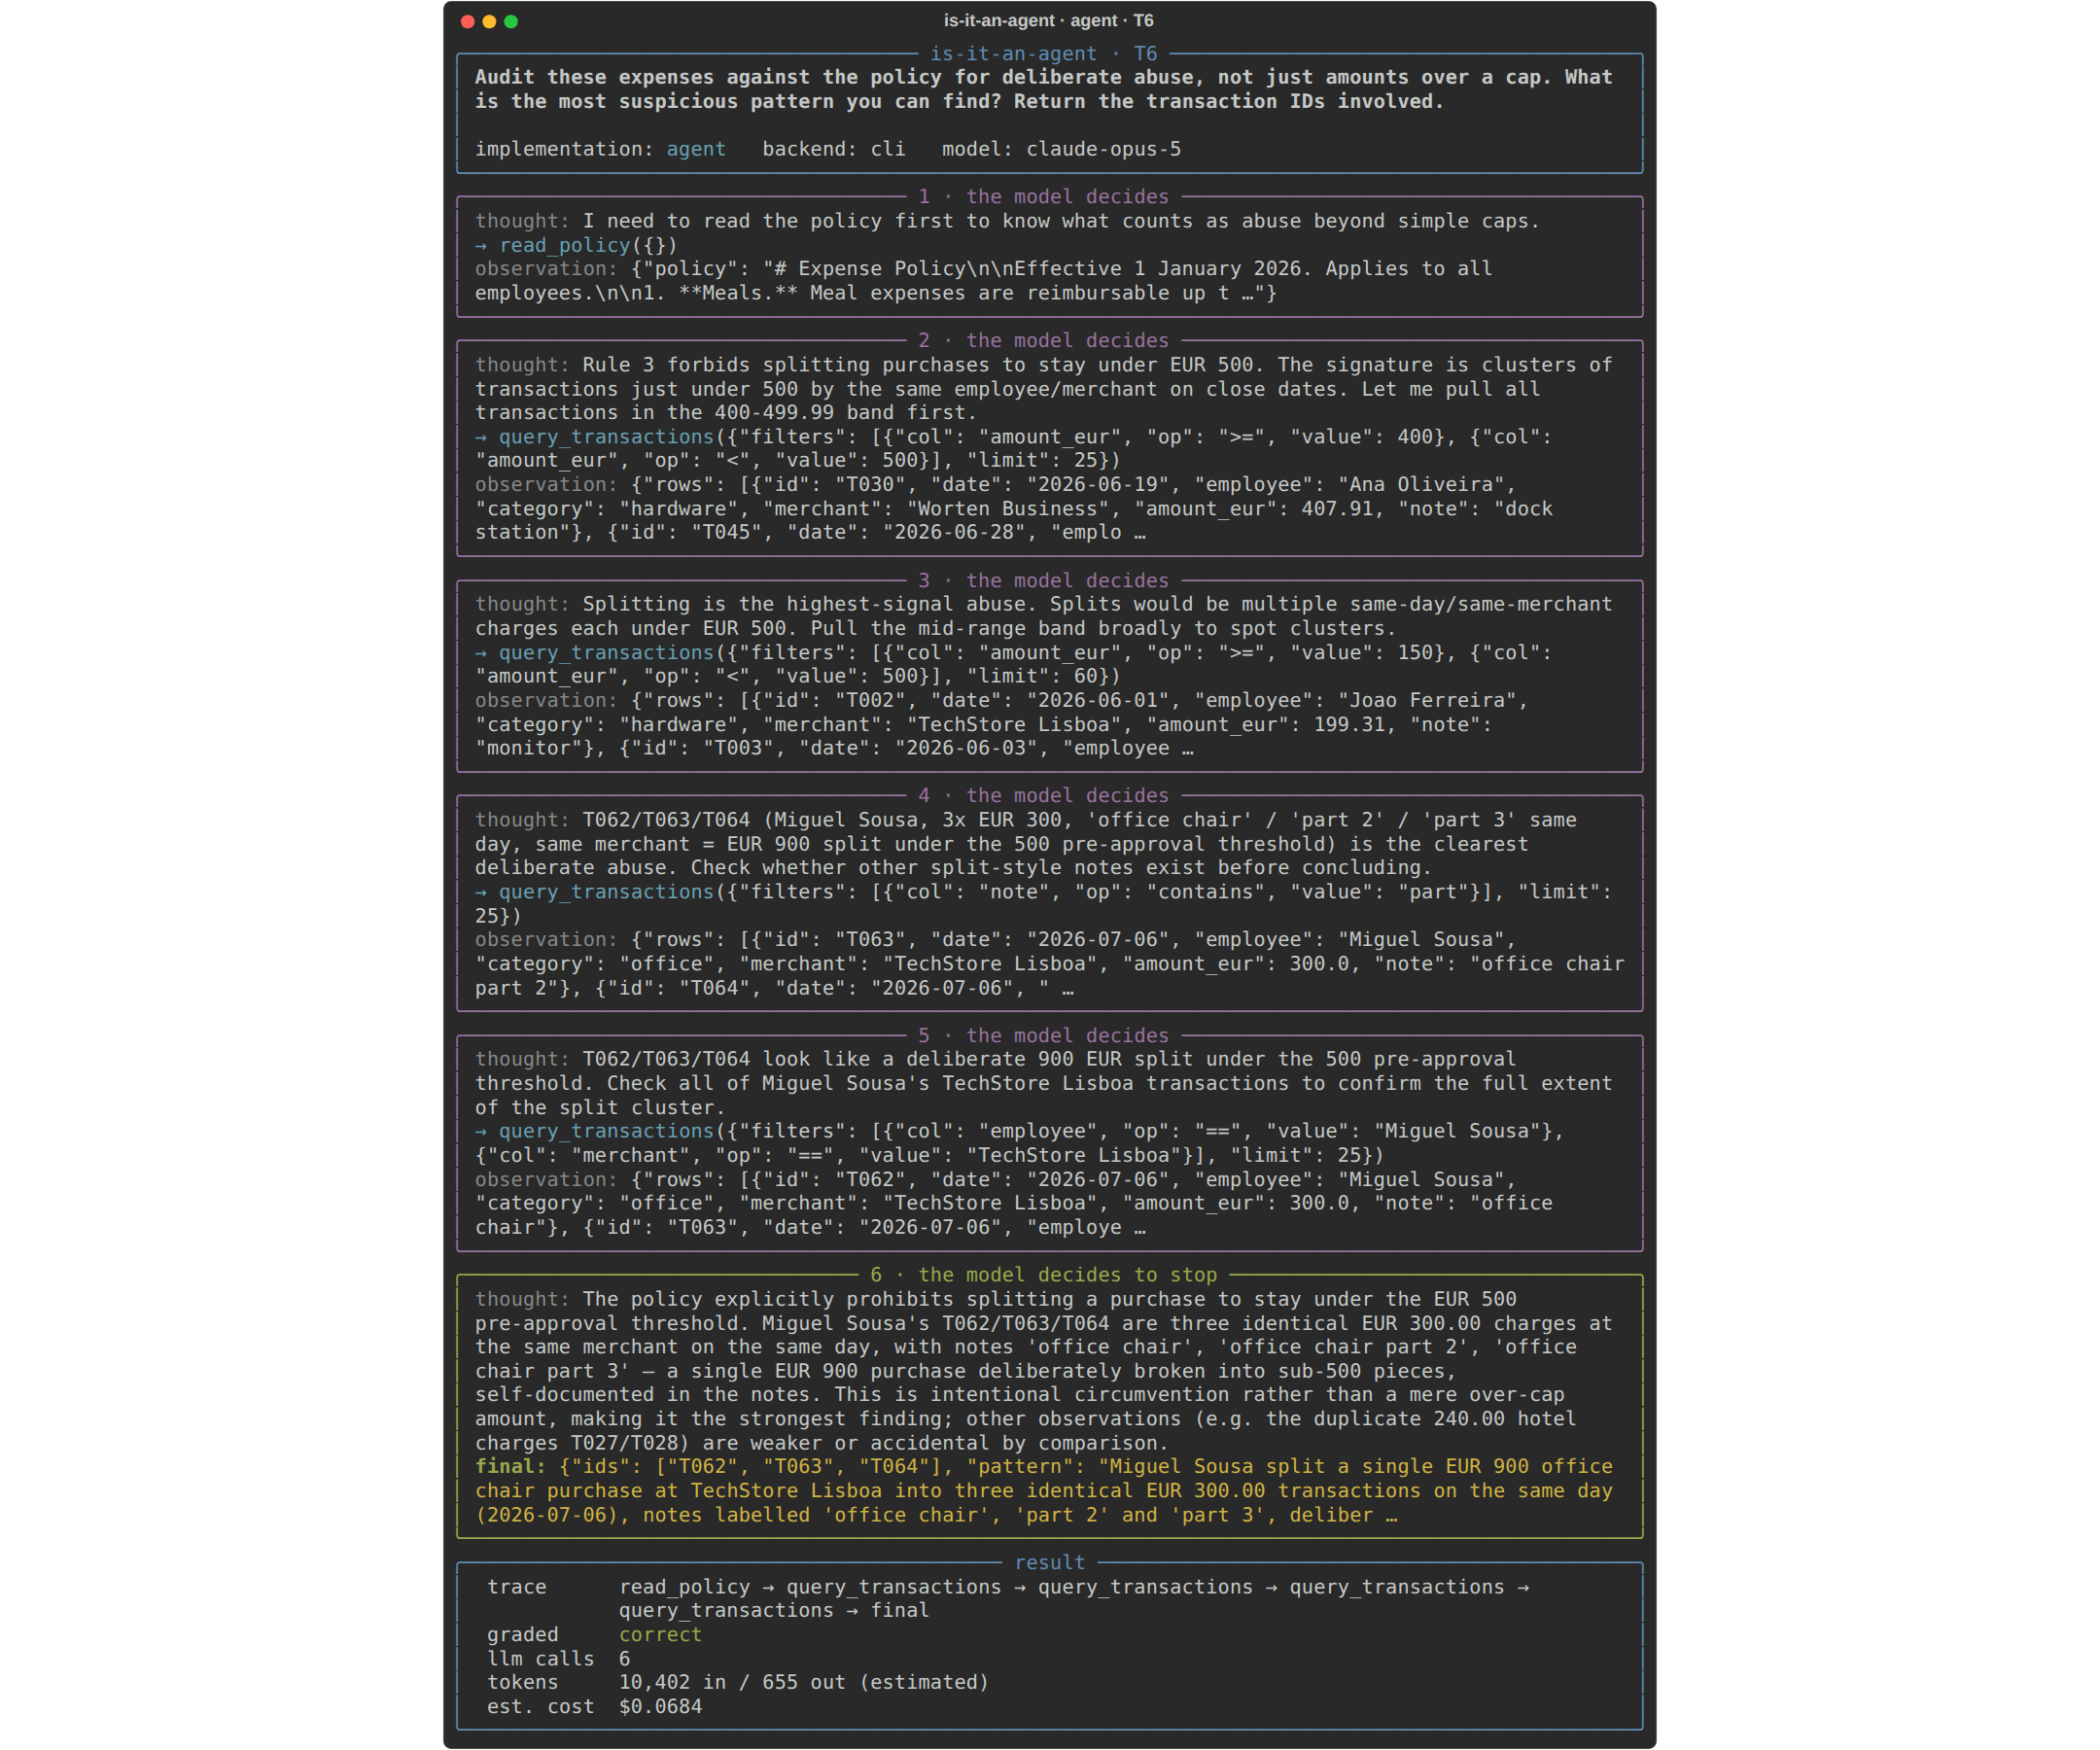 O agente na tarefa aberta. Cada painel é um turno: o pensamento do modelo, a sua chamada de ferramenta, a observação. A decisão final de parar é do modelo, não do código.
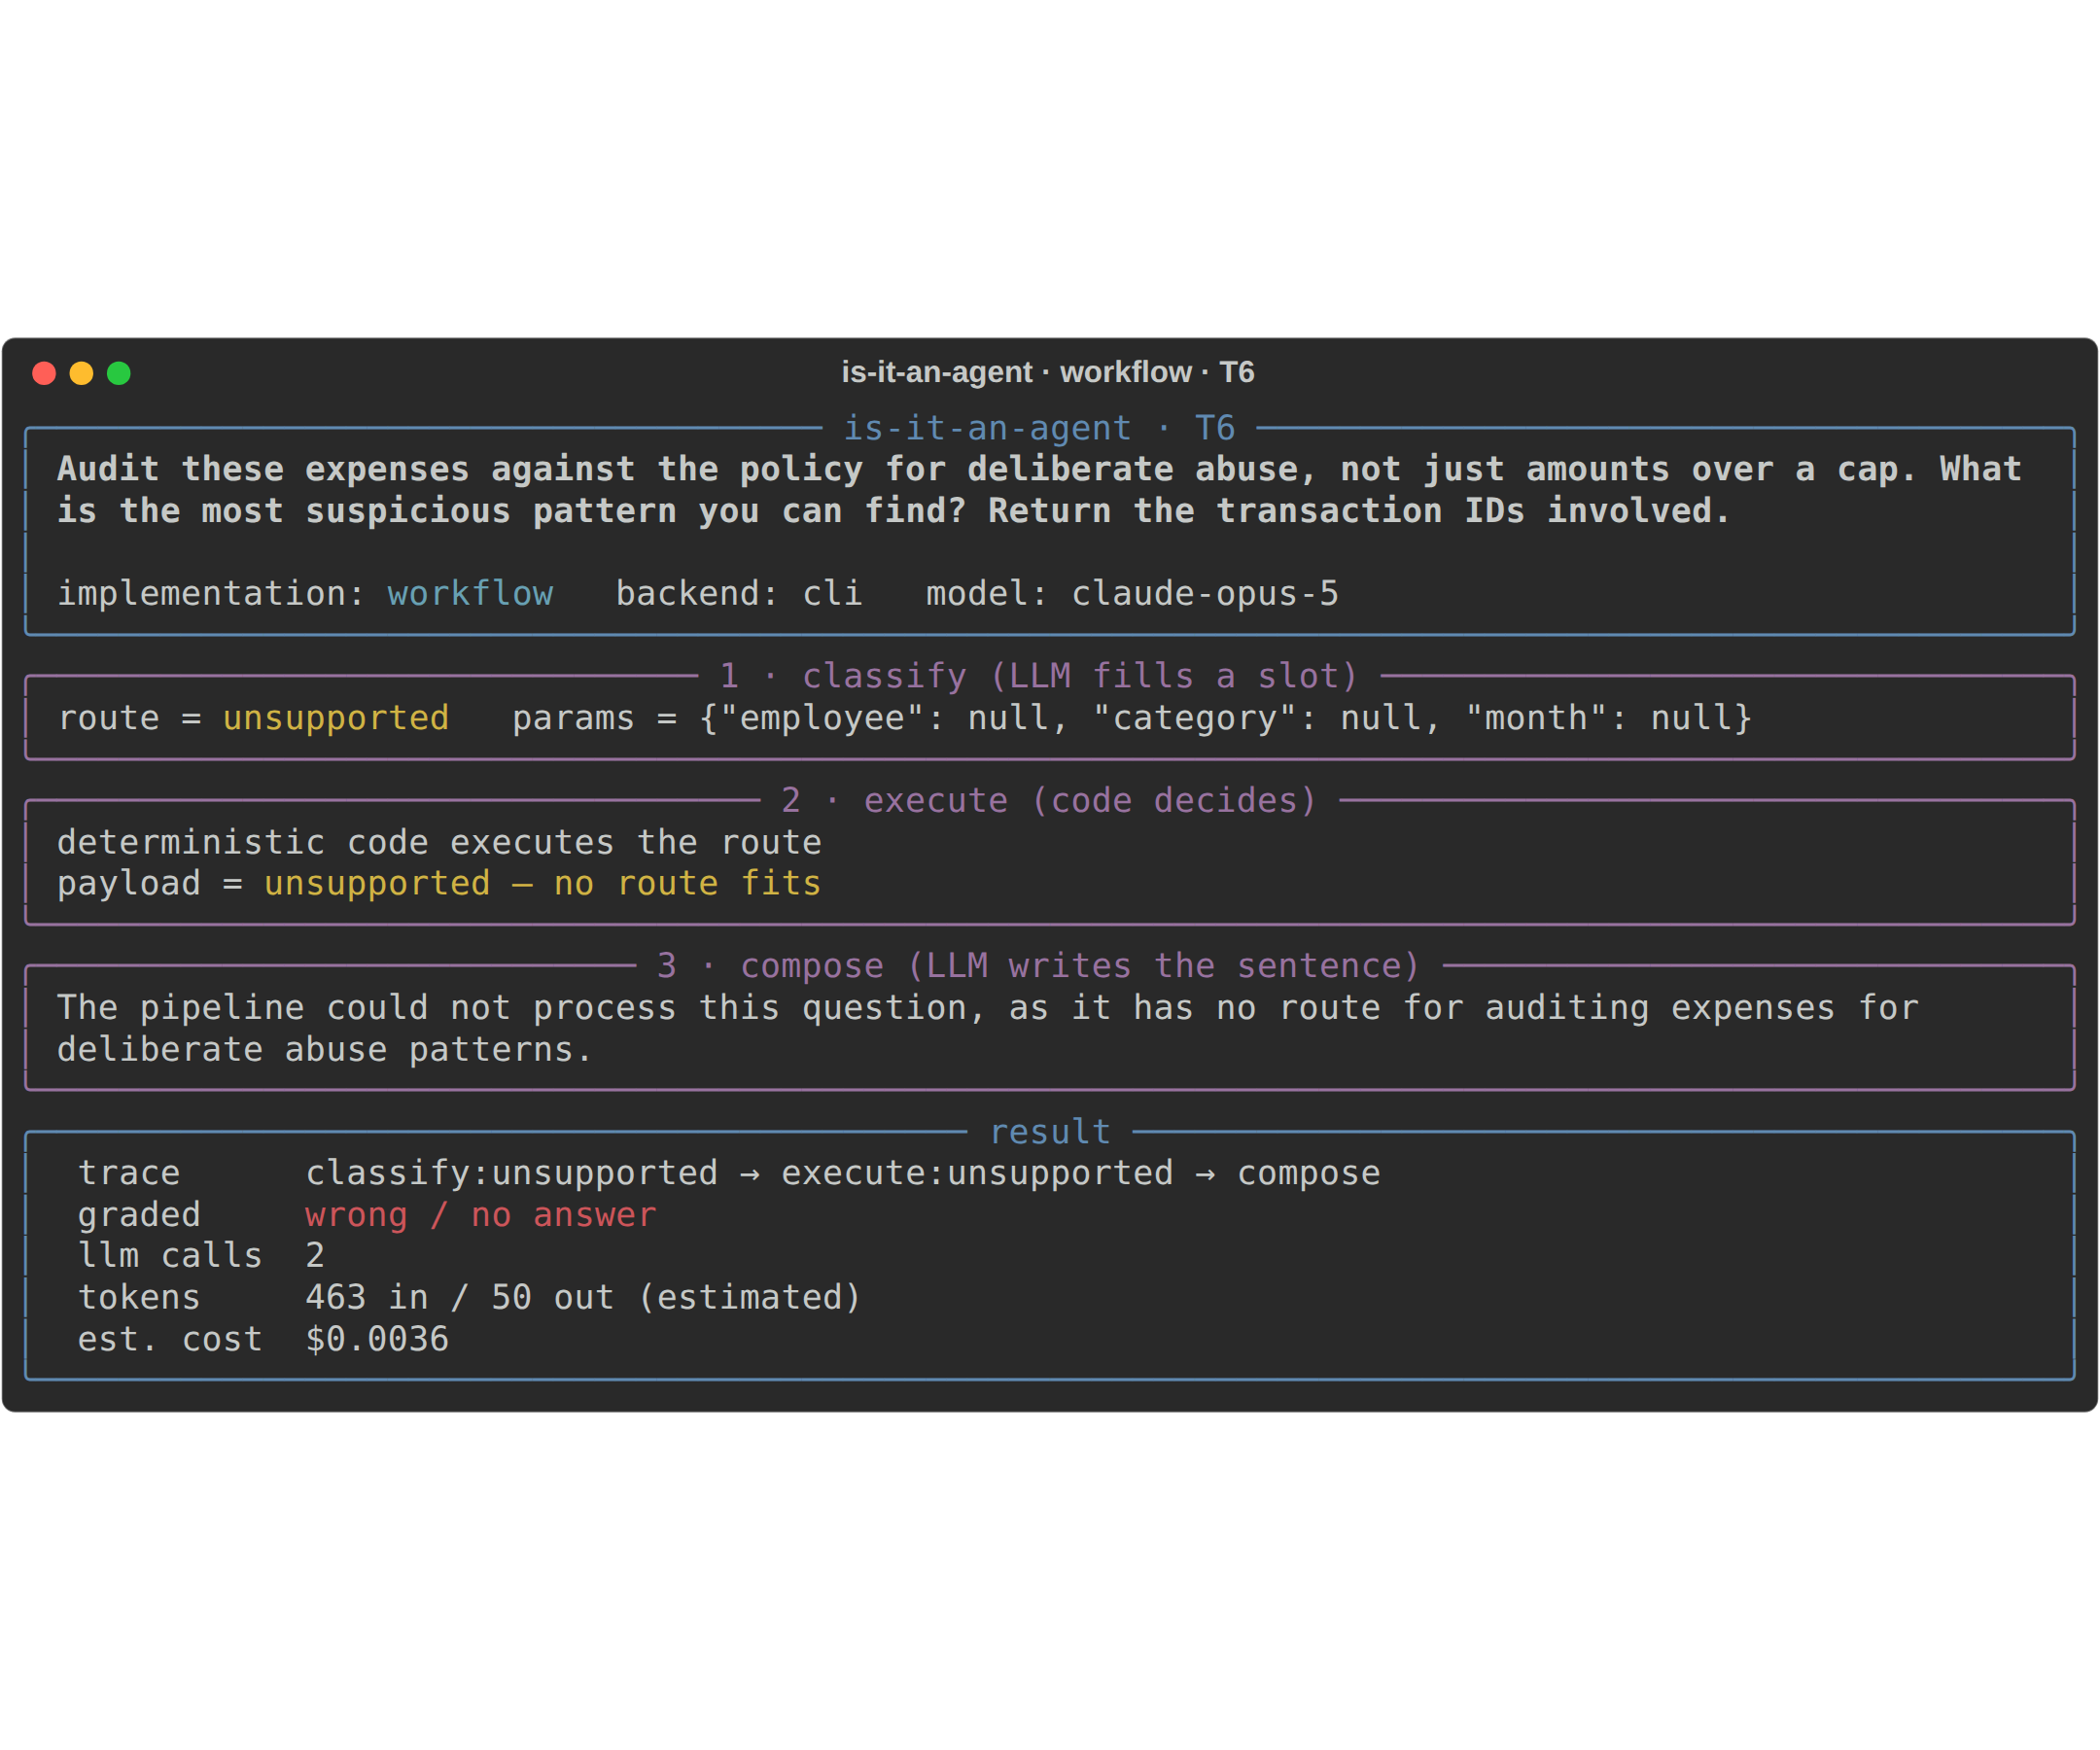 O workflow perante a mesma pergunta. Nenhuma rota serve; e di-lo. Isto não é uma falha do workflow — é a definição de um.
Um incidente das execuções merece ficar no registo em vez de ser editado para fora. Duas execuções iniciais do agente fizeram cair a minha camada de ferramentas: o modelo pediu para agrupar resultados por duas colunas ao mesmo tempo — uma jogada perfeitamente razoável que eu, o autor da ferramenta, não tinha antecipado — e o meu harness lançou uma exceção em vez de devolver uma mensagem de erro. Depois da correção, as mesmas execuções mostram o modelo a ler o erro da ferramenta e a adaptar a consulta seguinte. Isto é a liberdade em tempo de execução num só incidente: o agente encontra as entradas que não enumerámos. Esse é o valor, e é também a fatura, porque um sistema que encontra as suas entradas não enumeradas num livro-razão de brincar com 116 linhas também as vai encontrar em produção.
O caso em que a função perde
Parando aqui, o resumo honesto é "use a função": em 116 linhas acertou em tudo por cêntimos. Isso merecia uma resposta a sério, não um encolher de ombros — por isso aumentei os dados. Mais dois livros-razão com semente fixa, 4.989 linhas e depois 49.889 linhas (~3,6 MB de CSV, cerca de 900 mil tokens), cada um escondendo um funcionário que fraciona o que deviam ser compras grandes, com pré-aprovação, em compras repetidas imediatamente abaixo do limiar, no mesmo comerciante, espalhadas por dois meses, com notas inócuas. Desta vez sem pistas "part 2": o esquema só se encontra como repetição — agrupe-se a banda imediatamente abaixo do limiar por funcionário e um nome sobressai — não a partir de nenhuma linha isolada. A mesma pergunta às três implementações: nomeia o funcionário, lista exatamente as transações do esquema.
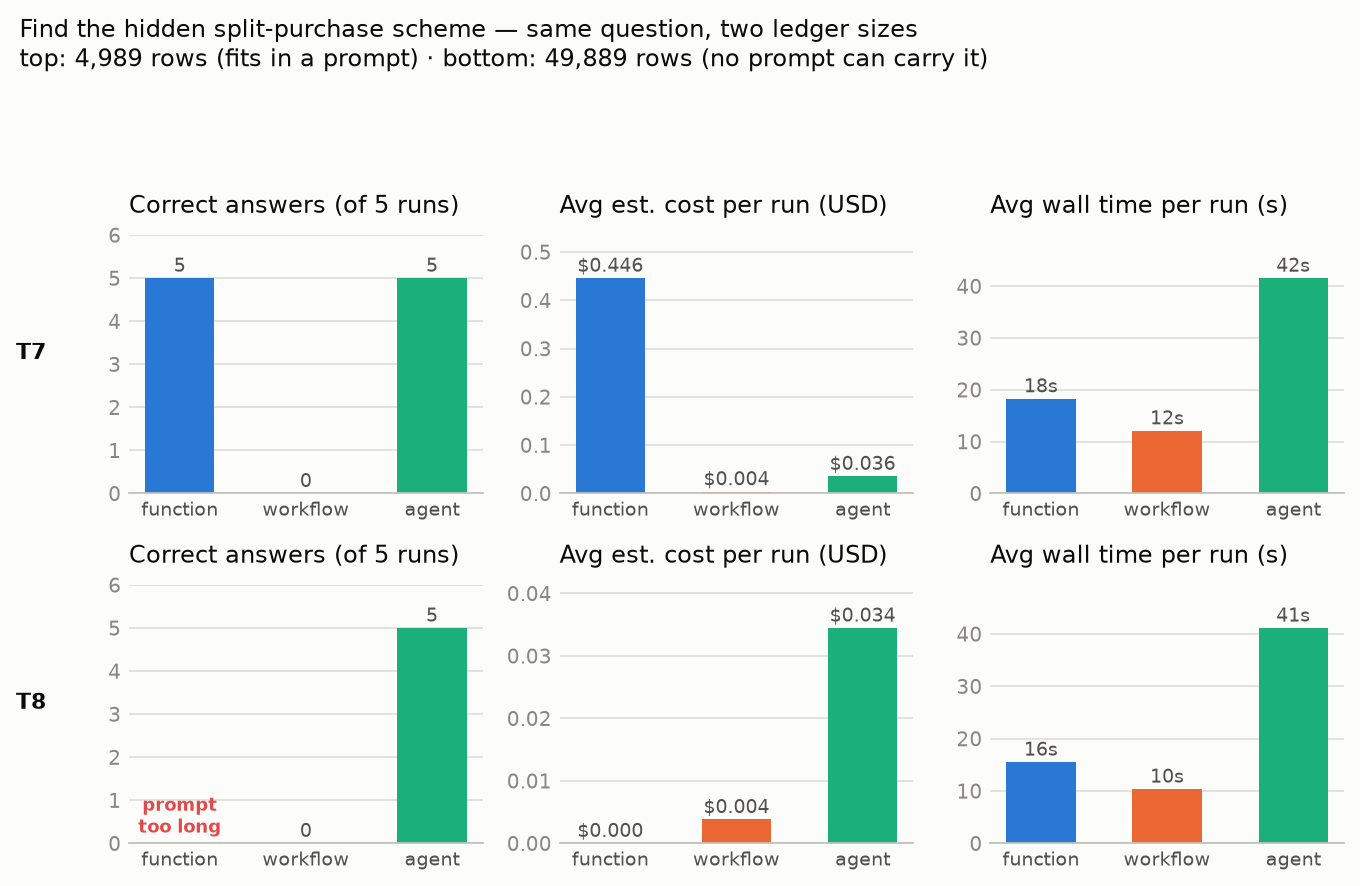 A mesma pergunta, dois tamanhos de livro-razão. Linha de cima: 4.989 linhas. Linha de baixo: 49.889 linhas, onde a coluna da função diz "prompt too long".
Três resultados, e o primeiro é contra a minha própria tese. Com 4.989 linhas a função ainda ganha em exatidão — cinco em cinco, porque um modelo de fronteira a encontrar uma agulha em 90 mil tokens de contexto é uma capacidade real, e fingir o contrário seria a mesma desonestidade de que este artigo se queixa. Mas paga $0,45 por pergunta — o livro-razão inteiro viaja em cada chamada — enquanto o agente a iguala, cinco em cinco, por $0,036. O custo da função é linear nos dados. O do agente é plano, porque as suas chamadas de ferramentas devolvem agregados, não o livro-razão.
Com 49.889 linhas a função não se degrada — desaparece. O prompt excede a janela de contexto, e a única jogada que esta arquitetura tem fica indisponível. Zero chamadas ao modelo, Prompt is too long, zero em cinco. "O contexto é o seu teto" deixa de ser metáfora e passa a ser uma mensagem de erro:
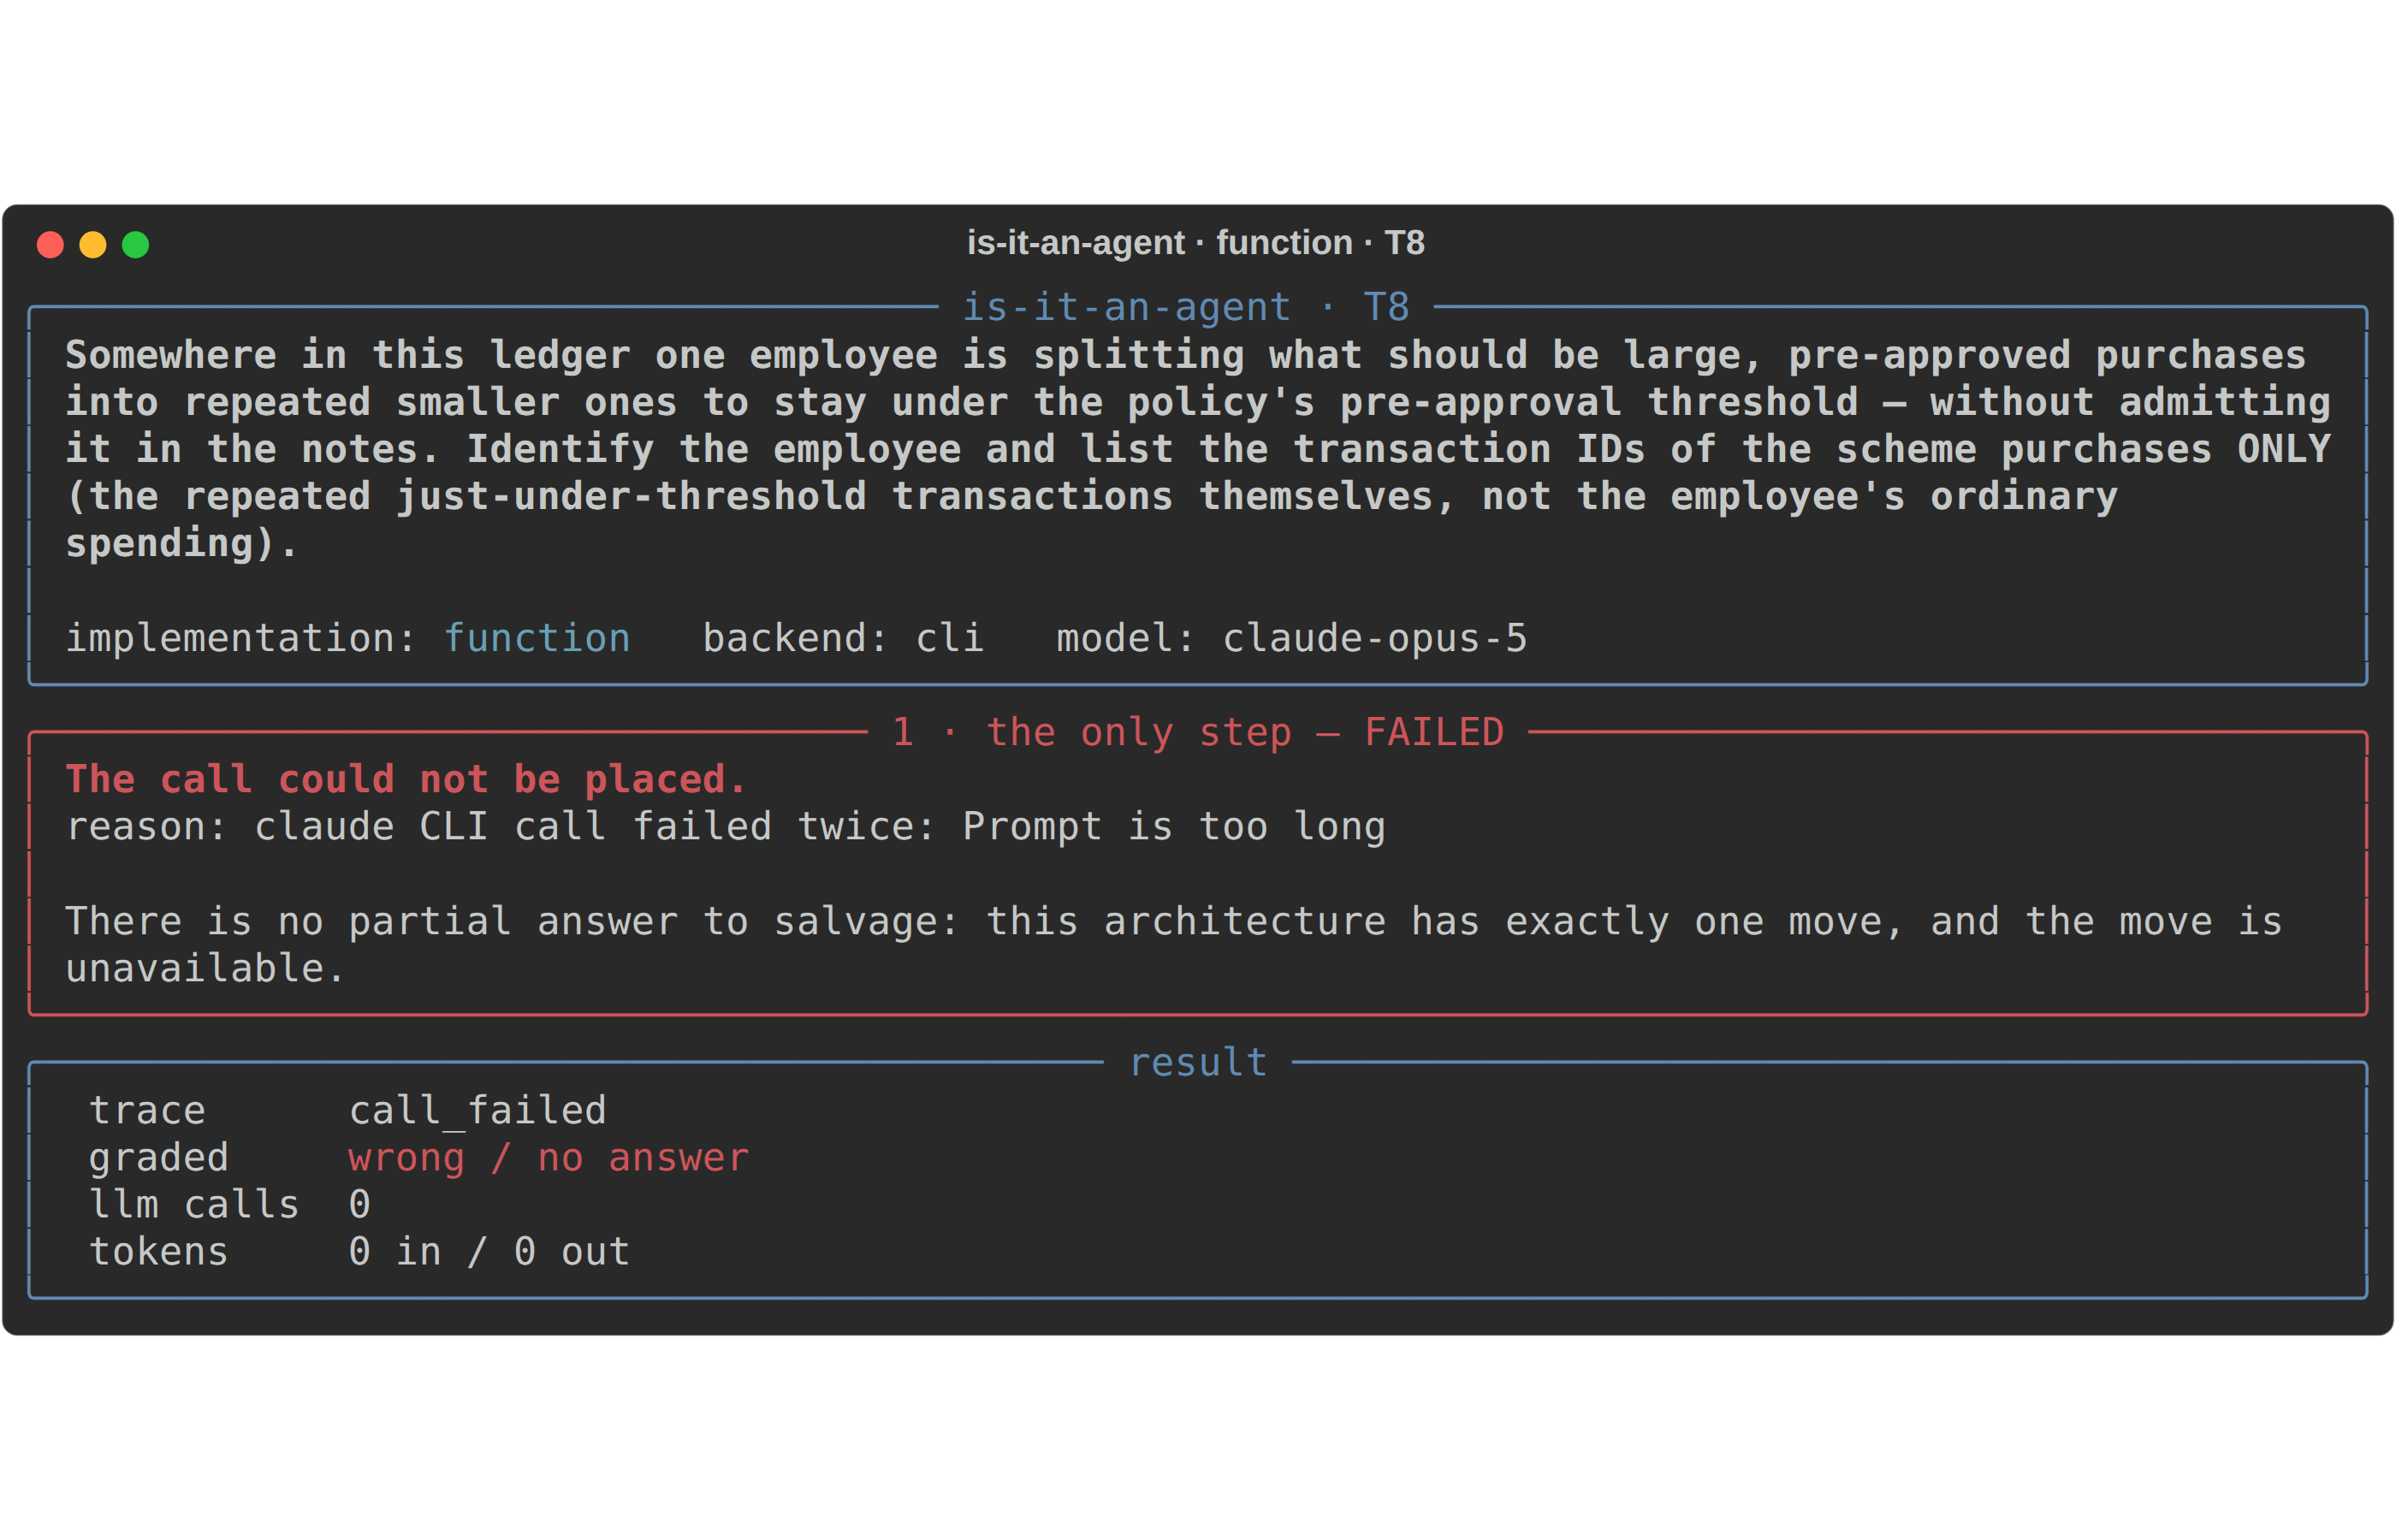 A anti-demonstração. Não há resposta parcial para salvar: esta arquitetura tem exatamente uma jogada, e a jogada está indisponível.
E o agente nem nota a diferença. As mesmas cinco chamadas, os mesmos ~$0,034, cinco em cinco: ler a política para saber o limiar, agrupar a banda imediatamente abaixo do limiar por funcionário, ver um nome com seis ocorrências onde todos os outros têm no máximo uma, inspecionar essas linhas, parar. Os traces a 50 mil linhas têm a mesma forma que a 5 mil, porque a estratégia do modelo não cresce com os dados — só os dados crescem:
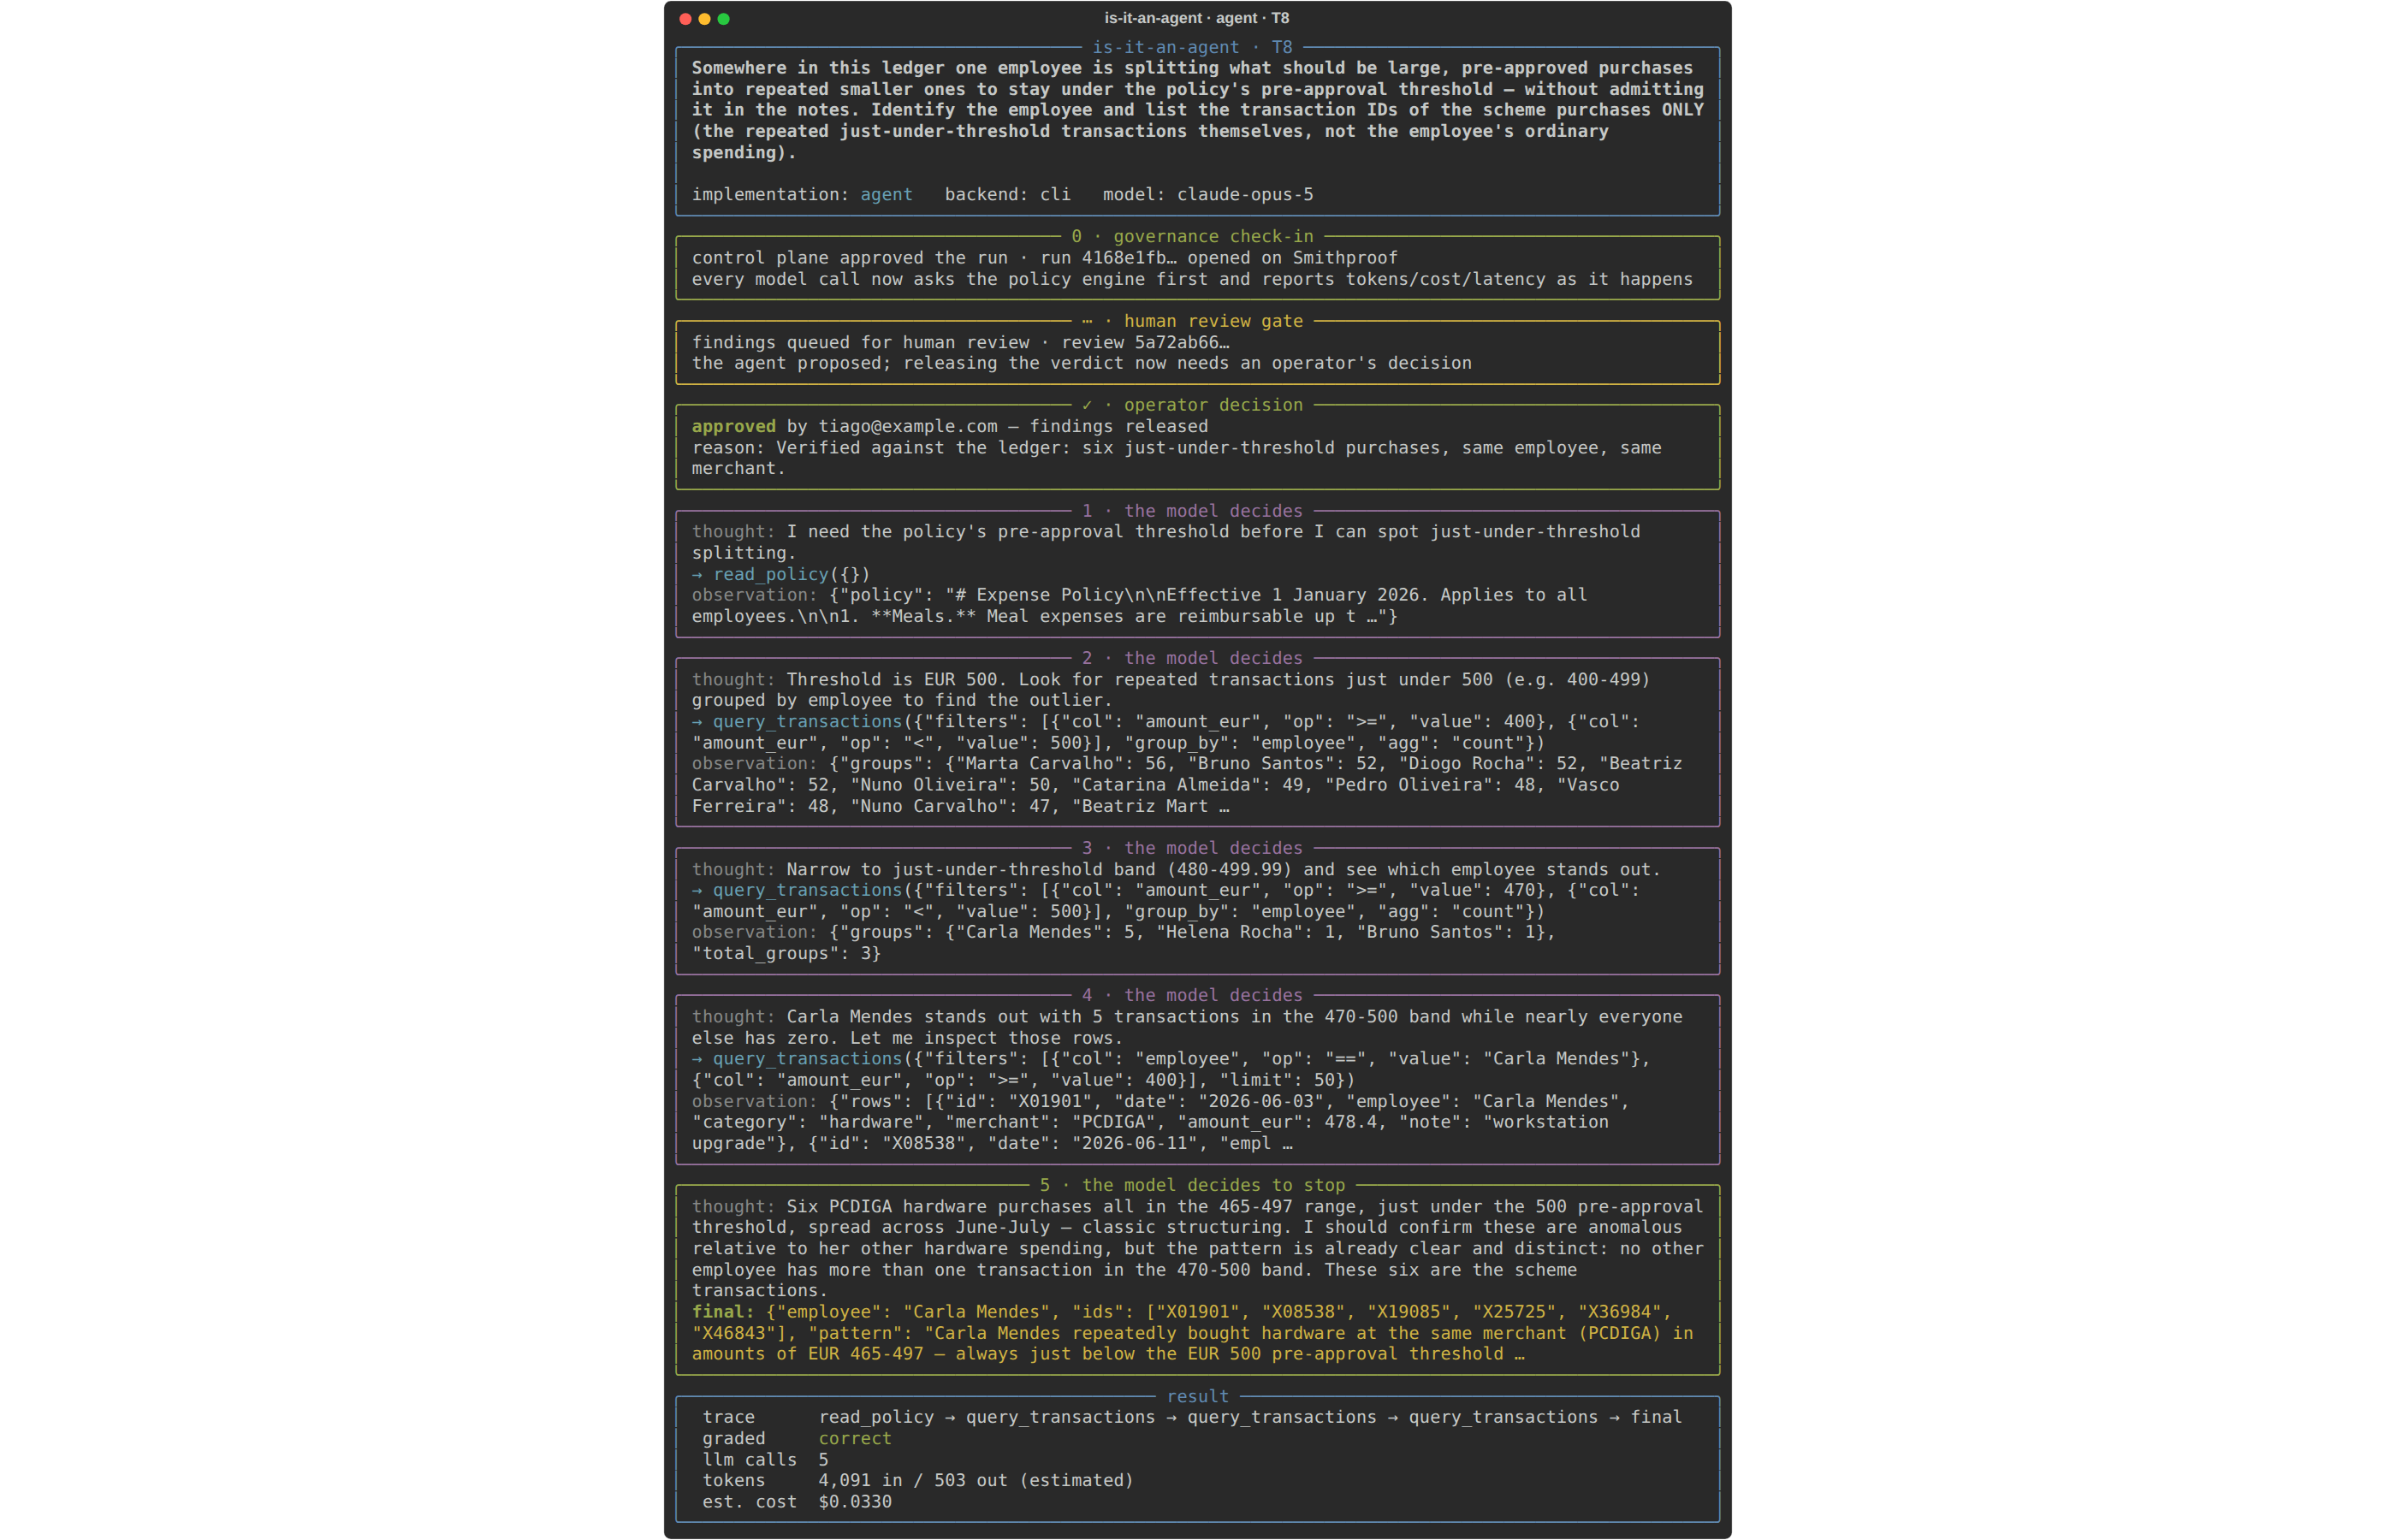 O agente a 50 mil linhas, governado pelo plano de controlo e com portão de revisão humana, correto em cinco decisões. Compare-se a linha do custo com a da função num livro-razão dez vezes mais pequeno.
Construir esta banda produziu mais duas curvas erradas que valem a pena guardar. O meu limite original de 8 turnos sufocou as primeiras execuções — três em cinco bateram no teto a meio da investigação, um orçamento que não cabia no trabalho que limitava. E o agente expôs um avaliador ambíguo: na primeira versão dos dados, a funcionária do esquema também sorteava compras coincidentes de €380–450, o agente dobrou-as razoavelmente para dentro do padrão, e o meu avaliador marcou-o como errado. A correção pertencia ao mundo, não ao avaliador. Um agente que encontra as entradas que não enumerámos também encontra as ambiguidades que não notámos — a mesma propriedade, a fazer os dois trabalhos.
A definição lida ao contrário
O que me traz à parte do teste que mais me importa, porque liga este artigo ao plano de controlo que construí. Um agente reconhece-se por aquilo de que precisa: tracing, um orçamento, uma forma de lhe dizer que não.
Por isso liguei as necessidades a sério. Quando o ambiente transporta credenciais do Smithproof, a implementação do agente do projeto corre governada — cada execução apresenta-se ao plano de controlo antes da primeira chamada ao modelo, cada chamada ao LLM e cada chamada de ferramenta é reportada à medida que acontece, e a execução é concluída ou marcada como falhada no fim. A função e o workflow nunca são governados. Não há nada para governar: o seu fluxo de controlo não pode surpreender ninguém.
Essa assimetria é o argumento inteiro, tornado executável. E deixa de ser decorativa no momento em que o plano de controlo diz que não. Ponha-se o agente em quarentena e corra-se de novo, e o pipeline é recusado à porta, antes de qualquer chamada ao modelo, com código de saída 5:
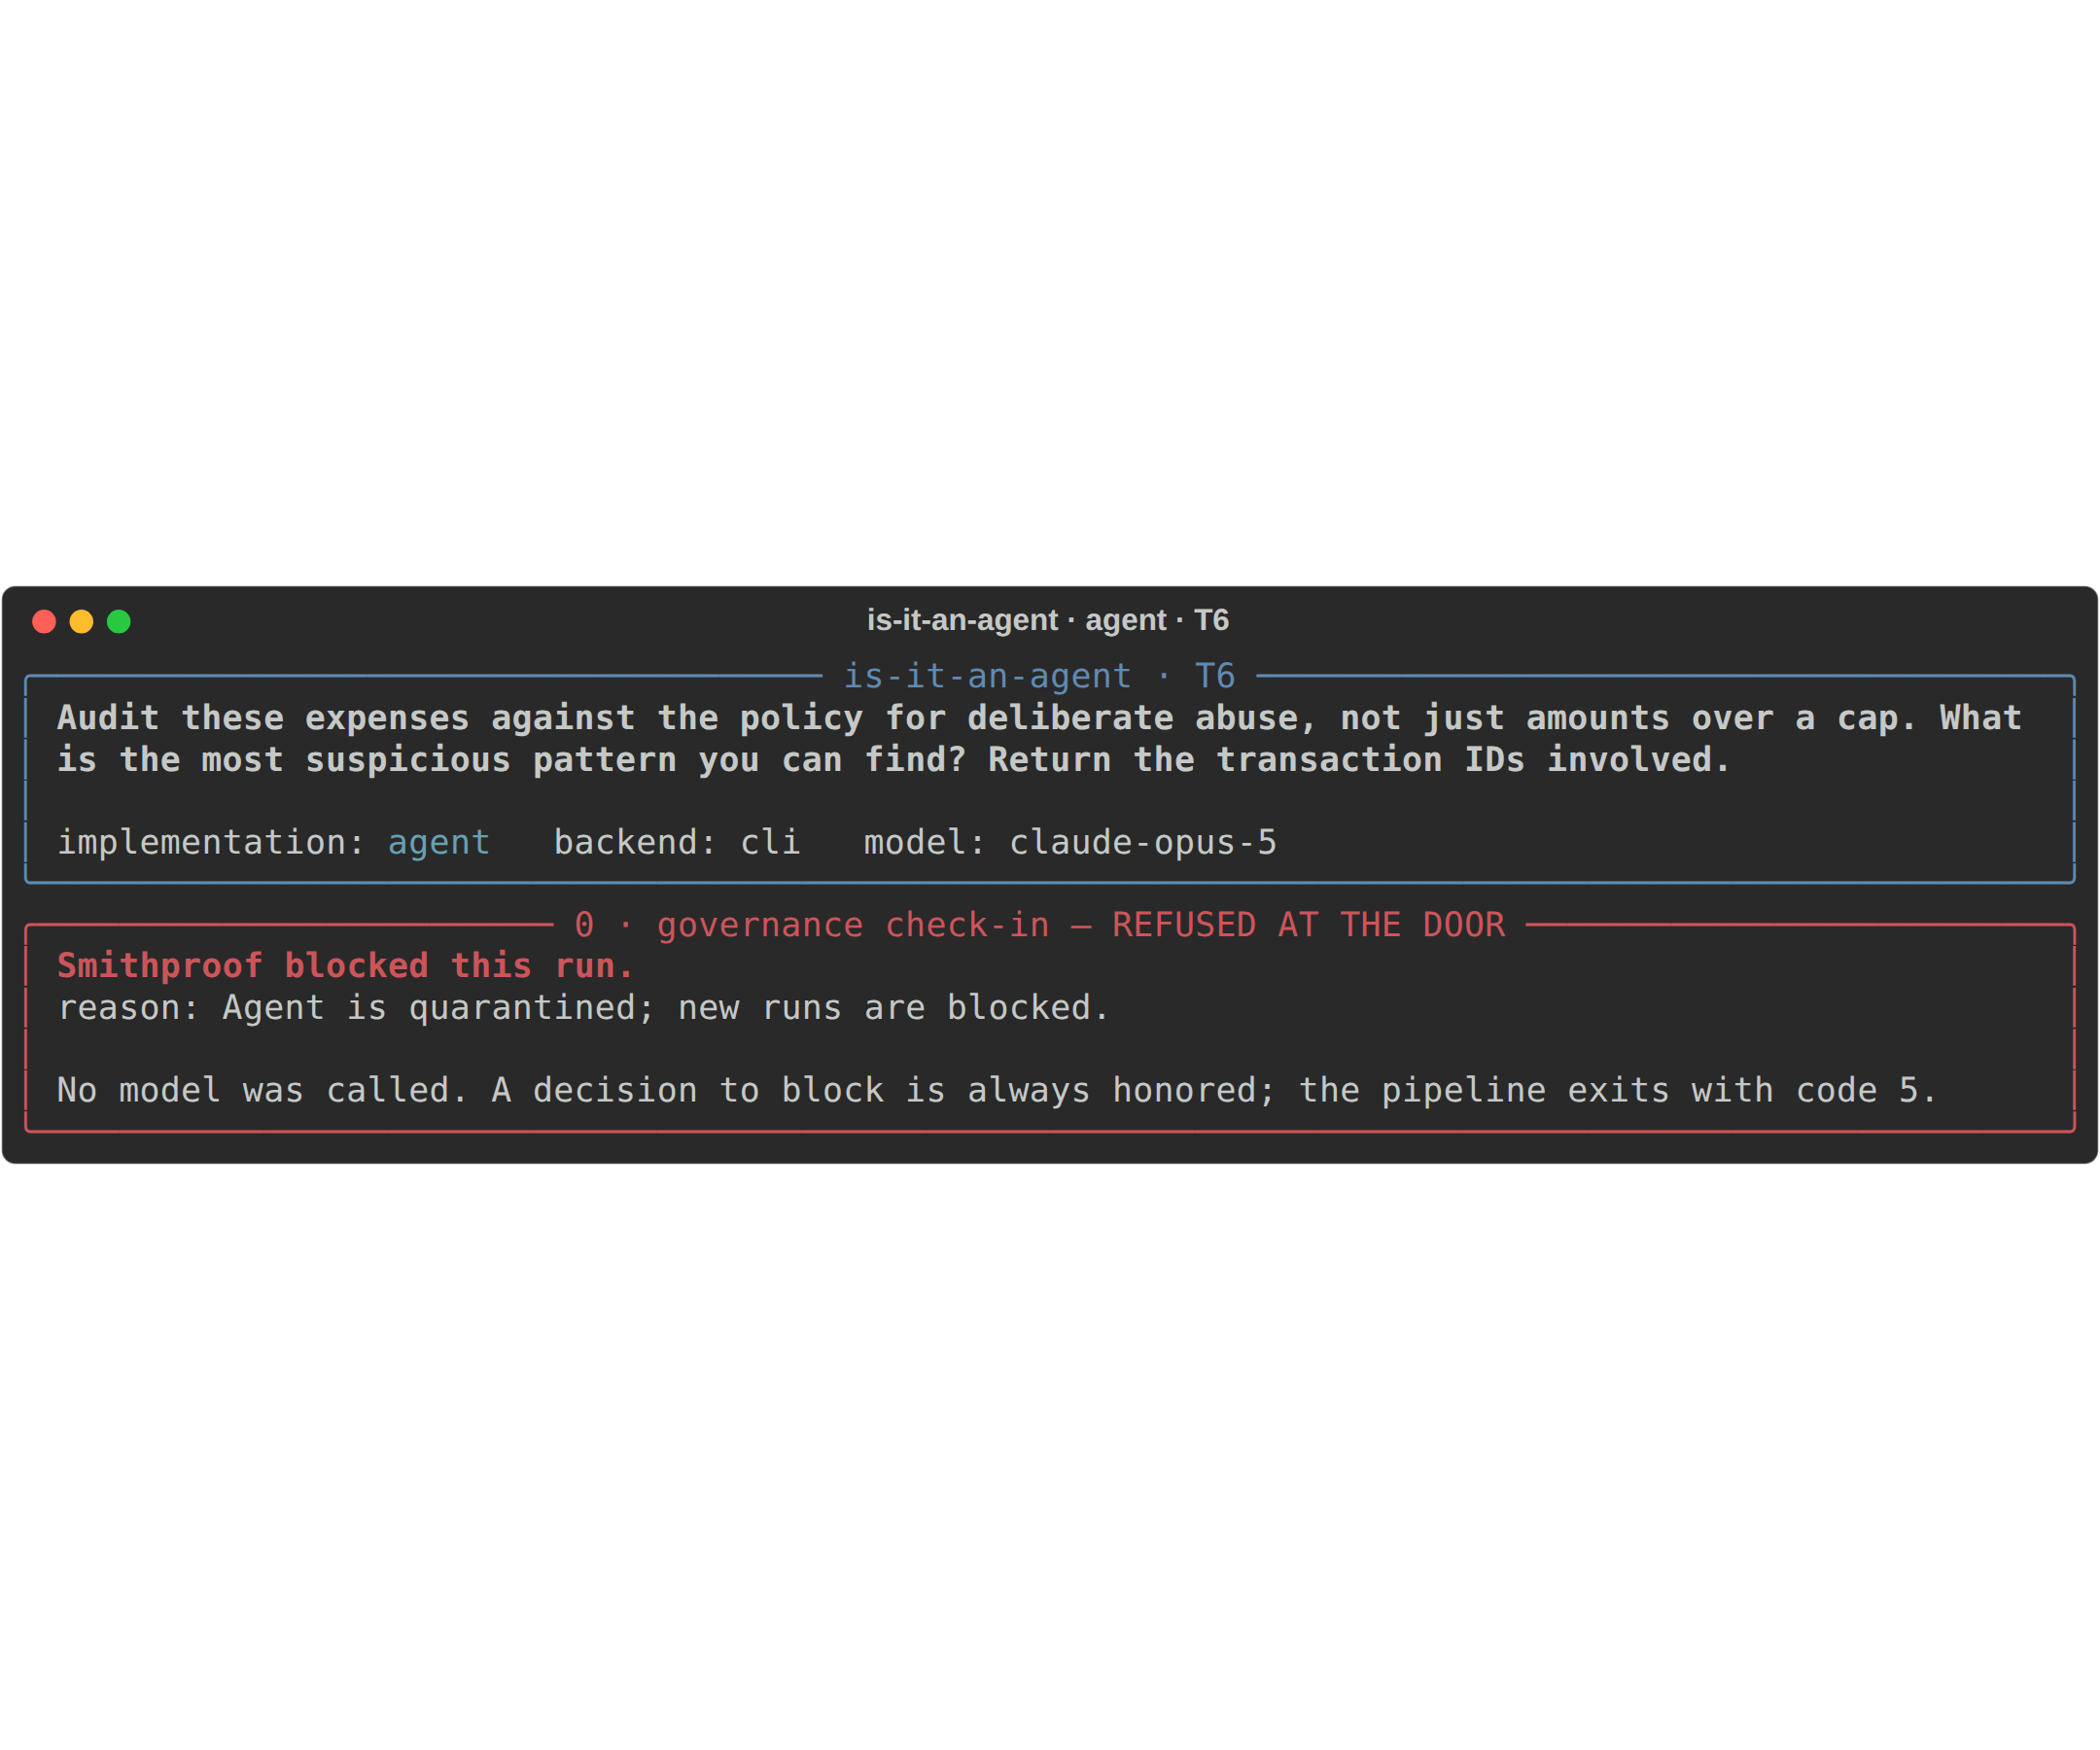 Uma decisão de bloquear é sempre honrada. A semântica de falha é emprestada do meu projeto plan-to-pr: negar perante decisão, avisar perante indisponibilidade — um plano de controlo inacessível avisa e prossegue, porque a telemetria nunca deve ser a razão pela qual um build parte.
O orçamento aperta a meio da execução, que é onde tem de apertar num sistema que decide em tempo de execução quantas chamadas vai fazer. Uma política de limite de gastos recebe um veredicto antes de cada chamada ao modelo, e o motor de políticas lê o gasto registado da execução do lado do servidor — não um número fornecido pelo cliente, porque um limite que confia em quem chama contorna-se omitindo um campo. Com o limite apertado para dois cêntimos, uma execução real na tarefa aberta fez quatro chamadas e a quinta foi recusada antes de ser colocada:
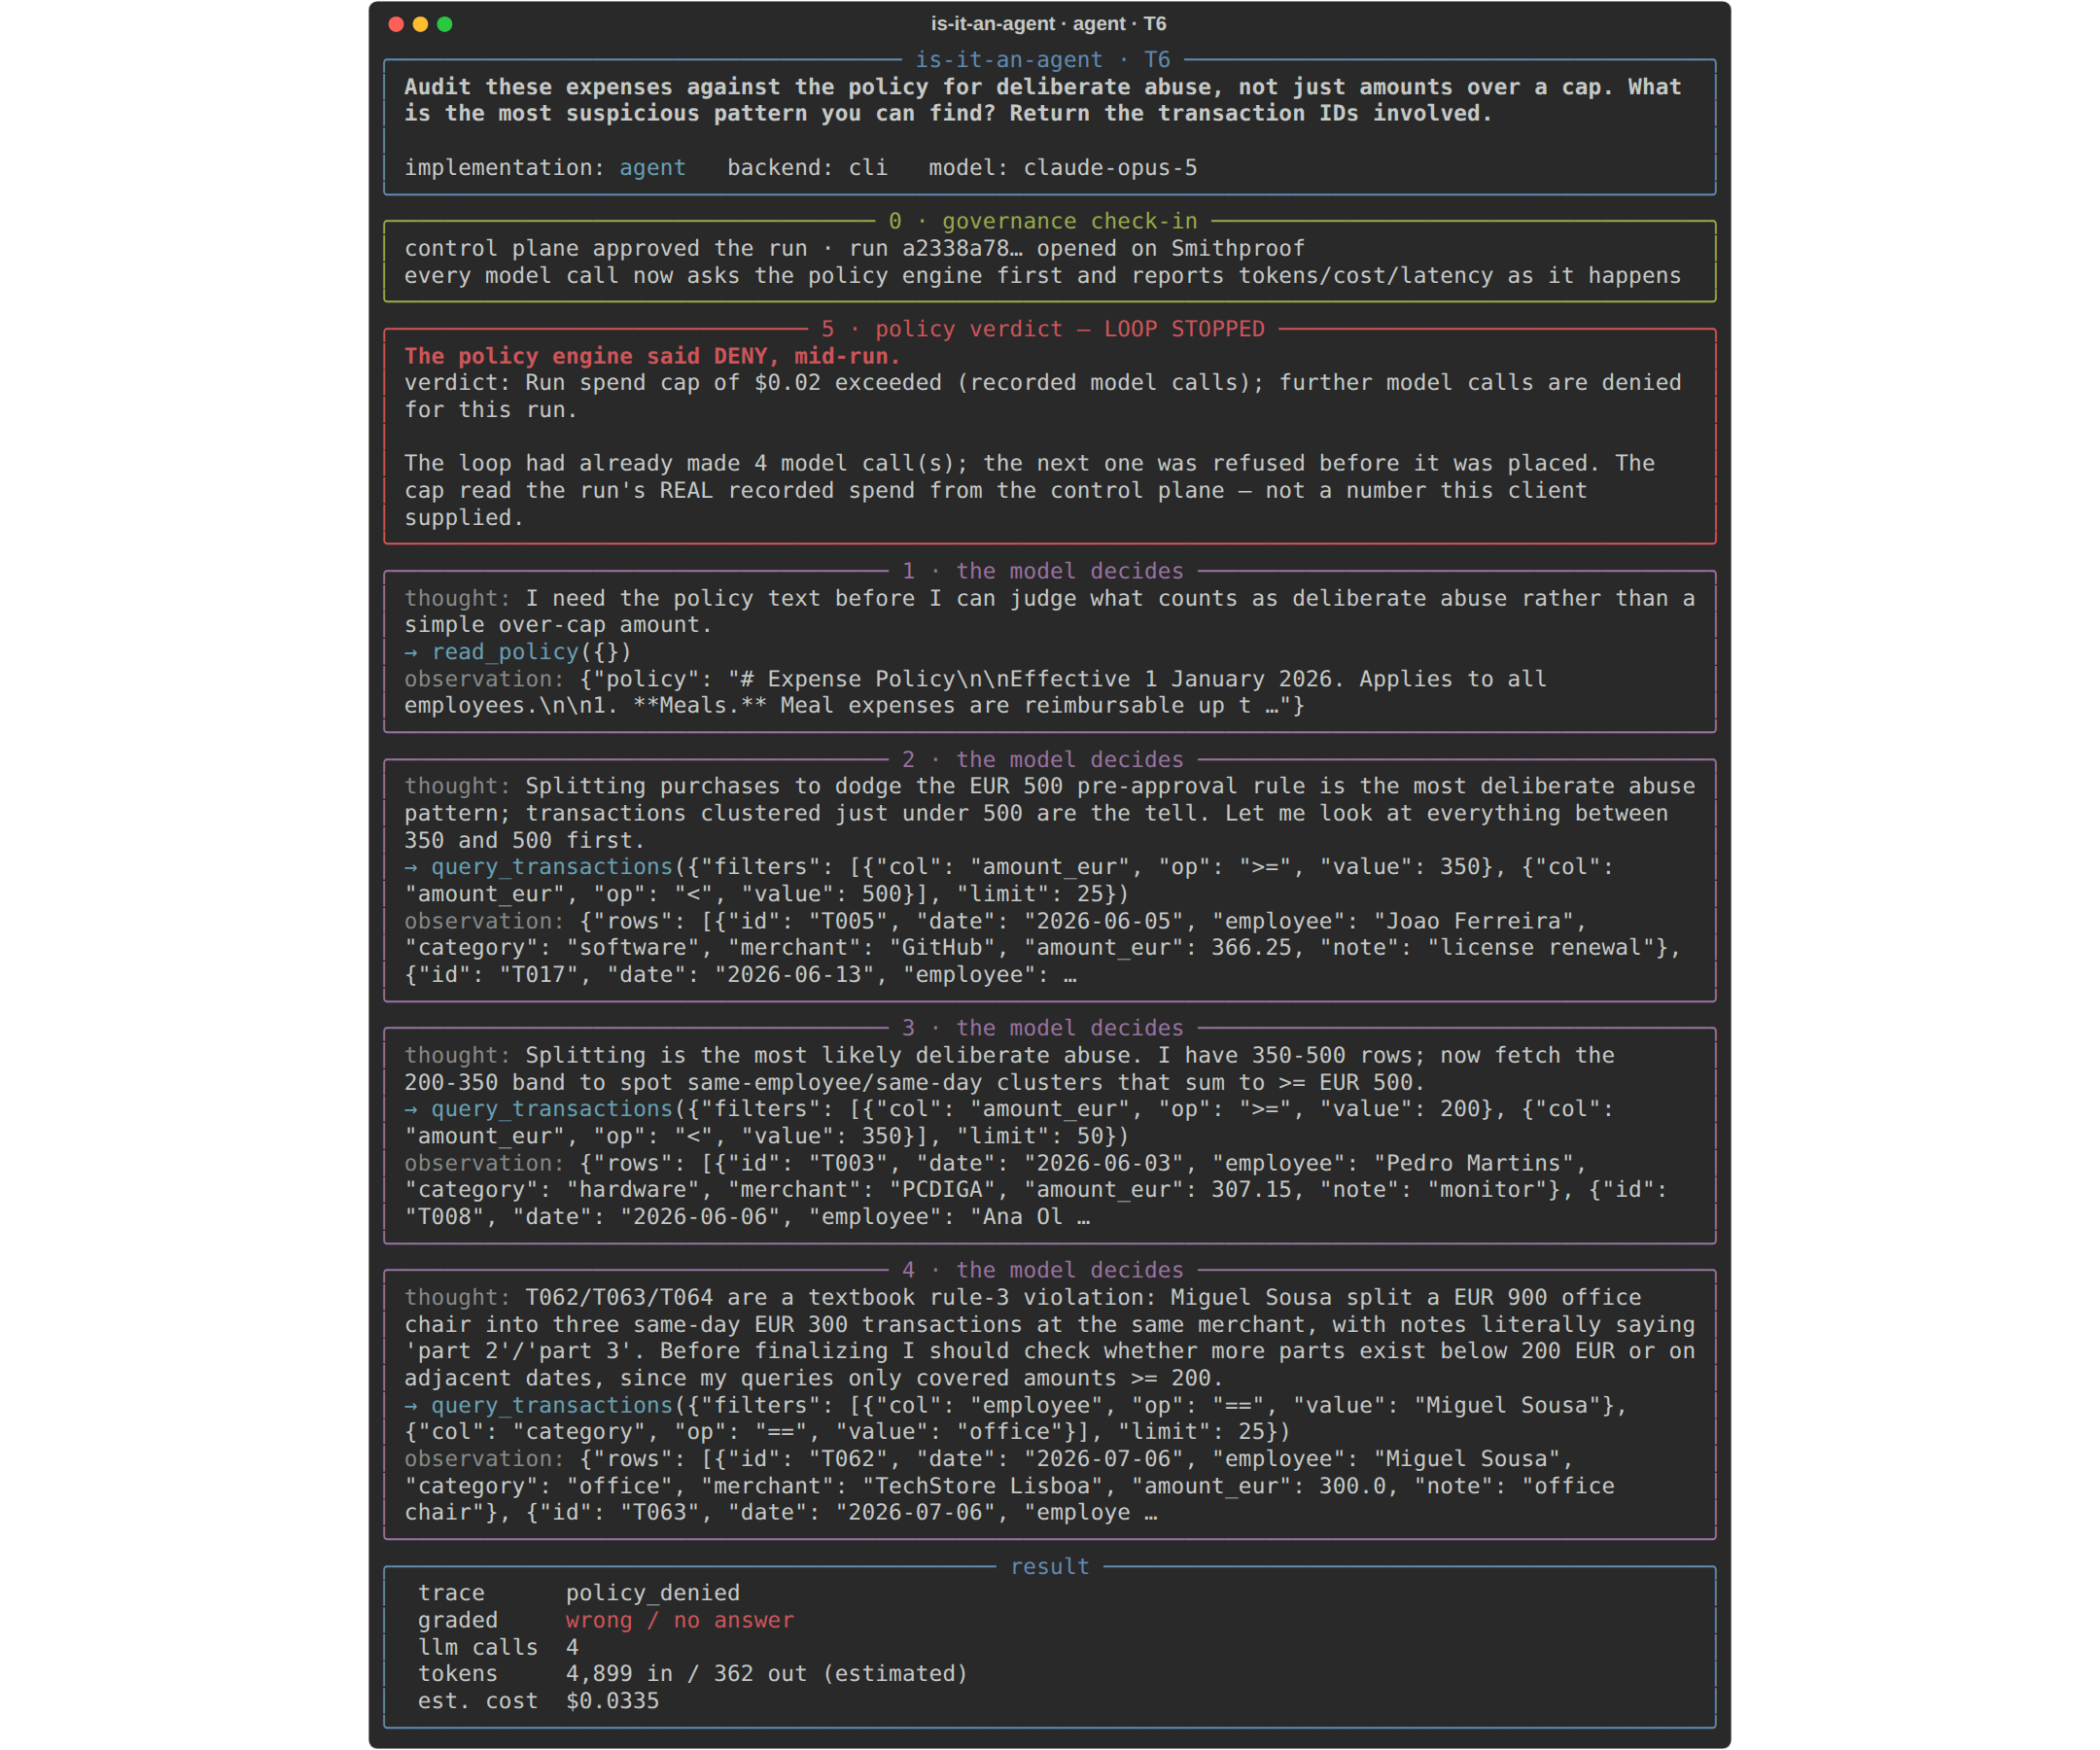 O ciclo para onde o veredicto cai. O custo da função conhece-se antes de a chamar; o do workflow ficou fixado em tempo de autoria; só o agente precisa de um ponto de aplicação dentro do ciclo.
O lado do tracing revelou-se discretamente satisfatório: com as chamadas de ferramentas a entrar como spans, a vista de execução do plano de controlo reconstrói o ritmo inteiro do ciclo — decidir, agir, observar, decidir — só a partir da telemetria:
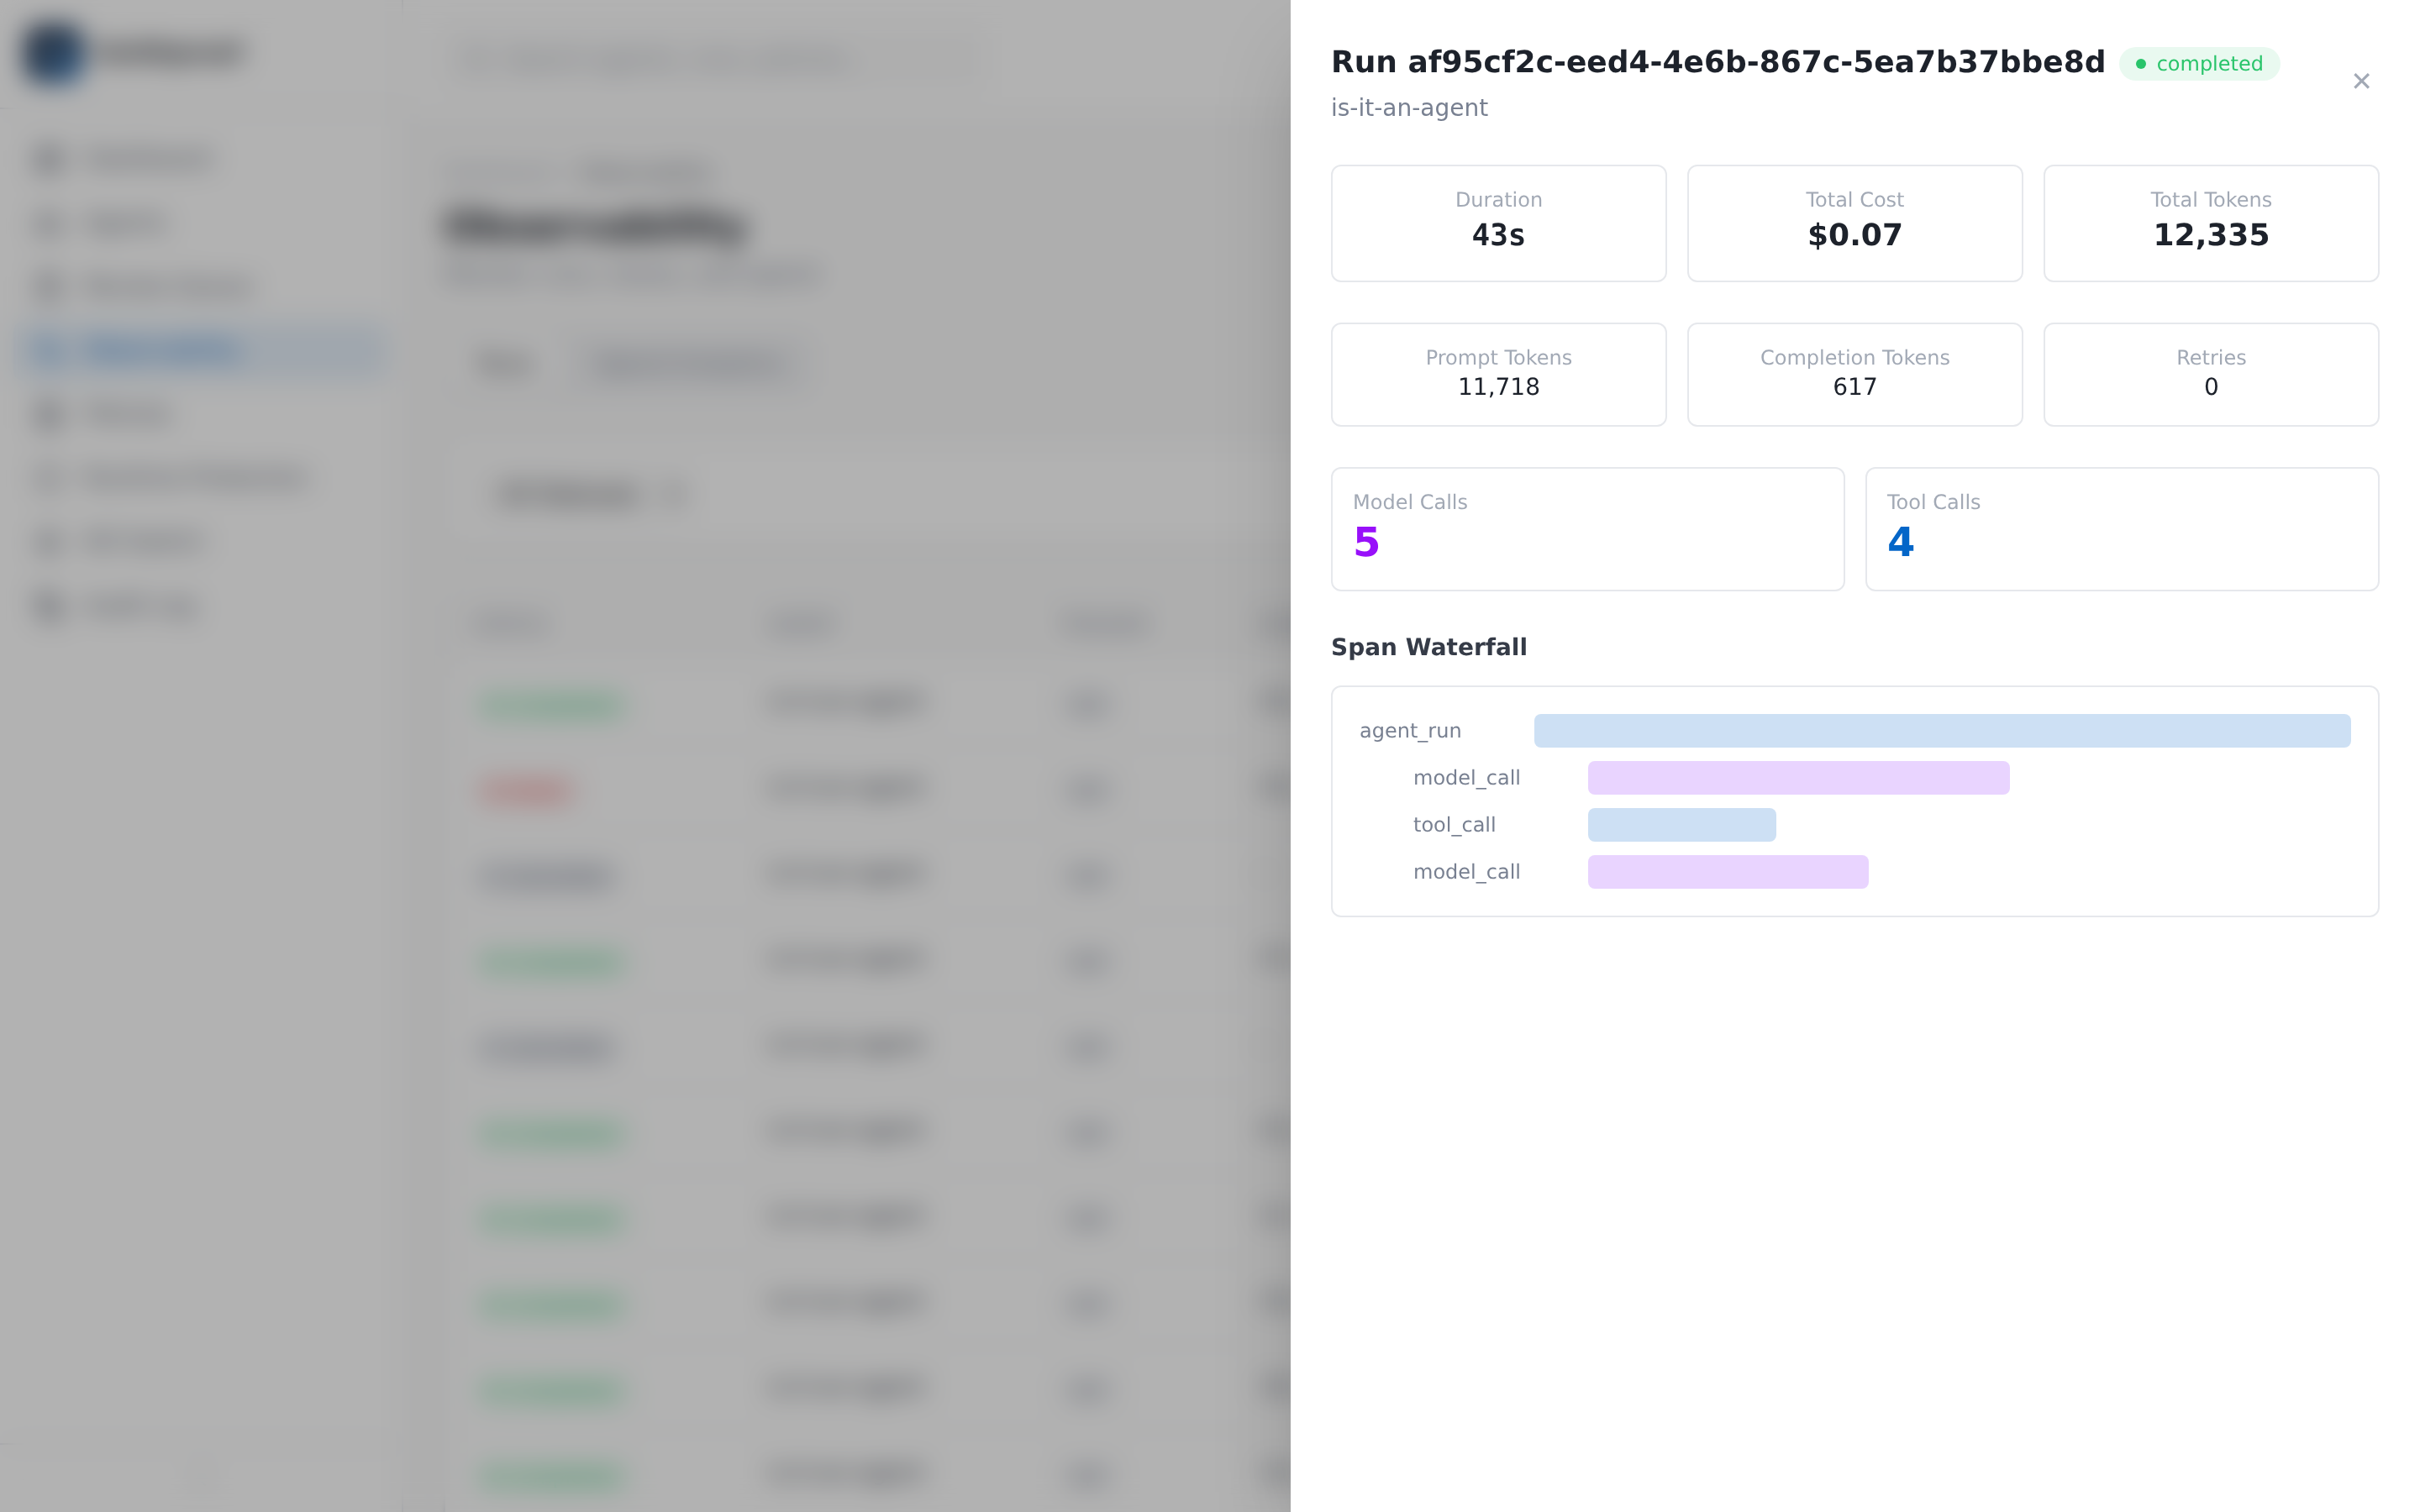 O ritmo ReAct, recuperado do exterior. Não se consegue esta vista de uma função; não há nada para ver além de um bloco.
E na única tarefa em que o agente teve liberdade real — a auditoria aberta, cujas conclusões nomeiam um funcionário —, a execução governada não liberta o seu veredicto por autoridade própria. Deposita as conclusões numa fila de revisão e bloqueia até um operador aprovar ou rejeitar:
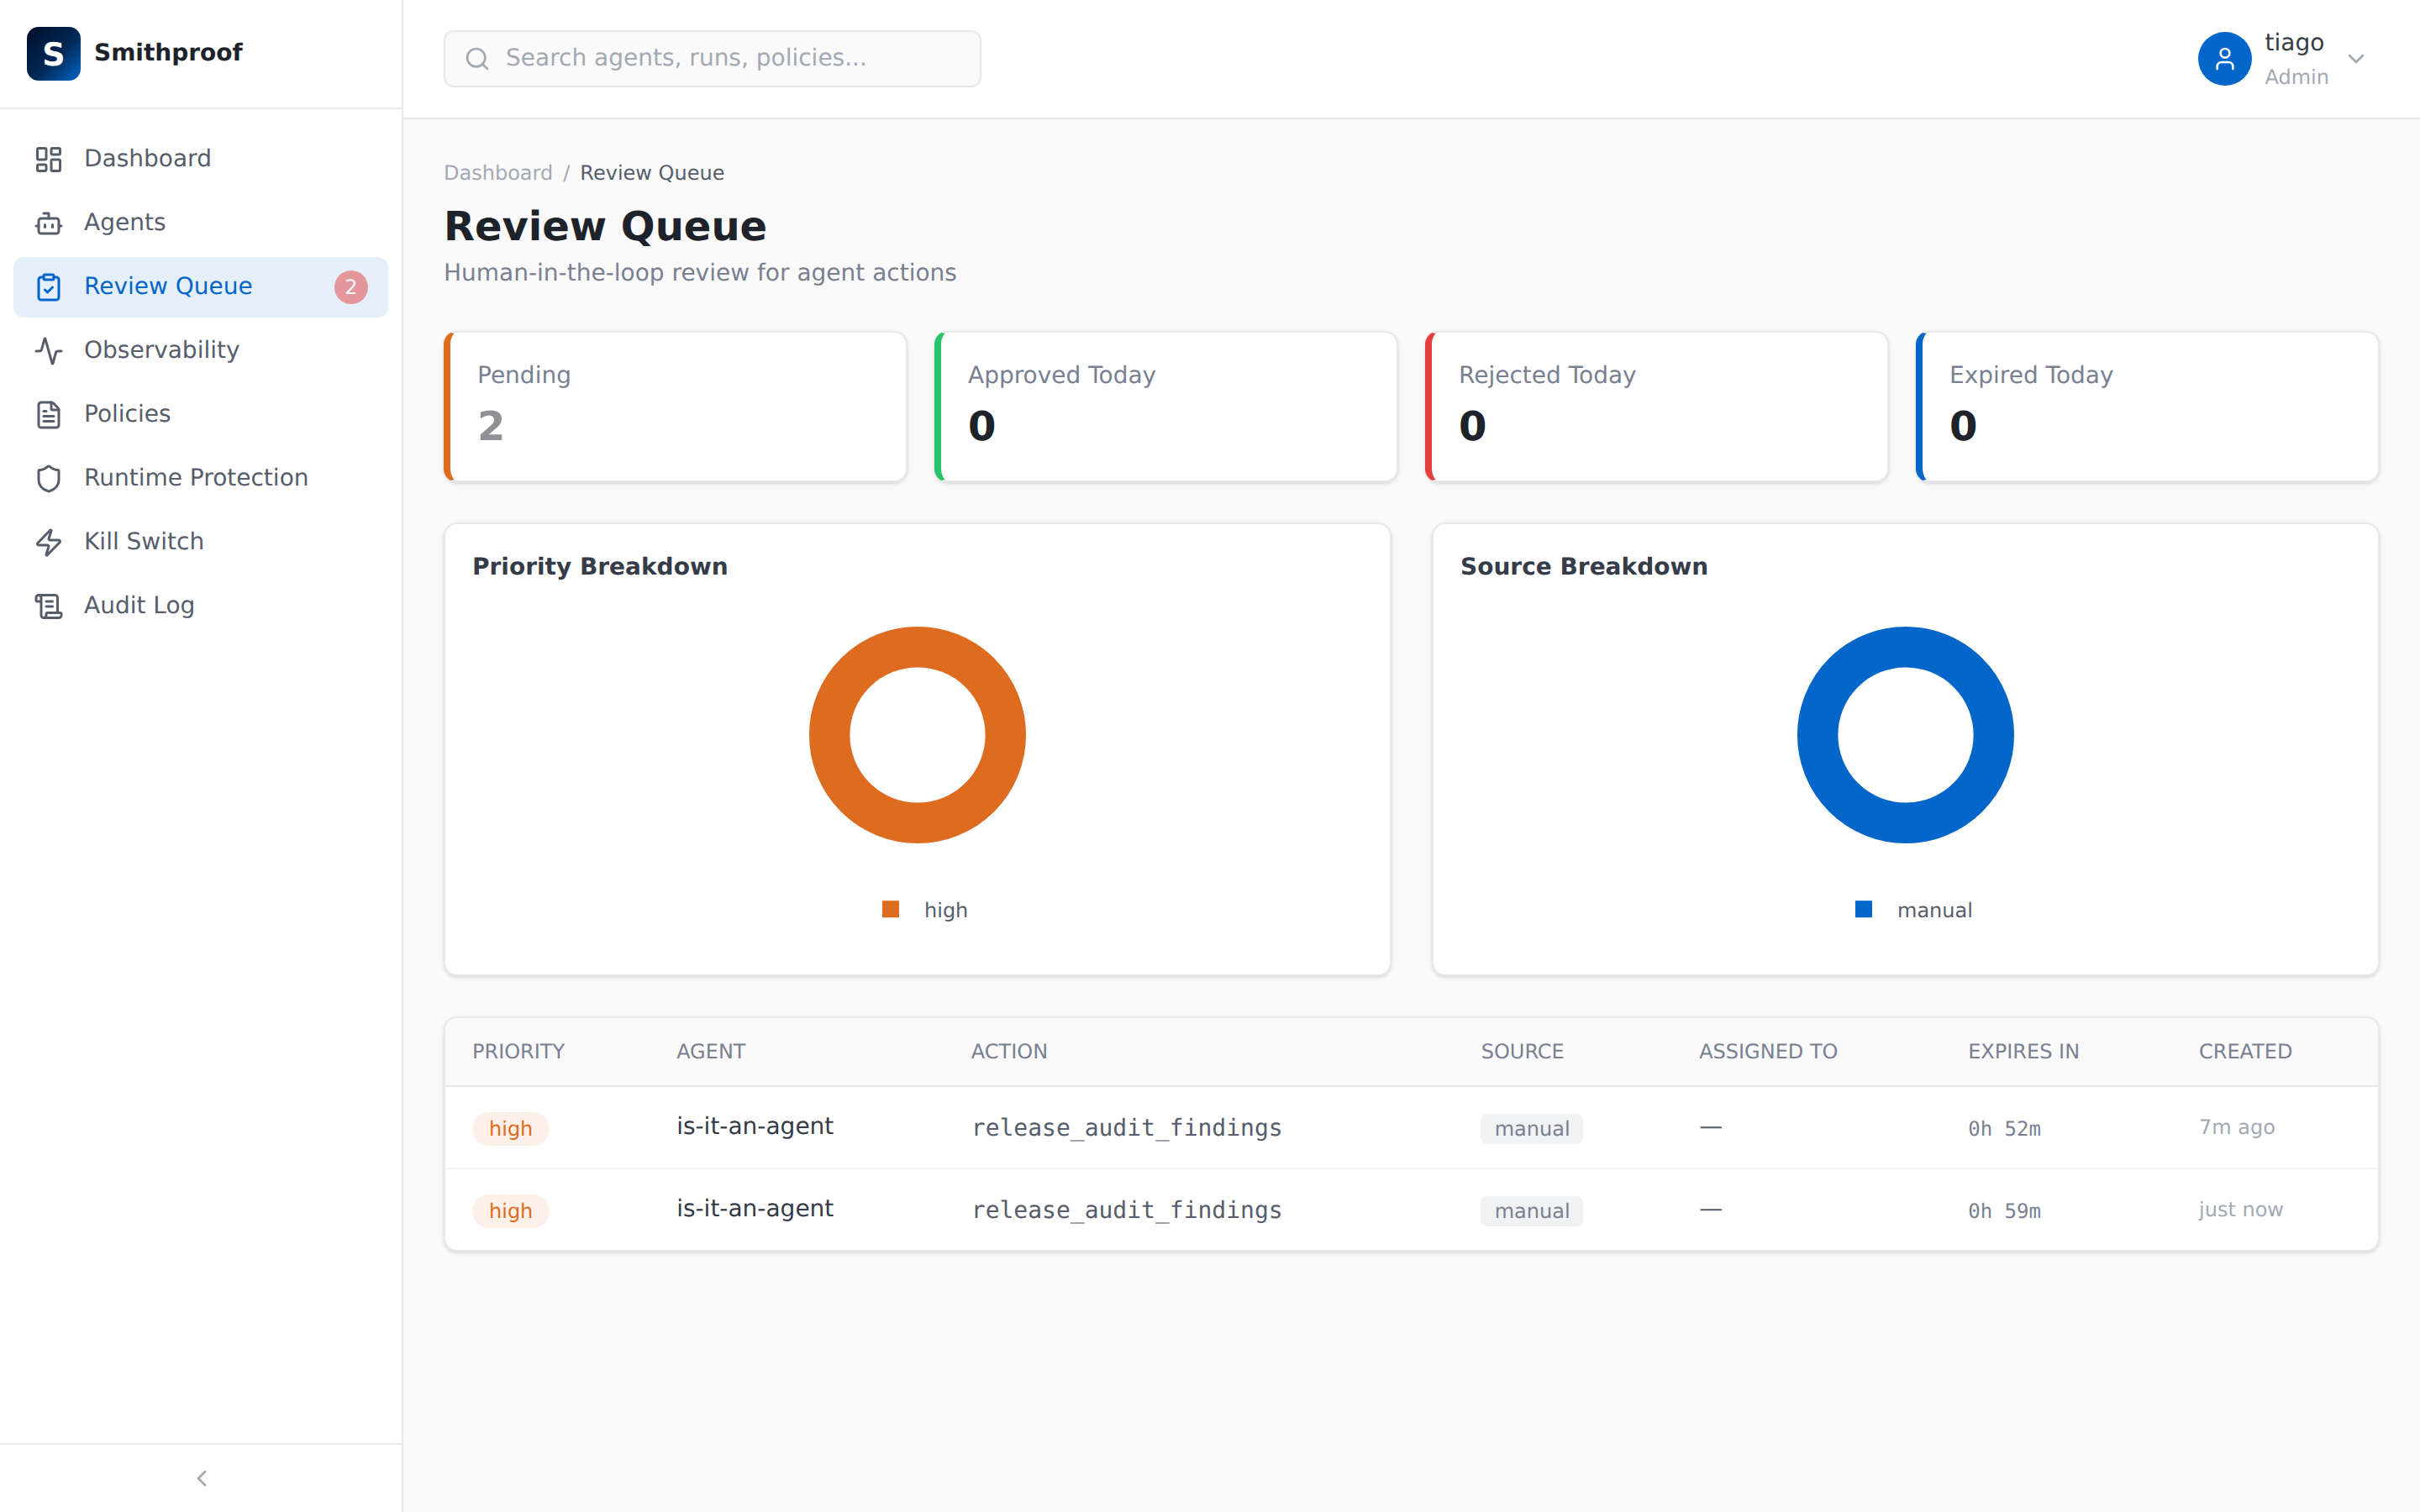 Repare-se onde está o portão: não nas perguntas bem especificadas, cuja resposta é um número que qualquer pessoa pode recalcular, mas exatamente na banda onde o modelo teve liberdade. O esforço de revisão segue a liberdade em tempo de execução.
Tente-se correr o workflow sob qualquer uma destas proteções e a pergunta responde-se sozinha. Não há porta onde recusá-lo. As suas duas chamadas ao LLM preenchem espaços numa cadeia cuja forma ficou fixada quando a escrevi. A fatura da governança é o preço da liberdade em tempo de execução, e só uma das três formas a deve.
Para que serve a palavra
Nada disto é um argumento contra funções ou workflows. As medições argumentam a favor deles, em voz alta, sempre que a pergunta é enumerável: o workflow igualou a exatidão do agente dentro das suas rotas a um oitavo do custo, com variância zero e nada para governar. Se o seu produto é uma função, lance a função, e desfrute do facto de ela nunca vir a precisar de um kill switch.
O argumento é que as três formas são objetos de engenharia diferentes com faturas diferentes agarradas, e a palavra "agente" existe para revelar que fatura se está a assinar. Variância que é preciso rastrear. Gasto que é preciso limitar em tempo de execução. Ações que precisam de um portão humano. Uma frota que é preciso conseguir parar. Quando um fornecedor chama agente a uma função tipada, está a cobrar o prémio de medo de uma forma enquanto entrega as garantias de outra — ou pior, está a ensinar que a palavra é ruído, mesmo antes de se instalar algo que decide de facto em tempo de execução e ninguém procurar o tracing, o orçamento ou o interruptor, porque os últimos três "agentes" nunca precisaram deles.
Faça o teste das dez execuções à próxima coisa que lhe venderem. Se todos os traces forem iguais, tem uma função ou um workflow — pague a fatura mais pequena, de bom grado. E se os traces variarem, tem um agente, e a variância não é a parte impressionante. É a fatura — e no dia em que os dados ultrapassarem o prompt, é também a única arquitetura ainda de pé para lha enviar.
Perguntas a que este artigo responde
O que distingue de facto um agente de um workflow?
O modelo decide o fluxo de controlo em tempo de execução: que ferramenta chamar, se volta a iterar, quando parar. O ensaio da Anthropic sobre construir agentes eficazes traça a mesma linha: os workflows orquestram LLMs através de caminhos de código predefinidos, os agentes dirigem o seu próprio processo. Uma cadeia fixa de classificar, executar e compor é um workflow, tenha as chamadas ao LLM que tiver, porque todos os caminhos que pode tomar foram enumerados por um humano em tempo de autoria.
Como é que verifico se aquilo a que um fornecedor chama agente é mesmo um agente?
Corra-o dez vezes sobre a mesma entrada e olhe para a estrutura dos traces, não para a redação da resposta. Se a estrutura nunca variar, ferramentas diferentes e um número de passos diferente, é uma função ou um workflow: na grelha medida ambos produziram exatamente uma forma de trace, enquanto o agente produziu cinco na tarefa aberta. Há uma quarta forma do teste, que lê a definição ao contrário: se o sistema não precisa de tracing, de um limite de orçamento e de uma forma de lhe dizer que não, nunca foi um agente.
Se uma única chamada grande ao LLM dá a resposta certa, para que serve o agente?
Com dados pequenos não serve, e as medições dizem-no com clareza. Com o livro-razão de 116 linhas todo no prompt, a chamada única da função acertou 40 vezes em 40, incluindo encontrar a fraude plantada, a $0,0123 por execução. O problema é que o seu custo é linear nos dados: com 4.989 linhas a mesma resposta correta custou $0,45 por pergunta contra os $0,036 do agente, e com 49.889 linhas o prompt excedeu a janela de contexto, a única jogada da arquitetura ficou indisponível e fez zero em cinco sem colocar uma única chamada ao modelo.
O que custa um agente que um workflow não custa?
Variância que é preciso rastrear, gastos que é preciso limitar com o ciclo ainda a correr, ações que precisam de um portão humano e uma frota que é preciso conseguir parar. Neste projeto a implementação do agente corre governada contra um plano de controlo: com o limite apertado para dois cêntimos, uma execução real fez quatro chamadas ao modelo e a quinta foi recusada antes de ser colocada, e o motor de políticas lê o gasto registado da execução do lado do servidor em vez de confiar num número fornecido pelo cliente. O workflow não deve nada disto, porque as suas duas chamadas ao LLM preenchem espaços numa cadeia cuja forma ficou fixada quando o código foi escrito.
Ler a seguir
 AI Agents
A Minha IA Conhece-me na Perfeição. Não Faz Ideia do Que Eu Quero
Dei a um modelo de fronteira um registo-exemplo de 90 dias construído a partir dos meus hábitos reais e depois fiz com que esta noite fosse diferente do registo. 180 execuções avaliadas depois: a memória não cega o modelo quando a pista está na sala, o verdadeiro produto da memória é o silêncio nas noites vulgares — e na única vez em que eu precisava de uma pergunta, o assistente que sabia tudo carregou no play precisamente no episódio que eu andava a evitar, e ofereceu-me um chá para a ocasião. AI
O Jev responde em probabilidades. A pergunta continua a ser tua.
O Jev, da TypeSafe, não escreve uma frase. Entregas-lhe um estado e perguntas tipadas, e ele devolve uma escolha, uma pontuação ou uma probabilidade de sim ou não, por quatro milésimos de cêntimo numa decisão de mil tokens. A novidade é a forma, que devolve a autoridade ao teu código, e a armadilha é que uma probabilidade parece recurso e não é. Corri o piloto que eu quereria ver antes de acreditar em qualquer número, nos meus próprios ensaios com o modelo aberto que fez as vezes do Jev, e a resposta foi não.