
Ist das wirklich ein Agent? Ich habe dieselbe Aufgabe dreimal gebaut, um es herauszufinden
Artikel anhören (experimentell) · 21:08
Im Marketing von KI-Produkten passiert etwas, das ich nicht mehr komisch finde. Ein Team verpackt einen LLM-Aufruf in eine Funktion — typisierte Eingaben, eine Completion, typisierte Felder als Ausgabe — und verkauft sie als Agent. Eine Pipeline aus drei Prompts wird zum Multi-Agenten-System. Das Wort leistet Verkaufsarbeit, keine Ingenieursarbeit, und das Ärgerliche ist nicht die Inflation selbst. Es ist, dass "Agent" eine spezifische, nützliche, falsifizierbare Behauptung trägt, und wer es als Synonym für "hat irgendwo ein LLM drin" benutzt, zerstört das eine Wort, das wir für diese Behauptung hatten.
Die Behauptung lautet: Das Modell entscheidet den Kontrollfluss zur Laufzeit. Welches Werkzeug aufgerufen wird. Ob noch eine Schleife gedreht wird. Wann Schluss ist. Anthropics Essay über den Bau effektiver Agenten zieht genau diese Linie — Workflows orchestrieren LLMs entlang vordefinierter Codepfade, Agenten steuern ihren eigenen Prozess — und ich habe mich in meinem Beitrag über die Landschaft der Agenten-Frameworks auf dieselbe Unterscheidung gestützt. Eine Funktion, die strukturierte Felder aus Text extrahiert, ist strukturierte Extraktion. Eine feste Folge aus Klassifizieren, Ausführen, Zusammenfassen ist ein Workflow. Beides sind ausgezeichnete Dinge mit existierenden Namen, und keines von beiden wird dadurch zum Agenten, dass man es in einem Pitch Deck umbenennt.
Ich hätte es bei der Definition belassen können. Aber über Definitionen streitet es sich billig und über Messungen nicht, also habe ich dieselbe Aufgabe dreimal gebaut — einmal als Funktion, einmal als Workflow, einmal als Agent —, das gesamte Raster gegen ein Frontier-Modell laufen lassen und gemessen, was das Etikett tatsächlich kostet. Alles Folgende — Code, Daten, Harness und jeder Screenshot — stammt aus einem kleinen Projekt, das ich für diesen Beitrag gebaut und wirklich laufen lassen habe; nichts hier ist illustrativ oder nachgestellt.
Ein Test für das Ding, das man Ihnen verkauft hat
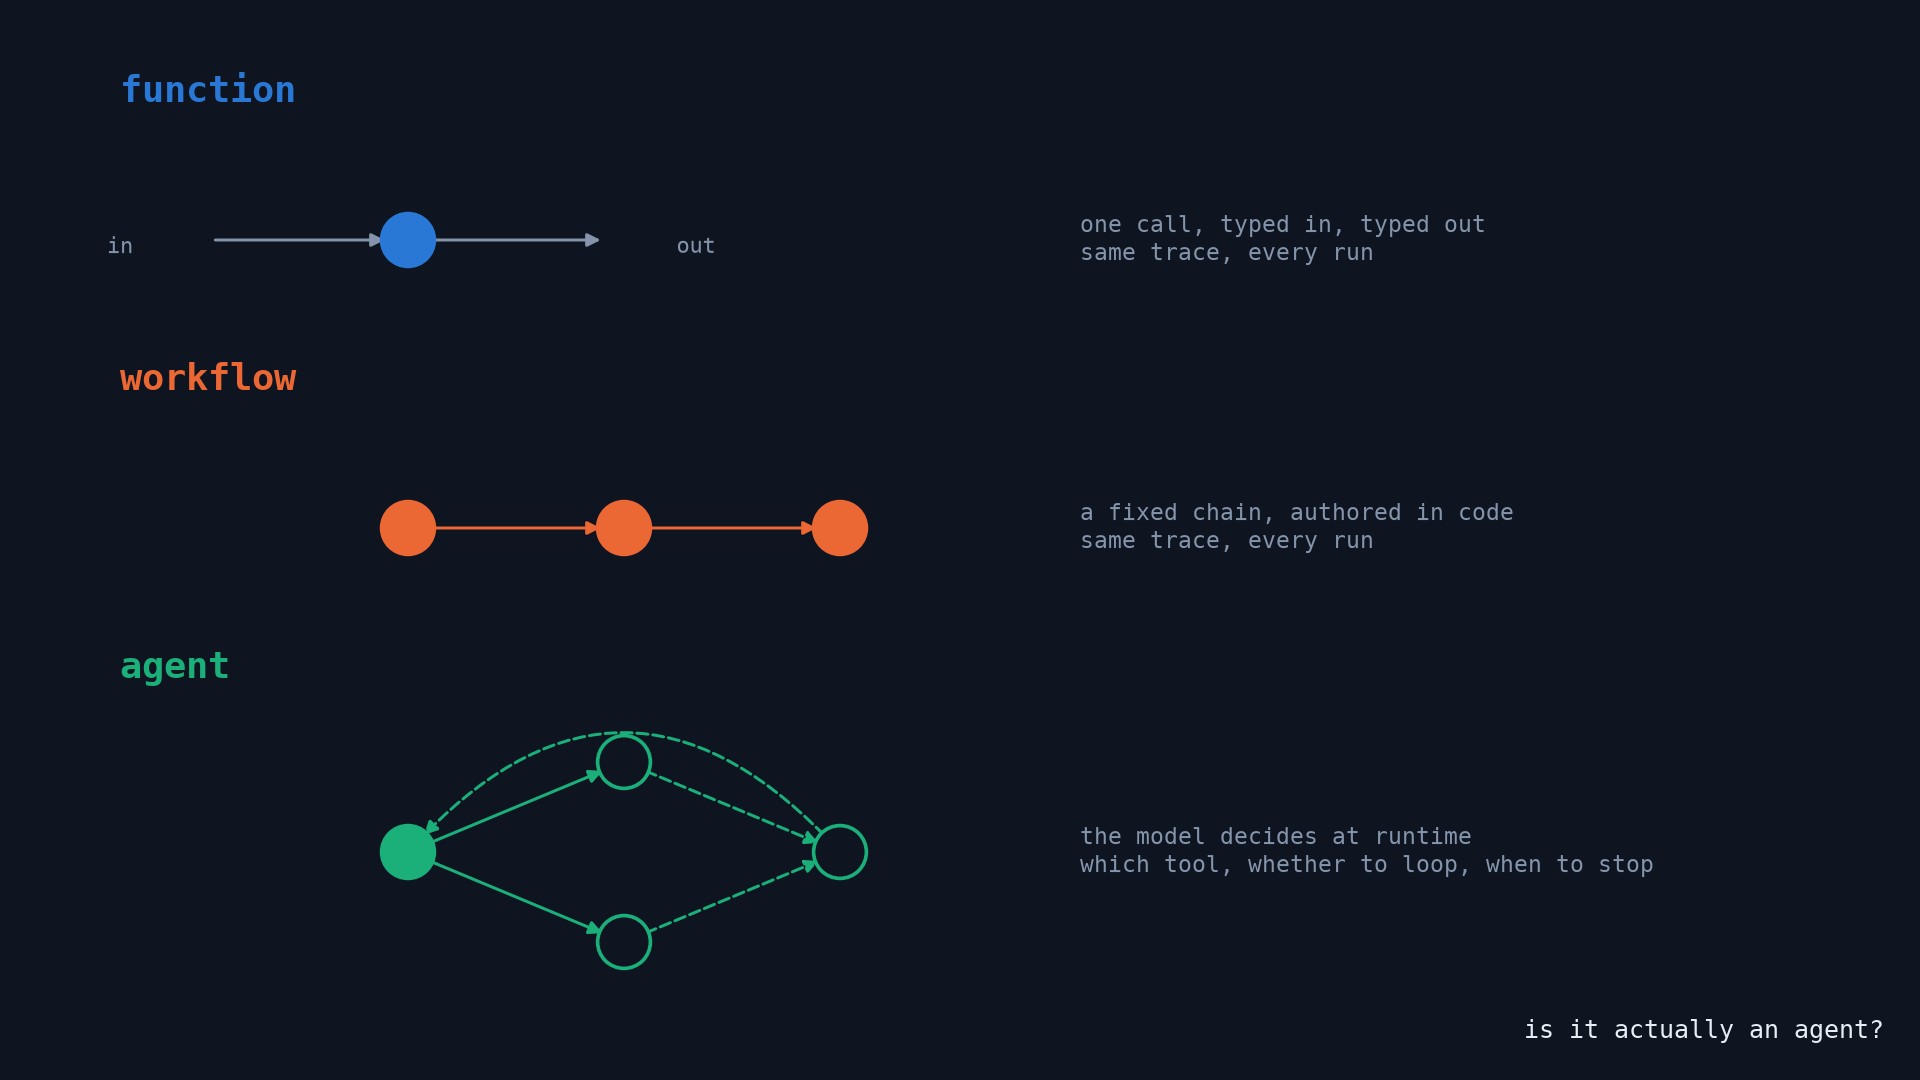
Vor dem Experiment der Test, den es hervorgebracht hat. Nehmen Sie das System, das jemand einen Agenten nennt, und lassen Sie es zehnmal auf derselben Eingabe laufen:
- Variiert die Struktur dessen, was passiert ist — andere Werkzeuge, andere Anzahl von Schritten — oder nur die Formulierung der Ausgabe? Wenn nur die Formulierung: eine Funktion.
- Kann es etwas tun, das niemand geskriptet hat? Wenn jeder mögliche Pfad zur Autorenzeit von einem Menschen aufgezählt wurde: ein Workflow.
- Hat es eine Abbruchbedingung, die es auswertet, statt eines Endes, das es erreicht? Schleifen entscheiden; Pipelines terminieren.
Und eine vierte Form des Tests, zu der ich immer wieder zurückkehre, liest die Definition rückwärts: Man erkennt einen Agenten daran, was er braucht. Wenn es kein Tracing braucht, keine Budgetgrenze und keinen Weg, ihm Nein zu sagen, war es nie ein Agent. Niemand baut einen Kill Switch in einen Serienbrief.
Das Experiment
Die Aufgabendomäne ist eine kleine Spesenprüfung: ein Hauptbuch mit 116 Transaktionen aus einem Generator mit festem Seed, mit drei eingepflanzten Betrugsmustern, und eine schriftliche Spesenrichtlinie. Sechs Fragen in drei Bändern — wohlspezifiziert ("Gesamte Reisekosten im Juni 2026"), Richtlinienanwendung ("Welche Essenstransaktionen überschreiten die Obergrenze der Richtlinie") und eine offene Frage ohne vorgeschriebenen Weg: "Finde das verdächtigste Muster und nenne die Transaktions-IDs." Die Referenzantworten werden zur Laufzeit aus dem CSV berechnet, mit derselben Abfrage-Engine, die auch die Implementierungen nutzen, niemals hartkodiert.
Die drei Implementierungen teilen sich Modell, Daten und Bewerter und unterscheiden sich nur darin, wem der Kontrollfluss gehört:
- Die Funktion: ein LLM-Aufruf, das gesamte Hauptbuch samt Richtlinie im Prompt, JSON als Ausgabe. Kontrollfluss: keiner.
- Der Workflow: klassifizieren → ausführen → formulieren. Das LLM wählt eine Route aus einem geschlossenen Enum und schreibt den Schlusssatz; die Arithmetik dazwischen ist deterministischer Code. Bei einer Frage außerhalb seiner Routen antwortet er mit einem ehrlichen "nicht unterstützt", statt zu improvisieren. Kontrollfluss: im Code festgeschrieben.
- Der Agent: eine handgeschriebene, vollständig sichtbare Werkzeugschleife. Das Modell liest die Frage, entscheidet, welches Werkzeug es aufruft — die Richtlinie lesen oder das Hauptbuch abfragen —, beobachtet das Ergebnis und entscheidet erneut, bis es sich fürs Aufhören entscheidet. Kontrollfluss: der des Modells, Zug um Zug, unter einer Zugobergrenze.
Kein Framework, mit Absicht. Jeder Mechanismus ist eine lesbare Datei, denn das Argument hängt davon ab, dass man sehen kann: Der einzige Unterschied ist, wo die Entscheidungen wohnen.
Was 120 bewertete Läufe tatsächlich gesagt haben
Fünf Läufe pro Zelle, zehn bei den varianzsensiblen Aufgaben, Claude Opus 5, August 2026:
| Ansatz | Erfolg | Ø LLM-Aufrufe | Ø gesch. Kosten/Lauf | Ø Laufzeit | verschiedene Trace-Formen (offene Aufgabe, 10 Läufe) |
|---|---|---|---|---|---|
| Funktion | 40/40 | 1,0 | $0,0123 | 11 s | 1 |
| Workflow | 30/40 | 2,0 | $0,0033 | 16 s | 1 |
| Agent | 40/40 | 3,4 | $0,0283 | 32 s | 5 |
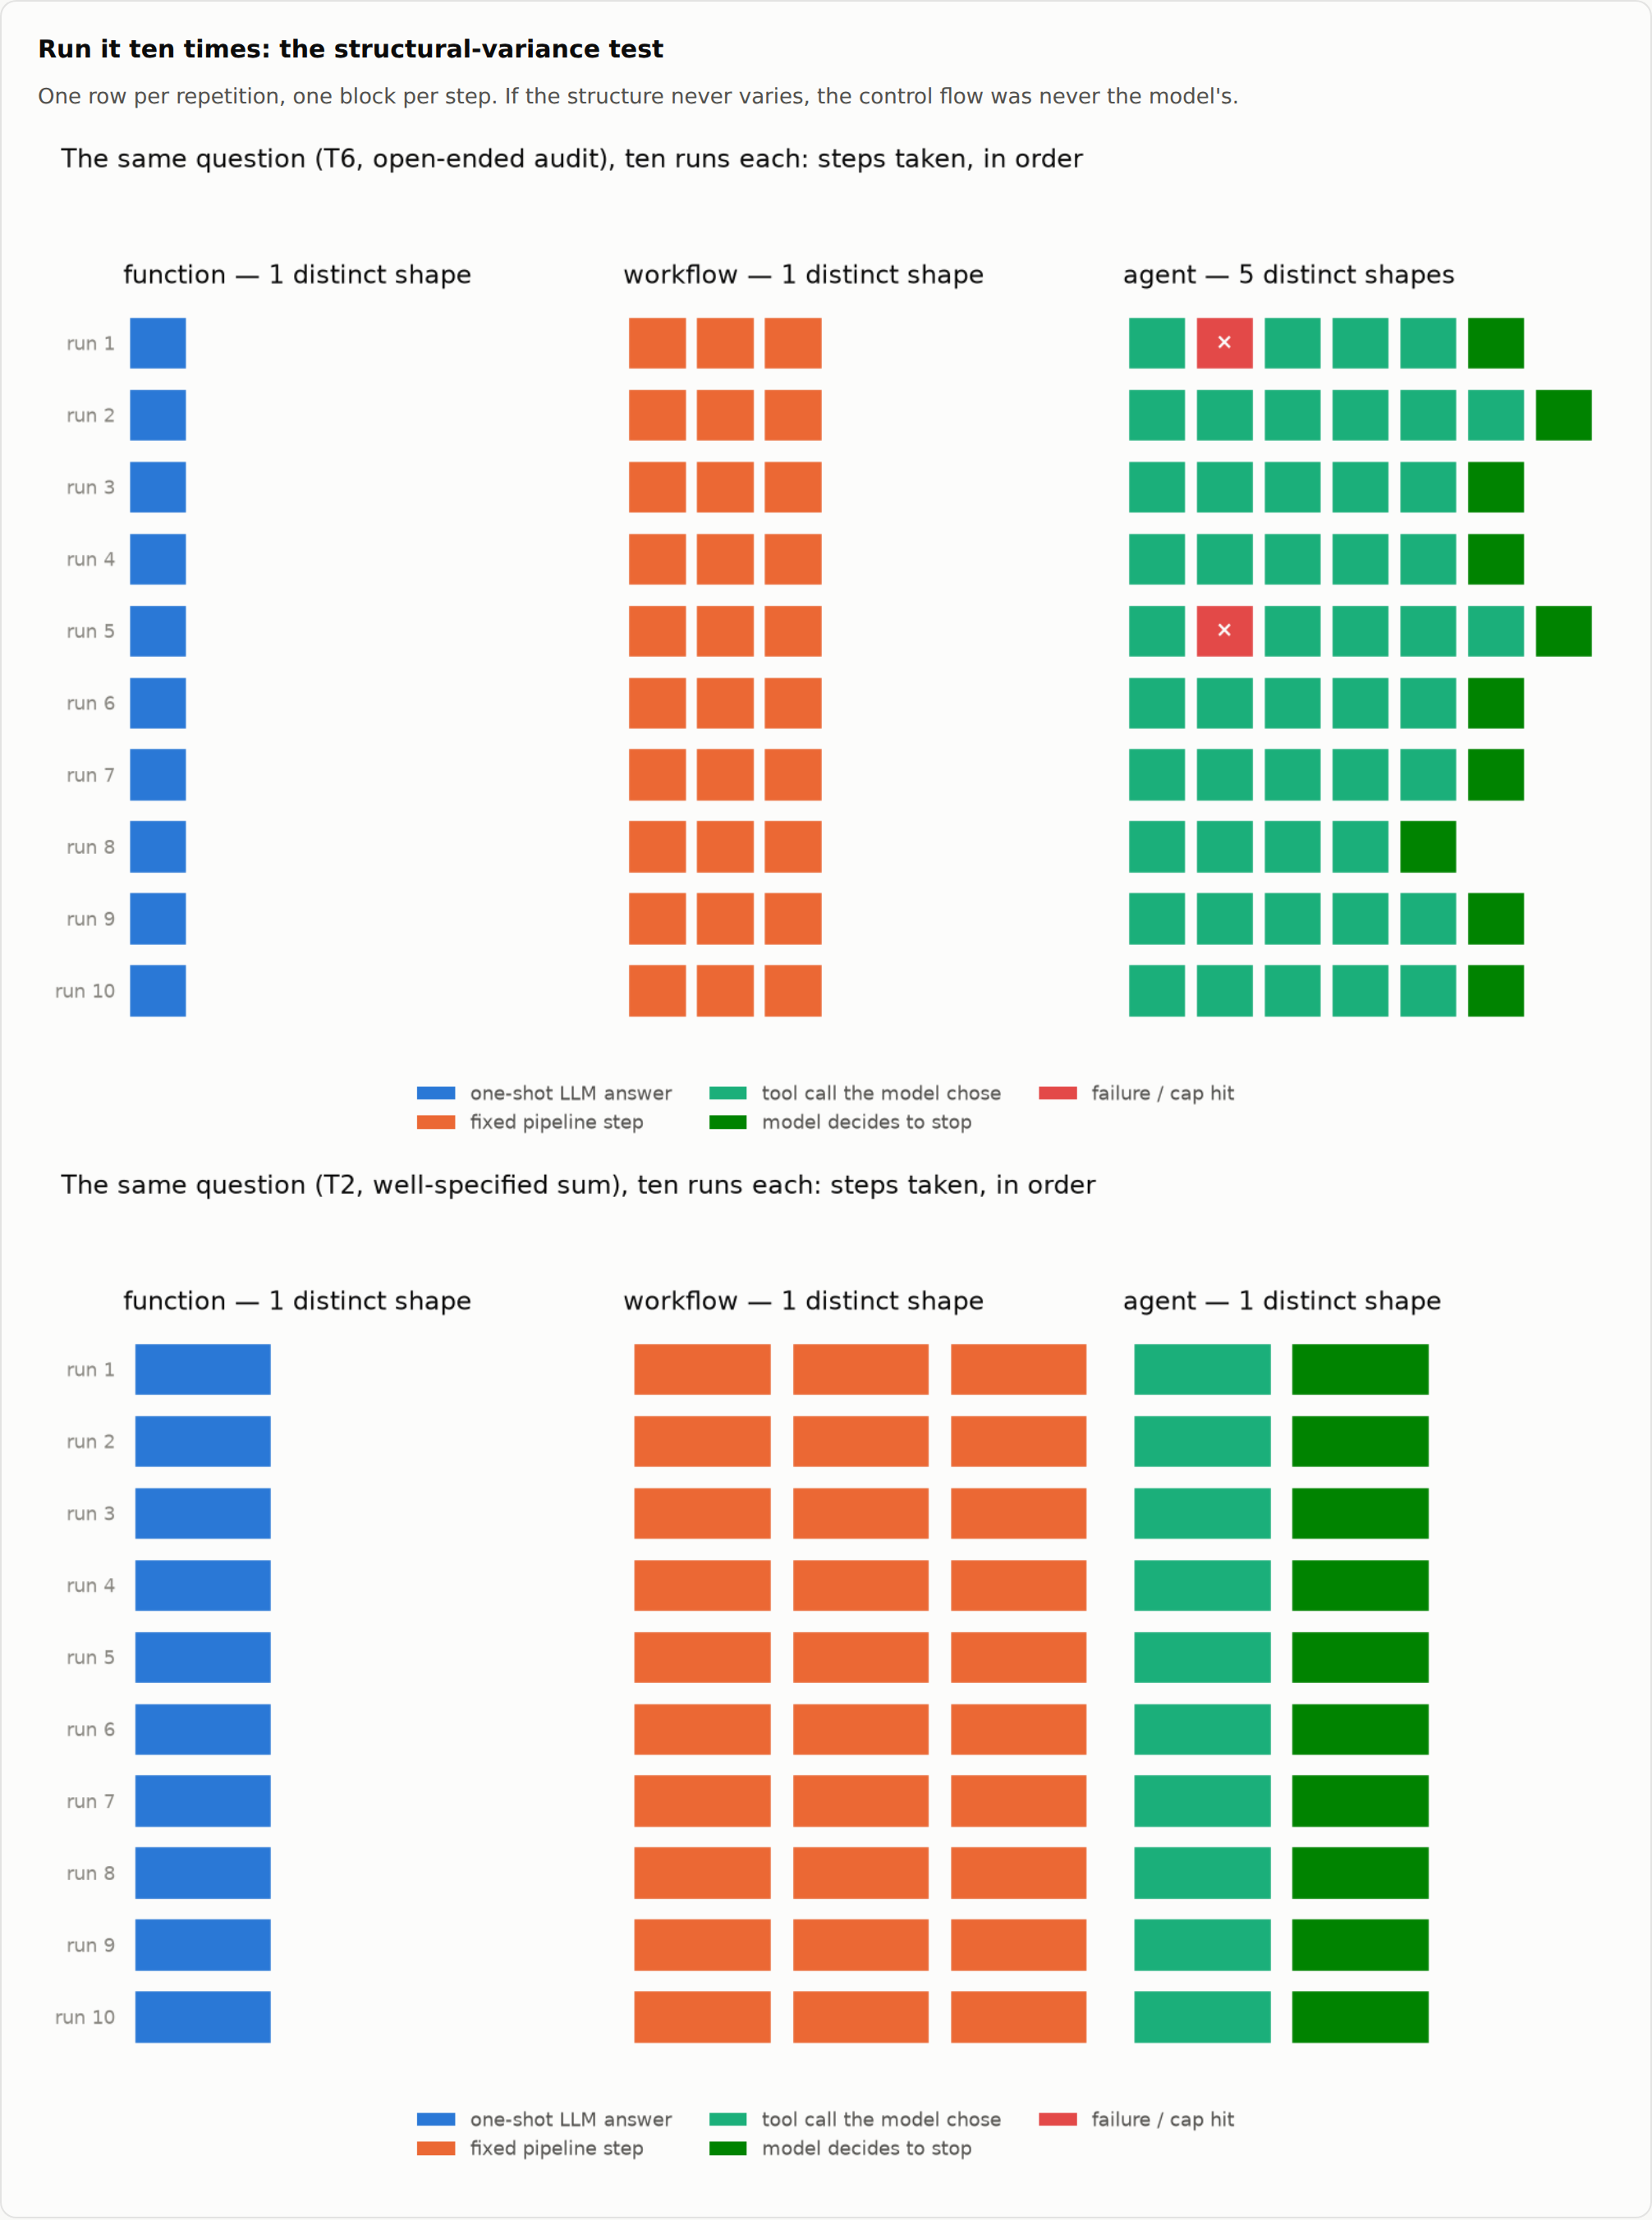 Der "Zehnmal laufen lassen"-Test, als Daten. Eine Trace-Form heißt: Die Struktur hat nie variiert. Fünf heißt: Das Modell hat fünf verschiedene Wege zur selben richtigen Antwort gewählt.
Drei Ergebnisse, ehrlich benannt, einschließlich derer, die gegen den Agenten sprechen.
Die Funktion hat alles richtig gemacht. Einschließlich dreißig Dezimalzahlen aus rohem CSV zu summieren und den eingepflanzten Betrug zu finden — denn ein Frontier-Modell mit dem kompletten 116-Zeilen-Hauptbuch im Kontext ist wirklich stark. Auf einem kleinen Datensatz ist die Schwäche der Funktion nicht die Genauigkeit. Es ist, dass ihre Kosten mit den Daten skalieren, ihr Kontextfenster ihre Decke ist und sie ihre Arbeit nicht zeigen kann: Die Trace ist ein opaker Block.
Der Workflow war innerhalb seiner Routen perfekt und außerhalb ehrlich. Seine Arithmetik ist Code, also kann eine korrekte Klassifikation keine falsche Zahl erzeugen, und seine Kosten sind pauschale ~$0,003, egal welche Frage — der günstigste der drei, um den Faktor 4. Seine dreißig "Fehlschläge" sind alle dasselbe wiederholte Ereignis: Auf die offene Frage antwortete er "nicht unterstützt", zehnmal von zehn, statt zu improvisieren. Workflows terminieren; sie erkunden nicht.
Der Agent hat sich seine Varianz genau einmal verdient — bei der Aufgabe, die niemand geskriptet hat. Bei der offenen Frage las er die Richtlinie, fragte das Band knapp unter dem Schwellenwert ab, bemerkte die "part 2 / part 3"-Notizen an einem Cluster von Transaktionen, bestätigte das Muster und benannte den gestückelten Einkauf — zehnmal von zehn, auf fünf verschiedenen Wegen. Bei den wohlspezifizierten Fragen kauften seine zusätzlichen Aufrufe nichts, was der Workflow nicht schon hatte, zum 2,3-fachen Preis der Funktion und der dreifachen Latenz.
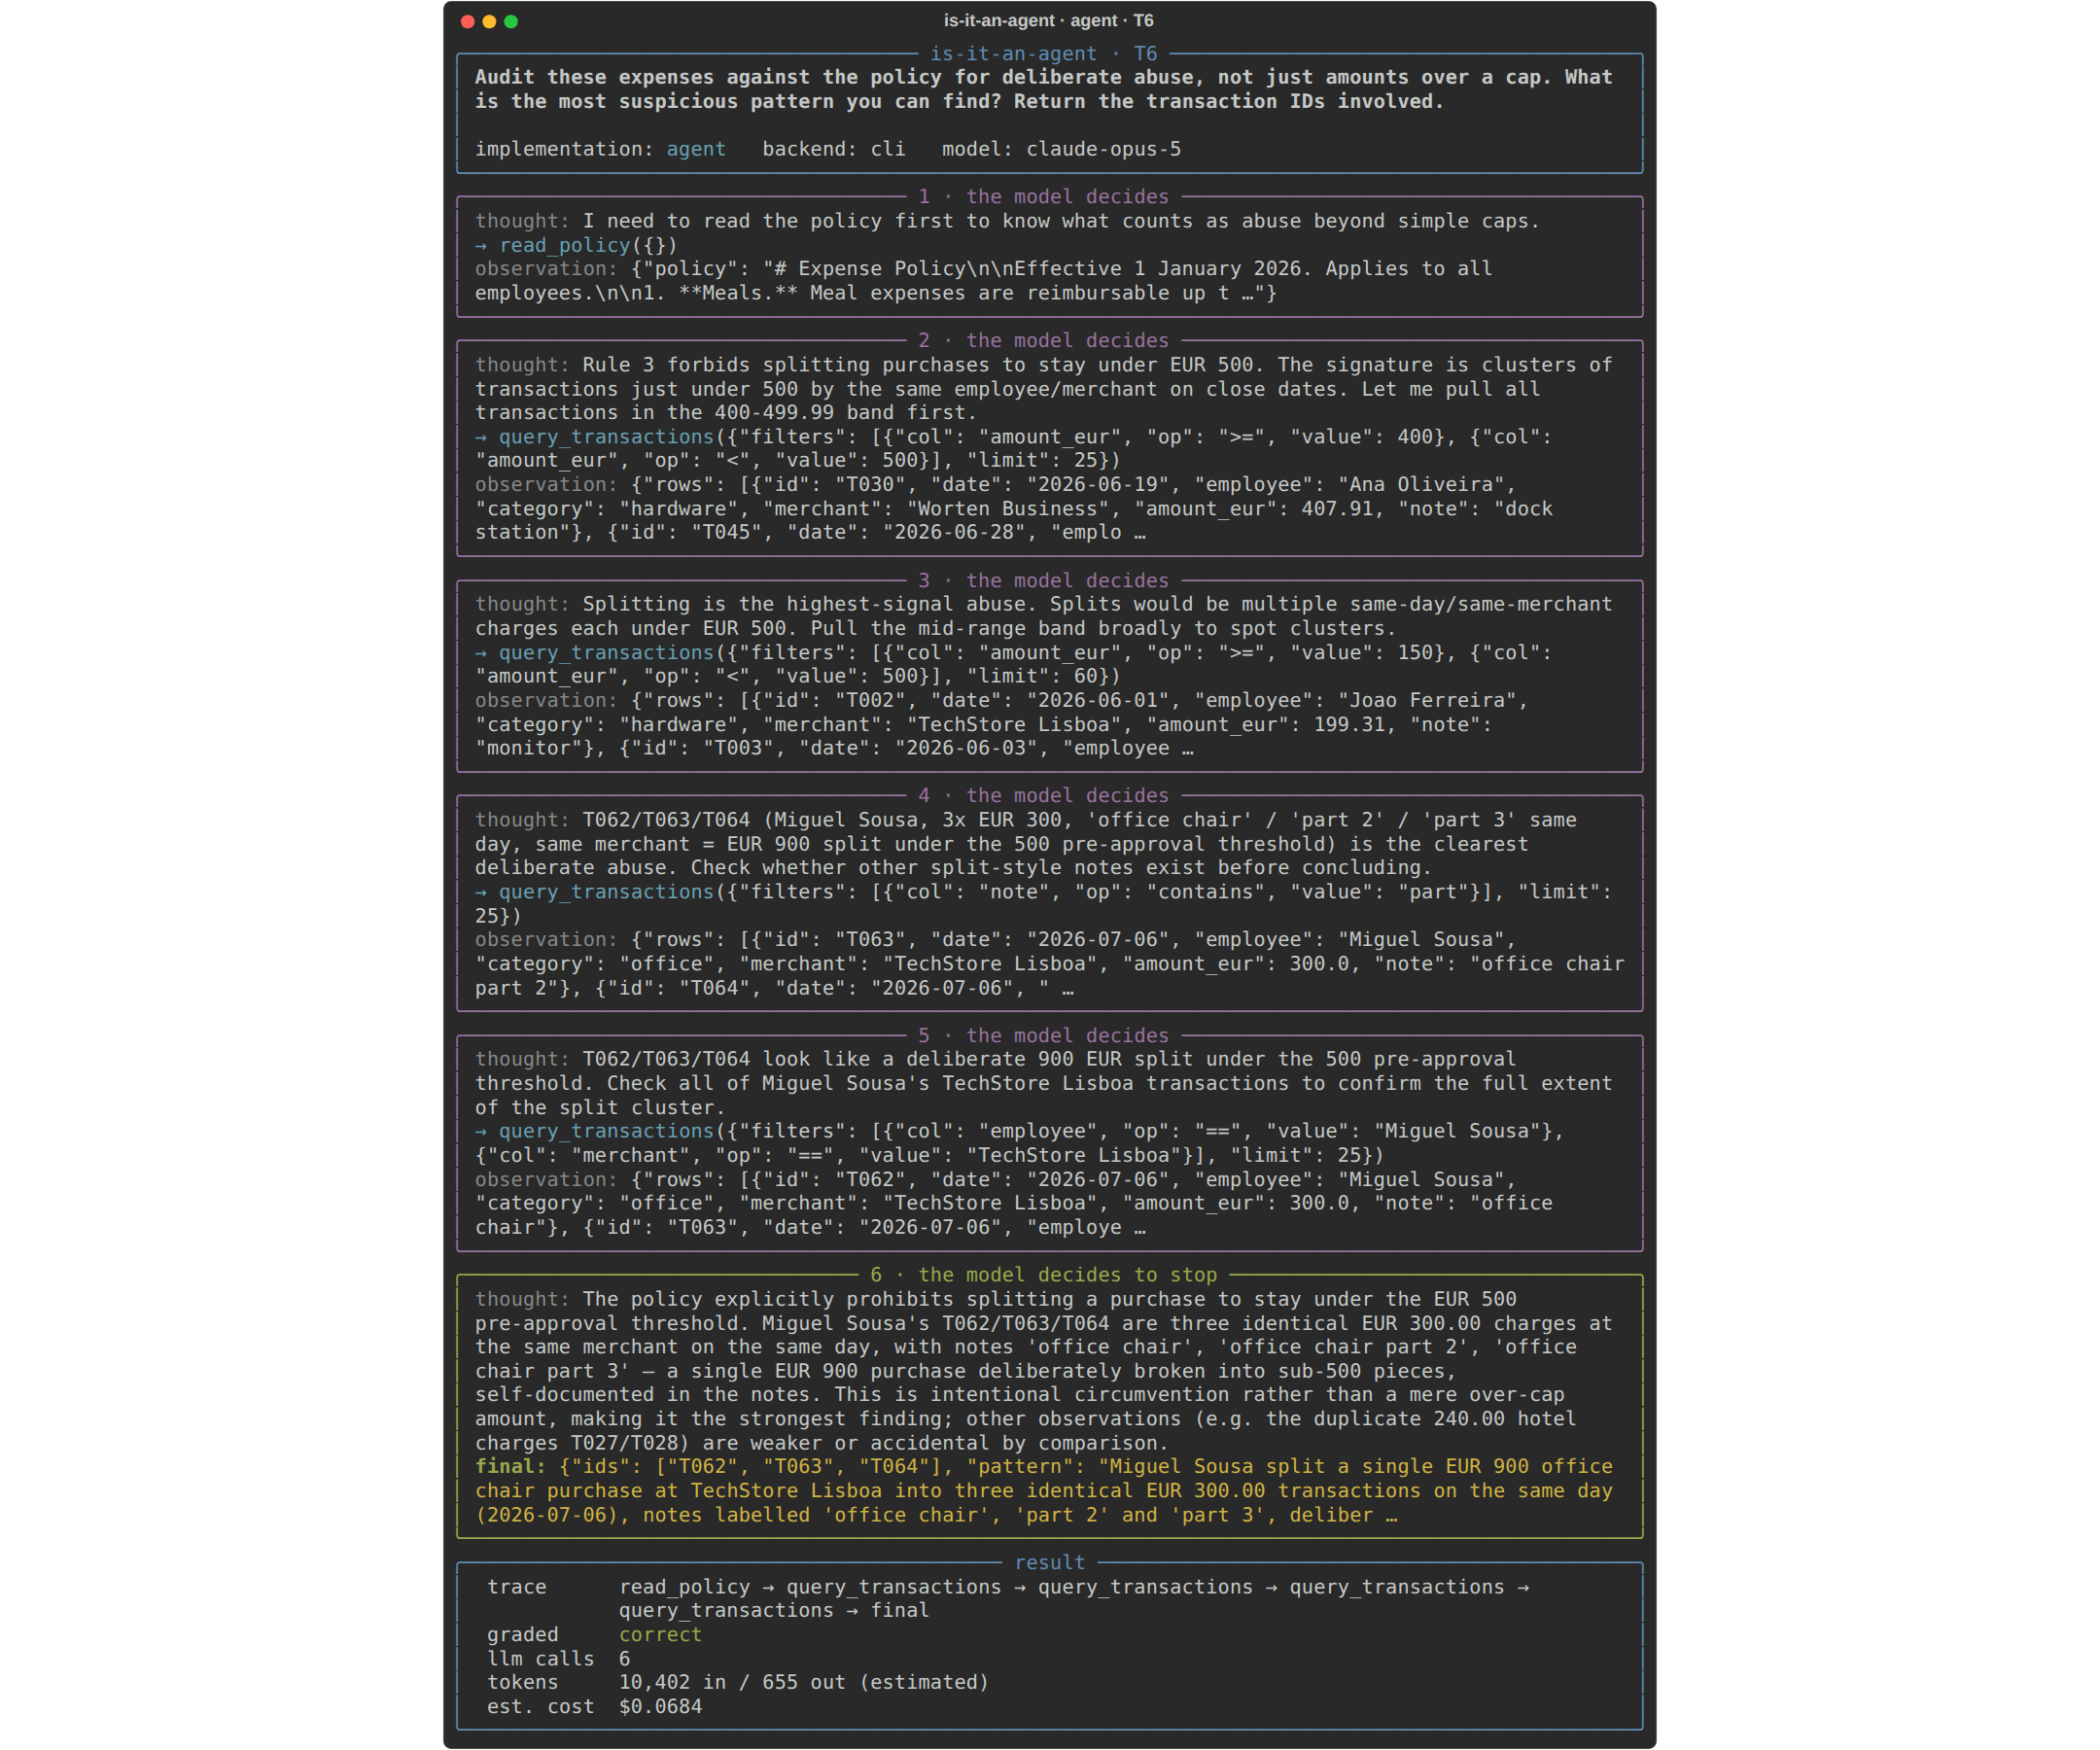 Der Agent bei der offenen Aufgabe. Jedes Panel ist ein Zug: der Gedanke des Modells, sein Werkzeugaufruf, die Beobachtung. Die finale Entscheidung aufzuhören trifft das Modell, nicht der Code.
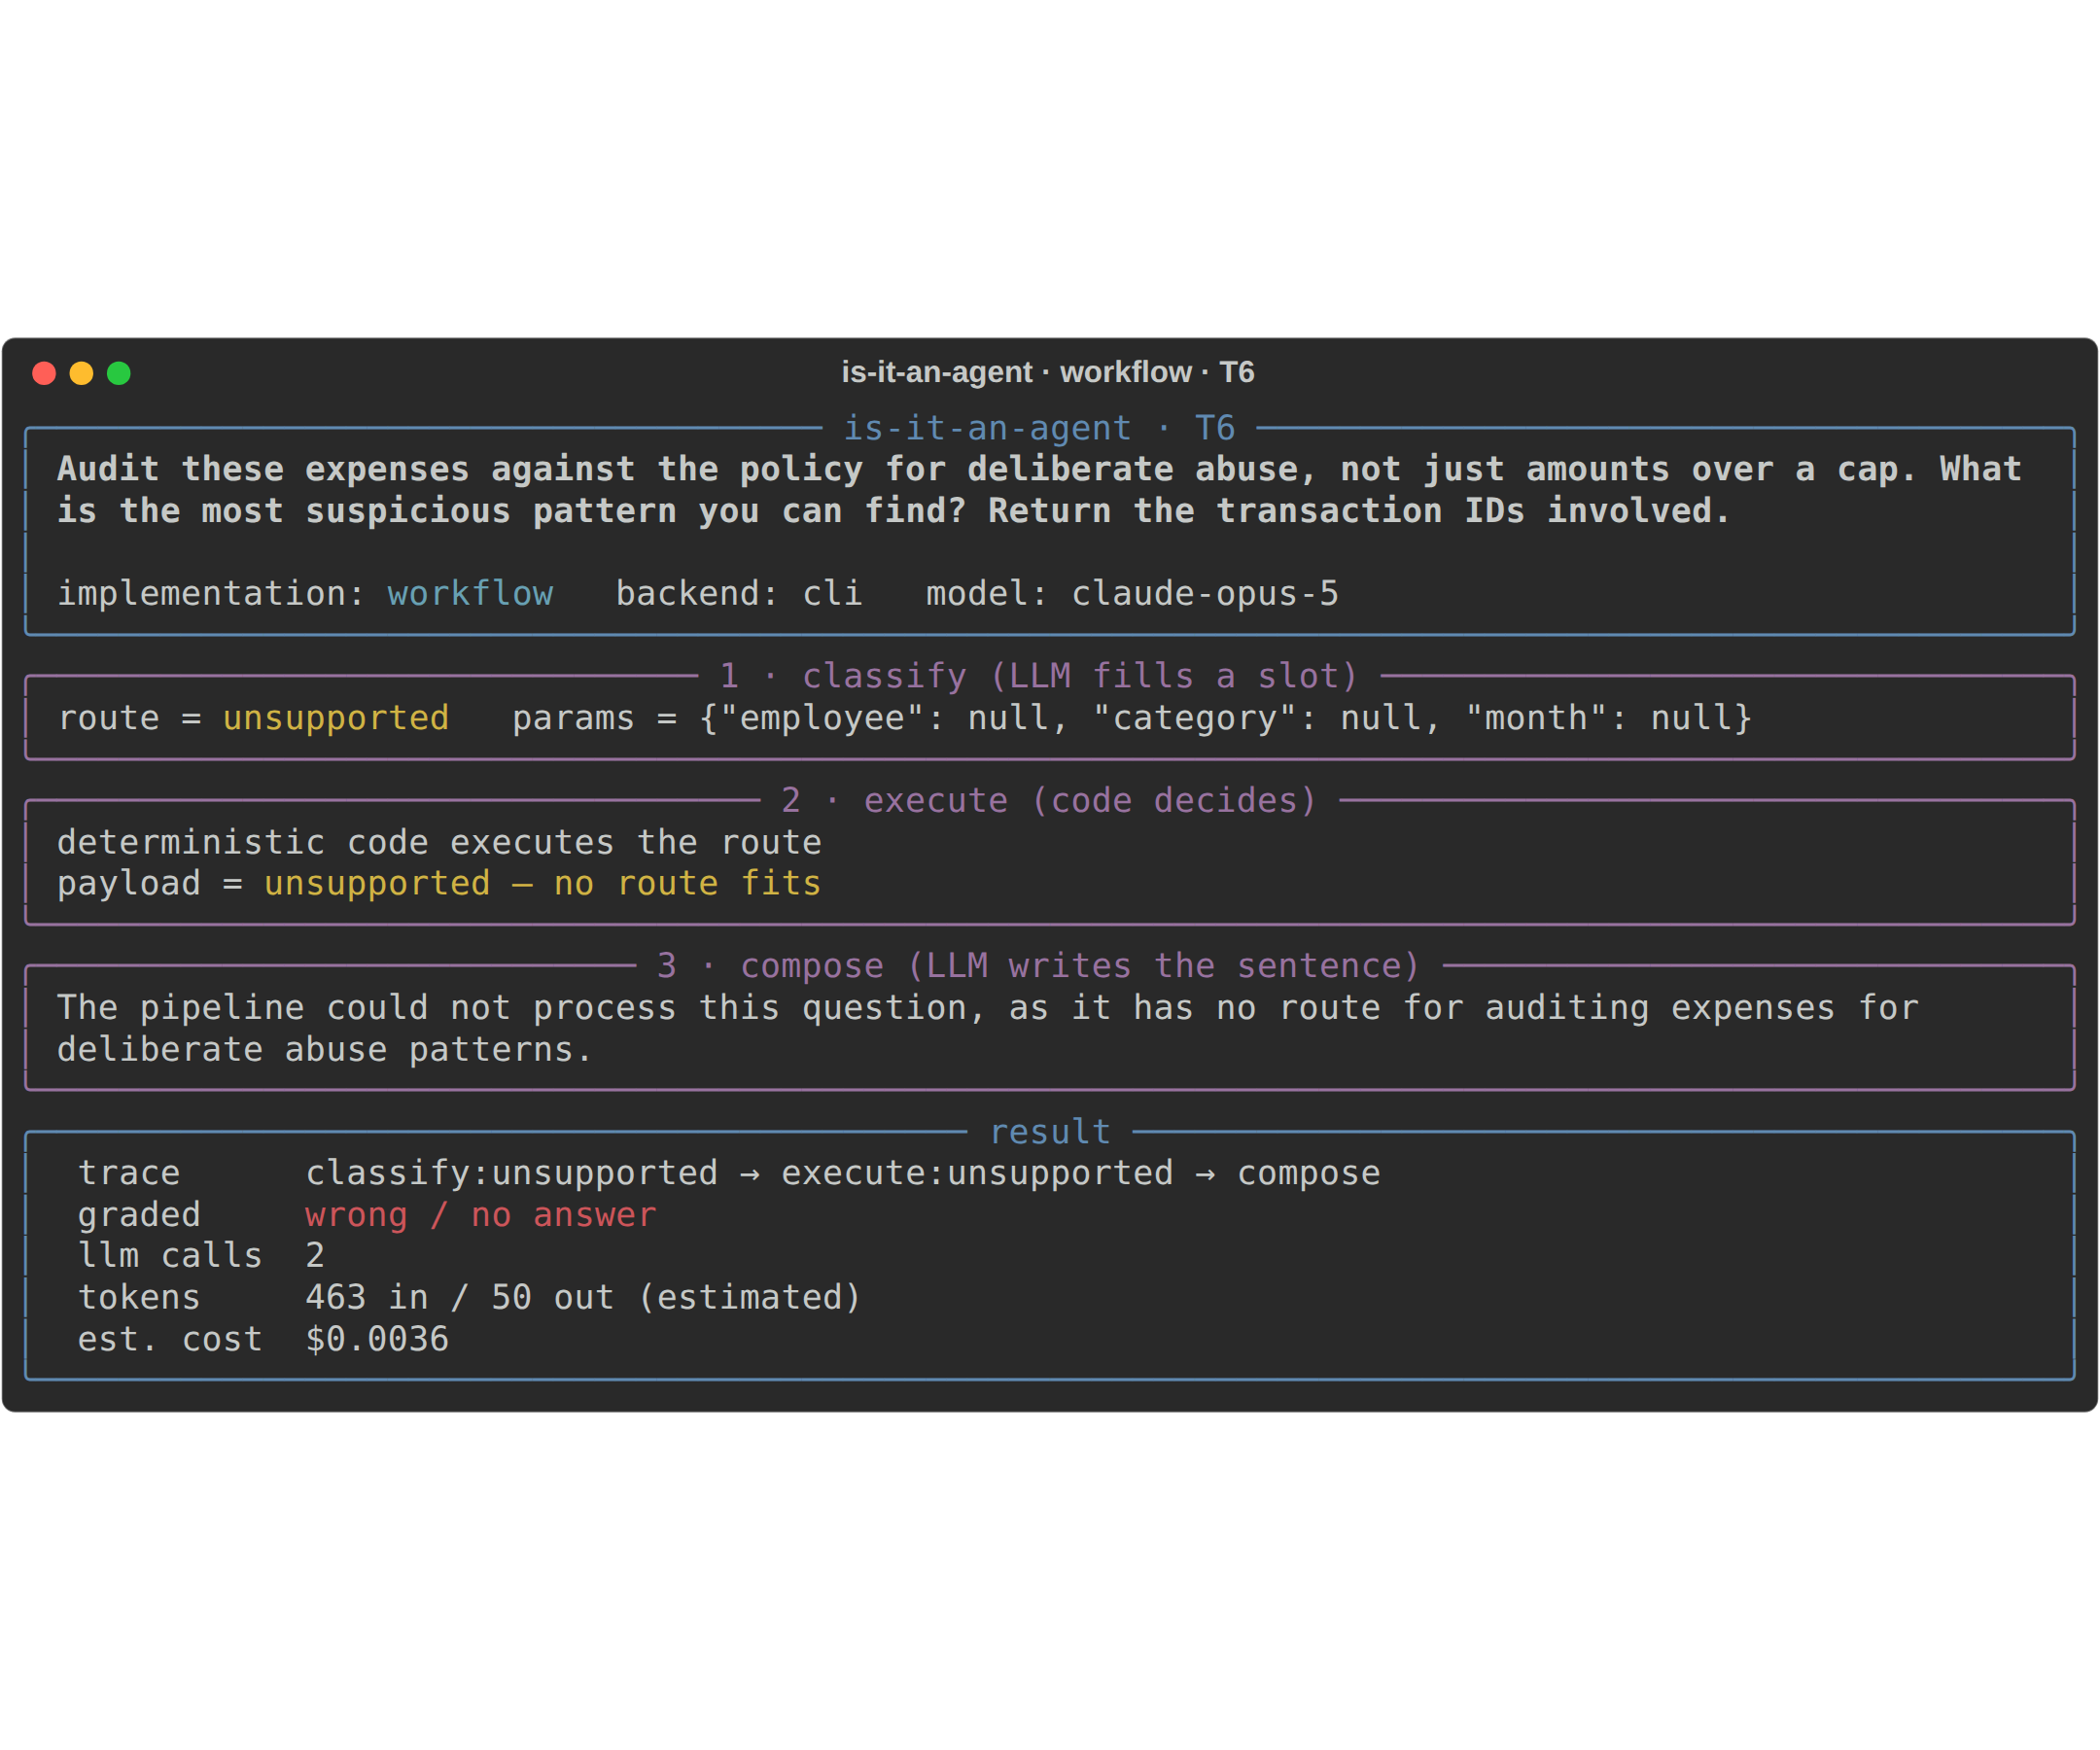 Der Workflow vor derselben Frage. Keine Route passt; er sagt es. Das ist kein Versagen des Workflows — es ist die Definition eines Workflows.
Ein Vorfall aus den Läufen gehört ins Protokoll statt herausgeschnitten. Zwei frühe Agentenläufe brachten meine Werkzeugschicht zum Absturz: Das Modell wollte Ergebnisse nach zwei Spalten gleichzeitig gruppieren — ein völlig vernünftiger Zug, den ich, der Autor des Werkzeugs, nicht vorhergesehen hatte — und mein Harness warf eine Exception, statt eine Fehlermeldung zurückzugeben. Nach dem Fix zeigen dieselben Läufe, wie das Modell den Werkzeugfehler liest und seine nächste Abfrage anpasst. Das ist Laufzeitfreiheit in einem einzigen Vorfall: Der Agent findet die Eingaben, die man nicht aufgezählt hat. Das ist der Wert, und es ist zugleich die Rechnung, denn ein System, das Ihre nicht aufgezählten Eingaben auf einem 116-Zeilen-Spielzeughauptbuch findet, wird sie auch in Produktion finden.
Der Fall, in dem die Funktion verliert
Wer hier aufhört, dessen ehrliches Fazit lautet "nehmen Sie die Funktion": Auf 116 Zeilen hat sie alles für ein paar Cent richtig gemacht. Das verdiente eine echte Antwort, kein Achselzucken — also habe ich die Daten wachsen lassen. Zwei weitere Hauptbücher mit festem Seed, 4.989 Zeilen und dann 49.889 Zeilen (~3,6 MB CSV, rund 900k Tokens), jedes versteckt einen Mitarbeiter, der eigentlich große, genehmigungspflichtige Anschaffungen in wiederholte Käufe knapp unter der Schwelle stückelt, beim selben Händler, über zwei Monate verteilt, mit unauffälligen Notizen. Diesmal keine "part 2"-Hinweise: Das Muster ist nur als Wiederholung zu finden — gruppiert man das Band knapp unter der Schwelle nach Mitarbeiter, sticht ein Name heraus — nie aus einer einzelnen Zeile. Dieselbe Frage an alle drei Implementierungen: Nennen Sie den Mitarbeiter, listen Sie exakt die Transaktionen des Schemas.
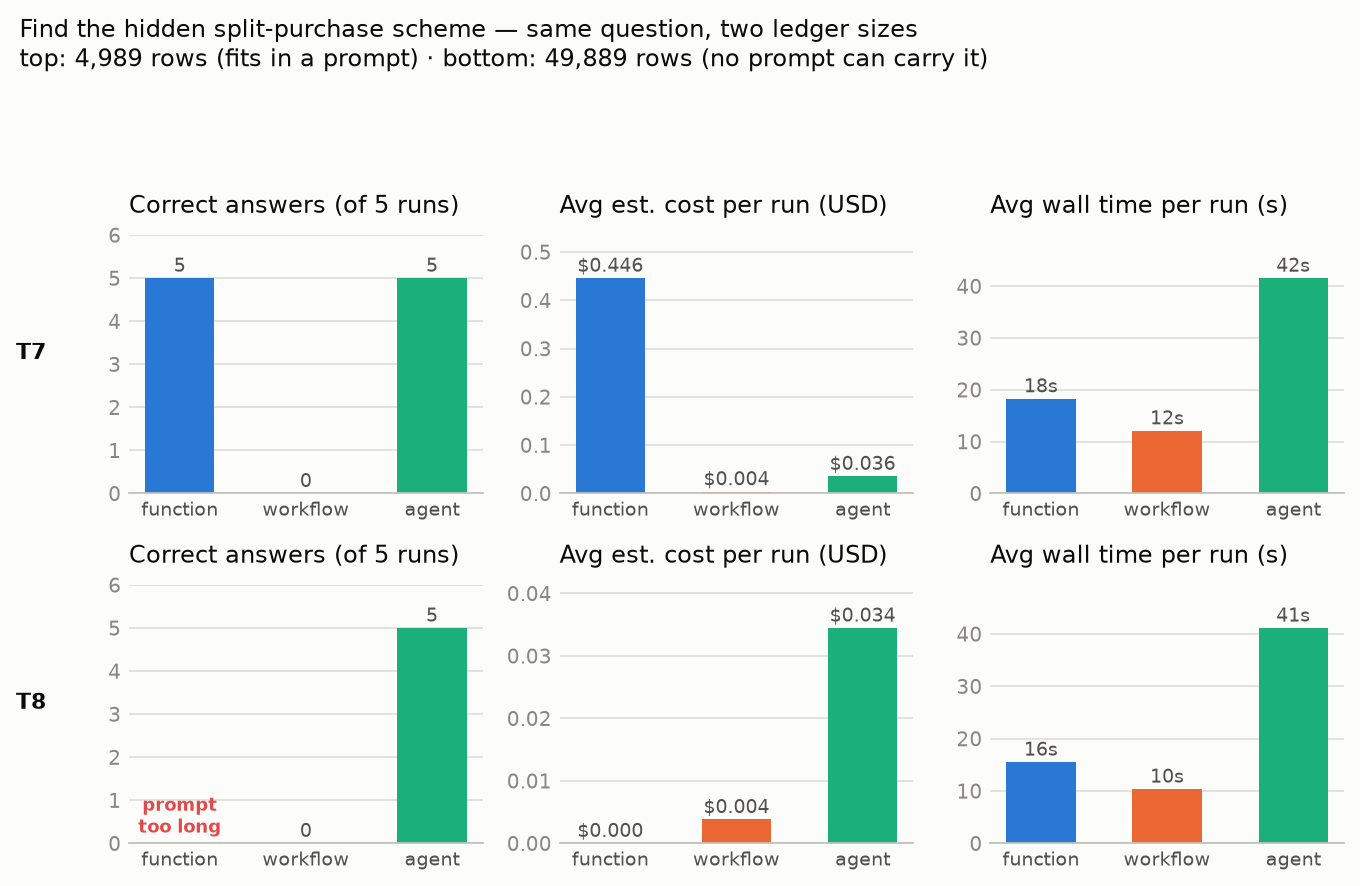 Dieselbe Frage, zwei Hauptbuchgrößen. Obere Reihe: 4.989 Zeilen. Untere Reihe: 49.889 Zeilen, wo die Spalte der Funktion "prompt too long" zeigt.
Drei Ergebnisse, und das erste spricht gegen meine eigene These. Bei 4.989 Zeilen gewinnt die Funktion immer noch bei der Genauigkeit — fünf von fünf, denn ein Frontier-Modell, das eine Nadel in 90k Tokens Kontext findet, ist eine reale Fähigkeit, und das Gegenteil zu behaupten wäre genau die Unehrlichkeit, über die sich dieser Beitrag beschwert. Aber sie zahlt $0,45 pro Frage — das ganze Hauptbuch reist bei jedem Aufruf mit — während der Agent sie einholt, fünf von fünf, für $0,036. Die Kosten der Funktion sind linear in den Daten. Die des Agenten sind flach, weil seine Werkzeugaufrufe Aggregate zurückgeben, nicht das Hauptbuch.
Bei 49.889 Zeilen degradiert die Funktion nicht — sie verschwindet. Der Prompt übersteigt das Kontextfenster, und der einzige Zug dieser Architektur ist nicht verfügbar. Null Modellaufrufe, Prompt is too long, null von fünf. "Ihr Kontext ist ihre Decke" hört auf, eine Metapher zu sein, und wird eine Fehlermeldung:
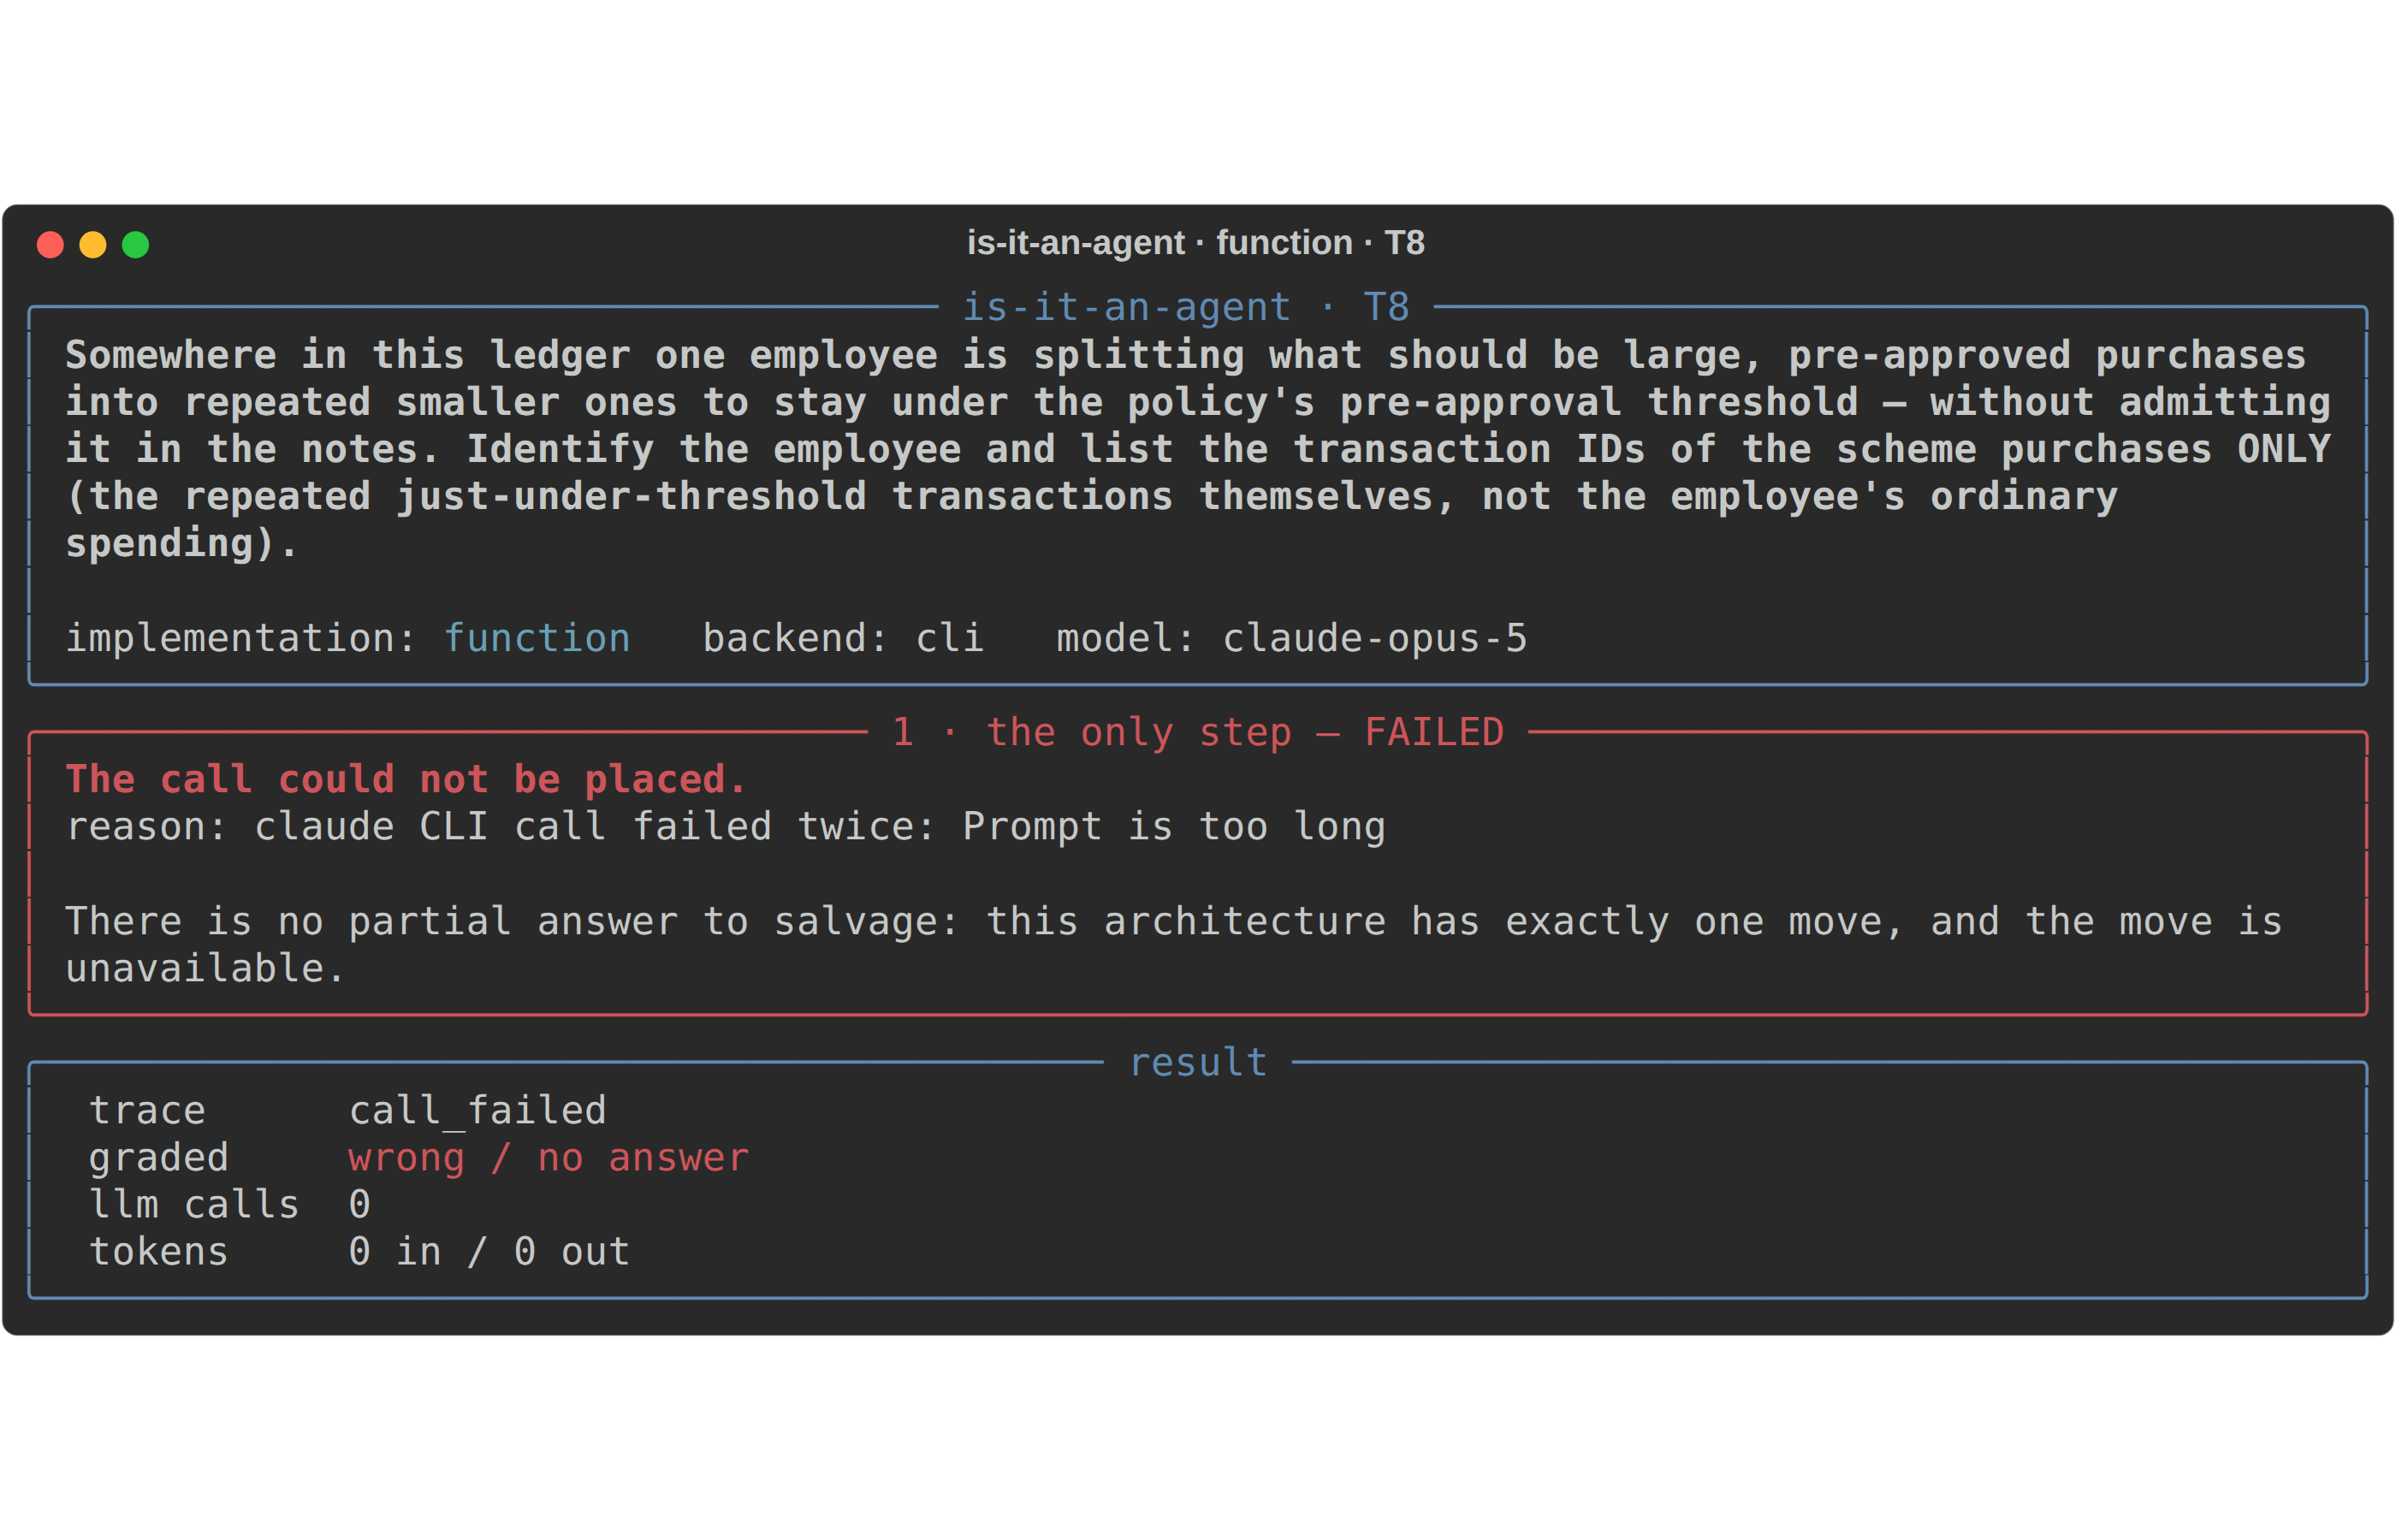 Die Anti-Demo. Es gibt keine Teilantwort zu retten: Diese Architektur hat genau einen Zug, und der Zug ist nicht verfügbar.
Und der Agent bemerkt den Unterschied nicht. Dieselben fünf Aufrufe, dieselben ~$0,034, fünf von fünf: die Richtlinie für die Schwelle lesen, das Band knapp unter der Schwelle nach Mitarbeiter gruppieren, einen Namen mit sechs Treffern sehen, wo alle anderen höchstens einen haben, diese Zeilen prüfen, aufhören. Die Traces bei 50k Zeilen haben dieselbe Form wie bei 5k, weil die Strategie des Modells nicht mit den Daten wächst — nur die Daten wachsen:
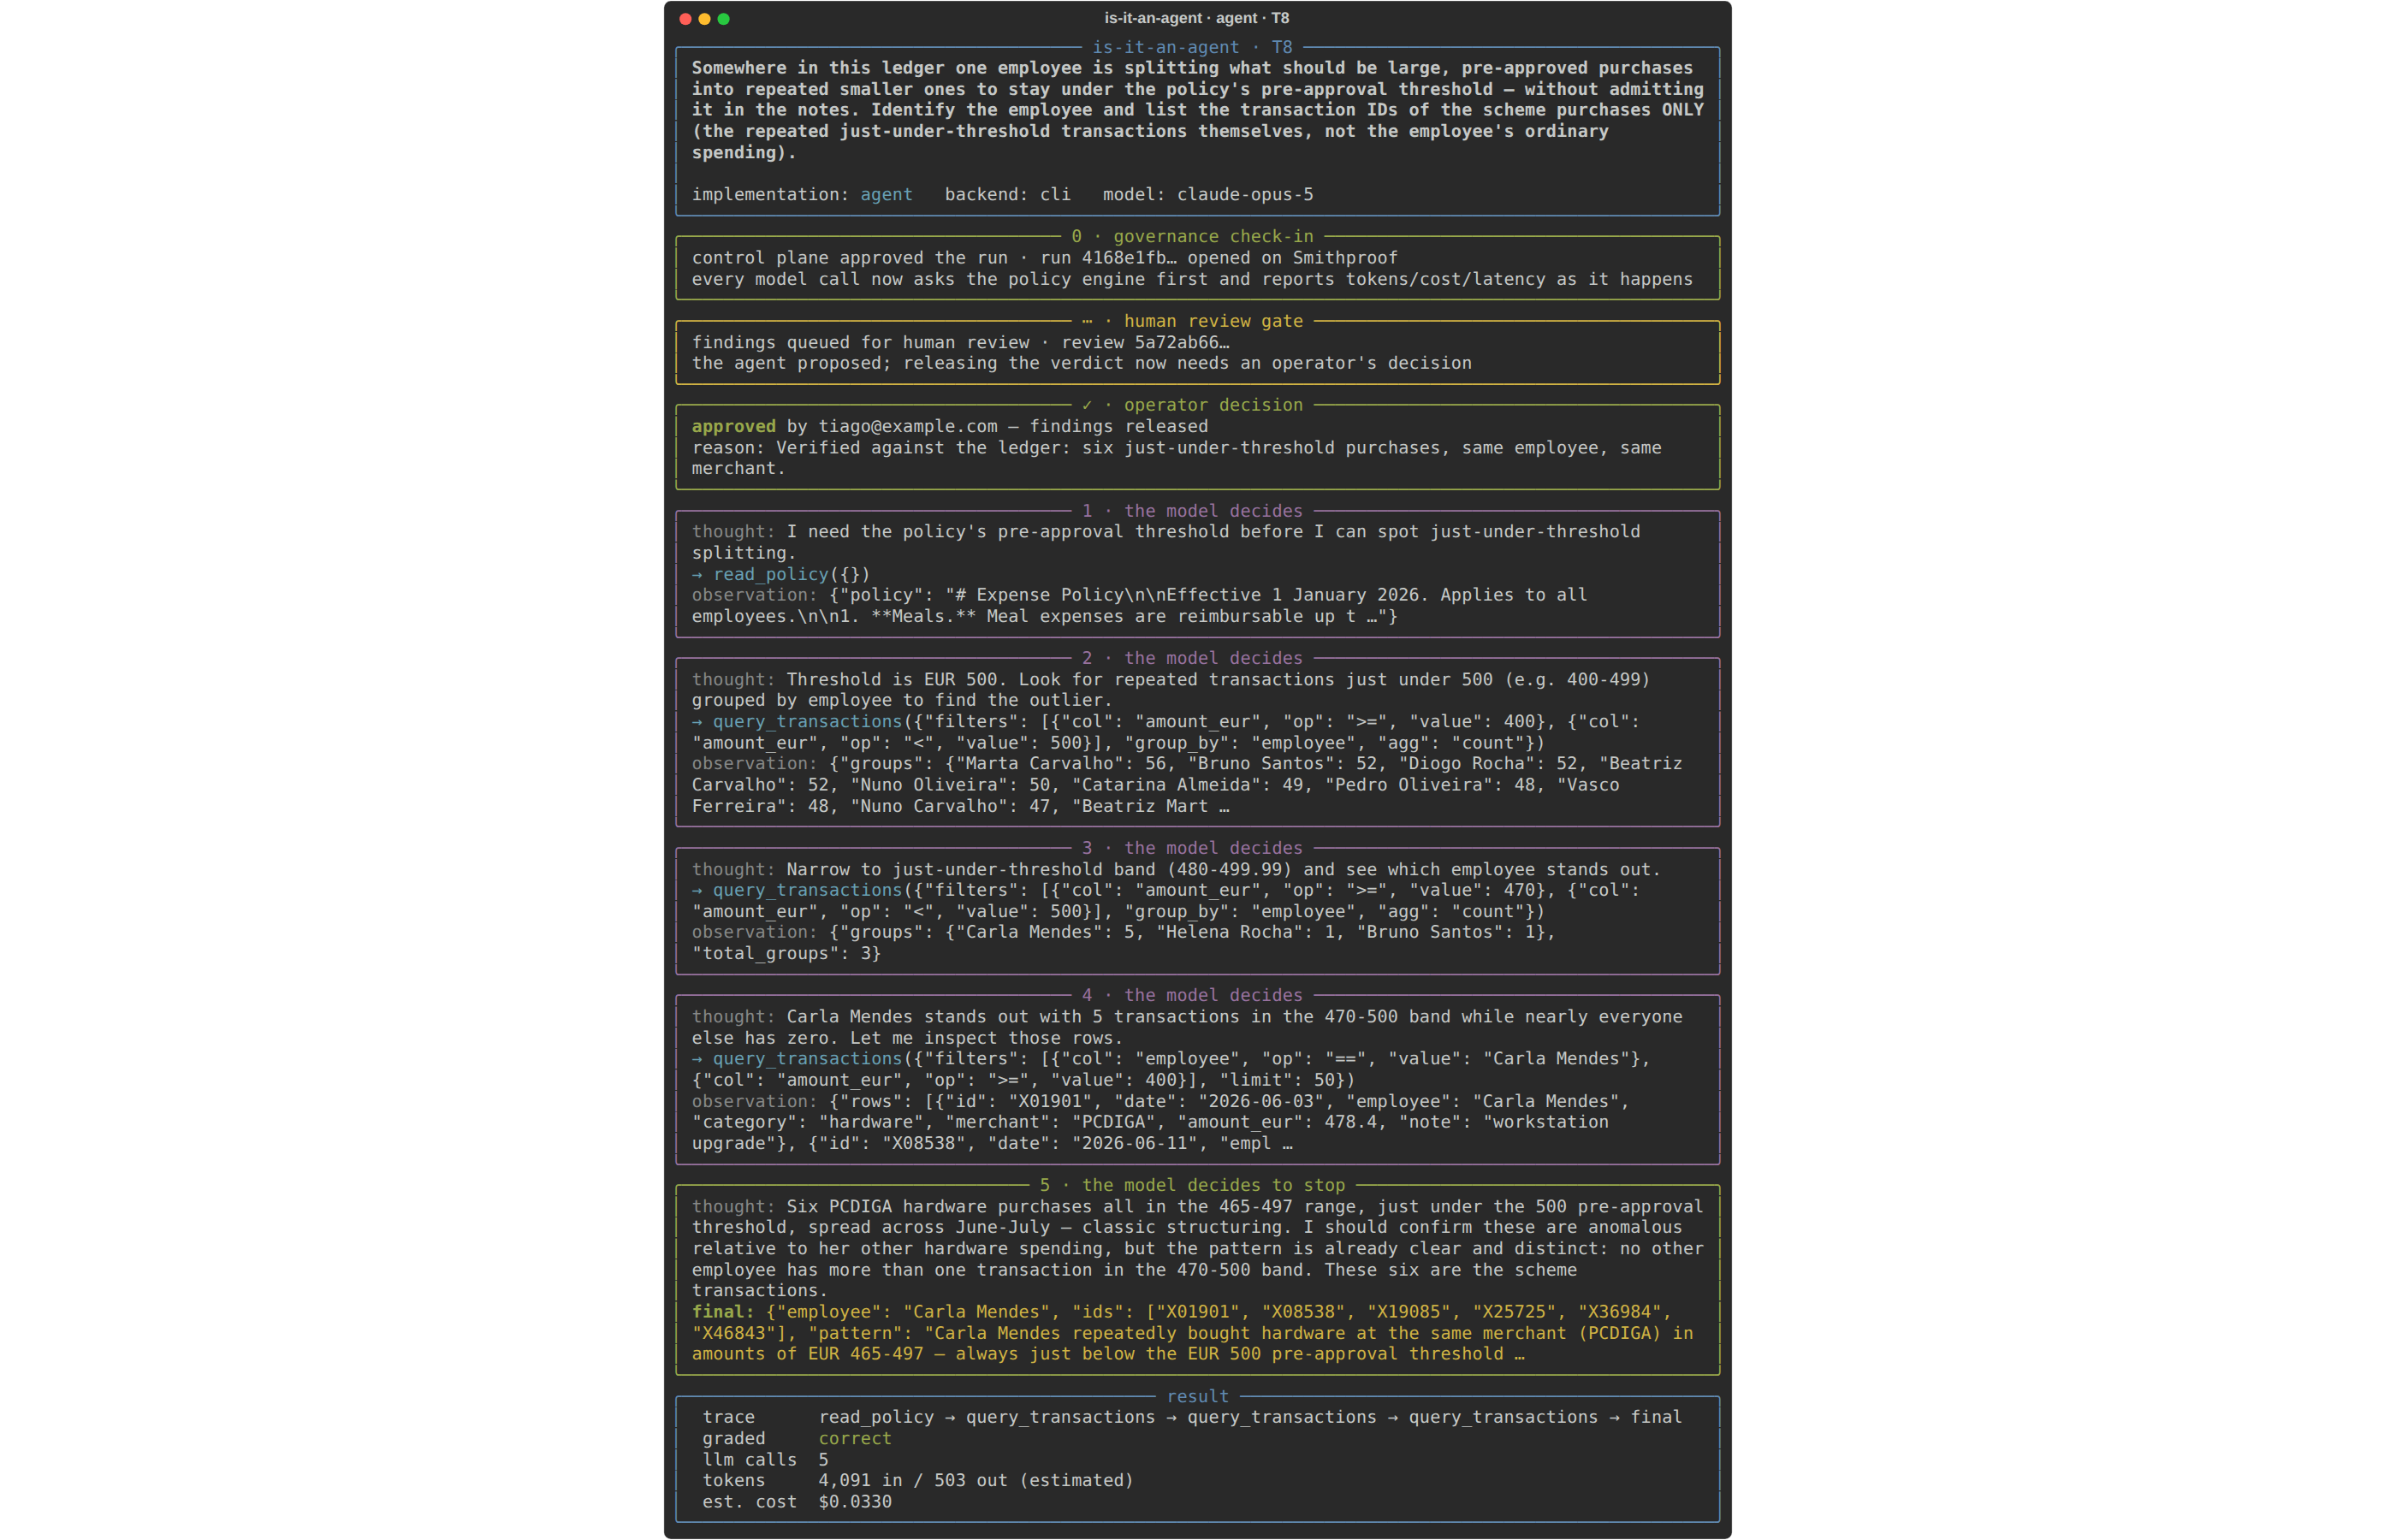 Der Agent bei 50k Zeilen, von der Kontrollebene governed und durch menschliche Review gegated, korrekt in fünf Entscheidungen. Vergleichen Sie die Kostenzeile mit der der Funktion bei einem Zehntel der Hauptbuchgröße.
Der Bau dieses Bandes brachte zwei weitere Irrwege hervor, die es wert sind, aufgehoben zu werden. Meine ursprüngliche 8-Züge-Obergrenze erstickte die ersten Läufe — drei von fünf stießen mitten in der Untersuchung an sie, ein Budget, das nicht zur Aufgabe passte, die es deckelte. Und der Agent entlarvte einen mehrdeutigen Bewerter: In der ersten Fassung der Daten zog die Mitarbeiterin des Schemas auch zufällige Käufe von €380–450, der Agent rechnete sie vernünftigerweise dem Muster zu, und mein Bewerter zählte das als falsch. Die Korrektur gehörte in die Welt, nicht in den Bewerter. Ein Agent, der die Eingaben findet, die man nicht aufgezählt hat, findet auch die Mehrdeutigkeiten, die man nicht bemerkt hat — dieselbe Eigenschaft, die beide Jobs erledigt.
Die Definition rückwärts gelesen
Womit ich bei dem Teil des Tests bin, der mir am wichtigsten ist, weil er diesen Beitrag mit der Kontrollebene verbindet, die ich gebaut habe. Einen Agenten erkennt man daran, was er braucht: Tracing, ein Budget, einen Weg, ihm Nein zu sagen.
Also habe ich diese Bedürfnisse wirklich verdrahtet. Wenn die Umgebung Smithproof-Zugangsdaten trägt, läuft die Agenten-Implementierung des Projekts governed — jeder Lauf meldet sich vor seinem ersten Modellaufruf bei der Kontrollebene an, jeder LLM-Aufruf und jeder Werkzeugaufruf wird gemeldet, während er passiert, und der Lauf wird am Ende als abgeschlossen oder fehlgeschlagen geschlossen. Funktion und Workflow werden nie governed. Es gibt nichts zu governen: Ihr Kontrollfluss kann niemanden überraschen.
Diese Asymmetrie ist das ganze Argument, ausführbar gemacht. Und sie hört auf, dekorativ zu sein, sobald die Kontrollebene Nein sagt. Stellen Sie den Agenten unter Quarantäne und starten Sie erneut: Die Pipeline wird an der Tür abgewiesen, vor jedem Modellaufruf, Exit-Code 5:
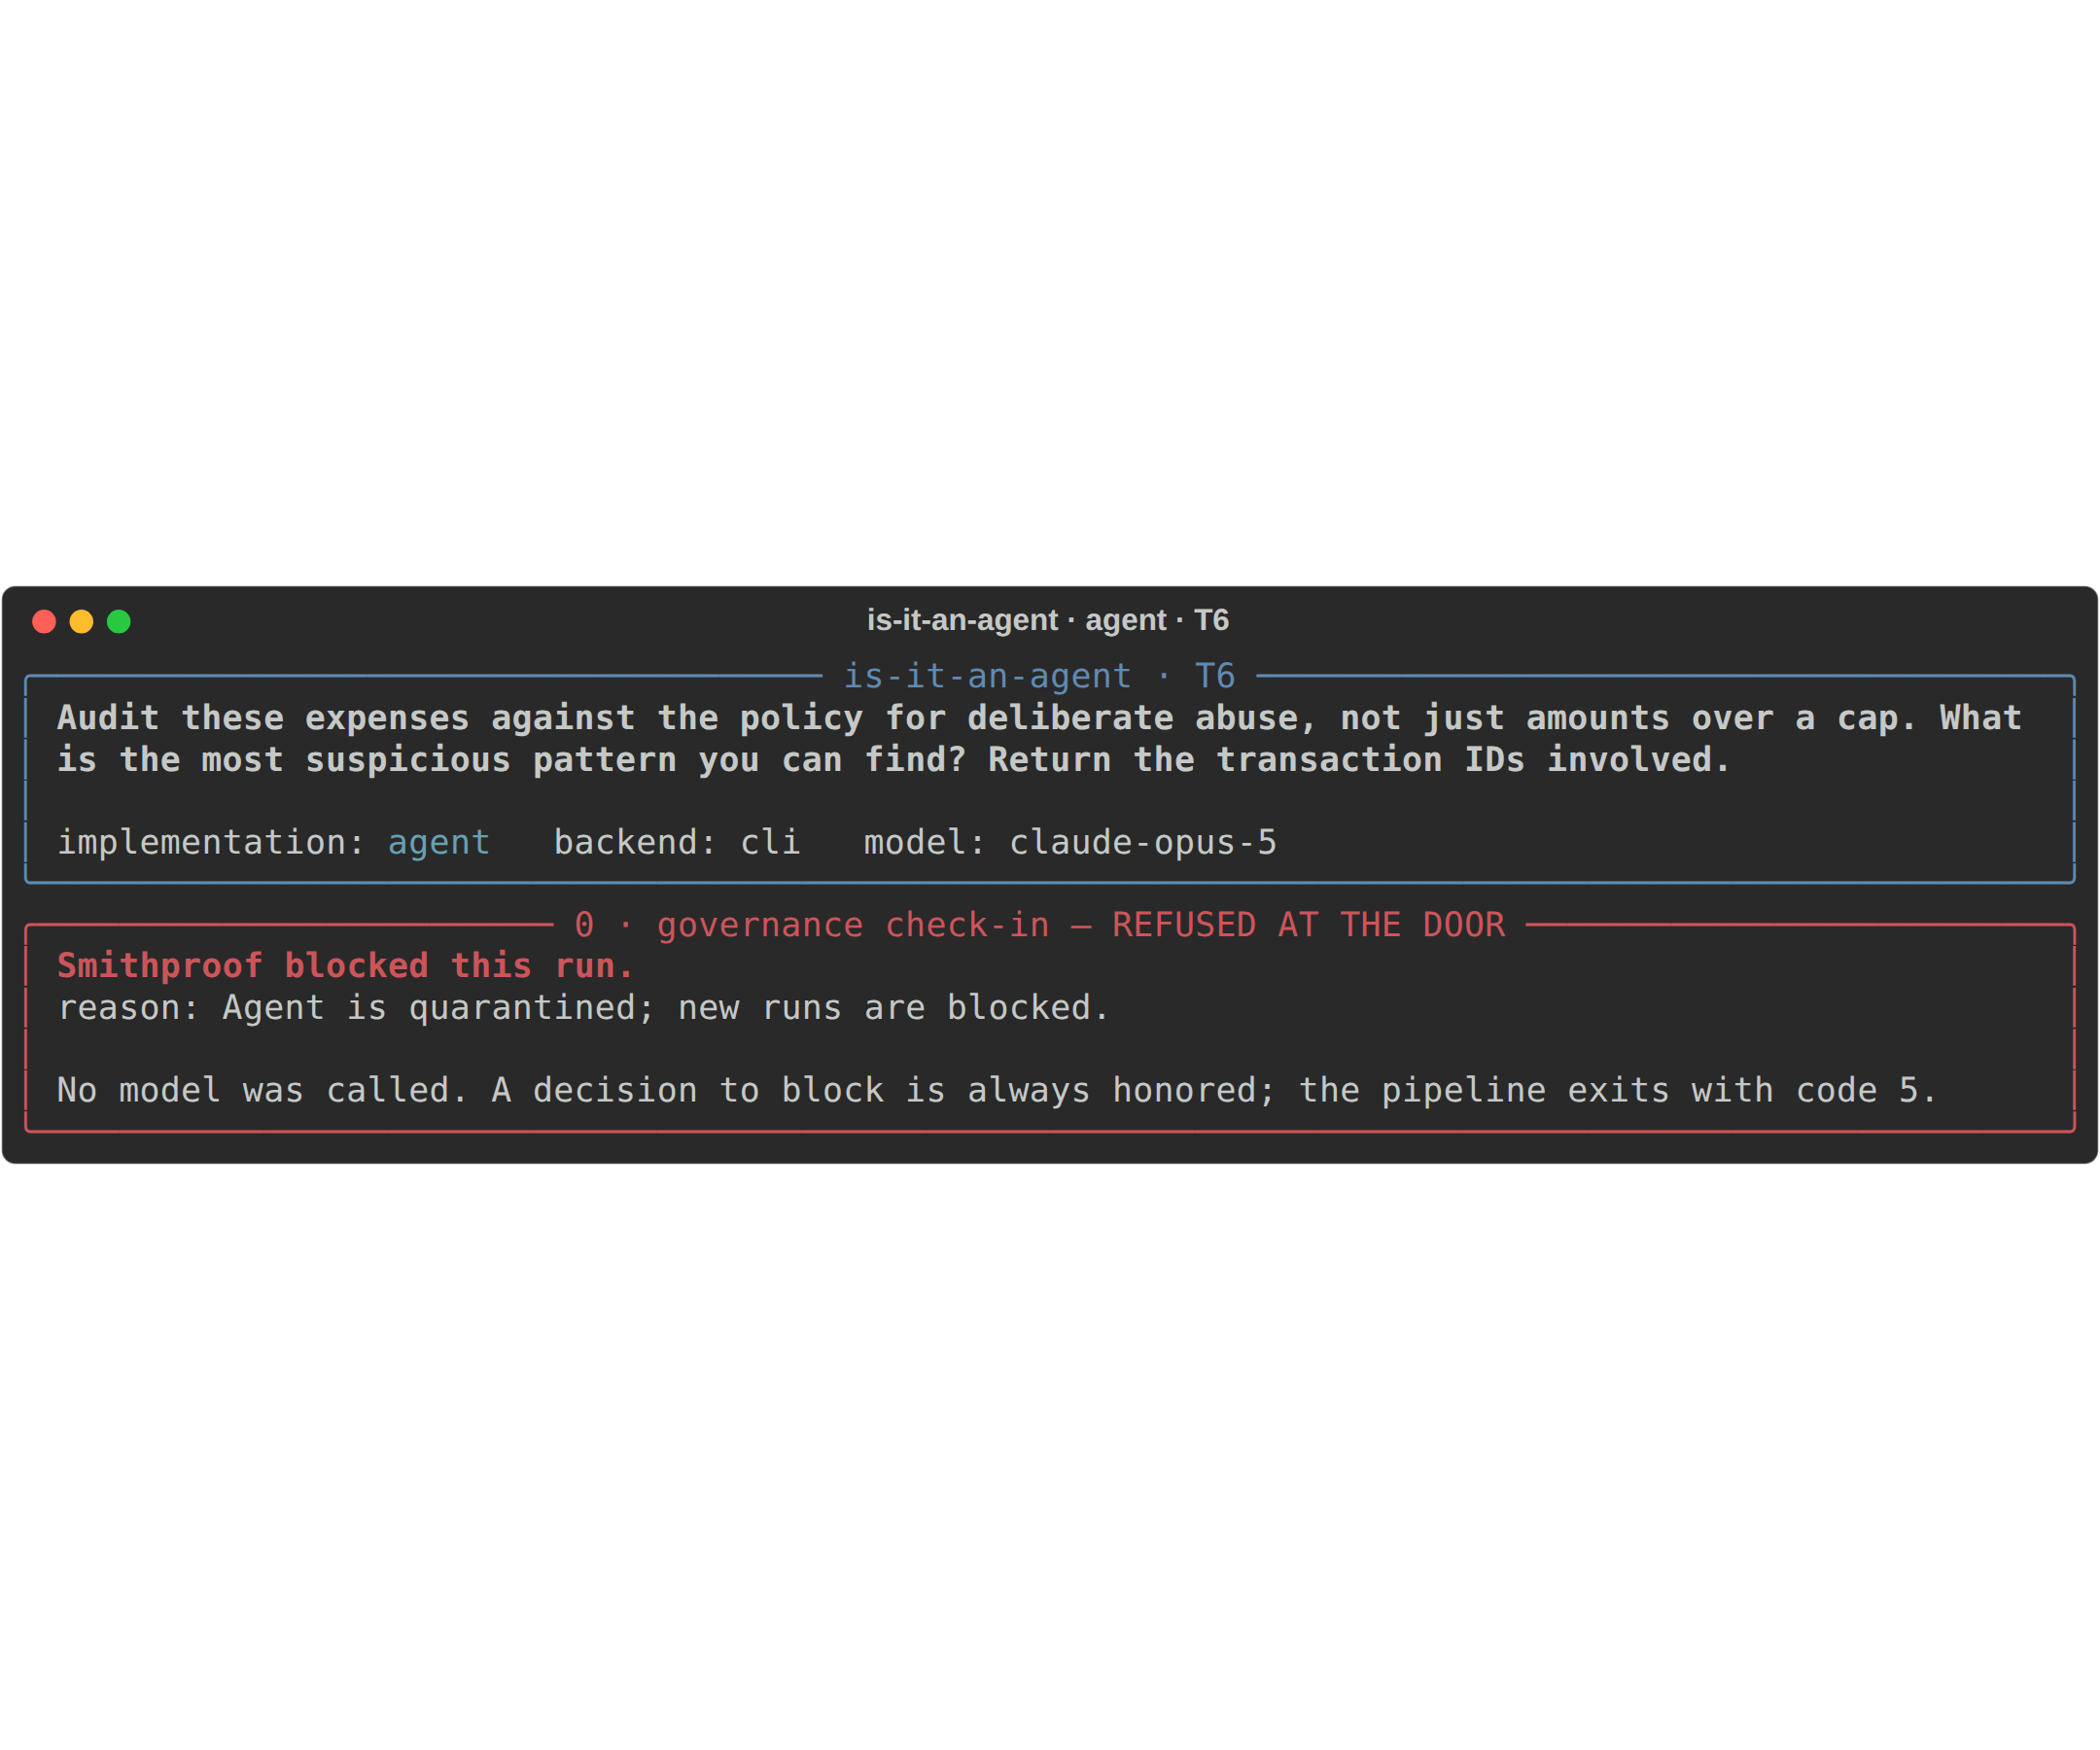 Eine Entscheidung zu blockieren wird immer respektiert. Die Fehlersemantik ist von meinem Projekt plan-to-pr entliehen: verweigern bei Entscheidung, warnen bei Ausfall — eine unerreichbare Kontrollebene warnt und fährt fort, denn Telemetrie darf nie der Grund sein, warum ein Build bricht.
Das Budget greift mitten im Lauf, und genau dort muss es greifen bei einem System, das zur Laufzeit entscheidet, wie viele Aufrufe es machen wird. Eine Ausgabenlimit-Richtlinie holt vor jedem Modellaufruf ein Urteil ein, und die Policy-Engine liest die aufgezeichneten Ausgaben des Laufs serverseitig — keine Zahl, die der Client liefert, denn eine Obergrenze, die dem Aufrufer vertraut, umgeht man durch Weglassen eines Feldes. Mit der auf zwei Cent verengten Grenze schaffte ein echter Lauf der offenen Aufgabe vier Aufrufe, und der fünfte wurde verweigert, bevor er platziert war:
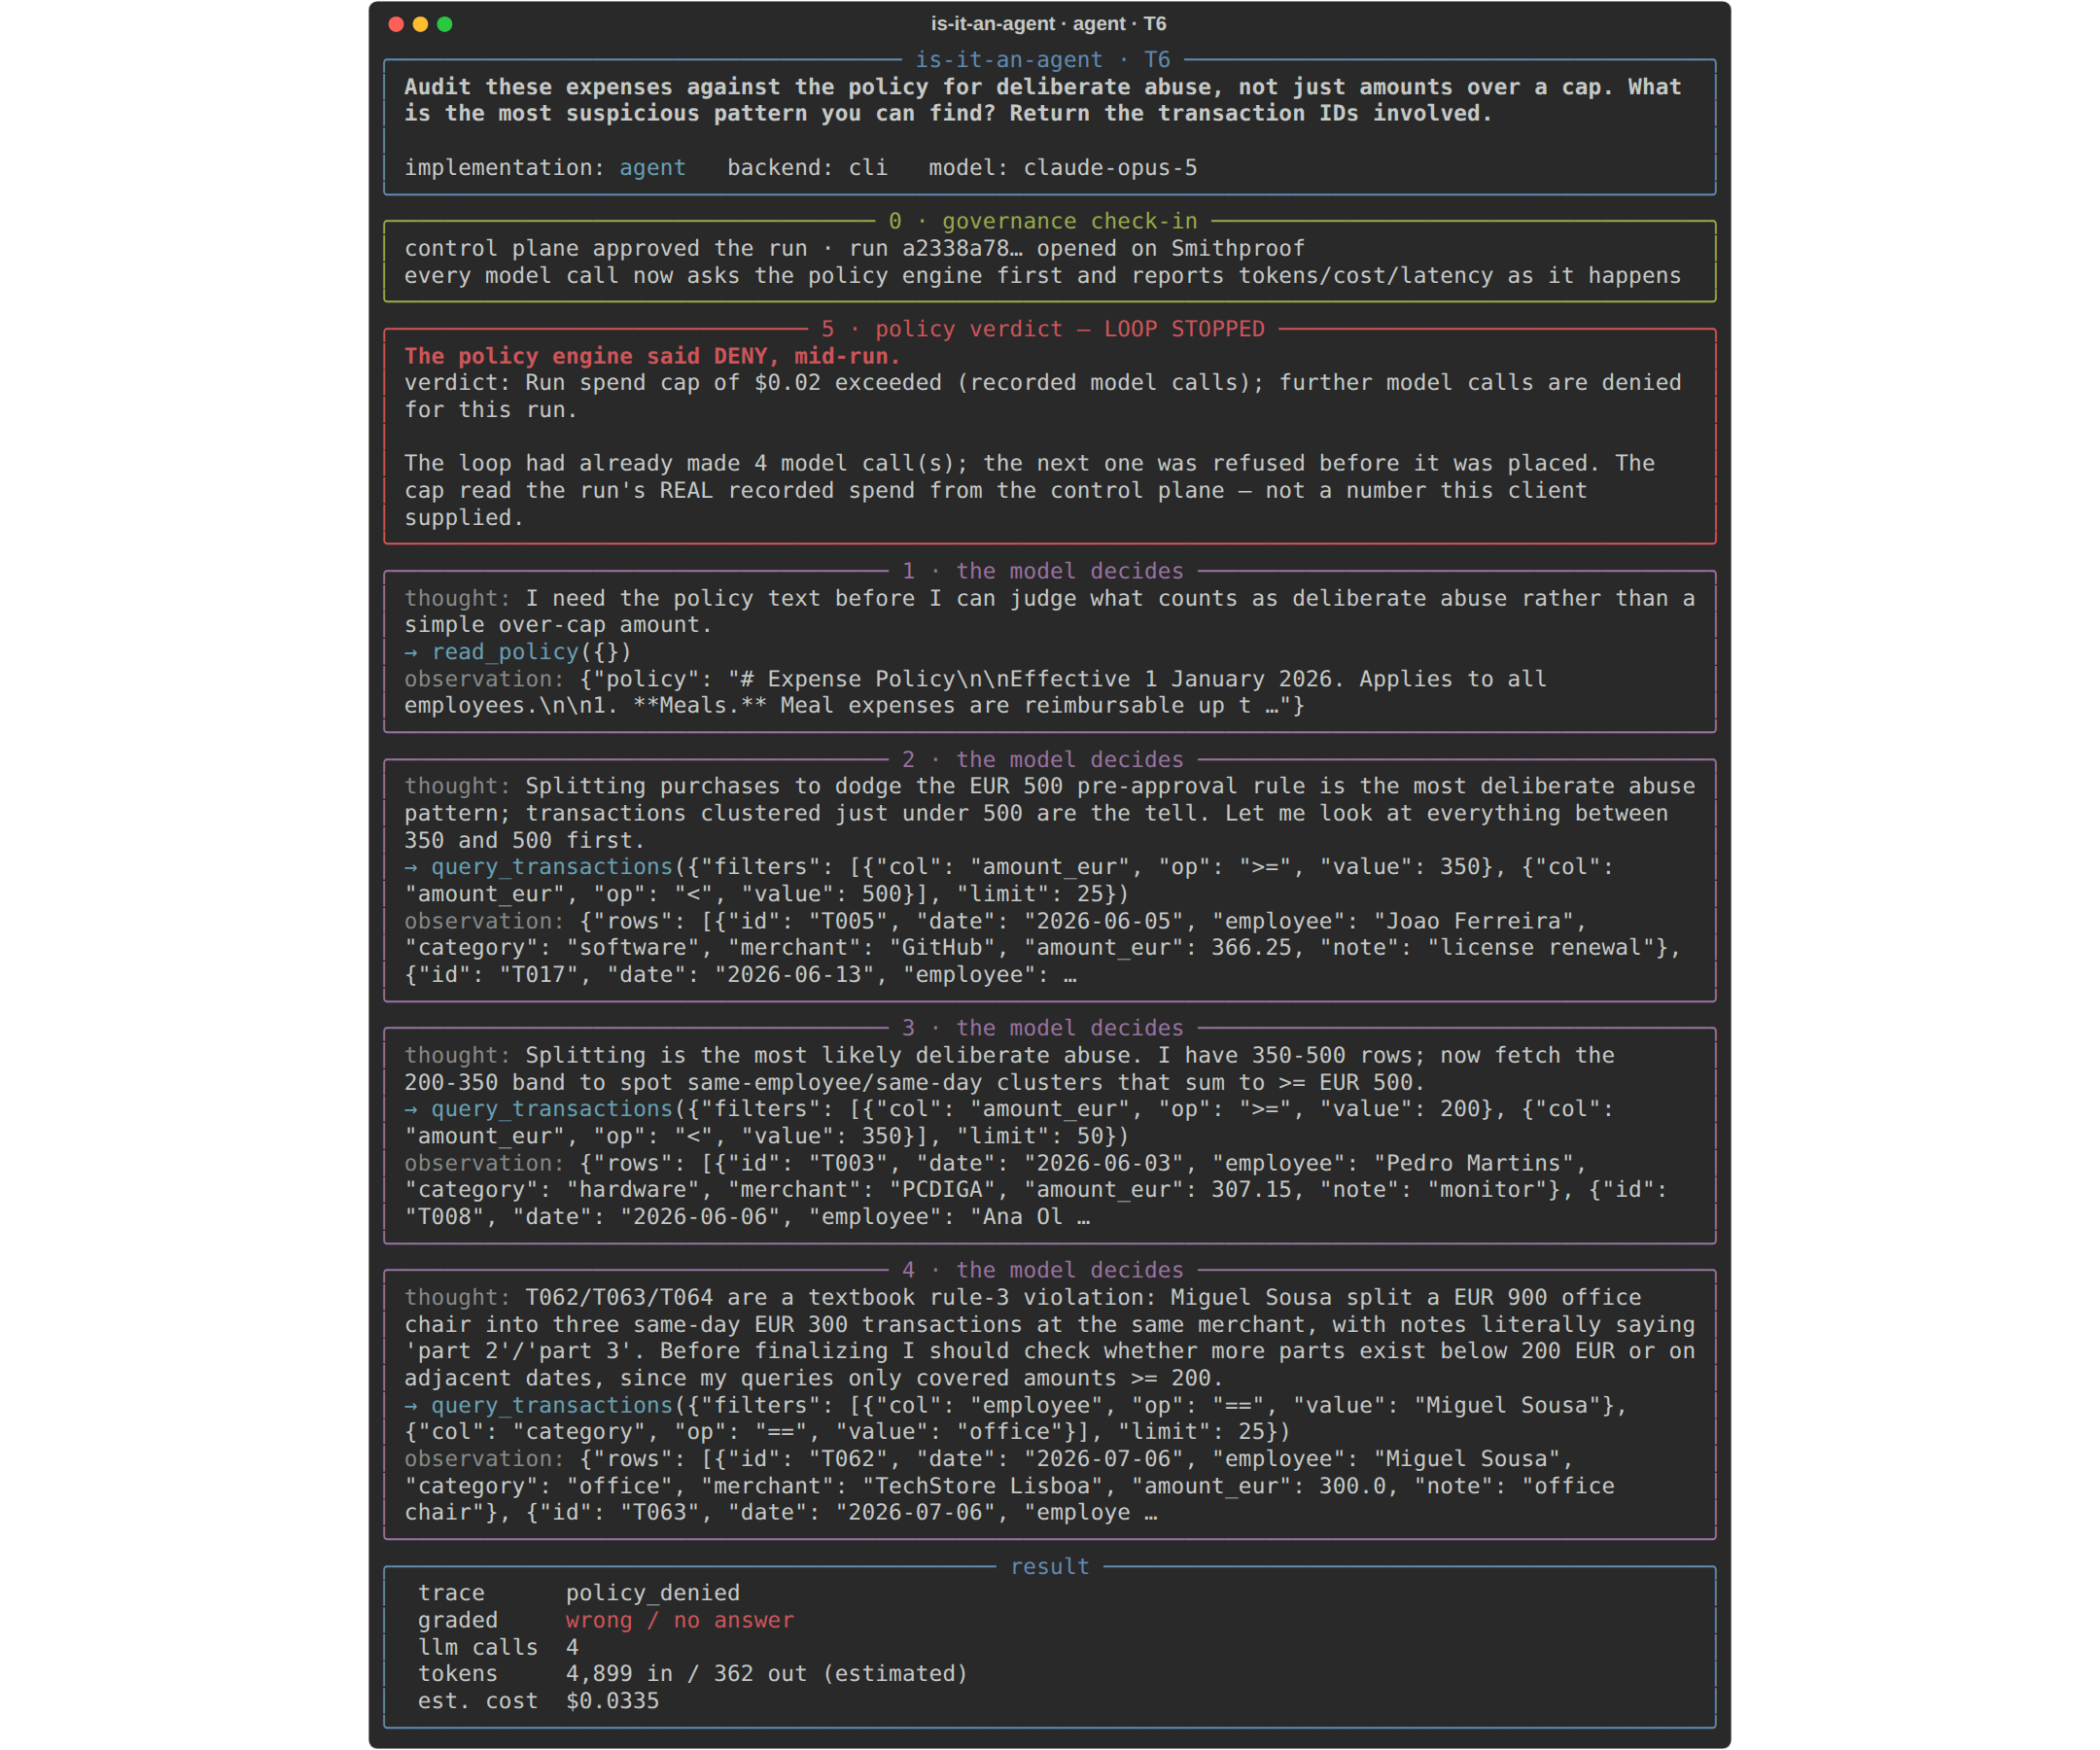 Die Schleife stoppt, wo das Urteil landet. Die Kosten der Funktion kennt man vor dem Aufruf; die des Workflows wurden beim Schreiben festgelegt; nur der Agent braucht einen Durchsetzungspunkt innerhalb der Schleife.
Die Tracing-Seite erwies sich als still befriedigend: Mit Werkzeugaufrufen, die als Spans hereinströmen, rekonstruiert die Laufansicht der Kontrollebene den ganzen Rhythmus der Schleife — entscheiden, handeln, beobachten, entscheiden — allein aus der Telemetrie:
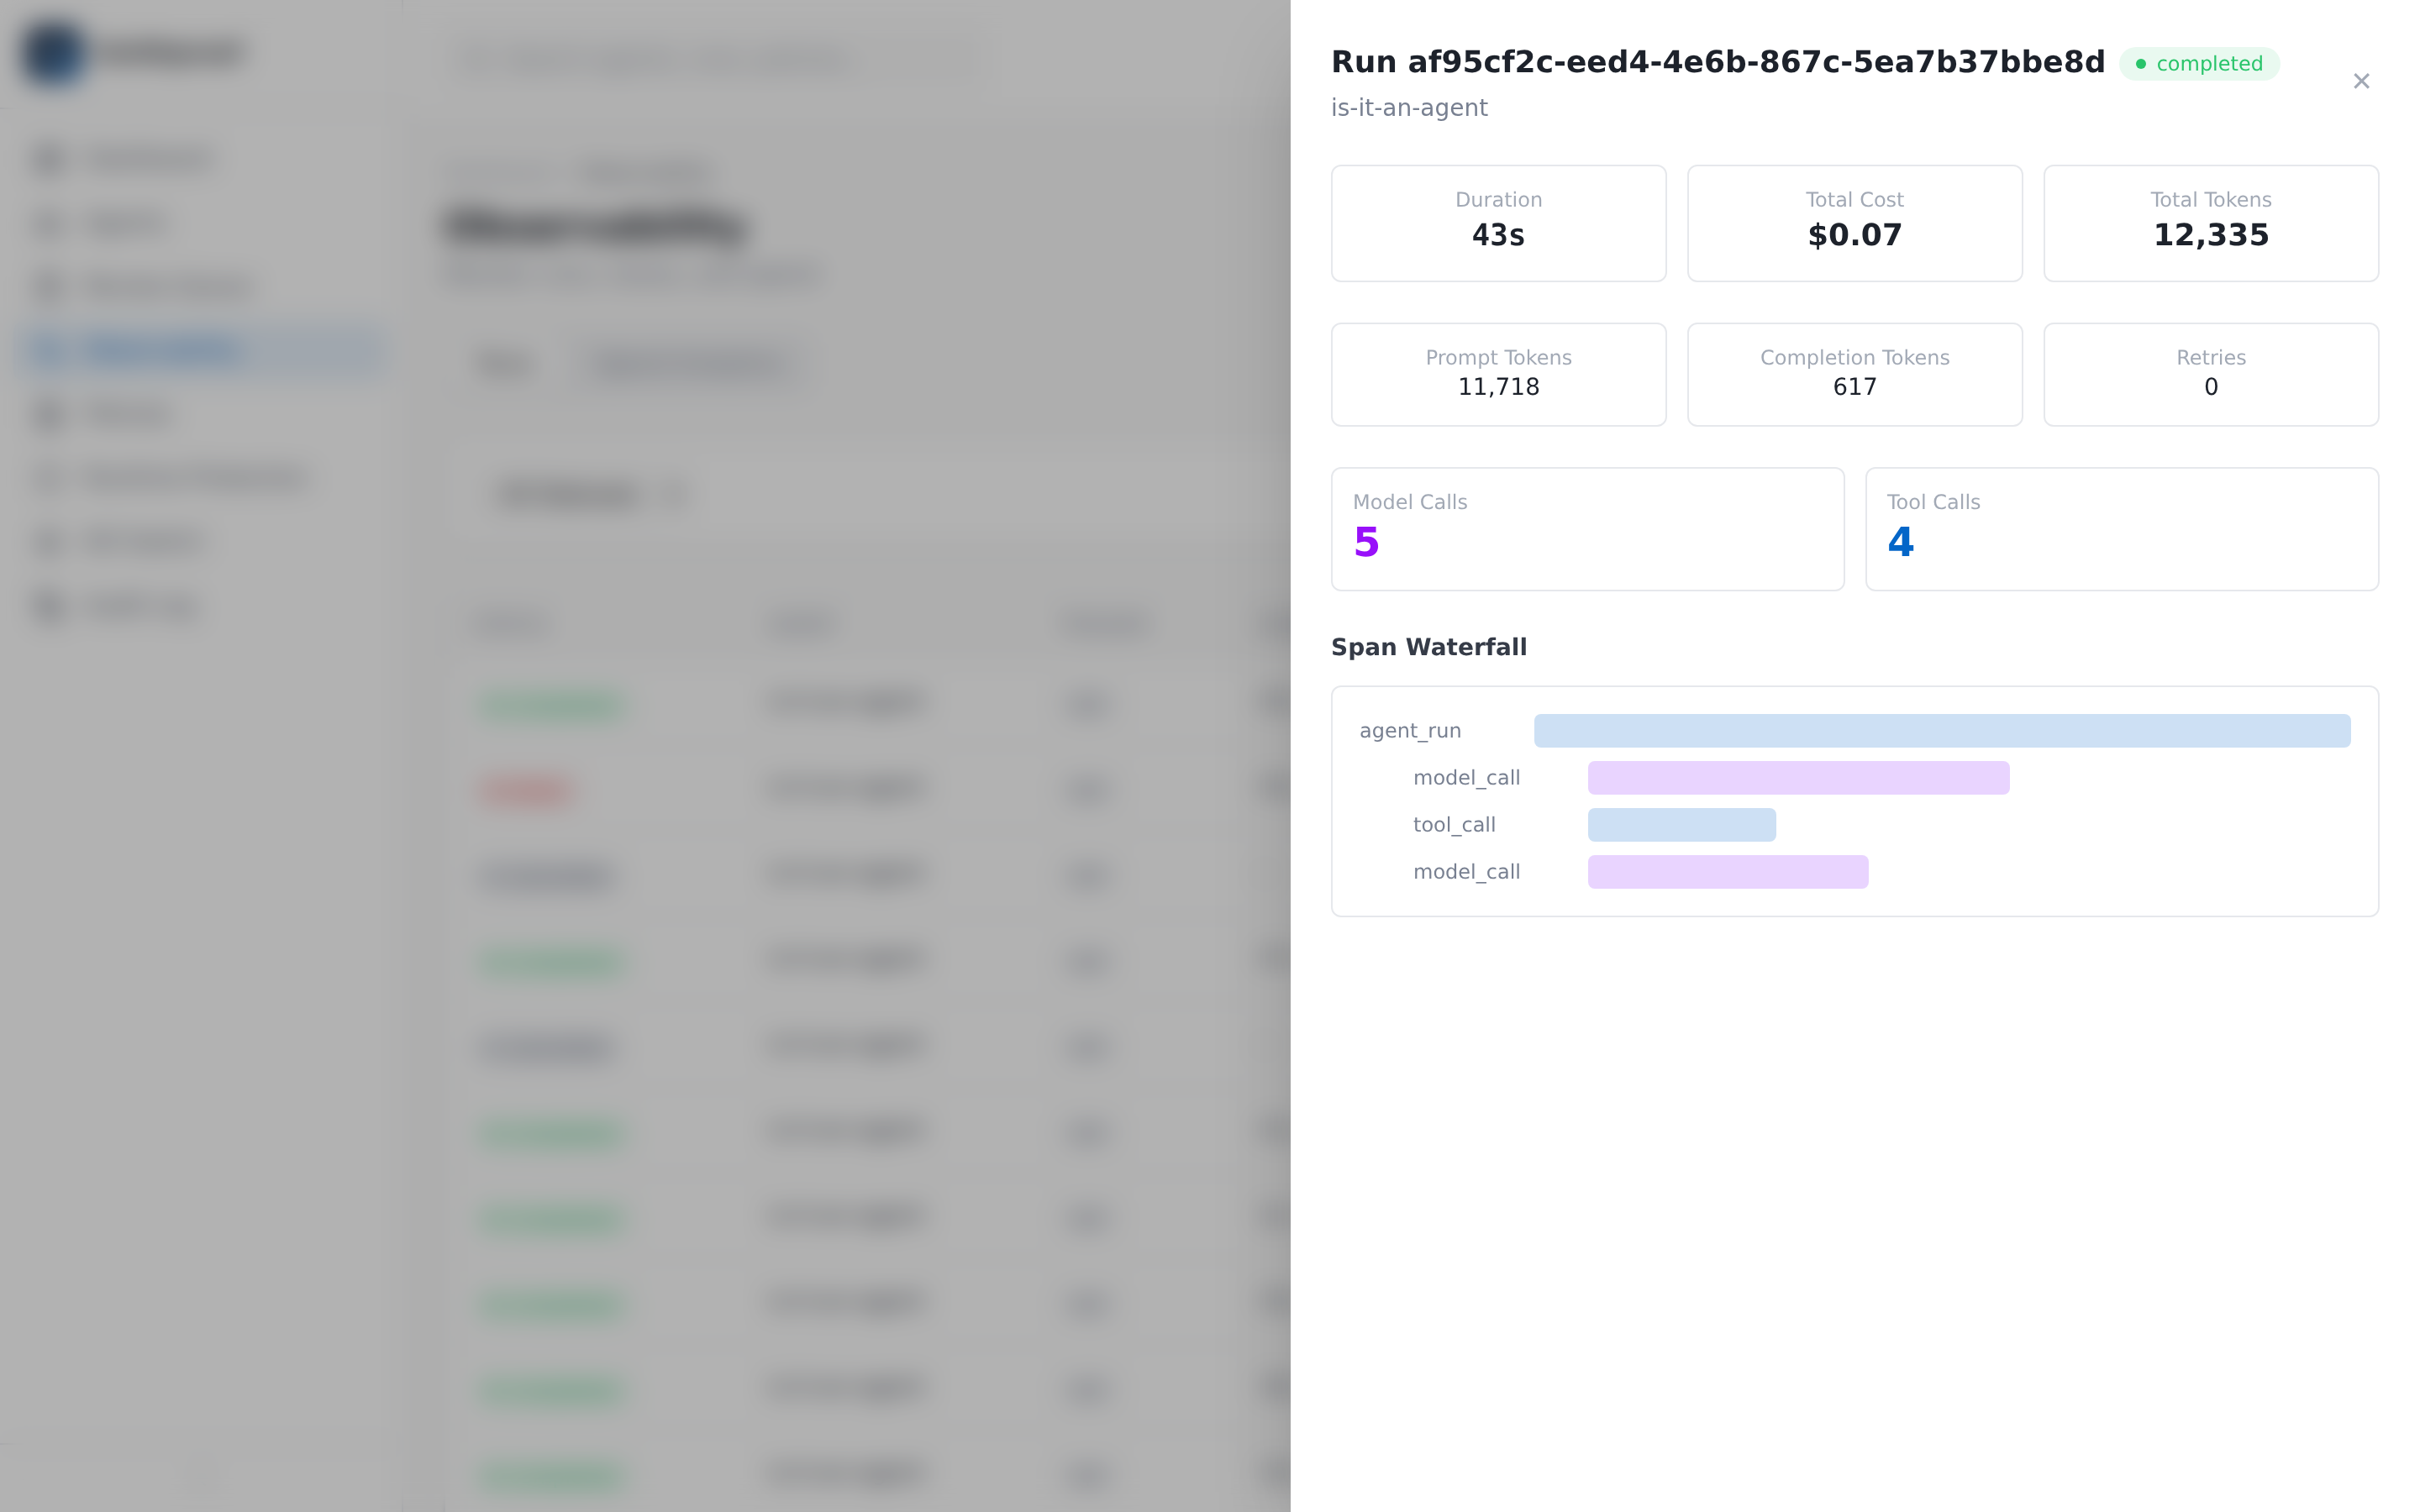 Der ReAct-Rhythmus, von außen wiedergewonnen. Diese Ansicht bekommt man von einer Funktion nicht; da ist nichts zu sehen außer einem Block.
Und bei der einen Aufgabe, bei der der Agent echte Freiheit hatte — dem offenen Audit, dessen Befunde einen Mitarbeiter benennen —, gibt der governed Lauf sein Urteil nicht aus eigener Autorität frei. Er legt die Befunde in eine Review-Warteschlange und blockiert, bis ein Operator genehmigt oder ablehnt:
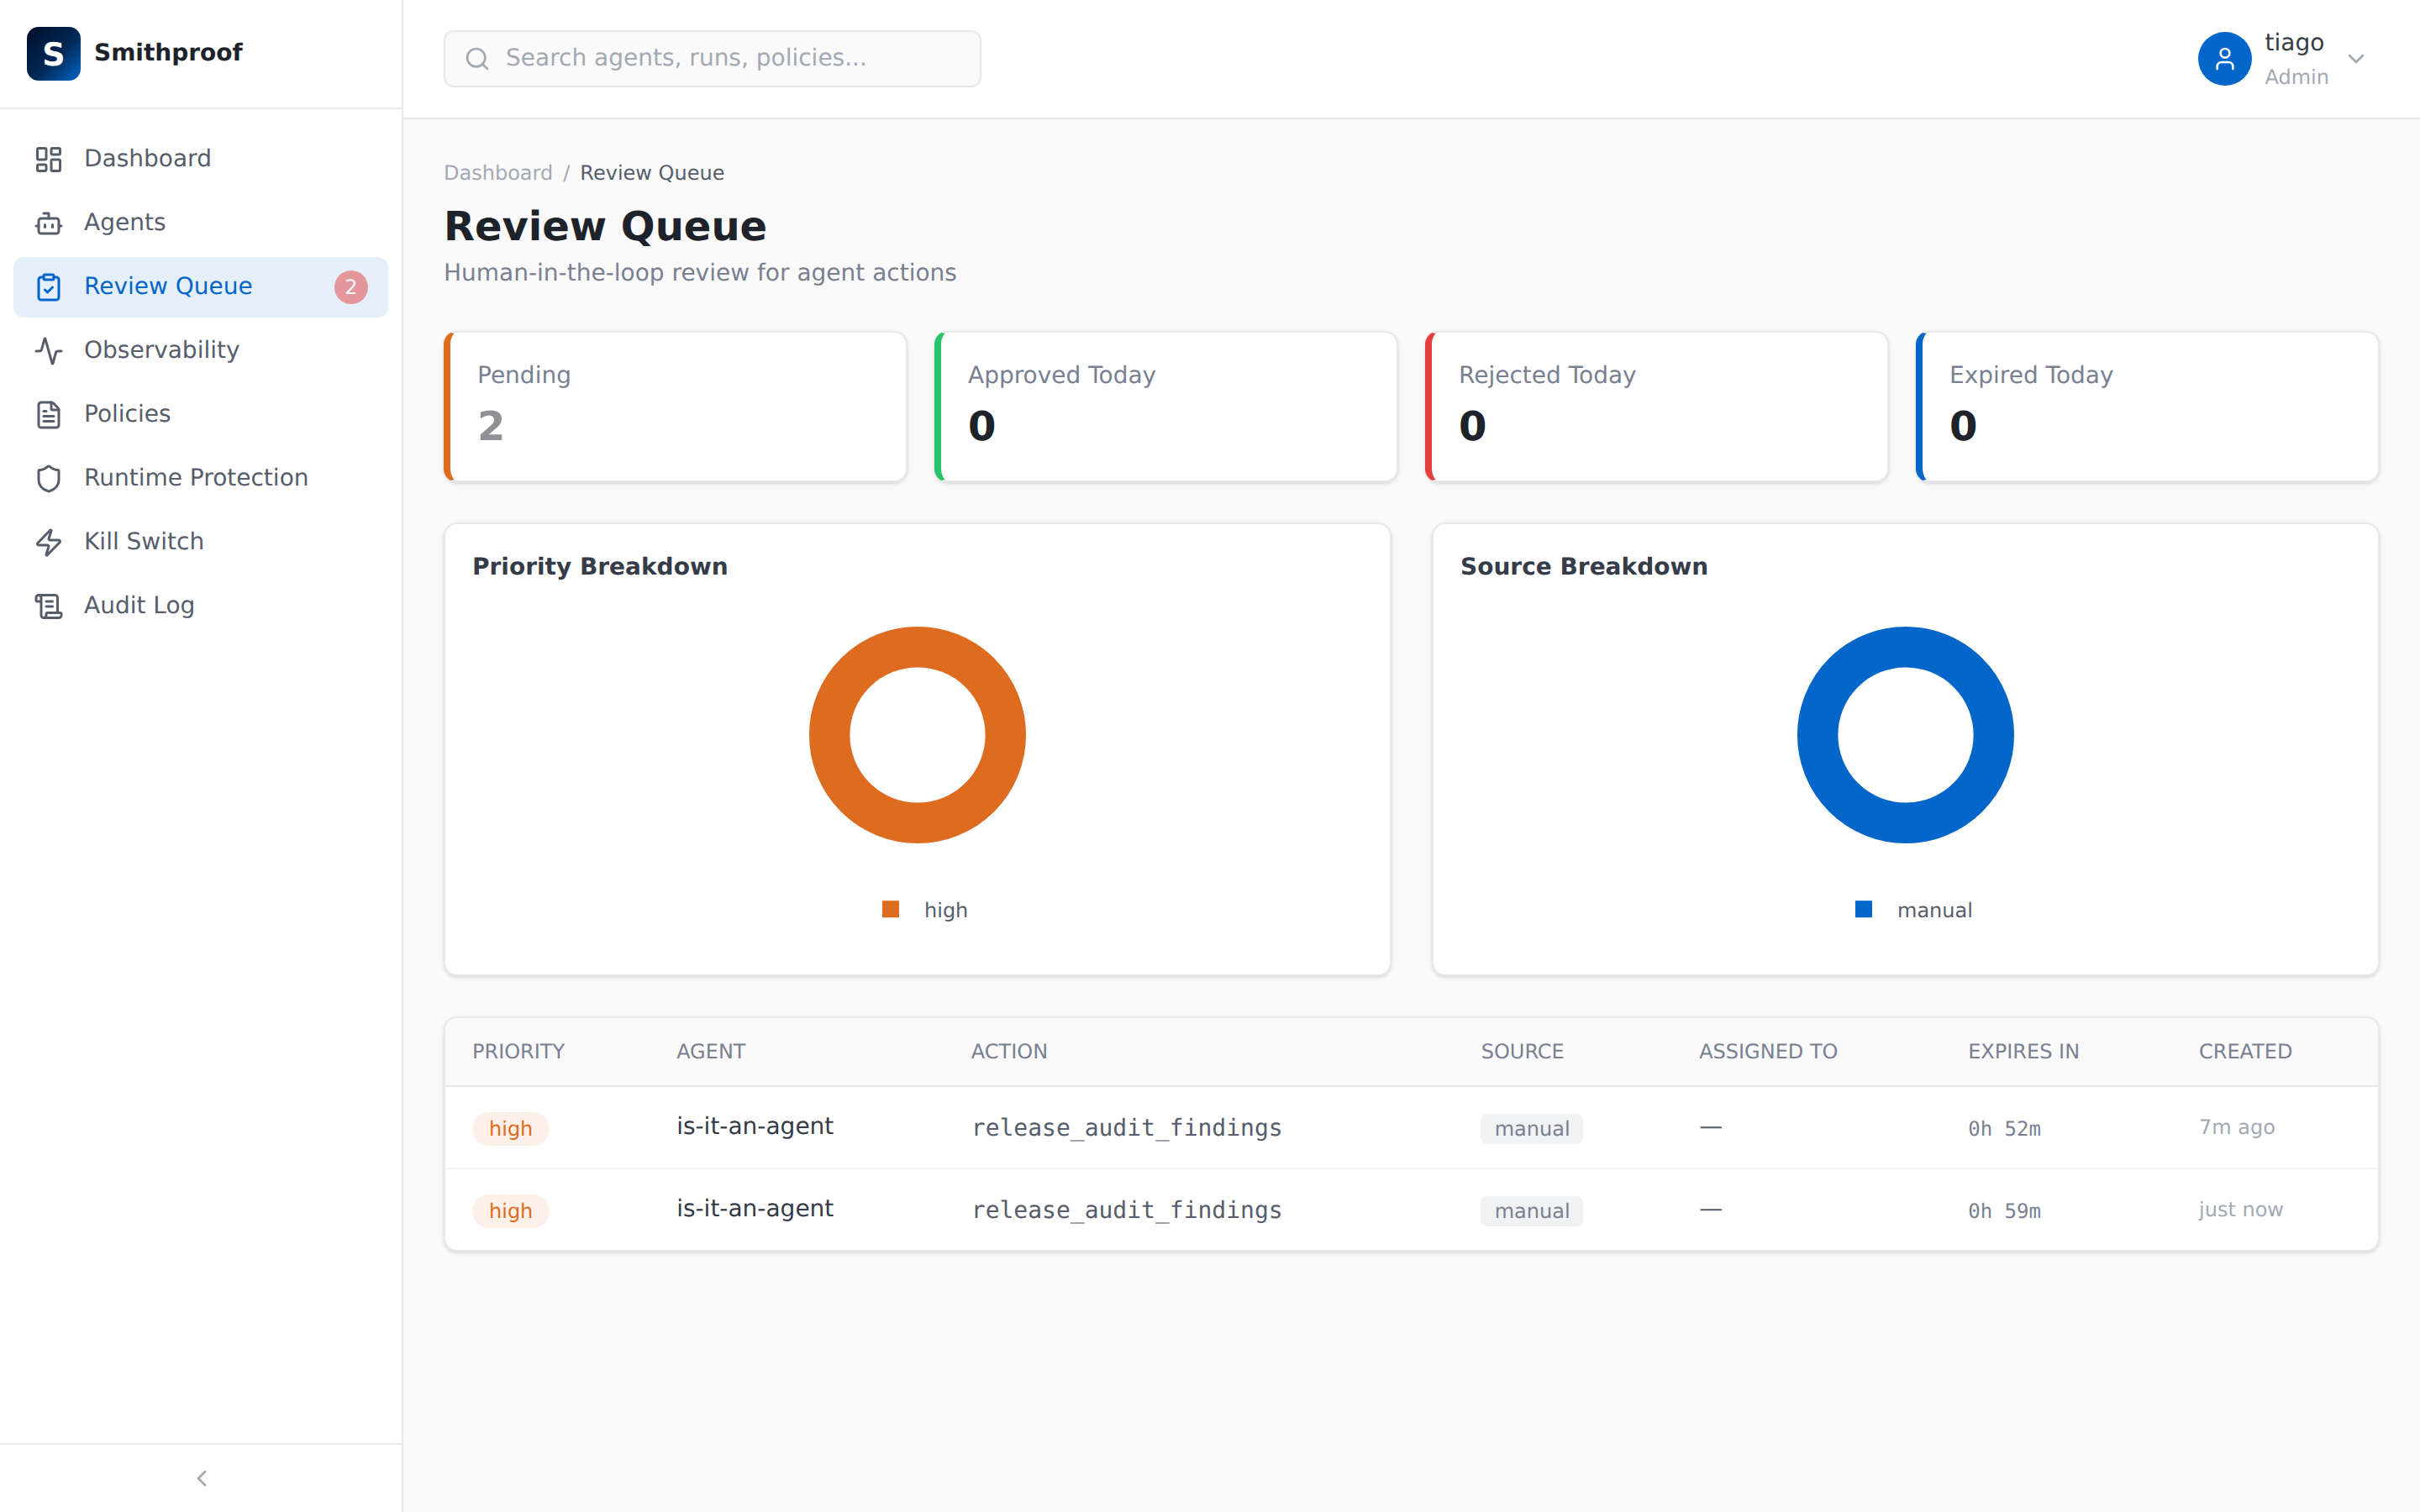 Beachten Sie, wo das Tor sitzt: nicht bei den wohlspezifizierten Fragen, deren Antwort eine Zahl ist, die jeder nachrechnen kann, sondern genau in dem Band, in dem das Modell Freiheit hatte. Review-Aufwand folgt Laufzeitfreiheit.
Versuchen Sie, den Workflow unter irgendeinem dieser Schutzmechanismen laufen zu lassen, und die Frage beantwortet sich selbst. Es gibt keine Tür, an der man ihn abweisen könnte. Seine zwei LLM-Aufrufe füllen Felder in einer Kette, deren Form feststand, als ich sie schrieb. Die Governance-Rechnung ist der Preis der Laufzeitfreiheit, und nur eine der drei Formen schuldet sie.
Wofür das Wort da ist
Nichts davon ist ein Argument gegen Funktionen oder Workflows. Die Messungen argumentieren laut für sie, überall dort, wo die Frage aufzählbar ist: Der Workflow erreichte die Genauigkeit des Agenten innerhalb seiner Routen zu einem Achtel der Kosten, mit null Varianz und nichts zu governen. Wenn Ihr Produkt eine Funktion ist, liefern Sie die Funktion aus, und genießen Sie, dass sie nie einen Kill Switch brauchen wird.
Das Argument ist, dass die drei Formen verschiedene Ingenieursobjekte mit verschiedenen angehefteten Rechnungen sind, und das Wort "Agent" soll offenlegen, welche Rechnung Sie unterschreiben. Varianz, die man tracen muss. Ausgaben, die man zur Laufzeit deckeln muss. Handlungen, die ein menschliches Tor brauchen. Eine Flotte, die man anhalten können muss. Wenn ein Anbieter eine typisierte Funktion einen Agenten nennt, berechnet er Ihnen die Angstprämie der einen Form und liefert die Garantien einer anderen — oder schlimmer, er bringt Ihnen bei, dass das Wort Rauschen ist, kurz bevor Sie etwas ausrollen, das wirklich zur Laufzeit entscheidet, und niemand nach Tracing, Budget oder Aus-Schalter greift, weil die letzten drei "Agenten" sie nie gebraucht haben.
Machen Sie den Zehn-Läufe-Test mit dem nächsten Ding, das man Ihnen verkauft. Wenn alle Traces gleich aussehen, haben Sie eine Funktion oder einen Workflow — zahlen Sie gern die kleinere Rechnung. Und wenn die Traces variieren, haben Sie einen Agenten, und die Varianz ist nicht der beeindruckende Teil. Sie ist die Rechnung — und an dem Tag, an dem Ihre Daten dem Prompt entwachsen, ist sie auch die einzige Architektur, die noch steht, um Ihnen eine zu schicken.
Fragen, die dieser Artikel beantwortet
Was macht etwas wirklich zu einem Agenten und nicht zu einem Workflow?
Das Modell entscheidet den Kontrollfluss zur Laufzeit: welches Werkzeug aufgerufen wird, ob noch eine Schleife gedreht wird, wann Schluss ist. Anthropics Essay über den Bau effektiver Agenten zieht dieselbe Linie: Workflows orchestrieren LLMs entlang vordefinierter Codepfade, Agenten steuern ihren eigenen Prozess. Eine feste Kette aus Klassifizieren, Ausführen und Formulieren bleibt ein Workflow, egal wie viele LLM-Aufrufe sie enthält, weil jeder mögliche Pfad zur Autorenzeit von einem Menschen aufgezählt wurde.
Wie prüfe ich, ob das, was ein Anbieter Agent nennt, wirklich einer ist?
Lassen Sie es zehnmal auf derselben Eingabe laufen und schauen Sie auf die Struktur der Traces, nicht auf die Formulierung der Ausgabe. Variiert die Struktur nie, also andere Werkzeuge und eine andere Anzahl von Schritten, dann ist es eine Funktion oder ein Workflow: im gemessenen Raster erzeugten beide genau eine Trace-Form, der Agent dagegen fünf bei der offenen Aufgabe. Es gibt eine vierte Form des Tests, die die Definition rückwärts liest: Wenn das System kein Tracing, keine Budgetgrenze und keinen Weg braucht, ihm Nein zu sagen, war es nie ein Agent.
Wenn ein großer LLM-Aufruf die richtige Antwort liefert, wozu dann überhaupt ein Agent?
Bei kleinen Daten braucht es keinen, und die Messungen sagen das deutlich. Mit dem kompletten 116-Zeilen-Hauptbuch im Prompt lag der einzelne Funktionsaufruf 40 von 40 Mal richtig, einschließlich des eingepflanzten Betrugs, zu $0,0123 pro Lauf. Das Problem ist, dass ihre Kosten linear in den Daten sind: bei 4.989 Zeilen kostete dieselbe richtige Antwort $0,45 pro Frage gegen $0,036 beim Agenten, und bei 49.889 Zeilen überstieg der Prompt das Kontextfenster, der einzige Zug dieser Architektur war nicht verfügbar, und sie erreichte null von fünf, ohne einen einzigen Modellaufruf zu platzieren.
Was kostet ein Agent, was ein Workflow nicht kostet?
Varianz, die man tracen muss, Ausgaben, die man deckeln muss, während die Schleife noch läuft, Handlungen, die ein menschliches Tor brauchen, und eine Flotte, die man anhalten können muss. In diesem Projekt läuft die Agenten-Implementierung governed gegen eine Kontrollebene: mit der auf zwei Cent verengten Grenze schaffte ein echter Lauf vier Modellaufrufe, der fünfte wurde verweigert, bevor er platziert war, und die Policy-Engine liest die aufgezeichneten Ausgaben des Laufs serverseitig, statt einer Zahl zu vertrauen, die der Client liefert. Der Workflow schuldet nichts davon, weil seine zwei LLM-Aufrufe Felder in einer Kette füllen, deren Form beim Schreiben des Codes feststand.
Weiterlesen
 AI Agents
Meine KI kennt mich perfekt. Sie hat keine Ahnung, was ich will
Ich habe einem Frontier-Modell ein beispielhaftes 90-Tage-Protokoll aus meinen echten Gewohnheiten gegeben und dann den heutigen Abend vom Protokoll abweichen lassen. 180 bewertete Läufe später: Gedächtnis macht das Modell nicht blind, wenn der Hinweis im Raum steht, das eigentliche Produkt des Gedächtnisses ist Stille an gewöhnlichen Abenden — und das eine Mal, als ich eine Frage gebraucht hätte, drückte der Assistent, der alles wusste, auf Play bei genau der Folge, die ich vermied, und bot mir passend zum Anlass einen Tee an. AI
Jev antwortet in Wahrscheinlichkeiten. Die Frage bleibt deine.
Jev von TypeSafe schreibt keinen einzigen Satz. Du gibst ihm einen Zustand und typisierte Fragen, und es gibt eine Wahl, einen Score oder eine Ja/Nein-Wahrscheinlichkeit zurück, für vier Tausendstel Cent pro Entscheidung bei tausend Tokens Eingabe. Das Neue ist die Form, die die Autorität zurück in deinen Code legt, und die Falle ist, dass eine Wahrscheinlichkeit nach Absicherung aussieht und keine ist. Ich habe den Pilotversuch gefahren, den ich verlangen würde, bevor ich irgendeiner Zahl glaube, auf meinen eigenen Essays mit dem offenen Modell, das für Jev eingesprungen ist, und die Antwort war Nein.