
Ich habe die Pipeline gebaut, die mein Produkt gebaut hat. Was Delegieren wirklich verlangt
Artikel anhören (experimentell) · 14:37

Gestern habe ich einen Satz getippt, "Add CSV export for completed tasks", ein CLI auf eine kleine Task-Tracking-API gerichtet und bin einfach weggegangen. Zwölf Minuten später gab es einen Plan mit Akzeptanzkriterien, fünf Tickets auf einem Board, einen Freigabe-Nachweis und einen Draft Pull Request mit einem funktionierenden Endpoint, einem neuen Modul, Tests und aktualisierter Doku: 1.190 neue Zeilen auf einem zusammenhängenden Branch, ein Commit pro Task, alles wartete nur noch auf das Review.
Der Wunsch ist älter als das Werkzeug. Wer in einem Unternehmen mit Scrum gearbeitet hat, kennt diesen Gedanken aus der Sprint-Planung: Die User Stories liegen da, verfeinert und geschätzt, und wie schön wäre es, wenn eine KI die erste Iteration übernähme, während wir unsere Zeit damit verbringen, den PR zu reviewen, ihn lokal laufen zu lassen, um zu prüfen, dass alles funktioniert, nachzujustieren und die Runde erneut zu drehen. Spart das wirklich Zeit? Schwer zu sagen, und ich habe das Werkzeug nicht gebaut, um dieses Argument zu gewinnen. Ich habe es gebaut, um diese Erfahrung real zu machen, und die Frage nach dem Nutzen erst einmal beiseitegelassen.
In einem früheren Beitrag habe ich über Smithproof geschrieben, die Control Plane, die ich gebaut habe, um KI-Agenten zu kontrollieren. Dies ist die Geschichte des Werkzeugs auf der anderen Seite dieser Beziehung: plan-to-pr, eine Kommandozeilen-Pipeline, die einen natürlichsprachlichen Feature-Wunsch in geprüfte Pull Requests verwandelt. Die beiden sind enger verflochten als ein Demo-Paar. Die Pipeline hat beim Bau der Control Plane geholfen, und die Control Plane kontrolliert heute die Pipeline. Doch bevor es um beides geht, verdient die Pipeline ihren eigenen Feldbericht, denn ihr Bau hat mich gelehrt, was Delegieren an Coding-Agents tatsächlich verlangt.
Was die Pipeline ist
Vier Stufen, jede mit einem Artefakt:
| Stufe | Was passiert | Was davon bleibt |
|---|---|---|
| Plan | Ein LLM klassifiziert die Absicht, reichert den Wunsch mit einem Repo-Scan an und erzeugt Epics, Tickets und Tasks mit Akzeptanzkriterien | plan.json, gegen ein Schema validiert |
| Tickets | Pro Task landet ein Ticket auf dem Board (Trello oder GitHub Issues) | Karten, die ein Team sehen und neu zuweisen kann |
| Approve | Ein menschliches Gate; Ablehnung bedeutet exit code 4 | approval.json: wer, wann |
| Execute | Jedes Ticket bekommt einen eigenen Branch; ein Agent generiert Code Task für Task | Ein Draft PR pro Ticket, zurückverlinkt auf sein Ticket |
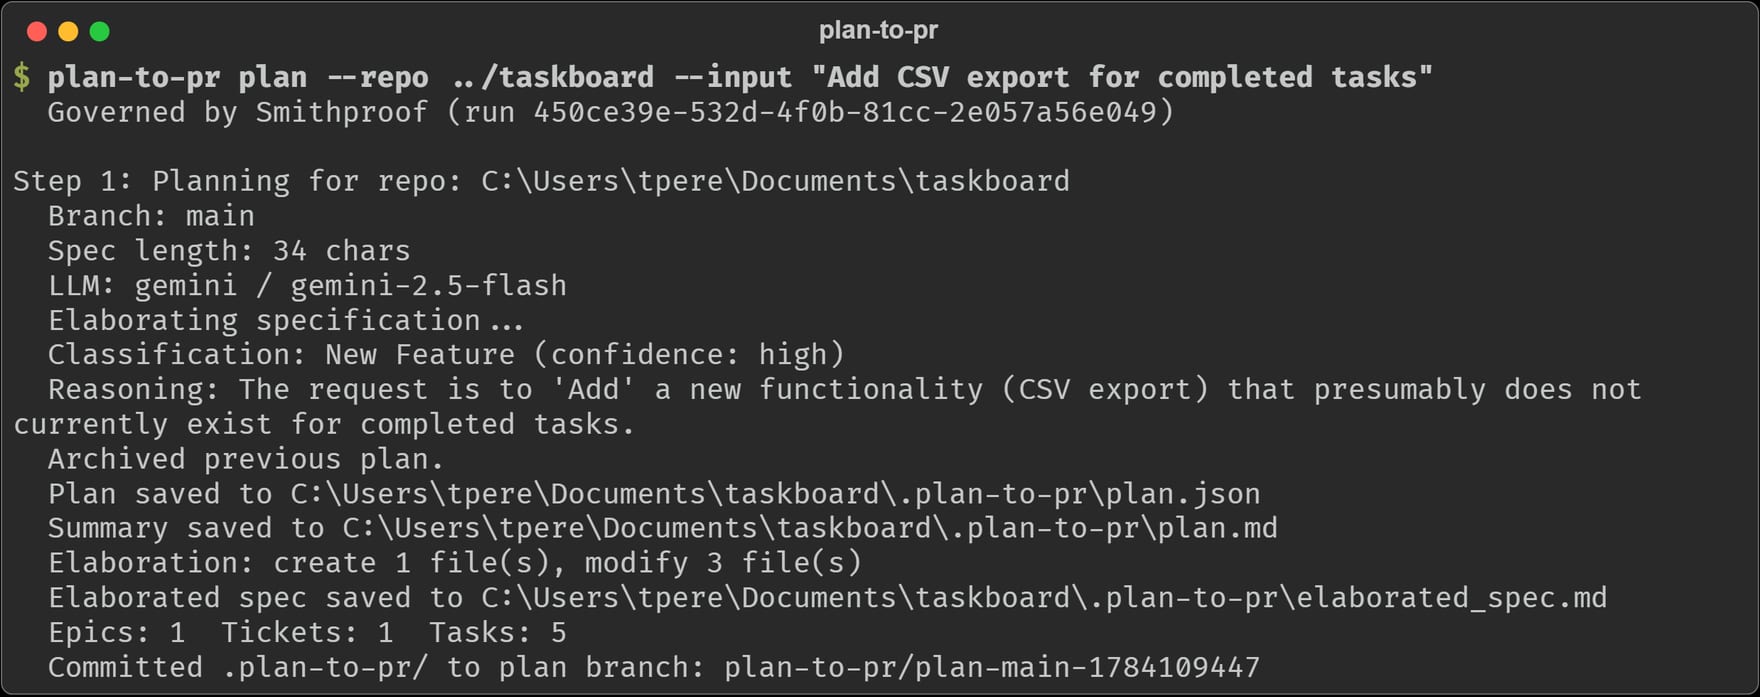 Der Plan-Lauf aus der Demo. Der Plan selbst wird auf einen eigenen Branch committet, nie auf main.
Der Zustand, der alles zusammenhält, liegt in einem .plan-to-pr/-Ordner im Ziel-Repository: der Plan, die Ticket-Zuordnungen, die Ausführungsergebnisse. Läufe sind wiederaufnehmbar; ein abgeschlossener Task wird nie erneut ausgeführt. Nichts davon ist exotisch. Genau das ist der Punkt. Die Pipeline ist bewusst langweilige Orchestrierung um ein Modell herum, das alles andere als vorhersehbar ist.
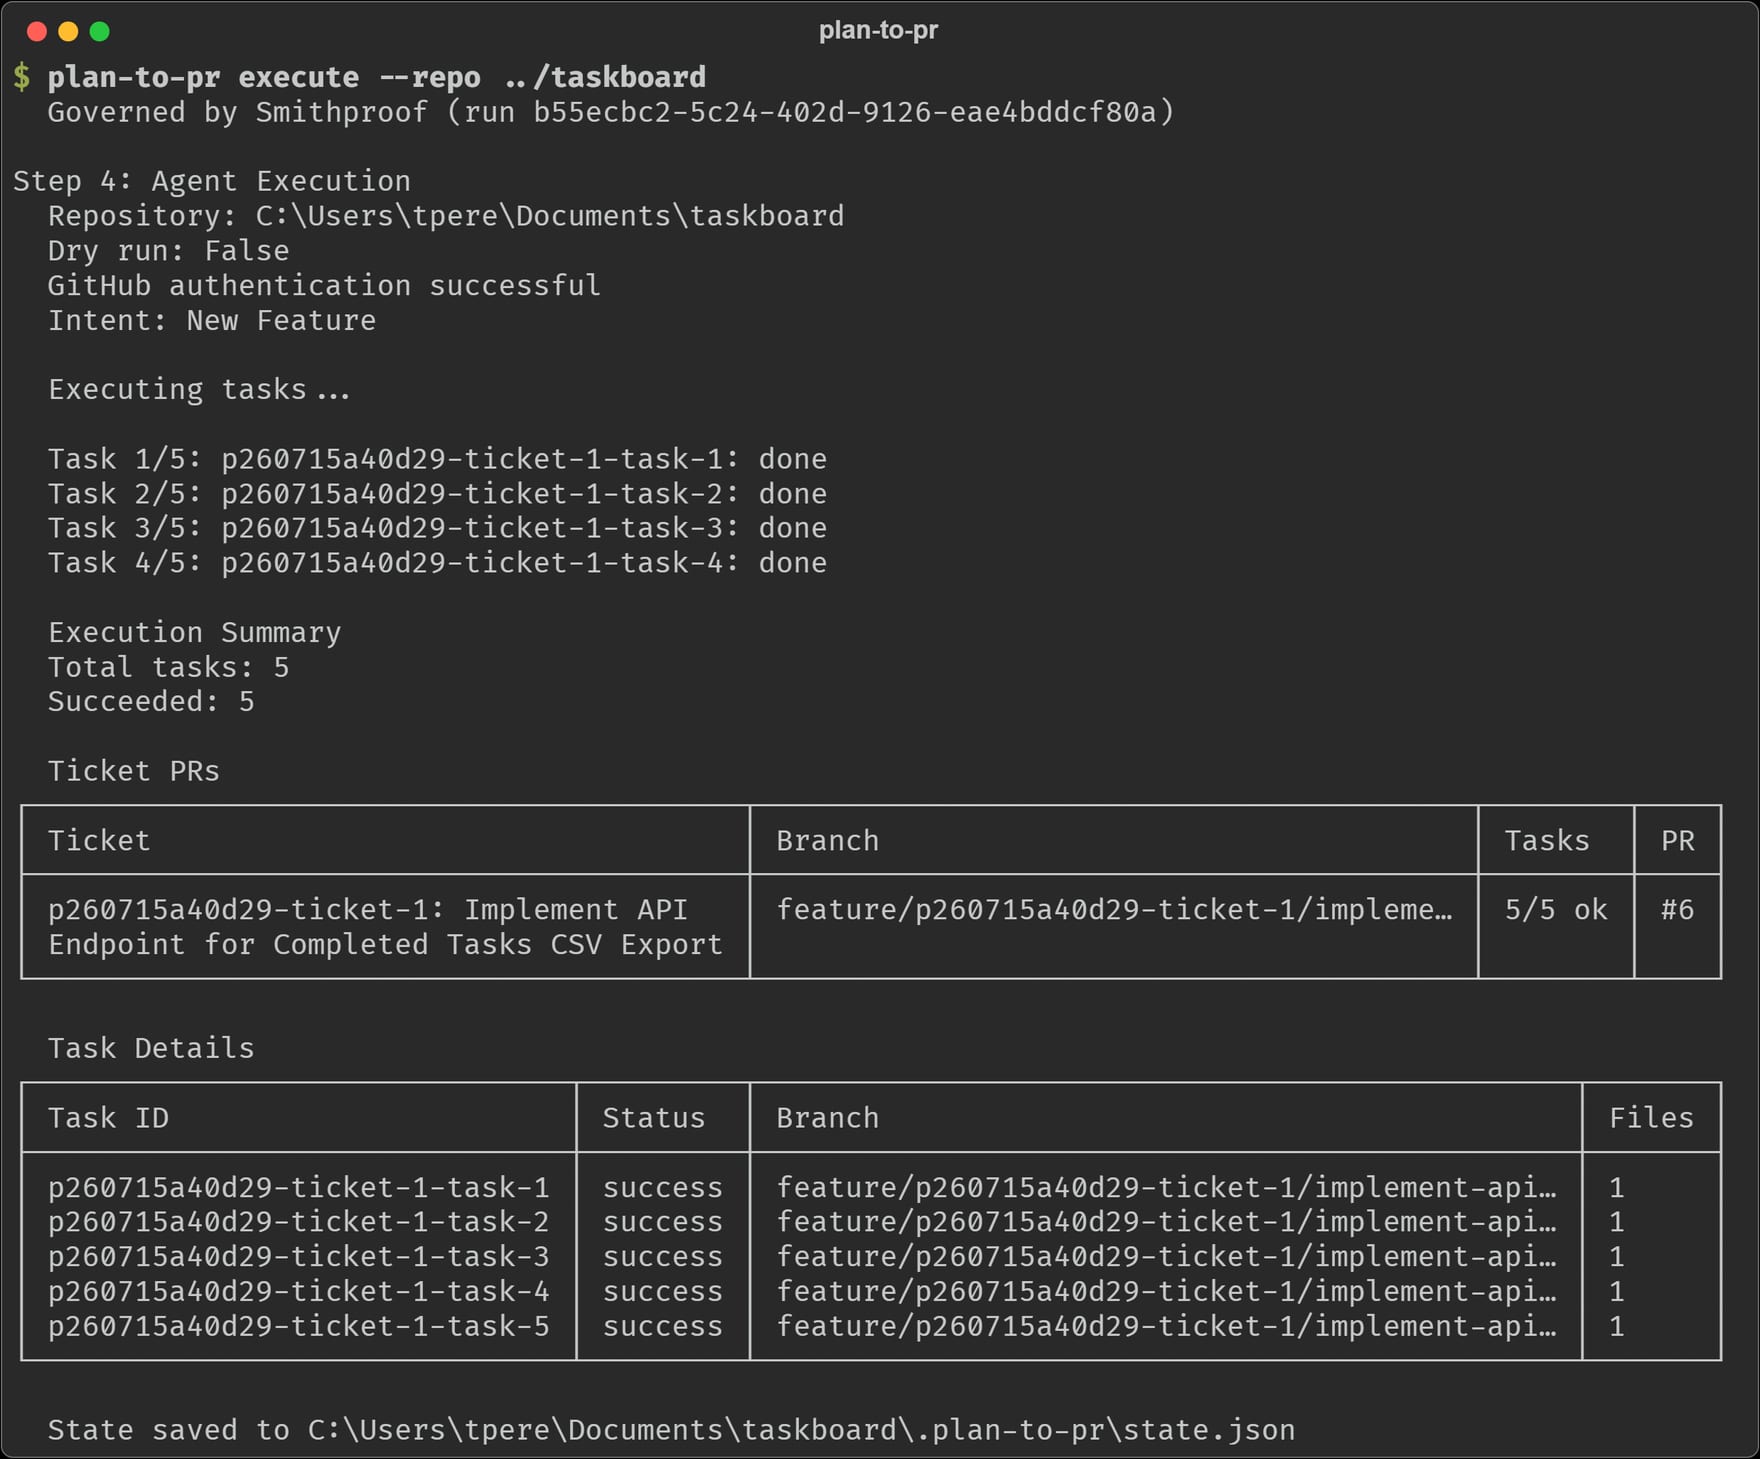 Execute, von Anfang bis Ende: ein Branch pro Ticket, ein Commit pro Task, ein Draft PR mit der Checkliste in der Beschreibung.
Warum eine Pipeline und kein Chat
Ich nutze interaktive Coding-Agents jeden Tag, und die naheliegende Frage verdient eine klare Antwort: Warum nicht Claude Code öffnen, den Plan-Modus nutzen und all das von der Session erledigen lassen?
Für Exploration, einen einmaligen Fix oder alles, wo ich mitten im Flug steuern will, gewinnt die interaktive Session, und zwar deutlich. Aber Delegieren ist ein anderer Job als Zusammenarbeiten, und der Unterschied zeigt sich an fünf Stellen.
Artefakte sind der Standard, kein Gefallen. Ein fähiger Chat-Agent schreibt eine Plandatei und legt Tickets auf dem Board an, wenn man ihn darum bittet, und eine gut geschriebene Skill sorgt dafür bei jedem Aufruf, an den man denkt. Der Unterschied liegt darin, wo die Garantie wohnt. Eine Skill bleibt ein Satz Anweisungen, dem das Modell fast immer folgt; eine Pipeline-Stufe ist Code, der sich nicht überspringen lässt. Treibt man den Skill-Ansatz bis zum Ende, Hooks, die die Ausführung blockieren, bis eine Freigabedatei existiert, ein Skript für jede Stufe, dann hat man genau diese Pipeline gebaut, mit einem Chat-Fenster davor. Wenn ich drei Tage später zurückkomme, liegt der Zustand der Welt auf dem Board und in den Branches, weil nichts anderes möglich war, nicht weil alle daran gedacht haben, danach zu fragen.
Ein Gate ist keine Frage. Ein interaktiver Agent fragt "Sieht das so richtig aus?", und die Wahrheit ist: Nach genug Freigaben liest man nicht mehr. Der Freigabe-Schritt der Pipeline ist ein harter Stopp mit einem Exit-Code. Nichts wird ausgeführt, bis approval.json existiert, und Ablehnung ist ein vollwertiges Ergebnis, keine höfliche Nachricht.
Arbeitseinheiten sind Review-Einheiten. Die Pipeline erzeugt einen PR pro Ticket, jeder klein genug, um ihn wirklich zu reviewen, jeder verlinkt mit dem Ticket, das ihn ausgelöst hat. Eine lange Agenten-Session produziert eher einen ausufernden Diff, geformt von der zufälligen Reihenfolge des Gesprächs.
Kontrollfluss gehört in Code. In der Pipeline schreibt das Modell Pläne und Code innerhalb klar definierter Schritte, aber die Schleife selbst, was läuft, in welcher Reihenfolge, was bei einem Fehler passiert, ist deterministisches Python. Wenn nachts um zwei etwas kaputtgeht, debugge ich eine Pipeline, keine Persönlichkeit.
Eine Pipeline lässt sich kontrollieren. Das ist der Punkt, der mir am wichtigsten ist, und er bekommt unten seinen eigenen Abschnitt. Ein CLI mit definierten Einstiegspunkten kann registriert, beobachtet, budgetiert und abgewiesen werden. Zu einer freien Session lässt sich viel schwerer Nein sagen.
Nichts davon ist ein Argument gegen interaktive Agents. Es ist ein Argument dafür, dass "lass das den Agenten machen" in zwei Produkte zerfällt: einen Mitarbeiter, den man steuert, und einen Beauftragten, den man zur Rechenschaft zieht. Der zweite braucht Belege.
Die beiden bestehen in meiner eigenen Arbeit nebeneinander, und genau dieses Projekt hat beide benutzt. Der letzte Feinschliff am Werkzeug kam von Claude Code mit Fable 5 und Opus 4.8, Modellen, die schneller und stärker sind als die der Pipeline, mit einem Max-Abo, bei dem ich aufhöre, Tokens zu zählen. Wenn die Kosten pauschal sind und ein Mensch an der Tastatur sitzt, gewinnt der interaktive Agent den Sprint. Die Pipeline braucht von Anfang bis Ende länger, vermute ich, aber sie läuft auf einem Modell im Gratis-Kontingent, ihre Kosten pro Feature sind eine Zahl, die man von einem Dashboard abliest, und ihr Verhalten ist beim zehnten Lauf dasselbe wie beim ersten. Billiger und berechenbarer ist nicht die glamouröse Hälfte des Tauschs, aber es ist die Hälfte, die zählt, sobald der Mensch sich entfernt und etwas die Ausgaben deckeln muss.
Der schwierige Teil ist die Aufteilung, und die Lösung steckt in einem Prompt
Die tiefste technische Lektion kam aus dem Ausführungsmodell.
Jedes Ticket läuft auf einem frischen Branch, abgezweigt vom Basis-Branch. Tickets sehen die Dateien der anderen nicht, weil ihre Branches noch nicht gemergt sind. Die erste Konsequenz kommt schnell: Gruppiert der Planner die Arbeit nach Schichten, alle Models in einem Ticket, alle Endpoints in einem anderen, dann importiert jeder Branch Dateien, die nur auf einem Geschwister-Branch existieren, und nichts läuft.
Die Lösung steckt nicht im Executor. Sie steckt im System-Prompt des Planners, der dem Modell die Ausführungstopologie des Werkzeugs selbst beibringt: Code aus anderen Tickets liegt nicht auf der Platte; wenn Datei A Datei B importiert, gehören beide ins selbe Ticket; Arbeit wird als vertikale Slices gruppiert; gemeinsame Grundlagen kommen in Ticket eins. Der Prompt benennt sogar das Anti-Pattern, ein Ticket für alle Models und eines für alle Schemas, als garantierten Import-Fehler. Im Demo-Lauf hat der Planner die Storage-Funktion, das CSV-Modul, den Endpoint und die Tests genau deshalb in ein einziges Ticket gepackt, weil sie eine einzige Abhängigkeitskette bilden.
Als Design-Artefakt finde ich das wirklich interessant: Die Einschränkung ist infrastrukturell, die Lösung ist sprachlich, und beide haben sich gemeinsam entwickelt, durch beobachtete Fehlschläge. Zwei kleinere Bausteine runden das ab. Während der Ausführung klassifiziert ein Discovery-Durchlauf, welche Dateien erstellt, geändert oder als Konventionskontext gelesen werden, und der Codegenerator kann Dateien von den Branches anderer abgeschlossener Tickets mit git show lesen, Cross-Branch-Bewusstsein, ohne jemals auszuchecken. Und weil LLM-Ausgaben für Parser feindliches Terrain sind, laufen die Plan- und Code-Antworten durch einen kleinen Verteidigungs-Stack: Sentinel-Marker, vier Extraktions-Fallbacks, einen Escape-Reparierer für Regex-in-JSON und eine Retry-Schleife, die den Parse-Fehler bei niedrigerer Temperatur an das Modell zurückspielt. Jedes einzelne Teil existiert, weil etwas Echtes kaputtgegangen ist.
Die Belege
Ich vertraue dieser Pipeline, weil sie Arbeit geliefert hat, mit der ich danach leben musste. Teile von Smithproof, darunter das Human-Review-Subsystem und die Maschinerie für Hintergrund-Tasks, kamen als plan-to-pr-Tickets und Draft PRs an, die maschinell erzeugten Branch-Namen stehen noch heute in der Historie. Der Codegen-Prompt trägt weiterhin das Narbengewebe: Konventionen zu den exakten Basisklassen und Schema-Stilen dieser Codebasis, nachgerüstet nach Läufen, die genau das falsch gemacht hatten.
Das gilt in beide Richtungen, und es lohnt sich, das offen zu sagen: Die Pipeline ist am besten bei sauber umrissener Feature-Arbeit in Codebasen mit klaren Konventionen. Sie ist nicht das Werkzeug für verzwickte Refactorings oder für Probleme, die ich noch nicht in einem Satz beschreiben kann. Zu wissen, welche Hälfte der Arbeit welche ist, entpuppt sich als die eigentliche Kunst beim Delegieren an Agents.
Der Kreis schließt sich
Jetzt kommt mein Lieblingsteil. plan-to-pr läuft heute als kontrollierter Agent unter Smithproof, der Control Plane, die es selbst mitgebaut hat.
Sind die Governance-Einstellungen vorhanden, registriert sich jeder Pipeline-Aufruf auf der Control Plane, öffnet einen Run, bevor irgendeine Arbeit passiert, und meldet beim Schließen des Runs seine Modellaufrufe, mit gemessener Latenz und geschätzten Kosten. Die Konsole zeigt die Pipeline in der Flotte wie jeden anderen Agenten: drei Runs gestern, zehn Modellaufrufe auf der Execute-Etappe, rund fünf Cent Kosten.
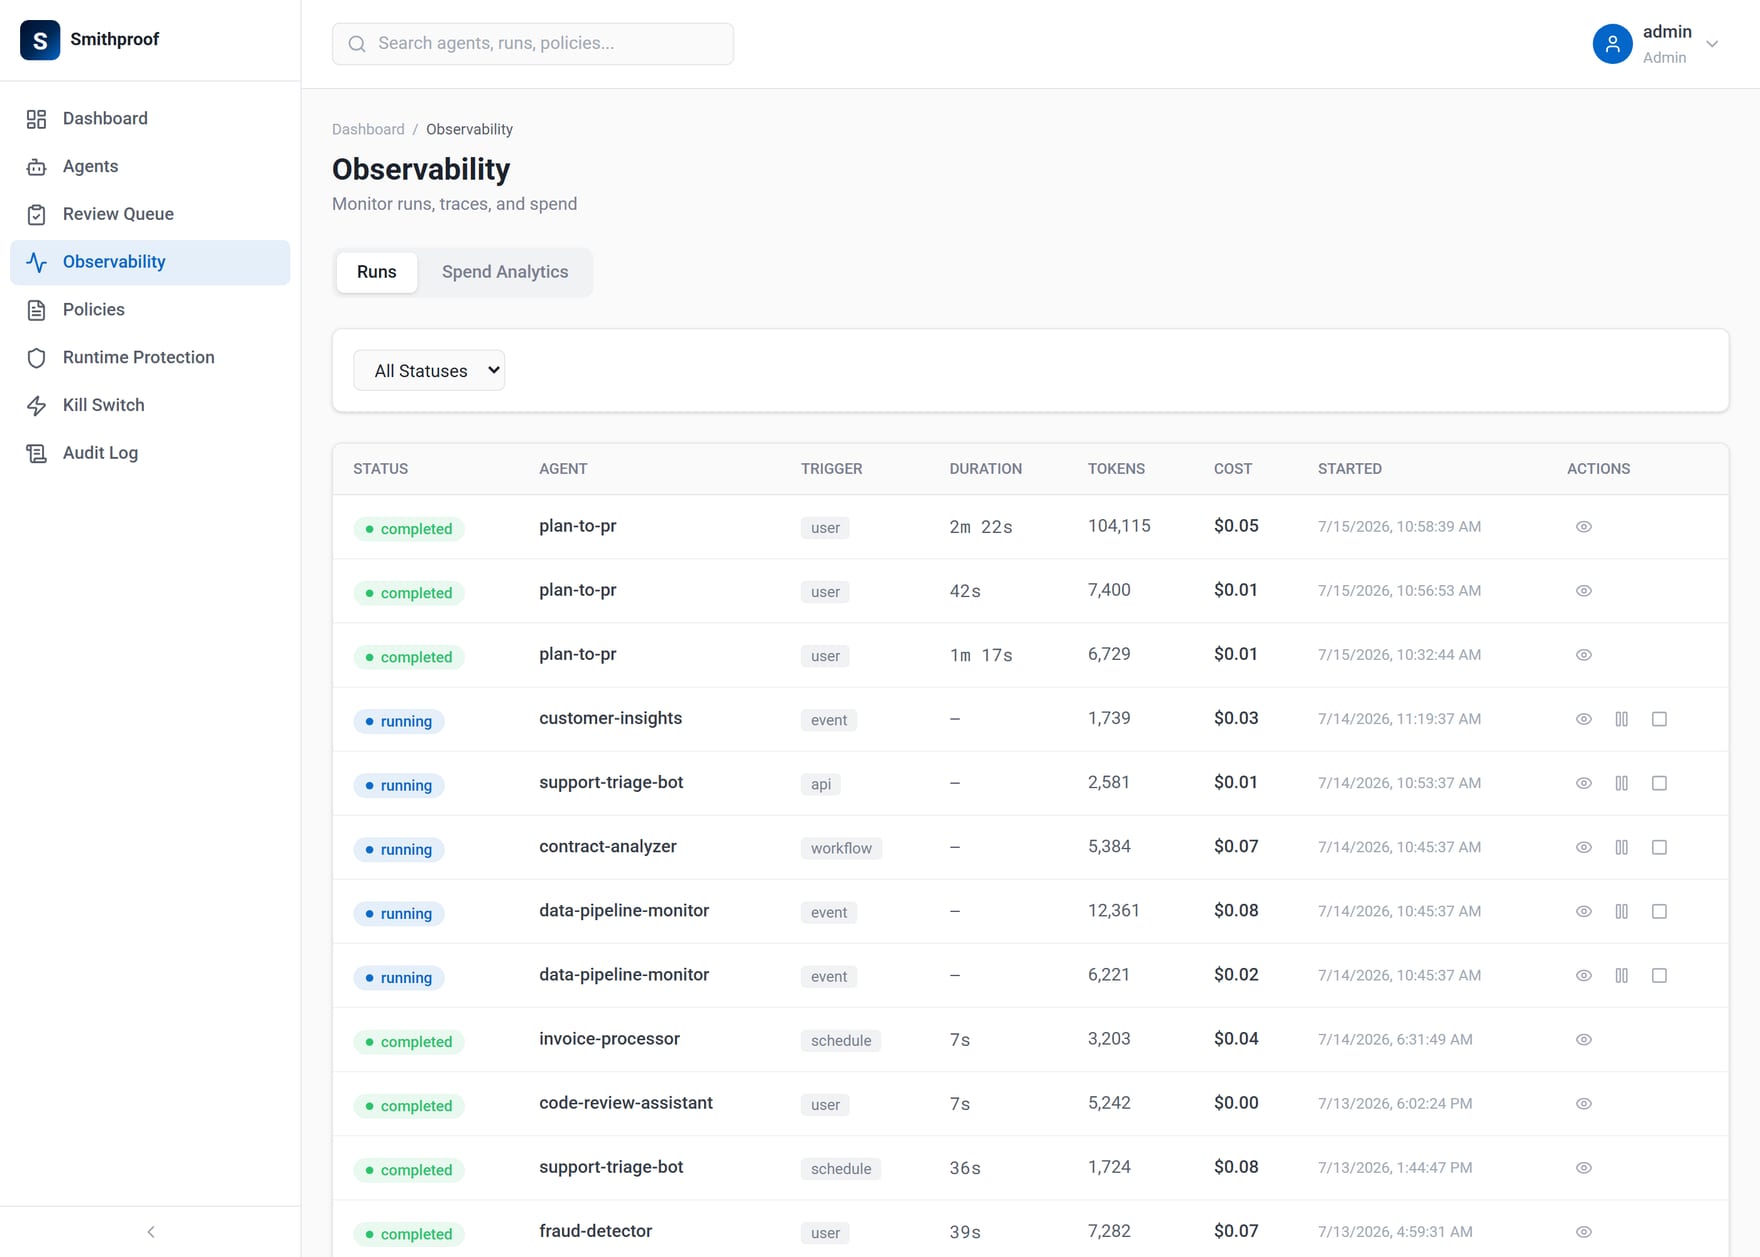 Die Runs der Pipeline in der Observability-Ansicht der Control Plane, neben dem Rest der Flotte.
Was zählt, ist nicht die Telemetrie. Was zählt, ist, dass die Control Plane Nein sagen kann und die Pipeline darauf hört. Stellt man den Agenten in der Konsole unter Quarantäne, stoppt schon der allernächste Aufruf an der Tür, vor einem einzigen Modellaufruf oder einer einzigen Dateiänderung:
 Exit code 5. Die Begründung kommt von der Control Plane, nicht vom Werkzeug.
Die Fehlersemantik verlangte eine echte Entscheidung: Abbruch bei Entscheidung, Warnung bei Ausfall. Verweigert die Control Plane den Run ausdrücklich, bricht die Pipeline ab. Ist die Control Plane nicht erreichbar, warnt die Pipeline laut und macht weiter, denn Telemetrie sollte nie der Grund sein, warum ein Build scheitert, aber eine Entscheidung zu blockieren muss immer respektiert werden. Im letzten Beitrag habe ich geschrieben, dass eine Policy eine Entscheidung ist und Durchsetzung eine Architektur. So fühlt sich die Durchsetzungsseite von innen an, aus dem kontrollierten Prozess heraus, und nachdem ich beide Hälften gebaut habe, kann ich berichten: Der geschlossene Kreis ist befriedigender als jede Hälfte für sich.
Wo es heute steht
plan-to-pr plant heute gegen jedes Git-Repository mit nichts weiter als einem kostenlosen Gemini-Key, legt Tickets auf Trello oder GitHub Issues an und öffnet Draft PRs auf GitHub; ClickUp, Azure DevOps und GitLab stehen auf der Provider-Roadmap. Die Governance-Integration schätzt Token-Zahlen aus Textlängen, bis die LLM-Schicht exakte Nutzungsdaten liefert, und die Runs sind entsprechend markiert. Die Pipeline loggt noch eine Warnung, wenn sie mitten in der Ausführung ihren State-Ordner nicht erneut auf den Plan-Branch committen kann, ein Checkout-Konflikt, der als Nächstes auf der Fix-Liste steht. Feldberichte sollten das Feld nicht aussparen.
Wenn man aus diesem Projekt eines mitnehmen soll: Das Modell war nie der schwere Teil. Die schweren Teile waren dieselben wie bei jedem Delegieren, Zerlegung, Gates, Rechenschaft und die Demut, Belege aufzuheben. Die Werkzeuge, die Agents für echte Arbeit nützlich machen, werden weniger wie klügere Chat-Fenster aussehen und mehr wie das hier: Pipelines mit Artefakten, ausgeführt von Agents, kontrolliert von etwas, das ihnen Nein sagen kann.
Fragen, die dieser Artikel beantwortet
Warum nicht einfach einen interaktiven Coding-Agent im Plan-Modus nutzen, statt eine Pipeline zu bauen?
Für Exploration, einen einmaligen Fix oder alles, wo man mitten im Flug steuern will, gewinnt die interaktive Session deutlich. Die Pipeline ist für den anderen Job, das Delegieren, bei dem eine Stufe Code ist und nicht eine Anweisung, der das Modell fast immer folgt, und bei dem drei Tage später der Zustand der Welt auf dem Board und in den Branches liegt, weil nichts anderes möglich war. Treibt man den Ansatz aus Skills und Hooks bis zum Ende, hat man genau diese Pipeline gebaut, mit einem Chat-Fenster davor.
Wie verhindert man, dass Tickets auf getrennten Branches sich gegenseitig kaputtmachen?
Das löst man im Planner, nicht im Executor. Jedes Ticket läuft auf einem frischen Branch, abgezweigt vom Basis-Branch, also liegt der Code eines Geschwister-Tickets nicht auf der Platte, und genau das bringt der System-Prompt des Planners bei: Wenn Datei A Datei B importiert, gehören beide ins selbe Ticket, Arbeit wird als vertikale Slices gruppiert, gemeinsame Grundlagen kommen in Ticket eins. Im Demo-Lauf hat der Planner die Storage-Funktion, das CSV-Modul, den Endpoint und die Tests in ein einziges Ticket gepackt, weil sie eine einzige Abhängigkeitskette bilden.
Ist die Pipeline wirklich schneller, als die Arbeit mit einem interaktiven Agenten zu erledigen?
Wahrscheinlich nicht, und darum ging es auch nie. Die interaktive Session mit den stärkeren Modellen gewinnt den Sprint, wenn die Kosten pauschal sind und ein Mensch an der Tastatur sitzt; die Pipeline braucht von Anfang bis Ende länger, läuft aber auf einem Modell im Gratis-Kontingent, ihre Kosten pro Feature sind eine Zahl, die man vom Dashboard abliest, und beim zehnten Lauf tut sie dasselbe wie beim ersten. Billiger und berechenbarer ist die Hälfte, die zählt, sobald der Mensch sich entfernt und etwas die Ausgaben deckeln muss.
Kann man eine laufende Agenten-Pipeline tatsächlich stoppen?
Ja, und zwar von außerhalb des Werkzeugs. Jeder Aufruf registriert sich auf der Smithproof Control Plane und öffnet einen Run, bevor irgendeine Arbeit passiert, also stoppt der nächste Aufruf mit exit code 5 an der Tür, sobald man den Agenten in der Konsole unter Quarantäne stellt, vor einem einzigen Modellaufruf oder einer einzigen Dateiänderung. Die Fehlersemantik lautet Abbruch bei Entscheidung, Warnung bei Ausfall: Eine ausdrückliche Verweigerung bricht den Run ab, eine nicht erreichbare Control Plane führt nur zu einer lauten Warnung und der Lauf geht weiter, denn Telemetrie sollte nie der Grund sein, warum ein Build scheitert.
Weiterlesen
 AI Agents
Ich habe eine KI-Schicht gebaut, die nie antwortet. Was eine gute Frage wirklich braucht
Feldnotizen zu OrbitSpec, einer Klärungs-Engine, die vage Anfragen in typisierte, auditierbare Context Bundles verwandelt, bevor irgendein Modell läuft, und warum Zuverlässigkeit vor der Antwort beginnt. AI Agents
Ich habe eine Control Plane für KI-Agenten gebaut. Das ist es, was Governance wirklich erfordert
Feldnotizen zum Bau von Smithproof, einer mandantenfähigen Control Plane für KI-Agenten, und warum Erkennung ohne Reaktion und Richtlinien ohne Durchsetzung nichts steuern.