
Construí el pipeline que construyó mi producto. Esto es lo que exige delegar de verdad
Escuchar el artículo (experimental) · 14:23

Ayer escribí una sola frase, "Añadir exportación CSV de las tareas completadas", apunté una CLI a una pequeña API de seguimiento de tareas y me fui a otra cosa. Doce minutos después había un plan con criterios de aceptación, cinco tickets en un tablero, un registro de aprobación y una pull request en borrador con un endpoint funcional, un módulo nuevo, tests y documentación actualizada: 1.190 líneas añadidas en una rama coherente, un commit por tarea, esperando revisión.
La idea es más vieja que la herramienta. Cualquiera que haya trabajado con scrum en una empresa ha tenido este pensamiento durante la planificación del sprint: las historias de usuario están ahí, refinadas y estimadas, y qué bien estaría que una IA hiciera la primera iteración, mientras nosotros dedicamos el tiempo a revisar el PR, ejecutarlo en local para comprobar que todo funciona, ajustar y volver a iterar. ¿Ahorra tiempo de verdad? Es difícil saberlo, y no construí esto para ganar ese debate. Lo construí para hacer real esa experiencia, y dejé la cuestión del impacto para más adelante.
En una entrada anterior escribí sobre Smithproof, el plano de control que construí para gobernar agentes de IA. Esta es la historia de la herramienta al otro lado de esa relación: plan-to-pr, un pipeline de línea de comandos que convierte una petición de funcionalidad en lenguaje natural en pull requests revisadas. La relación entre ambas va más allá de un emparejamiento para la demo. El pipeline ayudó a construir el plano de control, y el plano de control ahora gobierna el pipeline. Pero antes de todo eso, la herramienta se gana su propio informe de campo, porque construirla me enseñó lo que exige de verdad delegar en agentes de código.
Qué es el pipeline
Cuatro etapas, cada una con su artefacto:
| Etapa | Qué ocurre | Qué sobrevive |
|---|---|---|
| Plan | Un LLM clasifica la intención, enriquece la petición con un escaneo del repositorio y emite épicas, tickets y tareas con criterios de aceptación | plan.json, validado contra un esquema |
| Tickets | Un ticket por tarea aterriza en el tablero (Trello o GitHub Issues) | Tarjetas que un equipo puede ver y reasignar |
| Approve | Una puerta humana; el rechazo es exit code 4 | approval.json: quién, cuándo |
| Execute | Cada ticket recibe su propia rama; un agente genera el código tarea a tarea | Una PR en borrador por ticket, enlazada a su ticket |
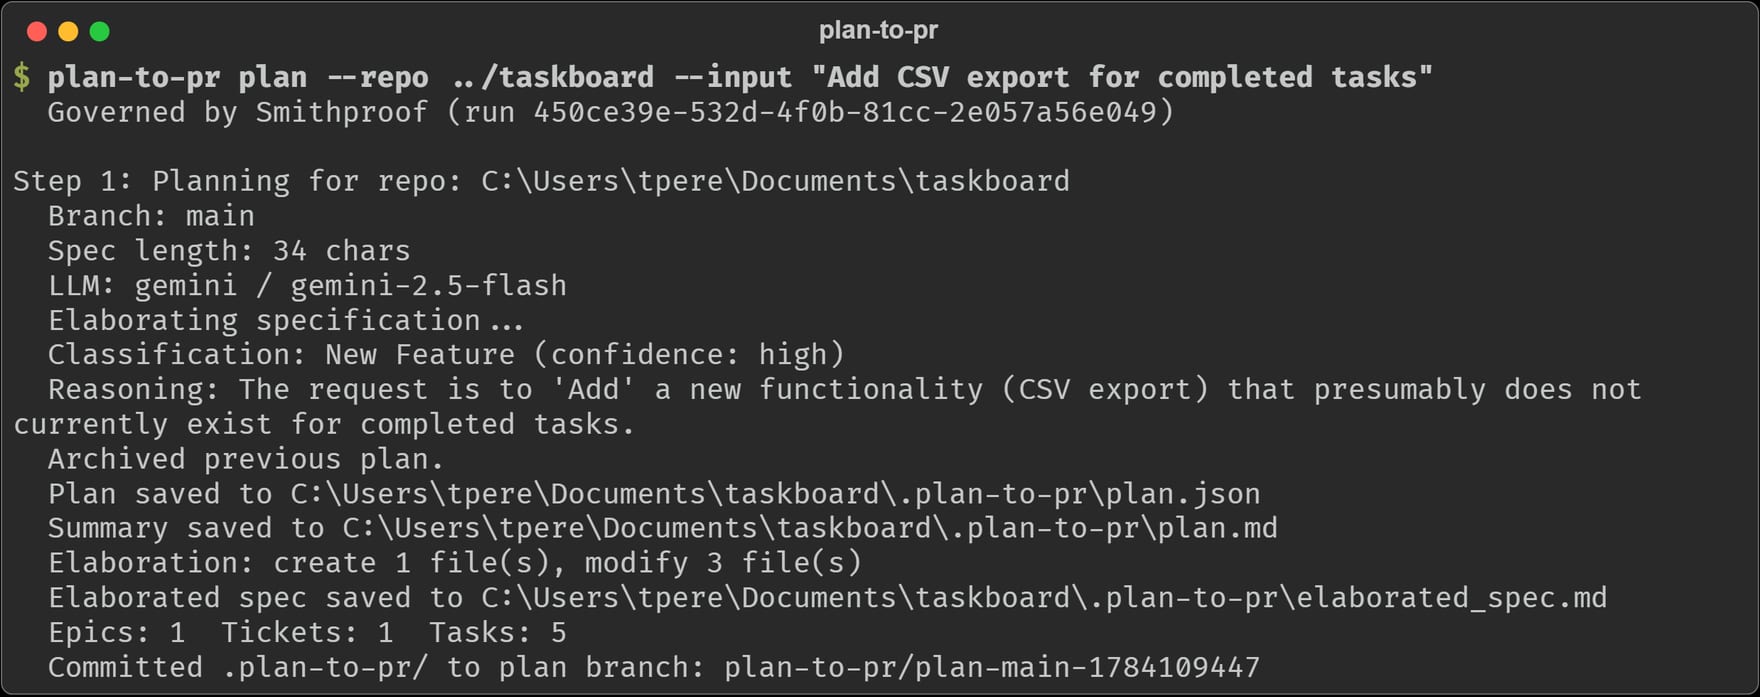 La ejecución del plan en la demo. El propio plan se confirma en una rama dedicada, nunca en main.
El estado que lo une todo vive en una carpeta .plan-to-pr/ dentro del repositorio de destino: el plan, los mapeos de tickets, los resultados de la ejecución. Las ejecuciones se pueden reanudar; una tarea completada nunca se rehace. Nada de esto es exótico. Esa es la gracia. El pipeline es orquestación deliberadamente aburrida alrededor de un modelo que es de todo menos predecible.
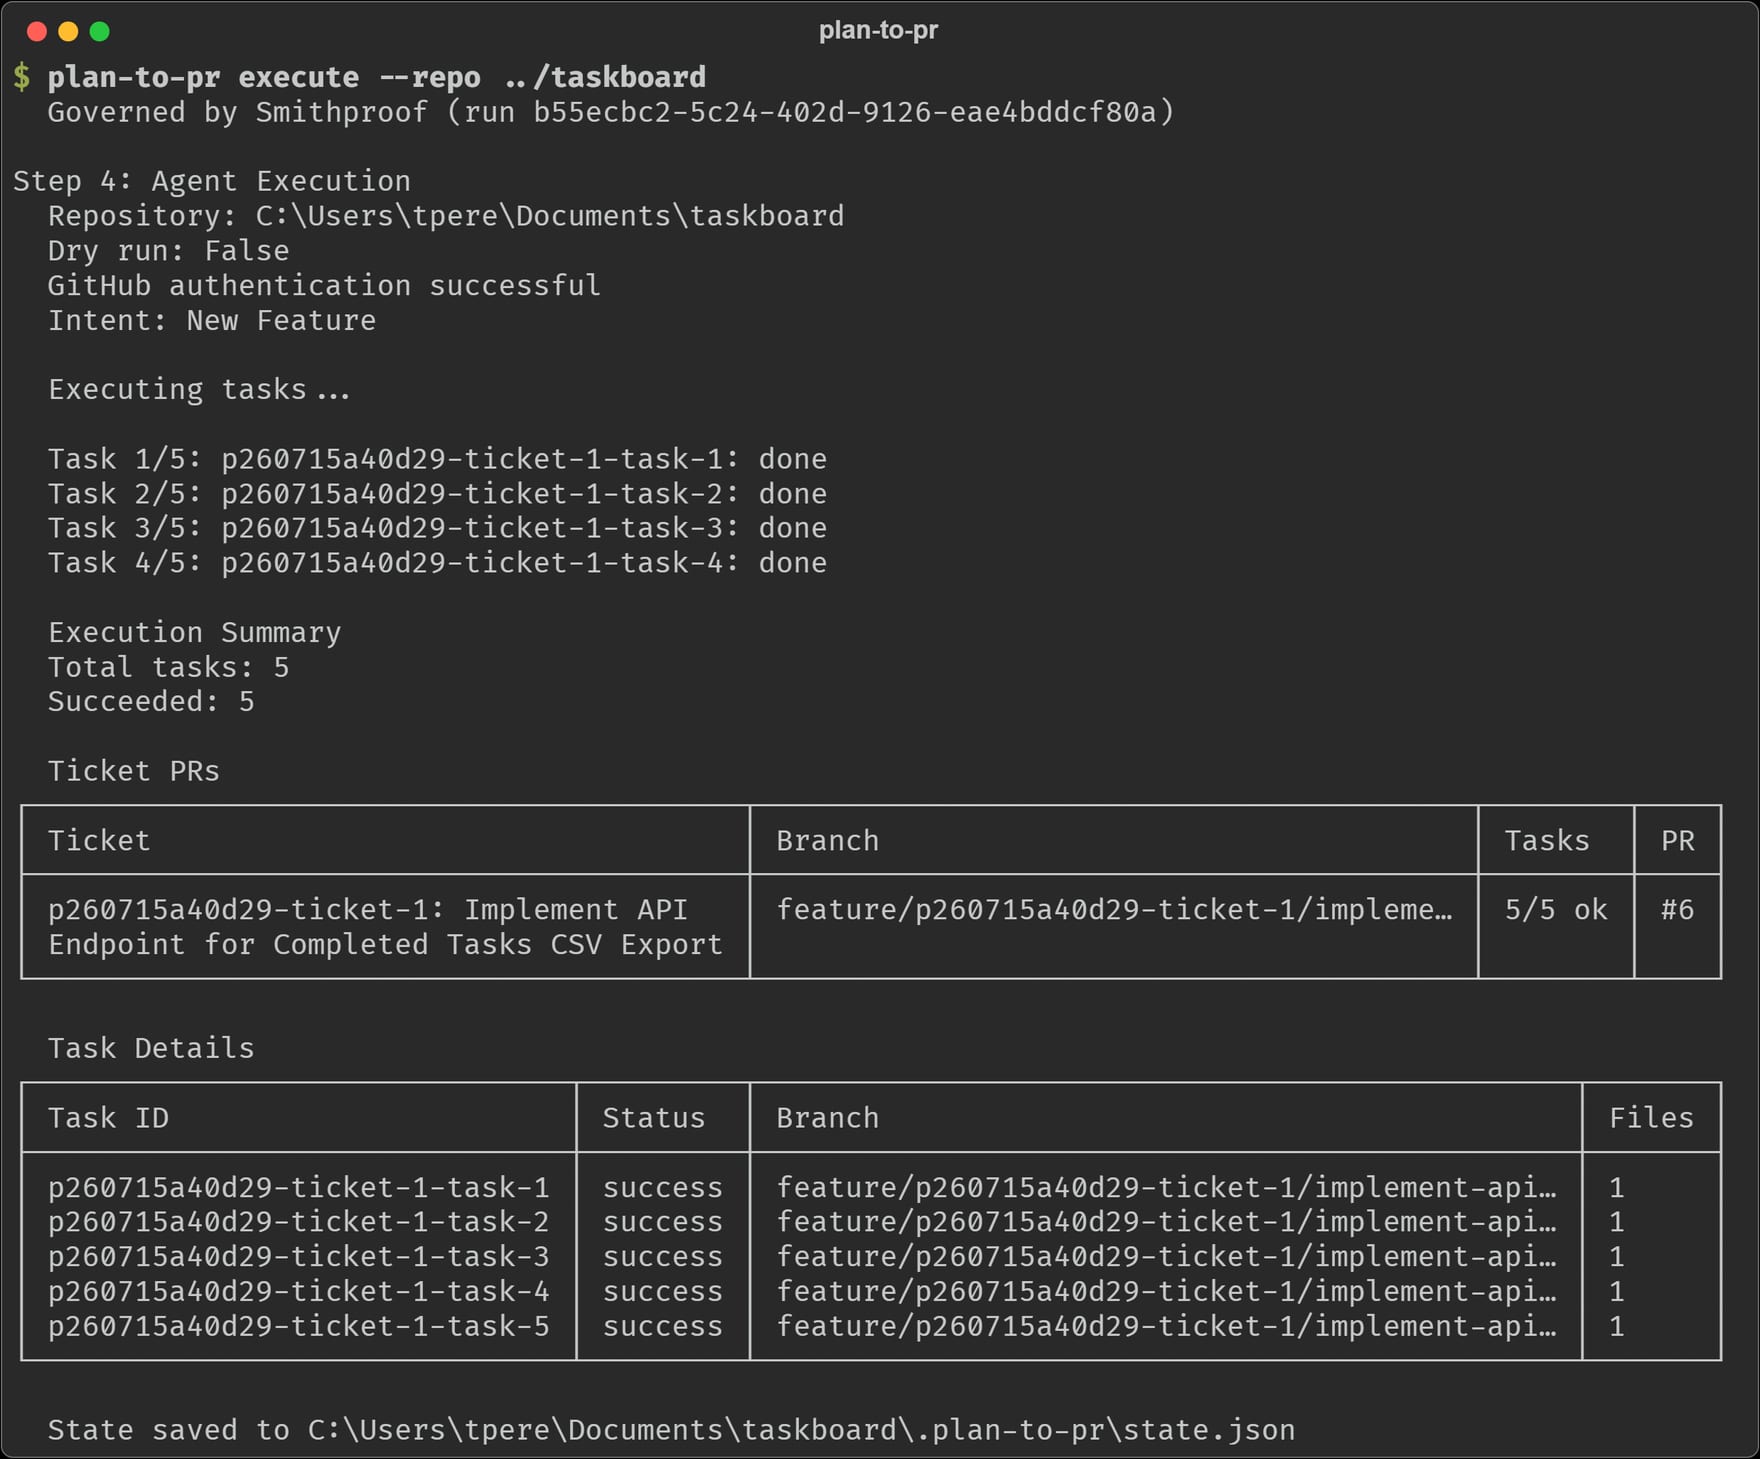 Execute, de principio a fin: una rama por ticket, un commit por tarea, una PR en borrador con la lista de comprobación en su descripción.
Por qué un pipeline y no un chat
Uso agentes de código interactivos a diario, y la pregunta obvia merece una respuesta directa: ¿por qué no abrir Claude Code, usar el modo plan y dejar que la sesión haga todo esto?
Para explorar, para un arreglo puntual o para cualquier cosa en la que quiera corregir el rumbo sobre la marcha, la sesión interactiva gana, y no por poco. Pero delegar es un trabajo distinto de colaborar, y la diferencia se nota en cinco puntos.
Los artefactos son el comportamiento por defecto, no un favor. Un agente de chat capaz escribe un archivo de plan y crea tickets en el tablero si se lo pides, y una skill bien escrita hará que lo haga cada vez que te acuerdes de invocarla. La diferencia está en dónde vive la garantía. Una skill sigue siendo un conjunto de instrucciones que el modelo casi siempre sigue; una etapa del pipeline es código que no se puede saltar. Lleva el enfoque de las skills hasta el final, hooks que bloquean la ejecución hasta que exista un archivo de aprobación, un script para cada etapa, y lo que has construido es este pipeline con una ventana de chat acoplada delante. Cuando vuelvo tres días después, el estado del mundo está en el tablero y en las ramas porque no había otra posibilidad, no porque todos se acordaran de pedirlo.
Una puerta no es una pregunta. Un agente interactivo pregunta "¿esto tiene buena pinta?", y la verdad es que, tras suficientes aprobaciones, dejas de leer. El paso de aprobación del pipeline es una parada en seco con un exit code. Nada se ejecuta hasta que existe approval.json, y el rechazo es un resultado de pleno derecho, no un mensaje amable.
Las unidades de trabajo son unidades revisables. El pipeline emite una PR por ticket, cada una lo bastante pequeña como para revisarla de verdad, cada una enlazada al ticket que la motivó. Una sesión larga con un agente tiende a producir un único diff desparramado, moldeado por el orden que casualmente tomó la conversación.
El flujo de control pertenece al código. En el pipeline, el modelo escribe planes y código dentro de pasos bien definidos, pero el bucle en sí, qué se ejecuta, en qué orden, qué pasa cuando algo falla, es Python determinista. Cuando algo se rompe a las dos de la madrugada, depuro un pipeline, no una personalidad.
Un pipeline se puede gobernar. Este es el punto que más me importa, y tiene su propia sección más abajo. Una CLI con puntos de entrada definidos se puede registrar, observar, presupuestar y rechazar. A una sesión de formato libre es mucho más difícil decirle que no.
Nada de esto es un argumento contra los agentes interactivos. Es un argumento de que "que lo haga el agente" se divide en dos productos: un colaborador al que diriges y un delegado al que pides cuentas. El segundo necesita justificantes.
Los dos conviven en mi propio trabajo, y este mismo proyecto usó ambos. El pulido final de la herramienta salió de Claude Code con Fable 5 y Opus 4.8, modelos más rápidos y más potentes que los que usa el pipeline, con una suscripción Max en la que dejo de contar tokens. Cuando el coste es plano y hay un humano al teclado, el agente interactivo gana el sprint. El pipeline tarda más de principio a fin, sospecho, pero corre sobre un modelo de nivel gratuito, su coste por funcionalidad es un número que se lee en un panel, y su comportamiento es el mismo en la décima ejecución que en la primera. Más barato y más predecible no es la mitad glamurosa del intercambio, pero es la mitad que importa cuando el humano se aparta y algo tiene que poner tope al gasto.
Lo difícil es particionar, y el arreglo vive en un prompt
La lección técnica más profunda vino del modelo de ejecución.
Cada ticket se ejecuta en una rama nueva creada a partir de la rama base. Los tickets no ven los ficheros de los demás, porque sus ramas todavía no se han fusionado. La primera consecuencia llega rápido: si el planificador agrupa el trabajo por capas, todos los modelos en un ticket, todos los endpoints en otro, cada rama importa ficheros que solo existen en una rama hermana, y nada funciona.
El arreglo no está en el ejecutor. Está en el system prompt del planificador, que enseña al modelo la topología de ejecución de la propia herramienta: el código de otros tickets no está en disco; si el fichero A importa el fichero B, ambos pertenecen al mismo ticket; agrupa el trabajo en cortes verticales; pon los cimientos compartidos en el ticket uno. El prompt llega a nombrar el antipatrón, un ticket para todos los modelos y otro para todos los esquemas, como un fallo de importación garantizado. En la ejecución de la demo, el planificador agrupó la función de almacenamiento, el módulo CSV, el endpoint y los tests en un solo ticket precisamente porque forman una única cadena de dependencias.
Esto me parece genuinamente interesante como artefacto de diseño: la restricción es de infraestructura, la solución es lingüística, y las dos evolucionaron juntas a base de fallos observados. Dos piezas menores lo completan. Durante la ejecución, una pasada de descubrimiento clasifica qué ficheros crear, modificar o leer como contexto de convenciones, y el generador de código puede leer ficheros de las ramas de otros tickets ya completados con git show, conciencia entre ramas sin llegar a hacer checkout de ninguna. Y como la salida de un LLM es hostil para los parsers, las respuestas de plan y de código pasan por una pequeña pila defensiva: marcadores centinela, cuatro mecanismos de extracción de respaldo, un reparador de escapes para expresiones regulares dentro de JSON y un bucle de reintentos que devuelve el error de parseo al modelo con una temperatura más baja. Cada una de esas piezas existe porque algo real se rompió.
Los justificantes
La razón por la que me fío de este pipeline es que ha entregado trabajo con el que luego he tenido que convivir. Partes de Smithproof, entre ellas el subsistema de revisión humana y la maquinaria de tareas en segundo plano, llegaron como tickets de plan-to-pr y PRs en borrador, con los nombres de rama generados por la máquina todavía en el historial. El prompt de generación de código aún carga con las cicatrices: convenciones sobre las clases base exactas y los estilos de esquema de ese codebase, añadidas después de ejecuciones que se equivocaron.
Eso corta en ambos sentidos, y conviene decirlo sin rodeos: el pipeline rinde mejor en funcionalidades bien acotadas dentro de codebases con convenciones claras. No es la herramienta para refactorizaciones enrevesadas ni para problemas que todavía no sé describir en una frase. Saber qué mitad del trabajo es cuál resulta ser la verdadera habilidad de delegar en agentes.
El bucle se cierra
Aquí viene mi parte favorita. plan-to-pr ahora se ejecuta como agente gobernado bajo Smithproof, el plano de control que ayudó a construir.
Cuando la configuración de gobernanza está presente, cada invocación del pipeline se registra en el plano de control, abre una ejecución antes de hacer ningún trabajo y, al cerrarla, informa de sus llamadas al modelo, con la latencia medida y el coste estimado. La consola muestra el pipeline en la flota como un agente más: tres ejecuciones ayer, diez llamadas al modelo en el tramo de execute, unos cinco céntimos de gasto.
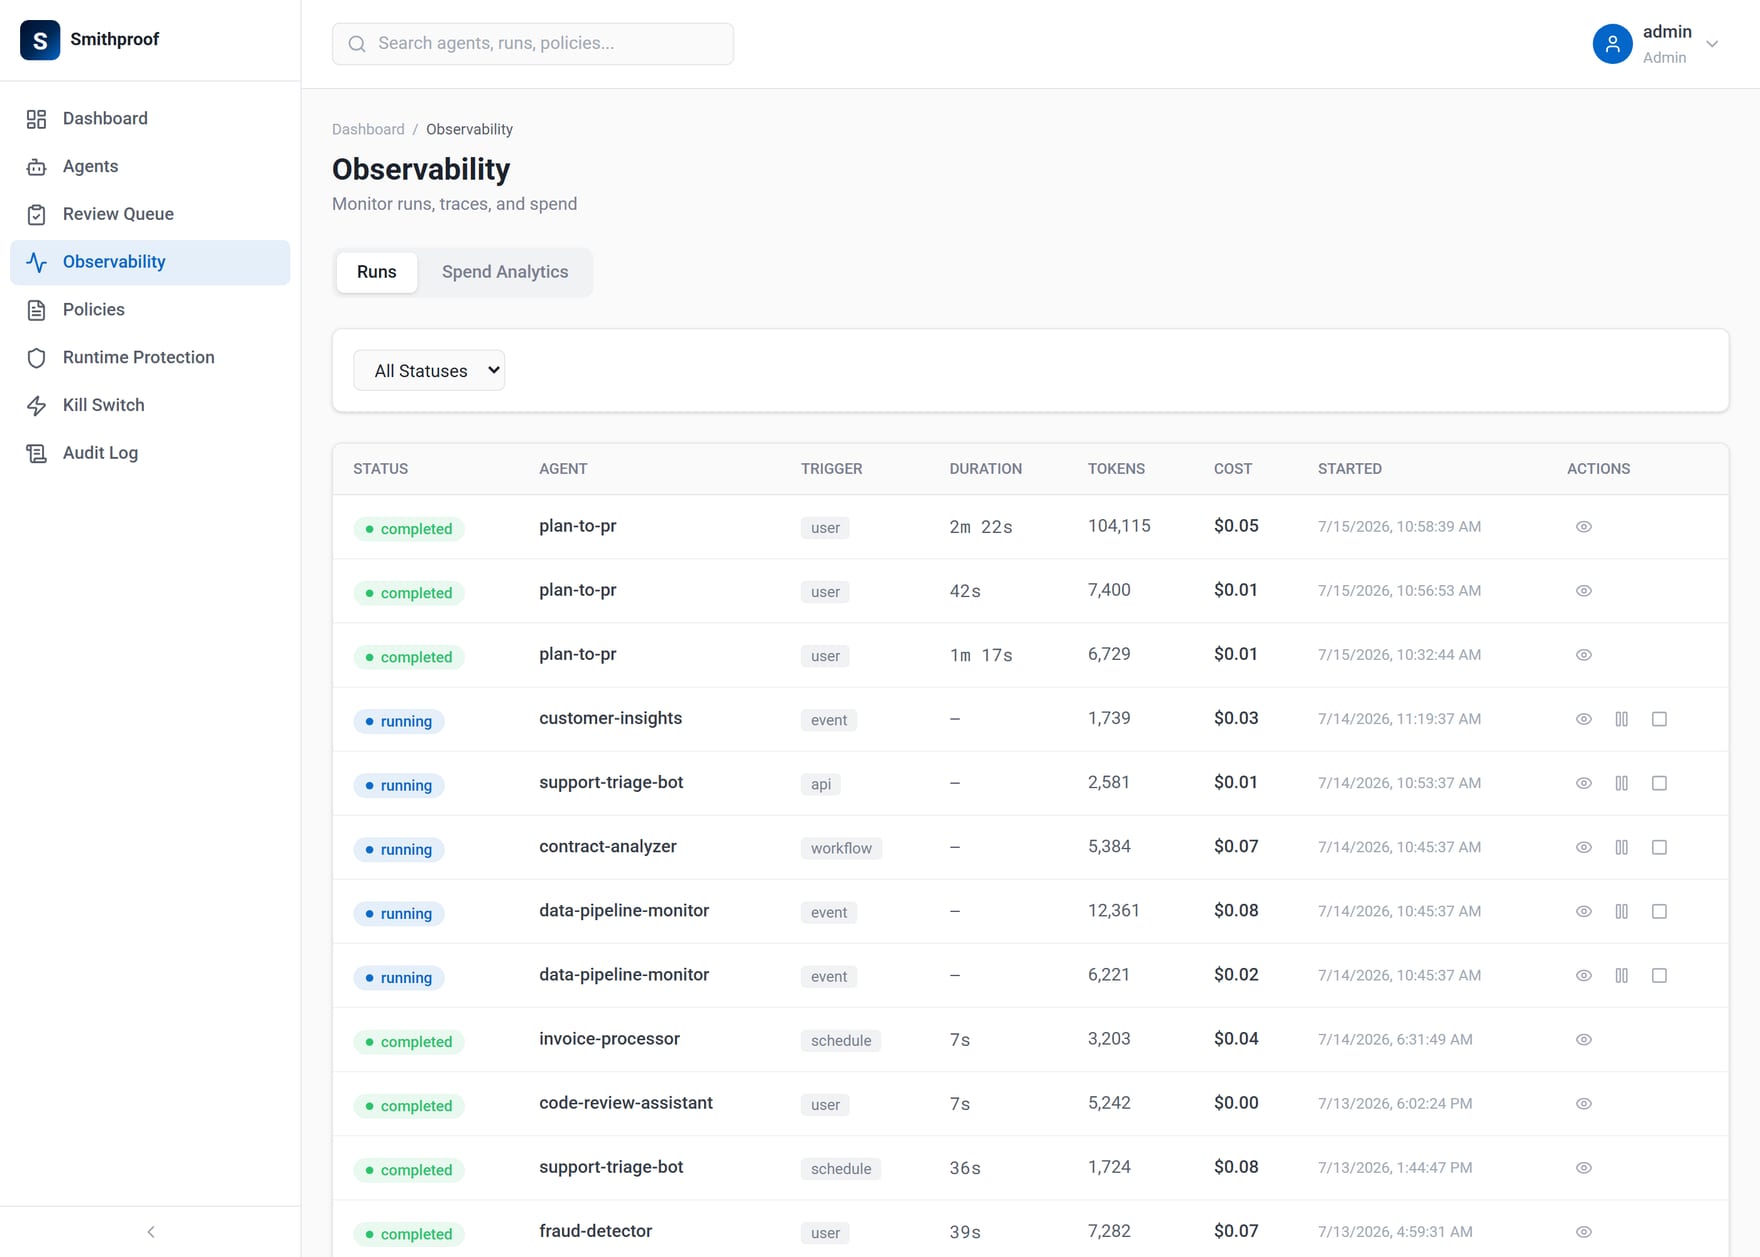 Las ejecuciones del pipeline en la vista de observabilidad del plano de control, junto al resto de la flota.
La parte que importa no es la telemetría. Es que el plano de control puede decir que no, y el pipeline obedece. Pon el agente en cuarentena desde la consola y la siguiente invocación se detiene en la puerta, antes de una sola llamada al modelo o un solo cambio de fichero:
 Exit code 5. El motivo viene del plano de control, no de la herramienta.
La semántica de fallos exigió una decisión de verdad: denegar ante una decisión, avisar ante una caída. Si el plano de control rechaza la ejecución de forma explícita, el pipeline aborta. Si el plano de control no está accesible, el pipeline avisa bien alto y sigue adelante, porque la telemetría nunca debería ser el motivo por el que se rompe una build, pero una decisión de bloqueo debe respetarse siempre. En la entrada anterior escribí que una política es una decisión y hacerla cumplir es una arquitectura. Así se siente el lado del cumplimiento desde dentro del proceso gobernado, y habiendo construido las dos mitades, puedo confirmar que el bucle es más satisfactorio que cualquiera de las dos por separado.
En qué punto está
A día de hoy, plan-to-pr planifica contra cualquier repositorio git con solo una clave gratuita de Gemini, coloca tickets en Trello o GitHub Issues y abre PRs en borrador en GitHub, con ClickUp, Azure DevOps y GitLab en la hoja de ruta de proveedores. La integración de gobernanza estima los recuentos de tokens a partir de la longitud del texto hasta que la capa de LLM exponga el uso exacto, y las ejecuciones quedan etiquetadas en consecuencia. El pipeline todavía registra un aviso cuando no consigue volver a hacer commit de su carpeta de estado en la rama del plan a mitad de ejecución, un conflicto de checkout que es lo siguiente en la lista de arreglos. Un informe de campo debe incluir el campo.
Si hay una sola cosa que llevarse de esta construcción: el modelo nunca fue la parte difícil. Las partes difíciles fueron las mismas que en cualquier delegación, la descomposición, las puertas, la rendición de cuentas y la humildad de guardar los justificantes. Las herramientas que hagan útiles a los agentes para el trabajo real se parecerán menos a ventanas de chat más listas y más a esto: pipelines con artefactos, ejecutados por agentes, gobernados por algo que puede decirles que no.
Preguntas que responde este artículo
¿Por qué no usar un agente de código interactivo en modo plan en lugar de montar un pipeline?
Para explorar, para un arreglo puntual o para cualquier cosa en la que quieras corregir el rumbo sobre la marcha, la sesión interactiva gana, y no por poco. El pipeline es para el otro trabajo, delegar, donde una etapa es código y no una instrucción que el modelo casi siempre sigue, y donde tres días después el estado del mundo está en el tablero y en las ramas porque no había otra posibilidad. Lleva el enfoque de las skills y los hooks hasta el final y lo que has construido es este pipeline con una ventana de chat acoplada delante.
¿Cómo evitas que tickets que se ejecutan en ramas distintas se rompan entre sí?
Se arregla en el planificador, no en el ejecutor. Cada ticket se ejecuta en una rama nueva creada a partir de la rama base, así que el código de un ticket hermano no está en disco, y el system prompt del planificador enseña justo eso: si el fichero A importa el fichero B, ambos pertenecen al mismo ticket, agrupa el trabajo en cortes verticales, pon los cimientos compartidos en el ticket uno. En la ejecución de la demo, el planificador metió la función de almacenamiento, el módulo CSV, el endpoint y los tests en un solo ticket porque forman una única cadena de dependencias.
¿Es más rápido de verdad que hacer el trabajo con un agente interactivo?
Probablemente no, y nunca fue ese el argumento. La sesión interactiva con los modelos más potentes gana el sprint cuando el coste es plano y hay un humano al teclado; el pipeline tarda más de principio a fin, pero corre sobre un modelo de nivel gratuito, su coste por funcionalidad es un número que se lee en un panel y hace lo mismo en la décima ejecución que en la primera. Más barato y más predecible es la mitad que importa en cuanto el humano se aparta y algo tiene que poner tope al gasto.
¿Se puede parar de verdad un pipeline de agentes que ya está en marcha?
Sí, y desde fuera de la herramienta. Cada invocación se registra en el plano de control de Smithproof y abre una ejecución antes de hacer ningún trabajo, así que poner el agente en cuarentena desde la consola hace que la siguiente invocación se detenga en la puerta con exit code 5, antes de una sola llamada al modelo o un solo cambio de fichero. La semántica de fallos es denegar ante una decisión y avisar ante una caída: un rechazo explícito aborta la ejecución, mientras que un plano de control inaccesible solo avisa y sigue adelante, porque la telemetría nunca debería ser el motivo por el que se rompe una build.
Leer a continuación
 AI Agents
He construido una capa de IA que nunca responde. Esto es lo que exige de verdad una buena pregunta
Notas de campo de OrbitSpec, un motor de clarificación que convierte peticiones vagas en Context Bundles tipados y auditables antes de que se ejecute ningún modelo, y por qué la fiabilidad empieza antes de la respuesta. AI Agents
Construí un plano de control para agentes de IA. Esto es lo que exige de verdad la gobernanza
Notas de campo sobre la construcción de Smithproof, un plano de control multiinquilino para agentes de IA, y por qué la detección sin respuesta y la política sin aplicación no gobiernan nada.