
Ho costruito la pipeline che ha costruito il mio prodotto. Ecco cosa serve davvero per delegare
Ascolta l'articolo (sperimentale) · 13:46

Ieri ho scritto una sola frase, "Add CSV export for completed tasks", ho puntato una CLI su una piccola API di gestione dei task e me ne sono andato. Dodici minuti dopo c'erano un piano con criteri di accettazione, cinque ticket su una board, la registrazione dell'approvazione e una pull request in bozza con un endpoint funzionante, un modulo nuovo, i test e la documentazione aggiornata: 1.190 righe aggiunte su un branch coerente, un commit per ogni task, in attesa di revisione.
La voglia è più vecchia dello strumento. Chiunque abbia lavorato in scrum in un'azienda ha avuto questo pensiero durante la pianificazione dello sprint: le user story sono lì, rifinite e stimate, e quanto sarebbe bello se un'IA facesse la prima iterazione, mentre noi passiamo il tempo a rivedere la PR, a eseguirla in locale per verificare che tutto funzioni, ad aggiustare e a ripetere il giro. Fa davvero risparmiare tempo? È difficile dirlo, e non l'ho costruito per vincere quella discussione. L'ho costruito per rendere reale quell'esperienza, lasciando da parte la questione dell'impatto.
In un post precedente ho raccontato Smithproof, il control plane che ho costruito per governare gli agenti AI. Questa è la storia dello strumento dall'altra parte di quella relazione: plan-to-pr, una pipeline a riga di comando che trasforma una richiesta di funzionalità in linguaggio naturale in pull request revisionate. I due sono più intrecciati di una semplice accoppiata da demo. La pipeline ha aiutato a costruire il control plane, e il control plane oggi governa la pipeline. Prima ancora, però, la pipeline si merita il suo resoconto dal campo, perché costruirla mi ha insegnato cosa serve davvero per delegare agli agenti di coding.
Che cos'è la pipeline
Quattro fasi, ognuna con un artefatto:
| Fase | Cosa succede | Cosa ne sopravvive |
|---|---|---|
| Plan | Un LLM classifica l'intento, arricchisce la richiesta con una scansione del repository ed emette epic, ticket e task con criteri di accettazione | plan.json, validato rispetto a uno schema |
| Tickets | Un ticket per ogni task finisce sulla board (Trello o GitHub Issues) | Card che un team può vedere e riassegnare |
| Approve | Un gate umano; il rifiuto è exit code 4 | approval.json: chi, quando |
| Execute | Ogni ticket ha il suo branch; un agente genera il codice task per task | Una PR in bozza per ogni ticket, collegata al ticket di origine |
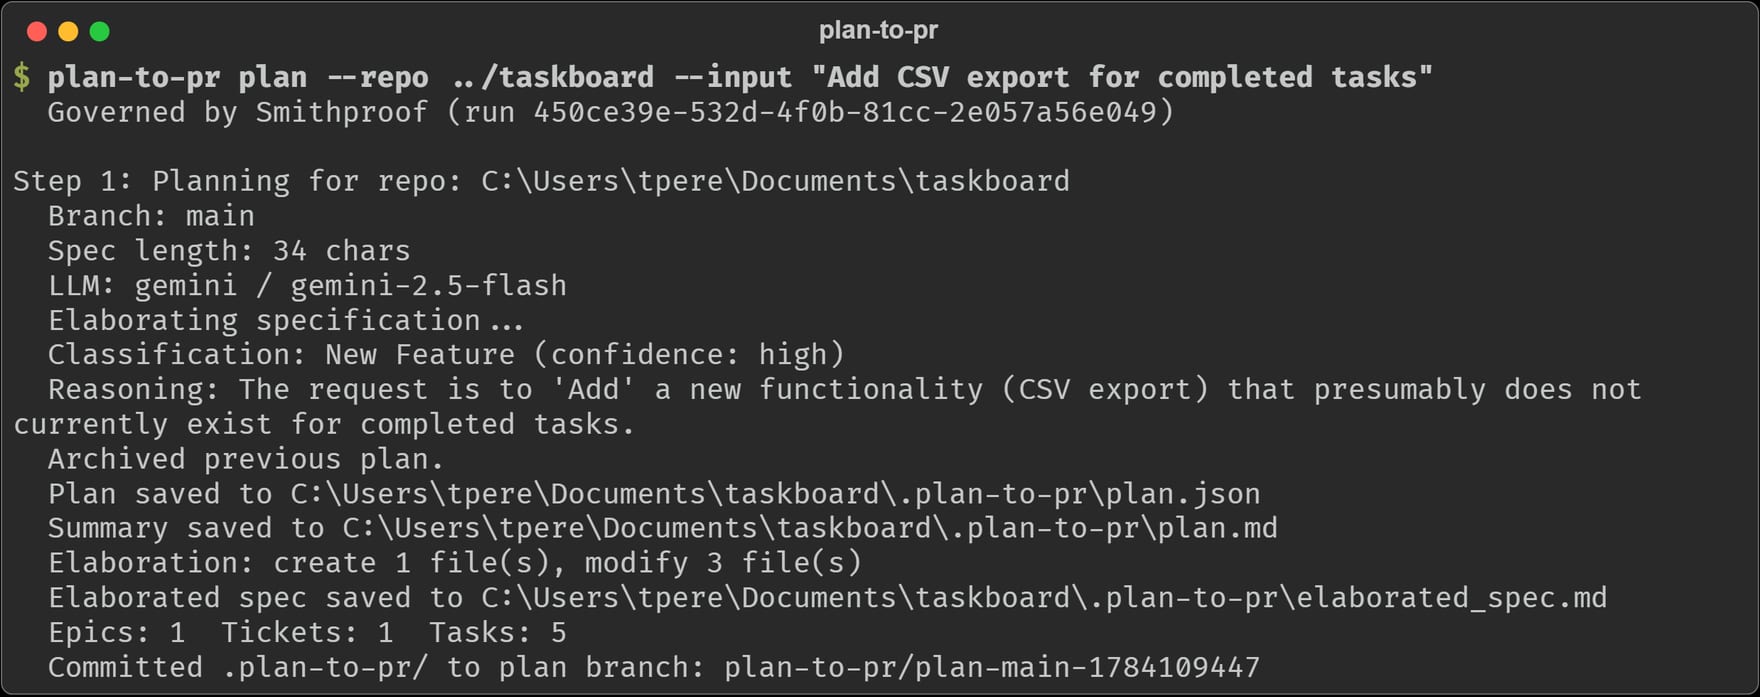 La run di plan della demo. Il piano stesso viene committato su un branch dedicato, mai su main.
Lo stato che tiene insieme il tutto vive in una cartella .plan-to-pr/ dentro il repository di destinazione: il piano, le mappature dei ticket, i risultati dell'esecuzione. Le run sono riprendibili; un task completato non viene mai rifatto. Niente di tutto questo è esotico. Ed è proprio il punto. La pipeline è orchestrazione volutamente noiosa attorno a un modello che è tutto fuorché prevedibile.
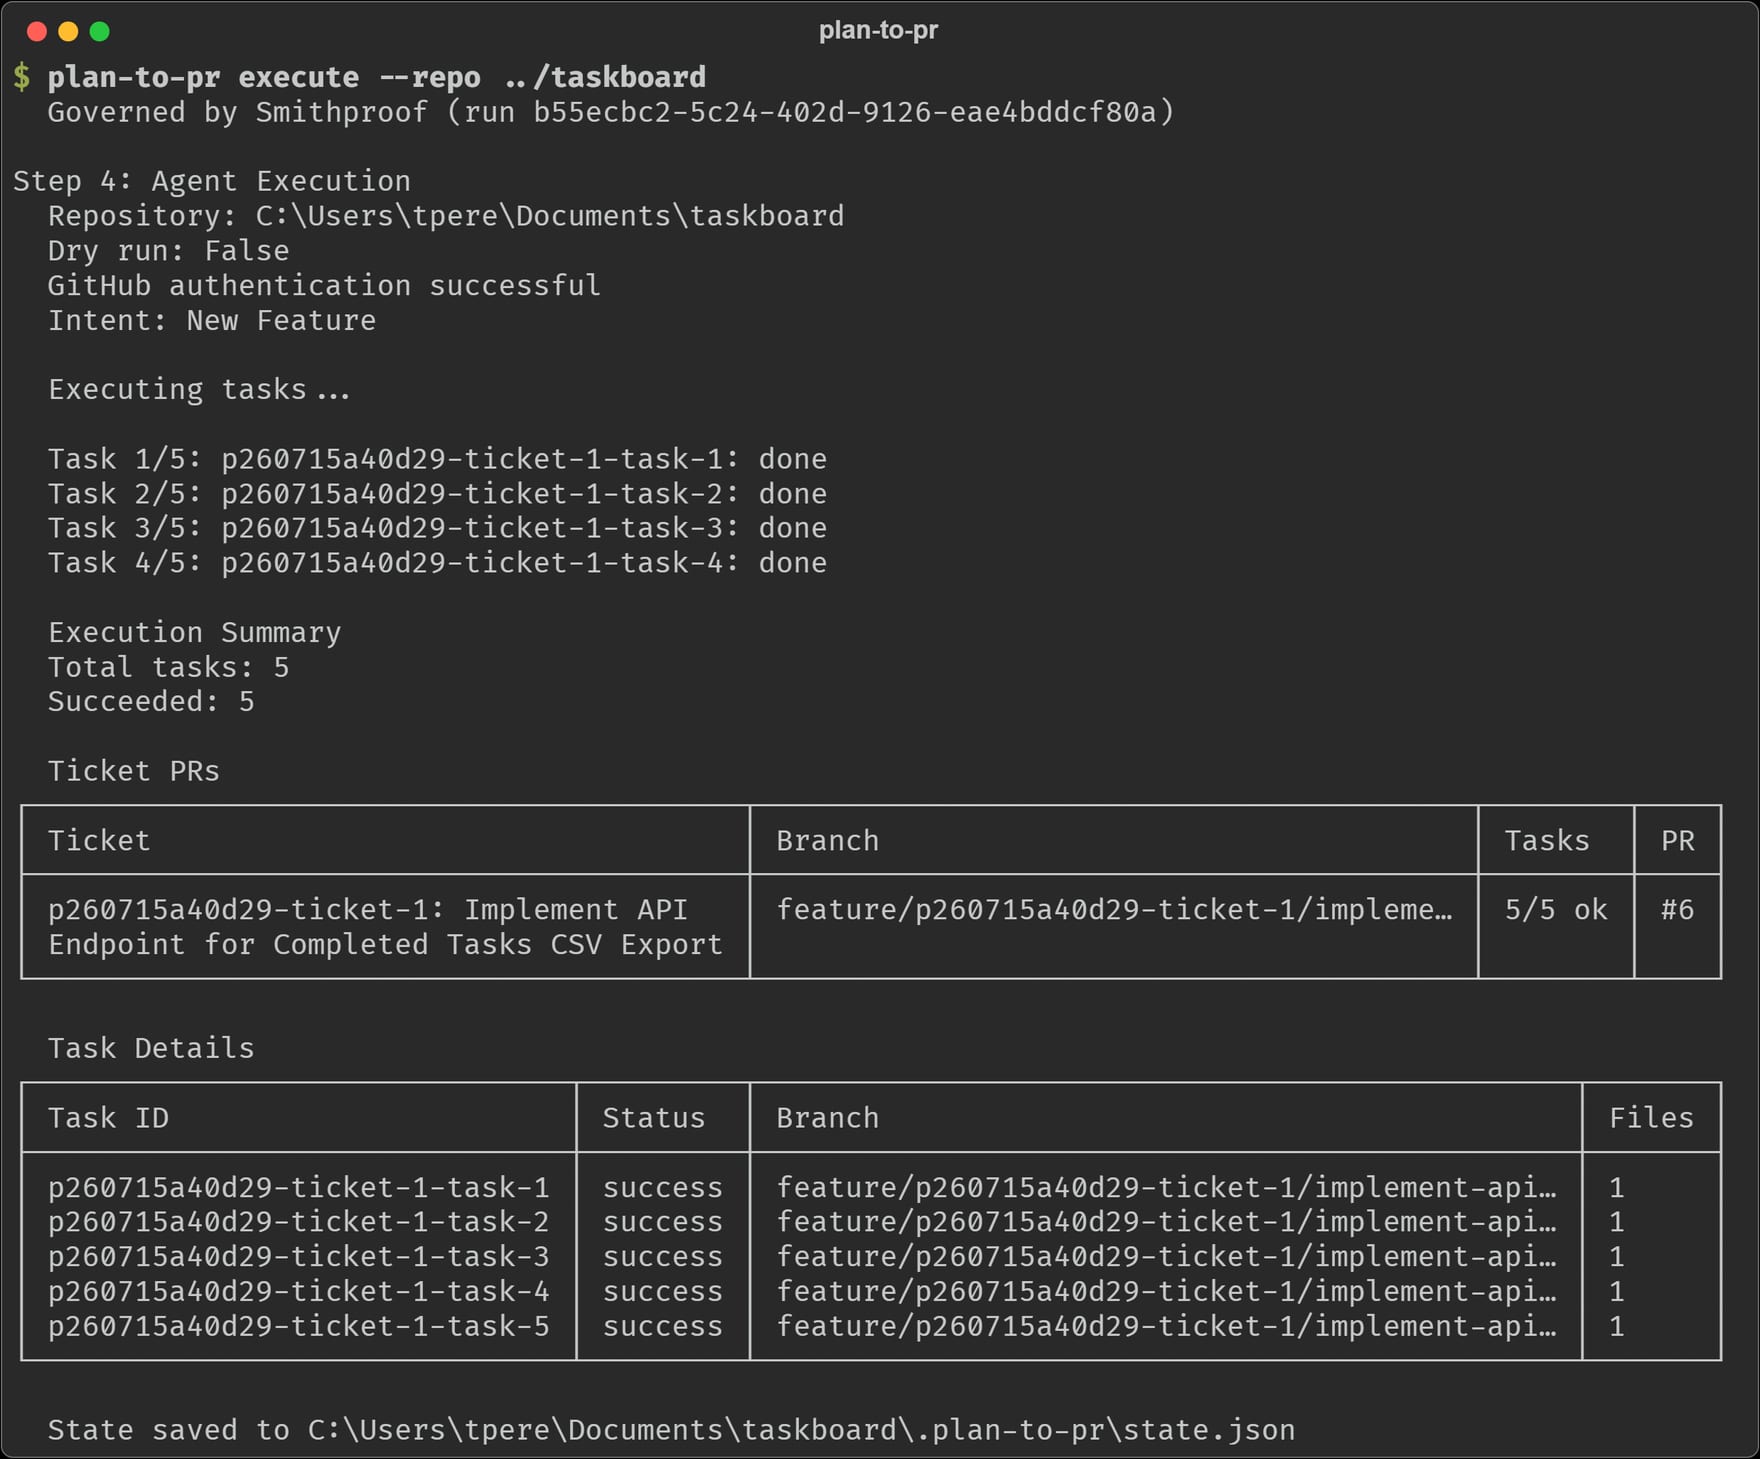 Execute, da cima a fondo: un branch per ticket, un commit per task, una PR in bozza con la checklist nella descrizione.
Perché una pipeline e non una chat
Uso agenti di coding interattivi tutti i giorni, e la domanda ovvia merita una risposta diretta: perché non aprire Claude Code, usare la modalità plan e lasciare che la sessione faccia tutto questo?
Per esplorare, per una correzione una tantum o per qualsiasi cosa in cui voglio correggere la rotta in corsa, la sessione interattiva vince, e non di poco. Ma delegare è un mestiere diverso dal collaborare, e la differenza emerge in cinque punti.
Gli artefatti sono il comportamento predefinito, non un favore. Un agente di chat capace scrive un file di piano e crea ticket sulla board se glielo chiedi, e una skill scritta bene glielo fa fare ogni volta che ti ricordi di invocarla. La differenza sta in dove vive la garanzia. Una skill resta un insieme di istruzioni che il modello segue quasi sempre; una fase della pipeline è codice che non si può saltare. Porta l'approccio delle skill fino in fondo, hook che bloccano l'esecuzione finché non esiste un file di approvazione, uno script per ogni fase, e quello che hai costruito è questa pipeline con una finestra di chat attaccata davanti. Quando torno tre giorni dopo, lo stato del mondo è sulla board e nei branch perché non c'era altra possibilità, non perché tutti si sono ricordati di chiederlo.
Un gate non è una domanda. Un agente interattivo chiede "ti sembra giusto?" e la verità è che dopo un certo numero di approvazioni si smette di leggere. La fase di approvazione della pipeline è uno stop netto con un exit code. Nulla viene eseguito finché non esiste approval.json, e il rifiuto è un esito di prima classe, non un messaggio di cortesia.
Le unità di lavoro sono unità revisionabili. La pipeline emette una PR per ogni ticket, ciascuna abbastanza piccola da poter essere davvero revisionata, ciascuna collegata al ticket che l'ha motivata. Una lunga sessione con un agente tende a produrre un unico diff sconfinato, modellato dall'ordine che la conversazione ha preso per caso.
Il flusso di controllo sta nel codice. Nella pipeline il modello scrive piani e codice dentro passi ben definiti, ma il loop in sé, cosa gira, in che ordine, cosa succede in caso di errore, è Python deterministico. Quando qualcosa si rompe alle due di notte, faccio il debug di una pipeline, non di una personalità.
Una pipeline si può governare. È il punto che mi sta più a cuore, e più sotto ha la sua sezione dedicata. Una CLI con punti di ingresso definiti si può registrare, osservare, mettere a budget e rifiutare. A una sessione a briglia sciolta è molto più difficile dire di no.
Niente di tutto questo è un argomento contro gli agenti interattivi. È un argomento per dire che "fallo fare all'agente" si divide in due prodotti: un collaboratore da guidare e un delegato chiamato a risponderne. Il secondo ha bisogno di ricevute.
I due convivono nel mio stesso lavoro, e su questo preciso progetto li ho usati entrambi. La rifinitura finale dello strumento è arrivata da Claude Code con Fable 5 e Opus 4.8, modelli più veloci e più forti di quelli usati dalla pipeline, con un abbonamento Max in cui smetto di contare i token. Quando il costo è fisso e c'è un umano alla tastiera, l'agente interattivo vince lo sprint. La pipeline richiede più tempo da un capo all'altro, sospetto, ma gira su un modello nella fascia gratuita, il suo costo per funzionalità è un numero che si legge su una dashboard, e il suo comportamento è identico alla decima esecuzione come alla prima. Più economico e più prevedibile non è la metà affascinante dello scambio, ma è la metà che conta quando l'umano si allontana e qualcosa deve mettere un tetto alla spesa.
La parte difficile è il partizionamento, e la soluzione vive in un prompt
La lezione tecnica più profonda è arrivata dal modello di esecuzione.
Ogni ticket viene eseguito su un branch nuovo, derivato dal branch di base. I ticket non vedono i file degli altri, perché i loro branch non sono ancora stati uniti. La prima conseguenza arriva in fretta: se il planner raggruppa il lavoro per livello, tutti i model in un ticket, tutti gli endpoint in un altro, ogni branch importa file che esistono solo su un branch fratello, e non gira niente.
La soluzione non sta nell'executor. Sta nel system prompt del planner, che insegna al modello la topologia di esecuzione dello strumento stesso: il codice degli altri ticket non è su disco; se il file A importa il file B, entrambi appartengono allo stesso ticket; il lavoro va raggruppato in fette verticali; le fondamenta condivise vanno nel ticket uno. Il prompt nomina perfino l'anti-pattern, un ticket per tutti i model e un altro per tutti gli schema, come un fallimento di import garantito. Nella run della demo, il planner ha riunito la funzione di storage, il modulo CSV, l'endpoint e i test in un unico ticket proprio perché formano un'unica catena di dipendenze.
Lo trovo genuinamente interessante come artefatto di design: il vincolo è infrastrutturale, la soluzione è linguistica, e i due sono evoluti insieme attraverso fallimenti osservati. Due pezzi più piccoli completano il quadro. Durante l'esecuzione, un passaggio di discovery classifica quali file creare, modificare o leggere come contesto di convenzioni, e il generatore di codice può leggere file dai branch dei ticket già completati con git show, consapevolezza tra branch senza mai farne il checkout. E siccome l'output di un LLM è ostile ai parser, le risposte di piano e di codice passano per un piccolo stack difensivo: marcatori sentinella, quattro fallback di estrazione, un riparatore di escape per le regex dentro il JSON e un ciclo di retry che restituisce al modello l'errore di parsing a temperatura più bassa. Ognuno di questi pezzi esiste perché qualcosa di reale si è rotto.
Le ricevute
Il motivo per cui mi fido di questa pipeline è che ha consegnato lavoro con cui poi ho dovuto convivere. Parti di Smithproof, tra cui il sottosistema di revisione umana e la macchina dei task in background, sono arrivate come ticket e PR in bozza di plan-to-pr, con i nomi di branch generati dalla macchina ancora nella cronologia. Il prompt di codegen porta ancora il tessuto cicatriziale: convenzioni sulle esatte classi base e sugli stili di schema di quella codebase, aggiunte dopo run che le avevano sbagliate.
La cosa taglia in entrambe le direzioni, e vale la pena dirlo senza giri di parole: la pipeline dà il meglio su funzionalità ben delimitate in codebase con convenzioni chiare. Non è lo strumento per i refactoring più contorti né per i problemi che non so ancora descrivere in una frase. Sapere quale metà del lavoro è quale si rivela la vera competenza nel delegare agli agenti.
Il cerchio si chiude
Ecco la mia parte preferita. plan-to-pr oggi gira come agente governato sotto Smithproof, il control plane che ha aiutato a costruire.
Quando le impostazioni di governance sono presenti, ogni invocazione della pipeline si registra sul control plane, apre una run prima di fare qualunque lavoro e, alla chiusura della run, riporta le sue chiamate al modello, con latenza misurata e costo stimato. La console mostra la pipeline nella flotta come qualsiasi altro agente: tre run ieri, dieci chiamate al modello nella tratta di execute, circa cinque centesimi di spesa.
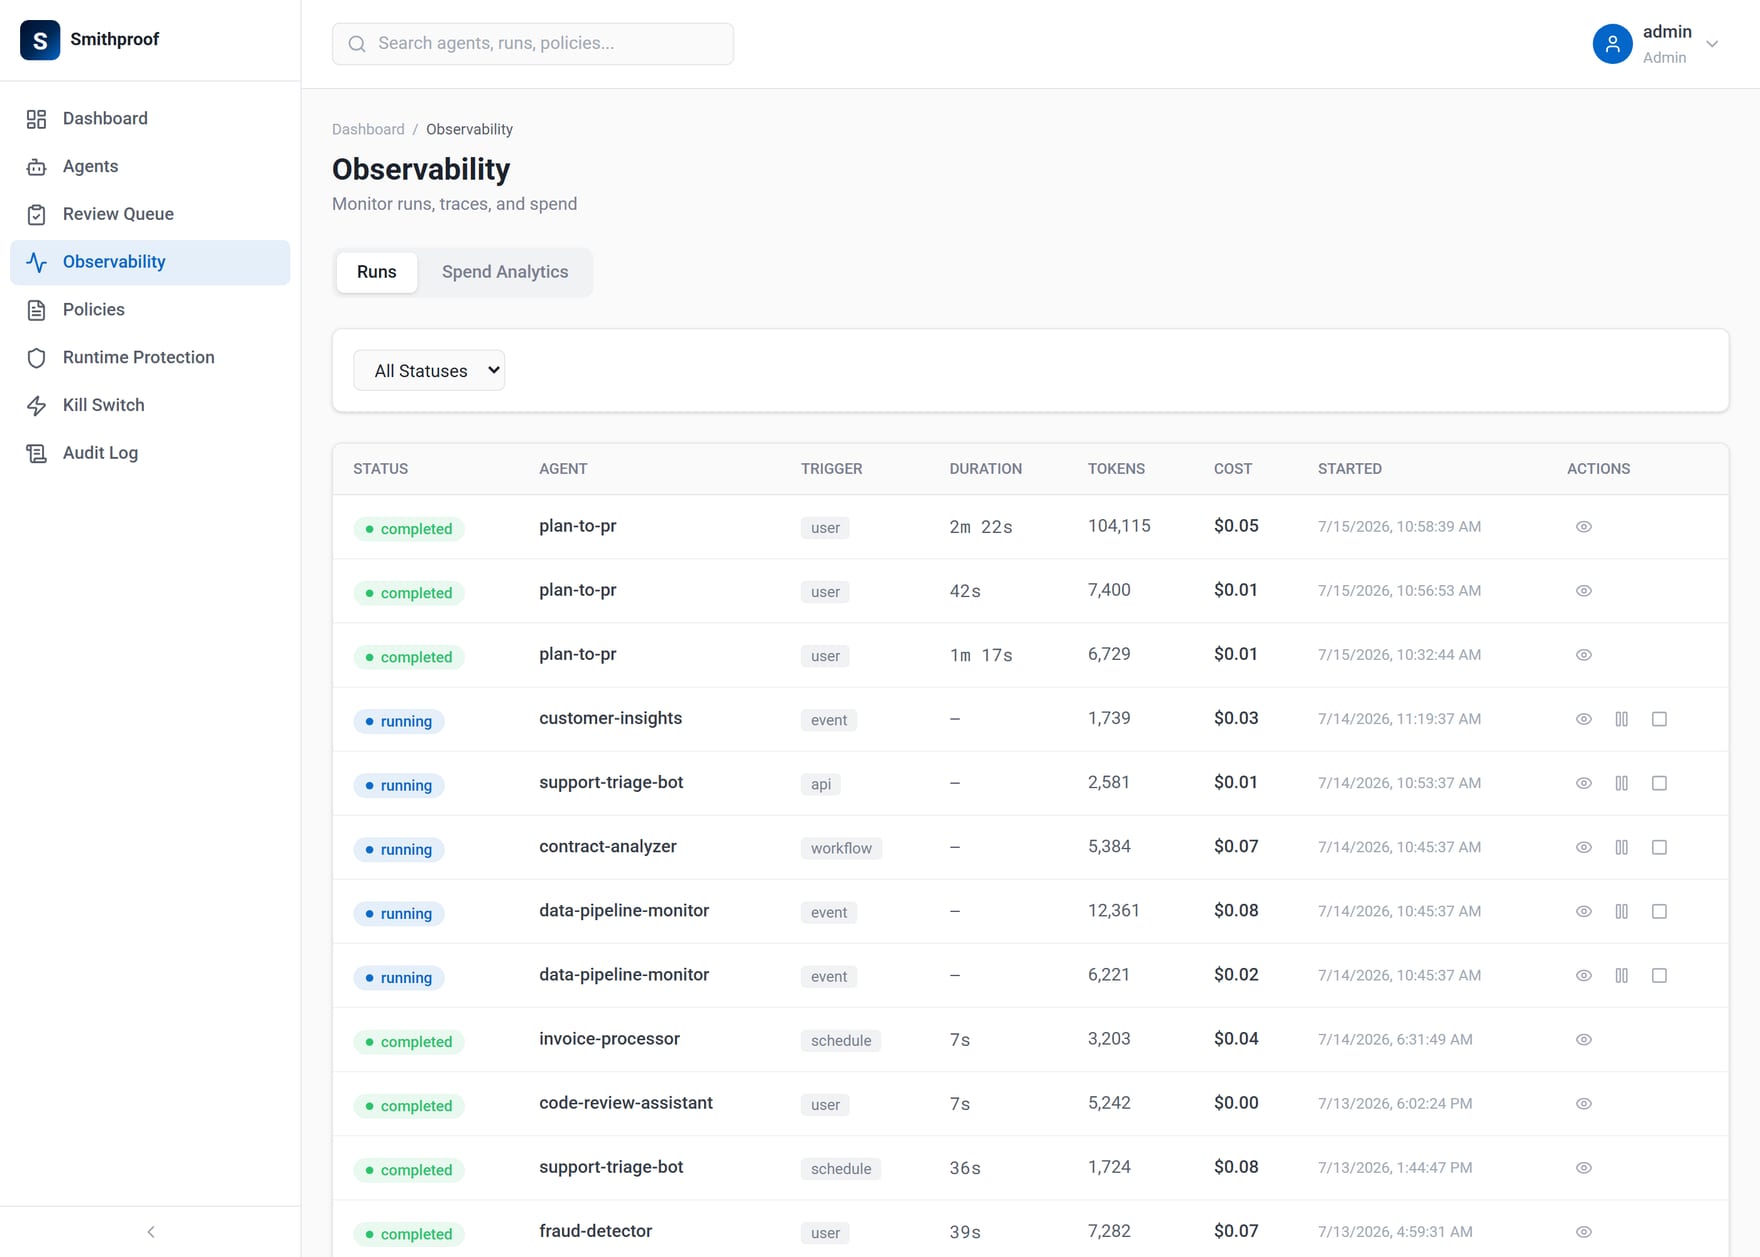 Le run della pipeline nella vista di osservabilità del control plane, accanto al resto della flotta.
La parte che conta non è la telemetria. È che il control plane può dire di no, e la pipeline ascolta. Basta mettere l'agente in quarantena dalla console e l'invocazione immediatamente successiva si ferma sulla porta, prima di una singola chiamata al modello o di una modifica ai file:
 Exit code 5. La motivazione arriva dal control plane, non dallo strumento.
La semantica dei fallimenti ha richiesto una sola decisione vera: negare in caso di decisione, avvisare in caso di disservizio. Se il control plane rifiuta esplicitamente la run, la pipeline si interrompe. Se il control plane è irraggiungibile, la pipeline avvisa a voce alta e prosegue, perché la telemetria non deve mai essere il motivo per cui una build si rompe, ma una decisione di blocco va sempre onorata. Nel post precedente scrivevo che una policy è una decisione e l'enforcement è un'architettura. Questo è l'effetto che fa il lato enforcement visto da dentro il processo governato, e avendo costruito entrambe le metà posso dire che il cerchio completo è più soddisfacente di ciascuna metà da sola.
A che punto è
Oggi plan-to-pr pianifica su qualsiasi repository git con la sola chiave gratuita di Gemini, mette i ticket su Trello o GitHub Issues e apre PR in bozza su GitHub, con ClickUp, Azure DevOps e GitLab nella roadmap dei provider. L'integrazione di governance stima i conteggi di token dalle lunghezze dei testi finché il layer LLM non esporrà l'uso esatto, e le run sono etichettate di conseguenza. La pipeline registra ancora un warning quando, a metà esecuzione, non riesce a ri-committare la sua cartella di stato sul branch del piano, un conflitto di checkout che è il prossimo della lista delle correzioni. Un resoconto dal campo deve includere anche il campo.
Se c'è una cosa da portarsi via da questo progetto è questa: il modello non è mai stato la parte difficile. Le parti difficili erano le stesse di qualsiasi delega, la scomposizione, i gate, la responsabilità e l'umiltà di conservare le ricevute. Gli strumenti che renderanno gli agenti utili per il lavoro vero somiglieranno meno a finestre di chat più intelligenti e più a questo: pipeline con artefatti, eseguite da agenti, governate da qualcosa che sa dirgli di no.
Le domande a cui questo articolo risponde
Perché non usare un agente di coding interattivo in modalità plan invece di costruire una pipeline?
Per esplorare, per una correzione una tantum o per qualsiasi cosa in cui vuoi correggere la rotta in corsa, la sessione interattiva vince e non di poco. La pipeline serve per l'altro mestiere, delegare, dove una fase è codice e non un'istruzione che il modello segue quasi sempre, e dove tre giorni dopo lo stato del mondo è sulla board e nei branch perché non c'era altra possibilità. Porta l'approccio di skill e hook fino in fondo e quello che hai costruito è questa pipeline con una finestra di chat attaccata davanti.
Come si evita che ticket eseguiti su branch separati si rompano a vicenda?
Si risolve nel planner, non nell'executor. Ogni ticket viene eseguito su un branch nuovo derivato da quello di base, quindi il codice di un ticket fratello non è su disco, e il system prompt del planner insegna esattamente questo: se il file A importa il file B, entrambi appartengono allo stesso ticket, il lavoro va raggruppato in fette verticali, le fondamenta condivise vanno nel ticket uno. Nella run della demo il planner ha riunito la funzione di storage, il modulo CSV, l'endpoint e i test in un unico ticket perché formano un'unica catena di dipendenze.
È davvero più veloce che fare il lavoro con un agente interattivo?
Probabilmente no, e non è mai stato quello l'argomento. La sessione interattiva con i modelli più forti vince lo sprint quando il costo è fisso e c'è un umano alla tastiera; la pipeline richiede più tempo da un capo all'altro, ma gira su un modello nella fascia gratuita, il suo costo per funzionalità è un numero che si legge su una dashboard e alla decima esecuzione fa quello che faceva alla prima. Più economico e più prevedibile è la metà che conta quando l'umano si allontana e qualcosa deve mettere un tetto alla spesa.
Si può davvero fermare una pipeline di agenti già in esecuzione?
Sì, e dall'esterno dello strumento. Ogni invocazione si registra sul control plane di Smithproof e apre una run prima di fare qualunque lavoro, quindi basta mettere l'agente in quarantena dalla console perché l'invocazione successiva si fermi sulla porta con exit code 5, prima di una singola chiamata al modello o di una modifica ai file. La semantica dei fallimenti è negare in caso di decisione, avvisare in caso di disservizio: un rifiuto esplicito interrompe la run, mentre un control plane irraggiungibile si limita a un avviso e lascia proseguire, perché la telemetria non deve mai essere il motivo per cui una build si rompe.
Da leggere dopo
 AI Agents
Ho costruito un livello AI che non risponde mai. Ecco cosa serve davvero a una buona domanda
Appunti dal campo su OrbitSpec, un motore di chiarimento che trasforma richieste vaghe in Context Bundle tipizzati e verificabili prima che qualsiasi modello giri, e perché l'affidabilità comincia prima della risposta. AI Agents
Ho costruito un control plane per agenti AI. Ecco cosa serve davvero per governarli
Appunti sul campo dalla costruzione di Smithproof, un control plane multi-tenant per agenti AI, e perché il rilevamento senza risposta e le policy senza applicazione non governano nulla.