
Construí o pipeline que construiu o meu produto. Eis o que delegar realmente exige
Ouvir o artigo (experimental) · 13:46

Ontem escrevi uma frase, "Add CSV export for completed tasks", apontei uma CLI a uma pequena API de gestão de tarefas e fui-me embora. Doze minutos depois havia um plano com critérios de aceitação, cinco tickets num quadro, um registo de aprovação e um draft pull request com um endpoint a funcionar, um módulo novo, testes e documentação atualizada: 1.190 linhas adicionadas ao longo de um branch coerente, um commit por tarefa, à espera de revisão.
A vontade é mais antiga do que a ferramenta. Qualquer pessoa que tenha trabalhado em scrum numa empresa já teve este pensamento durante o planeamento do sprint: as user stories estão ali, refinadas e estimadas, e que bom seria se uma IA fizesse a primeira iteração, enquanto nós passávamos o tempo a rever o PR, a corrê-lo localmente para confirmar que tudo funciona, a ajustar e a repetir o ciclo. Poupa mesmo tempo? É difícil dizer, e não construí isto para vencer esse argumento. Construí-o para tornar essa experiência real, e deixei a questão do impacto para depois.
Num artigo anterior escrevi sobre o Smithproof, o control plane que construí para governar agentes de IA. Esta é a história da ferramenta do outro lado dessa relação: o plan-to-pr, um pipeline de linha de comandos que transforma um pedido de funcionalidade em linguagem natural em pull requests revistos. Os dois estão mais entrelaçados do que um par montado para uma demo. O pipeline ajudou a construir o control plane, e o control plane governa agora o pipeline. Antes de qualquer uma dessas histórias, porém, a ferramenta merece o seu próprio relatório de campo, porque construí-la me ensinou o que delegar em agentes de código realmente exige.
O que é o pipeline
Quatro fases, cada uma com um artefacto:
| Fase | O que acontece | O que fica dela |
|---|---|---|
| Plan | Um LLM classifica a intenção, enriquece o pedido com base num varrimento do repositório e emite épicos, tickets e tarefas com critérios de aceitação | plan.json, validado contra um schema |
| Tickets | Cada tarefa dá origem a um ticket no quadro (Trello ou GitHub Issues) | Cartões que uma equipa pode ver e reatribuir |
| Approve | Um gate humano; a rejeição é o exit code 4 | approval.json: quem, quando |
| Execute | Cada ticket recebe o seu próprio branch; um agente gera código tarefa a tarefa | Um draft PR por ticket, com ligação ao ticket que lhe deu origem |
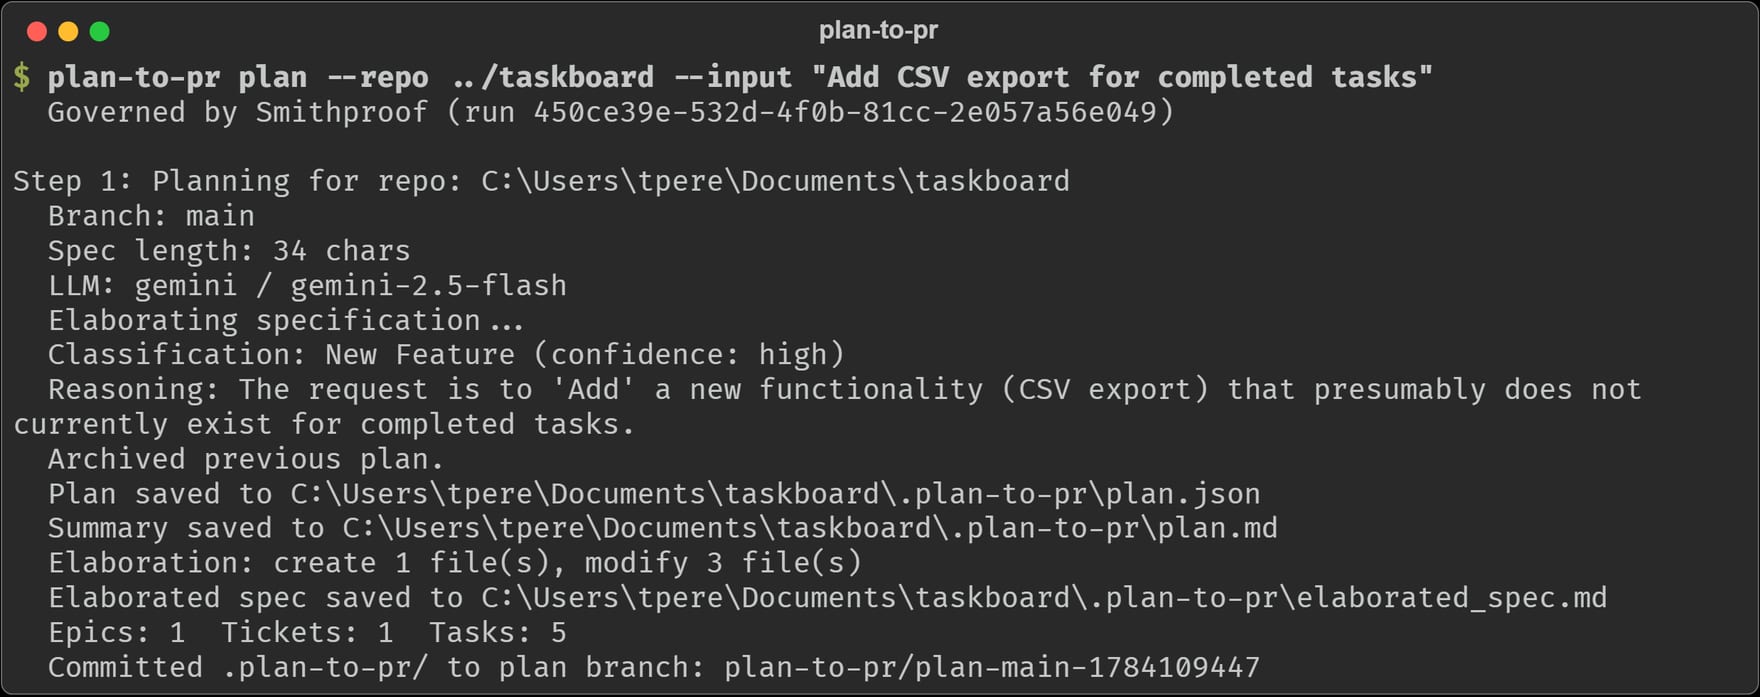 A fase de plano da demo. O próprio plano fica registado num branch dedicado, nunca no main.
O estado que liga tudo isto vive numa pasta .plan-to-pr/ dentro do repositório alvo: o plano, os mapeamentos dos tickets, os resultados da execução. As execuções são retomáveis; uma tarefa concluída nunca é refeita. Nada disto é exótico. É esse precisamente o ponto. O pipeline é orquestração deliberadamente aborrecida à volta de um modelo que é tudo menos previsível.
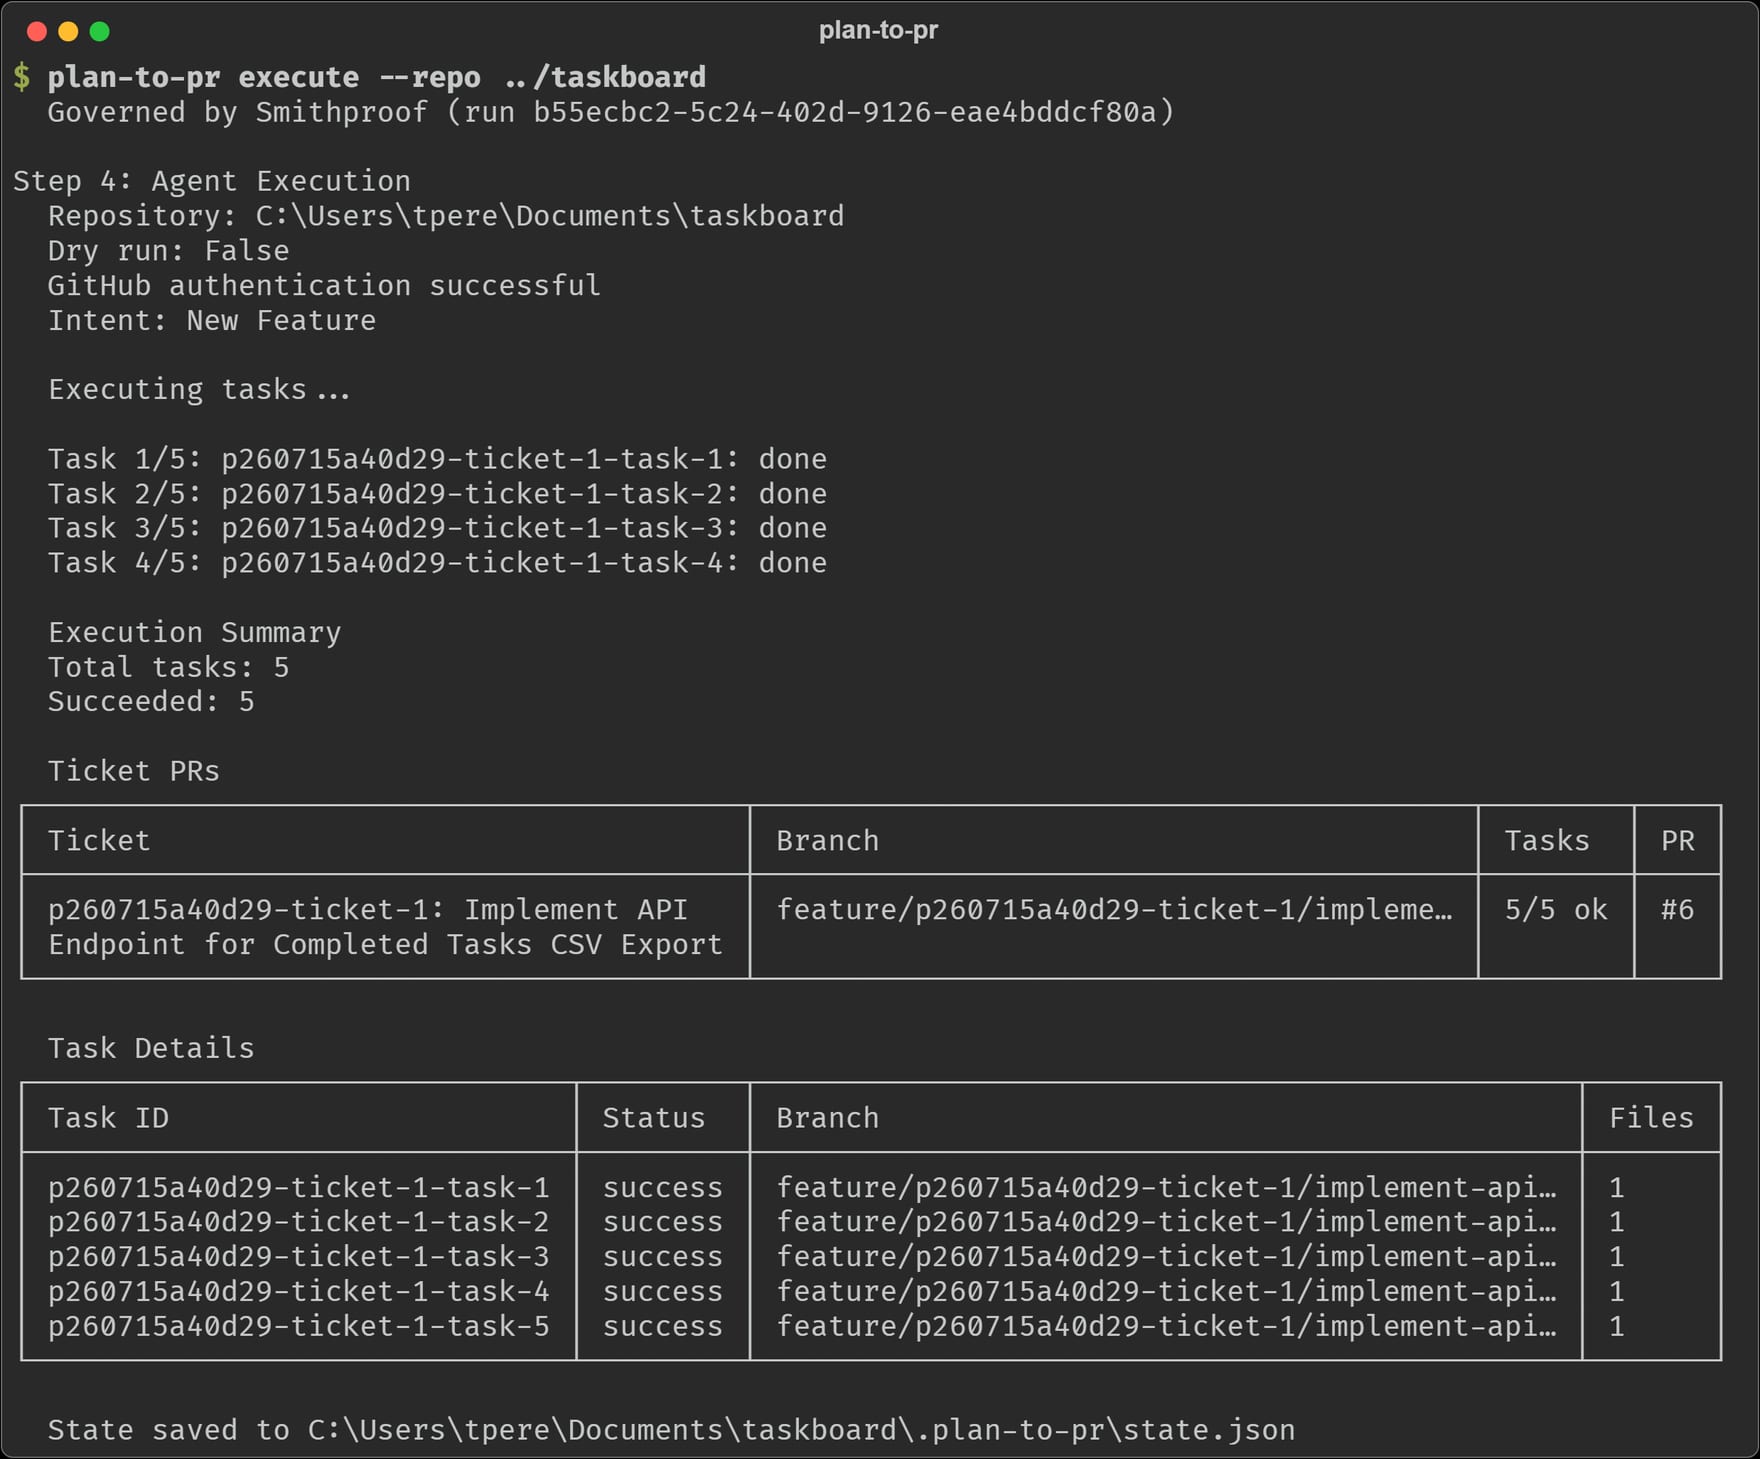 Execute, de ponta a ponta: um branch por ticket, um commit por tarefa, um draft PR com a checklist na descrição.
Porquê um pipeline e não um chat
Uso agentes de código interativos todos os dias, e a pergunta óbvia merece uma resposta direta: porque não abrir o Claude Code, usar o plan mode e deixar a sessão fazer isto tudo?
Para explorar, para uma correção pontual ou para qualquer coisa em que eu queira corrigir o rumo a meio do voo, a sessão interativa ganha, e ganha por larga margem. Mas delegar é um trabalho diferente de colaborar, e a diferença aparece em cinco sítios.
Os artefactos são o comportamento por omissão, não um favor. Um agente de chat capaz escreve um ficheiro de plano e cria tickets no quadro se lho pedirmos, e uma skill bem escrita fá-lo-á sempre que nos lembrarmos de a invocar. A diferença está em onde vive a garantia. Uma skill continua a ser um conjunto de instruções que o modelo quase sempre segue; uma fase do pipeline é código que não pode ser saltado. Levando a abordagem das skills até ao fim, hooks que bloqueiam a execução até existir um ficheiro de aprovação, um script para cada fase, o que se construiu foi este pipeline com uma janela de chat acoplada à frente. Quando volto três dias depois, o estado do mundo está no quadro e nos branches porque nada mais era possível, não porque toda a gente se lembrou de pedir.
Um gate não é uma pergunta. Um agente interativo pergunta "isto está bem assim?" e a verdade é que, ao fim de aprovações suficientes, deixamos de ler. O passo de aprovação do pipeline é uma paragem obrigatória, com um exit code. Nada é executado enquanto o approval.json não existir, e a rejeição é um desfecho de primeira classe, não uma mensagem educada.
As unidades de trabalho são unidades de revisão. O pipeline emite um PR por ticket, cada um pequeno o suficiente para ser revisto a sério, cada um ligado ao ticket que o motivou. Uma sessão longa com um agente tende a produzir um diff enorme e disperso, moldado pela ordem que a conversa por acaso tomou.
O fluxo de controlo pertence ao código. No pipeline, o modelo escreve planos e código dentro de passos bem definidos, mas o ciclo em si, o que corre, por que ordem, o que acontece em caso de falha, é Python determinístico. Quando algo se parte às duas da manhã, vou depurar um pipeline, não uma personalidade.
Um pipeline pode ser governado. É este o ponto que mais me importa, e tem uma secção só sua mais abaixo. Uma CLI com pontos de entrada definidos pode ser registada, observada, orçamentada e recusada. A uma sessão em formato livre é muito mais difícil dizer que não.
Nada disto é um argumento contra agentes interativos. É um argumento de que "o agente que trate disso" se divide em dois produtos: um colaborador que conduzimos e um delegado a quem pedimos contas. O segundo precisa de recibos.
Os dois convivem no meu próprio trabalho, e este preciso projeto usou ambos. O polimento final da ferramenta veio do Claude Code com o Fable 5 e o Opus 4.8, modelos mais rápidos e mais fortes do que os que o pipeline usa, numa subscrição Max em que deixo de contar tokens. Quando o custo é fixo e há um humano ao teclado, o agente interativo ganha o sprint. O pipeline demora mais de ponta a ponta, suspeito, mas corre num modelo de nível gratuito, o custo por funcionalidade é um número que se lê num dashboard, e o comportamento é o mesmo à décima execução e à primeira. Mais barato e mais previsível não é a metade glamorosa da troca, mas é a metade que conta quando o humano se afasta e alguma coisa tem de limitar a despesa.
A parte difícil é particionar, e a correção vive num prompt
A lição técnica mais profunda veio do modelo de execução.
Cada ticket executa num branch novo, criado a partir do branch base. Os tickets não veem os ficheiros uns dos outros, porque os respetivos branches ainda não foram integrados. A primeira consequência chega depressa: se o planeador agrupar o trabalho por camada, todos os modelos num ticket, todos os endpoints noutro, cada branch importa ficheiros que só existem num branch irmão, e nada corre.
A correção não está no executor. Está no system prompt do planeador, que ensina ao modelo a topologia de execução da própria ferramenta: o código dos outros tickets não está no disco; se o ficheiro A importa o ficheiro B, ambos pertencem ao mesmo ticket; o trabalho agrupa-se em fatias verticais; as fundações partilhadas vão para o ticket um. O prompt chega a dar nome ao anti-padrão, um ticket para todos os modelos e outro para todos os schemas, como falha de importação garantida. Na execução da demo, o planeador juntou a função de armazenamento, o módulo CSV, o endpoint e os testes num único ticket precisamente por serem uma só cadeia de dependências.
Acho isto genuinamente interessante enquanto artefacto de design: a restrição é infraestrutural, a solução é linguística, e as duas evoluíram juntas a partir de falhas observadas. Duas peças mais pequenas completam o quadro. Durante a execução, uma passagem de descoberta classifica que ficheiros criar, modificar ou ler como contexto de convenções, e o gerador de código consegue ler ficheiros dos branches de outros tickets já concluídos com git show, consciência entre branches sem nunca lhes fazer checkout. E porque o output de um LLM é hostil para parsers, as respostas de plano e de código passam por uma pequena pilha defensiva: marcadores sentinela, quatro fallbacks de extração, um reparador de escapes para regex dentro de JSON e um ciclo de retry que devolve o erro de parsing ao modelo com temperatura mais baixa. Cada uma destas peças existe porque algo real partiu.
Os recibos
A razão pela qual confio neste pipeline é já ter entregue trabalho com o qual depois tive de viver. Partes do Smithproof, entre elas o subsistema de revisão humana e a maquinaria de tarefas em segundo plano, chegaram como tickets e draft PRs do plan-to-pr, com os nomes de branch gerados pela máquina ainda no histórico. O prompt de geração de código ainda carrega as cicatrizes: convenções sobre as classes base exatas e os estilos de schema dessa base de código, acrescentadas depois de execuções que se enganaram nelas.
Isto corta nos dois sentidos, e vale a pena dizê-lo com clareza: o pipeline é melhor em trabalho de funcionalidades bem delimitado, em bases de código com convenções claras. Não é a ferramenta para refactors complicados nem para problemas que ainda não consigo descrever numa frase. Saber qual metade do trabalho é qual acaba por ser a verdadeira competência de quem delega em agentes.
O ciclo fecha-se
Esta é a minha parte preferida. O plan-to-pr corre agora como um agente governado sob o Smithproof, o control plane que ele próprio ajudou a construir.
Quando as definições de governação estão presentes, cada invocação do pipeline regista-se no control plane, abre uma execução antes de fazer o que quer que seja e comunica as suas chamadas ao modelo, com latência medida e custo estimado, quando a execução fecha. A consola mostra o pipeline na frota como outro agente qualquer: três execuções ontem, dez chamadas ao modelo na fase de execução, cerca de cinco cêntimos de despesa.
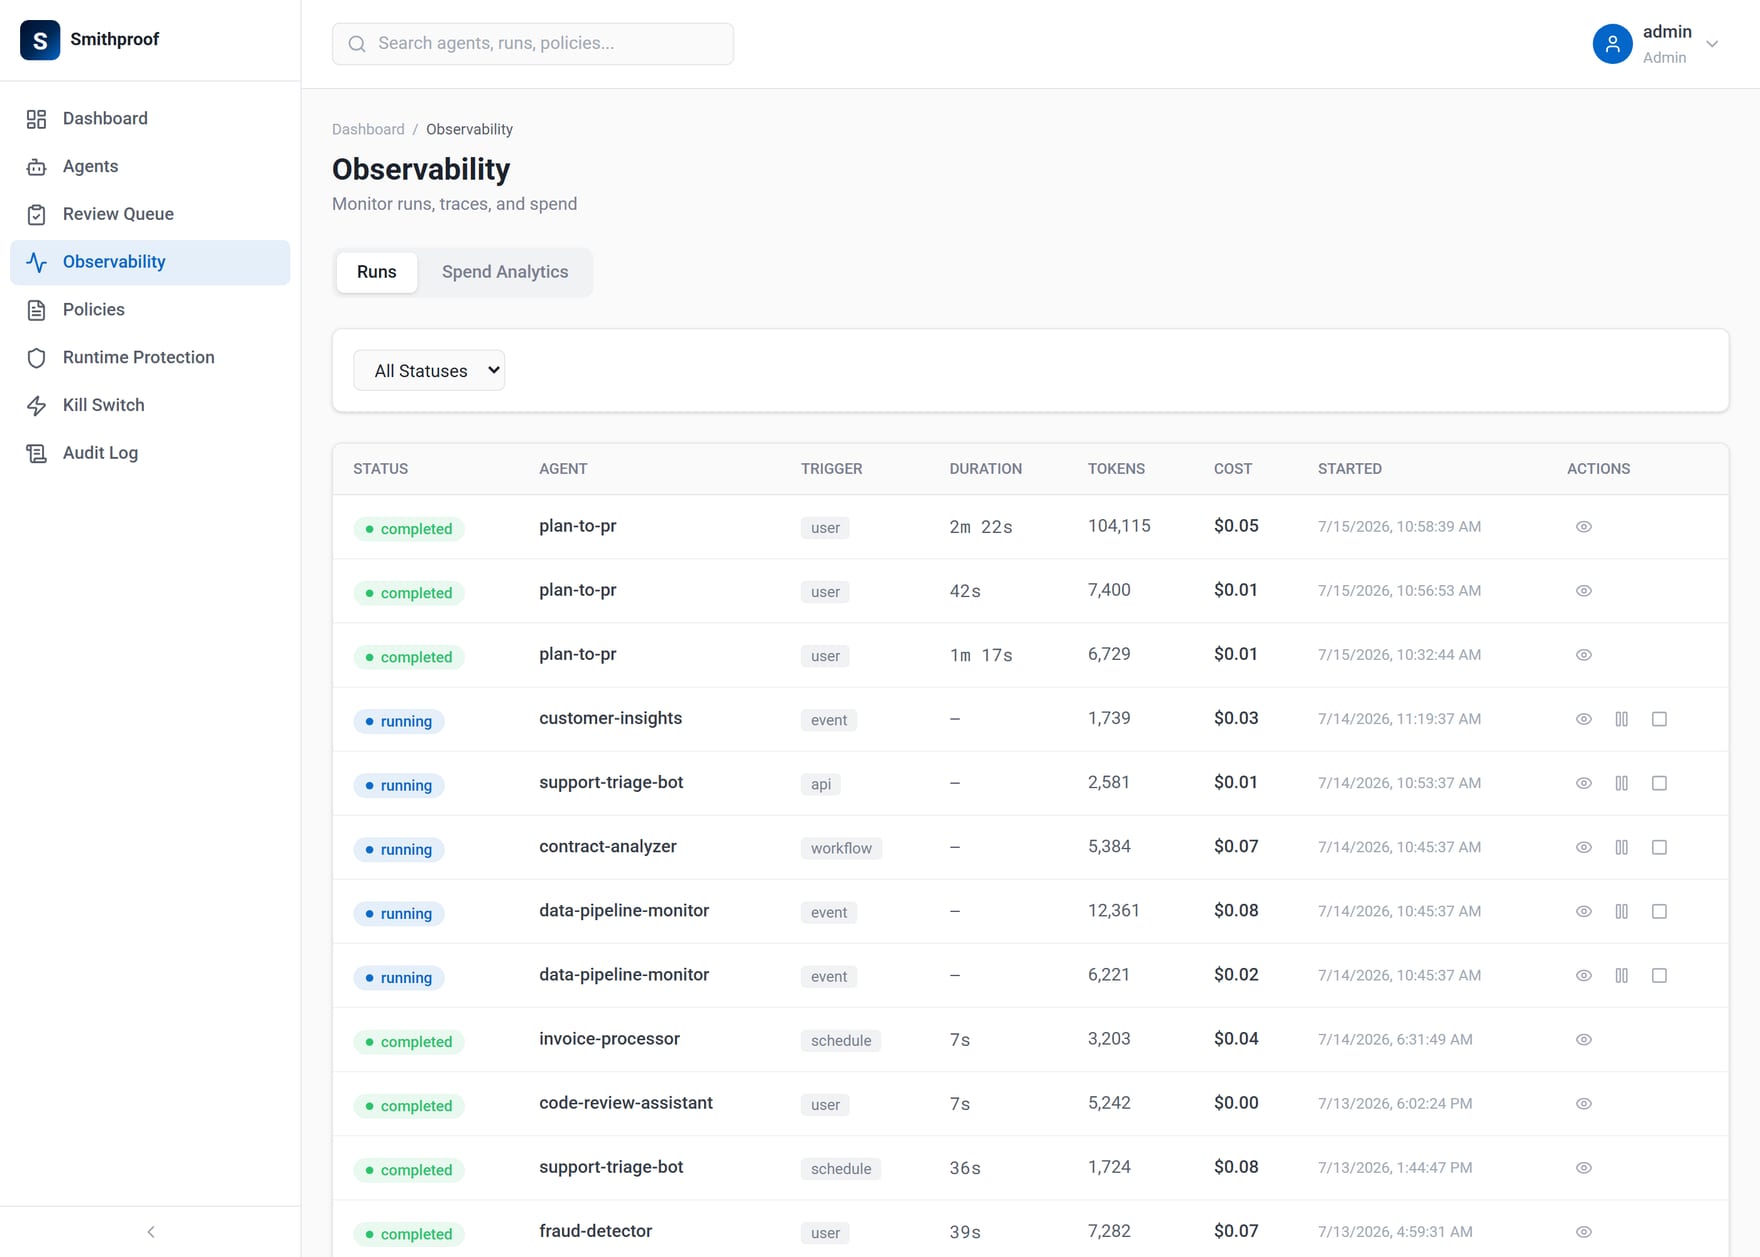 As execuções do pipeline na vista de observabilidade do control plane, ao lado do resto da frota.
A parte que importa não é a telemetria. É que o control plane pode dizer que não, e o pipeline ouve. Basta pôr o agente em quarentena na consola para a invocação seguinte parar logo à porta, antes de uma única chamada ao modelo ou de uma única alteração a ficheiros:
 Exit code 5. A razão vem do control plane, não da ferramenta.
A semântica de falha exigiu uma decisão a sério: negar perante uma decisão, avisar perante uma indisponibilidade. Se o control plane recusar explicitamente a execução, o pipeline aborta. Se o control plane estiver inacessível, o pipeline avisa bem alto e segue em frente, porque a telemetria nunca deve ser o motivo de um build partir, mas uma decisão de bloqueio tem de ser sempre honrada. No artigo anterior escrevi que uma política é uma decisão e que a sua aplicação é uma arquitetura. É esta a sensação do lado da aplicação, visto de dentro do processo governado, e, tendo construído as duas metades, posso dizer que o ciclo completo é mais satisfatório do que qualquer das metades sozinha.
O ponto da situação
Hoje, o plan-to-pr planeia sobre qualquer repositório git apenas com uma chave gratuita do Gemini, coloca tickets no Trello ou no GitHub Issues e abre draft PRs no GitHub, com ClickUp, Azure DevOps e GitLab no roadmap de fornecedores. A integração de governação estima as contagens de tokens a partir do comprimento dos textos, até a camada de LLM expor a utilização exata, e as execuções ficam etiquetadas em conformidade. O pipeline ainda regista um aviso quando não consegue voltar a fazer commit da pasta de estado no branch do plano a meio da execução, um conflito de checkout que é o próximo item na lista de correções. Um relatório de campo deve incluir o campo.
Se há uma coisa a levar desta construção é esta: o modelo nunca foi a parte difícil. As partes difíceis foram as mesmas de qualquer delegação: a decomposição, os gates, a responsabilização e a humildade de guardar os recibos. As ferramentas que tornarem os agentes úteis para trabalho a sério vão parecer-se menos com janelas de chat mais inteligentes e mais com isto: pipelines com artefactos, executados por agentes, governados por algo que lhes saiba dizer que não.
Perguntas a que este artigo responde
Porque não usar um agente de código interativo em plan mode em vez de construir um pipeline?
Para explorar, para uma correção pontual ou para qualquer coisa em que se queira corrigir o rumo a meio do voo, a sessão interativa ganha por larga margem. O pipeline serve o outro trabalho, delegar, em que uma fase é código e não uma instrução que o modelo quase sempre segue, e em que três dias depois o estado do mundo está no quadro e nos branches porque nada mais era possível. Levando a abordagem das skills e dos hooks até ao fim, o que se construiu foi este pipeline com uma janela de chat acoplada à frente.
Como se evita que tickets a correr em branches separados se partam uns aos outros?
A correção está no planeador, não no executor. Cada ticket executa num branch novo criado a partir do branch base, por isso o código de um ticket irmão não está no disco, e o system prompt do planeador ensina exatamente isso: se o ficheiro A importa o ficheiro B, ambos pertencem ao mesmo ticket, o trabalho agrupa-se em fatias verticais, as fundações partilhadas vão para o ticket um. Na execução da demo, o planeador juntou a função de armazenamento, o módulo CSV, o endpoint e os testes num único ticket por serem uma só cadeia de dependências.
Poupa mesmo tempo em relação a fazer o trabalho com um agente interativo?
Provavelmente não, e nunca foi esse o argumento. A sessão interativa com os modelos mais fortes ganha o sprint quando o custo é fixo e há um humano ao teclado; o pipeline demora mais de ponta a ponta, mas corre num modelo de nível gratuito, o custo por funcionalidade é um número que se lê num dashboard, e faz o mesmo à décima execução e à primeira. Mais barato e mais previsível é a metade que conta quando o humano se afasta e alguma coisa tem de limitar a despesa.
É possível travar um pipeline de agentes já a correr?
Sim, e a partir de fora da ferramenta. Cada invocação regista-se no control plane do Smithproof e abre uma execução antes de fazer o que quer que seja, por isso basta pôr o agente em quarentena na consola para a invocação seguinte parar logo à porta com o exit code 5, antes de uma única chamada ao modelo ou alteração a ficheiros. A semântica de falha é negar perante uma decisão e avisar perante uma indisponibilidade: uma recusa explícita aborta a execução, ao passo que um control plane inacessível apenas avisa e segue em frente, porque a telemetria nunca deve ser o motivo de um build partir.
Ler a seguir
 AI Agents
Construí uma camada de IA que nunca responde. Eis o que uma boa pergunta realmente exige
Notas de campo do OrbitSpec, um motor de clarificação que transforma pedidos vagos em Context Bundles tipados e auditáveis antes de qualquer modelo correr, e porque é que a fiabilidade começa antes da resposta. AI Agents
Construí um plano de controlo para agentes de IA. Eis o que a governança exige de facto
Notas de campo sobre a construção do Smithproof, um plano de controlo multi-inquilino para agentes de IA, e porque é que a deteção sem resposta e a política sem aplicação não governam nada.