
Construí uma camada de IA que nunca responde. Eis o que uma boa pergunta realmente exige
Ouvir o artigo (experimental) · 12:55

Escreva "não me sinto bem e quero saber o que fazer" num serviço que construí, e ele não lhe dirá o que fazer. Pergunta que sintomas tem. Depois pergunta quando começaram. E depois deixa de perguntar, porque esses são os dois únicos campos que o pack marca como obrigatórios, e entrega à sua aplicação um documento JSON tipado, versionado e auditável chamado Context Bundle. Tempo total de motor ao longo de toda a conversa: bem abaixo de um milissegundo. Número de respostas dadas: zero.
Essa recusa em responder é o produto na sua totalidade, e nasceu de duas ideias que me acompanhavam há algum tempo. A primeira devo-a a Marc Brooker, que defende que uma especificação não é algo que se decreta antes do trabalho; é algo a que se chega iterando, e que uma boa especificação é, cada vez mais, aquilo que permite a uma IA fazer sequer o trabalho (Spec Driven Development isn't Waterfall). Os requisitos não aparecem já esclarecidos. Esclarecemo-los perguntando, ou seja, conversando. A segunda devo-a a Rafael Peixoto, que me convenceu há coisa de um ano ou dois de que o futuro da IA era neurossimbólico, modelos neuronais flexíveis envoltos numa estrutura simbólica que se pode efetivamente verificar, numa altura em que todo o campo apostava no sentido contrário. O OrbitSpec é o que essas duas ideias parecem quando corram como serviço: uma conversa breve que transforma um pedido vago numa especificação verificável, conduzida por um motor determinista que trata o modelo de linguagem como convidado, nunca como anfitrião.
Este é também o terceiro relato de campo de uma série que acabou por ser um só sistema visto de três ângulos. O Smithproof governa o que os agentes fazem. O plan-to-pr estrutura o que lhes delegamos. O OrbitSpec, cronologicamente a primeira coisa que construí e a última a ser documentada, está mesmo no início da cadeia, onde um humano escreve algo vago e começa todo o custo que se segue. O seu chassis partiu do template full-stack do tiangolo, com o devido crédito a quem o merece; o motor que assenta por cima é a história que aqui se conta.
O que é
O OrbitSpec é clarificação como serviço: uma API B2B que se coloca à frente de um produto de IA. A aplicação do cliente cria uma sessão, submete o rascunho do utilizador e recebe um de dois resultados. Ou needs_clarification, com exatamente uma pergunta para reencaminhar ao utilizador, ou ready, com o Context Bundle para o modelo que o cliente executar a jusante.
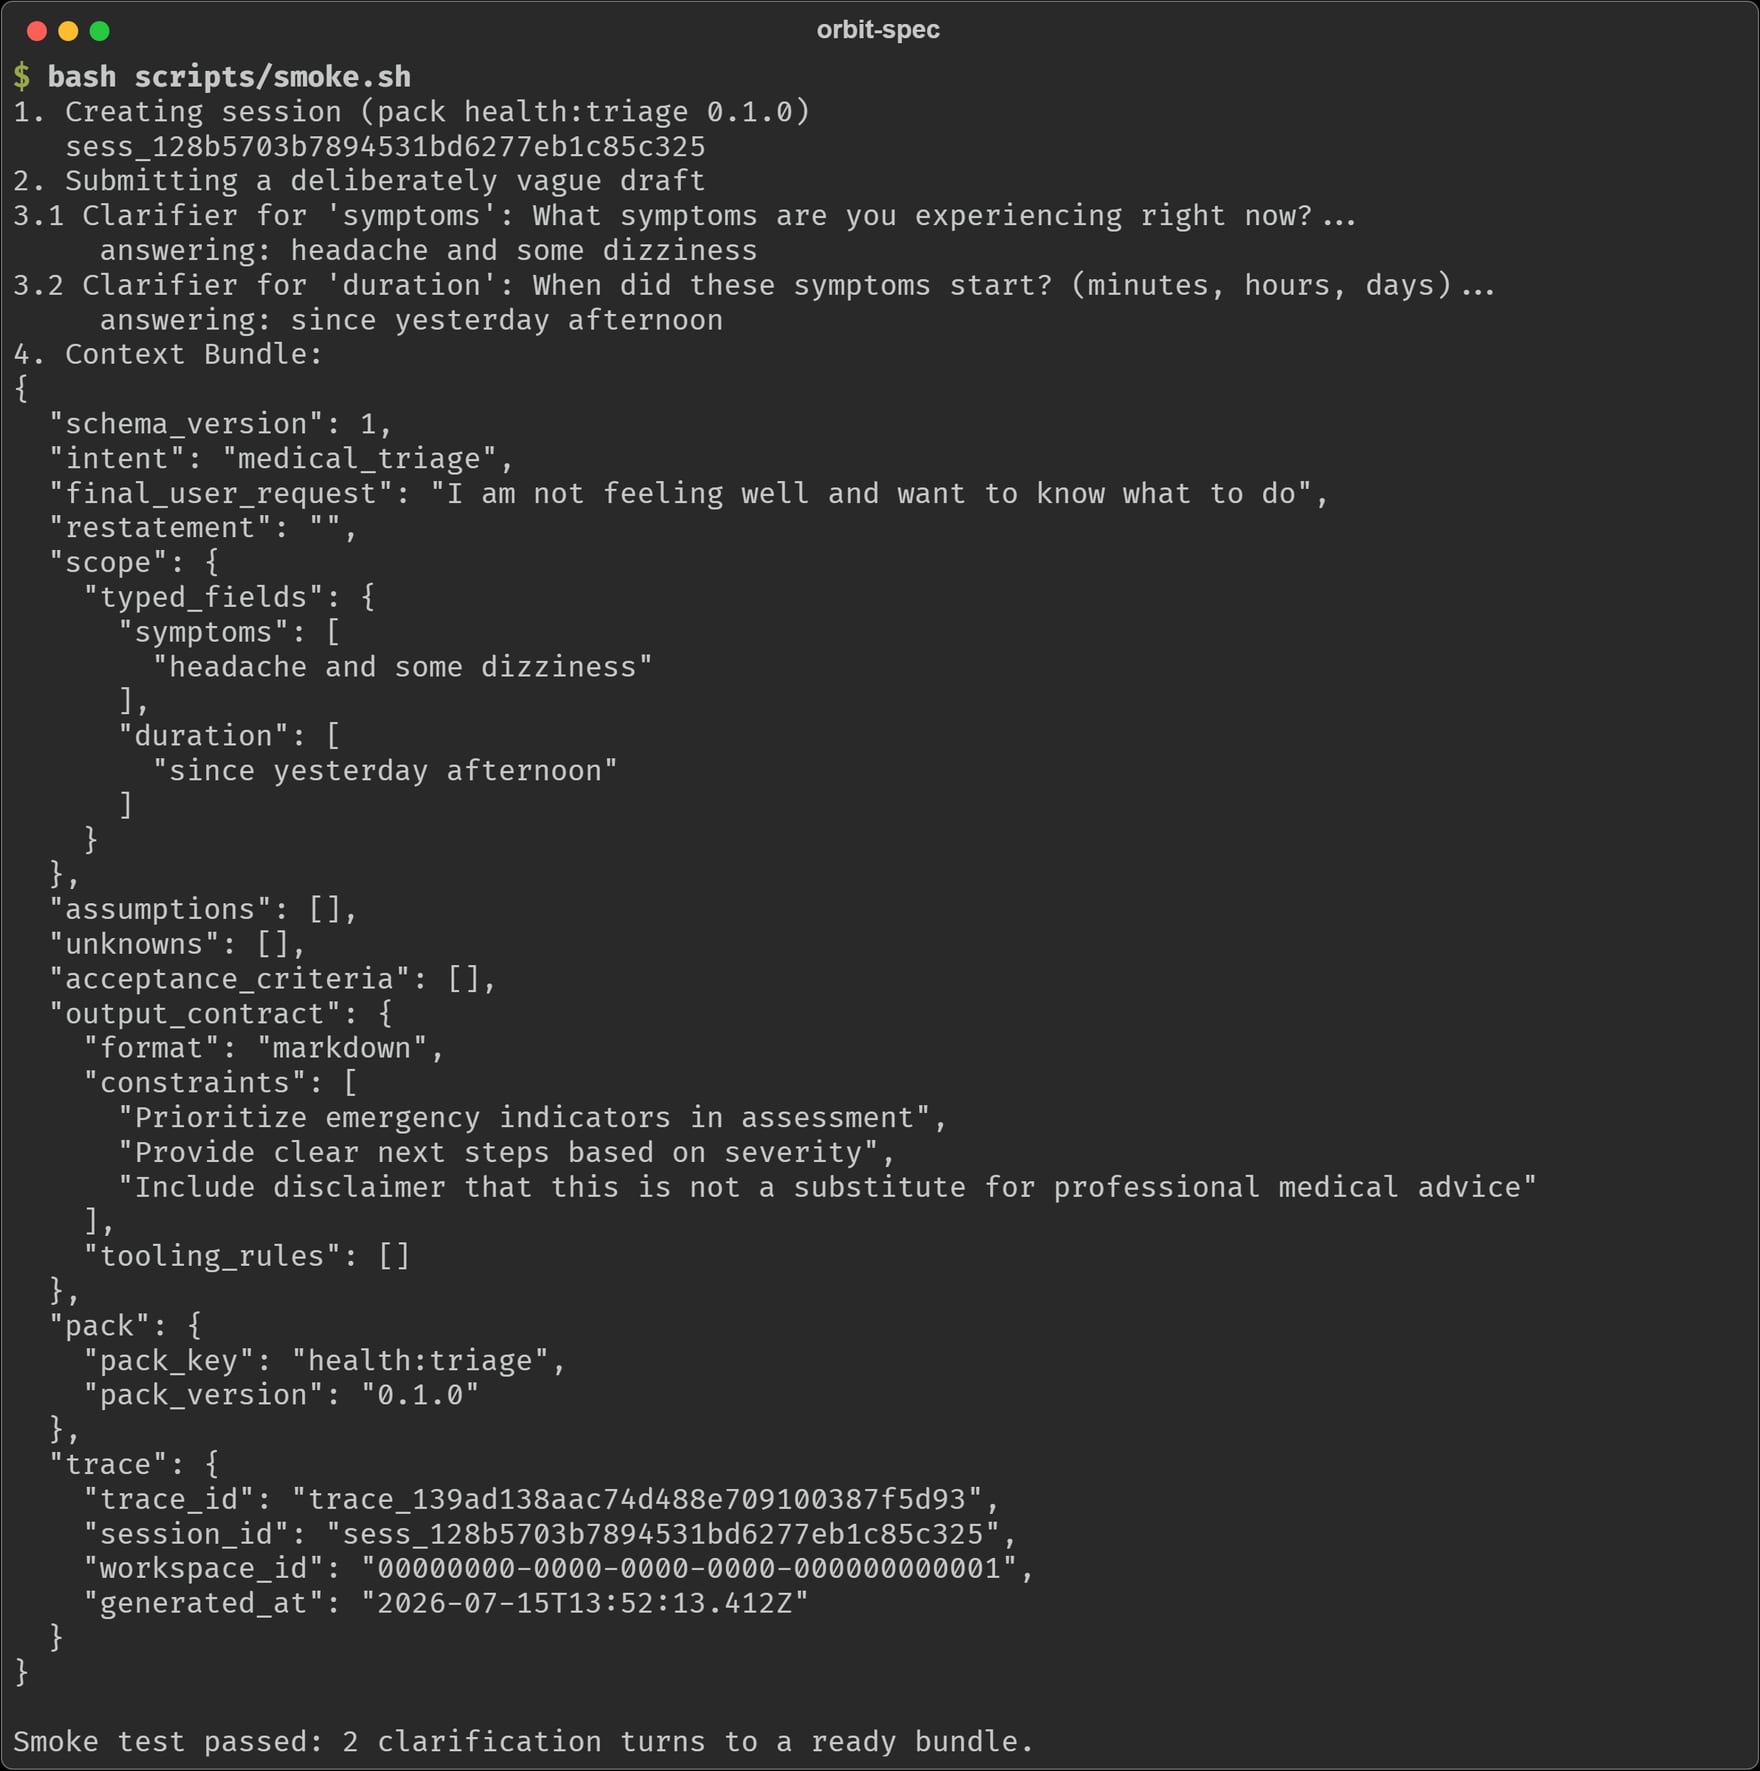 O ciclo completo a partir de um terminal: um rascunho vago, duas perguntas, um bundle. O motor fez duas perguntas porque o pack exige dois dos seus sete campos, e nunca pergunta mais do que o pack impõe.
O comportamento vive em dados, não em código. Intent Packs versionados em YAML definem os campos de que um domínio precisa, quais são obrigatórios, que pergunta fazer para cada um e uma prioridade de clarificação. Uma sessão fixa a versão do pack no momento da criação, pelo que uma atualização do pack nunca muda as regras de uma conversa a meio do voo, e a versão fixada dentro de cada bundle torna-o reproduzível: mesmo pack, mesmas respostas, mesmo resultado. Há packs para triagem de saúde, admissão jurídica, participações de seguros, investigação e um fallback genérico.
Três propriedades fazem o trabalho pesado, e as três são velhas virtudes de software, não novidades de IA. O ciclo é determinístico: o motor que funde o âmbito, valida os campos e escolhe a pergunta seguinte é código simples com precedência documentada. A pergunta é singular: um clarificador por turno, escolhido como a pergunta útil mais pequena, porque os utilizadores respondem a uma pergunta e abandonam questionários. E tudo é auditado: cada passo de cada turno fica registado num event log append-only com a respetiva latência.
A vitória de fiabilidade mais barata acontece antes de o modelo correr
A indústria esforça-se por fazer os modelos responder melhor. Retrieval, reranking, guardrails, evals: tudo isso opera do lado da resposta da transação. Mas uma grande fatia dos maus resultados de IA não são perguntas mal respondidas; são más perguntas bem respondidas. "Preciso de ajuda com um problema de saúde" não tem boa resposta, e tudo o que um modelo gerar a partir daí é adivinhação cara com tom confiante.
A eficácia quase irrazoável do design do OrbitSpec está em corrigir isto por quase nada. Eis o próprio livro-razão de auditoria do motor para a sessão acima:
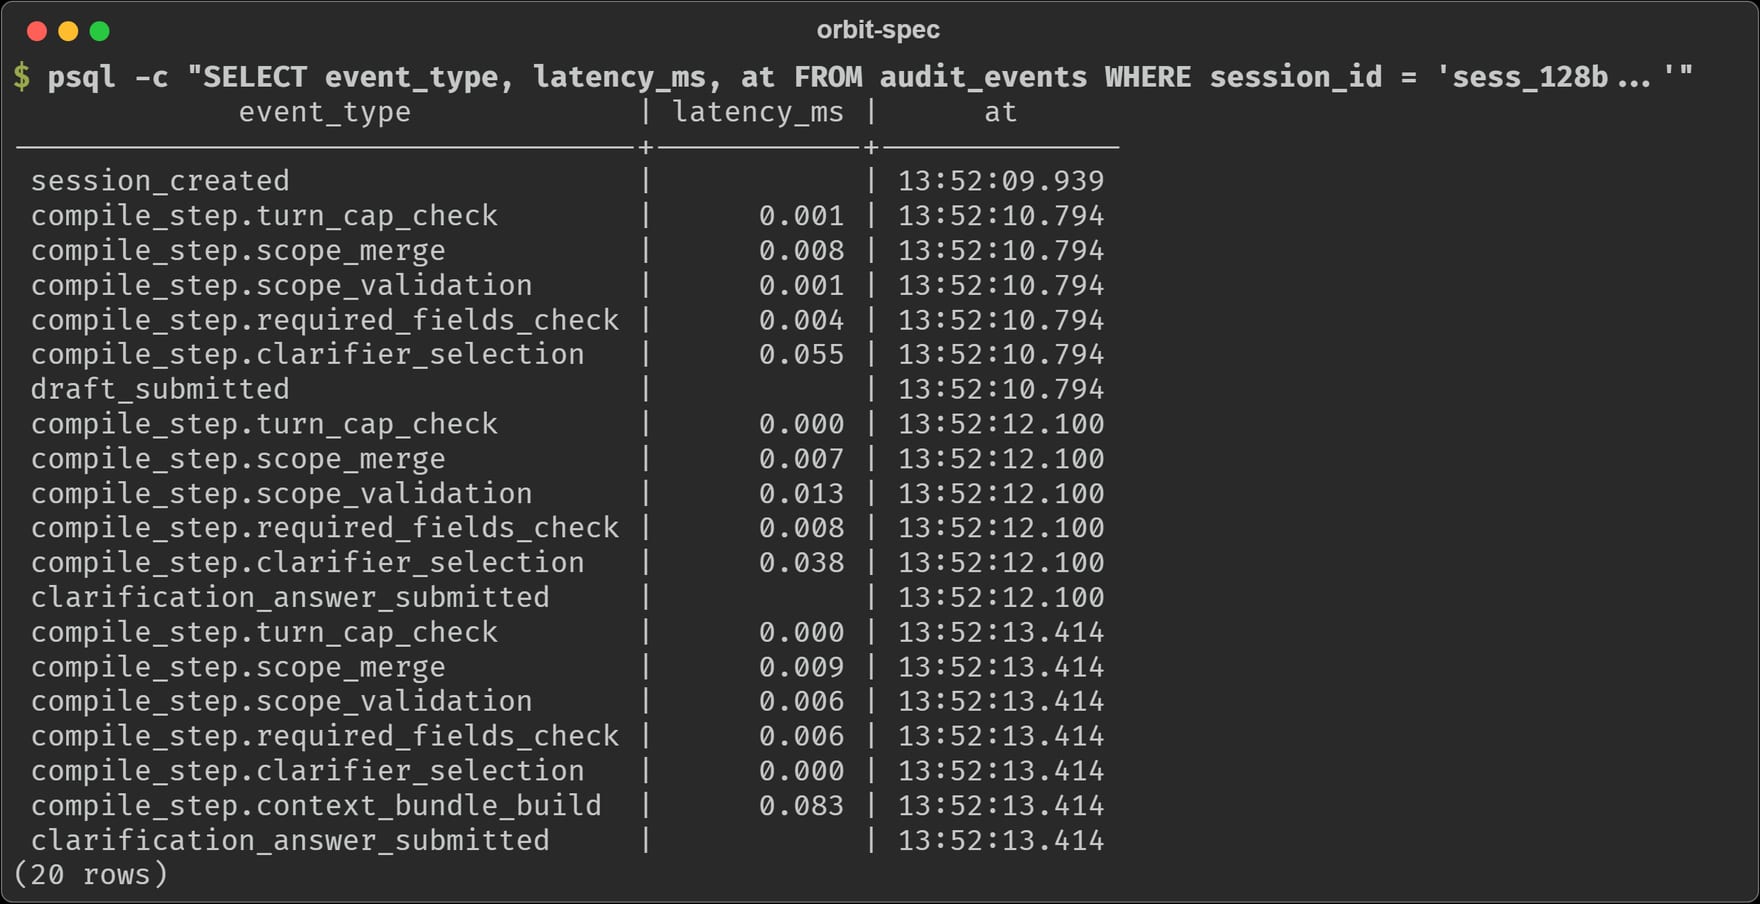 Cada passo de cada turno, com timestamp e latência. O motor inteiro gasta microssegundos por turno.
Microssegundos por turno, e cada linha é atribuível: que passo correu, quando, dentro de que sessão, sob que trace id. Quando algo corre mal a jusante, a pergunta que produziu o bundle não é uma memória perdida num registo de chat; é um registo consultável. No artigo sobre o Smithproof escrevi que despesa que se consegue ler é despesa que um control plane consegue limitar. O mesmo vale aqui: intenção que se consegue ler é intenção que se consegue auditar.
Um nó no agente de outrem
O OrbitSpec não é uma app, e a forma mais rápida de o julgar mal é avaliá-lo como se fosse. O repositório inclui quatro chatbots de demonstração construídos com LangGraph, cada um a consumir o serviço através do seu SDK Python gerado, e a arquitetura deles é o argumento: o OrbitSpec é um nó no grafo de agente do cliente. O input do utilizador entra no nó de clarificação; o nó devolve ou uma pergunta, que o chat reencaminha, ou um bundle, que o resto do grafo consome.
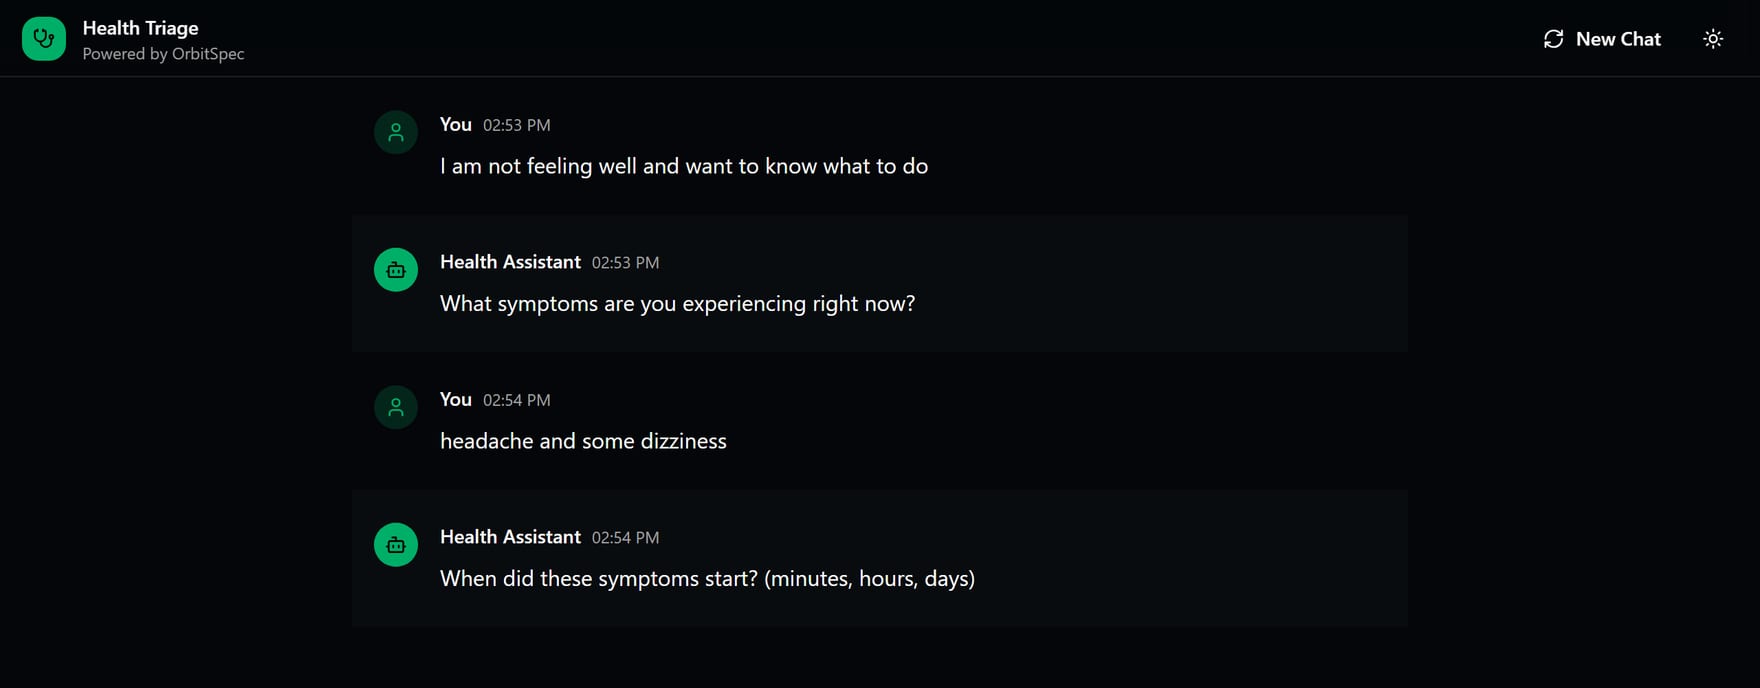 A demo de triagem de saúde. A UI de chat pertence ao cliente; as perguntas vêm do pack; o assistente nunca responde, clarifica.
O próprio SDK faz parte da história de fiabilidade. É gerado a partir da especificação OpenAPI, e o CI regenera-o a cada alteração do backend e falha se houver divergência, pelo que o cliente que as demos consomem não pode afastar-se em silêncio da API que o serve. Os contratos de integração apodrecem nas costuras; este é verificado em cada pull request.
A lição dos 138 segundos
A decisão técnica profunda deste projeto é sobre onde a inteligência deve viver, e foi aprendida da maneira cara.
O design óbvio usa um LLM para extrair campos do rascunho: o utilizador diz "tenho dores de cabeça e alguma tontura desde ontem à tarde" e o modelo preenche symptoms e duration sem perguntar. A primeira implementação corria essa extração num modelo local através do Ollama em CPU, e o repositório preserva o post-mortem: uma média de 138 segundos por pedido de deteção de campos, contra um timeout de 60 segundos. A extração que devia poupar uma pergunta ao utilizador demorava dois minutos a não lhe responder.
A correção teve três camadas, e a ordem importa mais do que qualquer uma delas isoladamente.
As regras são o chão. O ciclo de clarificação é totalmente funcional sem LLM nenhum: os campos preenchem-se com as respostas, o motor mantém-se no território dos microssegundos e o produto funciona. A inteligência é um upgrade, nunca uma dependência. Essa única decisão é a razão pela qual um modelo de dois minutos não conseguiu arrastar o produto consigo.
A inferência é uma troca, não uma reescrita. A extração passou para um router alojado a correr um modelo Llama pequeno, segundos em vez de minutos, e o Ollama local ficou disponível atrás de um compose profile para quem quiser inferência no seu próprio hardware. Como a extração está atrás de uma interface com fallback de regras, o fornecedor é uma escolha de configuração.
Nada do que o modelo diz entra sem fundamentação. Os valores extraídos passam por uma camada de validação antes de serem aceites: campos propensos a alucinações têm de ter fundamentação lexical nas próprias palavras do utilizador, valores que são sobretudo um eco do input inteiro são rejeitados como cópias, e campos de tipo data têm de passar uma verificação de plausibilidade. Um modelo pequeno que erra depressa só é útil se o erro não puder entrar no bundle.
O artigo sobre o Smithproof defendia que o modelo que nos podemos dar ao luxo de correr inline é o modelo que governa. Esta é a mesma lei vista do outro lado: o modelo pelo qual não nos podemos dar ao luxo de esperar é o modelo que não nos pode ajudar, e o motor determinístico em que mal reparamos é o que pode sempre.
Aborrecido de propósito
Duas peças mais pequenas merecem a sua linha, ambas do tipo de engenharia que nunca fica bem numa demo. O estado da sessão vive em hashes de Redis guardados por um lock otimista em script Lua: um único script atómico verifica um campo de versão antes de escrever, devolve códigos de erro distintos para sessão inexistente e para conflito de versão, e renova o TTL, para que duas respostas concorrentes à mesma sessão não se sobreponham em silêncio. E o bloco de trace do bundle transporta a cadeia de identidade completa, trace id, session id, workspace id, generated-at, para que qualquer bundle possa ser reconduzido a cada passo que o produziu.
Nada disto é novo. Tudo isto é o que faz a diferença entre uma demonstração de clarificação e um serviço sobre o qual outra empresa pode construir.
O ponto em que está
O Context Bundle transporta hoje a intenção, o pedido original, campos tipados, restrições de output e identidade de trace. Os campos do roadmap estão visíveis no schema: uma reformulação do pedido nas palavras do motor, pressupostos, incógnitas e critérios de aceitação seguem todos como placeholders vazios, à espera da camada que os preencha. Os Scope Profiles, respostas memorizadas que acompanham um utilizador entre sessões, têm o seu lugar na precedência de fusão e a sua flag na API, com a persistência ainda por vir. Os clarificadores são hoje de texto livre; os tipos de escolha e de data já estão desenhados no sistema de tipos. As costuras foram cortadas onde as próximas funcionalidades encaixam, em vez de ficarem aparafusadas por fora.
Construí o OrbitSpec antes de qualquer um dos outros dois sistemas, e arrumei-o na gaveta para os ir construir. Ao regressar-lhe com a trilogia completa, a forma do todo é mais clara do que era vista de dentro de qualquer uma das partes: especificar a pergunta, estruturar a delegação, governar o agente. Três camadas, uma lição em cada, e a mesma conclusão de todas as vezes. As partes de um sistema de IA em que se pode confiar são as que nunca foram inteligentes, e o trabalho delas é tornar as partes inteligentes seguras de usar.
Perguntas a que este artigo responde
Porque é que um produto de IA há de fazer uma pergunta em vez de simplesmente responder?
Porque a falha que está a ser evitada fica a montante do modelo. Um pedido que diz apenas que alguém precisa de ajuda com um problema de saúde não tem boa resposta, e tudo o que um modelo gerar a partir daí é adivinhação cara com tom confiante. Retrieval, reranking, guardrails e evals operam todos do lado da resposta, já depois de a má pergunta ter sido aceite, enquanto fazer um clarificador antes custa microssegundos.
Uma etapa de clarificação não acrescenta latência e irrita o utilizador?
O custo do motor não é o problema: o tempo total de motor ao longo de uma conversa inteira fica bem abaixo de um milissegundo, e o livro-razão de auditoria mostra cada passo em frações de milissegundo. O número de perguntas é limitado pelos dados e não pelo critério de um modelo, por isso um pack com sete campos que marca dois como obrigatórios produz uma conversa de duas perguntas e nunca mais do que o pack impõe. Fazer um clarificador por turno também é deliberado, porque os utilizadores respondem a uma pergunta e abandonam questionários.
O que está afinal dentro de um Context Bundle?
Hoje transporta a intenção, o pedido original, campos tipados, restrições de output e um bloco de trace com trace id, session id, workspace id e generated-at, para que qualquer bundle possa ser reconduzido a cada passo que o produziu. A versão do pack é fixada na criação da sessão e registada no bundle, o que o torna reproduzível: mesmo pack, mesmas respostas, mesmo resultado. Reformulação, pressupostos, incógnitas e critérios de aceitação estão no schema como placeholders vazios, à espera da camada que os preencha.
Devo usar um LLM para extrair campos do que o utilizador já escreveu?
Só atrás de um fallback de regras e de uma verificação de fundamentação. A primeira implementação corria a extração num modelo local através do Ollama em CPU e dava uma média de 138 segundos por pedido de deteção de campos, contra um timeout de 60 segundos, ou seja, o passo que devia poupar uma pergunta ao utilizador demorava dois minutos a não lhe responder. A mudança para um router alojado com um modelo Llama pequeno baixou isso para segundos, e os valores extraídos continuam a passar primeiro pela validação: campos propensos a alucinações precisam de fundamentação lexical nas próprias palavras do utilizador, valores que são sobretudo um eco do input inteiro são rejeitados, e campos de tipo data têm de passar uma verificação de plausibilidade.
Ler a seguir
 AI Agents
Construí o pipeline que construiu o meu produto. Eis o que delegar realmente exige
Notas de campo do plan-to-pr, um pipeline que transforma um pedido de funcionalidade em tickets, num gate de aprovação e em draft pull requests, e a razão pela qual delegar em agentes de código exige artefactos, não conversa. AI Agents
Construí um plano de controlo para agentes de IA. Eis o que a governança exige de facto
Notas de campo sobre a construção do Smithproof, um plano de controlo multi-inquilino para agentes de IA, e porque é que a deteção sem resposta e a política sem aplicação não governam nada.