
He construido una capa de IA que nunca responde. Esto es lo que exige de verdad una buena pregunta
Escuchar el artículo (experimental) · 12:16

Escribe «no me encuentro bien y quiero saber qué hacer» en un servicio que he construido y no te dirá qué hacer. Te pregunta qué síntomas tienes. Después te pregunta cuándo empezaron. Y después deja de preguntar, porque esos son los únicos dos campos que su pack marca como obligatorios, y le entrega a tu aplicación un documento JSON tipado, versionado y auditable llamado Context Bundle. Tiempo total de motor en toda la conversación: bastante menos de un milisegundo. Respuestas dadas: cero.
Esa negativa a responder es el producto entero, y nació de dos ideas que llevaban tiempo rondándome. La primera se la debo a Marc Brooker, que sostiene que una especificación no es algo que se dicta antes del trabajo, sino algo a lo que se llega iterando, y que una buena especificación es, cada vez más, lo que permite que una IA haga el trabajo siquiera (Spec Driven Development isn't Waterfall). Los requisitos no aparecen ya clarificados. Los clarificamos preguntando, es decir, conversando. La segunda se la debo a Rafael Peixoto, que hace un año o dos me convenció de que el futuro de la IA era neurosimbólico, modelos neuronales flexibles envueltos en una estructura simbólica que de verdad se puede comprobar, en una época en que todo el campo apostaba por lo contrario. OrbitSpec es el aspecto que tienen esas dos ideas funcionando como servicio: una conversación breve que convierte una petición vaga en una especificación comprobable, impulsada por un motor determinista que trata al modelo de lenguaje como un invitado, nunca como el anfitrión.
Este es también el tercer informe de campo de una serie que resultó ser un único sistema visto desde tres lados. Smithproof gobierna lo que hacen los agentes. plan-to-pr estructura lo que les delegamos. OrbitSpec, cronológicamente lo primero que construí y lo último que documenté, se sitúa justo al comienzo de la cadena, donde una persona escribe algo vago y empieza a acumularse cada coste posterior. Su chasis partió de la plantilla full-stack de tiangolo, con el crédito para quien lo merece (plantilla full-stack de tiangolo); el motor que va encima es lo que se cuenta aquí.
Qué es
OrbitSpec es clarificación como servicio: una API B2B que se coloca delante de un producto de IA. La aplicación del cliente crea una sesión, envía el borrador del usuario y recibe uno de dos resultados. O bien needs_clarification, con exactamente una pregunta que trasladar al usuario, o bien ready, con el Context Bundle para el modelo que el cliente ejecute después.
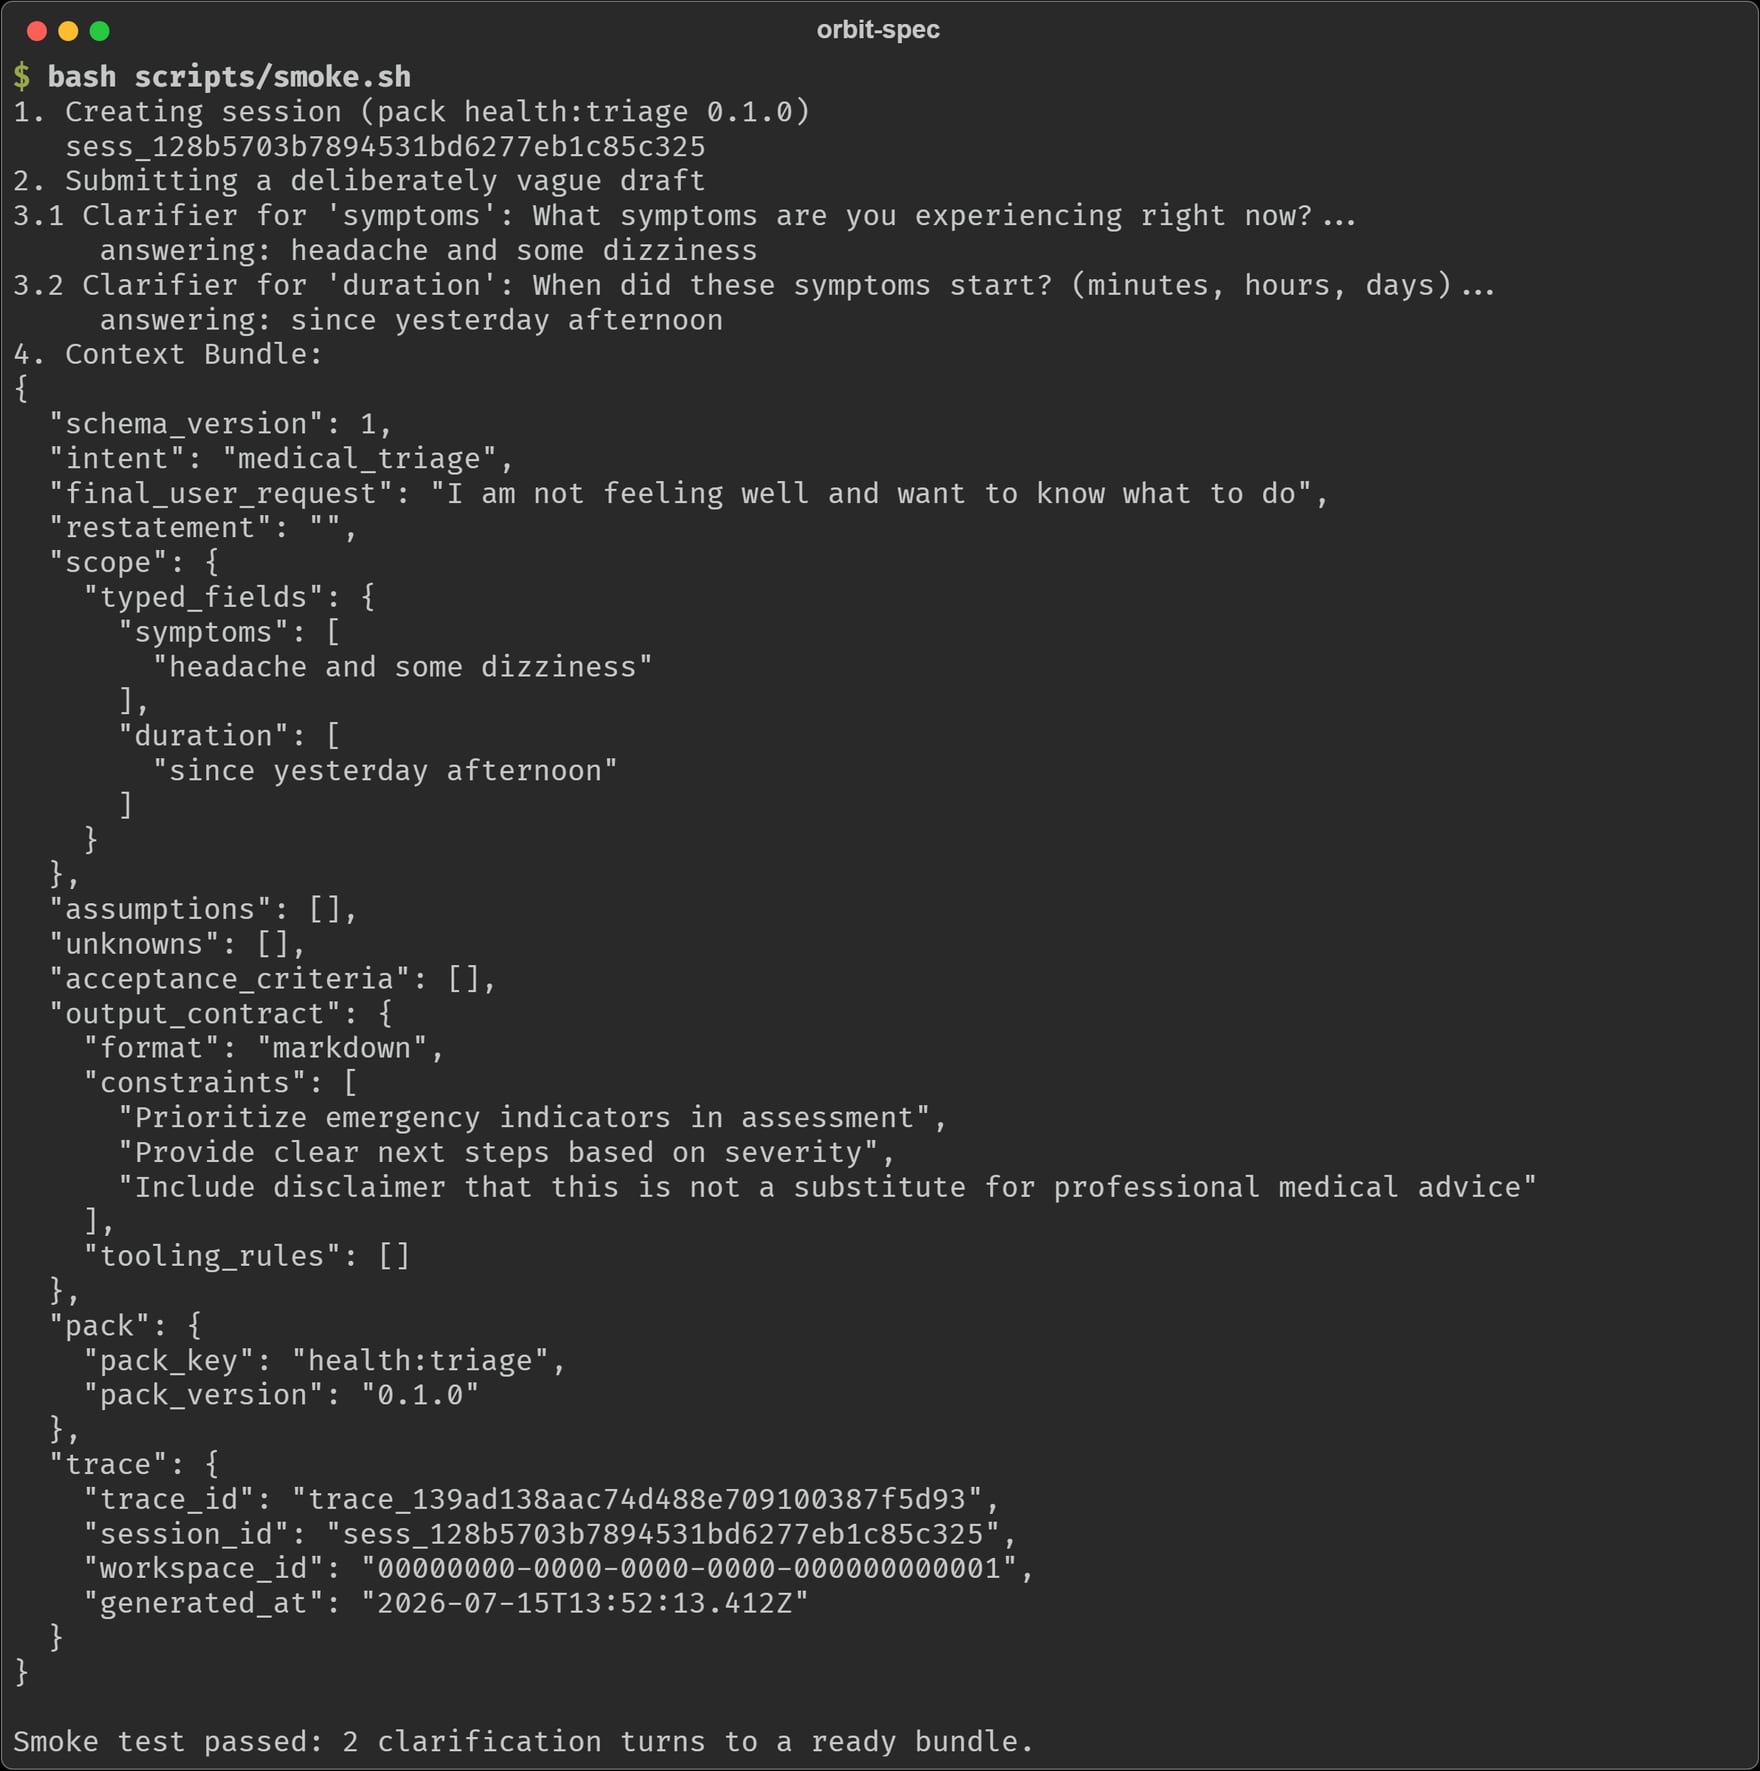 El ciclo completo desde el terminal: un borrador vago, dos preguntas, un bundle. El motor hizo dos preguntas porque el pack exige dos de sus siete campos, y nunca pregunta más de lo que el pack pide.
El comportamiento vive en datos, no en código. Unos Intent Packs versionados en YAML definen los campos que necesita un dominio, cuáles son obligatorios, qué pregunta hacer para cada uno y una prioridad de clarificación. Una sesión fija la versión de su pack al crearse, de modo que una actualización del pack nunca cambia las reglas de una conversación en pleno vuelo, y la versión fijada dentro de cada bundle hace que el bundle sea reproducible: mismo pack, mismas respuestas, misma salida. Hay packs para triaje sanitario, admisión legal, reclamaciones de seguros, investigación y un genérico de reserva.
Tres propiedades cargan con el peso, y las tres son viejas virtudes del software, no novedades de la IA. El bucle es determinista: el motor que fusiona el alcance, valida los campos y elige la siguiente pregunta es código normal con una precedencia documentada. La pregunta es singular: un clarificador por turno, elegido como la pregunta útil más pequeña, porque los usuarios responden una pregunta y abandonan los cuestionarios. Y todo queda auditado: cada paso de cada turno acaba en un registro de eventos append-only con su latencia.
La fiabilidad más barata se gana antes de que el modelo arranque
La industria se esfuerza mucho en que los modelos respondan mejor. Retrieval, reranking, guardrails, evals: todo eso opera en el lado de la respuesta de la transacción. Pero una parte enorme de las malas salidas de la IA no son preguntas mal respondidas; son malas preguntas correctamente respondidas. «Necesito ayuda con un problema de salud» no tiene buena respuesta, y todo lo que un modelo genere a partir de ahí es conjetura cara con tono de seguridad.
La eficacia desproporcionada del diseño de OrbitSpec está en que arreglar esto no cuesta casi nada. Este es el propio libro de auditoría del motor para la sesión de arriba:
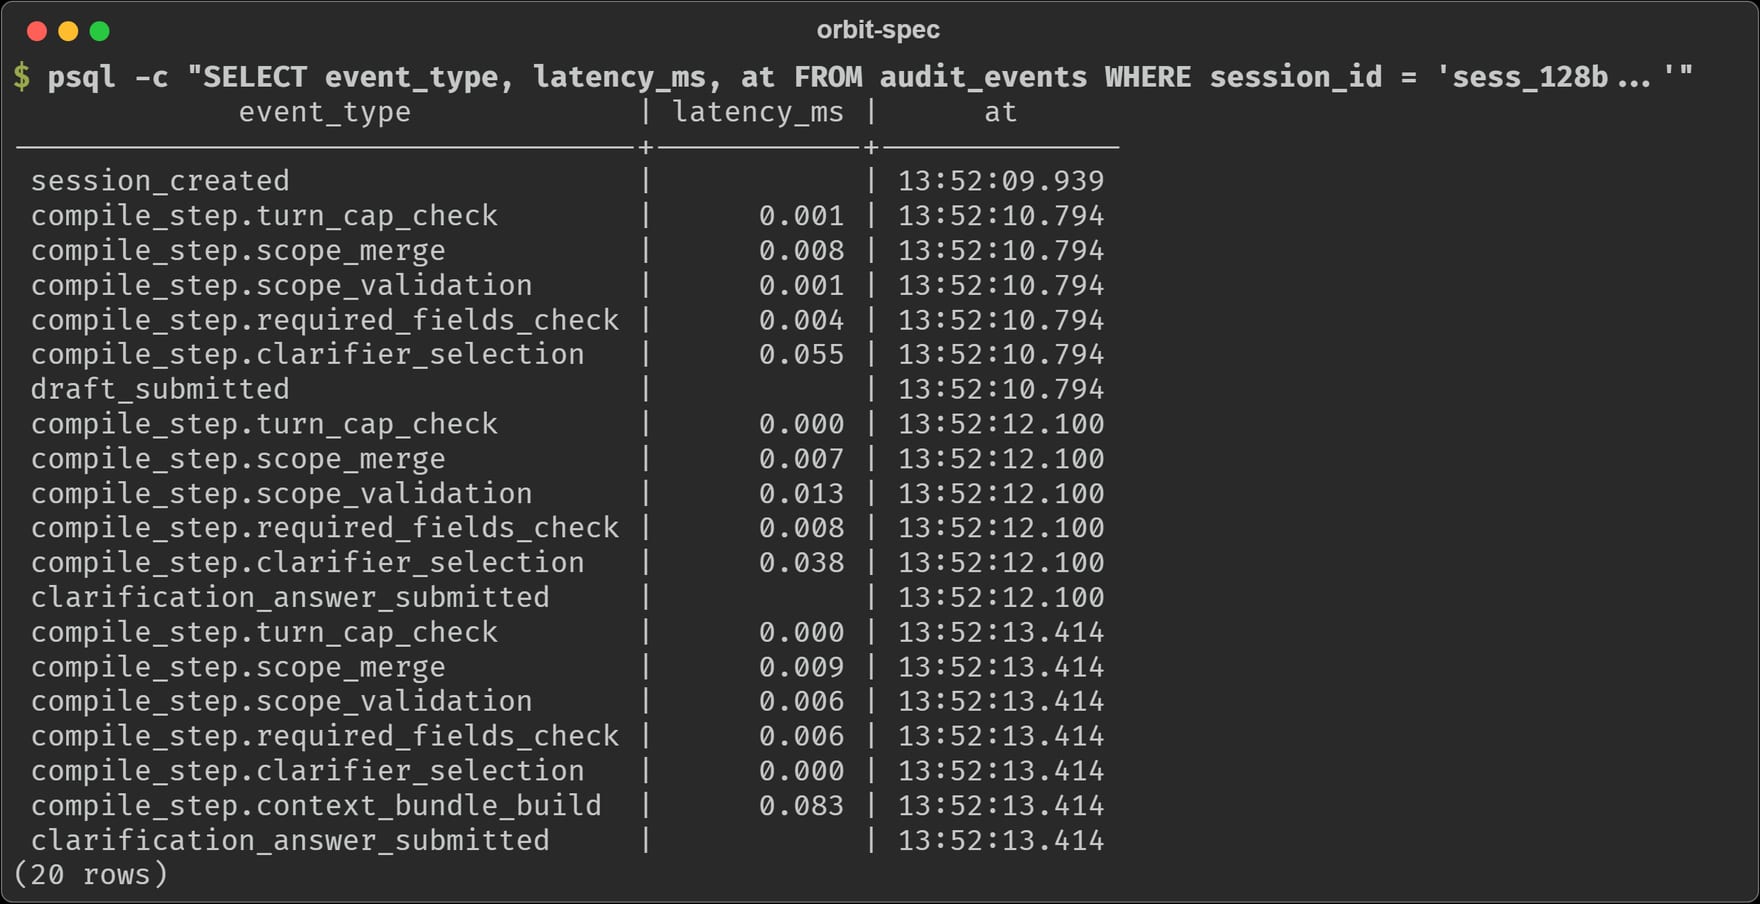 Cada paso de cada turno, con marca de tiempo y latencia. El motor entero gasta microsegundos por turno.
Microsegundos por turno, y cada fila es atribuible: qué paso se ejecutó, cuándo, dentro de qué sesión, bajo qué trace id. Cuando algo falla más adelante, la pregunta que produjo el bundle no es un recuerdo en un historial de chat; es un registro consultable. En el artículo de Smithproof escribí que el gasto que puedes leer es gasto que un plano de control puede limitar. Aquí vale lo mismo: la intención que puedes leer es intención que puedes auditar.
Un nodo en el agente de otro
OrbitSpec no es una aplicación, y la forma más rápida de juzgarlo mal es evaluarlo como si lo fuera. El repositorio incluye cuatro chatbots de demostración construidos con LangGraph, cada uno consumiendo el servicio a través de su SDK de Python generado, y su arquitectura es la clave: OrbitSpec es un nodo en el grafo de agente del cliente. La entrada del usuario fluye hacia el nodo de clarificación; el nodo devuelve o una pregunta, que el chat traslada, o un bundle, que consume el resto del grafo.
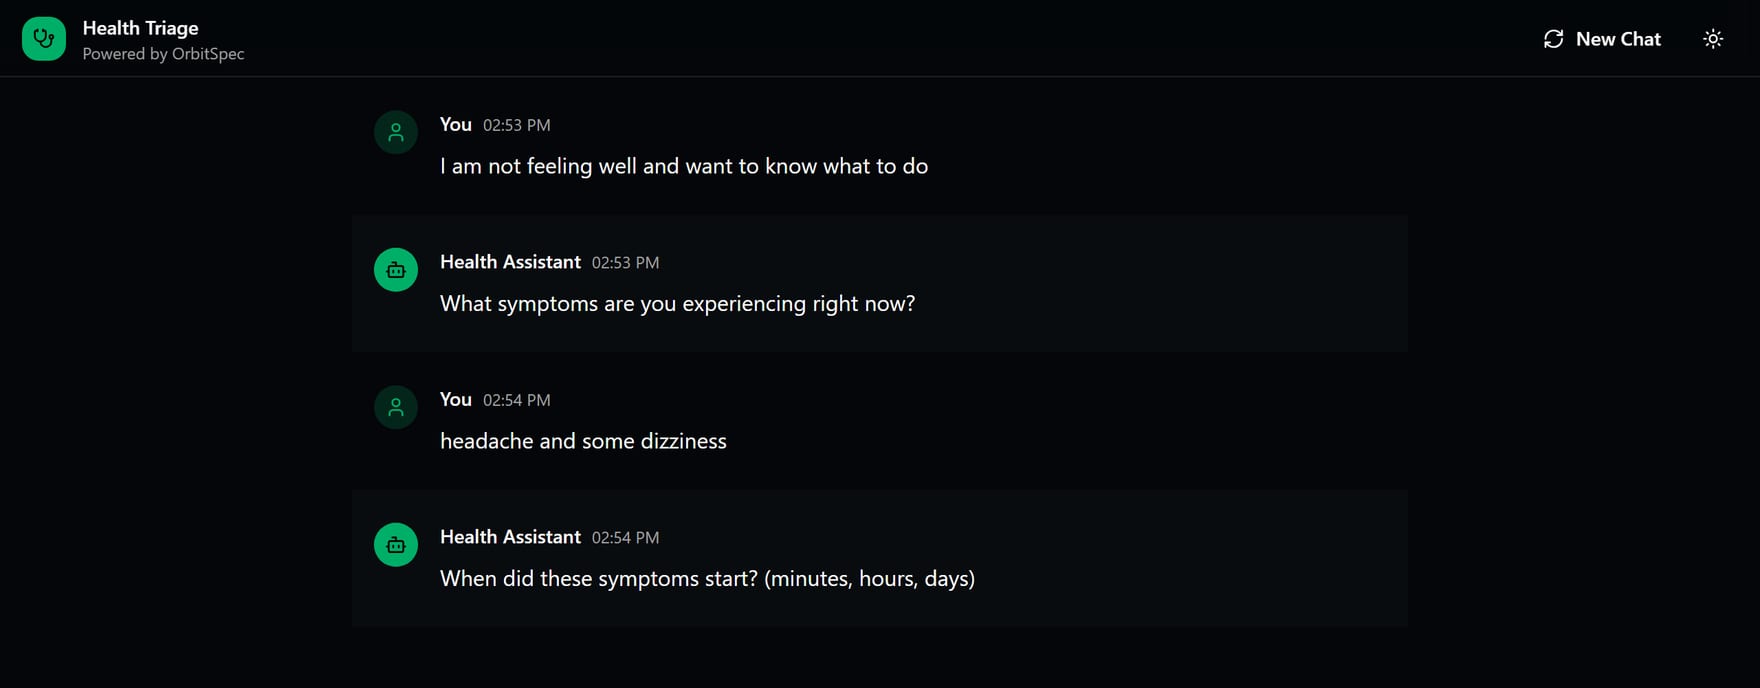 La demo de triaje sanitario. La interfaz de chat es del cliente; las preguntas vienen del pack; el asistente nunca responde, clarifica.
El propio SDK forma parte de la historia de fiabilidad. Se genera a partir de la especificación OpenAPI, y la CI lo regenera con cada cambio del backend y falla si hay desviación, de modo que el cliente que consumen las demos no puede divergir en silencio de la API que las sirve. Los contratos de integración se pudren en las costuras; este se comprueba en cada pull request.
La lección de los 138 segundos
La decisión técnica de fondo de este proyecto trata de dónde debe vivir la inteligencia, y se aprendió por la vía cara.
El diseño obvio usa un LLM para extraer campos del borrador: el usuario dice «tengo dolor de cabeza y algo de mareo desde ayer por la tarde» y el modelo rellena symptoms y duration sin preguntar. La primera implementación ejecutaba esa extracción en un modelo local a través de Ollama sobre CPU, y el repositorio conserva el post-mortem: una media de 138 segundos por petición de detección de campos, frente a un timeout de 60 segundos. La extracción que iba a ahorrarle al usuario una pregunta tardaba dos minutos en no responderla.
El arreglo tuvo tres capas, y el orden importa más que cualquiera de ellas por separado.
Las reglas son el suelo. El bucle de clarificación funciona por completo sin ningún LLM: los campos se rellenan con las respuestas, el motor sigue en territorio de microsegundos y el producto funciona. La inteligencia es una mejora, nunca una dependencia. Esa única decisión es la razón de que un modelo de dos minutos no pudiera hundir el producto consigo.
La inferencia se cambia, no se reescribe. La extracción se movió a un router alojado que ejecuta un modelo Llama pequeño, segundos en lugar de minutos, y el Ollama local quedó disponible tras un compose profile para quien quiera la inferencia en hardware propio. Como la extracción está detrás de una interfaz con reglas de reserva, el proveedor es una elección de configuración.
Nada de lo que diga el modelo entra sin anclaje. Los valores extraídos pasan una capa de validación antes de aceptarse: los campos propensos a alucinaciones deben tener anclaje léxico en las palabras del propio usuario, los valores que son sobre todo un eco de la entrada completa se rechazan como copias, y los campos con pinta de fecha deben superar una comprobación de plausibilidad. Un modelo pequeño que se equivoca rápido solo es útil si el error no puede entrar en el bundle.
El artículo de Smithproof defendía que el modelo que te puedes permitir ejecutar en línea es el modelo que gobierna. Esta es la misma ley vista del otro lado: el modelo al que no te puedes permitir esperar es el modelo que no puede ayudarte, y el motor determinista que apenas notas es el que siempre puede.
Aburrido a propósito
Dos piezas menores merecen su línea, ambas del tipo de ingeniería que nunca luce en una demo. El estado de sesión vive en hashes de Redis protegidos por un bloqueo optimista escrito en Lua: un único script atómico comprueba un campo de versión antes de escribir, devuelve códigos de error distintos para una sesión inexistente y para un conflicto de versión, y refresca el TTL, de modo que dos respuestas concurrentes a la misma sesión no pueden sobrescribirse en silencio. Y el bloque de traza del bundle lleva la cadena de identidad completa, trace id, session id, workspace id, generated-at, de modo que cualquier bundle puede recorrerse hacia atrás hasta cada paso que lo produjo.
Nada de esto es novedoso. Todo esto es lo que marca la diferencia entre una demo de clarificación y un servicio sobre el que otra empresa pueda construir.
En qué punto está
El Context Bundle de hoy lleva la intención, la petición original, campos tipados, restricciones de salida e identidad de traza. Los campos de la hoja de ruta son visibles en el esquema: una reformulación de la petición en palabras del motor, suposiciones, incógnitas y criterios de aceptación se entregan como huecos vacíos, a la espera de la capa que los rellene. Los Scope Profiles, respuestas recordadas que acompañan al usuario entre sesiones, tienen su hueco en la precedencia de fusión y su bandera en la API, con la persistencia por llegar. Los clarificadores hoy son de texto libre; los tipos de elección y fecha ya están dibujados en el sistema de tipos. Las costuras están cortadas donde las próximas funciones encajan, en lugar de atornillarse encima.
Construí OrbitSpec antes que los otros dos sistemas, y lo aparqué para ir a construirlos. Al volver a él con la trilogía completa, la forma del conjunto se ve más clara que desde dentro de cualquiera de las partes: especificar la pregunta, estructurar la delegación, gobernar el agente. Tres capas, una lección cada una, y la misma conclusión todas las veces. Las partes de un sistema de IA en las que puedes confiar son las que nunca fueron inteligentes, y su trabajo es hacer que las partes inteligentes sean seguras de usar.
Preguntas que responde este artículo
¿Por qué un producto de IA hace una pregunta en lugar de responder directamente?
Porque el fallo que se evita está aguas arriba del modelo. Una petición que solo dice que alguien necesita ayuda con un problema de salud no tiene buena respuesta, y todo lo que un modelo genere a partir de ahí es conjetura cara con tono de seguridad. Retrieval, reranking, guardrails y evals operan en el lado de la respuesta, cuando la mala pregunta ya se ha aceptado, mientras que hacer un clarificador antes cuesta microsegundos.
¿Un paso de clarificación no añade latencia y acaba molestando al usuario?
El coste del motor no es el problema: el tiempo total de motor en toda una conversación queda bastante por debajo de un milisegundo, y el libro de auditoría muestra cada paso en fracciones de milisegundo. El número de preguntas lo limitan los datos y no el criterio de un modelo, así que un pack con siete campos que marca dos como obligatorios produce una conversación de dos preguntas y nunca más de lo que el pack pide. Hacer un clarificador por turno también es deliberado, porque los usuarios responden una pregunta y abandonan los cuestionarios.
¿Qué lleva dentro exactamente un Context Bundle?
Hoy lleva la intención, la petición original, campos tipados, restricciones de salida y un bloque de traza con trace id, session id, workspace id y generated-at, de modo que cualquier bundle puede recorrerse hacia atrás hasta cada paso que lo produjo. La versión del pack se fija al crear la sesión y queda registrada en el bundle, lo que lo hace reproducible: mismo pack, mismas respuestas, misma salida. La reformulación, las suposiciones, las incógnitas y los criterios de aceptación están en el esquema como huecos vacíos para la capa que los rellene.
¿Conviene usar un LLM para extraer campos de lo que el usuario ya ha escrito?
Solo detrás de unas reglas de reserva y una comprobación de anclaje. La primera implementación ejecutaba la extracción en un modelo local a través de Ollama sobre CPU y promedió 138 segundos por petición de detección de campos frente a un timeout de 60 segundos, así que el paso que iba a ahorrarle al usuario una pregunta tardaba dos minutos en no responderla. Pasar a un router alojado con un modelo Llama pequeño lo bajó a segundos, y los valores extraídos siguen pasando antes por la validación: los campos propensos a alucinaciones necesitan anclaje léxico en las palabras del propio usuario, los valores que son sobre todo un eco de la entrada completa se rechazan, y los campos con pinta de fecha deben superar una comprobación de plausibilidad.
Leer a continuación
 AI Agents
Construí el pipeline que construyó mi producto. Esto es lo que exige delegar de verdad
Notas de campo sobre plan-to-pr, un pipeline que convierte una petición de funcionalidad en tickets, una puerta de aprobación y pull requests en borrador, y por qué delegar en agentes de código exige artefactos, no chat. AI Agents
Construí un plano de control para agentes de IA. Esto es lo que exige de verdad la gobernanza
Notas de campo sobre la construcción de Smithproof, un plano de control multiinquilino para agentes de IA, y por qué la detección sin respuesta y la política sin aplicación no gobiernan nada.