
Ho costruito un livello AI che non risponde mai. Ecco cosa serve davvero a una buona domanda
Ascolta l'articolo (sperimentale) · 12:01

Scrivi "non mi sento bene e voglio sapere cosa fare" in un servizio che ho costruito, e non ti dirà cosa fare. Ti chiede quali sintomi hai. Poi ti chiede quando sono iniziati. Poi smette di chiedere, perché quelli sono gli unici due campi che il suo pack segna come obbligatori, e consegna alla tua applicazione un documento JSON tipizzato, versionato e verificabile chiamato Context Bundle. Tempo totale di motore sull'intera conversazione: ben sotto il millisecondo. Numero di risposte date: zero.
Quel rifiuto di rispondere è l'intero prodotto, e nasce da due idee che mi frullavano in testa da un po'. La prima la devo a Marc Brooker, secondo cui una specifica non è qualcosa che consegni prima del lavoro: è qualcosa a cui arrivi iterando, e una buona specifica è sempre di più ciò che permette a un'AI di svolgere il lavoro (Spec Driven Development isn't Waterfall). I requisiti non si presentano già chiariti. Li chiariamo chiedendo, ossia conversando. La seconda la devo a Rafael Peixoto, che un anno o due fa mi convinse che il futuro dell'AI sarebbe stato neurosimbolico, modelli neurali flessibili avvolti in una struttura simbolica che puoi davvero verificare, quando tutto il settore scommetteva sul contrario. OrbitSpec è l'aspetto che quelle due idee assumono quando girano come servizio: una breve conversazione che trasforma una richiesta vaga in una specifica verificabile, guidata da un motore deterministico che tratta il modello linguistico come un ospite, mai come il padrone di casa.
Questo è anche il terzo resoconto sul campo di una serie che si è rivelata essere un unico sistema visto da tre lati. Smithproof governa cosa fanno gli agenti. plan-to-pr struttura cosa deleghiamo loro. OrbitSpec, cronologicamente la prima cosa che ho costruito e l'ultima di cui ho scritto, si colloca proprio all'inizio della catena, dove una persona digita qualcosa di vago e comincia ogni costo a valle. Il suo telaio parte dal template full-stack di tiangolo, a cui va riconosciuto il merito; il motore che ci gira sopra è la storia di questo articolo.
Che cos'è
OrbitSpec è chiarimento come servizio: una API B2B che sta davanti a un prodotto AI. L'app del cliente crea una sessione, invia la bozza dell'utente e riceve uno di due esiti. O needs_clarification, con esattamente una domanda da riferire all'utente, o ready, con il Context Bundle per qualunque modello il cliente esegua a valle.
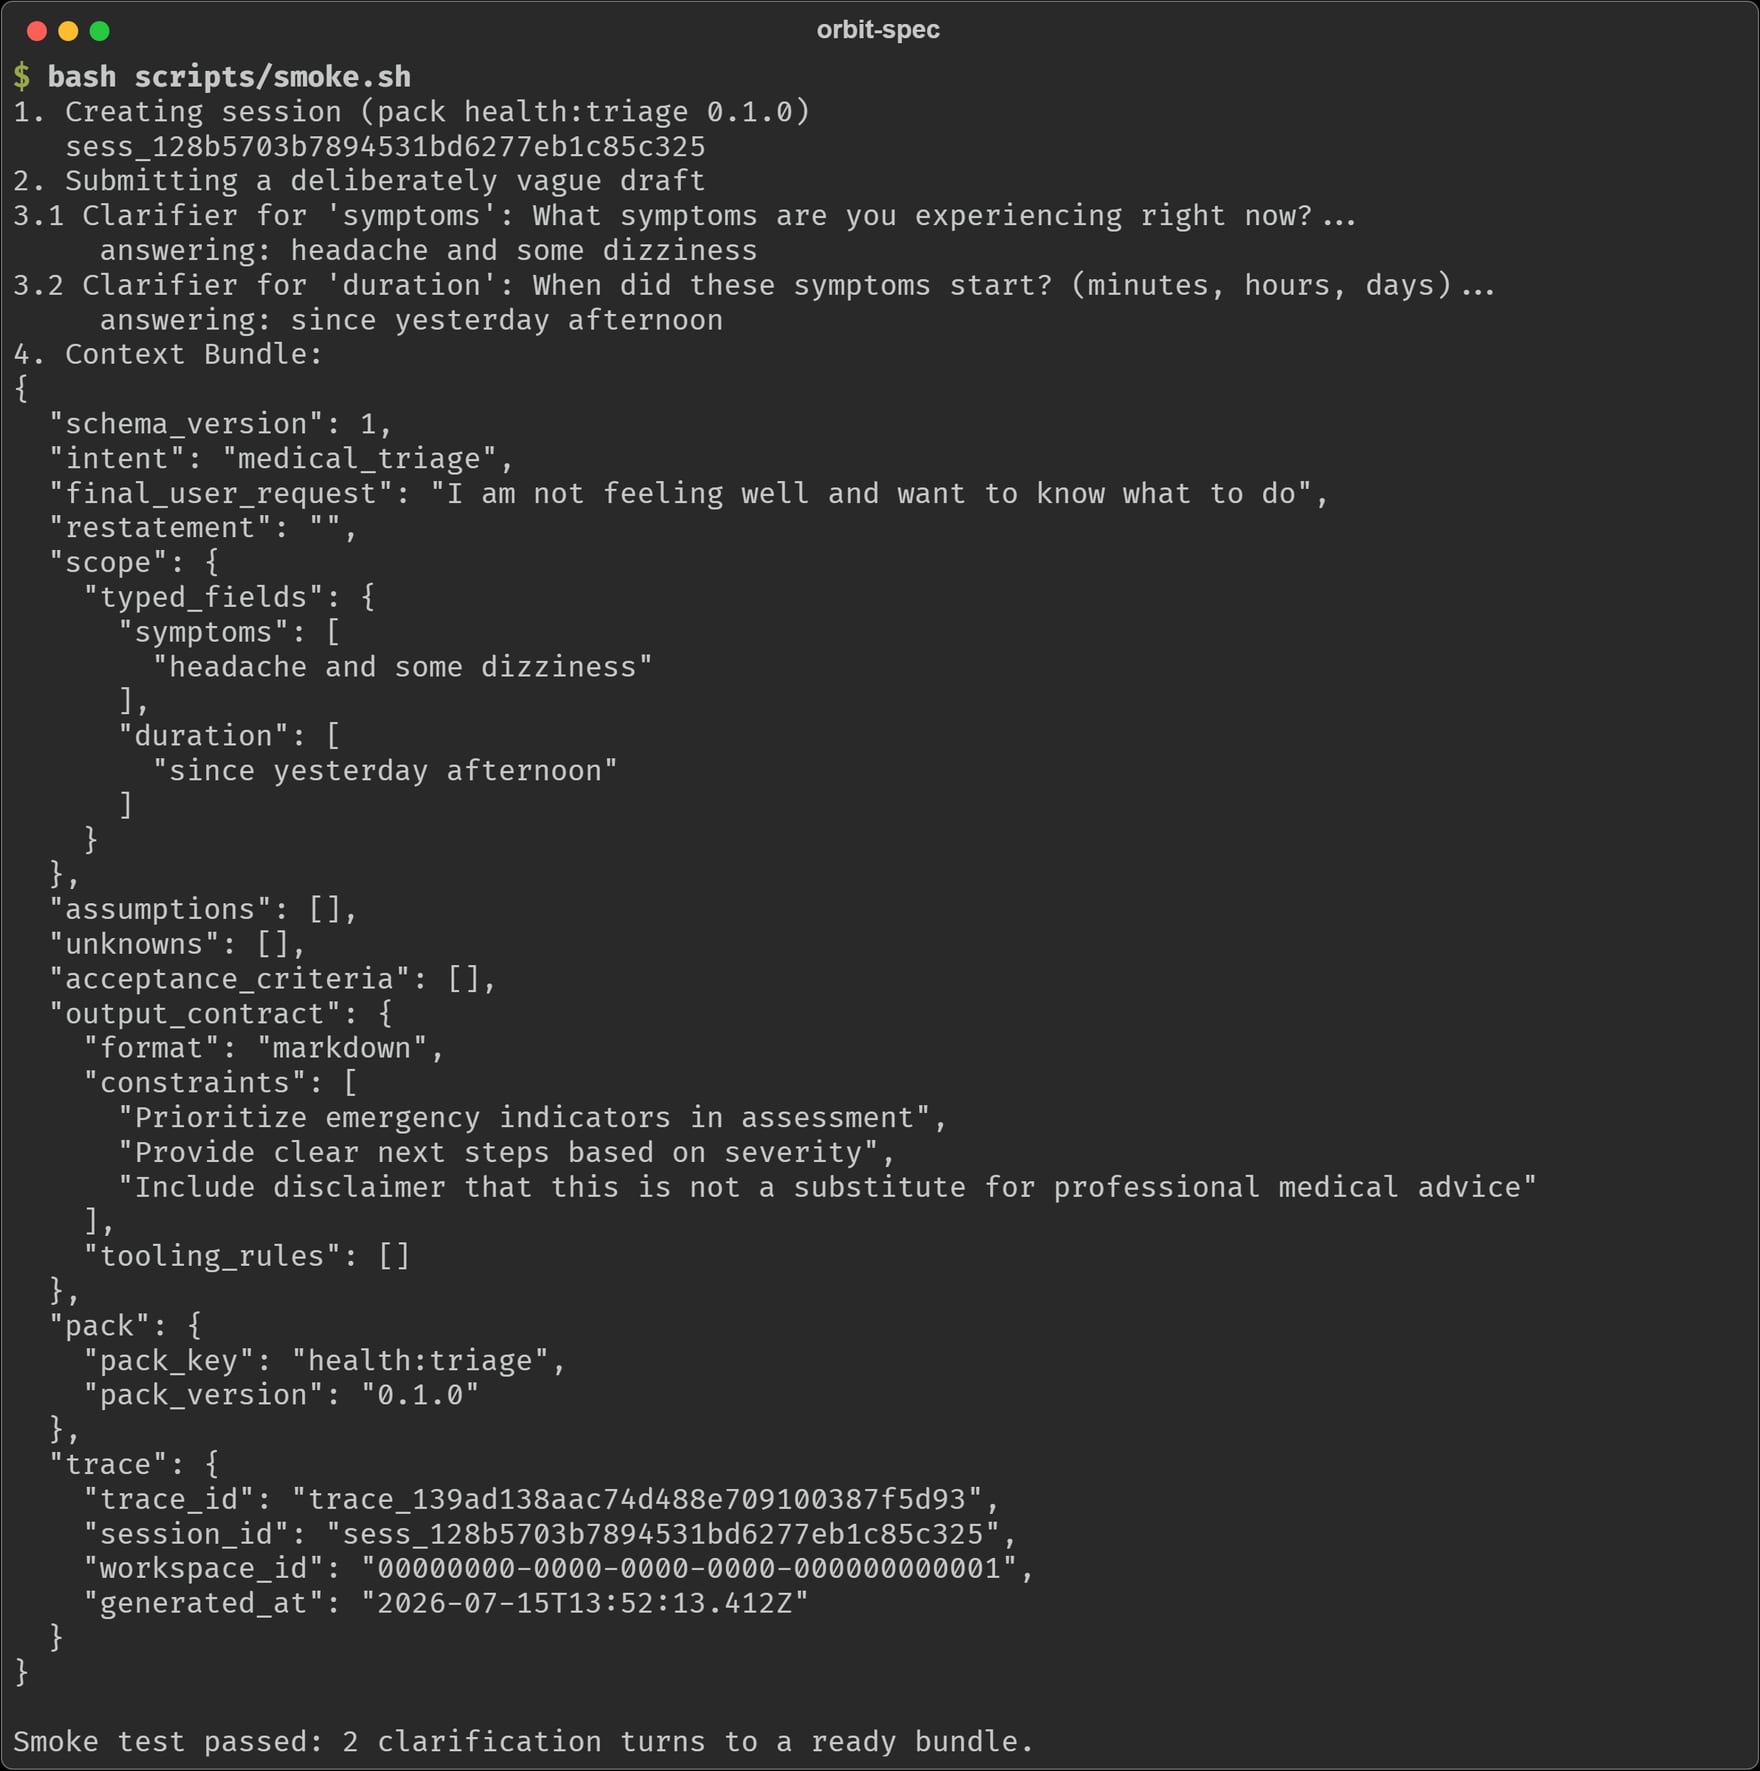 L'intero loop da un terminale: una bozza vaga, due domande, un bundle. Il motore ha fatto due domande perché il pack richiede due dei suoi sette campi, e non chiede mai più di quanto il pack esiga.
Il comportamento vive nei dati, non nel codice. Gli Intent Packs versionati in YAML definiscono i campi di cui un dominio ha bisogno, quali sono obbligatori, quale domanda porre per ciascuno e una priorità di chiarimento. Una sessione fissa la versione del proprio pack alla creazione, così un aggiornamento del pack non cambia mai le regole di una conversazione in corso, e la versione fissata dentro ogni bundle rende il bundle riproducibile: stesso pack, stesse risposte, stesso output. Ci sono pack per il triage sanitario, l'intake legale, i sinistri assicurativi, la ricerca e un fallback generico.
Tre proprietà fanno il grosso del lavoro, e tutte e tre sono vecchie virtù del software, non nuove virtù dell'AI. Il loop è deterministico: il motore che fonde lo scope, valida i campi e sceglie la domanda successiva è codice ordinario con precedenze documentate. La domanda è una sola: una domanda di chiarimento per turno, scelta come la più piccola domanda utile, perché gli utenti rispondono a una domanda e abbandonano i questionari. E tutto è tracciato: ogni passo di ogni turno finisce in un log eventi append-only con la sua latenza.
La vittoria di affidabilità più economica arriva prima che il modello giri
L'industria lavora sodo per far rispondere meglio i modelli. Retrieval, reranking, guardrail, eval: tutto opera sul lato risposta della transazione. Ma una quota consistente dei cattivi output dell'AI non sono domande a cui si è risposto male; sono cattive domande a cui si è risposto correttamente. "Mi serve aiuto con un problema di salute" non ha una buona risposta, e tutto ciò che un modello genera a partire da lì è costosa congettura vestita di un tono sicuro.
L'efficacia irragionevole del design di OrbitSpec sta nel fatto che rimediare costa quasi nulla. Ecco il registro di audit del motore stesso per la sessione qui sopra:
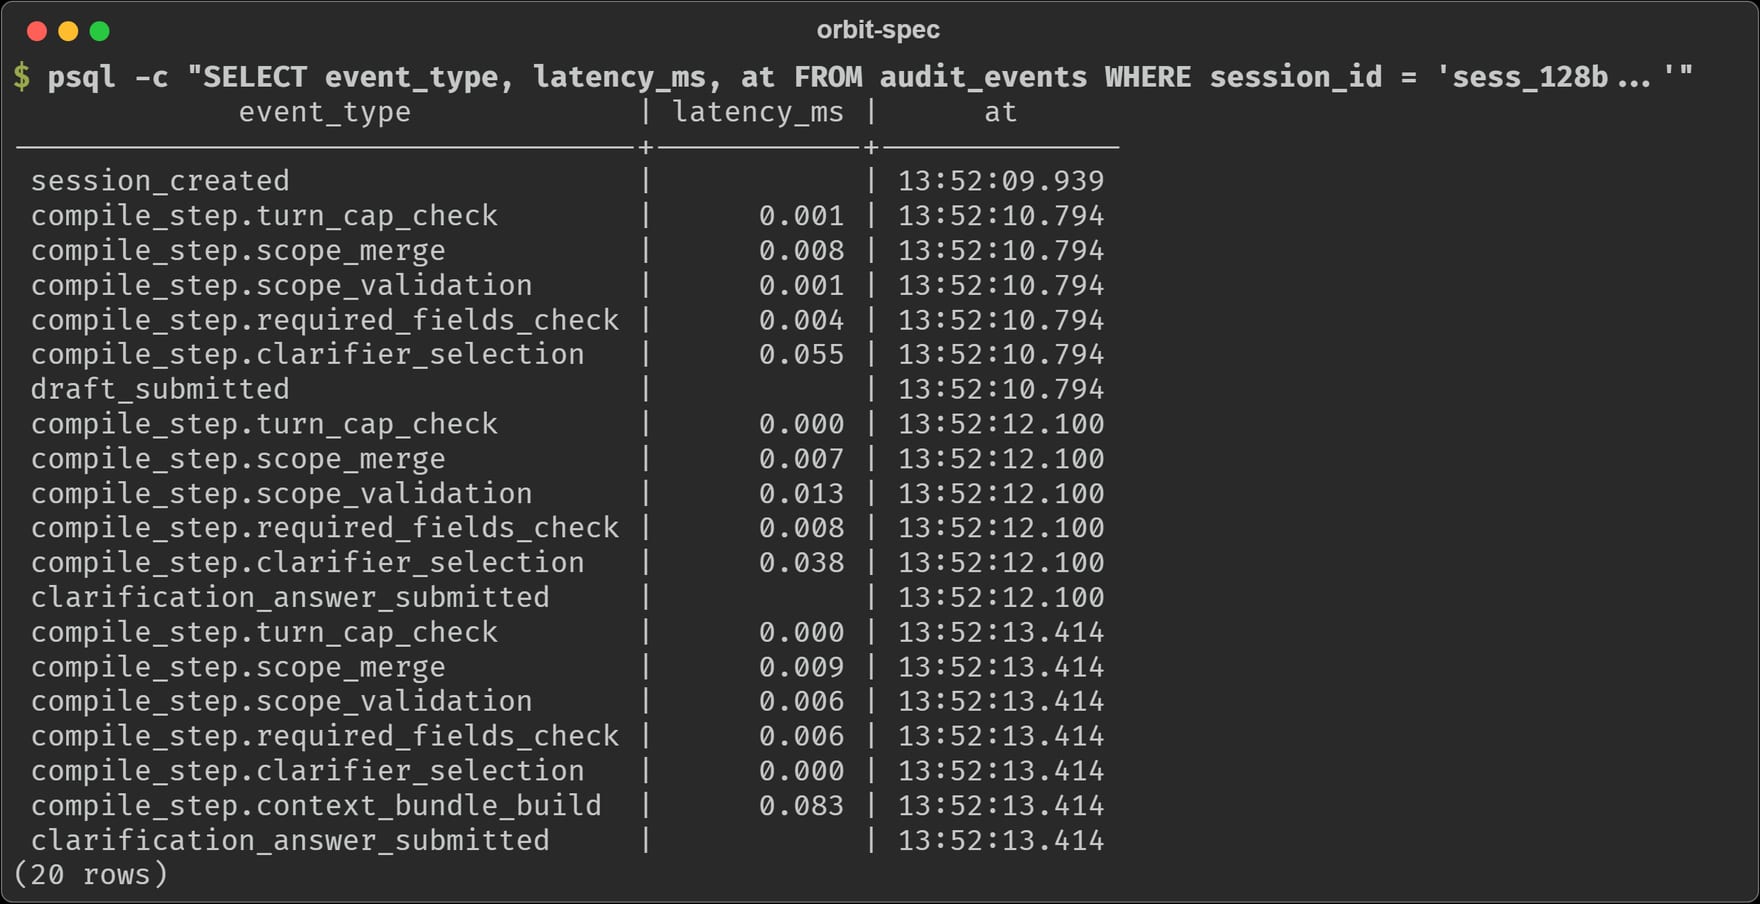 Ogni passo di ogni turno, con marca temporale e latenza. L'intero motore spende microsecondi per turno.
Microsecondi per turno, e ogni riga è attribuibile: quale passo è girato, quando, dentro quale sessione, sotto quale trace id. Quando qualcosa va storto a valle, la domanda che ha prodotto il bundle non è un ricordo in un log di chat; è un record interrogabile. Nel post su smithproof ho scritto che la spesa che puoi leggere è spesa che un control plane può limitare. Qui vale lo stesso: l'intento che puoi leggere è intento che puoi sottoporre ad audit.
Un nodo nell'agente di qualcun altro
OrbitSpec non è un'app, e il modo più rapido per giudicarlo male è valutarlo come se lo fosse. Il repository include quattro chatbot demo costruiti con LangGraph, ognuno dei quali consuma il servizio tramite l'SDK Python generato, e la loro architettura è il punto: OrbitSpec è un nodo nel grafo dell'agente del cliente. L'input dell'utente fluisce nel nodo di chiarimento; il nodo restituisce o una domanda, che la chat riferisce, o un bundle, che il resto del grafo consuma.
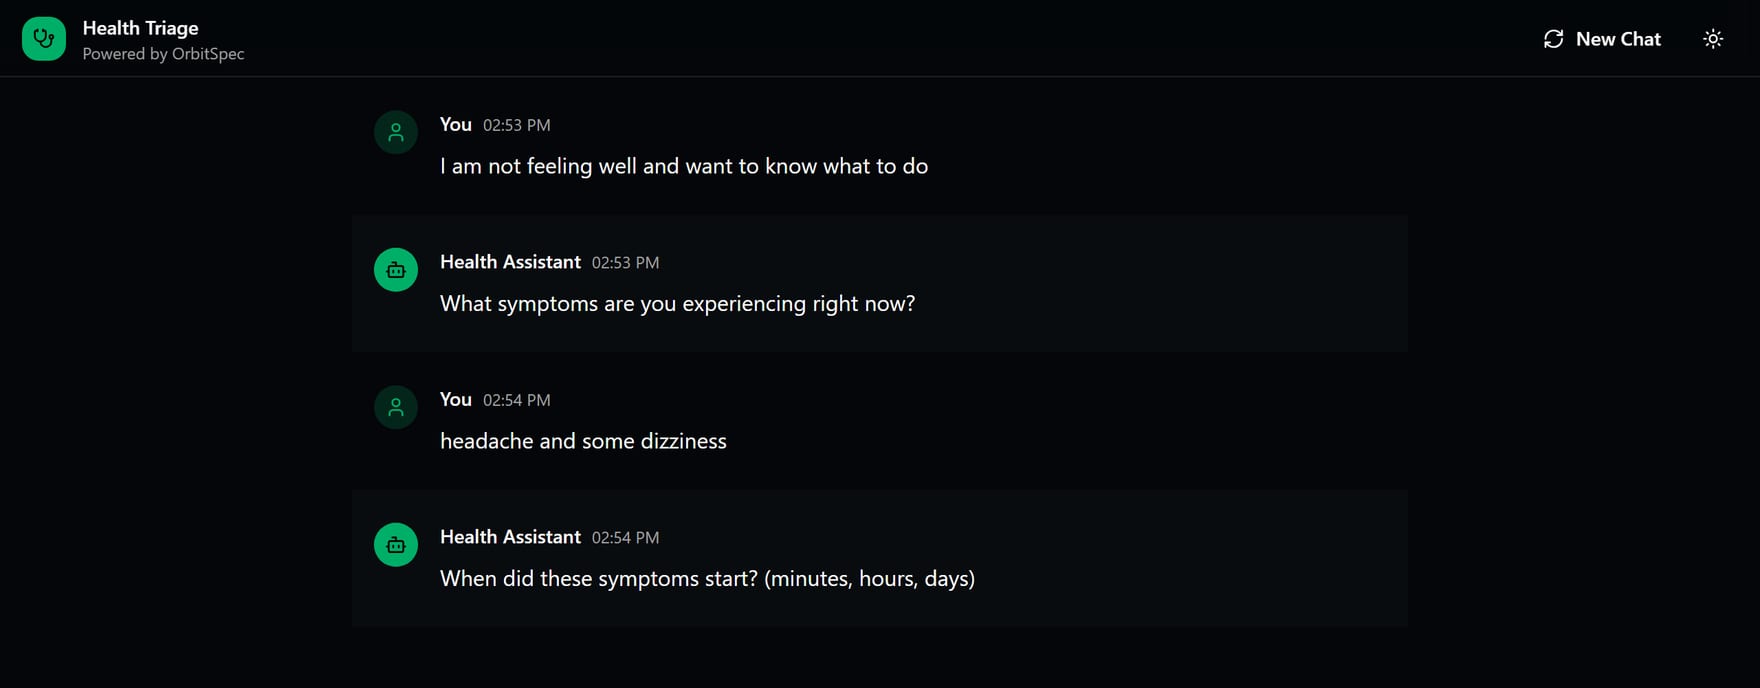 La demo di triage sanitario. L'interfaccia di chat appartiene al cliente; le domande vengono dal pack; l'assistente non risponde mai, chiarisce.
L'SDK stesso fa parte della storia di affidabilità. È generato dalla specifica OpenAPI, e la CI lo rigenera a ogni modifica del backend e fallisce in caso di drift, così il client che le demo consumano non può divergere in silenzio dall'API che le serve. I contratti di integrazione marciscono nelle giunture; questo viene controllato a ogni pull request.
La lezione dei 138 secondi
La decisione tecnica profonda di questo progetto riguarda dove debba stare l'intelligenza, ed è stata imparata nel modo più costoso.
Il design ovvio usa un LLM per estrarre i campi dalla bozza: l'utente dice "ho mal di testa e un po' di capogiri da ieri pomeriggio" e il modello riempie symptoms e duration senza chiedere. La prima implementazione eseguiva quell'estrazione su un modello locale tramite Ollama su CPU, e il repository conserva il post-mortem: una media di 138 secondi per richiesta di rilevamento campi, contro un timeout di 60 secondi. L'estrazione che doveva risparmiare una domanda all'utente ci metteva due minuti a non rispondere.
La correzione aveva tre livelli, e l'ordine conta più di ciascuno di essi preso da solo.
Le regole sono il pavimento. Il loop di chiarimento è pienamente funzionante senza alcun LLM: i campi si riempiono con le risposte, il motore resta in territorio da microsecondi e il prodotto funziona. L'intelligenza è un upgrade, mai una dipendenza. Quella singola decisione è il motivo per cui un modello da due minuti non ha potuto trascinare giù il prodotto con sé.
L'inferenza è una sostituzione, non una riscrittura. L'estrazione è passata a un router in hosting che esegue un piccolo modello Llama, secondi invece di minuti, e Ollama in locale è rimasto disponibile dietro un compose profile per chi vuole l'inferenza sul proprio ferro. Poiché l'estrazione sta dietro un'interfaccia con un fallback a regole, il provider è una scelta di configurazione.
Niente di ciò che dice il modello entra senza grounding. I valori estratti passano un livello di validazione prima di essere accettati: i campi inclini all'allucinazione devono avere un ancoraggio lessicale nelle parole stesse dell'utente, i valori che sono per lo più un'eco dell'intero input vengono respinti come copie, e i campi di tipo data devono superare un controllo di plausibilità. Un modello piccolo che sbaglia in fretta è utile solo se l'errore non può entrare nel bundle.
Il post su smithproof sosteneva che il modello che ti puoi permettere di eseguire inline è il modello che governa. Questa è la stessa legge vista dall'altro lato: il modello che non ti puoi permettere di aspettare è il modello che non può aiutarti, e il motore deterministico che noti a malapena è quello che può sempre farlo.
Noioso di proposito
Due pezzi più piccoli meritano la loro riga, entrambi quel tipo di ingegneria che in demo non rende mai. Lo stato di sessione vive in hash Redis protetti da un lock ottimistico in script Lua: un singolo script atomico controlla un campo di versione prima di scrivere, restituisce codici di errore distinti per una sessione mancante rispetto a un conflitto di versione e rinfresca il TTL, così due risposte concorrenti alla stessa sessione non possono sovrascriversi in silenzio a vicenda. E il blocco trace del bundle porta l'intera catena di identità, trace id, session id, workspace id, generated-at, così ogni bundle può essere ripercorso a ritroso fino a ogni passo che lo ha prodotto.
Niente di tutto questo è inedito. Tutto questo è ciò che fa la differenza tra una demo di chiarimento e un servizio su cui un'altra azienda possa costruire.
A che punto è
Il Context Bundle oggi porta l'intento, la richiesta originale, campi tipizzati, vincoli di output e identità di trace. I campi della roadmap sono visibili nello schema: una riformulazione della richiesta con le parole del motore, assunzioni, incognite e criteri di accettazione arrivano tutti come segnaposto vuoti, in attesa del livello che li riempirà. Gli Scope Profiles, risposte memorizzate che seguono un utente tra le sessioni, hanno il loro posto nella precedenza di merge e il loro flag nell'API, con la persistenza in arrivo. Le domande di chiarimento oggi sono a testo libero; i tipi a scelta e a data sono già disegnati nel sistema di tipi. Le giunture sono tagliate dove le prossime funzionalità si innestano, invece di essere avvitate dopo.
Ho costruito OrbitSpec prima degli altri due sistemi, e l'ho messo da parte per andare a costruirli. Tornandoci con la trilogia completa, la forma dell'insieme è più chiara di quanto fosse dall'interno di una singola parte: specificare la domanda, strutturare la delega, governare l'agente. Tre livelli, una lezione ciascuno, e ogni volta la stessa conclusione. Le parti di un sistema AI di cui ti puoi fidare sono le parti che non sono mai state intelligenti, e il loro compito è rendere le parti intelligenti sicure da usare.
Le domande a cui questo articolo risponde
Perché un prodotto AI fa una domanda invece di rispondere e basta?
Perché il guasto che viene evitato sta a monte del modello. Una richiesta che dice solo che qualcuno ha bisogno di aiuto con un problema di salute non ha una buona risposta, e tutto ciò che un modello genera a partire da lì è costosa congettura vestita di un tono sicuro. Retrieval, reranking, guardrail ed eval operano tutti sul lato risposta, quando la cattiva domanda è già stata accettata, mentre fare prima una domanda di chiarimento costa microsecondi.
Un passaggio di chiarimento non aggiunge solo latenza e infastidisce l'utente?
Il costo del motore non è il problema: il tempo totale di motore sull'intera conversazione resta ben sotto il millisecondo, e il registro di audit mostra ogni passo in frazioni di millisecondo. Il numero di domande è limitato dai dati e non dalla discrezione di un modello, quindi un pack con sette campi che ne segna due come obbligatori produce una conversazione di due domande e mai più di quanto il pack esiga. Anche fare una sola domanda di chiarimento per turno è deliberato, perché gli utenti rispondono a una domanda e abbandonano i questionari.
Cosa c'è davvero dentro un Context Bundle?
Oggi porta l'intento, la richiesta originale, campi tipizzati, vincoli di output e un blocco trace con trace id, session id, workspace id e generated-at, così ogni bundle può essere ripercorso a ritroso fino a ogni passo che lo ha prodotto. La versione del pack viene fissata alla creazione della sessione e registrata nel bundle, il che lo rende riproducibile: stesso pack, stesse risposte, stesso output. Riformulazione, assunzioni, incognite e criteri di accettazione stanno nello schema come segnaposto vuoti, in attesa del livello che li riempirà.
Conviene usare un LLM per estrarre i campi da quello che l'utente ha già scritto?
Solo dietro un fallback a regole e un controllo di ancoraggio. La prima implementazione eseguiva l'estrazione su un modello locale tramite Ollama su CPU con una media di 138 secondi per richiesta di rilevamento campi contro un timeout di 60 secondi, quindi il passo che doveva risparmiare una domanda all'utente ci metteva due minuti a non rispondere. Il passaggio a un router in hosting con un piccolo modello Llama lo ha portato a secondi, e i valori estratti passano comunque prima dalla validazione: i campi inclini all'allucinazione hanno bisogno di un ancoraggio lessicale nelle parole stesse dell'utente, i valori che sono per lo più un'eco dell'intero input vengono respinti, e i campi di tipo data devono superare un controllo di plausibilità.
Da leggere dopo
 AI Agents
Ho costruito la pipeline che ha costruito il mio prodotto. Ecco cosa serve davvero per delegare
Appunti dal campo su plan-to-pr, una pipeline che trasforma una richiesta di funzionalità in ticket, un gate di approvazione e pull request in bozza, e perché delegare agli agenti di coding richiede artefatti, non chat. AI Agents
Ho costruito un control plane per agenti AI. Ecco cosa serve davvero per governarli
Appunti sul campo dalla costruzione di Smithproof, un control plane multi-tenant per agenti AI, e perché il rilevamento senza risposta e le policy senza applicazione non governano nulla.