
Ich habe eine KI-Schicht gebaut, die nie antwortet. Was eine gute Frage wirklich braucht
Artikel anhören (experimentell) · 14:01

Wer in einen Dienst, den ich gebaut habe, „Mir geht es nicht gut und ich will wissen, was ich tun soll" eintippt, erfährt nicht, was zu tun ist. Der Dienst fragt, welche Symptome vorliegen. Dann fragt er, wann sie angefangen haben. Dann hört er auf zu fragen, weil das die einzigen beiden Felder sind, die sein Pack als erforderlich markiert, und übergibt der Anwendung ein typisiertes, versioniertes, auditierbares JSON-Dokument namens Context Bundle. Gesamte Engine-Zeit für das ganze Gespräch: deutlich unter einer Millisekunde. Zahl der gegebenen Antworten: null.
Diese Weigerung zu antworten ist das ganze Produkt, und sie entstand aus zwei Ideen, die mich schon länger beschäftigt hatten. Die erste verdanke ich Marc Brooker, der argumentiert, dass eine Spezifikation nichts ist, was man vor der Arbeit von oben herab vorgibt; man gelangt durch Iteration zu ihr, und eine gute Spezifikation ist zunehmend das, was eine KI die Arbeit überhaupt erst erledigen lässt (Spec Driven Development isn't Waterfall). Anforderungen kommen nicht fertig geklärt daher. Wir klären sie, indem wir fragen, das heißt, indem wir ein Gespräch führen. Die zweite verdanke ich Rafael Peixoto, der mich vor ein, zwei Jahren davon überzeugte, dass die Zukunft der KI neurosymbolisch sein würde: flexible neuronale Modelle, eingebettet in eine symbolische Struktur, die sich tatsächlich überprüfen lässt, und das zu einer Zeit, als das ganze Feld auf das Gegenteil setzte. OrbitSpec ist, wie diese beiden Ideen als Dienst aussehen: ein kurzes Gespräch, das aus einer vagen Anfrage eine überprüfbare Spezifikation macht, angetrieben von einer deterministischen Engine, die das Sprachmodell als Gast behandelt, niemals als Gastgeber.
Dies ist außerdem der dritte Erfahrungsbericht in einer Reihe, die sich als ein einziges System herausstellte, betrachtet von drei Seiten. Smithproof regelt, was Agenten tun. plan-to-pr strukturiert, was wir an sie delegieren. OrbitSpec, chronologisch das Erste, das ich gebaut habe, und das Letzte, das beschrieben wurde, steht ganz am Anfang der Kette, dort, wo ein Mensch etwas Vages eintippt und alle nachgelagerten Kosten ihren Anfang nehmen. Das Chassis ging von tiangolos Full-Stack-Template aus, dem die Anerkennung gebührt; die Engine darüber ist die eigentliche Geschichte hier.
Was es ist
OrbitSpec ist Klärung als Dienstleistung: eine B2B-API, die vor einem KI-Produkt sitzt. Die App des Kunden erstellt eine Session, reicht den Entwurf des Nutzers ein und bekommt eines von zwei Ergebnissen zurück. Entweder needs_clarification, mit genau einer Frage, die an den Nutzer weiterzureichen ist, oder ready, mit dem Context Bundle für das Modell, das der Kunde nachgelagert betreibt.
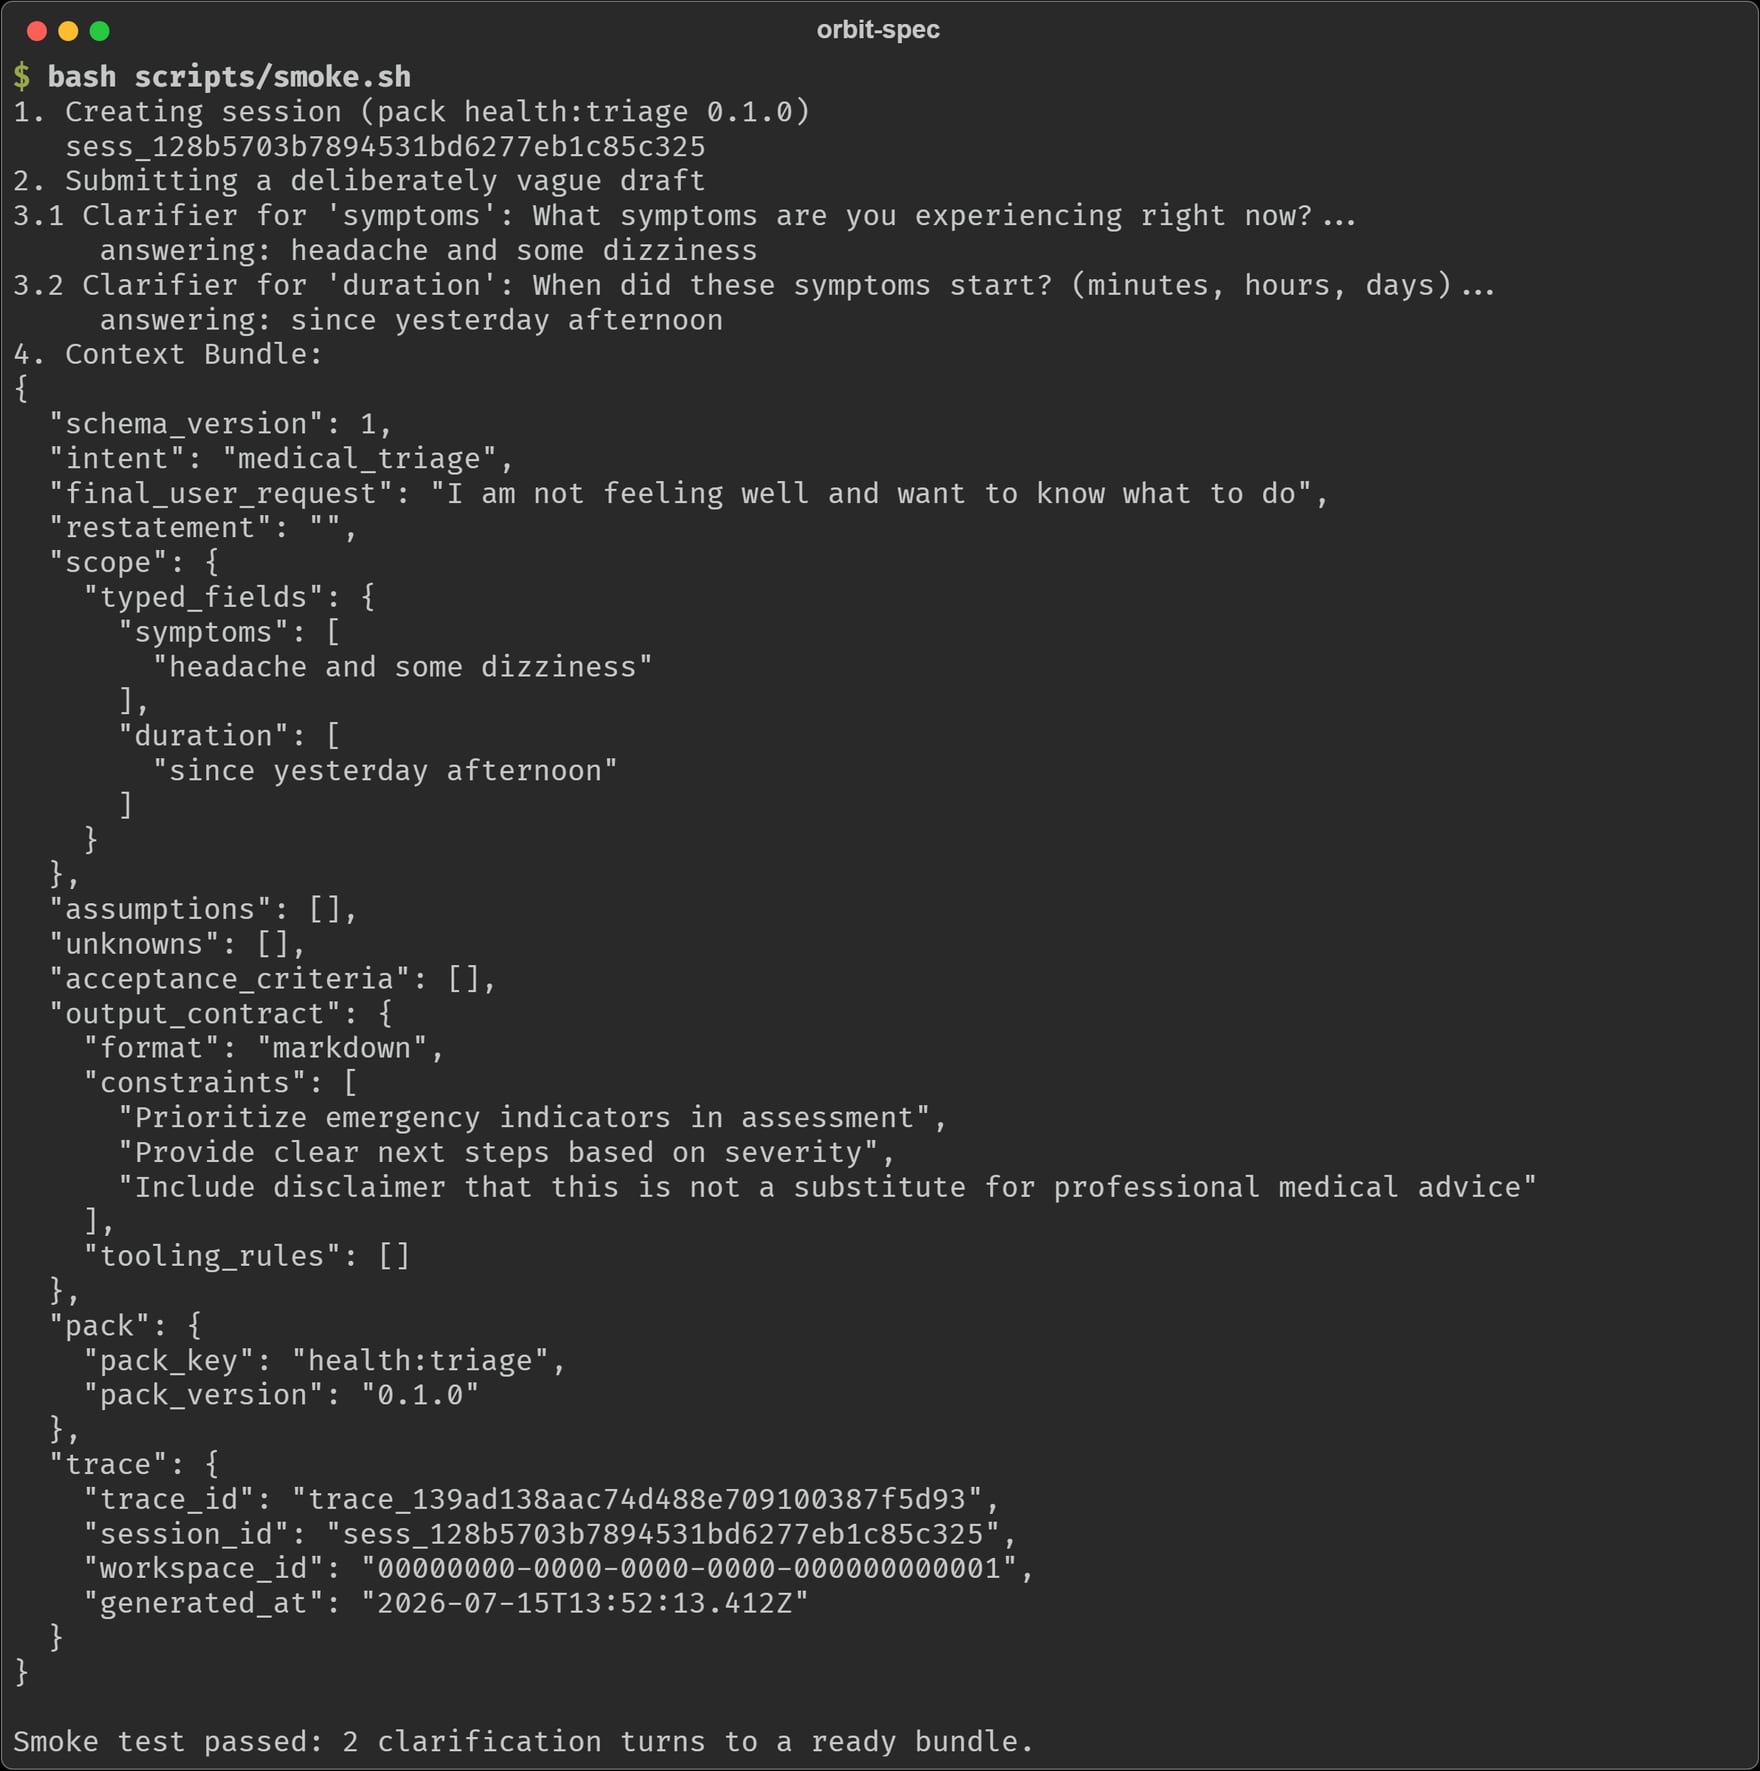 Die ganze Schleife aus einem Terminal: ein vager Entwurf, zwei Fragen, ein Bundle. Die Engine hat zwei Fragen gestellt, weil das Pack zwei seiner sieben Felder verlangt, und sie fragt nie mehr ab, als das Pack fordert.
Das Verhalten lebt in Daten, nicht in Code. Versionierte Intent Packs in YAML definieren, welche Felder eine Domäne braucht, welche davon erforderlich sind, welche Frage zu jedem Feld gehört und in welcher Priorität geklärt wird. Eine Session pinnt ihre Pack-Version bei der Erstellung fest, ein Pack-Upgrade ändert also nie mitten im Gespräch die Regeln, und die festgepinnte Version in jedem Bundle macht das Bundle reproduzierbar: gleiches Pack, gleiche Antworten, gleiche Ausgabe. Es gibt Packs für Gesundheits-Triage, juristische Erstaufnahme, Versicherungsfälle, Recherche und einen generischen Fallback.
Drei Eigenschaften tragen die Hauptlast, und alle drei sind alte Software-Tugenden, keine neuen KI-Tugenden. Die Schleife ist deterministisch: Die Engine, die Scope zusammenführt, Felder validiert und die nächste Frage auswählt, ist gewöhnlicher Code mit dokumentierter Präzedenz. Die Frage ist singulär: eine Klärungsfrage pro Runde, gewählt als die kleinste nützliche Frage, denn Nutzer beantworten eine Frage und brechen Fragebögen ab. Und alles wird auditiert: Jeder Schritt jeder Runde landet mit seiner Latenz in einem Append-only-Ereignisprotokoll.
Der billigste Zuverlässigkeitsgewinn passiert, bevor das Modell läuft
Die Branche arbeitet hart daran, dass Modelle besser antworten. Retrieval, Reranking, Guardrails, Evals: All das setzt auf der Antwortseite der Transaktion an. Aber ein großer Teil schlechter KI-Ausgaben sind keine schlecht beantworteten Fragen; es sind korrekt beantwortete schlechte Fragen. „Ich brauche Hilfe bei einem Gesundheitsproblem" hat keine gute Antwort, und alles, was ein Modell daraus erzeugt, ist teure Raterei im Ton der Gewissheit.
Die unverschämte Wirksamkeit von OrbitSpecs Design liegt darin, dass die Behebung fast nichts kostet. Hier das eigene Audit-Ledger der Engine für die obige Session:
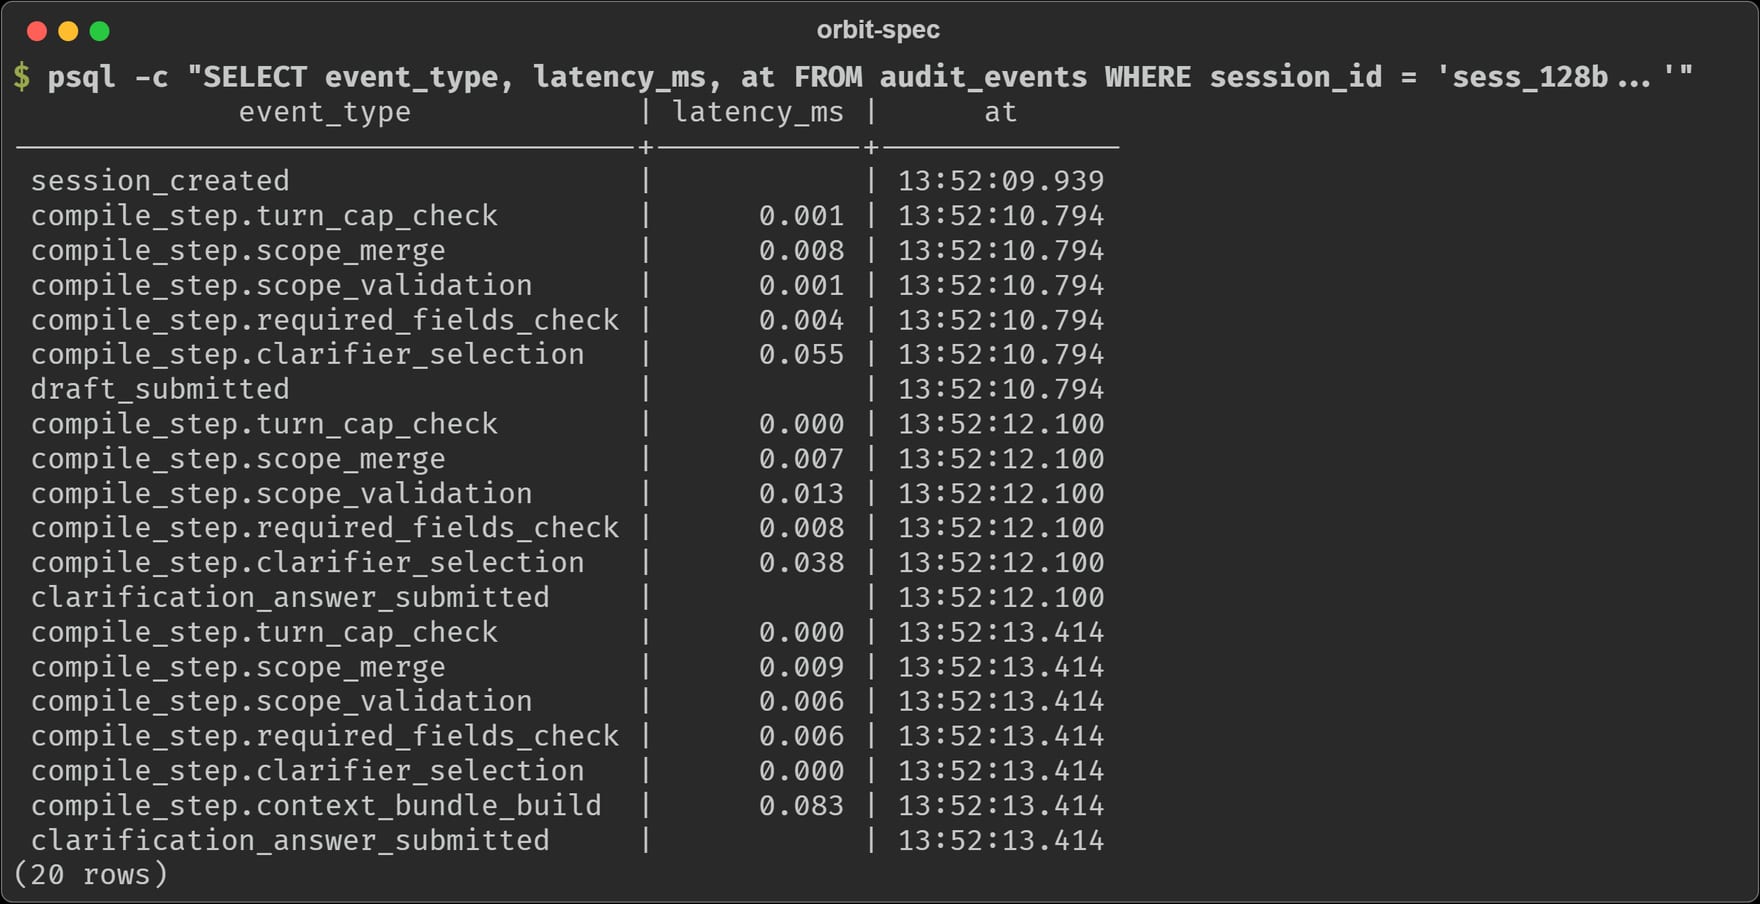 Jeder Schritt jeder Runde, mit Zeitstempel und Latenz. Die gesamte Engine verbraucht Mikrosekunden pro Runde.
Mikrosekunden pro Runde, und jede Zeile ist zuordenbar: welcher Schritt lief, wann, in welcher Session, unter welcher trace id. Wenn nachgelagert etwas schiefgeht, ist die Frage, die das Bundle erzeugt hat, keine Erinnerung in einem Chat-Verlauf, sondern ein abfragbarer Datensatz. Im Smithproof-Beitrag habe ich geschrieben: Ausgaben, die man lesen kann, sind Ausgaben, die eine Control Plane deckeln kann. Dasselbe gilt hier: Intent, den man lesen kann, ist Intent, den man auditieren kann.
Ein Knoten im Agenten eines anderen
OrbitSpec ist keine App, und der schnellste Weg, es falsch einzuschätzen, ist, es wie eine zu bewerten. Das Repository liefert vier Demo-Chatbots mit, gebaut mit LangGraph, jeder konsumiert den Dienst über das generierte Python-SDK, und ihre Architektur ist der Punkt: OrbitSpec ist ein Knoten im Agenten-Graphen des Kunden. Nutzereingaben fließen in den Klärungsknoten; der Knoten gibt entweder eine Frage zurück, die der Chat weiterreicht, oder ein Bundle, das der Rest des Graphen konsumiert.
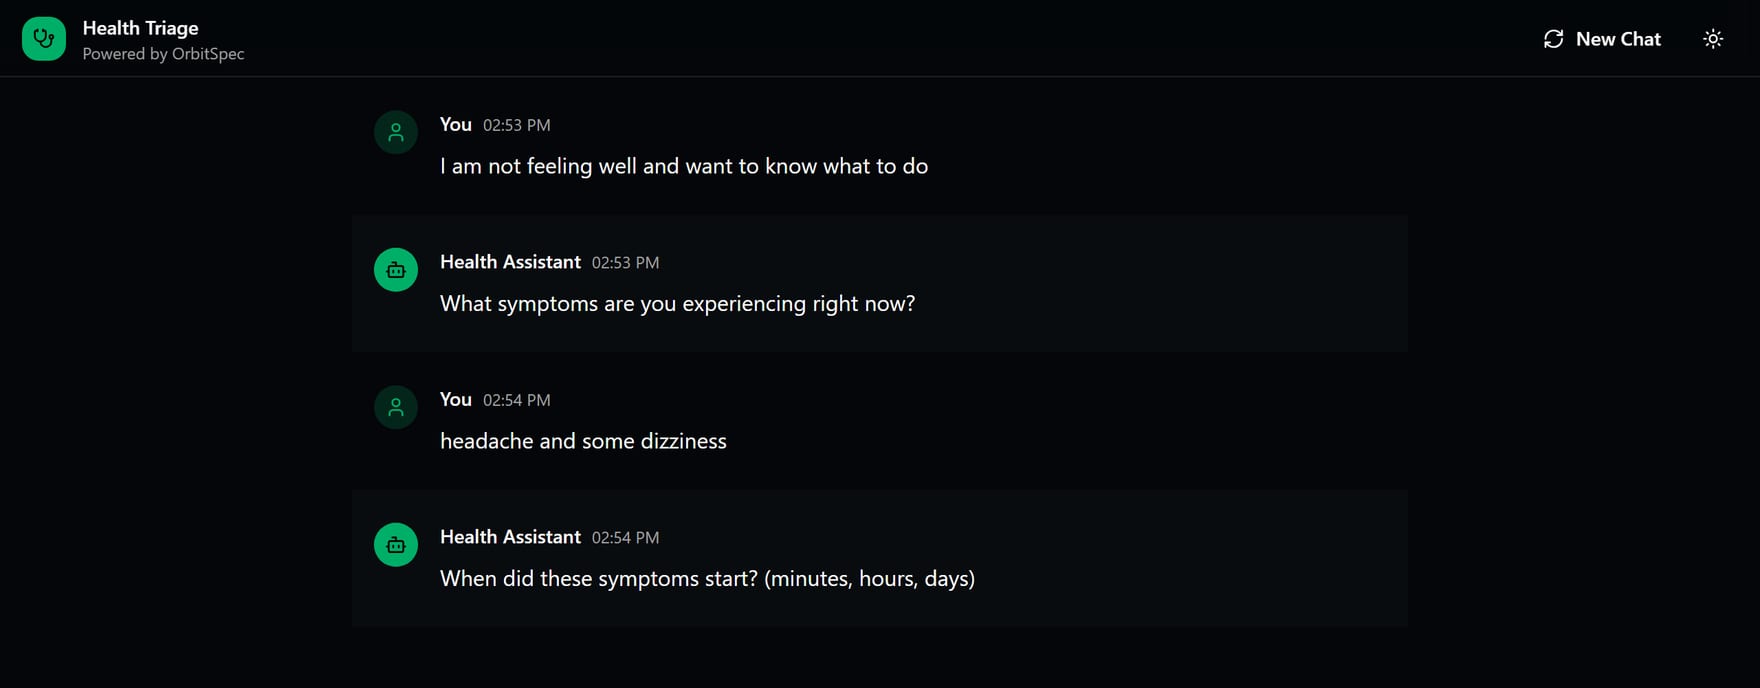 Die Gesundheits-Triage-Demo. Die Chat-Oberfläche gehört dem Kunden; die Fragen kommen aus dem Pack; der Assistent antwortet nie, er klärt.
Das SDK selbst ist Teil der Zuverlässigkeitsgeschichte. Es wird aus der OpenAPI-Spezifikation generiert, und die CI generiert es bei jeder Backend-Änderung neu und schlägt bei Drift fehl; der Client, den die Demos konsumieren, kann also nicht stillschweigend von der API abweichen, die ihn bedient. Integrationsverträge verrotten in den Nahtstellen; dieser hier wird bei jedem Pull Request geprüft.
Die 138-Sekunden-Lektion
Die tiefe technische Entscheidung in diesem Projekt betrifft die Frage, wohin Intelligenz gehört, und sie wurde auf die teure Art gelernt.
Das naheliegende Design nutzt ein LLM, um Felder aus dem Entwurf zu extrahieren: Der Nutzer sagt „Ich habe seit gestern Nachmittag Kopfschmerzen und etwas Schwindel", und das Modell füllt symptoms und duration, ohne zu fragen. Die erste Implementierung ließ diese Extraktion auf einem lokalen Modell über Ollama auf der CPU laufen, und das Repository bewahrt das Post-mortem auf: im Schnitt 138 Sekunden pro Felderkennungs-Anfrage, bei einem Timeout von 60 Sekunden. Die Extraktion, die dem Nutzer eine Frage ersparen sollte, brauchte zwei Minuten, um sie nicht zu beantworten.
Die Lösung hatte drei Schichten, und die Reihenfolge zählt mehr als jede einzelne davon.
Regeln sind der Boden. Die Klärungsschleife ist ganz ohne LLM voll funktionsfähig: Felder füllen sich über Antworten, die Engine bleibt im Mikrosekundenbereich, und das Produkt funktioniert. Intelligenz ist ein Upgrade, nie eine Abhängigkeit. Diese eine Entscheidung ist der Grund, warum ein Zwei-Minuten-Modell das Produkt nicht mit sich reißen konnte.
Inferenz ist ein Austausch, kein Umbau. Die Extraktion wanderte zu einem gehosteten Router mit einem kleinen Llama-Modell, Sekunden statt Minuten, und das lokale Ollama blieb hinter einem compose profile verfügbar, für alle, die Inferenz auf eigener Hardware wollen. Weil die Extraktion hinter einer Schnittstelle mit Regel-Fallback sitzt, ist der Anbieter eine Konfigurationsentscheidung.
Nichts, was das Modell sagt, kommt ohne Verankerung hinein. Extrahierte Werte durchlaufen eine Validierungsschicht, bevor sie akzeptiert werden: Halluzinationsanfällige Felder brauchen eine lexikalische Verankerung in den eigenen Worten des Nutzers, Werte, die im Wesentlichen ein Echo der gesamten Eingabe sind, werden als Kopien verworfen, und datumsartige Felder müssen eine Plausibilitätsprüfung bestehen. Ein kleines Modell, das schnell falsch liegt, ist nur dann nützlich, wenn das Falsche nicht ins Bundle gelangen kann.
Der Smithproof-Beitrag argumentierte, dass das Modell, das man sich inline leisten kann, das Modell ist, das regiert. Hier gilt dasselbe Gesetz von der anderen Seite: Das Modell, auf das zu warten man sich nicht leisten kann, ist das Modell, das einem nicht helfen kann, und die deterministische Engine, die man kaum wahrnimmt, ist die, die es immer kann.
Absichtlich langweilig
Zwei kleinere Bausteine verdienen ihre Zeile, beide von der Sorte Engineering, die in Demos nie gut aussieht. Der Session-Zustand lebt in Redis-Hashes, geschützt durch ein optimistisches Lock per Lua-Skript: Ein einzelnes atomares Skript prüft vor dem Schreiben ein Versionsfeld, gibt unterschiedliche Fehlercodes für eine fehlende Session und einen Versionskonflikt zurück und erneuert die TTL, sodass zwei gleichzeitige Antworten auf dieselbe Session einander nicht stillschweigend überschreiben können. Und der Trace-Block des Bundles trägt die vollständige Identitätskette, trace id, session id, workspace id, generated-at, sodass sich jedes Bundle bis zu jedem Schritt zurückverfolgen lässt, der es erzeugt hat.
Nichts davon ist neu. Alles davon macht den Unterschied zwischen einer Klärungs-Demo und einem Dienst, auf dem ein anderes Unternehmen aufbauen könnte.
Wo es steht
Das Context Bundle trägt heute Intent, die ursprüngliche Anfrage, typisierte Felder, Ausgabe-Constraints und Trace-Identität. Die Roadmap-Felder sind im Schema sichtbar: Eine Neuformulierung der Anfrage in den Worten der Engine, Annahmen, Unbekannte und Akzeptanzkriterien werden alle als leere Platzhalter ausgeliefert und warten auf die Schicht, die sie füllt. Scope Profiles, gemerkte Antworten, die einem Nutzer über Sessions hinweg folgen, haben ihren Platz in der Merge-Präzedenz und ihr Flag in der API; die Persistenz kommt noch. Klärungsfragen sind heute Freitext; Auswahl- und Datumstypen sind im Typsystem bereits angelegt. Die Nähte sind dort geschnitten, wo sich die nächsten Features einfügen, statt angeschraubt zu werden.
Ich habe OrbitSpec vor den beiden anderen Systemen gebaut und es beiseitegelegt, um sie zu bauen. Jetzt, mit vollständiger Trilogie, ist die Form des Ganzen klarer, als sie es aus dem Inneren eines einzelnen Teils je war: die Frage spezifizieren, die Delegation strukturieren, den Agenten regeln. Drei Schichten, je eine Lektion, und jedes Mal derselbe Schluss. Die Teile eines KI-Systems, denen man vertrauen kann, sind die Teile, die nie intelligent waren, und ihre Aufgabe ist es, die intelligenten Teile sicher nutzbar zu machen.
Fragen, die dieser Artikel beantwortet
Warum stellt ein KI-Produkt eine Frage, statt einfach zu antworten?
Weil der Fehler, der verhindert wird, dem Modell vorgelagert ist. Eine Anfrage, die nur sagt, dass jemand Hilfe bei einem Gesundheitsproblem braucht, hat keine gute Antwort, und alles, was ein Modell daraus erzeugt, ist teure Raterei im Ton der Gewissheit. Retrieval, Reranking, Guardrails und Evals setzen sämtlich auf der Antwortseite an, also erst nachdem die schlechte Frage schon akzeptiert wurde, während eine vorgeschaltete Klärungsfrage Mikrosekunden kostet.
Bringt ein Klärungsschritt nicht einfach mehr Latenz und nervt die Nutzer?
Die Engine-Kosten sind nicht das Problem: Die gesamte Engine-Zeit über ein ganzes Gespräch bleibt deutlich unter einer Millisekunde, und das Audit-Ledger weist jeden Schritt in Bruchteilen einer Millisekunde aus. Die Zahl der Fragen begrenzen die Daten und nicht das Ermessen eines Modells, ein Pack mit sieben Feldern, von denen zwei als erforderlich markiert sind, ergibt also ein Gespräch mit zwei Fragen und nie mehr, als das Pack fordert. Auch eine Klärungsfrage pro Runde ist Absicht, denn Nutzer beantworten eine Frage und brechen Fragebögen ab.
Was steckt eigentlich in einem Context Bundle?
Heute trägt es den Intent, die ursprüngliche Anfrage, typisierte Felder, Ausgabe-Constraints und einen Trace-Block mit trace id, session id, workspace id und generated-at, sodass sich jedes Bundle bis zu jedem Schritt zurückverfolgen lässt, der es erzeugt hat. Die Pack-Version wird beim Anlegen der Session festgepinnt und im Bundle vermerkt, was es reproduzierbar macht: gleiches Pack, gleiche Antworten, gleiche Ausgabe. Neuformulierung, Annahmen, Unbekannte und Akzeptanzkriterien stehen als leere Platzhalter im Schema und warten auf die Schicht, die sie füllt.
Sollte ich Felder mit einem LLM aus dem extrahieren, was der Nutzer ohnehin geschrieben hat?
Nur hinter einem Regel-Fallback und einer Verankerungsprüfung. Die erste Implementierung ließ die Extraktion auf einem lokalen Modell über Ollama auf der CPU laufen und brauchte im Schnitt 138 Sekunden pro Felderkennungs-Anfrage bei einem Timeout von 60 Sekunden, der Schritt, der dem Nutzer eine Frage ersparen sollte, brauchte also zwei Minuten, um sie nicht zu beantworten. Der Wechsel zu einem gehosteten Router mit einem kleinen Llama-Modell drückte das auf Sekunden, und extrahierte Werte durchlaufen weiterhin zuerst die Validierung: halluzinationsanfällige Felder brauchen lexikalische Verankerung in den eigenen Worten des Nutzers, Werte, die im Wesentlichen ein Echo der gesamten Eingabe sind, werden verworfen, und datumsartige Felder müssen eine Plausibilitätsprüfung bestehen.
Weiterlesen
 AI Agents
Ich habe die Pipeline gebaut, die mein Produkt gebaut hat. Was Delegieren wirklich verlangt
Feldnotizen zu plan-to-pr, einer Pipeline, die aus einem Feature-Wunsch Tickets, ein Freigabe-Gate und Draft Pull Requests macht, und warum Delegieren an Coding-Agents Artefakte braucht, keinen Chat. AI Agents
Ich habe eine Control Plane für KI-Agenten gebaut. Das ist es, was Governance wirklich erfordert
Feldnotizen zum Bau von Smithproof, einer mandantenfähigen Control Plane für KI-Agenten, und warum Erkennung ohne Reaktion und Richtlinien ohne Durchsetzung nichts steuern.