
Savoir ce que vous allez obtenir, savoir quoi construire
Écouter l'article (expérimental) · 14:10
Quelque part au-dessus de chaque équipe d'ingénierie se trouve une personne qui a besoin d'un seul chiffre : est-ce que ce sera livré d'ici la fin du trimestre ? Et la machinerie qui produit ce chiffre est remarquable. Cette personne demande à un lead. Les bonnes semaines, le lead sait déjà. Les autres, deux développeurs sont interrompus en plein travail pour produire une estimation polie. Dans les deux cas, la réponse est arrondie vers le haut à chaque étage qu'elle traverse, parce que personne ne veut porter les mauvaises nouvelles, et ce qui arrive en haut est une impression déguisée en pourcentage. Trois semaines plus tard, la date glisse et tout le monde joue la surprise.
Tout le monde dans cette chaîne y perd quelque chose. Le lead devient un routeur de statuts au lieu d'être celui qui lève les obstacles, et même le lead qui sait rapporte un souvenir, pas une mesure. Les développeurs, quand la question finit par les atteindre, paient un après-midi pour un rapport qui sera faux dès vendredi. La personne qui a posé la question n'a toujours pas de chiffre sur lequel agir, parce que « on pense que c'est en bonne voie » n'est pas un chiffre.
Je crois que le correctif est une méthode de travail, et j'ai construit l'outil qui la fait tourner. L'objectif n'est pas moins de questions, mais que les deux côtés regardent enfin la même chose : le métier sachant, à tout instant, quelle est sa probabilité d'obtenir ce qu'il a demandé, et les développeurs sachant, dès le premier jour, exactement ce qu'ils doivent construire et comment ce sera jugé.
D'où vient la méthode
La première pièce vient de la façon dont les meilleures équipes OKR travaillent déjà. Dans le style Radical Focus, chaque résultat clé démarre le trimestre à une confiance de cinq sur dix, et le check-in hebdomadaire fait monter ou descendre cette confiance selon ce qui s'est réellement passé. Google note les OKR de 0,0 à 1,0 en fin de trimestre. Ce rituel traite le statut d'un résultat clé comme une probabilité, révisée chaque semaine, et non comme une liste d'activités.
La deuxième pièce vient de la recherche sur la prévision. Les meilleurs prévisionnistes se distinguent des autres par leur comportement, pas par leur intelligence ni par des informations privilégiées : ils mettent à jour souvent et par petits pas, et ils s'ancrent sur les taux de base, ce qui arrive d'habitude, avant de toucher à ce qui semble différent cette fois-ci. De petites mises à jour fréquentes par-dessus un taux de base, c'est, presque mot pour mot, le check-in hebdomadaire OKR bien fait.
Mettez les deux côte à côte : le check-in hebdomadaire est un exercice de prévision. Les équipes le font à la main, en réunion, de mémoire, et celui qui tient le marqueur est en général le plus optimiste de la salle. Pendant ce temps, le taux de base, le rythme réel de l'équipe, dort dans le repo, enregistré à la seconde près, et personne ne le demande jamais.
Les outils du repo ne comblent pas cet écart non plus. Les burndown charts et les rapports de vélocité consomment les mêmes données, mais ils vivent au niveau du sprint, dans l'outillage des développeurs, là où le métier ne regarde jamais. Ils produisent des graphiques, pas des probabilités accompagnées de leurs raisons. Et personne ne revient noter un burndown face à ce qui a réellement été livré, donc personne ne peut vous dire si le graphique du trimestre dernier méritait qu'on y croie.
Le cadre
La proposition n'ajoute aucune réunion, même si elle exige l'hygiène d'issues que la plupart des équipes prétendent déjà avoir. Elle a besoin d'une réunion qui existe déjà et d'un job qui tourne tout seul.
Au début du trimestre, les leads s'assoient avec le métier et fixent les objectifs. Cette partie ne change pas. Ce qui change, c'est la suite : chaque objectif est découpé en résultats clés, et chaque résultat clé est encodé là où le travail vit vraiment, sous forme de milestone GitHub avec une échéance, ou de tranche de milestone identifiée par un label quand un milestone en porte plusieurs. Un résultat clé cesse d'être un slogan sur une slide et devient un ensemble d'issues cliquable.
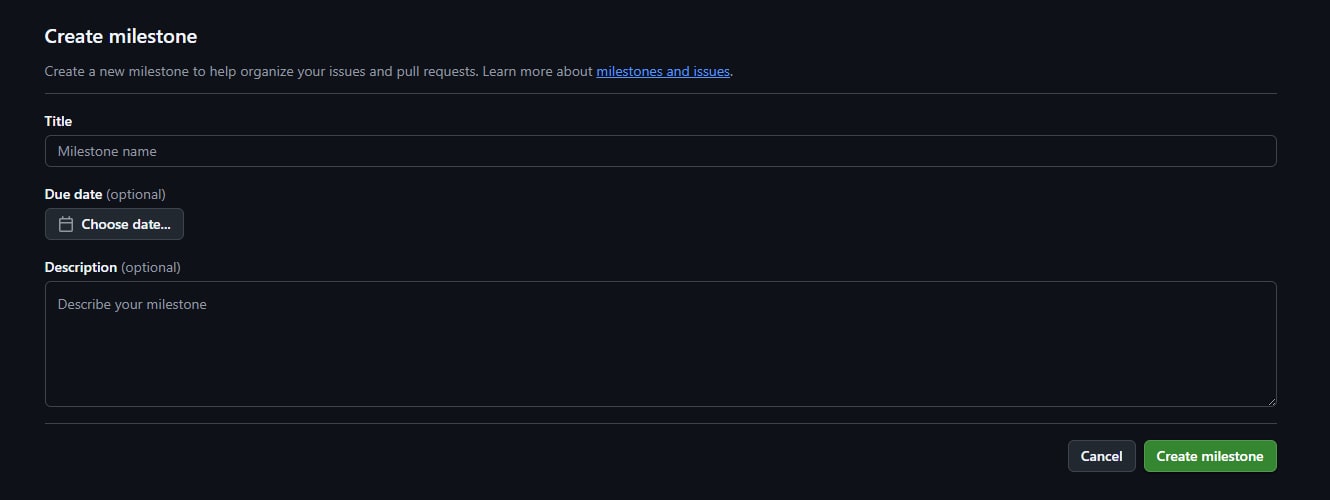
Le côté GitHub est délibérément ennuyeux. Un milestone avec une date d'échéance, c'est un petit formulaire :
Un label par résultat clé, c'en est un autre, posé à côté de ceux que tout repo possède déjà :
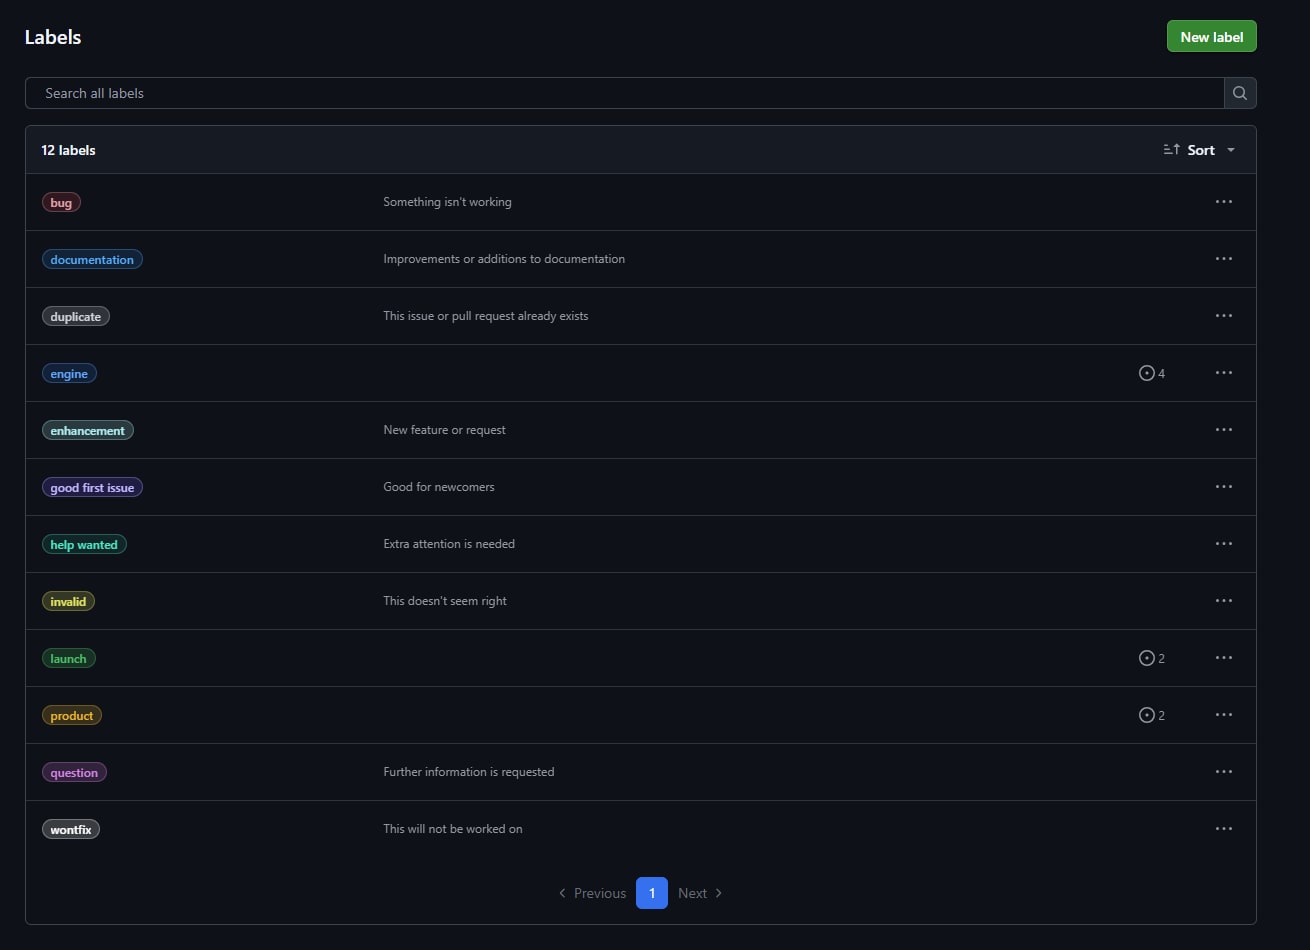
Les issues reçoivent les deux au fil du tri habituel : le milestone et le label de leur résultat clé. Un court fichier de configuration indique ensuite au forecaster et au dashboard comment les lire : quel objectif possède quel milestone, quel label le découpe en résultats clés, et quelle issue reçoit le commentaire hebdomadaire.
repo: tiago-peres/superforecaster
milestones:
  - milestone: v1.0
    objective: Ship Superforecaster v1
    deadline: 2026-08-14
    krs:
      - id: engine
        name: Forecast engine turns a milestone into a calibrated P(delivery)
        label: engine
        tracking_issue: 1
C'est toute la mise en place. Ouvrez ensuite le milestone et il se lit déjà comme la promesse qu'il est : une date d'échéance, une barre de progression, et chaque élément de travail restant portant le label de son résultat clé, visible par quiconque prend la peine de regarder. Terminé veut dire : ces issues, fermées, à cette date.
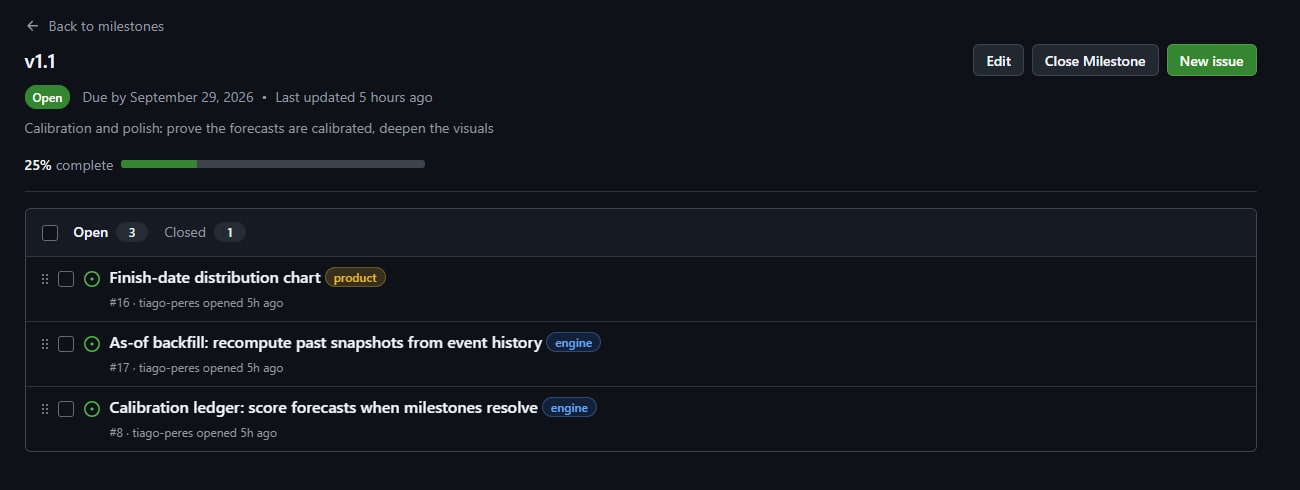
Une limite avant d'aller plus loin : tout ceci couvre les résultats clés de livraison, un périmètre qui est livré à une date donnée. Un résultat clé métrique, adoption, revenus, latence, a besoin de la métrique elle-même comme source, et aucune arithmétique d'issues ne la remplace. Mais les engagements de livraison du trimestre sont là où loge l'angoisse du sera-t-il-livré, et pour ceux-là, les issues sont le travail, et le travail est ce qu'une prévision peut observer.
Ensuite, pendant le trimestre, personne n'écrit de statut. Un job tourne chaque lundi et fait ce que la salle faisait semblant de faire. Il lit le repo : ce qui a été fermé cette semaine, ce qui a été ajouté au périmètre en cours de semaine, le rythme hebdomadaire réel. Il rejoue le reste du trimestre dix mille fois sur ce rythme, un Monte Carlo sur le débit réel, et rapporte la fraction de futurs qui tiennent l'échéance. Quand un repo est trop jeune pour avoir un rythme à lui, le forecaster emprunte la distribution du repo précédent de l'équipe, un prior délibérément faible, gardé seulement jusqu'à ce qu'un véritable historique s'accumule. Et la netteté de la prévision suit la décomposition du backlog : tant que la moitié du périmètre est encore en épiques, le cône est large, et il doit l'être.
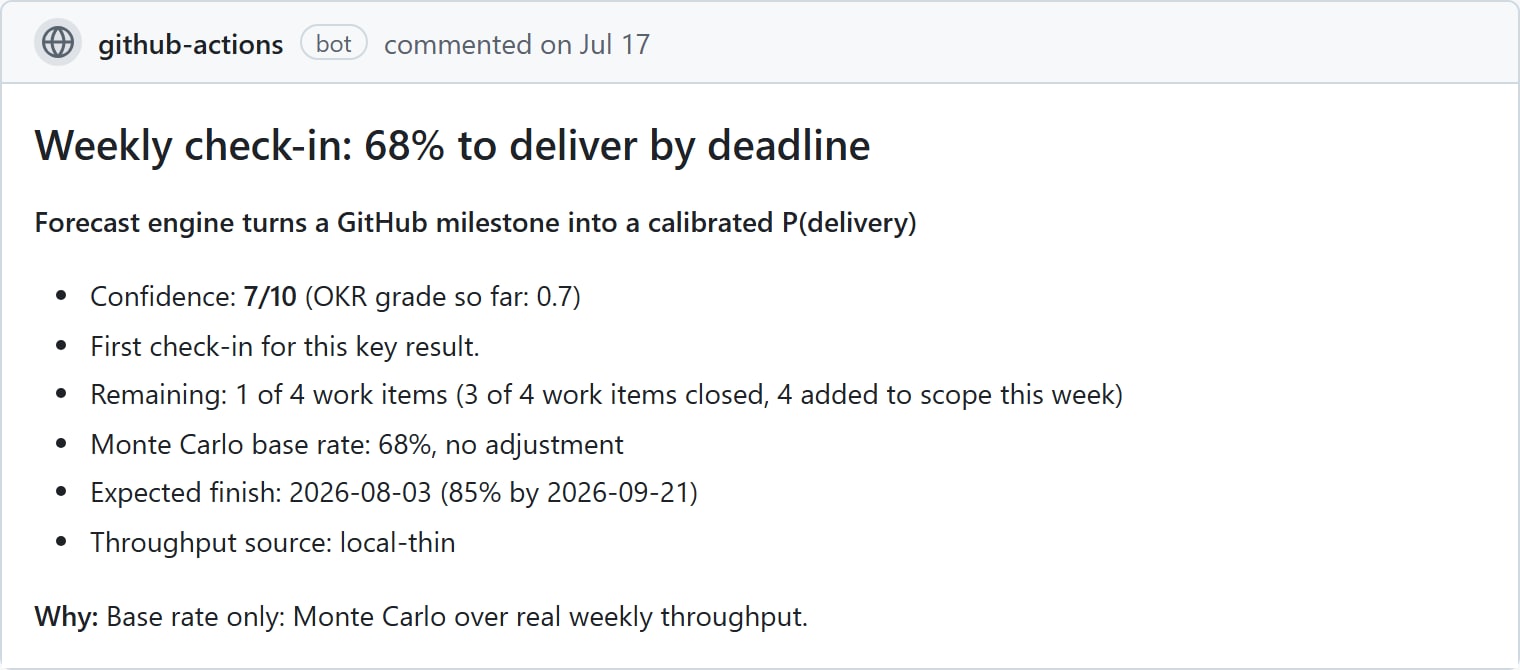
Par-dessus les mathématiques, un modèle lit les issues ouvertes comme le ferait un relecteur, en cherchant le risque que les chiffres ne voient pas, le ticket qui est en réalité de la recherche sans bornes, la dépendance à une décision que personne n'a prise. Il peut déplacer la probabilité de quinze points au maximum, son raisonnement est publié à côté du chiffre, et sa prévision ajustée est notée séparément de la prévision brute, de sorte que l'historique montre si la couche de jugement mérite sa place. Puis le job publie un commentaire par résultat clé sur son issue de suivi : la probabilité, son mouvement depuis la semaine dernière, ce qui l'a fait bouger, et pourquoi.
Et le dashboard est l'endroit où tout cela atterrit, pour tout le monde, à tout moment.
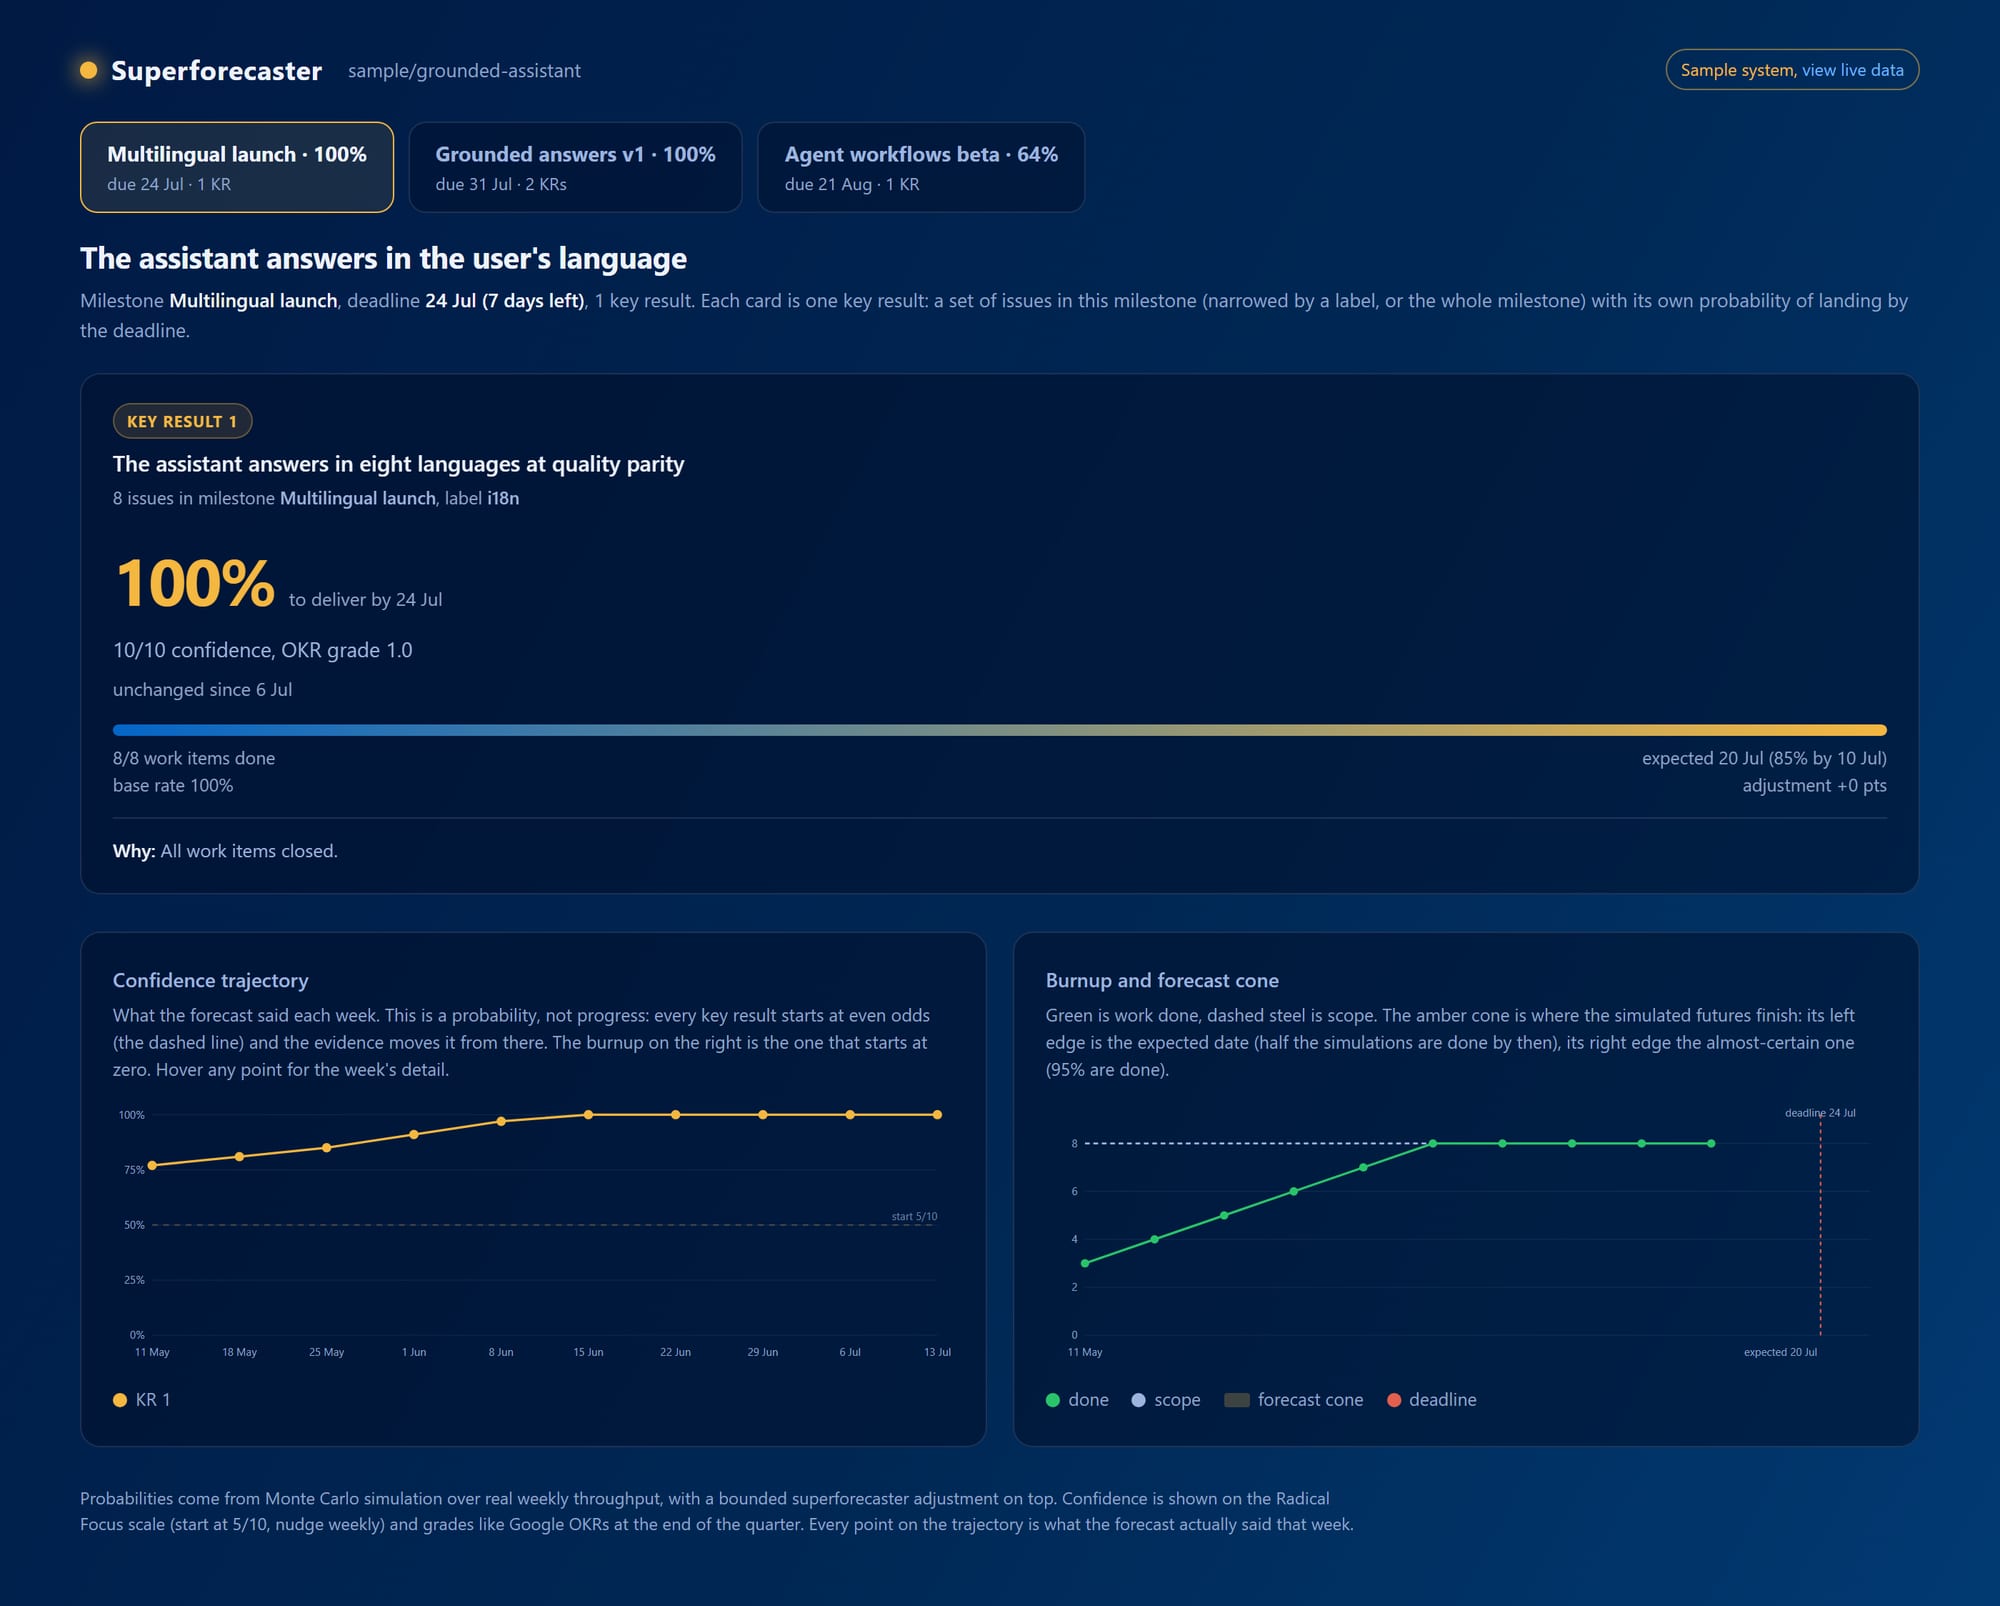
Le métier consulte le dashboard avant le comité de pilotage au lieu de demander à qui que ce soit. Chaque résultat clé affiche sa probabilité d'arriver à sa date, le mouvement de la semaine, la fin attendue et la raison écrite. Le graphique de trajectoire, c'est la ligne de confiance OKR rendue réelle : elle part d'une chance sur deux et chaque point est ce que la prévision disait cette semaine-là, pas une courbe redessinée pour faire propre en rétro. En fin de trimestre, la note de 0,0 à 1,0 tombe de l'historique au lieu d'être négociée dans une salle.
La vue qui justifie toute la méthode est celle qui n'a rien de réjouissant. Voici à quoi ressemble un milestone en difficulté, tiré du jeu d'exemple livré avec le dashboard :
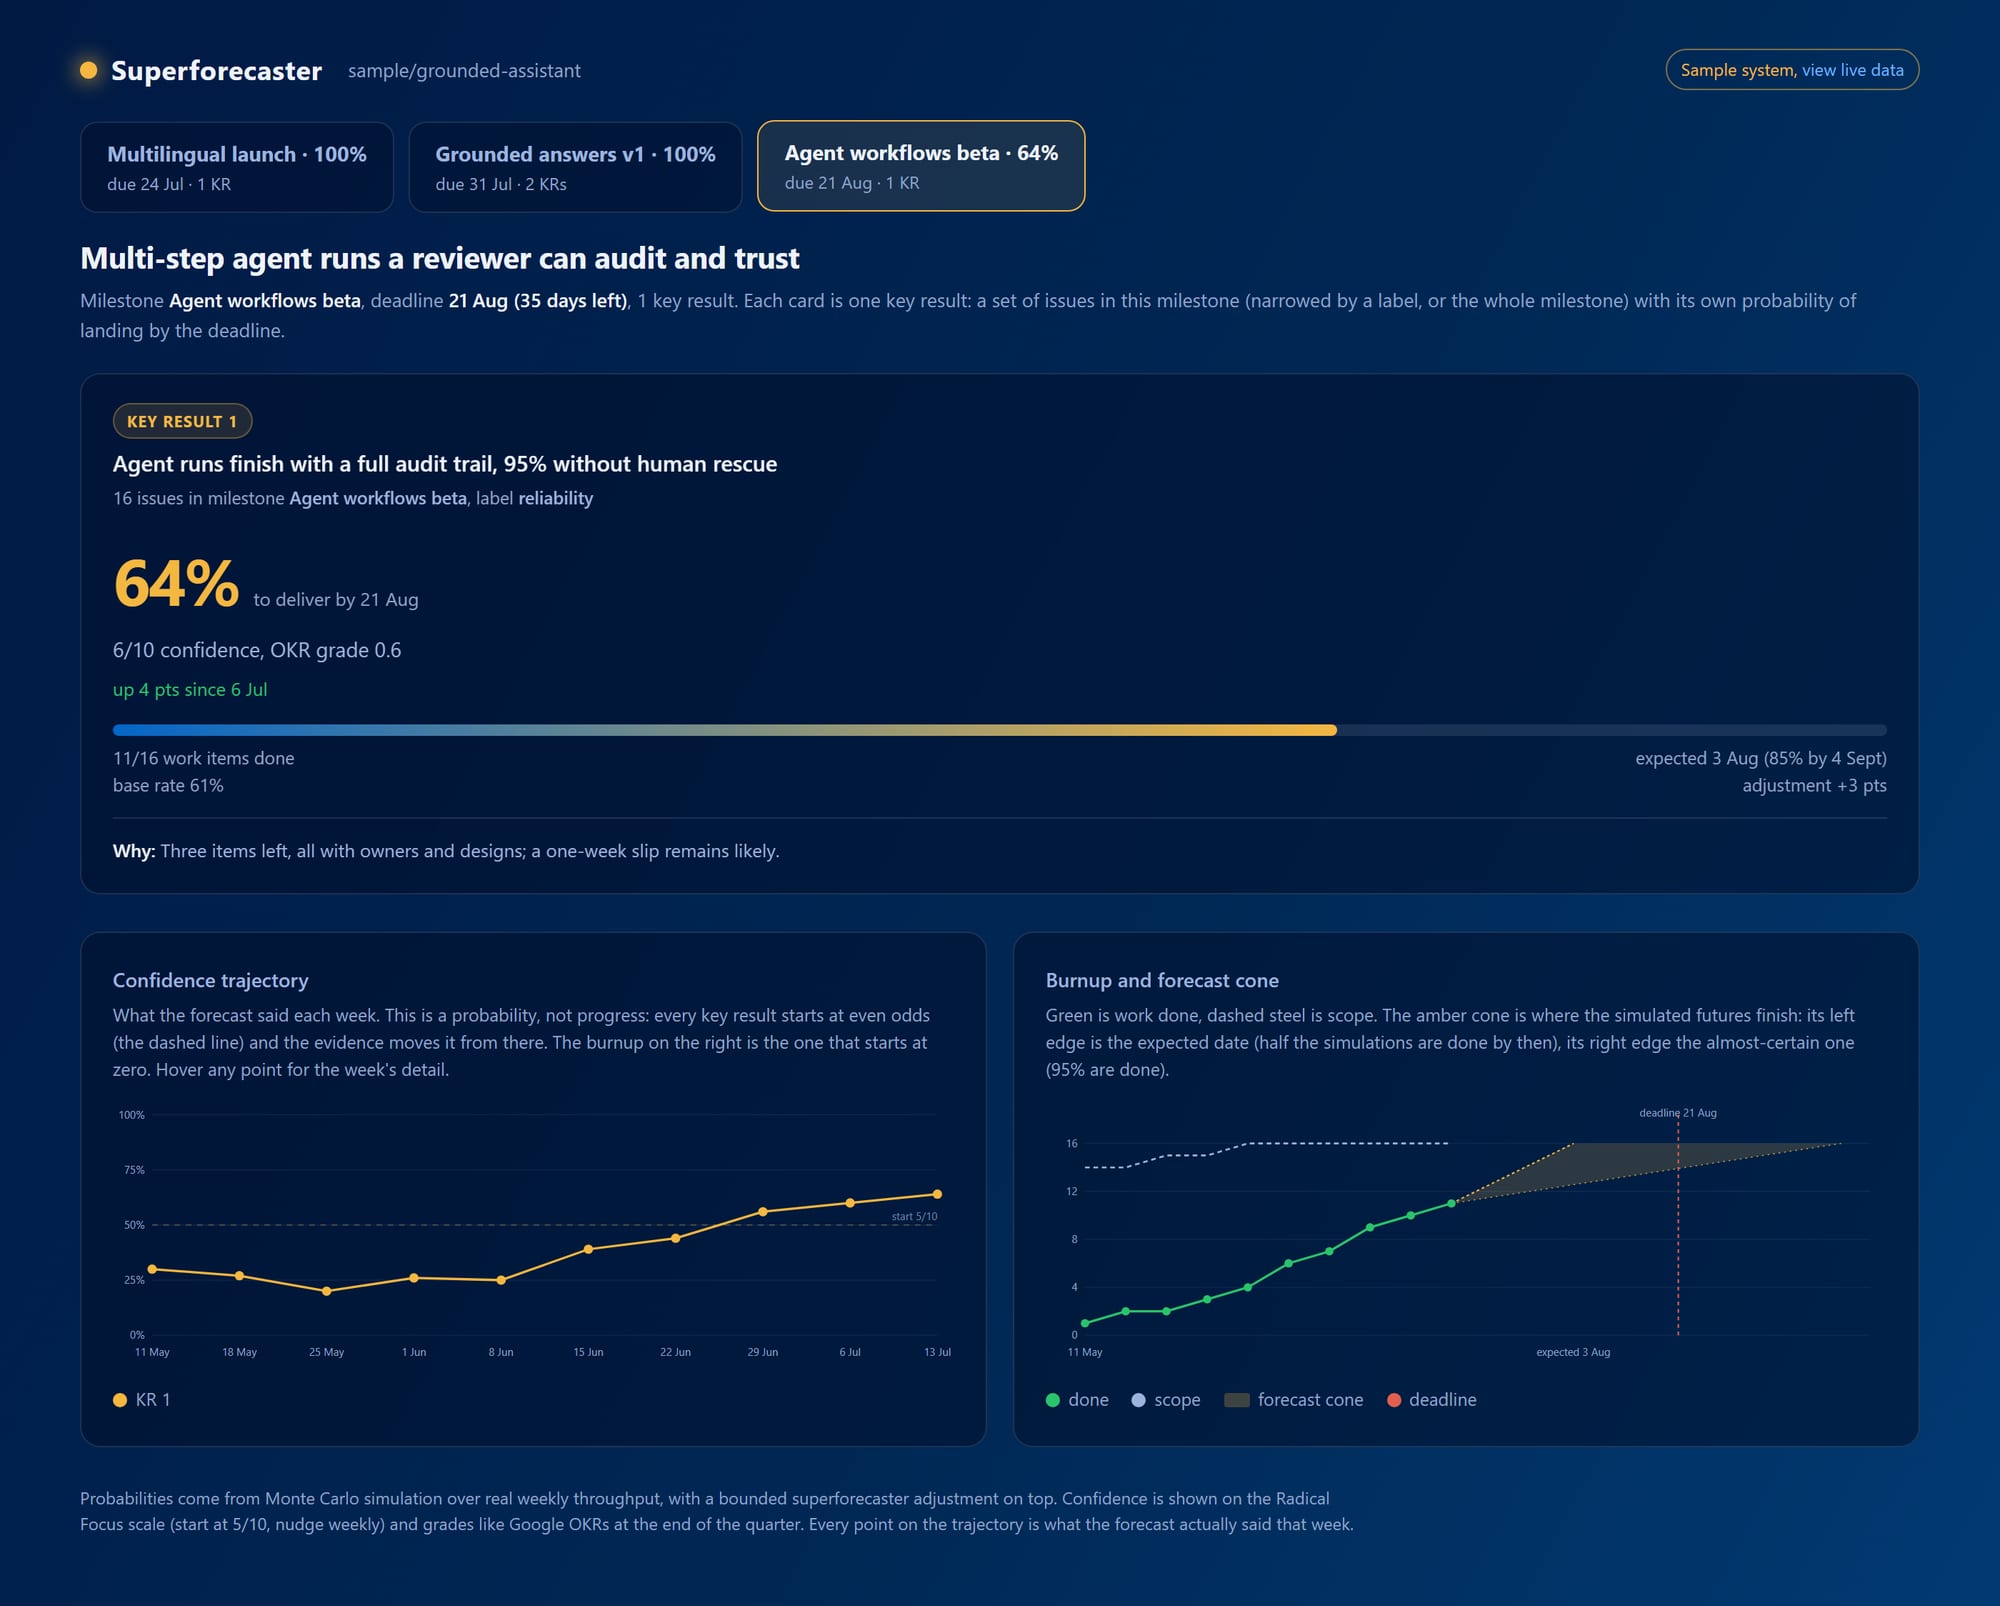
Un résultat clé à 64 %, visiblement en difficulté, des mois avant que son échéance ne cesse d'être négociable. La ligne de confiance a passé un mois sous son point de départ pendant qu'une brique d'infrastructure bloquante retenait tout le reste derrière elle, et le raisonnement écrit le disait chaque semaine. Personne n'a eu à escalader. Personne n'a eu à avouer quoi que ce soit en réunion. Le chiffre a baissé, la raison était attachée, et l'équipe a gagné des semaines pour agir au lieu d'une mauvaise surprise à l'échéance.
Ce que l'outil m'a appris dès le premier jour
J'ai construit tout cela sous la forme d'un produit appelé Superforecaster, et la première équipe qu'il prévoit, c'est lui-même : ses propres milestones, ses propres issues, ses propres check-ins hebdomadaires publiés sur son propre tracker. Le dogfooding m'a donné une leçon en quelques heures. Lors de sa première exécution sans supervision, il a annoncé une probabilité de 100 %, une confiance de dix sur dix, pour un milestone situé à quatre semaines. La cause était une seule bonne semaine de fermetures d'issues et aucune variance, ce qui est le plus vieux péché de la prévision : une certitude totale tirée d'un échantillon minuscule. Le correctif a consisté à faire qu'un historique mince élargisse l'incertitude au lieu de la resserrer, et à s'appuyer sur la vue extérieure tant que le repo n'a pas de véritable passé. Après le correctif, les mêmes données disaient 35 %.
Ce chiffre était inconfortable, et c'était voulu. Une impression aurait dit « ça avance bien ». La prévision, elle, disait : à ce rythme, avec ce périmètre, vous allez probablement rater. Vous pouvez discuter un 35 %, couper du périmètre en conséquence, déplacer une date à cause de lui. Il n'y a rien à discuter dans « en bonne voie ». Le milestone est encore ouvert au moment où j'écris, donc l'historique jugera ce 35 % comme cette méthode juge chaque prévision : noté face à ce qui s'est réellement passé. En attendant, c'est une estimation disciplinée, ce qui est déjà plus que ce qu'une réunion de statut a jamais donné à qui que ce soit.
Ce que chaque côté y gagne
Le métier obtient une probabilité cohérente d'une semaine à l'autre, parce que la même méthode la produit à chaque fois, avec la raison attachée. Quand la réponse est mauvaise, elle arrive assez tôt pour changer la demande pendant que le trimestre peut encore absorber la décision.
Les développeurs obtiennent une définition du succès qui tient dans un lien, fixée au départ et visible tout le trimestre, et quand elle change, elle change à l'endroit même où ils travaillent. Ils récupèrent aussi leur semaine : la prévision lit leurs commits et leurs issues, jamais leur temps, et elle agrège au niveau du milestone, si bien que le dashboard ne porte aucun chiffre par personne à contempler.
Les leads sortent du rôle de routeur. Le check-in s'écrit tout seul depuis le repo, si bien que le temps de réunion du lead va à ce que le dashboard a fait remonter, la décision bloquée, le périmètre qui a grossi, au lieu d'aller à la compilation des nouvelles.
Là où cela casse
Une probabilité n'est pas une promesse, et la méthode ne vaut que ce que vaut l'hygiène en dessous. Si le travail ne vit pas dans les issues, le forecaster est aveugle. Si les changements de périmètre ne touchent jamais le milestone, le burnup ment.
Les chiffres peuvent pourrir de deux façons, et elles demandent des remèdes différents. Le forecaster lui-même peut dériver, et pour cela le remède est mécanique : chaque prévision est consignée et notée quand le milestone se résout, de sorte que l'historique montre si elle mérite qu'on y croie. L'équipe peut aussi le contourner, en fermant des issues creuses, en découpant des tickets pour gonfler le rythme, en retirant du travail du périmètre du milestone sans que personne ne regarde, et aucune notation n'attrape cela. Le dashboard peut rendre visibles les changements de périmètre et les issues rouvertes, mais la dernière ligne de défense reste celle qu'elle a toujours été : une culture de revue où une fermeture vide ne survit pas. Un outil ne peut pas fournir cela. Il peut seulement rendre le contournement visible.
Les interruptions ne tombent pas à zéro non plus. Un chiffre qui perd neuf points un lundi va susciter des questions, et c'est tant mieux. Ce qui change, c'est l'endroit où ces questions atterrissent et ce qu'elles portent : elles vont sur l'issue de suivi, déjà chargée de la raison, et la conversation commence à « les chances ont baissé parce que le périmètre a grossi, qu'est-ce qu'on coupe ? » au lieu de « où en est-on ? ». C'est une conversation qui vaut la peine, avec n'importe qui.
Le trimestre commence avec des gens dans une salle qui s'accordent sur ce qui compte. Le travail de la machine, c'est tout le reste : elle observe le travail et fait l'arithmétique, et elle annonce à tout le monde le même chiffre au même moment.
Les questions auxquelles cet article répond
Comment savoir tôt si le travail du trimestre sera livré à temps ?
En lisant le repo plutôt qu'en interrogeant les gens. Un job tourne chaque lundi, prend ce qui a été fermé dans la semaine et ce qui a été ajouté au périmètre en cours de semaine, rejoue le reste du trimestre dix mille fois sur ce rythme réel et rapporte la fraction de futurs qui tiennent l'échéance. Un historique mince doit élargir l'incertitude au lieu de la resserrer : lors de sa première exécution sans supervision, l'outil a annoncé 100 % pour un milestone situé à quatre semaines, et après ce correctif les mêmes données disaient 35 %.
En quoi est-ce différent des burndown charts et des rapports de vélocité ?
Ceux-là consomment les mêmes données, mais ils vivent au niveau du sprint, dans l'outillage des développeurs, là où le métier ne regarde jamais, et ils produisent des graphiques plutôt que des probabilités accompagnées de leurs raisons. Personne ne revient noter un burndown face à ce qui a réellement été livré, donc personne ne peut vous dire si le graphique du trimestre dernier méritait qu'on y croie. Ici chaque prévision est consignée et notée quand le milestone se résout, et la couche de modèle qui lit les issues ouvertes peut déplacer le chiffre de quinze points au maximum, avec son raisonnement publié et son ajustement noté séparément de la prévision brute.
Qu'est-ce qui empêche une équipe de fausser la prévision en fermant des issues creuses ?
Rien dans l'outil, et cette limite mérite d'être dite. La notation attrape le forecaster qui dérive, mais pas les fermetures creuses, pas les tickets découpés pour gonfler le rythme, pas le périmètre retiré du milestone sans que personne ne regarde. Le dashboard peut rendre visibles les changements de périmètre et les issues rouvertes ; la dernière ligne de défense reste celle qu'elle a toujours été, une culture de revue où une fermeture vide ne survit pas.
Est-ce que cela finit par mesurer chaque développeur ?
Non. La prévision lit les commits et les issues, jamais le temps de qui que ce soit, et elle agrège au niveau du milestone, si bien que le dashboard ne porte aucun chiffre par personne à contempler. Ce que les développeurs reçoivent à la place, c'est une définition du succès qui tient dans un lien, fixée au début du trimestre et visible tout du long, et les après-midis qu'ils passaient à écrire des statuts que personne ne note.
À lire ensuite
 AI
Quand l'IA doit filmer sa propre relecture
Quand une pull request est ouverte, la mienne ou une autre que je dois relire, je demande désormais à l'agent de la lancer sur ma machine, d'essayer de la casser et de se filmer en train de le faire. Un paragraphe peut affirmer qu'un test a eu lieu. Un enregistrement doit le montrer, et décider de ce qu'il signifie reste mon travail. AI
Jev répond en probabilités. La question reste la vôtre.
Jev, de TypeSafe, n'écrira pas une phrase. Vous lui tendez un état et des questions typées, et il vous rend un choix, un score ou une probabilité oui/non, pour quatre millièmes de centime par décision sur mille tokens. La nouveauté, c'est la forme, qui remet l'autorité dans votre code, et le piège, c'est qu'une probabilité ressemble à un recours et n'en est pas un. J'ai lancé le pilote qu'il me faudrait avant de croire le moindre chiffre, sur mes propres essais avec le modèle ouvert qui a servi de doublure à Jev, et la réponse a été non.