
Sabe o Que Vais Receber, Sabe o Que Construir
Ouvir o artigo (experimental) · 13:24
Algures acima de qualquer equipa de engenharia há uma pessoa que precisa de um número: isto fica entregue até ao fim do trimestre? E a maquinaria que produz esse número é notável. A pessoa pergunta a um lead. Numa boa semana, o lead já sabe. Nas restantes, dois programadores são interrompidos a meio do trabalho para produzir um palpite educado. Em qualquer dos casos, a resposta é arredondada para cima em cada camada por que passa, porque ninguém quer carregar más notícias, e o que chega ao topo é uma sensação vestida de percentagem. Três semanas depois a data escorrega e toda a gente finge surpresa.
Toda a gente nessa cadeia perde alguma coisa. O lead passa a ser um encaminhador de estados em vez da pessoa que remove obstáculos, e mesmo o lead que sabe está a reportar uma memória, não uma medição. Os programadores, quando a pergunta lhes chega mesmo, pagam com uma tarde por um relatório que estará errado na sexta-feira. Quem perguntou continua sem um número sobre o qual possa agir, porque "achamos que está no caminho certo" não é um número.
Acho que a solução é um método de trabalho, e construí a ferramenta que o executa. O objetivo não é haver menos perguntas, mas os dois lados olharem finalmente para a mesma coisa: o negócio a saber, a qualquer momento, qual a probabilidade de receber o que pediu, e os programadores a saberem, desde o primeiro dia, exatamente o que têm de construir e como vai ser avaliado.
De onde vem o método
A primeira peça vem da forma como as melhores equipas de OKRs já trabalham. No estilo Radical Focus, cada key result começa o trimestre com uma confiança de cinco em dez, e o check-in semanal empurra essa confiança para cima ou para baixo consoante o que aconteceu de facto. A Google classifica os OKRs de 0,0 a 1,0 no fim do trimestre. Esse ritual trata o estado de um key result como uma probabilidade, revista todas as semanas, e não como uma lista de atividades.
A segunda peça vem da investigação sobre previsão. Os melhores forecasters distinguem-se dos outros pelo comportamento, não pela inteligência nem por informação privilegiada: atualizam com frequência e em passos pequenos, e ancoram-se em taxas base, no que costuma acontecer, antes de mexerem no que parece diferente desta vez. Atualizações pequenas e frequentes sobre uma taxa base é, quase palavra por palavra, o check-in semanal dos OKRs bem feito.
Põe as duas lado a lado: o check-in semanal é um exercício de previsão. As equipas fazem-no à mão, numa reunião, de memória, e quem tem o marcador na mão costuma ser a pessoa mais otimista da sala. Entretanto a taxa base, o ritmo real da equipa, está no repositório, registada ao segundo, e ninguém a pede.
As ferramentas do repositório também não fecham esta distância. Os gráficos de burndown e os relatórios de velocidade consomem os mesmos dados, mas vivem ao nível do sprint, dentro do tooling dos programadores, onde o negócio nunca olha. Produzem gráficos, não probabilidades com razões anexadas. E ninguém volta atrás para pontuar um burndown contra o que foi entregue de facto, por isso ninguém te sabe dizer se o gráfico do trimestre passado merecia crédito.
A framework
A proposta não acrescenta reuniões novas, embora exija a higiene de issues que a maior parte das equipas diz já ter. Precisa de uma reunião que já existe e de um job que corre sozinho.
No início do trimestre, os leads das equipas sentam-se com o negócio e definem os objetivos. Essa parte não muda. O que muda é o que vem a seguir: cada objetivo é partido em key results, e cada key result é codificado onde o trabalho vive de facto, como um milestone do GitHub com prazo, ou como uma fatia dele marcada por label quando um milestone carrega vários. Um key result deixa de ser um slogan num slide e passa a ser um conjunto de issues em que podes clicar.
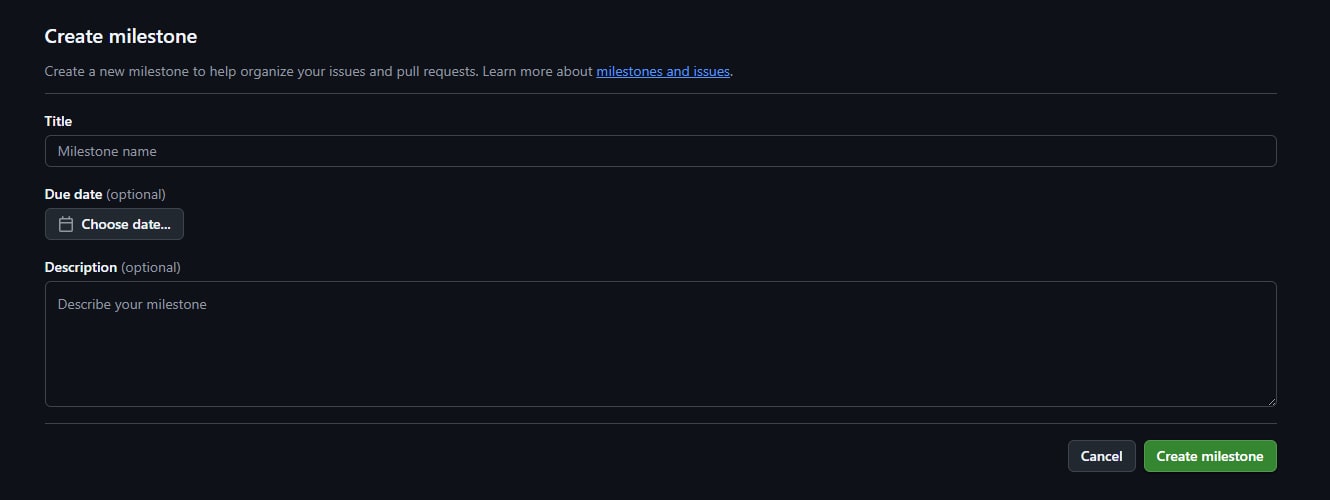
O lado GitHub disto é deliberadamente aborrecido. Um milestone com data de entrega é um pequeno formulário:
Uma label por key result é outro formulário, ao lado das que todos os repositórios já têm:
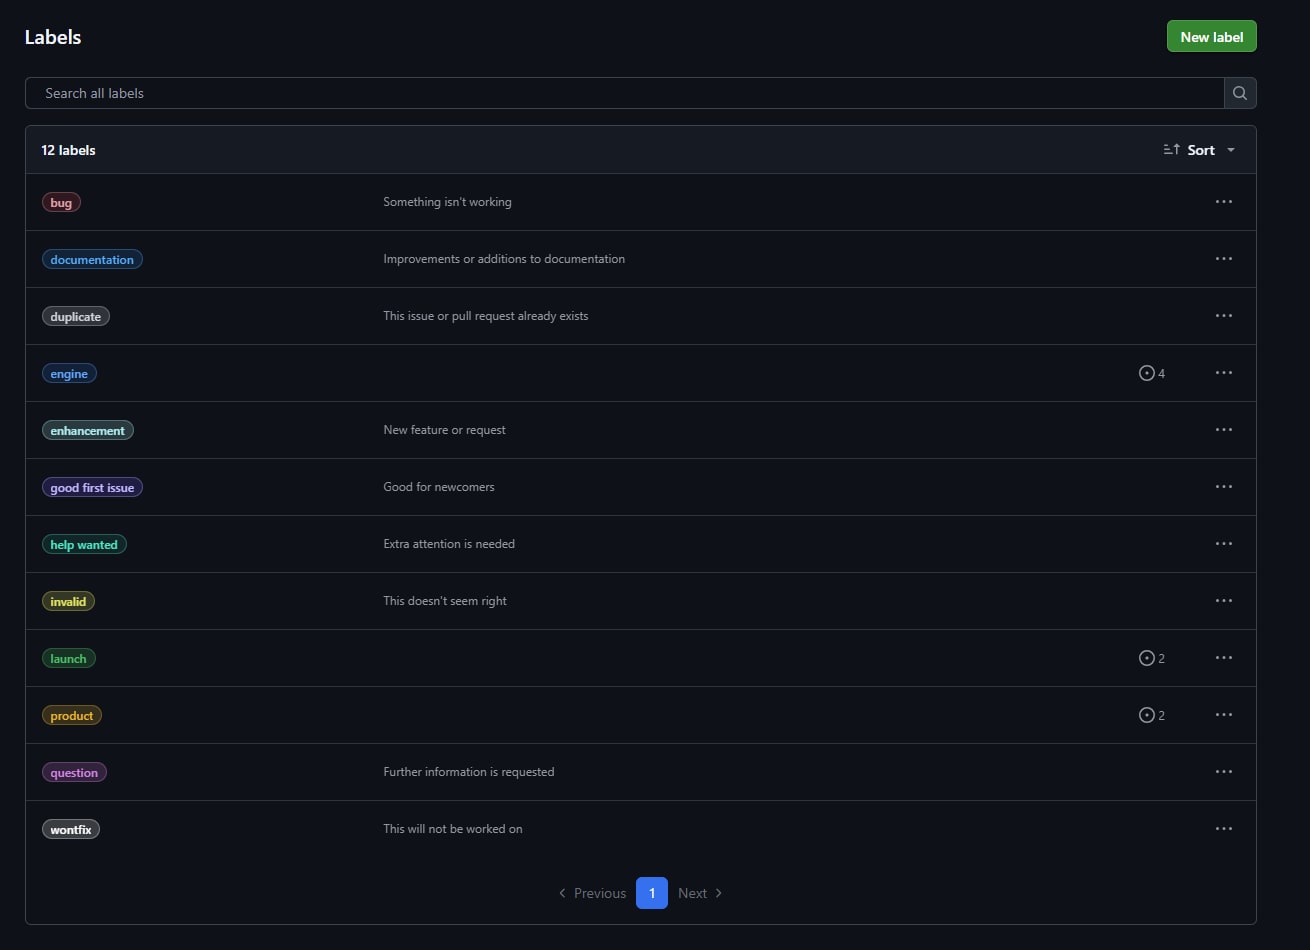
As issues recebem as duas coisas na triagem normal, o milestone e a label do seu key result. Um pequeno ficheiro de configuração diz depois ao forecaster e ao dashboard como as ler: que objetivo é dono de que milestone, que label o divide em key results, e que issue recebe o comentário semanal.
repo: tiago-peres/superforecaster
milestones:
  - milestone: v1.0
    objective: Ship Superforecaster v1
    deadline: 2026-08-14
    krs:
      - id: engine
        name: Forecast engine turns a milestone into a calibrated P(delivery)
        label: engine
        tracking_issue: 1
É esta a configuração toda. Abre o milestone a seguir e já se lê como a promessa que é: uma data de entrega, uma barra de progresso, e cada item de trabalho que falta a carregar a label do seu key result, visível para quem se der ao trabalho de olhar. Feito quer dizer estas issues, fechadas, até esta data.
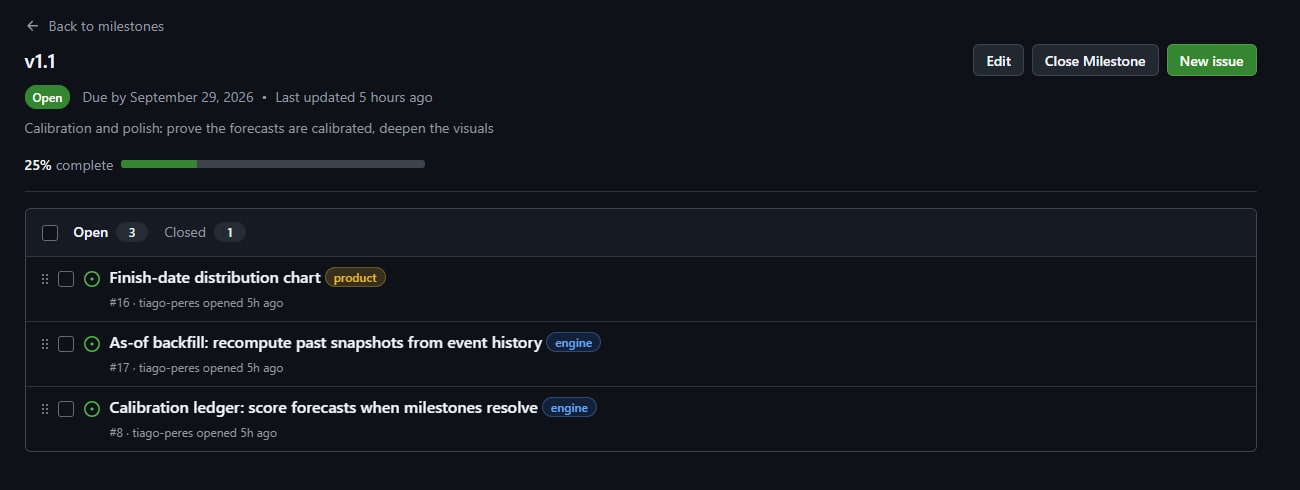
Um limite, antes de avançar: isto cobre key results de entrega, âmbito que sai até uma data. Um key result de métrica, adoção, receita, latência, precisa da própria métrica como fonte, e nenhuma aritmética de issues a substitui. Mas os compromissos de entrega do trimestre são onde vive a ansiedade do vai-sair-ou-não, e nesses, as issues são o trabalho, e o trabalho é o que uma previsão consegue vigiar.
Depois, durante o trimestre, ninguém escreve estados. Um job corre todas as segundas-feiras e faz aquilo que a sala andava a fingir que fazia. Lê o repositório: o que fechou esta semana, o que entrou no âmbito a meio da semana, o ritmo semanal real. Reproduz o resto do trimestre dez mil vezes sobre esse ritmo, Monte Carlo sobre o throughput real, e reporta a fração de futuros que cumprem o prazo. Quando um repositório é novo demais para ter ritmo próprio, o forecaster vai buscar emprestada a distribuição do repositório anterior da equipa, um prior deliberadamente fraco, mantido só até se acumular histórico real. E a nitidez da previsão acompanha a decomposição do backlog: enquanto metade do âmbito ainda for épicos, o cone é largo, e assim deve ser.
Por cima da matemática, um modelo lê as issues abertas como um revisor leria, à procura do risco que os números não veem, o ticket que é na verdade investigação sem fim à vista, a dependência de uma decisão que ninguém tomou. Pode mexer na probabilidade no máximo quinze pontos, o seu raciocínio é publicado ao lado do número, e a sua previsão ajustada é pontuada em separado da previsão bruta, para que o registo mostre se a camada de julgamento se paga a si própria. Depois o job publica um comentário por key result na respetiva issue de acompanhamento: a probabilidade, como se mexeu desde a semana passada, o que a mexeu, e porquê.
E o dashboard é onde tudo isto aterra, para toda a gente, a qualquer hora.
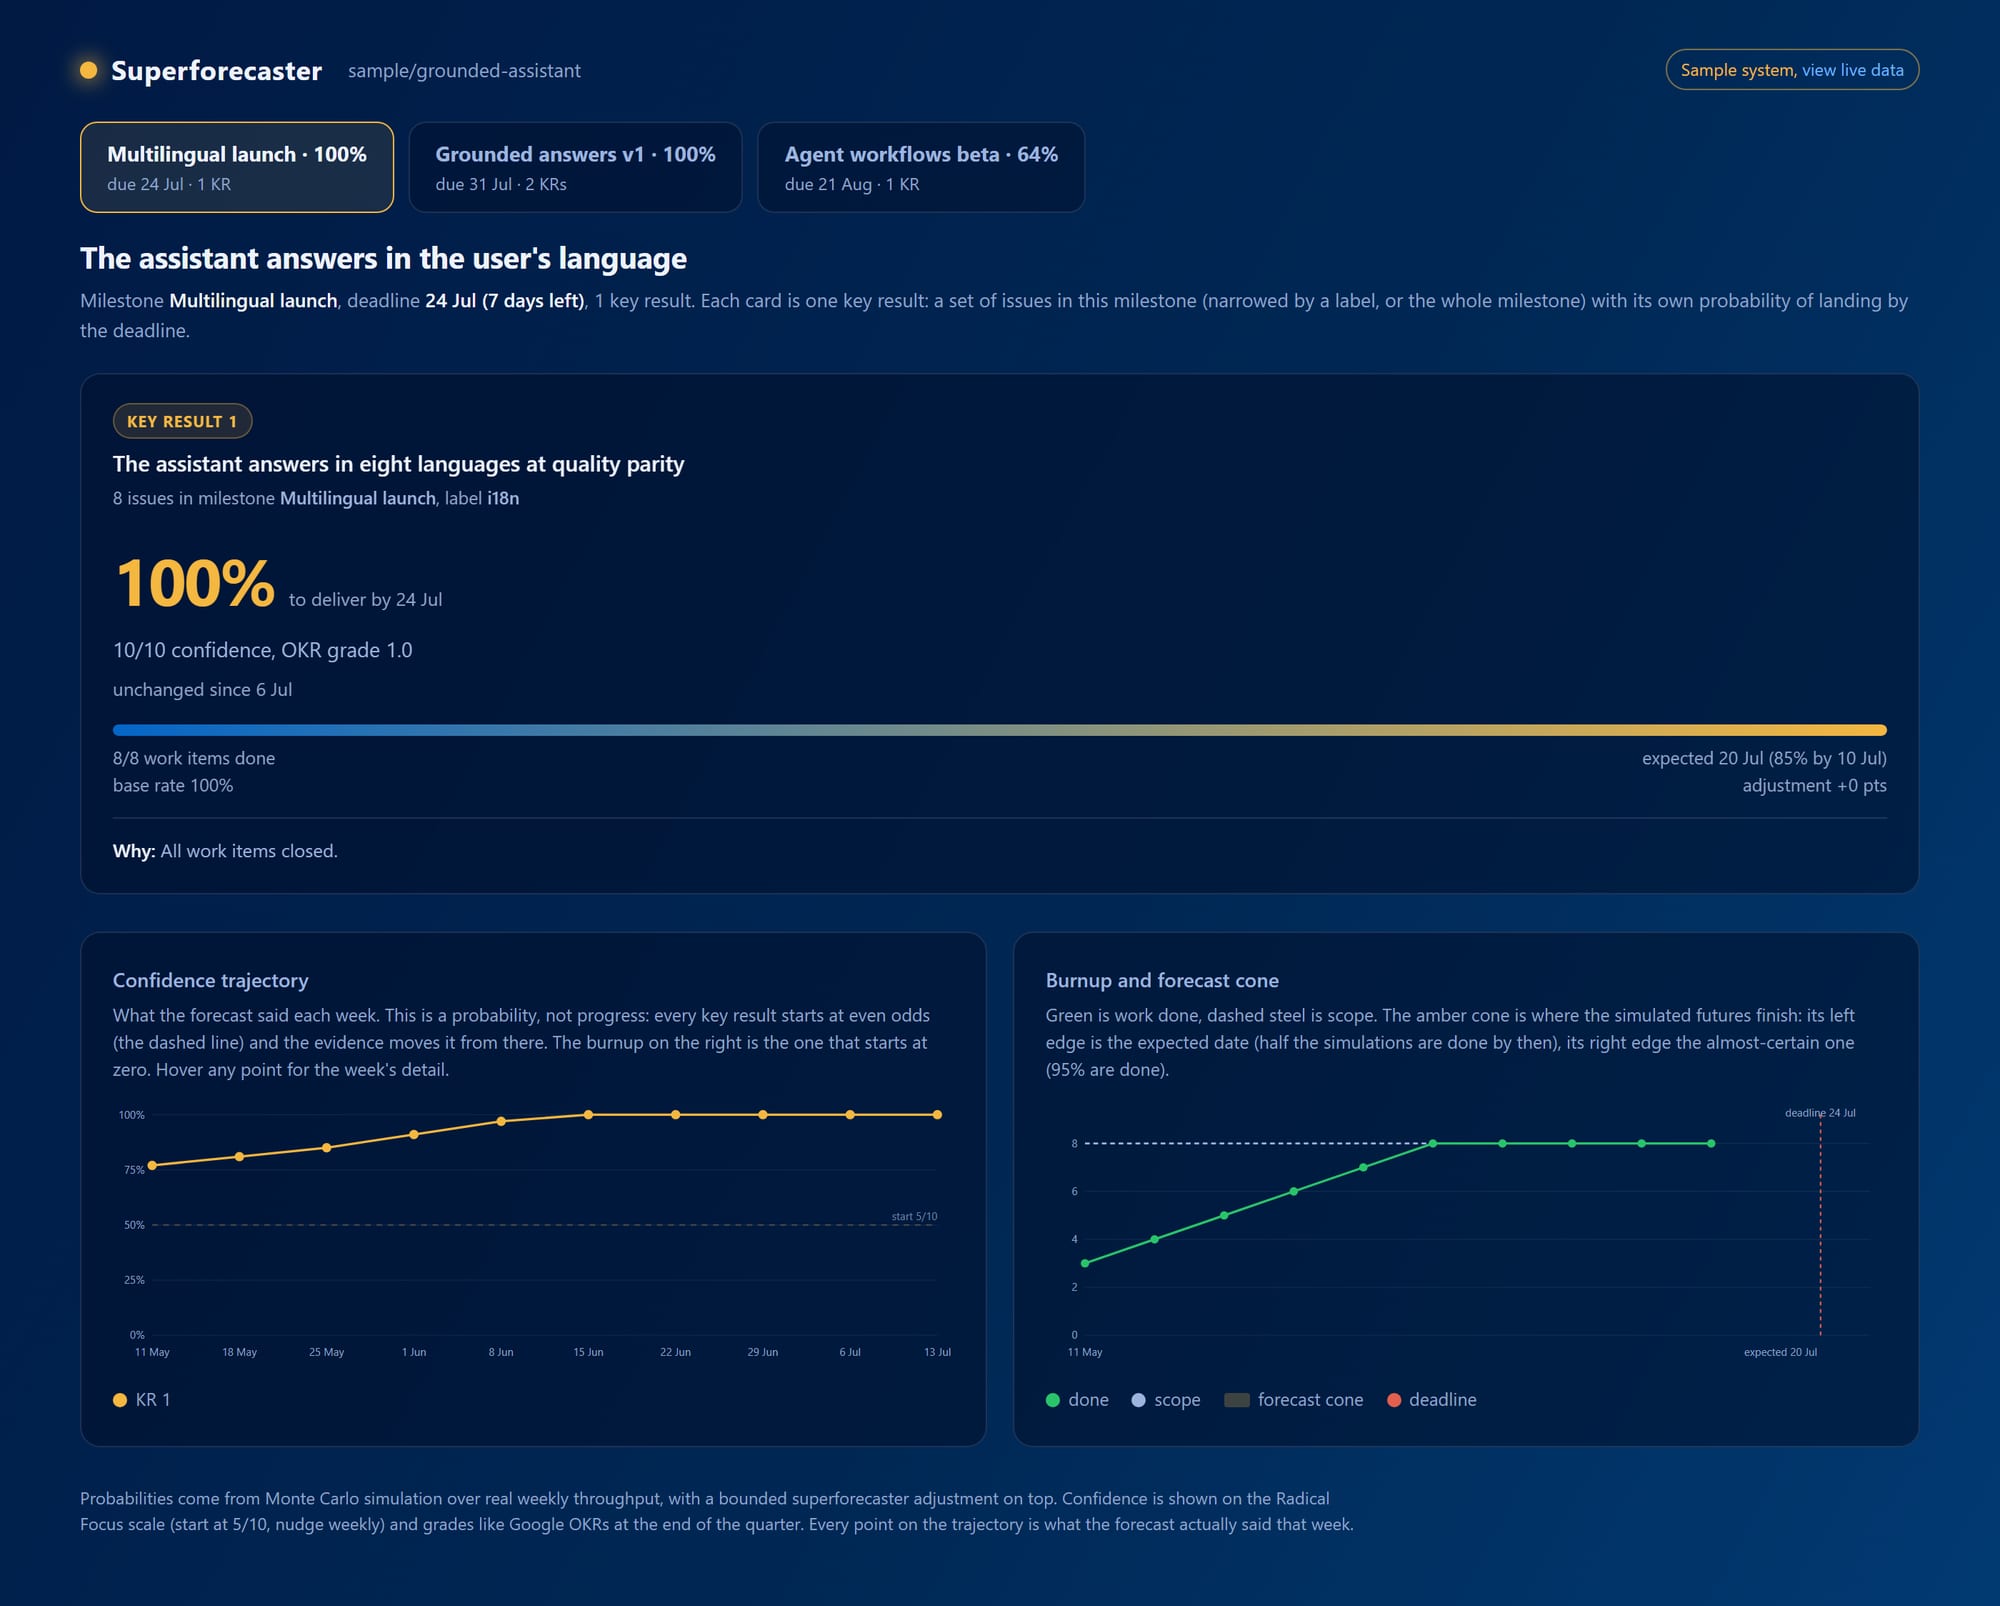
O negócio consulta o dashboard antes da reunião de acompanhamento em vez de perguntar a alguém. Cada key result mostra a sua probabilidade de sair até à data, o movimento da semana, o fim esperado e a razão escrita. O gráfico de trajetória é a linha de confiança dos OKRs tornada real: começa em 50/50 e cada ponto é o que a previsão disse naquela semana, não uma curva redesenhada para ficar bonita na retro. No fim do trimestre a nota de 0,0 a 1,0 sai do histórico em vez de ser negociada numa sala.
A vista que justifica o método todo é a infeliz. É este o aspeto de um milestone em apuros, a partir do sistema de exemplo que vem com o dashboard:
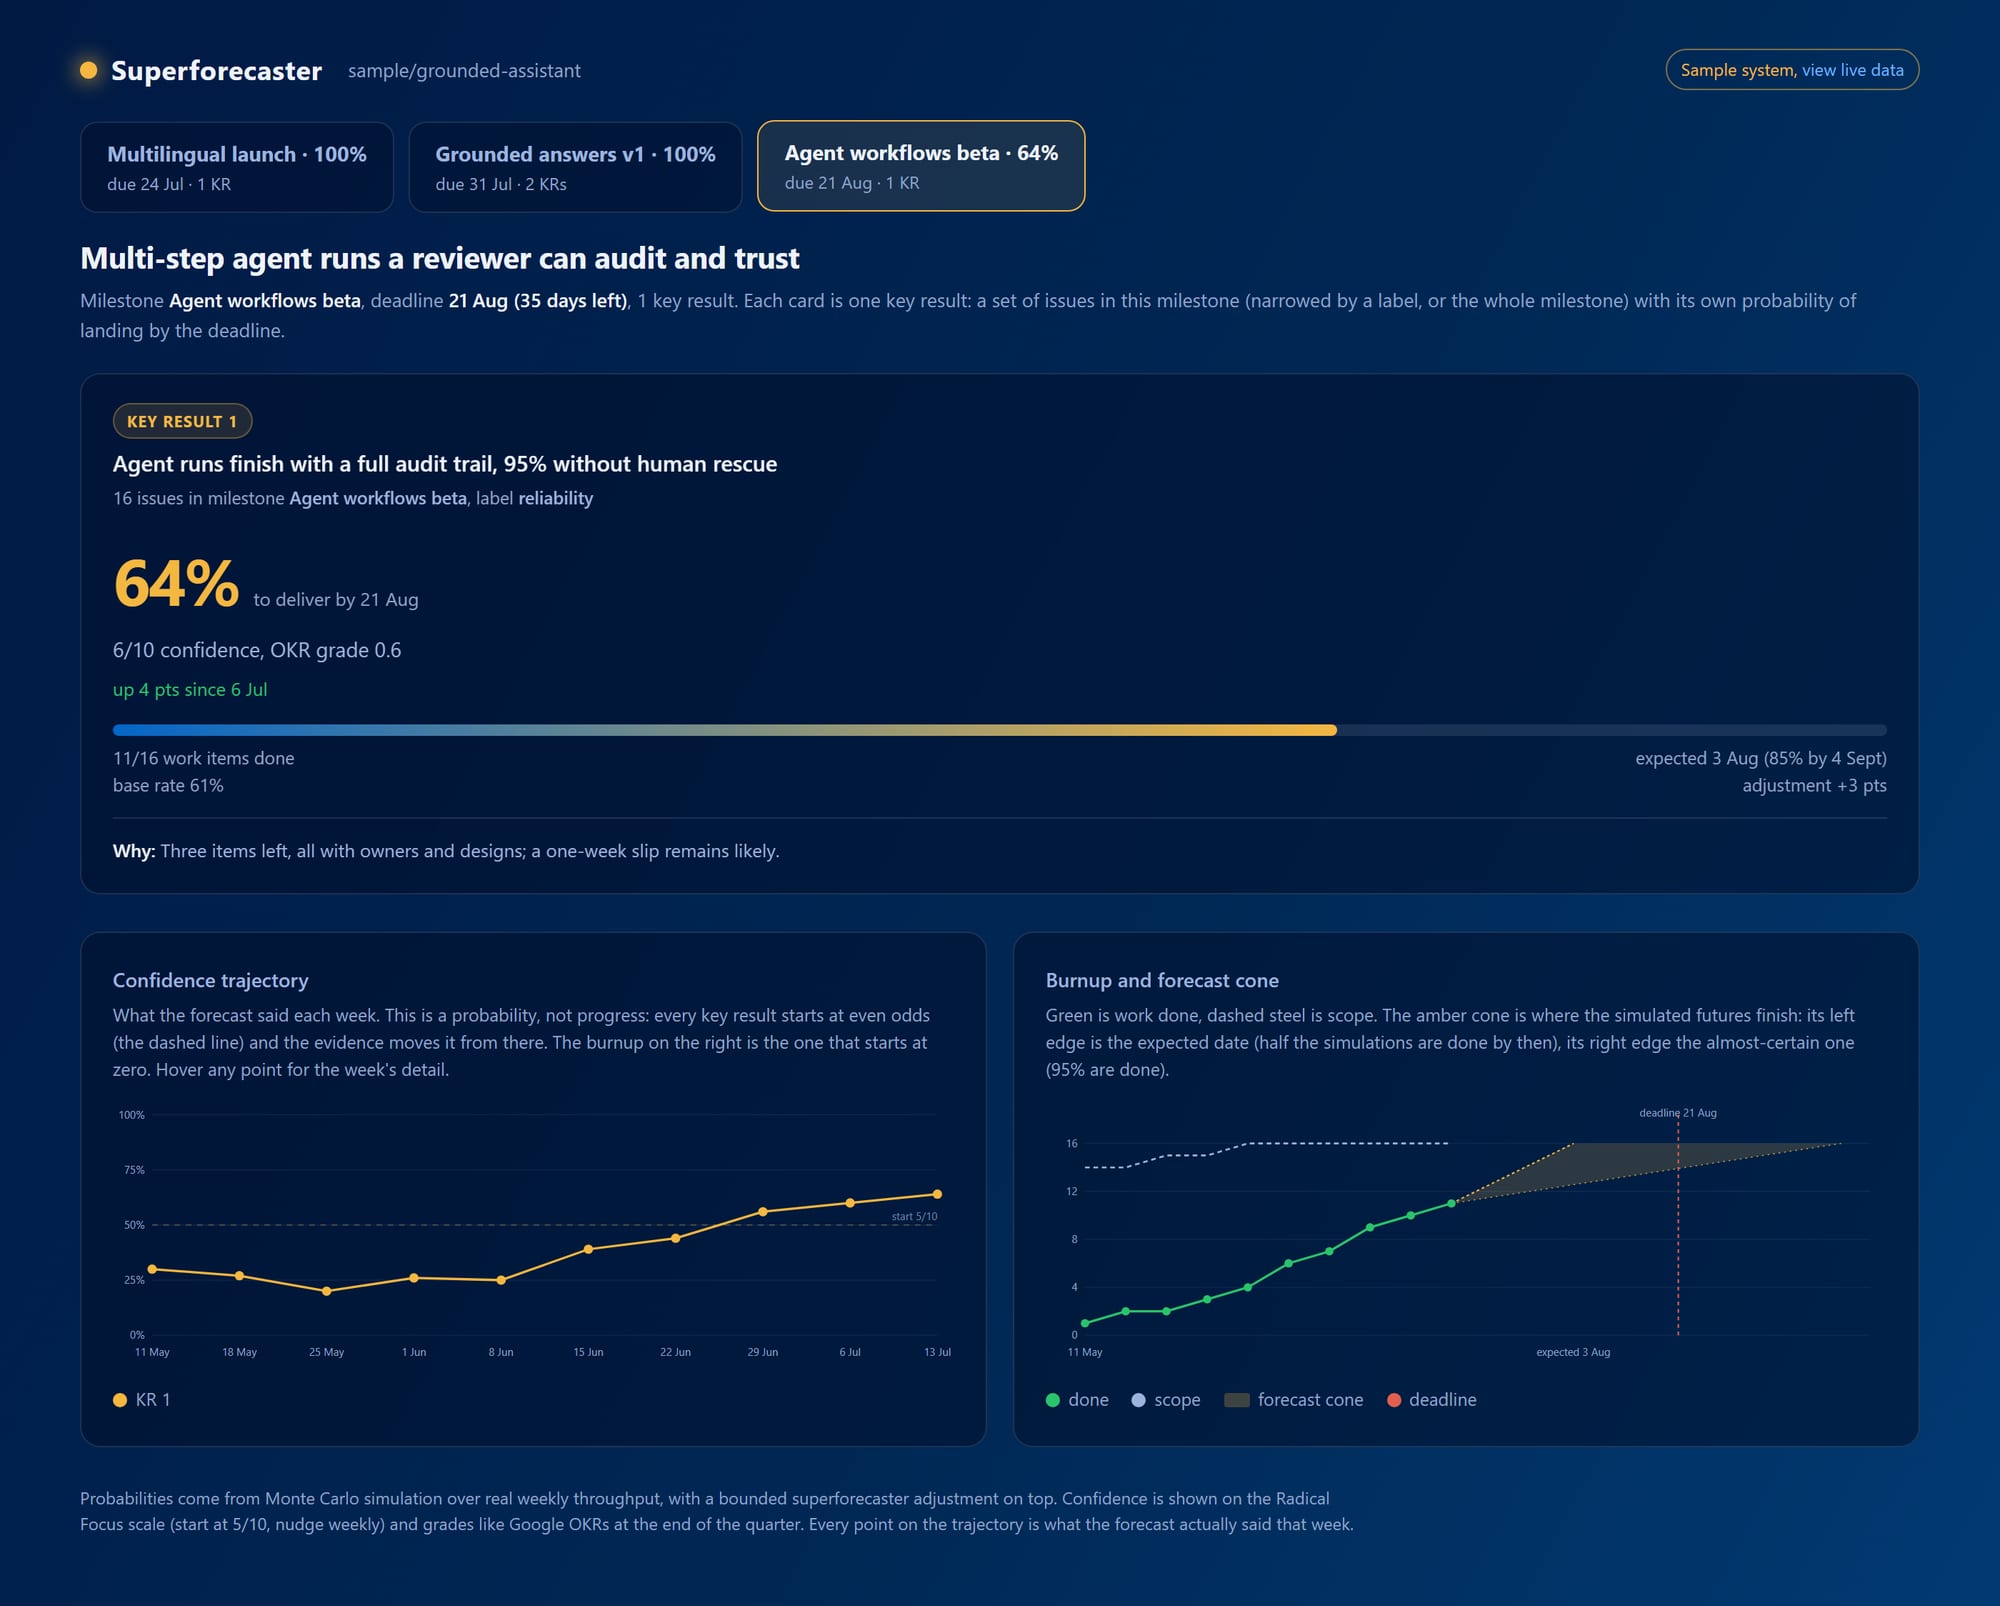
Um key result a 64%, visivelmente em apuros, meses antes de o seu prazo deixar de ser negociável. A linha de confiança passou um mês abaixo do ponto de partida enquanto uma peça de infraestrutura bloqueava tudo o que vinha atrás, e a justificação escrita dizia-o todas as semanas. Ninguém teve de escalar. Ninguém teve de confessar numa reunião. O número desceu, a razão vinha anexada, e a equipa ganhou semanas para agir em vez de uma má surpresa no prazo.
O que a ferramenta me ensinou no primeiro dia
Construí isto como um produto chamado Superforecaster, e a primeira equipa que ele prevê é ele próprio: os seus milestones, as suas issues, os seus check-ins semanais publicados no seu próprio tracker. O dogfooding ensinou-me uma lição em poucas horas. Na primeira execução sem supervisão, anunciou uma probabilidade de 100%, confiança de dez em dez, para um milestone que estava a quatro semanas de distância. A causa foi uma semana quente de issues fechadas e variância nenhuma, que é o pecado mais antigo da previsão: certeza total a partir de uma amostra minúscula. A correção foi fazer com que histórico escasso alargue a incerteza em vez de a estreitar, e apoiar-se na visão de fora até o repositório ter um percurso a sério. Depois da correção, os mesmos dados diziam 35%.
Esse número era desconfortável, e era suposto ser. Uma vibe teria dito "está a correr bem". A previsão disse: a este ritmo, com este âmbito, é provável que falhes. Podes discutir com um 35%, cortar âmbito por causa dele, mexer numa data por causa dele. Não há nada com que discutir num "está no caminho certo". O milestone ainda está aberto enquanto escrevo isto, por isso o registo vai julgar esse 35% da forma como este método julga todas as previsões: pontuado contra o que aconteceu de facto. Até lá é um palpite disciplinado, que já é mais do que uma reunião de estado alguma vez deu a alguém.
O que cada lado ganha
O negócio recebe uma probabilidade que é consistente de semana para semana, porque é sempre o mesmo método a produzi-la, com a razão anexada. Quando a resposta é má, chega cedo o suficiente para mudar o pedido enquanto o trimestre ainda consegue absorver a decisão.
Os programadores recebem uma definição de sucesso que é um link, fixada no início e visível durante todo o trimestre, e quando muda, muda no mesmo sítio onde eles trabalham. Recebem também a sua semana de volta: a previsão lê os commits e as issues, nunca o tempo deles, e agrega ao nível do milestone, por isso o dashboard não carrega números por pessoa para ninguém ficar a olhar.
Os leads saem do negócio de encaminhar informação. O check-in escreve-se sozinho a partir do repositório, por isso o tempo de reunião do lead vai para aquilo que o dashboard trouxe à superfície, a decisão bloqueada, o âmbito que cresceu, em vez de ir para juntar as notícias.
Onde isto falha
Uma probabilidade não é uma promessa, e o método vale o que valer a higiene por baixo dele. Se o trabalho não vive em issues, o forecaster está cego. Se as mudanças de âmbito nunca tocam no milestone, o burnup mente.
Há duas formas de os números apodrecerem, e precisam de curas diferentes. O próprio forecaster pode derivar, e para isso a cura é mecânica: todas as previsões ficam escritas e são pontuadas quando o milestone se resolve, para que o registo mostre se merece crédito. A equipa também o pode manipular, a fechar issues ocas, a partir tickets para inflacionar o ritmo, a tirar âmbito do milestone sem ninguém ver, e nenhuma pontuação apanha isso. O dashboard consegue tornar visíveis as mudanças de âmbito e as issues reabertas, mas a última linha de defesa é a de sempre: uma cultura de revisão onde um fecho vazio não sobrevive. Uma ferramenta não fornece isso. Só consegue tornar a manipulação visível.
As interrupções também não caem a zero. Um número que desce nove pontos numa segunda-feira vai levantar perguntas, e deve levantar. O que muda é onde as perguntas aterram e o que trazem com elas: vão para a issue de acompanhamento, já carregada com a razão, e a conversa começa em "as probabilidades desceram porque o âmbito cresceu, o que cortamos?" em vez de "onde estamos?". Essa é uma conversa que vale a pena ter, com quem quer que seja.
O trimestre começa com pessoas numa sala a concordar sobre o que importa. O trabalho da máquina é tudo o que vem depois: vigia o trabalho e faz as contas, e diz a toda a gente o mesmo número ao mesmo tempo.
Perguntas a que este artigo responde
Como é que se sabe cedo se o trabalho do trimestre vai mesmo sair a horas?
Lendo o repositório em vez de perguntar às pessoas. Um job corre todas as segundas-feiras, pega no que fechou nessa semana e no que entrou no âmbito a meio da semana, reproduz o resto do trimestre dez mil vezes sobre esse ritmo real e reporta a fração de futuros que cumprem o prazo. Histórico escasso tem de alargar a incerteza em vez de a estreitar: na primeira execução sem supervisão a ferramenta anunciou 100% para um milestone que estava a quatro semanas de distância, e depois dessa correção os mesmos dados diziam 35%.
Em que é que isto é diferente dos gráficos de burndown e dos relatórios de velocidade?
Esses consomem os mesmos dados, mas vivem ao nível do sprint, dentro do tooling dos programadores, onde o negócio nunca olha, e produzem gráficos em vez de probabilidades com razões anexadas. Ninguém volta atrás para pontuar um burndown contra o que foi entregue de facto, por isso ninguém sabe dizer se o gráfico do trimestre passado merecia crédito. Aqui todas as previsões ficam escritas e são pontuadas quando o milestone se resolve, e a camada de modelo que lê as issues abertas pode mexer no número no máximo quinze pontos, com o raciocínio publicado e o ajuste pontuado em separado da previsão bruta.
O que impede uma equipa de manipular a previsão a fechar issues vazias?
Nada dentro da ferramenta, e vale a pena dizê-lo. A pontuação apanha o forecaster a derivar, mas não apanha fechos ocos, tickets partidos para inflacionar o ritmo, nem âmbito tirado do milestone sem ninguém ver. O dashboard consegue tornar visíveis as mudanças de âmbito e as issues reabertas; a última linha de defesa é a de sempre, uma cultura de revisão onde um fecho vazio não sobrevive.
Isto acaba por medir os programadores um a um?
Não. A previsão lê os commits e as issues, nunca o tempo de ninguém, e agrega ao nível do milestone, por isso o dashboard não carrega números por pessoa para ninguém ficar a olhar. O que os programadores recebem em troca é uma definição de sucesso que é um link, fixada no início do trimestre e visível do princípio ao fim, e as tardes de volta que gastavam a escrever estados que ninguém pontua.
Ler a seguir
 AI
Quando a IA tem de filmar a sua própria revisão
Quando é aberto um pull request, meu ou um que tenho de rever, passei a pedir ao agente que o corra na minha máquina, que tente parti-lo e que se filme a fazê-lo. Um parágrafo pode afirmar que houve um teste. Uma gravação tem de o mostrar, e decidir o que isso significa continua a ser trabalho meu. AI
O Jev responde em probabilidades. A pergunta continua a ser tua.
O Jev, da TypeSafe, não escreve uma frase. Entregas-lhe um estado e perguntas tipadas, e ele devolve uma escolha, uma pontuação ou uma probabilidade de sim ou não, por quatro milésimos de cêntimo numa decisão de mil tokens. A novidade é a forma, que devolve a autoridade ao teu código, e a armadilha é que uma probabilidade parece recurso e não é. Corri o piloto que eu quereria ver antes de acreditar em qualquer número, nos meus próprios ensaios com o modelo aberto que fez as vezes do Jev, e a resposta foi não.