
Saber qué vas a recibir, saber qué construir
Escuchar el artículo (experimental) · 14:23
En algún punto por encima de todo equipo de ingeniería hay una persona que necesita un número: ¿esto llega para el final del trimestre? Y la maquinaria que produce ese número es notable. Esa persona pregunta a un lead. En una buena semana, el lead ya lo sabe. El resto de las semanas, se interrumpe a dos desarrolladores a mitad de faena para que produzcan una estimación de cortesía. En cualquier caso, la respuesta se redondea hacia arriba al atravesar cada capa, porque nadie quiere cargar con malas noticias, y lo que llega arriba es una sensación disfrazada de porcentaje. Tres semanas después la fecha se retrasa y todo el mundo hace como que se sorprende.
Todos los de esa cadena pierden algo. El lead se convierte en un enrutador de estados en lugar de la persona que quita obstáculos, y hasta el lead que lo sabe está reportando un recuerdo, no una medición. Los desarrolladores, cuando la pregunta llega hasta ellos, pagan con una tarde por un informe que el viernes ya estará desfasado. Quien preguntó sigue sin tener un número sobre el que actuar, porque "creemos que va bien" no es un número.
Creo que la solución es un método que funciona, y construí la herramienta que lo ejecuta. El objetivo no es tener menos preguntas, sino que ambos lados miren por fin lo mismo: el negocio sabiendo, en cualquier momento, cuán probable es que reciba lo que pidió, y los desarrolladores sabiendo, desde el primer día, exactamente qué tienen que construir y cómo se va a juzgar.
De dónde viene el método
La primera pieza viene de cómo trabajan ya los mejores equipos de OKR. Al estilo de Radical Focus, cada key result empieza el trimestre con una confianza de cinco sobre diez, y el check-in semanal empuja esa confianza hacia arriba o hacia abajo según lo que haya pasado de verdad. Google puntúa los OKRs de 0,0 a 1,0 al final del trimestre. Ese ritual trata el estado de un key result como una probabilidad, revisada cada semana, no como una lista de actividades.
La segunda pieza viene de la investigación sobre forecasting. Los mejores forecasters se diferencian del resto en el comportamiento, no en la inteligencia ni en la información privilegiada: actualizan a menudo y en pasos pequeños, y se anclan en tasas base, en lo que suele pasar, antes de tocar lo que parece distinto esta vez. Actualizaciones pequeñas y frecuentes sobre una tasa base es, casi palabra por palabra, el check-in semanal de OKR bien hecho.
Ponlos uno al lado del otro: el check-in semanal es un ejercicio de forecasting. Los equipos lo hacen a mano, en una reunión, de memoria, y quien sostiene el rotulador suele ser la persona más optimista de la sala. Mientras tanto, la tasa base, el ritmo real del equipo, está en el repositorio, registrada al segundo, y nadie la pide nunca.
Las herramientas del repositorio tampoco cierran esa distancia. Los gráficos de burndown y los informes de velocity consumen los mismos datos, pero viven a nivel de sprint, dentro del tooling de los desarrolladores, donde el negocio nunca mira. Producen gráficos, no probabilidades con sus razones adjuntas. Y nadie vuelve atrás a puntuar un burndown contra lo que se entregó de verdad, así que nadie te puede decir si el gráfico del trimestre pasado merecía que se le creyera.
El marco
La propuesta no añade reuniones nuevas, aunque sí exige la higiene de issues que la mayoría de los equipos dice tener ya. Necesita una reunión que ya existe y un job que se ejecuta solo.
Al principio del trimestre, los leads del equipo se sientan con el negocio y fijan los objetivos. Esa parte no cambia. Lo que cambia es lo que viene después: cada objetivo se descompone en key results, y cada key result se codifica donde vive el trabajo de verdad, como un milestone de GitHub con fecha límite, o como una porción etiquetada de uno cuando un milestone lleva varios. Un key result deja de ser un eslogan en una diapositiva y pasa a ser un conjunto de issues en el que puedes hacer clic.
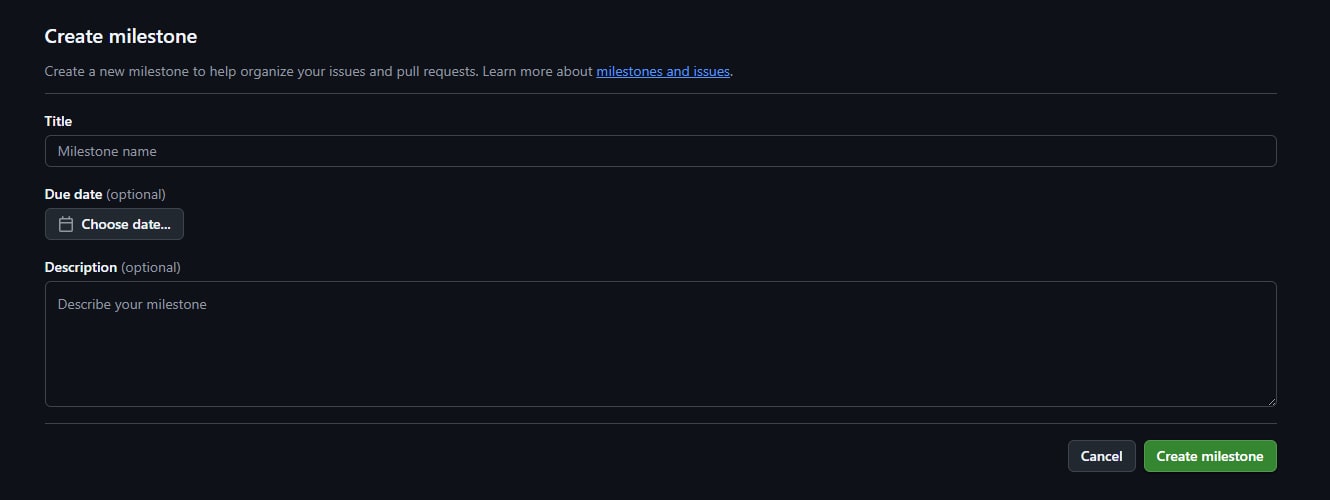
La parte de GitHub es aburrida a propósito. Un milestone con fecha de vencimiento es un formulario pequeño:
Una label por key result es otro formulario, junto a las que ya tiene cualquier repositorio:
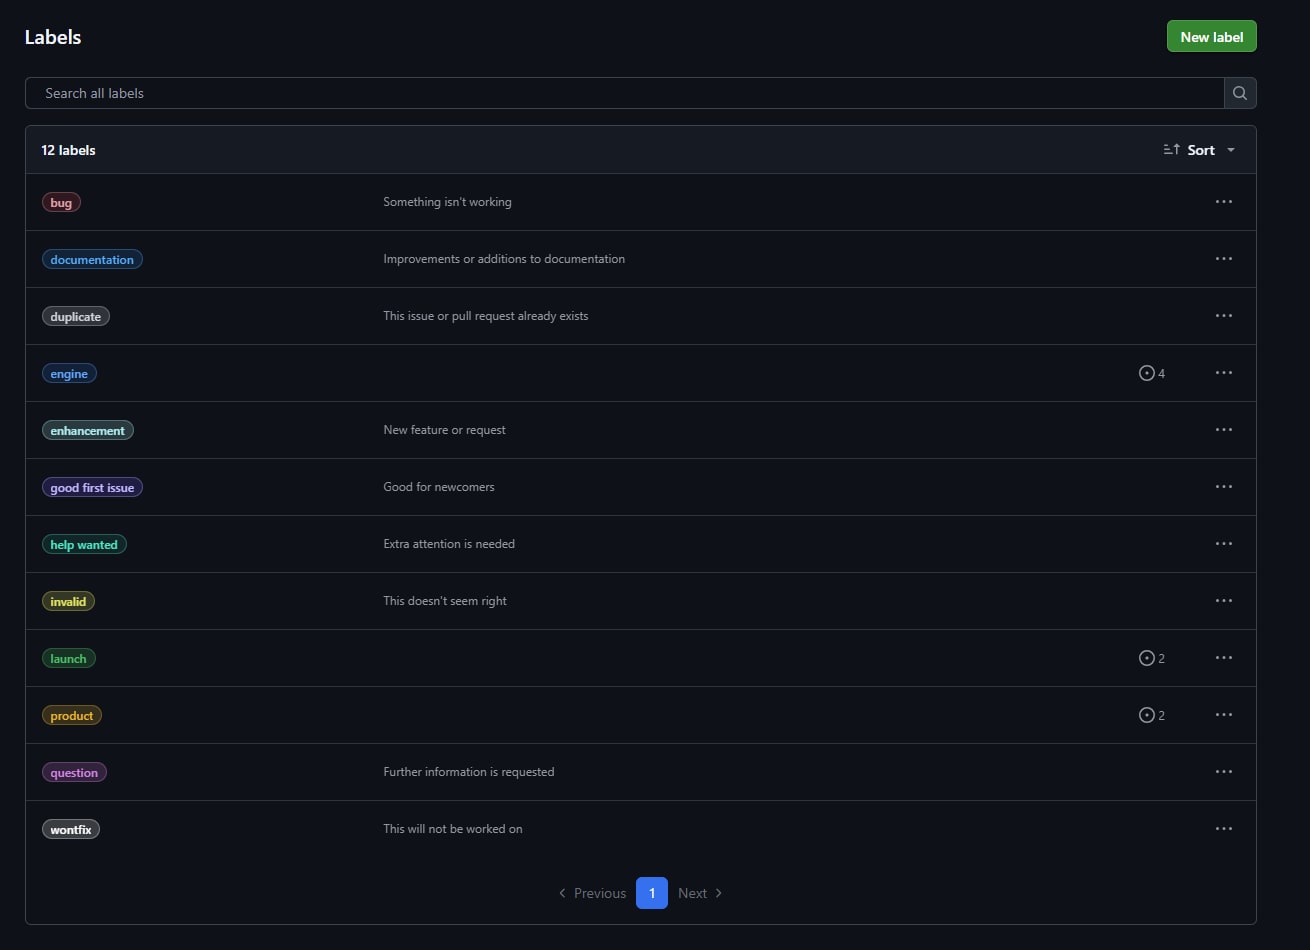
Las issues recogen ambas cosas durante el triaje normal, el milestone y la label de su key result. Un archivo de configuración corto le dice entonces al forecaster y al dashboard cómo leerlas: qué objetivo es dueño de qué milestone, qué label lo divide en key results y qué issue recibe el comentario semanal.
repo: tiago-peres/superforecaster
milestones:
  - milestone: v1.0
    objective: Ship Superforecaster v1
    deadline: 2026-08-14
    krs:
      - id: engine
        name: Forecast engine turns a milestone into a calibrated P(delivery)
        label: engine
        tracking_issue: 1
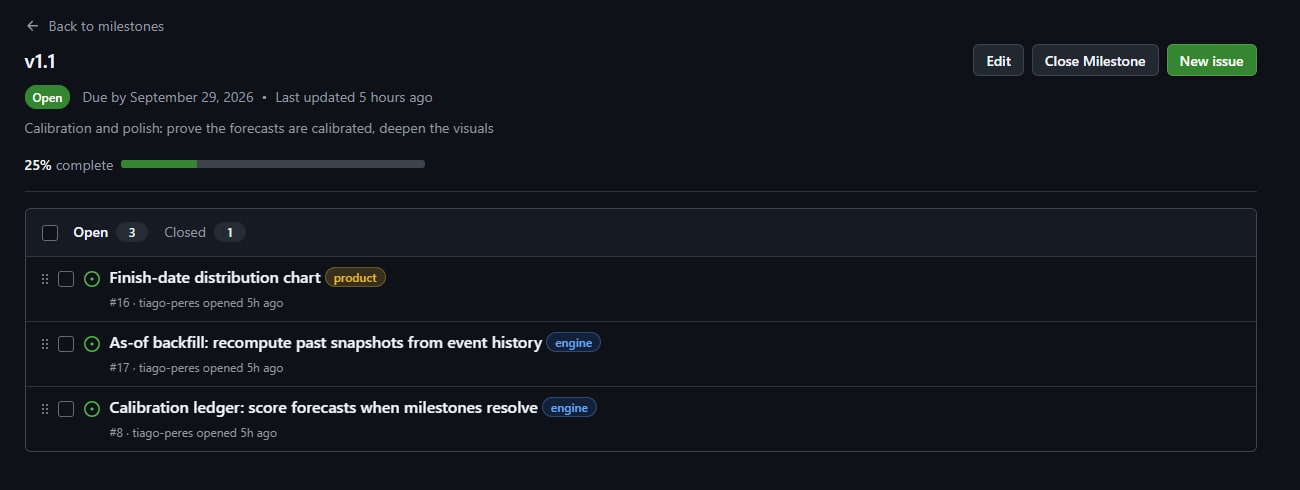
Eso es toda la configuración. Abre después el milestone y ya se lee como la promesa que es: una fecha de vencimiento, una barra de progreso y cada tarea pendiente llevando la label de su key result, visible para quien quiera mirar. Terminado significa estas issues, cerradas, para esta fecha.
Un límite antes de seguir: esto cubre key results de entrega, alcance que se entrega en una fecha. Un key result de métrica, adopción, ingresos, latencia, necesita la propia métrica como fuente, y ninguna aritmética de issues la sustituye. Pero los compromisos de entrega del trimestre son donde vive la ansiedad de si esto se entregará o no, y ahí las issues son el trabajo, y el trabajo es lo que un forecast puede vigilar.
Después, durante el trimestre, nadie escribe estados. Un job se ejecuta cada lunes y hace lo que la sala fingía hacer. Lee el repositorio: qué se cerró esta semana, qué entró en el alcance a mitad de semana, el ritmo semanal real. Reproduce el resto del trimestre diez mil veces sobre ese ritmo, Monte Carlo sobre el throughput real, e informa de la fracción de futuros que llegan a la fecha límite. Cuando un repositorio es demasiado joven para tener ritmo propio, el forecaster toma prestada la distribución del repositorio anterior del equipo, un prior deliberadamente débil que se mantiene solo hasta que se acumula historia real. Y la nitidez del forecast sigue la descomposición del backlog: mientras la mitad del alcance siga siendo épicas, el cono es ancho, y así debe ser.
Encima de las matemáticas, un modelo lee las issues abiertas como lo haría un revisor, buscando el riesgo que los números no pueden ver, el ticket que en realidad es investigación sin límites, la dependencia de una decisión que nadie ha tomado. Puede mover la probabilidad como mucho quince puntos, su razonamiento se publica junto al número, y su forecast ajustado se puntúa por separado del forecast en bruto, de modo que el registro muestra si la capa de juicio se gana el sueldo. Después, el job publica un comentario por key result en su issue de seguimiento: la probabilidad, cómo se ha movido desde la semana pasada, qué la ha movido y por qué.
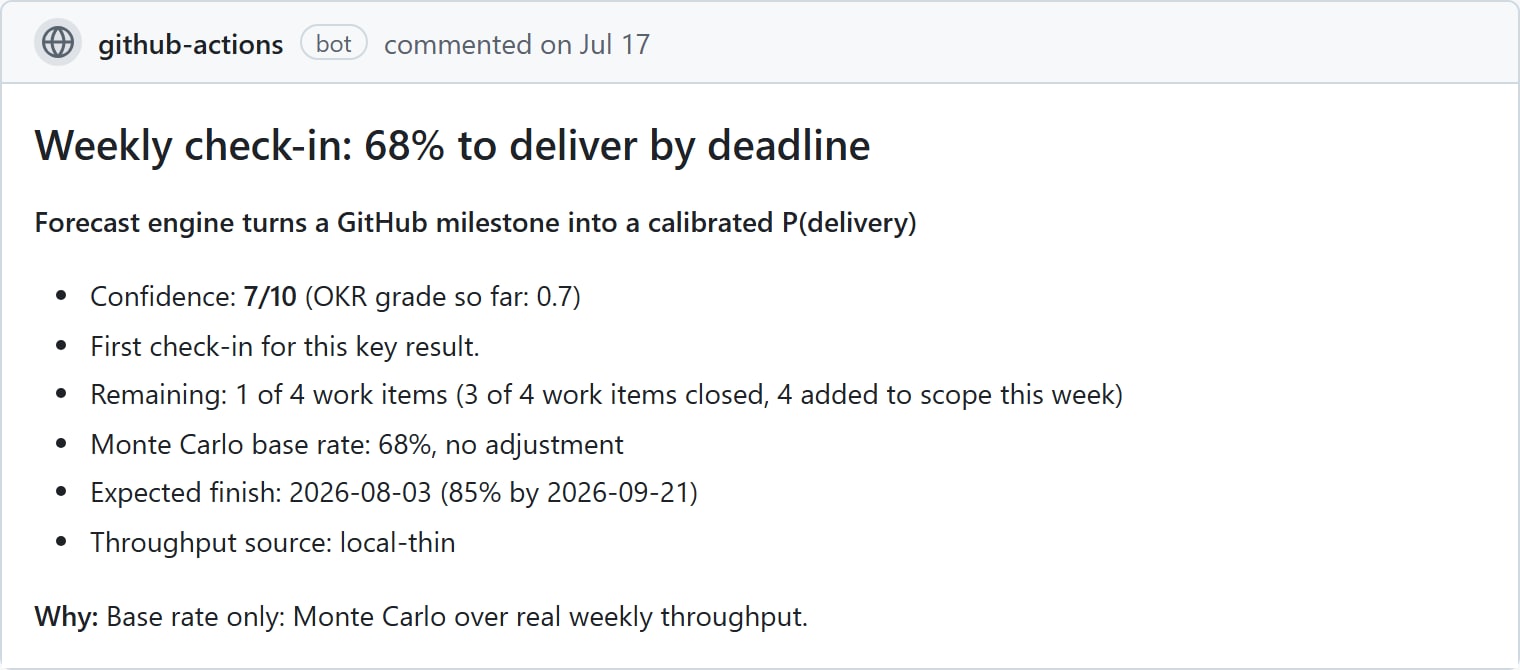
Y el dashboard es donde aterriza todo, para todo el mundo, en cualquier momento.
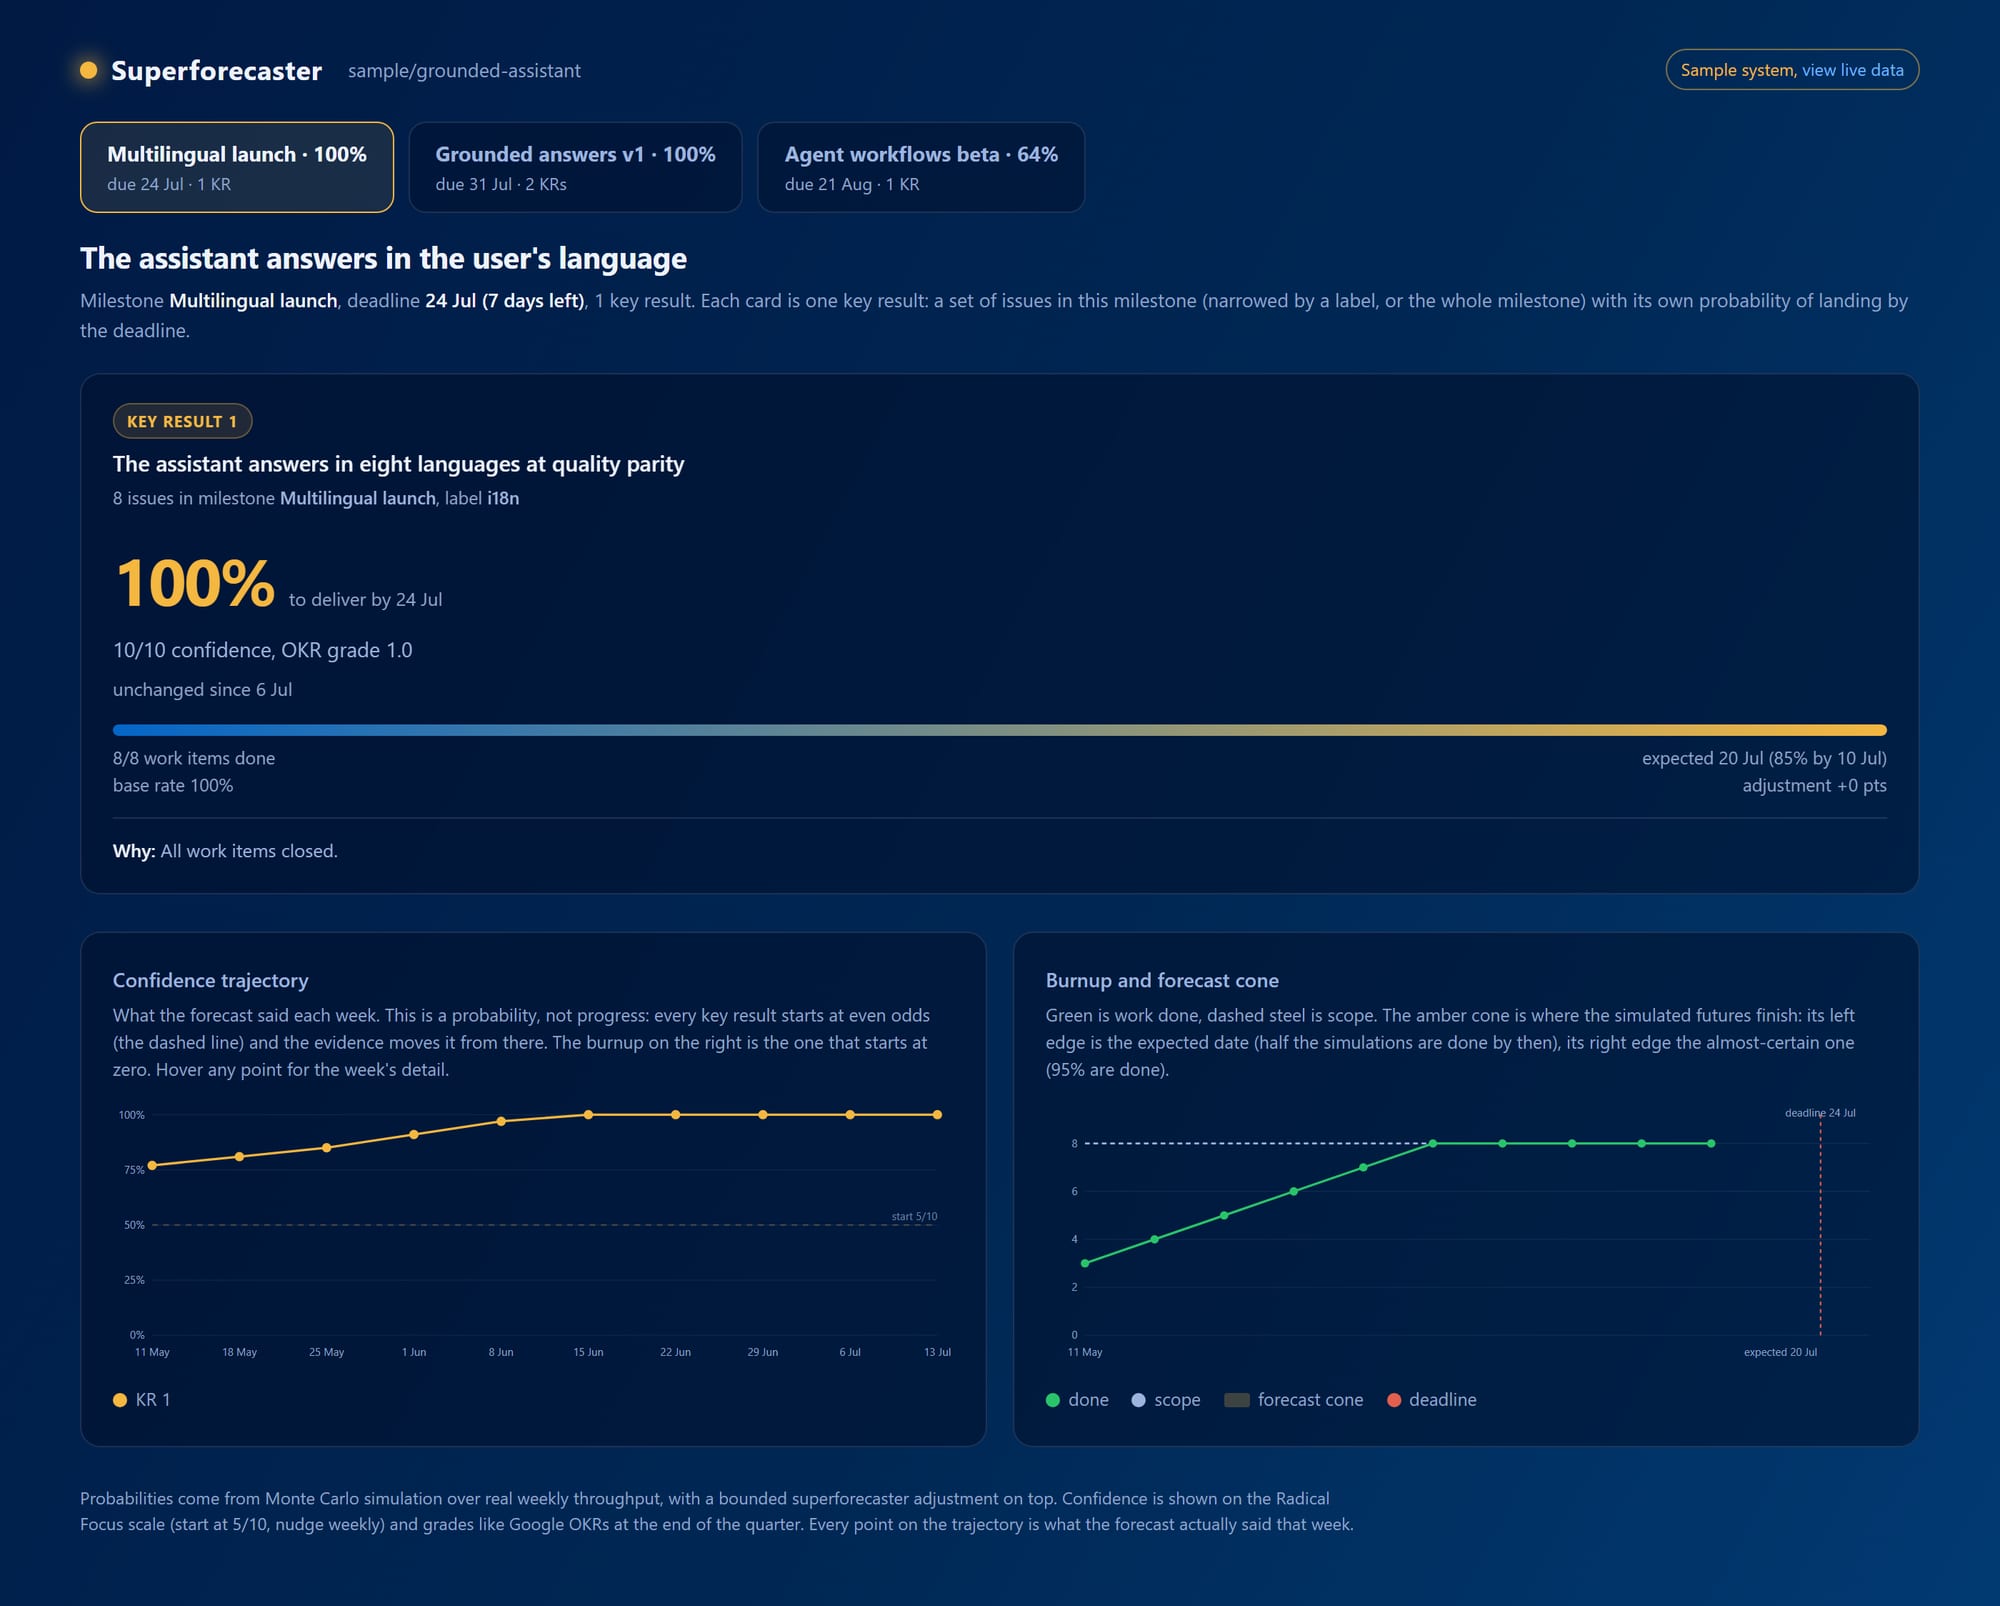
El negocio mira el dashboard antes de la reunión de seguimiento en vez de preguntar a nadie. Cada key result muestra su probabilidad de llegar en su fecha, el movimiento de la semana, el final previsto y la razón escrita. El gráfico de trayectoria es la línea de confianza de los OKRs hecha realidad: arranca al cincuenta por ciento y cada punto es lo que dijo el forecast esa semana, no una curva redibujada para que quede bonita en la retro. Al final del trimestre, la nota de 0,0 a 1,0 sale del historial en lugar de negociarse en una sala.
La vista que justifica todo el método es la desagradable. Así se ve un milestone en apuros, en el sistema de ejemplo que viene con el dashboard:
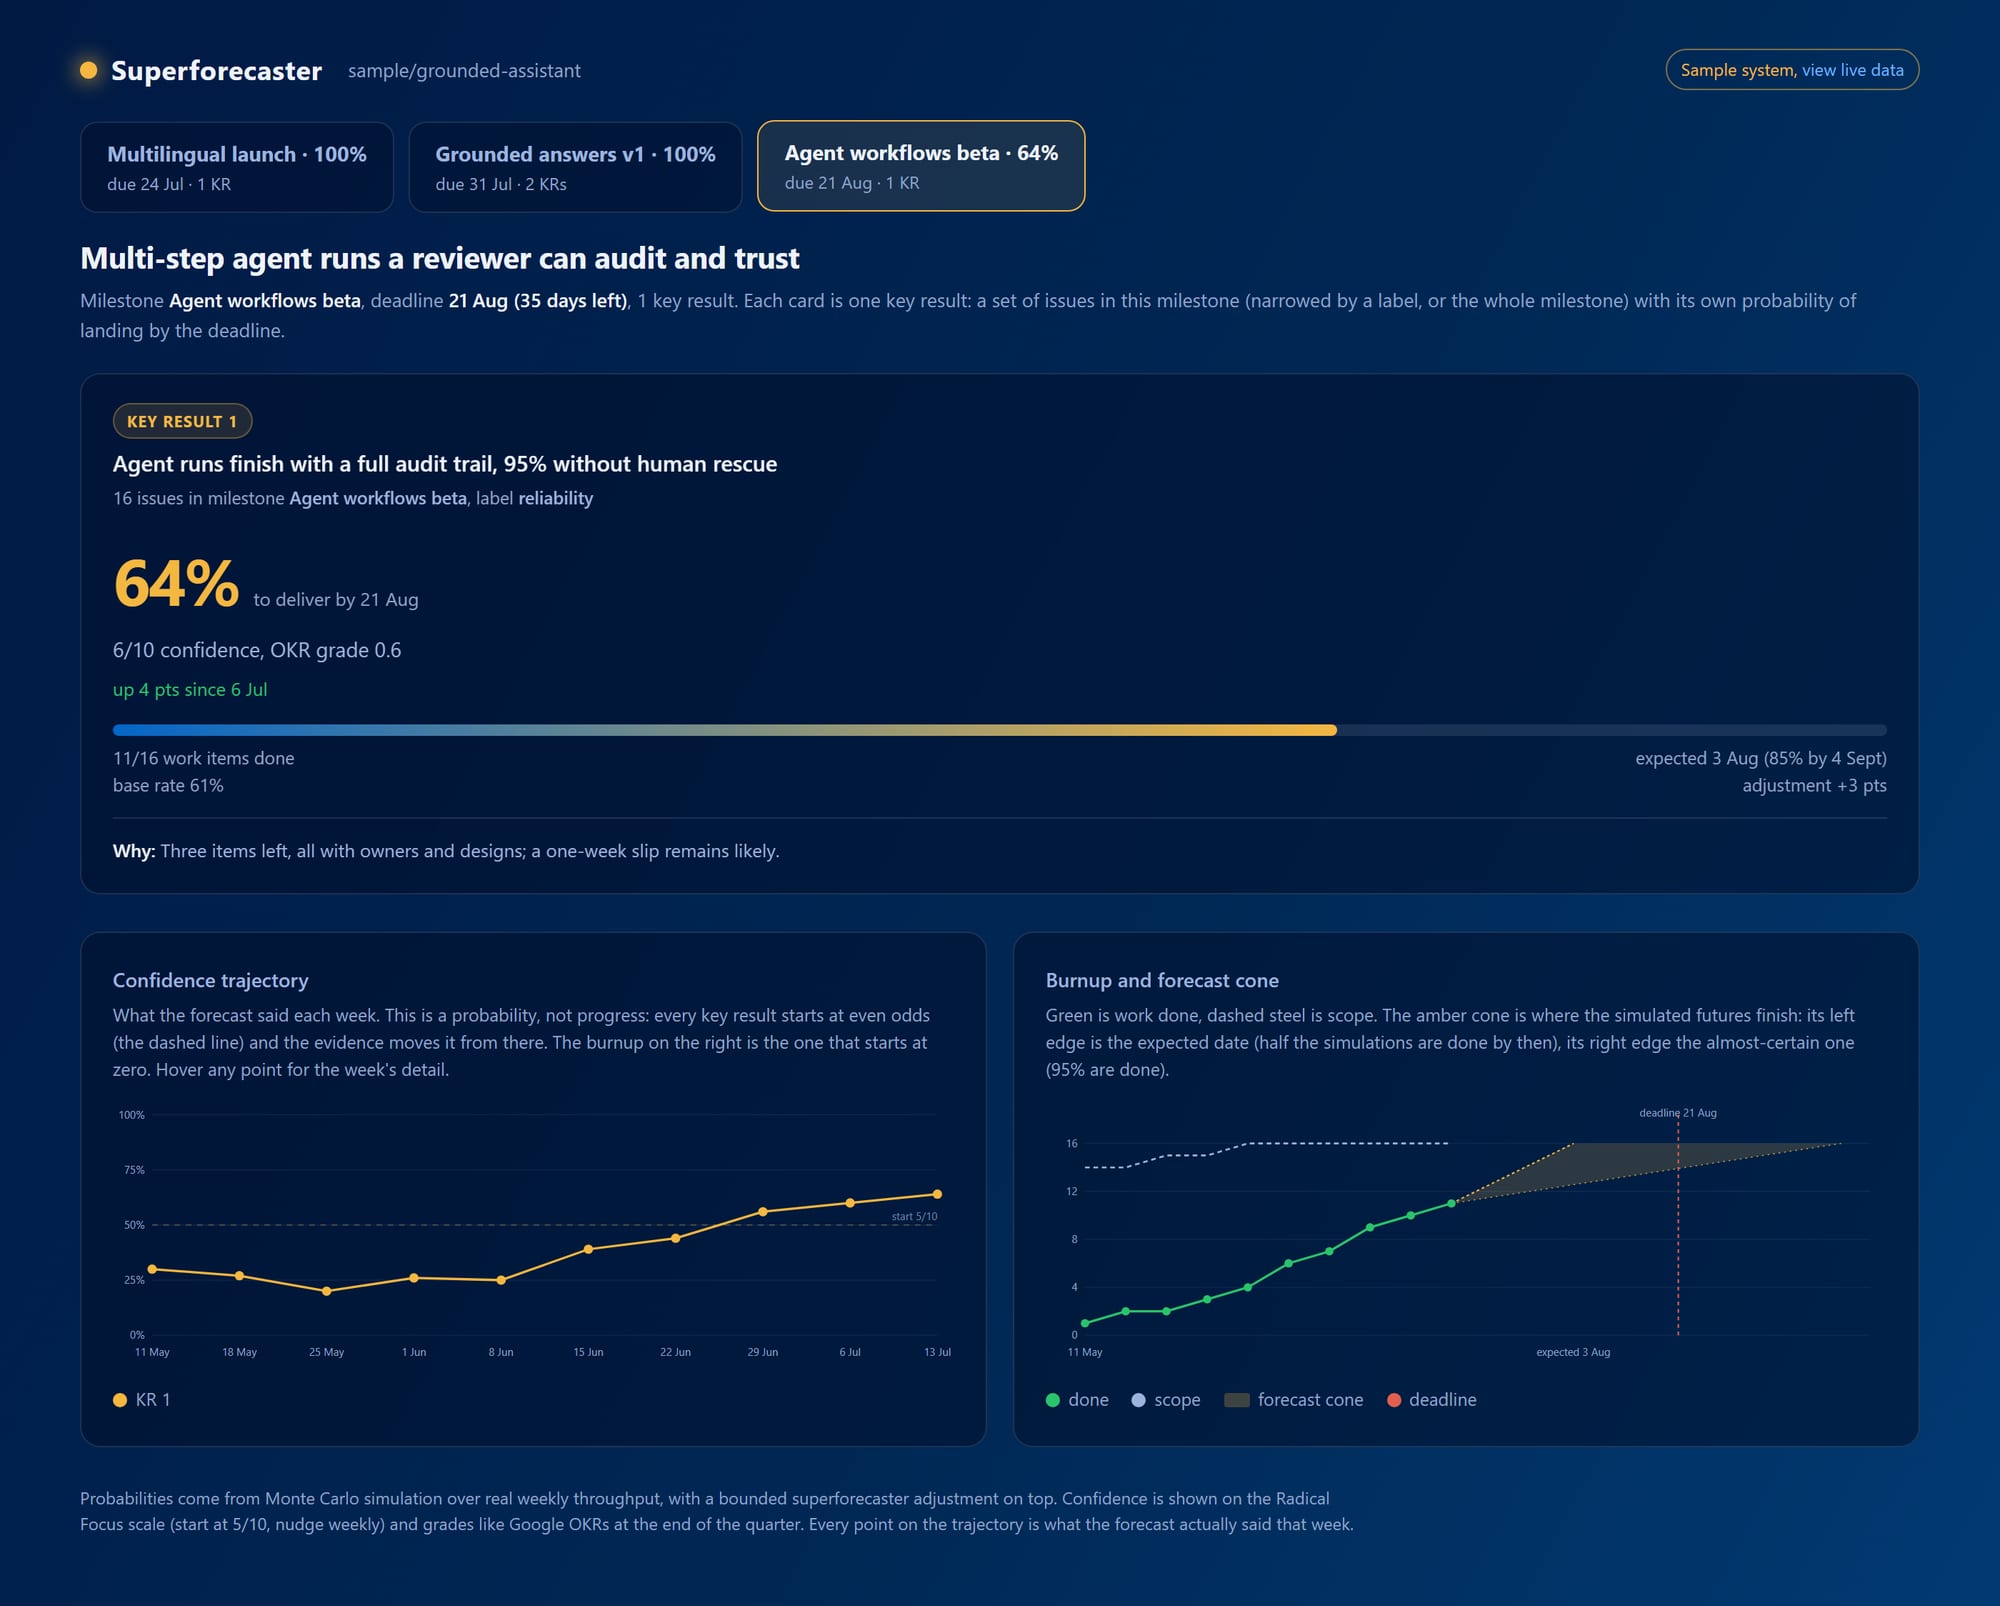
Un key result al 64 %, visiblemente en apuros, meses antes de que su fecha límite deje de ser negociable. La línea de confianza pasó un mes por debajo de su punto de partida mientras una pieza de infraestructura bloqueante retenía todo lo que venía detrás, y la justificación escrita lo decía cada semana. Nadie tuvo que escalar nada. Nadie tuvo que confesar en una reunión. El número bajó, la razón venía adjunta, y el equipo tuvo semanas para actuar en vez de una mala sorpresa en la fecha límite.
Lo que la herramienta me enseñó el primer día
Construí esto como un producto llamado Superforecaster, y el primer equipo sobre el que hace forecast es él mismo: sus propios milestones, sus propias issues, sus propios check-ins semanales publicados en su propio tracker. El dogfooding me dio una lección en cuestión de horas. En su primera ejecución sin supervisión, anunció una probabilidad del 100 %, diez sobre diez de confianza, para un milestone que estaba a cuatro semanas. La causa fue una semana especialmente buena de issues cerradas y ninguna varianza, que es el pecado más viejo del forecasting: certeza total a partir de una muestra minúscula. El arreglo fue hacer que un historial escaso ensanche la incertidumbre en lugar de estrecharla, y apoyarse en la visión externa hasta que el repositorio tenga un historial real. Después del arreglo, los mismos datos dijeron 35 %.
Ese número era incómodo, y tenía que serlo. Una sensación habría dicho "va bien". El forecast dijo: a este ritmo, con este alcance, probablemente no llegas. Con un 35 % puedes discutir, puedes recortar alcance frente a él, puedes mover una fecha por él. Con "va según lo previsto" no hay nada que discutir. El milestone sigue abierto mientras escribo esto, así que el registro juzgará ese 35 % igual que este método juzga cada forecast: puntuándolo contra lo que pasó de verdad. Hasta entonces es una estimación disciplinada, que ya es más de lo que jamás dio a nadie una reunión de estado.
Lo que gana cada lado
El negocio obtiene una probabilidad que es consistente de una semana a otra, porque la produce el mismo método cada vez, con la razón adjunta. Cuando la respuesta es mala, llega con tiempo suficiente para cambiar lo que se pide mientras el trimestre todavía puede absorber la decisión.
Los desarrolladores obtienen una definición de éxito que es un enlace, fijada al principio y visible todo el trimestre, y cuando cambia, cambia en el mismo sitio donde trabajan. También recuperan su semana: el forecast lee sus commits y sus issues, nunca su tiempo, y agrega a nivel de milestone, así que el dashboard no lleva números por persona a los que quedarse mirando.
Los leads dejan de hacer de enrutadores. El check-in se escribe solo desde el repositorio, así que el tiempo de reunión del lead se va a lo que sacó a la superficie el dashboard, la decisión bloqueada, el alcance que creció, en lugar de a montar el parte de novedades.
Dónde se rompe esto
Una probabilidad no es una promesa, y el método vale lo que vale la higiene que hay debajo. Si el trabajo no vive en issues, el forecaster está ciego. Si los cambios de alcance nunca tocan el milestone, el burnup miente.
Hay dos formas de que los números se pudran, y necesitan curas distintas. El propio forecaster puede desviarse, y para eso la cura es mecánica: cada forecast se anota y se puntúa cuando el milestone se resuelve, de modo que el registro muestra si merece que se le crea. El equipo también puede hacer trampas, cerrando issues huecas, partiendo tickets para inflar el ritmo, sacando alcance del milestone sin que nadie mire, y ninguna puntuación pilla eso. El dashboard puede hacer visibles los cambios de alcance y las issues reabiertas, pero la última línea de defensa es la de siempre: una cultura de revisión donde un cierre vacío no sobrevive. Una herramienta no puede aportar eso. Solo puede hacer visibles las trampas.
Las interrupciones tampoco bajan a cero. Un número que cae nueve puntos un lunes va a generar preguntas, y debe generarlas. Lo que cambia es dónde aterrizan esas preguntas y qué llevan encima: van a la issue de seguimiento, ya cargada con la razón, y la conversación empieza en "la probabilidad bajó porque creció el alcance, ¿qué recortamos?" en lugar de "¿por dónde vamos?". Esa es una conversación que merece la pena tener, con quien sea.
El trimestre empieza con personas en una sala poniéndose de acuerdo en lo que importa. El trabajo de la máquina es todo lo que viene después: vigila el trabajo y hace la aritmética, y le dice a todo el mundo el mismo número al mismo tiempo.
Preguntas que responde este artículo
¿Cómo saber pronto si el trabajo del trimestre se va a entregar a tiempo?
Leyendo el repositorio en lugar de preguntar a la gente. Un job se ejecuta cada lunes, toma lo que se cerró esa semana y lo que entró en el alcance a mitad de semana, reproduce el resto del trimestre diez mil veces sobre ese ritmo real e informa de la fracción de futuros que llegan a la fecha límite. Un historial escaso tiene que ensanchar la incertidumbre en vez de estrecharla: en su primera ejecución sin supervisión la herramienta anunció un 100 % para un milestone que estaba a cuatro semanas, y después de ese arreglo los mismos datos dijeron 35 %.
¿En qué se diferencia esto de los gráficos de burndown y los informes de velocity?
Esos consumen los mismos datos, pero viven a nivel de sprint, dentro del tooling de los desarrolladores, donde el negocio nunca mira, y producen gráficos en lugar de probabilidades con sus razones adjuntas. Nadie vuelve atrás a puntuar un burndown contra lo que se entregó de verdad, así que nadie te puede decir si el gráfico del trimestre pasado merecía que se le creyera. Aquí cada forecast se anota y se puntúa cuando el milestone se resuelve, y la capa de modelo que lee las issues abiertas puede mover el número como mucho quince puntos, con su razonamiento publicado y su ajuste puntuado por separado del forecast en bruto.
¿Qué impide que un equipo haga trampas cerrando issues vacías?
Nada dentro de la herramienta, y ese es el límite que conviene decir en voz alta. La puntuación pilla al forecaster desviándose, pero no pilla cierres huecos, tickets partidos para inflar el ritmo ni alcance sacado del milestone sin que nadie mire. El dashboard puede hacer visibles los cambios de alcance y las issues reabiertas; la última línea de defensa es la de siempre, una cultura de revisión donde un cierre vacío no sobrevive.
¿Esto acaba midiendo a cada desarrollador?
No. El forecast lee los commits y las issues, nunca el tiempo de nadie, y agrega a nivel de milestone, así que el dashboard no lleva números por persona a los que quedarse mirando. Lo que los desarrolladores reciben a cambio es una definición de éxito que es un enlace, fijada al principio del trimestre y visible durante todo él, y las tardes que se les iban en escribir estados que nadie puntúa.
Leer a continuación
 AI
Cuando la IA tiene que grabar su propia revisión
Cuando se abre una pull request, sea mía o una que me toca revisar, ahora le pido al agente que la ejecute en mi máquina, que intente romperla y que se grabe mientras lo hace. Un párrafo puede asegurar que se hizo una prueba. Una grabación tiene que enseñarla, y decidir qué significa sigue siendo cosa mía. AI
Jev responde en probabilidades. La pregunta sigue siendo tuya.
Jev, de TypeSafe, no escribe ni una frase. Le entregas un estado y unas preguntas tipadas, y te devuelve una elección, una puntuación o una probabilidad de sí o no, a cuatro milésimas de céntimo por una decisión sobre mil tokens. La novedad es la forma, que devuelve la autoridad a tu código, y la trampa es que una probabilidad parece un recurso y no lo es. Ejecuté el piloto que pediría antes de creerme ningún número, sobre mis propios ensayos con el modelo abierto que sustituyó a Jev, y la respuesta fue no.