
Sai cosa otterrai, sai cosa costruire
Ascolta l'articolo (sperimentale) · 13:45
Sopra ogni team di sviluppo c'è, da qualche parte, una persona che ha bisogno di un solo numero: questa cosa arriva entro fine trimestre? E il meccanismo che produce quel numero è notevole. La persona chiede a un lead. In una buona settimana il lead lo sa già. Nelle altre, due sviluppatori vengono interrotti a metà lavoro per produrre una stima di cortesia. In entrambi i casi la risposta viene arrotondata per eccesso a ogni livello che attraversa, perché nessuno vuole portare cattive notizie, e quello che arriva in cima è una sensazione travestita da percentuale. Tre settimane dopo la data slitta e tutti fanno finta di stupirsi.
In quella catena ci perdono tutti. Il lead diventa uno smistatore di status invece che la persona che rimuove gli ostacoli, e perfino il lead che lo sa sta riportando un ricordo, non una misura. Gli sviluppatori, quando la domanda arriva fino a loro, pagano un pomeriggio per un report che venerdì sarà già sbagliato. Chi ha fatto la domanda continua a non avere un numero su cui agire, perché "pensiamo di essere in linea" non è un numero.
Secondo me la soluzione è un metodo di lavoro, e ho costruito il tool che lo fa girare. L'obiettivo non è avere meno domande, ma che le due parti guardino finalmente la stessa cosa: il business che sa, in qualsiasi momento, quanto è probabile che ottenga ciò che ha chiesto, e gli sviluppatori che sanno, dal primo giorno, esattamente cosa devono costruire e come verrà giudicato.
Da dove viene il metodo
Il primo pezzo viene da come lavorano già i migliori team a OKR. Nello stile di Radical Focus, ogni key result inizia il trimestre con una confidenza di cinque su dieci, e il check-in settimanale sposta quella confidenza su o giù in base a quello che è successo davvero. Google valuta gli OKR da 0,0 a 1,0 a fine trimestre. Quel rituale tratta lo stato di un key result come una probabilità, rivista ogni settimana, non come un elenco di attività.
Il secondo pezzo viene dalla ricerca sul forecasting. I migliori forecaster si distinguono da tutti gli altri per comportamento, non per intelligenza o informazioni riservate: aggiornano spesso e a piccoli passi, e si ancorano ai tassi di base, a quello che di solito succede, prima di toccare quello che questa volta sembra diverso. Aggiornamenti piccoli e frequenti sopra un tasso di base sono, quasi parola per parola, il check-in settimanale degli OKR fatto bene.
Mettili uno accanto all'altro: il check-in settimanale è un esercizio di forecasting. I team lo fanno a mano, in riunione, a memoria, e chi tiene in mano il pennarello è di solito la persona più ottimista della stanza. Intanto il tasso di base, il ritmo reale del team, sta nel repository, registrato al secondo, e nessuno lo va mai a chiedere.
Nemmeno gli strumenti del repository colmano questa distanza. I burndown chart e i report di velocity consumano gli stessi dati, ma vivono a livello di sprint, dentro il tooling degli sviluppatori, dove il business non guarda mai. Producono grafici, non probabilità con le motivazioni allegate. E nessuno torna indietro a valutare un burndown rispetto a quello che è stato consegnato davvero, quindi nessuno sa dirti se al grafico del trimestre scorso valeva la pena credere.
Il framework
La proposta non aggiunge nuove riunioni, anche se pretende quell'igiene delle issue che la maggior parte dei team dice di avere già. Le servono una riunione che esiste già e un job che gira da solo.
A inizio trimestre i lead si siedono con il business e fissano gli obiettivi. Questa parte non cambia. Quello che cambia è ciò che viene dopo: ogni obiettivo viene scomposto in key result, e ogni key result viene codificato dove il lavoro vive davvero, come una milestone di GitHub con una deadline, o come una sua fetta identificata da una label quando una milestone ne contiene diversi. Un key result smette di essere uno slogan su una slide e diventa un insieme di issue su cui puoi cliccare.
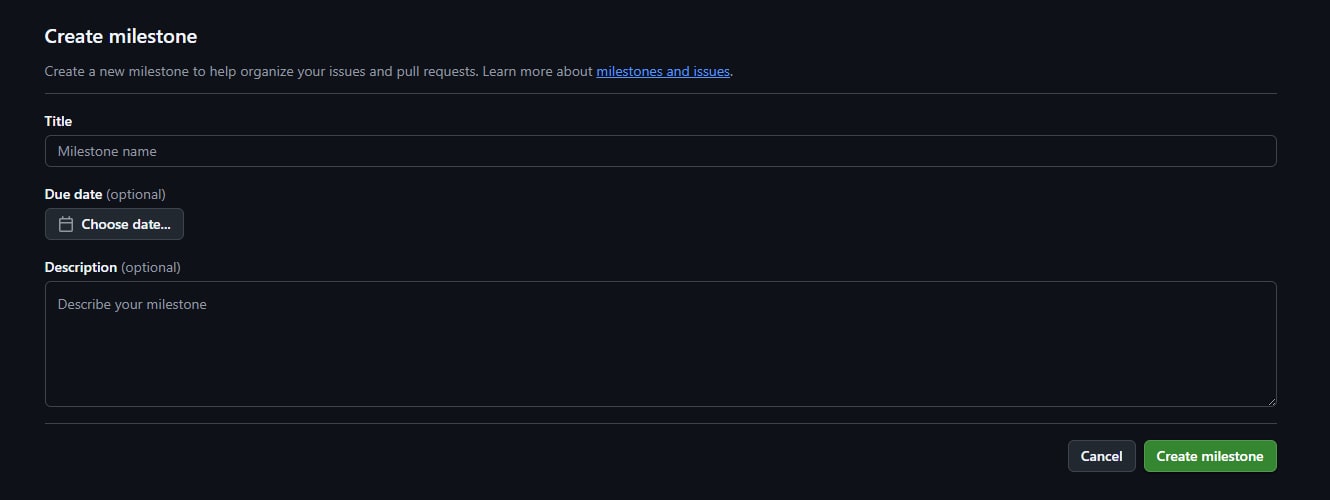
Il lato GitHub di tutto questo è volutamente noioso. Una milestone con una data di scadenza è un piccolo form:
Una label per ogni key result è un altro form, accanto a quelle che ogni repository ha già:
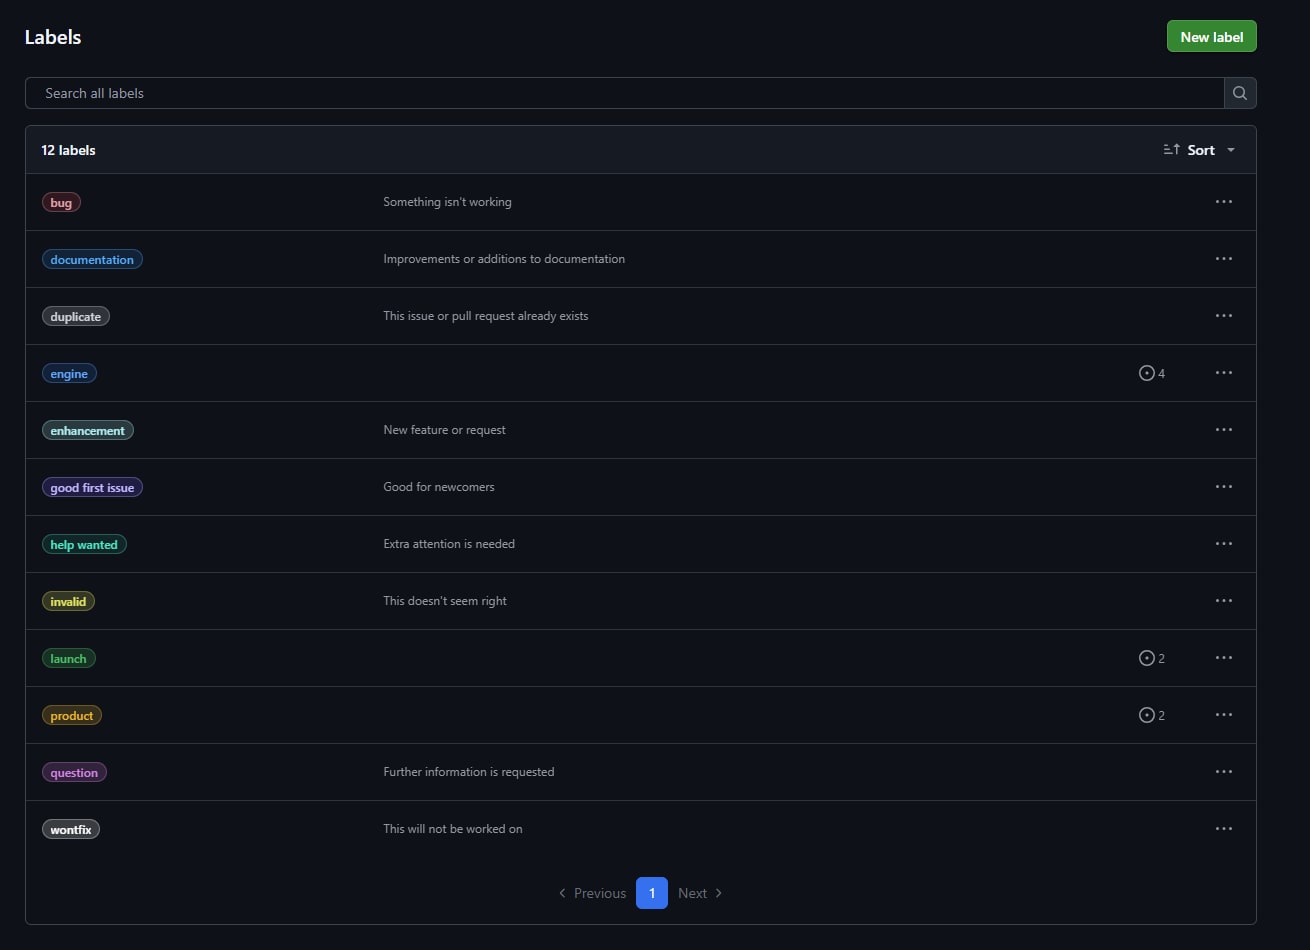
Le issue prendono entrambe le cose durante il normale triage, la milestone e la label del loro key result. Poi un breve file di configurazione dice al forecaster e alla dashboard come leggerle: quale obiettivo possiede quale milestone, quale label la divide in key result e quale issue riceve il commento settimanale.
repo: tiago-peres/superforecaster
milestones:
  - milestone: v1.0
    objective: Ship Superforecaster v1
    deadline: 2026-08-14
    krs:
      - id: engine
        name: Forecast engine turns a milestone into a calibrated P(delivery)
        label: engine
        tracking_issue: 1
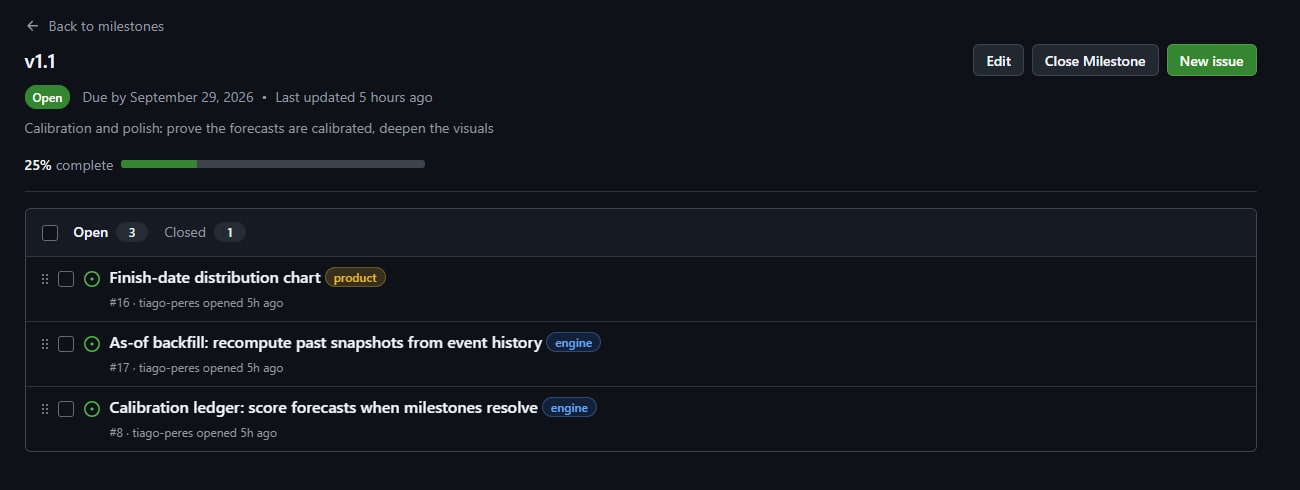
Il setup è tutto qui. Apri la milestone dopo e si legge già come la promessa che è: una data di scadenza, una barra di avanzamento e ogni elemento di lavoro rimasto che porta la label del suo key result, visibile a chiunque abbia voglia di guardare. Fatto significa: queste issue, chiuse, entro questa data.
Un limite, prima di andare avanti: tutto questo copre i key result di consegna, lo scope che viene rilasciato entro una data. Un key result di metrica, adozione, ricavi, latenza, ha bisogno della metrica stessa come sorgente, e nessuna aritmetica sulle issue la sostituisce. Ma è sugli impegni di consegna del trimestre che vive l'ansia del ce-la-facciamo-a-rilasciare, e per quelli le issue sono il lavoro, e il lavoro è ciò che una previsione può tenere d'occhio.
Poi, durante il trimestre, nessuno scrive lo status. Un job gira ogni lunedì e fa quello che la stanza fingeva di fare. Legge il repository: cosa si è chiuso questa settimana, cosa è entrato nello scope a metà settimana, il ritmo settimanale reale. Simula il resto del trimestre diecimila volte su quel ritmo, Monte Carlo sul throughput effettivo, e riporta la frazione di futuri che rispettano la deadline. Quando un repository è troppo giovane per avere un ritmo suo, il forecaster prende in prestito la distribuzione dal repository precedente del team, un prior volutamente debole tenuto solo finché non si accumula storia vera. E la nitidezza della previsione segue la scomposizione del backlog: finché metà dello scope è ancora fatta di epic, il cono è largo, ed è giusto così.
Sopra la matematica, un modello legge le issue aperte come farebbe un reviewer, cercando il rischio che i numeri non vedono, il ticket che in realtà è ricerca senza confini, la dipendenza da una decisione che nessuno ha preso. Può spostare la probabilità al massimo di quindici punti, il suo ragionamento viene pubblicato accanto al numero, e la sua previsione corretta viene valutata separatamente da quella grezza, così lo storico mostra se il livello di giudizio si guadagna il posto. Poi il job pubblica un commento per ogni key result sulla sua issue di tracking: la probabilità, come si è mossa rispetto alla settimana scorsa, cosa l'ha mossa e perché.
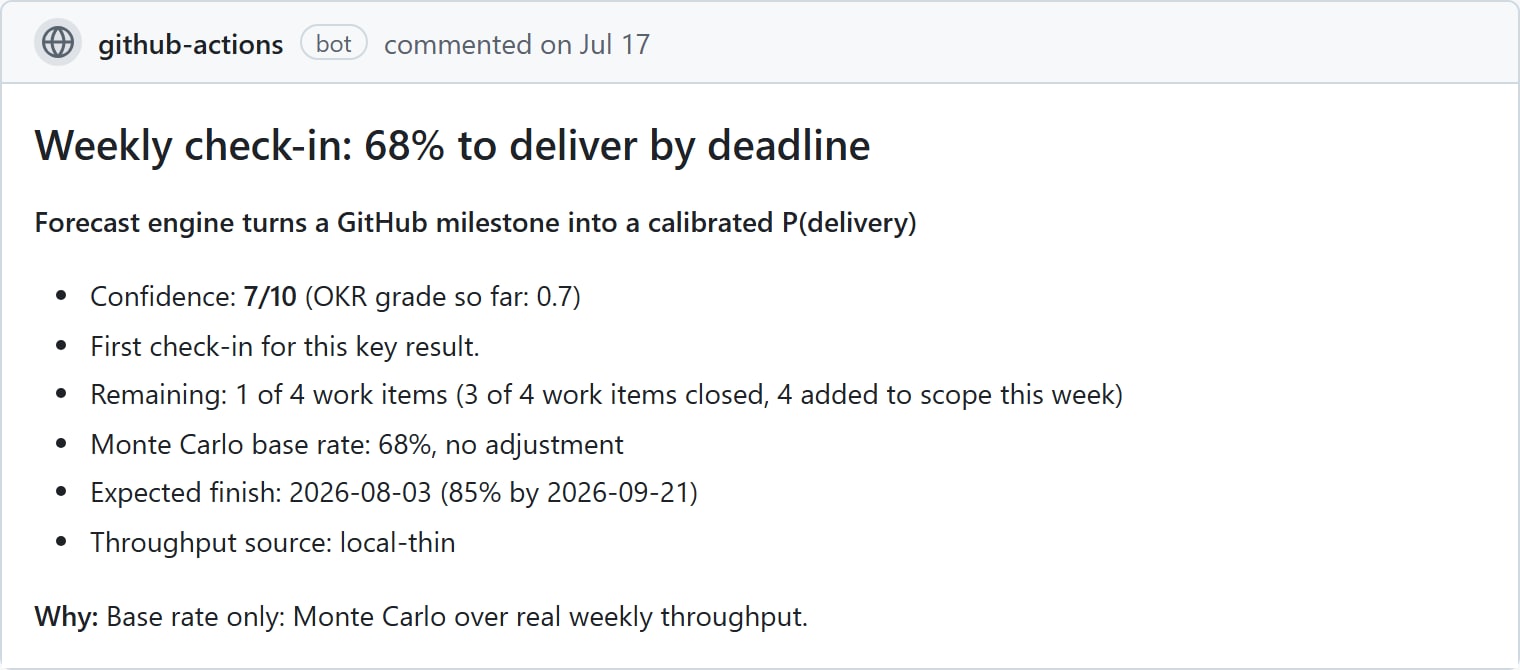
E la dashboard è il posto dove tutto questo atterra, per tutti, in qualsiasi momento.
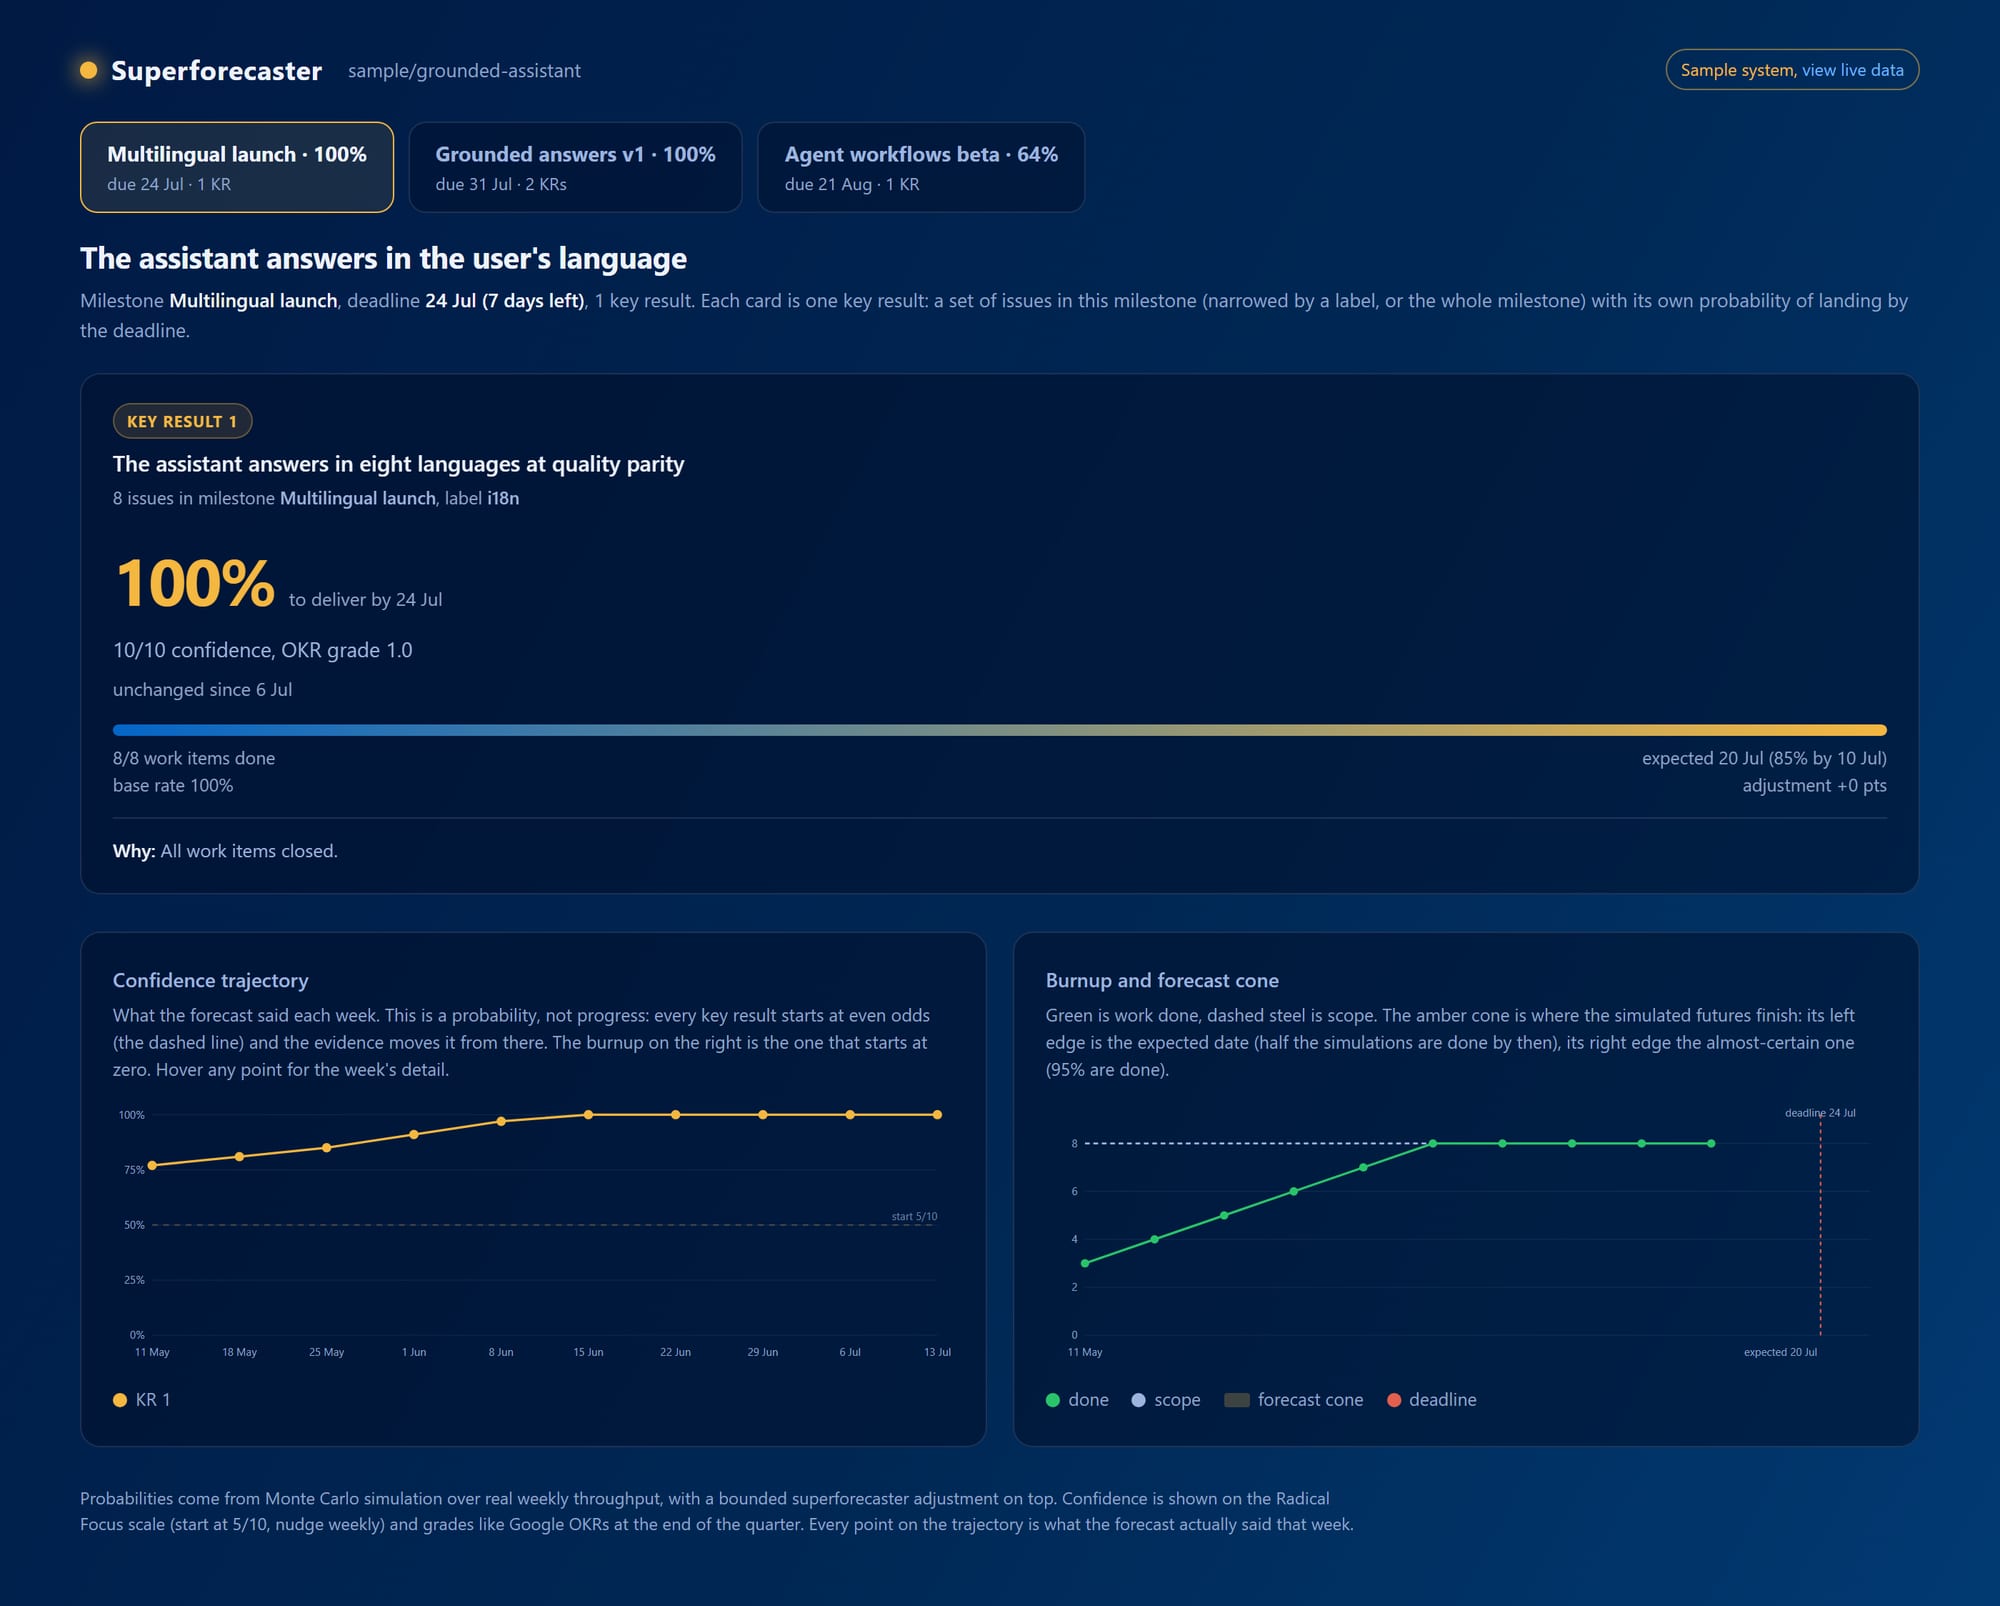
Il business guarda la dashboard prima della riunione di steering invece di chiedere a qualcuno. Ogni key result mostra la sua probabilità di arrivare entro la sua data, il movimento della settimana, la fine attesa e la motivazione scritta. Il grafico della traiettoria è la linea di confidenza degli OKR resa reale: parte da un cinquanta e cinquanta e ogni punto è quello che la previsione diceva quella settimana, non una curva ridisegnata per fare bella figura in retro. A fine trimestre il voto da 0,0 a 1,0 esce dallo storico invece di essere negoziato in una stanza.
La vista che giustifica tutto il metodo è quella infelice. Ecco che aspetto ha una milestone in difficoltà, presa dal sistema di esempio incluso nella dashboard:
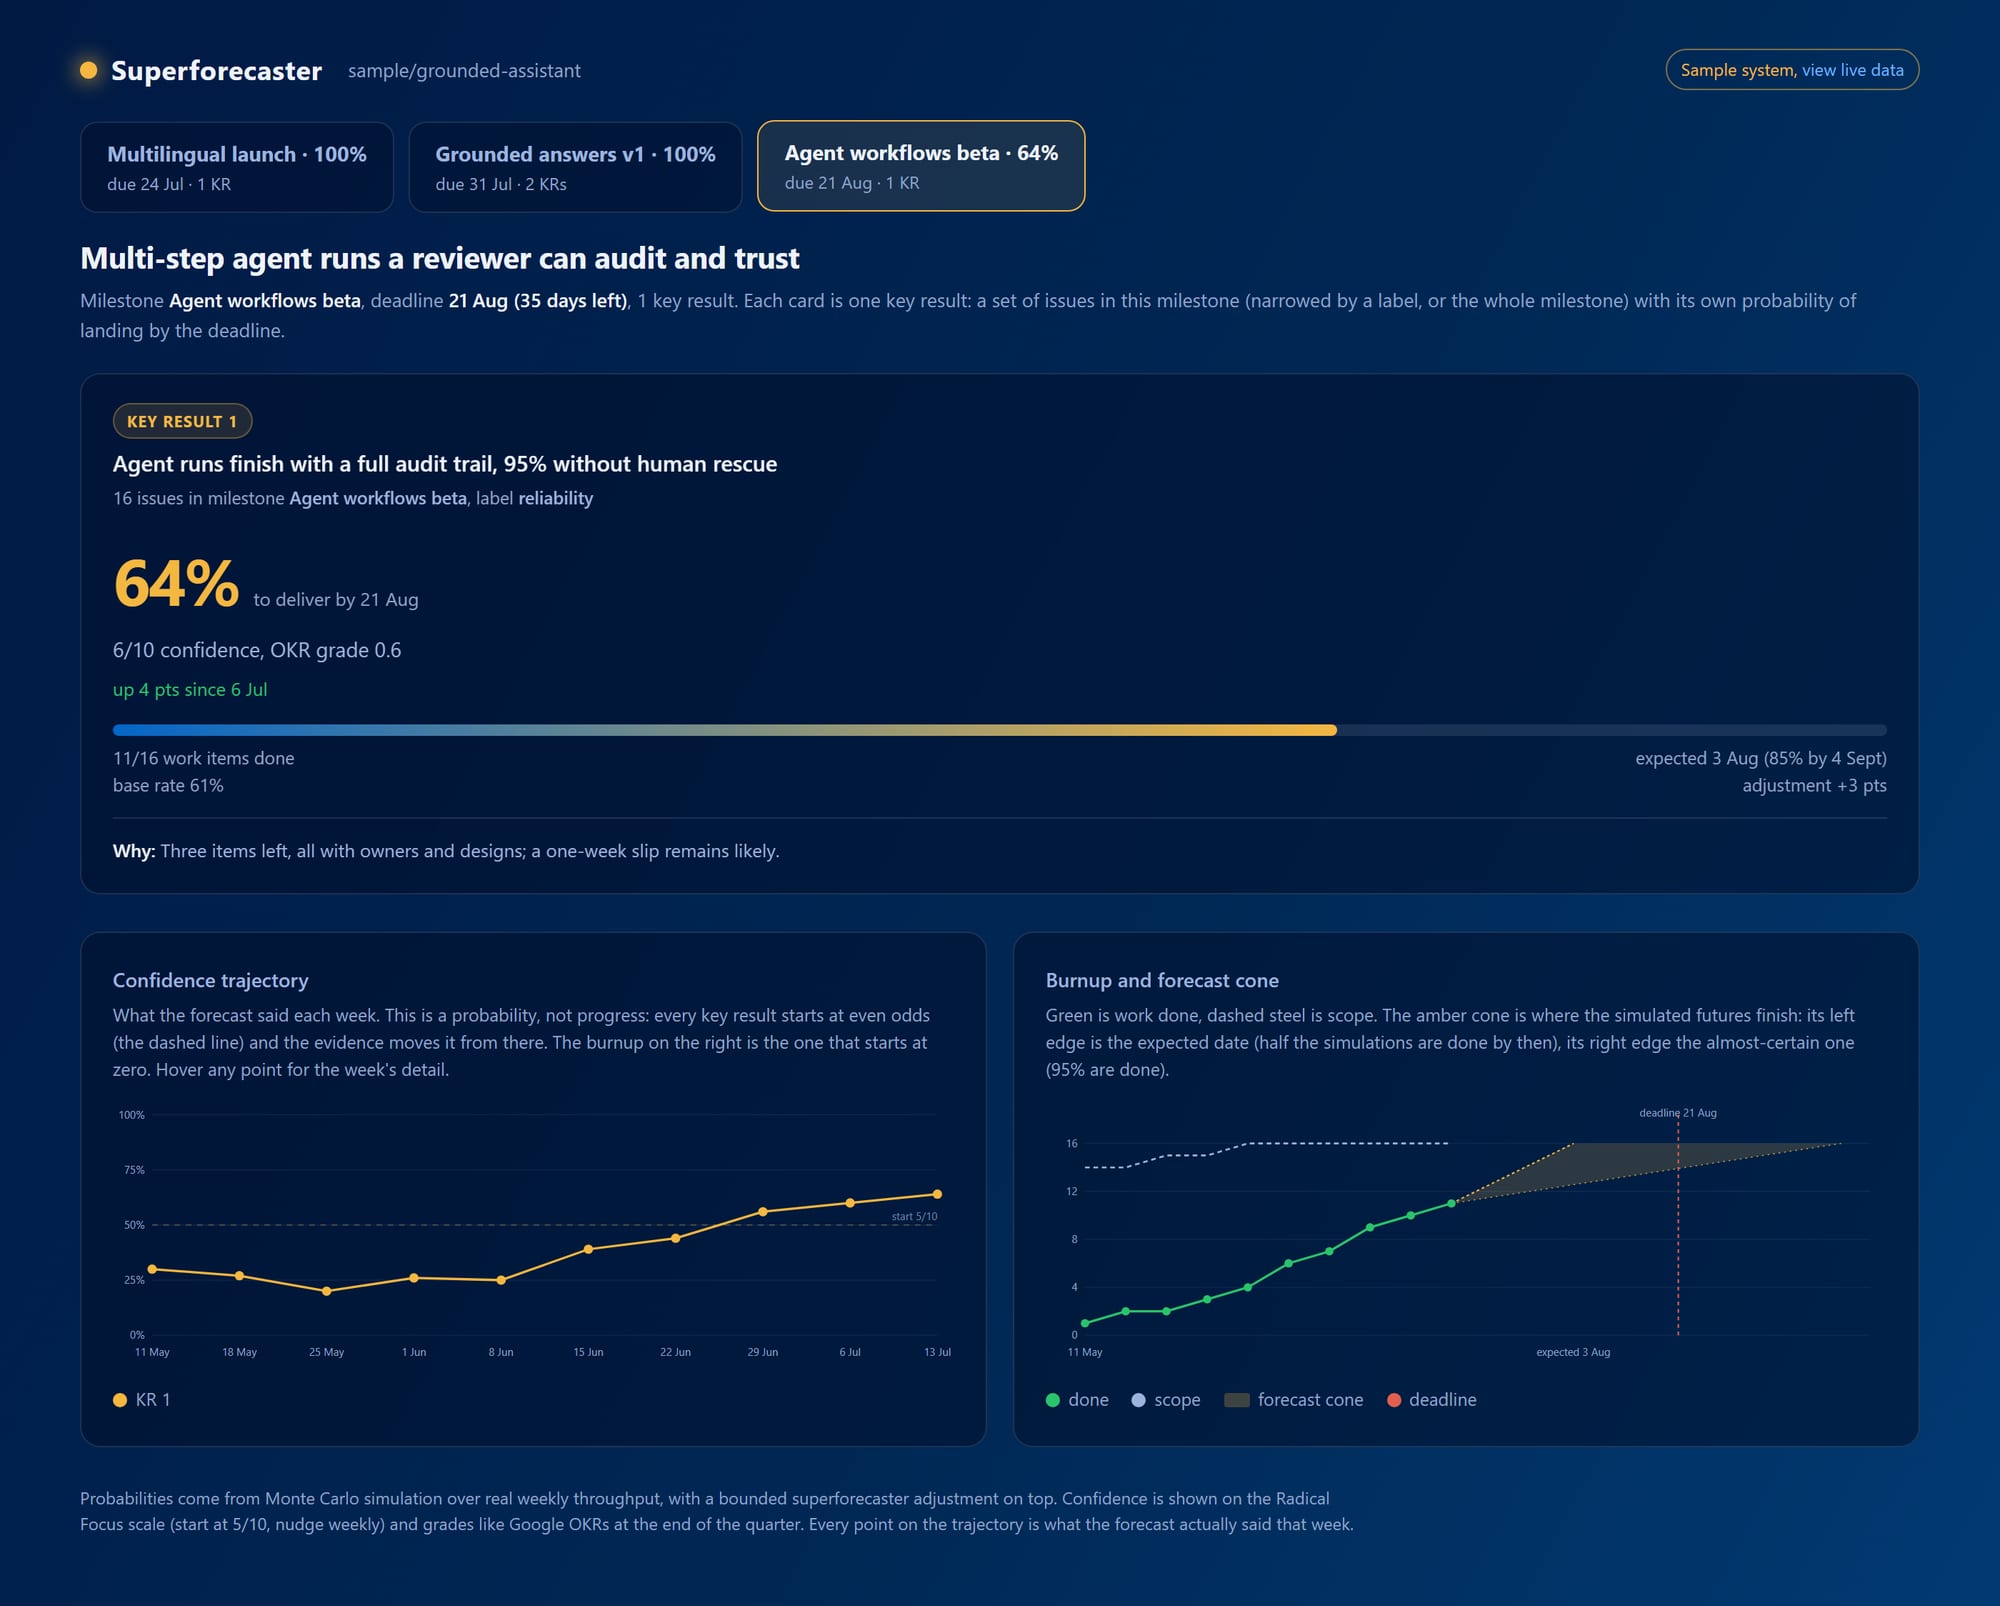
Un key result al 64%, visibilmente in difficoltà, mesi prima che la sua deadline smetta di essere negoziabile. La linea di confidenza ha passato un mese sotto il suo punto di partenza mentre un pezzo di infrastruttura bloccante teneva fermo tutto quello che veniva dopo, e la motivazione scritta lo diceva ogni settimana. Nessuno ha dovuto fare escalation. Nessuno ha dovuto confessare in riunione. Il numero è sceso, la ragione era allegata, e il team ha avuto settimane per agire invece di una brutta sorpresa alla scadenza.
Quello che il tool mi ha insegnato il primo giorno
L'ho costruito come prodotto, si chiama Superforecaster, e il primo team su cui fa previsioni è se stesso: le sue milestone, le sue issue, i suoi check-in settimanali pubblicati sul suo tracker. Il dogfooding mi ha insegnato una lezione nel giro di poche ore. Alla prima esecuzione senza supervisione ha annunciato una probabilità del 100%, confidenza dieci su dieci, per una milestone che era a quattro settimane di distanza. La causa era una settimana calda di issue chiuse e nessuna varianza, che è il peccato più antico del forecasting: certezza totale da un campione minuscolo. La correzione è stata fare in modo che una storia sottile allarghi l'incertezza invece di restringerla, e appoggiarsi alla visione dall'esterno finché il repository non ha uno storico vero. Dopo la correzione, gli stessi dati dicevano 35%.
Quel numero era scomodo, e doveva esserlo. Una sensazione avrebbe detto "va bene". La previsione diceva: a questo ritmo, con questo scope, probabilmente non ce la fai. Con un 35% puoi discutere, puoi tagliare scope, puoi spostare una data. Non c'è niente su cui discutere in "siamo in linea". La milestone è ancora aperta mentre scrivo, quindi lo storico giudicherà quel 35% come questo metodo giudica ogni previsione: valutata rispetto a quello che è successo davvero. Fino ad allora è una stima disciplinata, che è già più di quanto una riunione di status abbia mai dato a chiunque.
Cosa ottiene ciascuna parte
Il business ottiene una probabilità coerente da una settimana all'altra, perché a produrla è ogni volta lo stesso metodo, con la motivazione allegata. Quando la risposta è brutta, arriva abbastanza presto da poter cambiare la richiesta mentre il trimestre riesce ancora ad assorbire la decisione.
Gli sviluppatori ottengono una definizione di successo che è un link, fissata all'inizio e visibile per tutto il trimestre, e quando cambia, cambia nello stesso posto in cui lavorano. Si riprendono anche la loro settimana: la previsione legge i loro commit e le loro issue, mai il loro tempo, e aggrega a livello di milestone, quindi la dashboard non porta numeri per persona da fissare.
I lead escono dal mestiere di smistare. Il check-in si scrive da solo a partire dal repository, quindi il tempo di riunione del lead va sulla cosa che la dashboard ha fatto emergere, la decisione bloccata, lo scope che è cresciuto, invece che a mettere insieme le notizie.
Dove questo si rompe
Una probabilità non è una promessa, e il metodo vale quanto l'igiene che ci sta sotto. Se il lavoro non vive nelle issue, il forecaster è cieco. Se i cambi di scope non toccano mai la milestone, il burnup mente.
Ci sono due modi in cui i numeri possono marcire, e servono due cure diverse. Il forecaster stesso può andare alla deriva, e per quello la cura è meccanica: ogni previsione viene scritta e valutata quando la milestone si chiude, così lo storico mostra se merita di essere creduta. Il team può anche barare, chiudendo issue vuote, spezzando i ticket per gonfiare il ritmo, spostando scope fuori dalla milestone senza che nessuno guardi, e nessuna valutazione se ne accorge. La dashboard può rendere visibili i cambi di scope e le issue riaperte, ma l'ultima linea di difesa è quella che è sempre stata: una cultura della review in cui una chiusura vuota non sopravvive. Un tool non può fornirla. Può solo rendere visibili i trucchi.
Nemmeno le interruzioni scendono a zero. Un numero che perde nove punti di lunedì attirerà domande, ed è giusto così. Quello che cambia è dove atterrano le domande e cosa portano con sé: vanno sull'issue di tracking, già carica della motivazione, e la conversazione parte da "le probabilità sono scese perché lo scope è cresciuto, cosa tagliamo?" invece che da "a che punto siamo?". Questa è una conversazione che vale la pena fare, con chiunque.
Il trimestre inizia con delle persone in una stanza che si mettono d'accordo su cosa conta. Il compito della macchina è tutto quello che viene dopo: guarda il lavoro e fa i conti, e dice a tutti lo stesso numero nello stesso momento.
Le domande a cui questo articolo risponde
Come si capisce in anticipo se il lavoro del trimestre verrà consegnato in tempo?
Leggendo il repository invece di chiedere alle persone. Un job gira ogni lunedì, prende quello che si è chiuso in settimana e quello che è entrato nello scope a metà settimana, simula il resto del trimestre diecimila volte su quel ritmo reale e riporta la frazione di futuri che rispettano la deadline. Una storia sottile deve allargare l'incertezza invece di restringerla: alla prima esecuzione senza supervisione il tool ha annunciato 100% per una milestone che era a quattro settimane di distanza, e dopo quella correzione gli stessi dati dicevano 35%.
In cosa è diverso dai burndown chart e dai report di velocity?
Quelli consumano gli stessi dati, ma vivono a livello di sprint, dentro il tooling degli sviluppatori, dove il business non guarda mai, e producono grafici invece di probabilità con le motivazioni allegate. Nessuno torna indietro a valutare un burndown rispetto a quello che è stato consegnato davvero, quindi nessuno sa dirti se al grafico del trimestre scorso valeva la pena credere. Qui ogni previsione viene scritta e valutata quando la milestone si chiude, e il livello di modello che legge le issue aperte può spostare il numero al massimo di quindici punti, con il ragionamento pubblicato e la correzione valutata separatamente dalla previsione grezza.
Cosa impedisce a un team di barare chiudendo issue vuote?
Niente, dentro il tool, ed è un limite che vale la pena dire. La valutazione coglie il forecaster che va alla deriva, ma non coglie le chiusure vuote, i ticket spezzati per gonfiare il ritmo, lo scope spostato fuori dalla milestone senza che nessuno guardi. La dashboard può rendere visibili i cambi di scope e le issue riaperte; l'ultima linea di difesa è quella che è sempre stata, una cultura della review in cui una chiusura vuota non sopravvive.
Alla fine questo misura i singoli sviluppatori?
No. La previsione legge i commit e le issue, mai il tempo di nessuno, e aggrega a livello di milestone, quindi la dashboard non porta numeri per persona da fissare. Quello che gli sviluppatori ottengono in cambio è una definizione di successo che è un link, fissata a inizio trimestre e visibile per tutto il trimestre, e i pomeriggi che se ne andavano a scrivere status che nessuno valuta.
Da leggere dopo
 AI
Quando l'IA deve filmare la propria revisione
Quando viene aperta una pull request, una mia o una che devo revisionare, ora chiedo all'agente di eseguirla sulla mia macchina, di provare a romperla e di filmarsi mentre lo fa. Un paragrafo può affermare che un test è stato fatto. Una registrazione deve mostrarlo, e decidere cosa significa resta compito mio. AI
Jev risponde in probabilità. La domanda è ancora tua.
Jev di TypeSafe non scriverà una frase. Gli consegni uno stato e delle domande tipizzate, e lui ti restituisce una scelta, un punteggio o una probabilità sì/no, a quattro millesimi di centesimo per una decisione su mille token. La novità è la forma, che rimette l'autorità nel tuo codice, e la trappola è che una probabilità somiglia a una rivalsa e non lo è. Ho fatto partire il progetto pilota che vorrei prima di credere a qualsiasi numero, sui miei stessi saggi con il modello aperto che ha fatto le veci di Jev, e la risposta è stata no.