
Wissen, was du bekommst. Wissen, was du bauen musst.
Artikel anhören (experimentell) · 15:26
Irgendwo über jedem Engineering-Team sitzt eine Person, die eine einzige Zahl braucht: Kommt das bis Quartalsende an? Und die Maschinerie, die diese Zahl produziert, ist bemerkenswert. Die Person fragt einen Lead. In einer guten Woche weiß der Lead es bereits. In allen anderen werden zwei Entwickler mitten in der Arbeit unterbrochen, um eine höfliche Schätzung abzugeben. So oder so wird die Antwort auf ihrem Weg durch jede Ebene nach oben gerundet, weil niemand schlechte Nachrichten tragen will, und was oben ankommt, ist ein Gefühl im Kostüm einer Prozentzahl. Drei Wochen später rutscht der Termin, und alle tun überrascht.
Jeder in dieser Kette verliert etwas. Der Lead wird zum Status-Router statt zu der Person, die Hindernisse aus dem Weg räumt, und selbst der Lead, der es weiß, berichtet eine Erinnerung, keine Messung. Die Entwickler bezahlen, wenn die Frage sie denn erreicht, mit einem Nachmittag für einen Bericht, der bis Freitag falsch sein wird. Und wer gefragt hat, hat immer noch keine Zahl, mit der sich etwas anfangen lässt, denn „wir denken, es läuft nach Plan" ist keine Zahl.
Ich glaube, die Lösung ist eine Arbeitsweise, und ich habe das Tool gebaut, das sie ausführt. Das Ziel sind nicht weniger Fragen, sondern dass beide Seiten endlich auf dasselbe schauen: dass das Business jederzeit weiß, wie wahrscheinlich es ist, dass es bekommt, worum es gebeten hat, und dass die Entwickler ab Tag eins genau wissen, was sie bauen müssen und woran es gemessen wird.
Woher die Methode kommt
Das erste Stück kommt daher, wie die besten OKR-Teams ohnehin schon arbeiten. Im Stil von Radical Focus startet jedes Key Result das Quartal mit einer Confidence von fünf von zehn, und der wöchentliche Check-in schiebt diese Confidence nach oben oder unten, je nachdem, was tatsächlich passiert ist. Google bewertet OKRs zum Quartalsende auf einer Skala von 0,0 bis 1,0. Dieses Ritual behandelt den Stand eines Key Results als Wahrscheinlichkeit, wöchentlich revidiert, nicht als Liste von Aktivitäten.
Das zweite Stück kommt aus der Forschung zum Forecasting. Die besten Forecaster unterscheiden sich von allen anderen im Verhalten, nicht in Intelligenz oder Insiderwissen: Sie aktualisieren häufig und in kleinen Schritten, und sie verankern sich an Basisraten, an dem, was üblicherweise passiert, bevor sie sich damit befassen, was sich diesmal anders anfühlt. Häufige kleine Updates auf einer Basisrate sind, fast wörtlich, der wöchentliche OKR-Check-in, richtig gemacht.
Stell beides nebeneinander: Der wöchentliche Check-in ist eine Forecasting-Übung. Teams führen sie von Hand durch, in einem Meeting, aus dem Gedächtnis, und wer den Stift in der Hand hält, ist meist der optimistischste Mensch im Raum. Währenddessen liegt die Basisrate, das echte Tempo des Teams, im Repository, sekundengenau protokolliert, und niemand fragt sie je ab.
Auch die Tools rund ums Repository schließen diese Lücke nicht. Burndown-Charts und Velocity-Reports verarbeiten dieselben Daten, aber sie leben auf Sprint-Ebene, im Tooling der Entwickler, wo das Business nie hinschaut. Sie produzieren Diagramme, keine Wahrscheinlichkeiten mit angehängter Begründung. Und niemand geht zurück und bewertet einen Burndown daran, was tatsächlich ausgeliefert wurde, also kann dir niemand sagen, ob das Chart vom letzten Quartal Vertrauen verdient hatte.
Das Framework
Der Vorschlag fügt keine neuen Meetings hinzu, verlangt aber die Issue-Hygiene, die die meisten Teams ohnehin für sich beanspruchen. Er braucht ein Meeting, das es bereits gibt, und einen Job, der von allein läuft.
Zu Quartalsbeginn setzen sich die Team-Leads mit dem Business zusammen und legen die Objectives fest. Dieser Teil ändert sich nicht. Was sich ändert, ist, was danach passiert: Jedes Objective wird in Key Results zerlegt, und jedes Key Result wird dort kodiert, wo die Arbeit tatsächlich stattfindet, als GitHub-Milestone mit Deadline oder als per Label abgegrenzter Ausschnitt daraus, wenn ein Milestone mehrere trägt. Ein Key Result hört auf, ein Slogan auf einer Folie zu sein, und wird zu einer anklickbaren Menge von Issues.
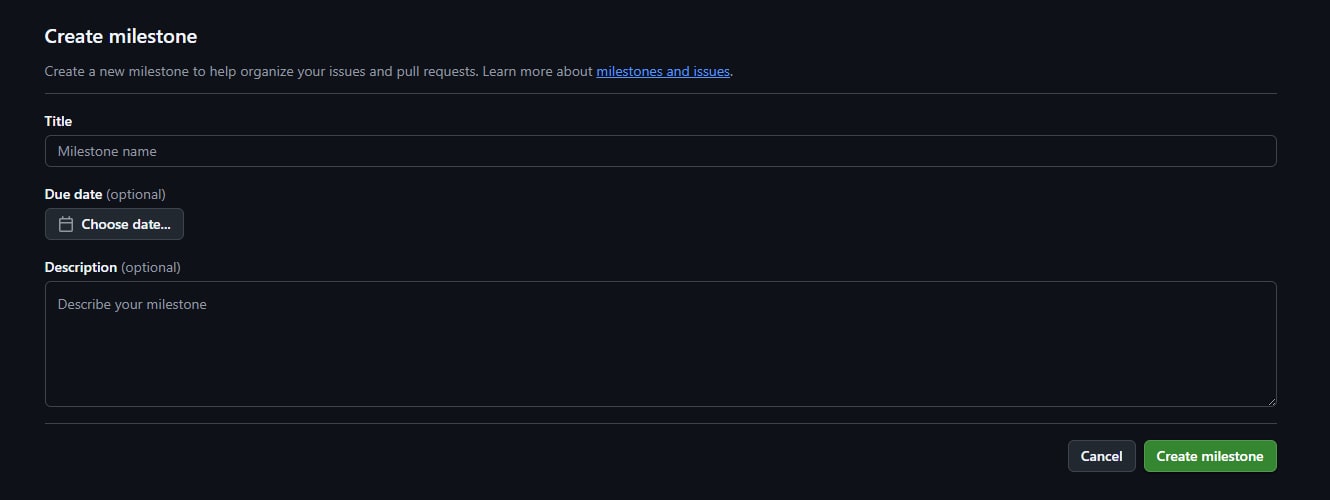
Die GitHub-Seite davon ist bewusst langweilig. Ein Milestone mit Fälligkeitsdatum ist ein kleines Formular:
Ein Label pro Key Result ist ein weiteres, direkt neben denen, die jedes Repository ohnehin hat:
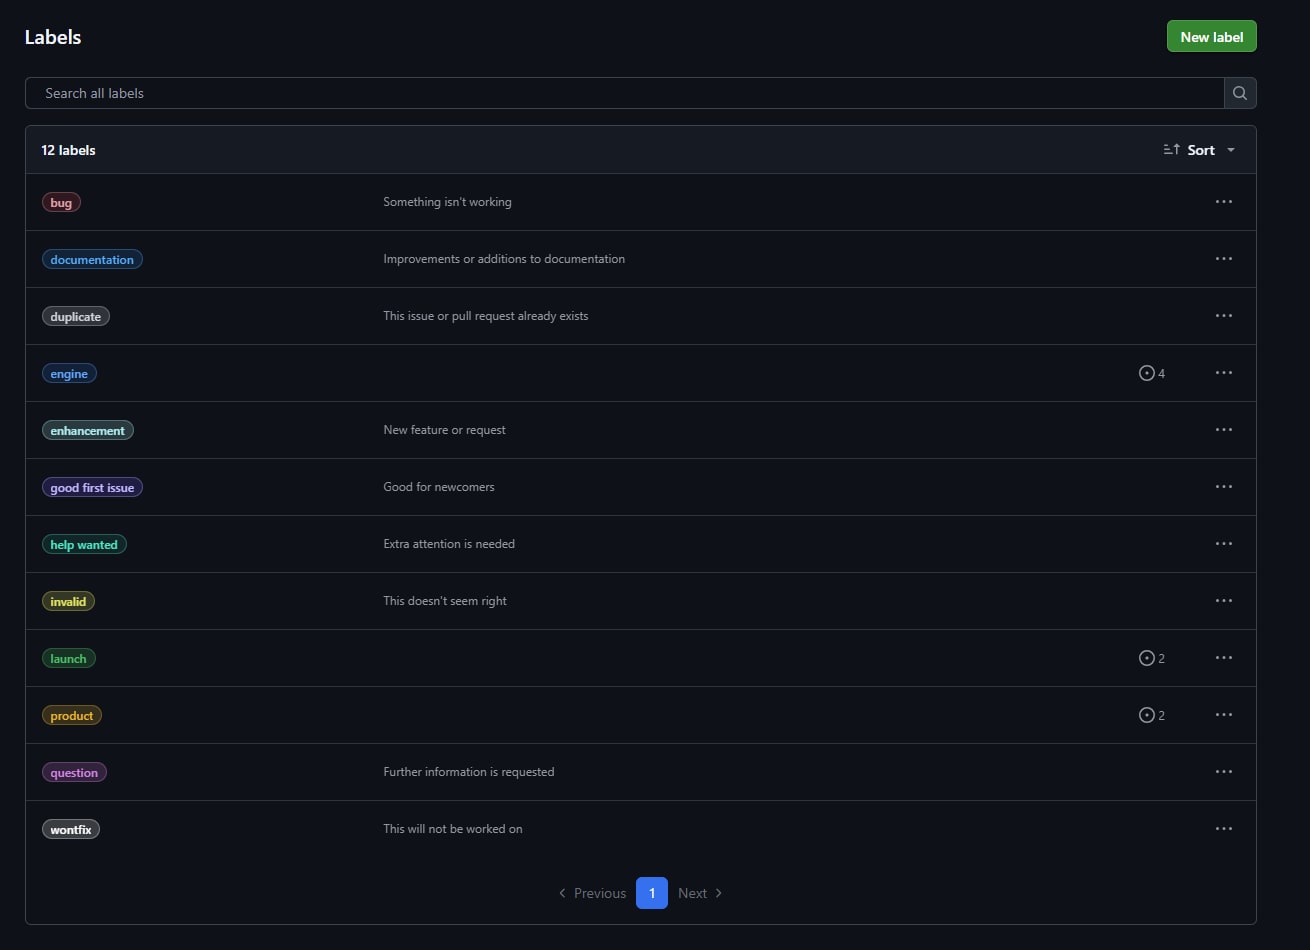
Issues bekommen beides im normalen Triage-Ablauf, den Milestone und das Label ihres Key Results. Eine kurze Konfigurationsdatei sagt dem Forecaster und dem Dashboard dann, wie sie zu lesen sind: welches Objective welchen Milestone besitzt, welches Label ihn in Key Results zerteilt und welches Issue den wöchentlichen Kommentar bekommt.
repo: tiago-peres/superforecaster
milestones:
  - milestone: v1.0
    objective: Ship Superforecaster v1
    deadline: 2026-08-14
    krs:
      - id: engine
        name: Forecast engine turns a milestone into a calibrated P(delivery)
        label: engine
        tracking_issue: 1
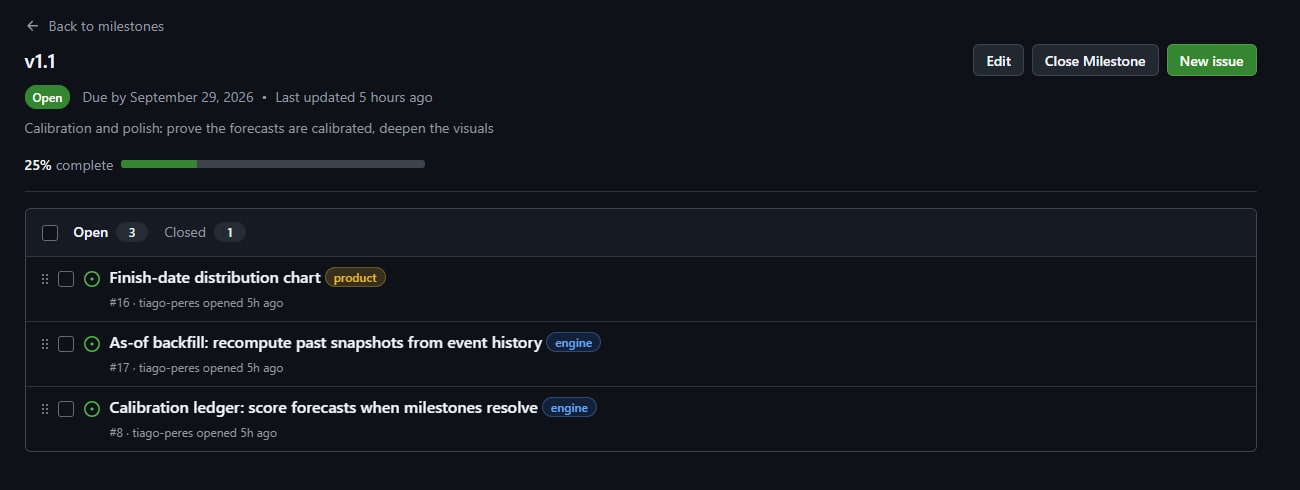
Das ist das ganze Setup. Öffne den Milestone danach, und er liest sich schon wie das Versprechen, das er ist: ein Fälligkeitsdatum, ein Fortschrittsbalken und jedes verbleibende Arbeitspaket mit dem Label seines Key Results, sichtbar für jeden, der hinschauen will. Fertig heißt: diese Issues, geschlossen, bis zu diesem Datum.
Eine Grenze, bevor es weitergeht: Das hier deckt Delivery-Key-Results ab, also Scope, der bis zu einem Datum ausgeliefert wird. Ein metrisches Key Result, Adoption, Umsatz, Latenz, braucht die Metrik selbst als Datenquelle, und keine noch so ausgefeilte Issue-Arithmetik ersetzt sie. Aber die Delivery-Zusagen des Quartals sind der Ort, an dem die Nervosität sitzt, ob es rechtzeitig fertig wird, und dort sind die Issues die Arbeit, und die Arbeit ist das, was eine Prognose beobachten kann.
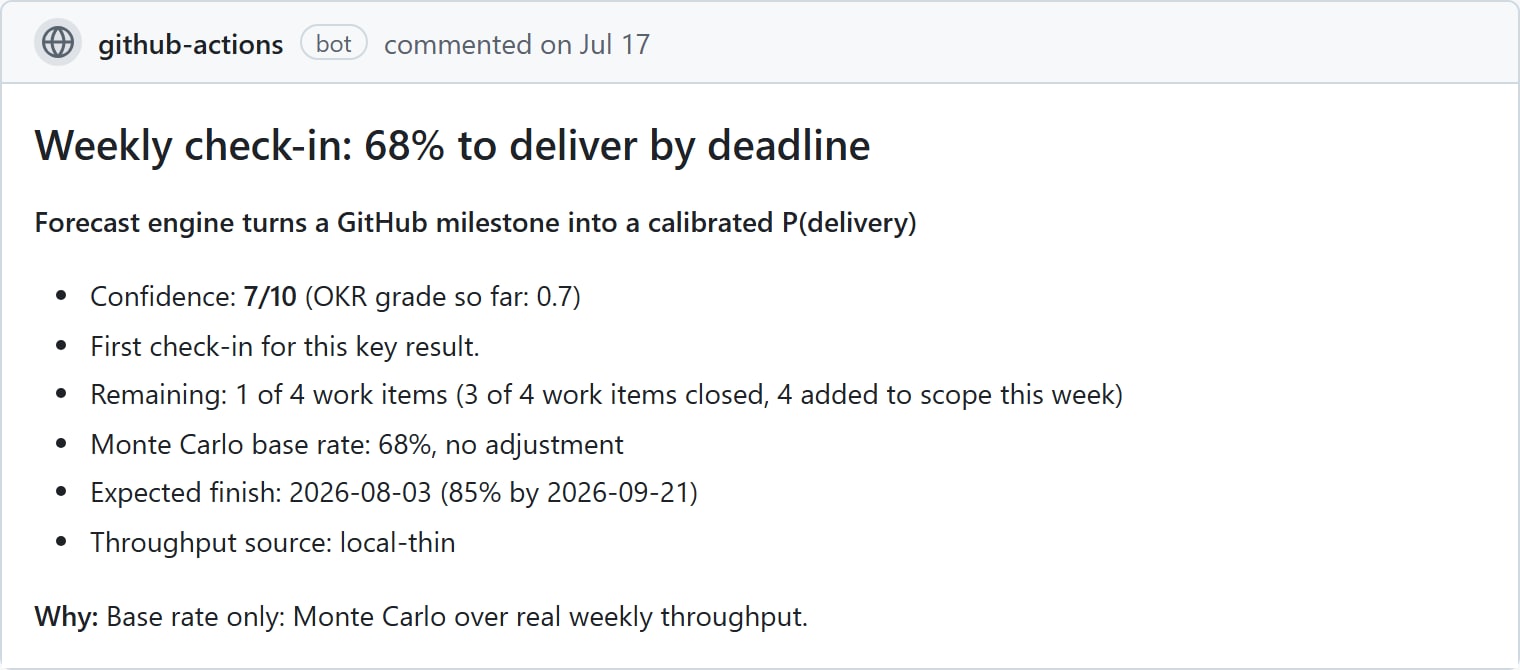
Während des Quartals schreibt dann niemand Status. Jeden Montag läuft ein Job und tut das, was der Raum vorgab zu tun. Er liest das Repository: was diese Woche geschlossen wurde, was mitten in der Woche zum Scope dazukam, das echte Wochentempo. Er spielt den Rest des Quartals zehntausendmal über dieses Tempo durch, Monte Carlo über den tatsächlichen Durchsatz, und meldet den Anteil der Zukünfte, die die Deadline halten. Wenn ein Repository zu jung ist, um ein eigenes Tempo zu haben, borgt sich der Forecaster die Verteilung aus dem vorherigen Repository des Teams, ein bewusst schwacher Prior, der nur so lange gilt, bis sich echte Historie ansammelt. Und die Schärfe der Prognose folgt dem Zerlegungsgrad des Backlogs: Solange die Hälfte des Scopes noch aus Epics besteht, ist der Trichter weit, und das soll er auch sein.
Über der Mathematik liest ein Modell die offenen Issues so, wie es ein Reviewer täte, auf der Suche nach dem Risiko, das die Zahlen nicht sehen können, dem Ticket, das in Wahrheit unbegrenzte Forschung ist, der Abhängigkeit von einer Entscheidung, die niemand getroffen hat. Es darf die Wahrscheinlichkeit um höchstens fünfzehn Punkte verschieben, seine Begründung wird neben der Zahl veröffentlicht, und seine angepasste Prognose wird getrennt von der rohen bewertet, damit die Historie zeigt, ob sich die Urteilsschicht rechnet. Dann postet der Job pro Key Result einen Kommentar auf dessen Tracking-Issue: die Wahrscheinlichkeit, wie sie sich seit der Vorwoche bewegt hat, was sie bewegt hat und warum.
Und im Dashboard läuft alles zusammen, für alle, jederzeit.
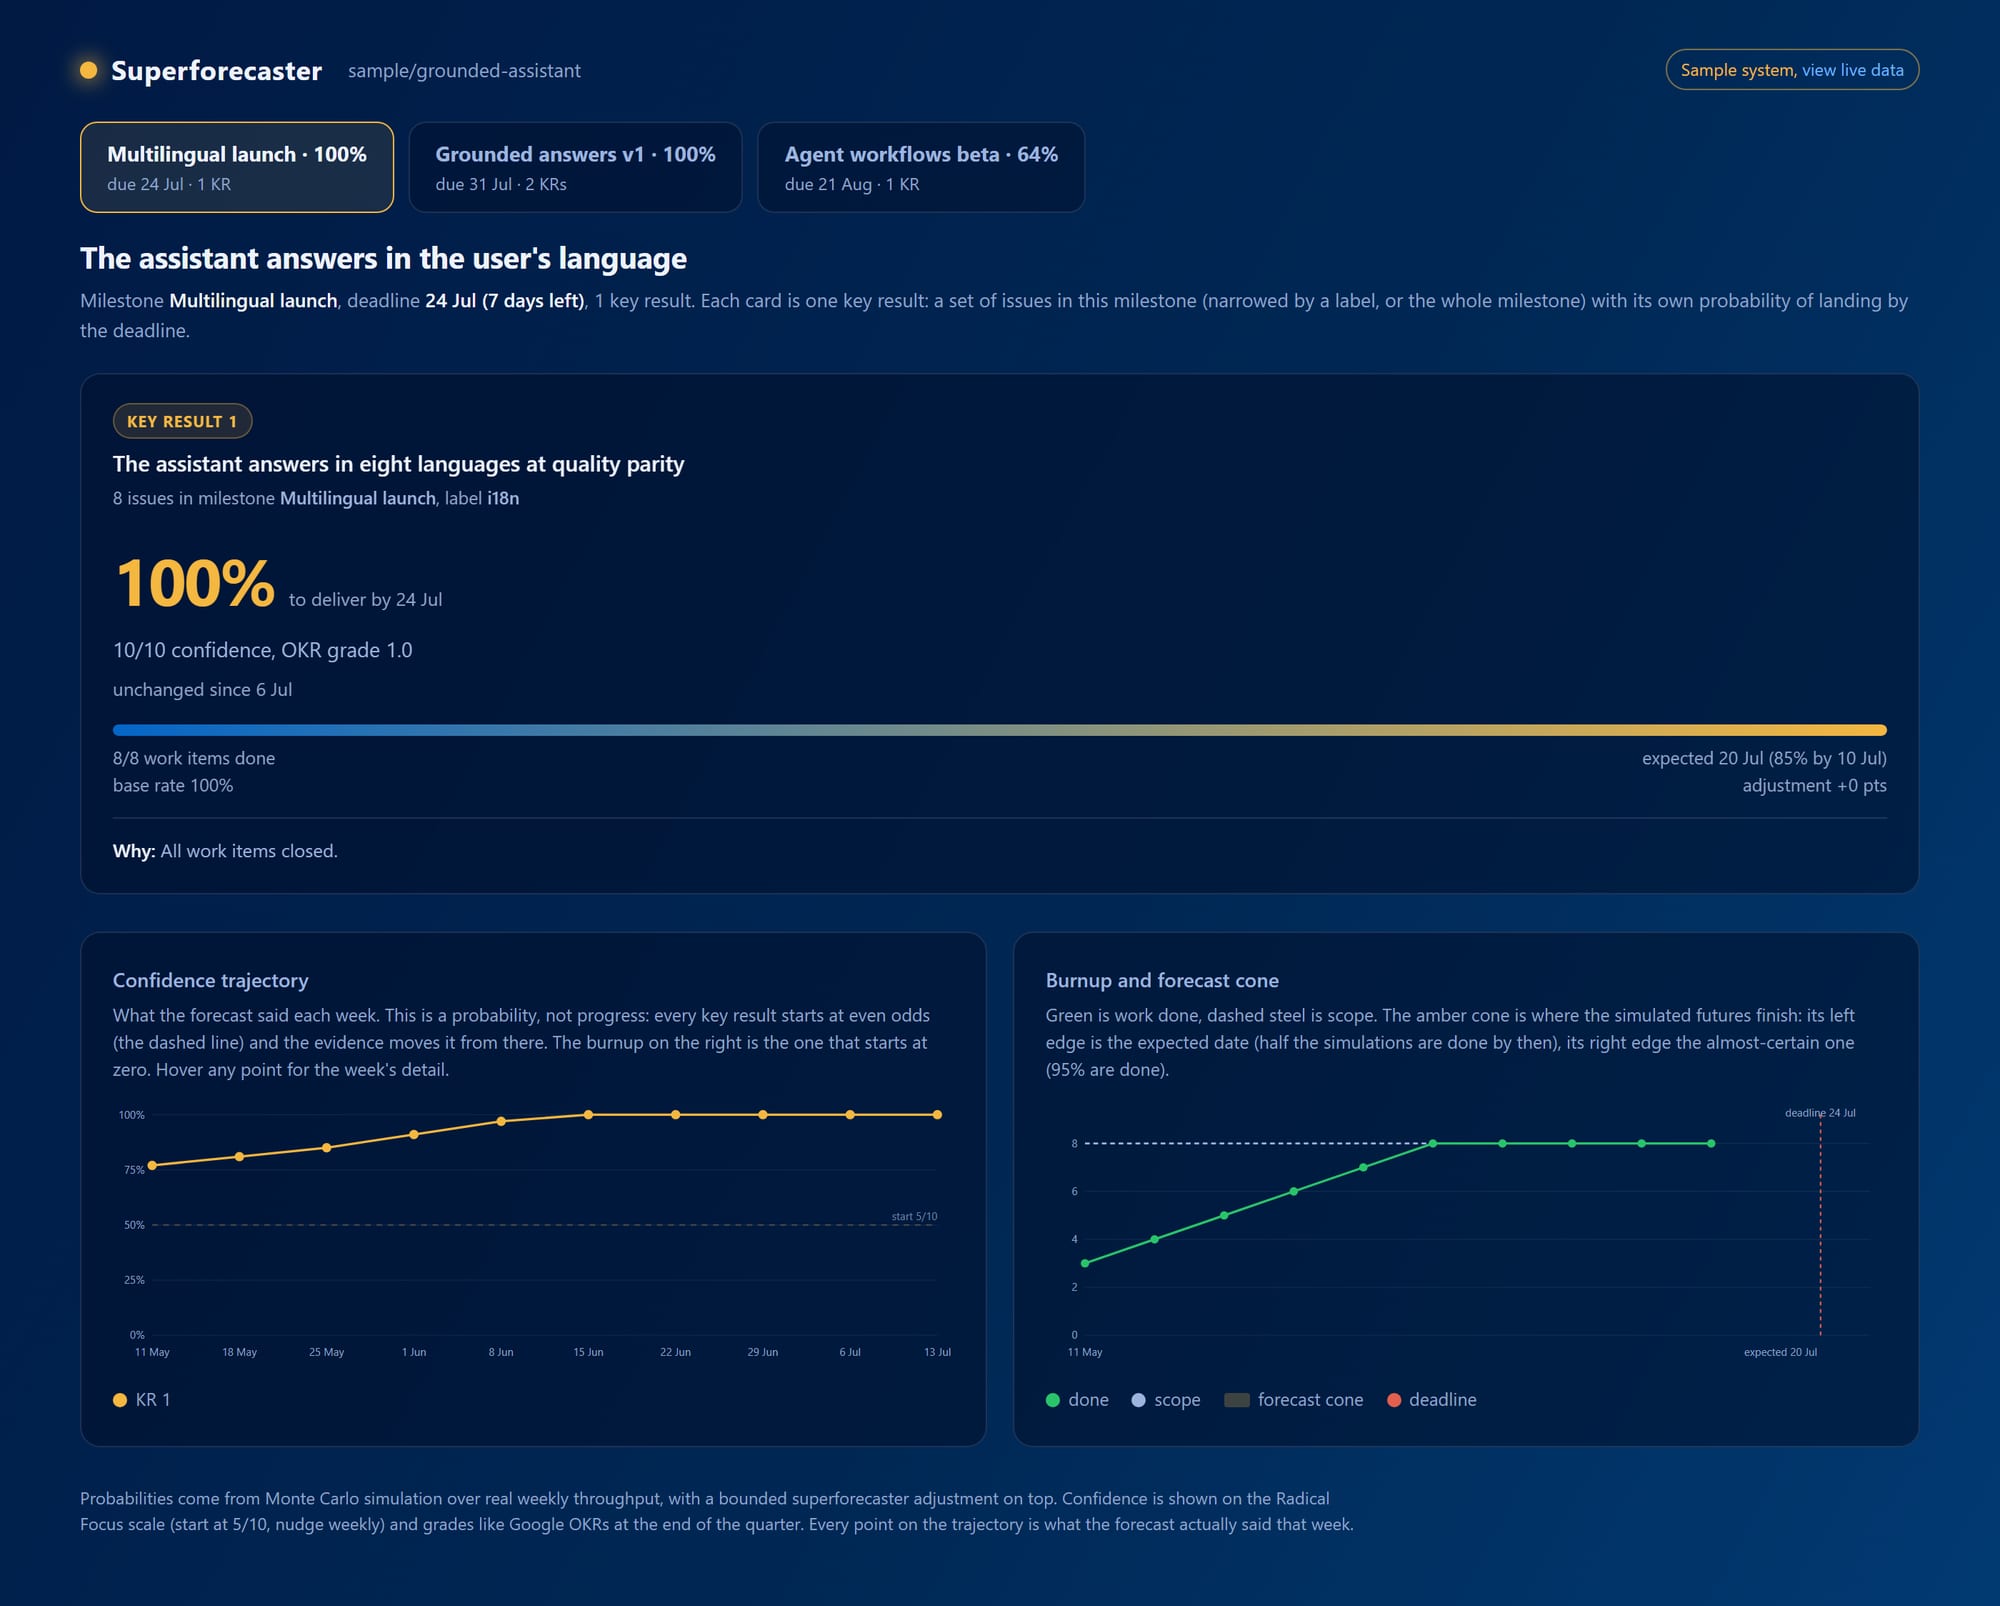
Das Business schaut vor dem Steering-Meeting ins Dashboard, statt jemanden zu fragen. Jedes Key Result zeigt seine Wahrscheinlichkeit, bis zu seinem Datum fertig zu werden, die Bewegung der Woche, das erwartete Ende und die schriftliche Begründung. Das Verlaufsdiagramm ist die OKR-Confidence-Linie, endlich echt: Sie startet bei fünfzig zu fünfzig, und jeder Punkt ist das, was die Prognose in jener Woche gesagt hat, keine Kurve, die für die Retro glattgezogen wurde. Zum Quartalsende fällt die Note von 0,0 bis 1,0 aus der Historie heraus, statt in einem Raum verhandelt zu werden.
Die Ansicht, die die ganze Methode rechtfertigt, ist die unerfreuliche. So sieht ein Milestone in Schwierigkeiten aus, aus dem Beispielsystem, das dem Dashboard beiliegt:
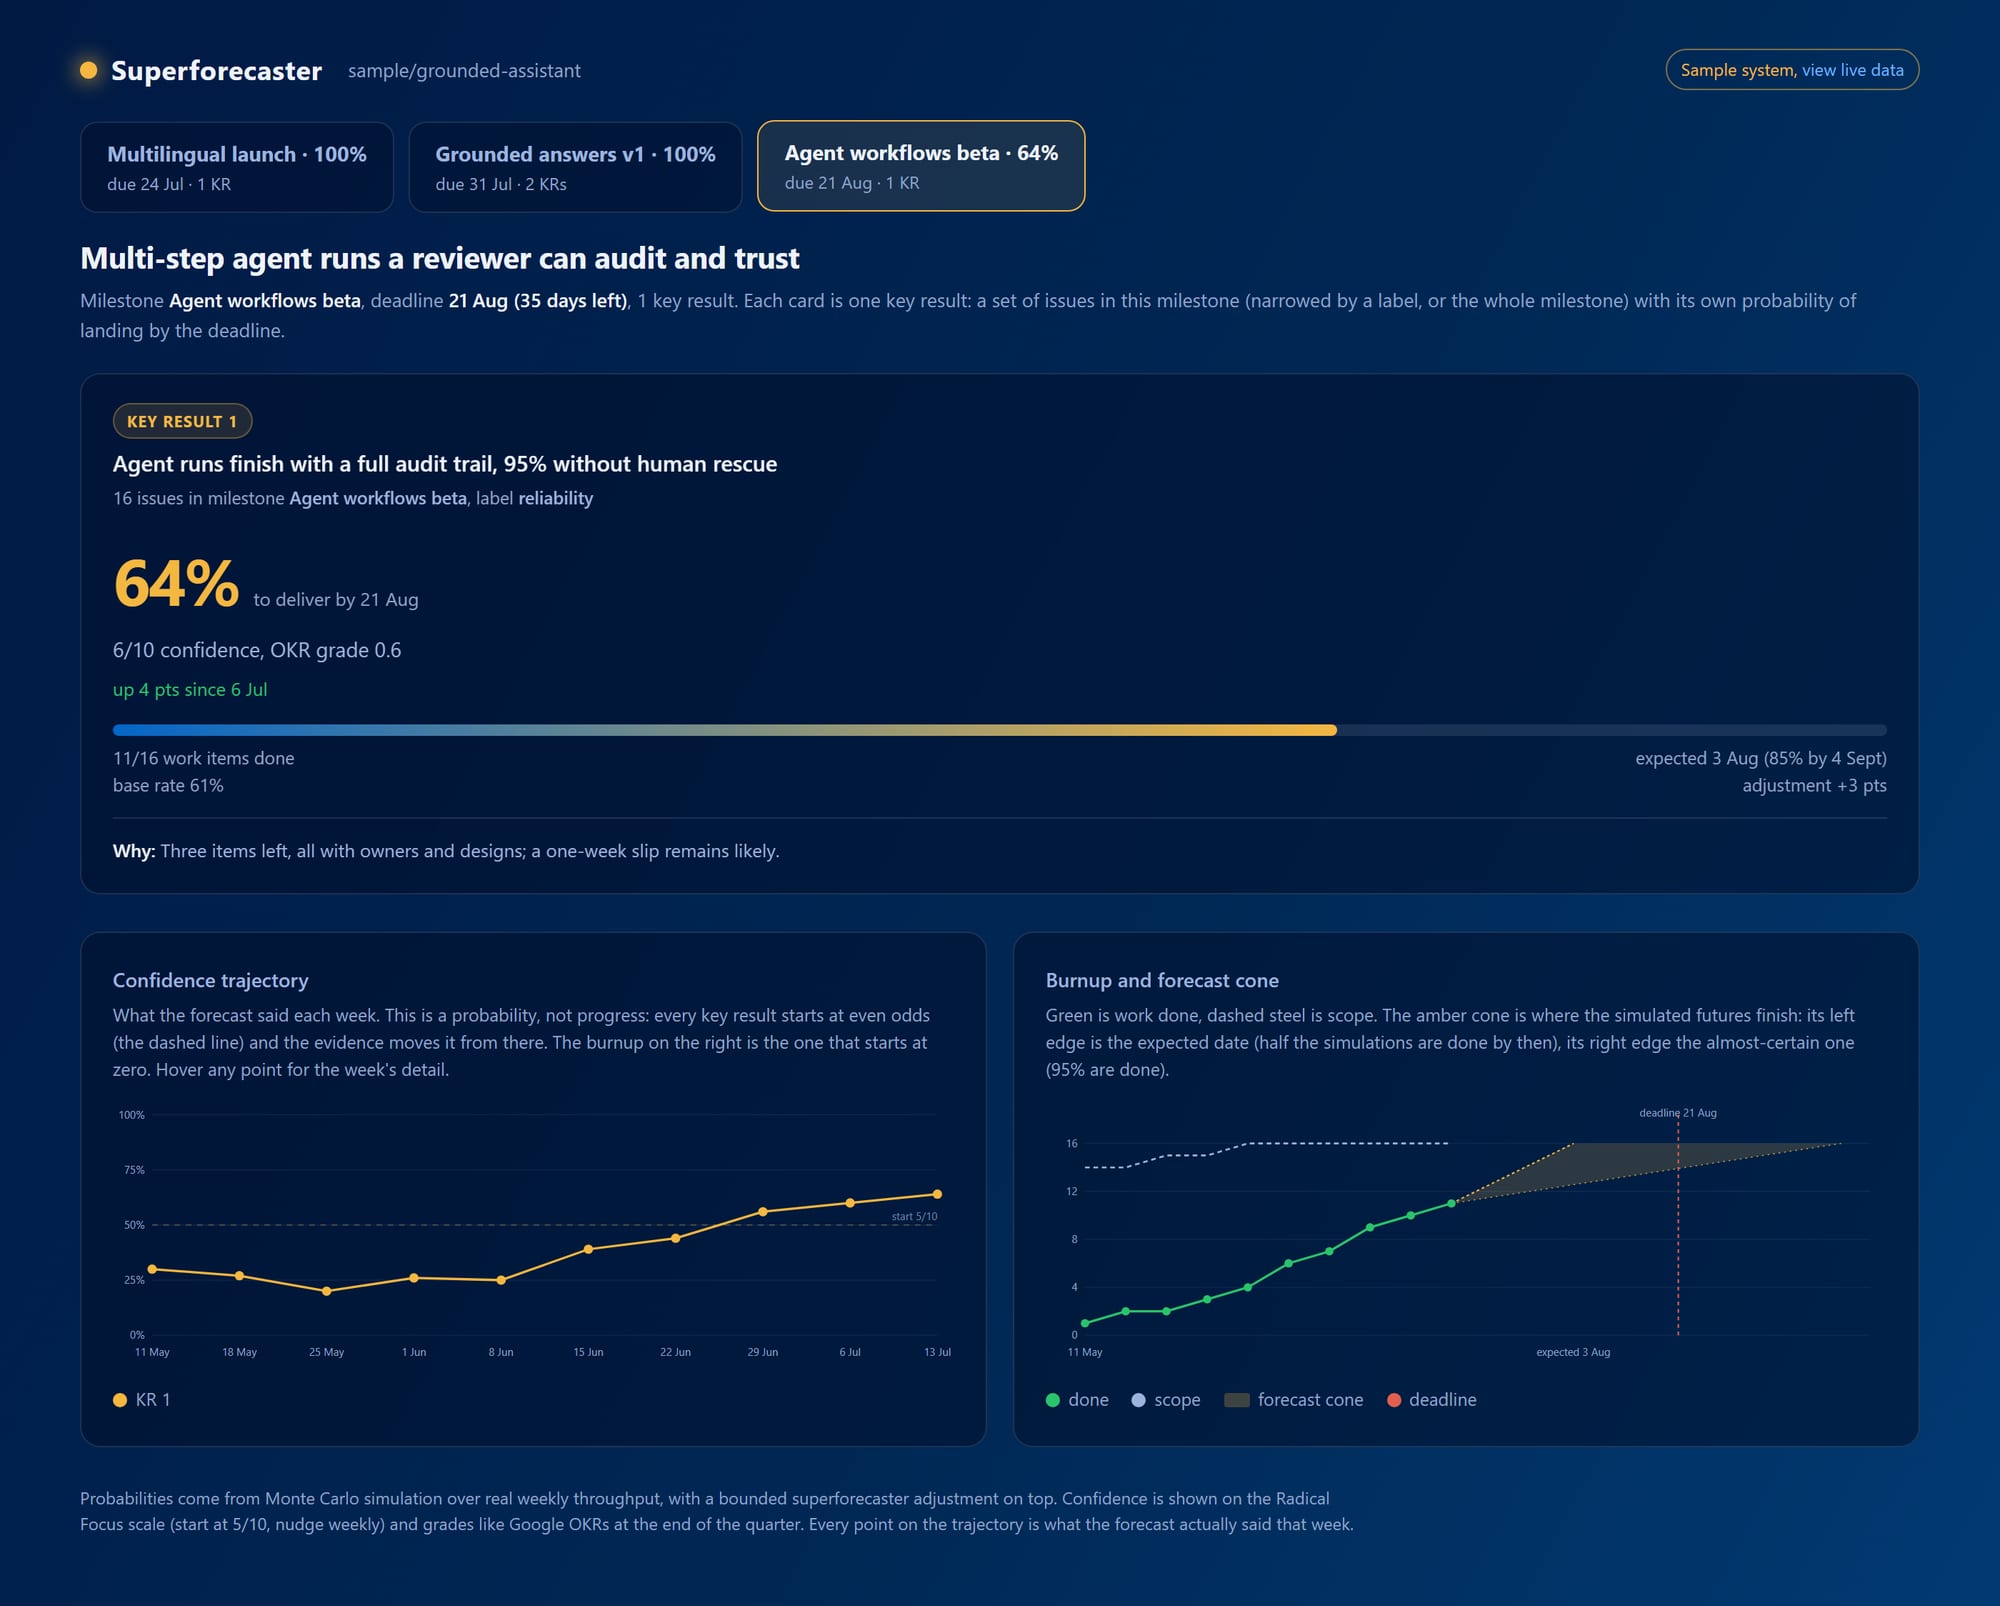
Ein Key Result bei 64 %, sichtbar in Schwierigkeiten, Monate bevor seine Deadline aufhört, verhandelbar zu sein. Die Confidence-Linie lag einen Monat lang unter ihrem Startpunkt, während ein blockierendes Stück Infrastruktur alles dahinter aufhielt, und die schriftliche Begründung sagte das jede Woche. Niemand musste eskalieren. Niemand musste in einem Meeting beichten. Die Zahl sank, der Grund hing daran, und das Team bekam Wochen zum Handeln statt einer bösen Überraschung an der Deadline.
Was das Tool mir an Tag eins beigebracht hat
Ich habe das als Produkt namens Superforecaster gebaut, und das erste Team, für das es Prognosen erstellt, ist es selbst: eigene Milestones, eigene Issues, eigene wöchentliche Check-ins, gepostet in den eigenen Tracker. Dogfooding hat mich innerhalb von Stunden etwas gelehrt. Beim ersten unbeaufsichtigten Lauf verkündete es eine Wahrscheinlichkeit von 100 %, Confidence zehn von zehn, für einen Milestone, der vier Wochen entfernt war. Die Ursache war eine heiße Woche voller geschlossener Issues und keinerlei Varianz, und das ist die älteste Sünde im Forecasting: totale Gewissheit aus einer winzigen Stichprobe. Die Korrektur bestand darin, dünne Historie die Unsicherheit verbreitern zu lassen statt sie zu verengen, und sich auf die Außensicht zu stützen, bis das Repository eine belastbare eigene Historie hat. Nach der Korrektur sagten dieselben Daten 35 %.
Diese Zahl war unangenehm, und das sollte sie sein. Ein Bauchgefühl hätte gesagt: „läuft gut." Die Prognose sagte: In diesem Tempo, mit diesem Scope, verfehlst du es wahrscheinlich. Mit 35 % kannst du streiten, dagegen Scope kürzen, deswegen ein Datum verschieben. An „läuft nach Plan" gibt es nichts, womit du streiten könntest. Der Milestone ist noch offen, während ich das schreibe, also wird die Historie diese 35 % so beurteilen, wie diese Methode jede Prognose beurteilt: bewertet an dem, was tatsächlich passiert ist. Bis dahin ist sie eine disziplinierte Schätzung, und das ist schon mehr, als ein Status-Meeting je jemandem gegeben hat.
Was jede Seite davon hat
Das Business bekommt eine Wahrscheinlichkeit, die von Woche zu Woche vergleichbar ist, weil jedes Mal dieselbe Methode sie erzeugt, mit angehängter Begründung. Wenn die Antwort schlecht ist, kommt sie früh genug, um die Anforderung zu ändern, solange das Quartal die Entscheidung noch verkraften kann.
Die Entwickler bekommen eine Definition von Erfolg, die ein Link ist, zu Beginn festgelegt und das ganze Quartal über sichtbar, und wenn sie sich ändert, ändert sie sich an genau dem Ort, an dem sie arbeiten. Sie bekommen außerdem ihre Woche zurück: Die Prognose liest ihre Commits und ihre Issues, nie ihre Zeit, und sie aggregiert auf Ebene des Milestones, sodass im Dashboard keine Zahlen pro Person stehen, auf die jemand starren könnte.
Die Leads sind die Rolle des Status-Routers los. Der Check-in schreibt sich aus dem Repository selbst, also fließt die Meeting-Zeit des Leads in das, was das Dashboard sichtbar gemacht hat, die blockierte Entscheidung, den gewachsenen Scope, statt ins Zusammentragen der Nachrichten.
Wo das Ganze bricht
Eine Wahrscheinlichkeit ist kein Versprechen, und die Methode ist nur so gut wie die Hygiene darunter. Wenn Arbeit nicht in Issues lebt, ist der Forecaster blind. Wenn Scope-Änderungen den Milestone nie berühren, lügt der Burnup.
Es gibt zwei Wege, auf denen die Zahlen verderben können, und sie brauchen verschiedene Gegenmittel. Der Forecaster selbst kann driften, und dagegen ist die Kur mechanisch: Jede Prognose wird festgehalten und bewertet, sobald der Milestone entschieden ist, damit die Historie zeigt, ob sie Vertrauen verdient. Das Team kann die Zahlen auch manipulieren, indem es hohle Issues schließt, Tickets aufteilt, um das Tempo aufzublähen, Scope aus dem Milestone herausschiebt, ohne dass jemand hinsieht, und keine Bewertung fängt das ab. Das Dashboard kann Scope-Änderungen und wieder geöffnete Issues sichtbar machen, aber die letzte Verteidigungslinie ist dieselbe wie immer: eine Review-Kultur, in der ein leeres Close nicht überlebt. Das kann ein Tool nicht liefern. Es kann die Manipulation nur sichtbar machen.
Auch die Unterbrechungen fallen nicht auf null. Eine Zahl, die an einem Montag um neun Punkte fällt, zieht Fragen nach sich, und das soll sie auch. Was sich ändert, ist, wo die Fragen landen und was sie mitbringen: Sie gehen an das Tracking-Issue, an dem die Begründung schon hängt, und das Gespräch beginnt bei „die Chancen sind gesunken, weil der Scope gewachsen ist, was streichen wir?" statt bei „wo stehen wir?". Das ist ein Gespräch, das sich lohnt, mit jedem.
Das Quartal beginnt damit, dass sich Menschen in einem Raum darauf einigen, was zählt. Die Aufgabe der Maschine ist alles danach: Sie beobachtet die Arbeit und macht die Rechnerei, und sie sagt allen dieselbe Zahl zur selben Zeit.
Fragen, die dieser Artikel beantwortet
Wie erkennt man früh, ob die Arbeit eines Quartals wirklich rechtzeitig fertig wird?
Indem man das Repository liest, statt Leute zu fragen. Jeden Montag läuft ein Job, nimmt, was in der Woche geschlossen wurde und was mitten in der Woche zum Scope dazukam, spielt den Rest des Quartals zehntausendmal über dieses echte Tempo durch und meldet den Anteil der Zukünfte, die die Deadline halten. Dünne Historie muss die Unsicherheit verbreitern statt sie zu verengen: Beim ersten unbeaufsichtigten Lauf verkündete das Tool 100 % für einen Milestone, der vier Wochen entfernt war, und nach der Korrektur sagten dieselben Daten 35 %.
Was unterscheidet das von Burndown-Charts und Velocity-Reports?
Die verarbeiten dieselben Daten, leben aber auf Sprint-Ebene im Tooling der Entwickler, wo das Business nie hinschaut, und sie liefern Diagramme statt Wahrscheinlichkeiten mit angehängter Begründung. Niemand geht zurück und bewertet einen Burndown daran, was tatsächlich ausgeliefert wurde, also kann dir niemand sagen, ob das Chart vom letzten Quartal Vertrauen verdient hatte. Hier wird jede Prognose festgehalten und bewertet, sobald der Milestone entschieden ist, und die Modellschicht, die die offenen Issues liest, darf die Zahl um höchstens fünfzehn Punkte verschieben, mit veröffentlichter Begründung und getrennt von der rohen Prognose bewertet.
Was hindert ein Team daran, die Prognose durch das Schließen leerer Issues zu manipulieren?
Nichts im Tool, und diese Grenze gehört ausgesprochen. Die Bewertung fängt das Driften des Forecasters ab, aber nicht hohle Closes, nicht Tickets, die zum Aufblähen des Tempos aufgeteilt werden, und nicht Scope, der unbeobachtet aus dem Milestone verschwindet. Das Dashboard kann Scope-Änderungen und wieder geöffnete Issues sichtbar machen; die letzte Verteidigungslinie ist dieselbe wie immer, eine Review-Kultur, in der ein leeres Close nicht überlebt.
Misst das am Ende einzelne Entwickler?
Nein. Die Prognose liest Commits und Issues, nie jemandes Zeit, und sie aggregiert auf Ebene des Milestones, sodass im Dashboard keine Zahlen pro Person stehen, auf die jemand starren könnte. Was Entwickler stattdessen bekommen, ist eine Definition von Erfolg, die ein Link ist, zu Quartalsbeginn festgelegt und das ganze Quartal über sichtbar, und die Nachmittage zurück, die bisher in Statusberichte flossen, die niemand bewertet.
Weiterlesen
 AI
Wenn die KI ihr eigenes Review filmen muss
Wenn ein Pull Request aufgemacht wird, mein eigener oder einer, den ich reviewen muss, bitte ich den Agenten inzwischen, ihn auf meinem Rechner laufen zu lassen, zu versuchen, ihn kaputtzumachen, und sich dabei zu filmen. Ein Absatz kann behaupten, dass ein Test stattgefunden hat. Eine Aufnahme muss es zeigen, und zu entscheiden, was das bedeutet, bleibt meine Aufgabe. AI
Jev antwortet in Wahrscheinlichkeiten. Die Frage bleibt deine.
Jev von TypeSafe schreibt keinen einzigen Satz. Du gibst ihm einen Zustand und typisierte Fragen, und es gibt eine Wahl, einen Score oder eine Ja/Nein-Wahrscheinlichkeit zurück, für vier Tausendstel Cent pro Entscheidung bei tausend Tokens Eingabe. Das Neue ist die Form, die die Autorität zurück in deinen Code legt, und die Falle ist, dass eine Wahrscheinlichkeit nach Absicherung aussieht und keine ist. Ich habe den Pilotversuch gefahren, den ich verlangen würde, bevor ich irgendeiner Zahl glaube, auf meinen eigenen Essays mit dem offenen Modell, das für Jev eingesprungen ist, und die Antwort war Nein.