
Imaginez un monde où les livres répondent à vos questions
Écouter l'article (expérimental) · 04:34
Intro
Vous êtes-vous déjà demandé ce que ce serait de poser des questions directement aux livres ? Les grands modèles de langage (LLM) comme OpenAI GPT-4 sont en train d'en faire une réalité. Dans ce guide concis, nous explorons l'univers captivant des LLM et leur potentiel à transformer de nombreux secteurs. Découvrez comment relier les LLM à des sources de données externes peut révéler des possibilités incroyables et enrichir notre interaction avec le savoir écrit. Laissons-nous inspirer ensemble !
Que sont les LLM ?
Les LLM exploitent la puissance des algorithmes d'apprentissage profond et des réseaux de neurones, en particulier les modèles transformeurs, pour comprendre et générer du texte en langage naturel. Entraînés sur de vastes jeux de données tels que des livres, des articles et des sites web, ces modèles sont capables de produire un texte d'apparence humaine. Ils prennent la capacité remarquable de personnes comme Kim Peek, qui pouvait lire des livres à grande vitesse et en retenir presque tout, et la portent à de nouveaux sommets. Parmi les exemples notables de LLM figurent BERT de Google, BLOOM de HuggingFace, LLaMA de Meta, et GPT-4 d'OpenAI.
Pourquoi utiliser les LLM ?
Les LLM ouvrent un monde de possibilités dans de nombreux secteurs :
- Santé : aider au diagnostic.
- Éducation : élaborer des plans d'apprentissage personnalisés.
- Développement logiciel : fluidifier le processus d'écriture de code.
Pour mieux éclairer le potentiel des LLM, explorons un scénario juridique. En reliant les LLM à des bases de données juridiques, on peut poser un socle de connaissances juridiques pour les avocats qui jonglent entre plusieurs affaires. Le LLM examine ensuite les circonstances propres à chaque affaire, en étudiant les pièces spécifiques du dossier en parallèle des textes de loi généraux, en croisant les lois et la jurisprudence pertinentes, et en générant des réponses sur mesure et précises pour chaque situation. Résultat : les LLM peuvent automatiser des tâches comme la rédaction de documents juridiques et l'analyse des affaires, ce qui fait gagner du temps et augmente l'efficacité, tant pour les avocats que pour leurs clients.
Comment utiliser les LLM ?
Pour exploiter la puissance des LLM, il est essentiel de cibler les tâches ou les questions qui exigent une expertise métier ou des informations qui vont au-delà des connaissances générales du LLM. Cela revient à comprendre quelle information précise est requise pour générer des réponses justes. Une fois cela identifié, nous pouvons obtenir l'information nécessaire en reliant les LLM à des sources de données externes, telles que des PDF, des API et des bases de données. Pour gérer la connexion entre les LLM et les données externes, des outils comme LangChain et LlamaIndex se révèlent pratiques, garantissant une intégration plus simple.
Projet d'exemple
Dans ce projet d'exemple, nous allons poser des questions et obtenir des réponses à partir d'un livre en utilisant GPT-4 d'OpenAI, LangChain et Pinecone (voir ici pour un exemple avec LlamaIndex). Ce projet est largement inspiré du travail de Gregory Kamradt. La seule différence est l'utilisation du Nouveau Testament (PDF) comme matériau source et le fait de poser des questions qui s'y rapportent.
Pour réaliser l'ensemble des étapes en local sous Windows 10, j'ai utilisé un jupyter-lab. Plusieurs bibliothèques Python étaient en outre nécessaires, telles que langchain, unstructured[local-inference], pinecone-client, et openai.
Il a ensuite suffi de suivre les étapes décrites dans le notebook de Gregory, qui consistent à
- Charger les données depuis un .PDF avec LangChain.
- Découper les données en documents plus petits de 1000 caractères.
- Créer des embeddings OpenAPI des documents et les stocker dans Pinecone.
- Interroger ces documents pour obtenir votre réponse
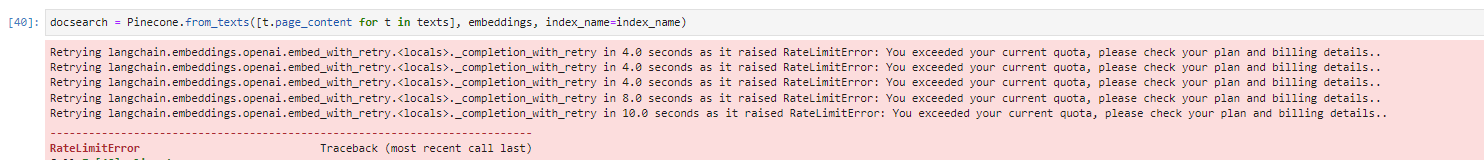
Si vous rencontrez une ReplicationError, assurez-vous d'avoir une carte configurée dans OpenAI.
Voici également le résultat final dans Pinecone, avec plus de 3000 vecteurs.
Et voilà !
Les questions auxquelles cet article répond
Comment poser des questions à mon propre PDF avec un LLM ?
Chargez le PDF avec LangChain, découpez les données en documents plus petits de 1000 caractères, créez des embeddings de ces documents et stockez-les dans Pinecone, puis interrogez-les pour obtenir la réponse. Le projet d'exemple présenté ici fait exactement cela avec GPT-4, LangChain et Pinecone, en prenant le Nouveau Testament comme matériau source. LlamaIndex est l'alternative pour gérer la même connexion entre le modèle et les données.
Pourquoi relier des données externes plutôt que d'interroger directement le modèle ?
Parce que les tâches qui justifient un LLM sont celles qui exigent une expertise métier ou des informations qui vont au-delà de ses connaissances générales. Le travail consiste à cibler quelle information précise est requise pour une réponse juste, puis à la fournir depuis des sources de données externes telles que des PDF, des API et des bases de données. Des outils comme LangChain et LlamaIndex existent pour gérer cette connexion et rendre l'intégration plus simple.
De quoi ai-je besoin pour reproduire ce projet moi-même ?
D'un environnement notebook et de quatre bibliothèques Python. Le montage décrit ici utilisait jupyter-lab sous Windows 10 avec langchain, unstructured avec local-inference, pinecone-client et openai, plus des comptes OpenAI et Pinecone. Le notebook suit les étapes du notebook de Gregory Kamradt, avec le Nouveau Testament comme livre source et des questions qui s'y rapportent.
Faut-il un compte OpenAI payant, et qu'est-ce que la ReplicationError ?
La ReplicationError signifie qu'aucune carte n'est configurée dans OpenAI, donc commencez par vérifier la facturation si vous tombez dessus. L'étape qui la déclenche est la création des embeddings du livre, ce qui ne se limite pas à deux appels de test : le texte source a donné ici plus de 3000 vecteurs dans Pinecone.
À lire ensuite
 AI
Quand l'IA doit filmer sa propre relecture
Quand une pull request est ouverte, la mienne ou une autre que je dois relire, je demande désormais à l'agent de la lancer sur ma machine, d'essayer de la casser et de se filmer en train de le faire. Un paragraphe peut affirmer qu'un test a eu lieu. Un enregistrement doit le montrer, et décider de ce qu'il signifie reste mon travail. AI
Jev répond en probabilités. La question reste la vôtre.
Jev, de TypeSafe, n'écrira pas une phrase. Vous lui tendez un état et des questions typées, et il vous rend un choix, un score ou une probabilité oui/non, pour quatre millièmes de centime par décision sur mille tokens. La nouveauté, c'est la forme, qui remet l'autorité dans votre code, et le piège, c'est qu'une probabilité ressemble à un recours et n'en est pas un. J'ai lancé le pilote qu'il me faudrait avant de croire le moindre chiffre, sur mes propres essais avec le modèle ouvert qui a servi de doublure à Jev, et la réponse a été non.