
Stellen Sie sich eine Welt vor, in der Bücher Ihre Fragen beantworten
Artikel anhören (experimentell) · 04:59
Intro
Haben Sie sich je gefragt, wie es wäre, Fragen direkt an Bücher zu stellen? Große Sprachmodelle (Large Language Models, LLMs) wie OpenAI GPT-4 machen das zur Realität. In diesem kompakten Leitfaden tauchen wir in die faszinierende Welt der LLMs ein und in ihr Potenzial, verschiedene Branchen zu verändern. Erfahren Sie, wie die Anbindung von LLMs an externe Datenquellen unglaubliche Möglichkeiten eröffnet und unseren Umgang mit schriftlichem Wissen bereichert. Lassen wir uns gemeinsam inspirieren!
Was sind LLMs?
LLMs nutzen die Kraft von Deep-Learning-Algorithmen und neuronalen Netzen, konkret von Transformer-Modellen, um natürlichsprachlichen Text zu verstehen und zu erzeugen. Trainiert auf riesigen Datensätzen wie Büchern, Artikeln und Websites, sind diese Modelle in der Lage, menschenähnlichen Text zu produzieren. Sie nehmen die bemerkenswerte Fähigkeit von Menschen wie Kim Peek, der Bücher rasend schnell lesen und nahezu alles behalten konnte, und heben diese Fähigkeit auf eine neue Stufe. Zu den bekannten Beispielen für LLMs zählen Googles BERT, HuggingFace BLOOM, Metas LLaMA und OpenAIs GPT-4.
Warum LLMs einsetzen?
LLMs eröffnen eine Welt voller Möglichkeiten in verschiedenen Branchen:
- Gesundheitswesen: Unterstützung bei der Diagnostik.
- Bildung: Erstellung personalisierter Lernpläne.
- Softwareentwicklung: Vereinfachung des Schreibens von Code.
Um das Potenzial von LLMs weiter zu verdeutlichen, betrachten wir ein juristisches Szenario. Durch die Anbindung von LLMs an juristische Datenbanken kann ein Fundament an Rechtswissen für Anwältinnen und Anwälte geschaffen werden, die mehrere Fälle gleichzeitig betreuen. Das LLM vertieft sich dann in die besonderen Umstände jedes Falls, prüft konkrete Fallakten neben allgemeinen Rechtsdokumenten, verweist auf einschlägige Gesetze und Präzedenzfälle und erzeugt für jede Situation maßgeschneiderte, präzise Antworten. Im Ergebnis können LLMs Aufgaben wie das Erstellen juristischer Dokumente und die Fallanalyse automatisieren und so letztlich Zeit sparen und die Effizienz für Anwälte und Mandanten gleichermaßen steigern.
Wie setzt man LLMs ein?
Um die Kraft von LLMs zu nutzen, ist es entscheidend, Aufgaben oder Fragen zu identifizieren, die Fachwissen oder zusätzliche Informationen über das allgemeine Wissen des LLM hinaus erfordern. Das bedeutet, die konkreten Informationen zu verstehen, die nötig sind, um präzise Antworten zu erzeugen. Sind diese identifiziert, können wir die nötigen Informationen beschaffen, indem wir LLMs an externe Datenquellen anbinden, etwa PDFs, APIs und Datenbanken. Um die Verbindung zwischen LLMs und externen Daten zu verwalten, sind Werkzeuge wie LangChain und LlamaIndex hilfreich und gewährleisten eine einfachere Integration.
Beispielprojekt
In diesem Beispielprojekt stellen wir Fragen an ein Buch und erhalten Antworten daraus, mithilfe von OpenAIs GPT-4, LangChain und Pinecone (hier nachzulesen für ein Beispiel mit LlamaIndex). Dieses Projekt ist stark von Gregory Kamradts Arbeit inspiriert. Der einzige Unterschied ist die Verwendung des Neuen Testaments (PDF) als Quellenmaterial und das Stellen von Fragen dazu.
Um die gesamte Liste der Schritte lokal unter Windows 10 abzuarbeiten, habe ich ein jupyter-lab verwendet. Zusätzlich waren mehrere Python-Bibliotheken nötig, etwa langchain, unstructured[local-inference], pinecone-client und openai.
Danach war es einfach eine Frage des Befolgens der in Gregorys Notebook beschriebenen Schritte, die wie folgt lauten:
- Die Daten aus einer .PDF mit LangChain laden.
- Die Daten in kleinere Dokumente zu je 1000 Zeichen aufteilen.
- OpenAPI-Embeddings der Dokumente erstellen und sie in Pinecone speichern.
- Diese Dokumente abfragen, um Ihre Antwort zurückzubekommen.
Falls Sie auf einen ReplicationError stoßen, stellen Sie sicher, dass bei OpenAI eine Zahlungskarte hinterlegt ist.
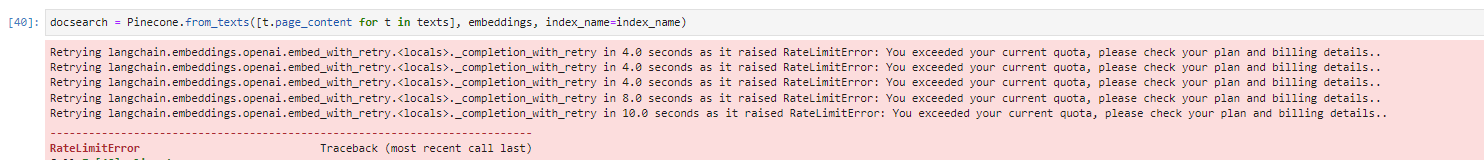
Und das ist das Endergebnis in Pinecone mit über 3000 Vektoren.
Das war's!
Fragen, die dieser Artikel beantwortet
Wie bringe ich ein LLM dazu, Fragen zu meinem eigenen PDF zu beantworten?
Laden Sie das PDF mit LangChain, teilen Sie die Daten in kleinere Dokumente zu je 1000 Zeichen auf, erstellen Sie Embeddings dieser Dokumente und speichern Sie sie in Pinecone, und fragen Sie diese dann ab, um die Antwort zurückzubekommen. Das Beispielprojekt hier macht genau das mit GPT-4, LangChain und Pinecone und nutzt das Neue Testament als Quellenmaterial. LlamaIndex ist die Alternative, um dieselbe Verbindung zwischen Modell und Daten zu verwalten.
Warum überhaupt externe Daten anbinden, statt das Modell einfach direkt zu fragen?
Weil sich ein LLM für die Aufgaben lohnt, die Fachwissen oder Informationen über das allgemeine Wissen des Modells hinaus erfordern. Die Arbeit besteht darin, zu bestimmen, welche konkreten Informationen eine präzise Antwort braucht, und sie dann aus externen Datenquellen wie PDFs, APIs und Datenbanken zu beschaffen. Werkzeuge wie LangChain und LlamaIndex gibt es, um diese Verbindung zu verwalten und die Integration einfacher zu machen.
Was muss ich installieren, um das selbst nachzubauen?
Eine Notebook-Umgebung und vier Python-Bibliotheken. Der hier beschriebene Aufbau nutzte jupyter-lab unter Windows 10 mit langchain, unstructured mit local-inference, pinecone-client und openai, dazu Konten bei OpenAI und Pinecone. Das Notebook folgt den Schritten aus Gregory Kamradts Notebook, nur mit dem Neuen Testament als Quellbuch und den passenden Fragen dazu.
Brauche ich ein kostenpflichtiges OpenAI-Konto, und was ist der ReplicationError?
Der ReplicationError bedeutet, dass bei OpenAI keine Zahlungskarte hinterlegt ist, prüfen Sie also zuerst die Abrechnung, wenn er auftritt. Ausgelöst wird er beim Erstellen der Embeddings für das Buch, und das sind keine zwei Testaufrufe: aus dem Quelltext wurden hier über 3000 Vektoren in Pinecone.
Weiterlesen
 AI
Wenn die KI ihr eigenes Review filmen muss
Wenn ein Pull Request aufgemacht wird, mein eigener oder einer, den ich reviewen muss, bitte ich den Agenten inzwischen, ihn auf meinem Rechner laufen zu lassen, zu versuchen, ihn kaputtzumachen, und sich dabei zu filmen. Ein Absatz kann behaupten, dass ein Test stattgefunden hat. Eine Aufnahme muss es zeigen, und zu entscheiden, was das bedeutet, bleibt meine Aufgabe. AI
Jev antwortet in Wahrscheinlichkeiten. Die Frage bleibt deine.
Jev von TypeSafe schreibt keinen einzigen Satz. Du gibst ihm einen Zustand und typisierte Fragen, und es gibt eine Wahl, einen Score oder eine Ja/Nein-Wahrscheinlichkeit zurück, für vier Tausendstel Cent pro Entscheidung bei tausend Tokens Eingabe. Das Neue ist die Form, die die Autorität zurück in deinen Code legt, und die Falle ist, dass eine Wahrscheinlichkeit nach Absicherung aussieht und keine ist. Ich habe den Pilotversuch gefahren, den ich verlangen würde, bevor ich irgendeiner Zahl glaube, auf meinen eigenen Essays mit dem offenen Modell, das für Jev eingesprungen ist, und die Antwort war Nein.