
Imagine um Mundo Onde os Livros Respondem às Suas Perguntas
Ouvir o artigo (experimental) · 04:29
Introdução
Já alguma vez se perguntou como seria fazer perguntas diretamente aos livros? Os Large Language Models (LLMs) como o GPT-4 da OpenAI estão a tornar isto realidade. Neste guia conciso, mergulhamos no fascinante universo dos LLMs e no seu potencial para transformar vários setores. Fique a saber como ligar LLMs a fontes de dados externas pode revelar possibilidades incríveis e enriquecer a nossa interação com o conhecimento escrito. Deixemo-nos inspirar em conjunto!
O que são LLMs?
Os LLMs aproveitam o poder dos algoritmos de aprendizagem profunda e das redes neuronais, em particular os transformer models, para compreender e gerar texto em linguagem natural. Treinados em conjuntos de dados vastos, como livros, artigos e websites, estes modelos são capazes de produzir texto semelhante ao humano. Pegam na notável capacidade de pessoas como o Kim Peek, que conseguia ler livros depressa e reter quase tudo, e levam-na a novos patamares. Alguns exemplos notáveis de LLMs incluem o BERT da Google, o BLOOM da HuggingFace, o LLaMA da Meta e o GPT-4 da OpenAI.
Porquê usar LLMs?
Os LLMs abrem um mundo de possibilidades em vários setores:
- Saúde: apoiar o diagnóstico.
- Educação: desenhar planos de aprendizagem personalizados.
- Desenvolvimento de software: simplificar o processo de escrever código.
Para ilustrar melhor o potencial dos LLMs, exploremos um cenário jurídico. Ao ligar LLMs a bases de dados jurídicas, é possível assentar uma base de conhecimento legal para advogados que gerem vários processos em simultâneo. O LLM aprofunda depois as circunstâncias particulares de cada caso, examinando peças processuais específicas a par de documentos legais gerais, cruzando leis e precedentes pertinentes e gerando respostas rigorosas e à medida para cada situação. Como resultado, os LLMs podem automatizar tarefas como redigir documentos jurídicos e fazer análise de casos, poupando tempo e aumentando a eficiência tanto para advogados como para clientes.
Como usar LLMs?
Para aproveitar o poder dos LLMs, é crucial identificar tarefas ou perguntas que exijam conhecimento de domínio ou informação adicional, para além do conhecimento geral do LLM. Isto implica perceber que informação específica é necessária para gerar respostas precisas. Uma vez identificada, podemos obter a informação necessária ligando os LLMs a fontes de dados externas, como PDFs, APIs e bases de dados. Para gerir a ligação entre os LLMs e os dados externos, ferramentas como o LangChain e o LlamaIndex dão jeito, garantindo uma integração mais fácil.
Projeto de exemplo
Neste projeto de exemplo vamos fazer perguntas e obter respostas a partir de um livro usando o GPT-4 da OpenAI, o LangChain e o Pinecone (leia aqui um exemplo com LlamaIndex). Este projeto é fortemente inspirado no trabalho de Gregory Kamradt. A única diferença é o uso do Novo Testamento (PDF) como material de origem e a colocação de perguntas relacionadas com ele.
Para completar toda a lista de passos localmente em Windows 10, usei um jupyter-lab. Além disso, foram precisas várias bibliotecas de Python, como o langchain, unstructured[local-inference], o pinecone-client e o openai.
Depois foi apenas uma questão de seguir os passos descritos no notebook do Gregory, que consistem em
- Carregar os dados de um .PDF usando o LangChain.
- Partir os dados em documentos mais pequenos de 1000 caracteres.
- Criar embeddings OpenAPI dos documentos e guardá-los no Pinecone.
- Consultar esses docs para obter a sua resposta
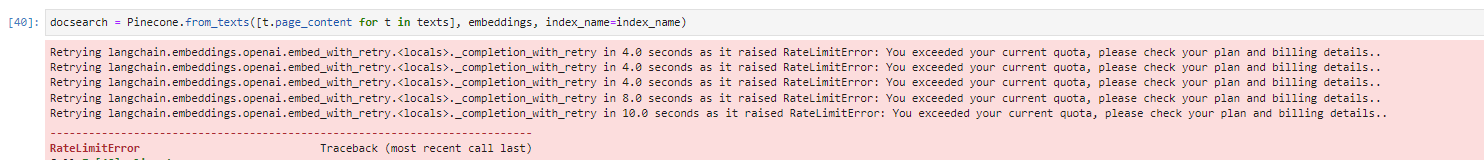
Se encontrar um ReplicationError, certifique-se de que tem um cartão configurado na OpenAI.
Além disso, este é o resultado final no Pinecone, com mais de 3000 vetores.
É isto!
Perguntas a que este artigo responde
Como fazer perguntas a um PDF meu e obter respostas de um LLM?
Carregue o PDF com o LangChain, parta os dados em documentos mais pequenos de 1000 caracteres, crie embeddings desses documentos e guarde-os no Pinecone, e depois consulte-os para obter a resposta. O projeto de exemplo aqui faz exatamente isso com o GPT-4, o LangChain e o Pinecone, usando o Novo Testamento como material de origem. O LlamaIndex é a alternativa para gerir a mesma ligação entre o modelo e os dados.
Porquê ligar dados externos em vez de perguntar diretamente ao modelo?
Porque as tarefas que compensam num LLM são as que exigem conhecimento de domínio ou informação para além do conhecimento geral do modelo. O trabalho está em perceber que informação específica é necessária para gerar uma resposta precisa e depois fornecê-la a partir de fontes de dados externas como PDFs, APIs e bases de dados. Ferramentas como o LangChain e o LlamaIndex existem para gerir essa ligação e garantir uma integração mais fácil.
O que preciso de instalar para montar isto sozinho?
Um ambiente de notebook e quatro bibliotecas de Python. A montagem descrita aqui usou jupyter-lab em Windows 10 com langchain, unstructured com local-inference, pinecone-client e openai, além de contas na OpenAI e no Pinecone. O notebook segue os passos do notebook de Gregory Kamradt, trocando o livro de origem e as perguntas pelo Novo Testamento.
Preciso de uma conta paga na OpenAI e o que é o ReplicationError?
O ReplicationError significa que não tem um cartão configurado na OpenAI, por isso comece por verificar a faturação se der com ele. O passo que o desencadeia é criar os embeddings do livro, que não são duas chamadas de teste: o texto de origem aqui deu mais de 3000 vetores no Pinecone.
Ler a seguir
 AI
Quando a IA tem de filmar a sua própria revisão
Quando é aberto um pull request, meu ou um que tenho de rever, passei a pedir ao agente que o corra na minha máquina, que tente parti-lo e que se filme a fazê-lo. Um parágrafo pode afirmar que houve um teste. Uma gravação tem de o mostrar, e decidir o que isso significa continua a ser trabalho meu. AI
O Jev responde em probabilidades. A pergunta continua a ser tua.
O Jev, da TypeSafe, não escreve uma frase. Entregas-lhe um estado e perguntas tipadas, e ele devolve uma escolha, uma pontuação ou uma probabilidade de sim ou não, por quatro milésimos de cêntimo numa decisão de mil tokens. A novidade é a forma, que devolve a autoridade ao teu código, e a armadilha é que uma probabilidade parece recurso e não é. Corri o piloto que eu quereria ver antes de acreditar em qualquer número, nos meus próprios ensaios com o modelo aberto que fez as vezes do Jev, e a resposta foi não.