
Imagina un mundo donde los libros responden a tus preguntas
Escuchar el artículo (experimental) · 04:26
Introducción
¿Alguna vez te has preguntado cómo sería hacerles preguntas directamente a los libros? Los grandes modelos de lenguaje (LLM) como GPT-4 de OpenAI lo están haciendo realidad. En esta guía concisa nos adentramos en el cautivador mundo de los LLM y su potencial para transformar distintos sectores. Descubre cómo conectar los LLM a fuentes de datos externas puede revelar posibilidades increíbles y mejorar nuestra interacción con el conocimiento escrito. ¡Inspirémonos juntos!
¿Qué son los LLM?
Los LLM aprovechan la potencia de los algoritmos de aprendizaje profundo y las redes neuronales, en concreto los modelos transformer, para entender y generar texto en lenguaje natural. Entrenados con conjuntos de datos enormes, como libros, artículos y sitios web, estos modelos son capaces de producir texto similar al humano. Toman la extraordinaria capacidad de personas como Kim Peek, que podía leer libros a gran velocidad y retener casi todo, y la llevan a nuevas cotas. Algunos ejemplos destacados de LLM son BERT de Google, BLOOM de HuggingFace, LLaMA de Meta y GPT-4 de OpenAI.
¿Por qué usar LLM?
Los LLM abren un mundo de posibilidades en distintos sectores:
- Sanidad: ayudar en el diagnóstico.
- Educación: elaborar planes de aprendizaje personalizados.
- Desarrollo de software: agilizar el proceso de escritura de código.
Para iluminar aún más el potencial de los LLM, exploremos un escenario legal. Al conectar los LLM a bases de datos jurídicas, pueden asentar una base de conocimiento legal para abogados que llevan varios casos a la vez. El LLM se adentra entonces en las circunstancias particulares de cada caso, examinando expedientes concretos junto a documentos legales generales, cruzando leyes y precedentes pertinentes y generando respuestas adaptadas y precisas para cada situación. Como resultado, los LLM pueden automatizar tareas como la redacción de documentos legales y el análisis de casos, ahorrando tiempo y aumentando la eficiencia tanto para abogados como para clientes.
¿Cómo usar los LLM?
Para aprovechar la potencia de los LLM, es crucial identificar tareas o preguntas que exijan conocimiento del dominio o información adicional más allá del conocimiento general del LLM. Esto implica entender qué información concreta hace falta para generar respuestas precisas. Una vez identificada, podemos obtener la información necesaria conectando los LLM a fuentes de datos externas, como PDFs, APIs y bases de datos. Para gestionar la conexión entre los LLM y los datos externos, herramientas como LangChain y LlamaIndex resultan muy útiles y garantizan una integración más sencilla.
Proyecto de ejemplo
En este proyecto de ejemplo vamos a hacer preguntas y obtener respuestas a partir de un libro usando GPT-4 de OpenAI, LangChain y Pinecone (lee aquí un ejemplo que usa LlamaIndex). Este proyecto está muy inspirado en el trabajo de Gregory Kamradt. La única diferencia es el uso del Nuevo Testamento (PDF) como material de origen y el planteamiento de preguntas relacionadas con él.
Para completar la lista entera de pasos en local en Windows 10, usé un jupyter-lab. Además, hicieron falta varias bibliotecas de Python, como langchain, unstructured[local-inference], pinecone-client y openai.
Después fue simplemente cuestión de seguir los pasos descritos en el notebook de Gregory, que consisten en
- Cargar los datos de un .PDF usando LangChain.
- Dividir los datos en documentos más pequeños de 1000 caracteres.
- Crear embeddings de OpenAPI de los documentos y almacenarlos en Pinecone.
- Consultar esos documentos para obtener tu respuesta
Si te encuentras con un ReplicationError, asegúrate de tener una tarjeta configurada en OpenAI.
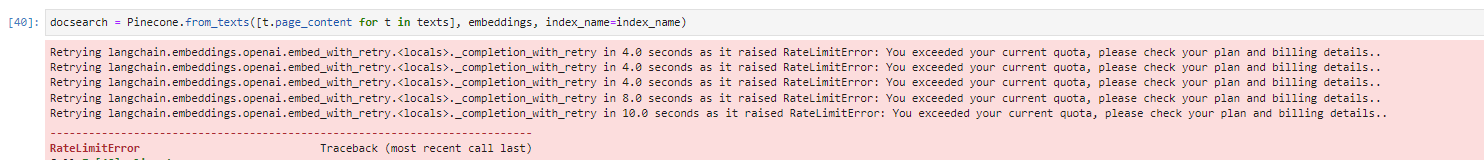
Por último, este es el resultado final en Pinecone, con más de 3000 vectores.
¡Y ya está!
Preguntas que responde este artículo
¿Cómo hago que un LLM responda preguntas sobre mi propio PDF?
Carga el PDF con LangChain, divide los datos en documentos más pequeños de 1000 caracteres, crea embeddings de esos documentos y almacénalos en Pinecone, y después consúltalos para obtener la respuesta. El proyecto de ejemplo hace exactamente eso con GPT-4, LangChain y Pinecone, usando el Nuevo Testamento como material de origen. LlamaIndex es la alternativa para gestionar esa misma conexión entre el modelo y los datos.
¿Para qué conectar datos externos en lugar de preguntarle directamente al modelo?
Porque las tareas para las que compensa usar un LLM son las que exigen conocimiento del dominio o información más allá del conocimiento general del modelo. El trabajo consiste en entender qué información concreta hace falta para generar una respuesta precisa y luego suministrarla desde fuentes de datos externas como PDFs, APIs y bases de datos. Herramientas como LangChain y LlamaIndex existen para gestionar esa conexión y garantizar una integración más sencilla.
¿Qué necesito instalar para montarlo yo mismo?
Un entorno de notebook y cuatro bibliotecas de Python. El montaje descrito aquí usó jupyter-lab en Windows 10 con langchain, unstructured con local-inference, pinecone-client y openai, además de cuentas en OpenAI y Pinecone. El notebook sigue los pasos del notebook de Gregory Kamradt, cambiando el libro de origen y las preguntas por el Nuevo Testamento.
¿Hace falta una cuenta de pago en OpenAI y qué es el ReplicationError?
El ReplicationError significa que no tienes una tarjeta configurada en OpenAI, así que revisa primero la facturación si te aparece. El paso que lo provoca es crear los embeddings del libro, que no son un par de llamadas de prueba: el texto de origen acabó aquí en más de 3000 vectores en Pinecone.
Leer a continuación
 AI
Cuando la IA tiene que grabar su propia revisión
Cuando se abre una pull request, sea mía o una que me toca revisar, ahora le pido al agente que la ejecute en mi máquina, que intente romperla y que se grabe mientras lo hace. Un párrafo puede asegurar que se hizo una prueba. Una grabación tiene que enseñarla, y decidir qué significa sigue siendo cosa mía. AI
Jev responde en probabilidades. La pregunta sigue siendo tuya.
Jev, de TypeSafe, no escribe ni una frase. Le entregas un estado y unas preguntas tipadas, y te devuelve una elección, una puntuación o una probabilidad de sí o no, a cuatro milésimas de céntimo por una decisión sobre mil tokens. La novedad es la forma, que devuelve la autoridad a tu código, y la trampa es que una probabilidad parece un recurso y no lo es. Ejecuté el piloto que pediría antes de creerme ningún número, sobre mis propios ensayos con el modelo abierto que sustituyó a Jev, y la respuesta fue no.