
Immagina un mondo in cui i libri rispondono alle tue domande
Ascolta l'articolo (sperimentale) · 04:23
Introduzione
Ti sei mai chiesto come sarebbe poter fare domande direttamente ai libri? I Large Language Model (LLM) come OpenAI GPT-4 stanno rendendo tutto questo realtà. In questa guida sintetica entriamo nell'affascinante mondo degli LLM e nel loro potenziale di trasformare diversi settori. Scopri come collegare gli LLM a sorgenti dati esterne può svelare possibilità incredibili e arricchire il nostro modo di interagire con la conoscenza scritta. Lasciamoci ispirare insieme!
Cosa sono gli LLM?
Gli LLM sfruttano la potenza degli algoritmi di deep learning e delle reti neurali, in particolare dei modelli transformer, per comprendere e generare testo in linguaggio naturale. Addestrati su enormi dataset come libri, articoli e siti web, questi modelli sono in grado di produrre testo simile a quello umano. Prendono la straordinaria capacità di persone come Kim Peek, che riusciva a leggere libri rapidamente e a ricordarne quasi tutto, e la portano a nuovi livelli. Alcuni esempi notevoli di LLM includono BERT di Google, BLOOM di HuggingFace, LLaMA di Meta e GPT-4 di OpenAI.
Perché usare gli LLM?
Gli LLM aprono un mondo di possibilità in diversi settori:
- Sanità: assistono nella diagnostica.
- Istruzione: creano piani di apprendimento personalizzati.
- Sviluppo software: snelliscono il processo di scrittura del codice.
Per illuminare ulteriormente il potenziale degli LLM, esploriamo uno scenario legale. Collegando gli LLM a banche dati giuridiche, è possibile gettare una base di conoscenza legale per gli avvocati che destreggiano più casi contemporaneamente. L'LLM poi approfondisce le circostanze specifiche di ogni caso, esaminando i singoli fascicoli insieme ai documenti normativi generali, incrociando leggi e precedenti pertinenti e generando risposte mirate e accurate per ogni situazione. Di conseguenza, gli LLM possono automatizzare attività come la redazione di documenti legali e l'analisi dei casi, facendo risparmiare tempo e aumentando l'efficienza sia per gli avvocati sia per i clienti.
Come usare gli LLM?
Per sfruttare la potenza degli LLM, è fondamentale individuare le attività o le domande che richiedono competenza di dominio o informazioni aggiuntive oltre alla conoscenza generale dell'LLM. Significa capire quali informazioni specifiche servono per generare risposte precise. Una volta individuate, possiamo ottenere le informazioni necessarie collegando gli LLM a sorgenti dati esterne, come PDF, API e database. Per gestire la connessione tra gli LLM e i dati esterni, strumenti come LangChain e LlamaIndex tornano molto utili, garantendo un'integrazione più semplice.
Progetto di esempio
In questo progetto di esempio faremo domande e otterremo risposte da un libro usando GPT-4 di OpenAI, LangChain e Pinecone (leggi qui per un esempio con LlamaIndex). Questo progetto è fortemente ispirato al lavoro di Gregory Kamradt. L'unica differenza è l'uso del Nuovo Testamento (PDF) come materiale di partenza e la formulazione di domande a esso correlate.
Per completare l'intera lista di passaggi in locale su Windows 10, ho usato un jupyter-lab. Inoltre, sono state necessarie diverse librerie Python, come langchain, unstructured[local-inference], pinecone-client e openai.
A quel punto è bastato seguire i passaggi descritti nel notebook di Gregory, che consistono nel
- Caricare i dati da un .PDF usando LangChain.
- Suddividere i dati in documenti più piccoli da 1000 caratteri.
- Creare embedding OpenAPI dei documenti e memorizzarli in Pinecone.
- Interrogare quei documenti per ottenere la tua risposta
Se incontri un ReplicationError, assicurati di avere una carta configurata in OpenAI.
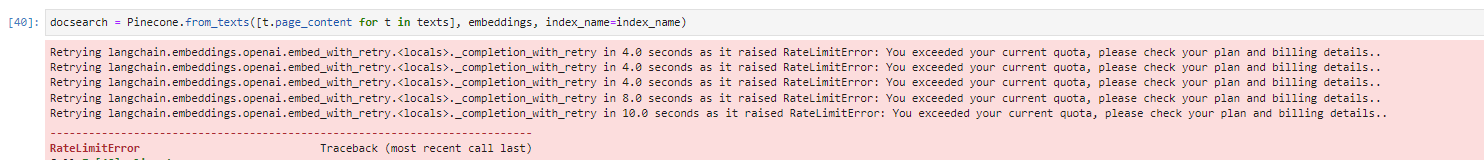
Inoltre, questo è il risultato finale in Pinecone, con oltre 3000 vettori.
Ecco fatto!
Le domande a cui questo articolo risponde
Come faccio a fare domande a un mio PDF con un LLM?
Carica il PDF con LangChain, suddividi i dati in documenti più piccoli da 1000 caratteri, crea gli embedding di quei documenti e memorizzali in Pinecone, poi interrogali per ottenere la risposta. Il progetto di esempio qui fa esattamente questo con GPT-4, LangChain e Pinecone, usando il Nuovo Testamento come materiale di partenza. LlamaIndex è l'alternativa per gestire la stessa connessione tra il modello e i dati.
Perché collegare dati esterni invece di chiedere direttamente al modello?
Perché le attività per cui conviene usare un LLM sono quelle che richiedono competenza di dominio o informazioni oltre la conoscenza generale del modello. Il lavoro sta nel capire quali informazioni specifiche servono per generare una risposta precisa e poi fornirle da sorgenti dati esterne come PDF, API e database. Strumenti come LangChain e LlamaIndex esistono per gestire quella connessione e garantire un'integrazione più semplice.
Che cosa mi serve installare per costruirlo da solo?
Un ambiente notebook e quattro librerie Python. Il progetto descritto qui ha usato jupyter-lab su Windows 10 con langchain, unstructured con local-inference, pinecone-client e openai, più gli account OpenAI e Pinecone. Il notebook segue i passaggi del notebook di Gregory Kamradt, cambiando il libro di partenza e le domande con il Nuovo Testamento.
Serve un account OpenAI a pagamento e cos'è il ReplicationError?
Il ReplicationError significa che non c'è una carta configurata in OpenAI, quindi se lo incontri controlla prima la fatturazione. Il passaggio che lo fa scattare è la creazione degli embedding del libro, che non sono due chiamate di prova: il testo di partenza qui è diventato oltre 3000 vettori in Pinecone.
Da leggere dopo
 AI
Quando l'IA deve filmare la propria revisione
Quando viene aperta una pull request, una mia o una che devo revisionare, ora chiedo all'agente di eseguirla sulla mia macchina, di provare a romperla e di filmarsi mentre lo fa. Un paragrafo può affermare che un test è stato fatto. Una registrazione deve mostrarlo, e decidere cosa significa resta compito mio. AI
Jev risponde in probabilità. La domanda è ancora tua.
Jev di TypeSafe non scriverà una frase. Gli consegni uno stato e delle domande tipizzate, e lui ti restituisce una scelta, un punteggio o una probabilità sì/no, a quattro millesimi di centesimo per una decisione su mille token. La novità è la forma, che rimette l'autorità nel tuo codice, e la trappola è che una probabilità somiglia a una rivalsa e non lo è. Ho fatto partire il progetto pilota che vorrei prima di credere a qualsiasi numero, sui miei stessi saggi con il modello aperto che ha fatto le veci di Jev, e la risposta è stata no.