
Fünf Musik-Engines, ein Adapter
Artikel anhören (experimentell) · 09:33
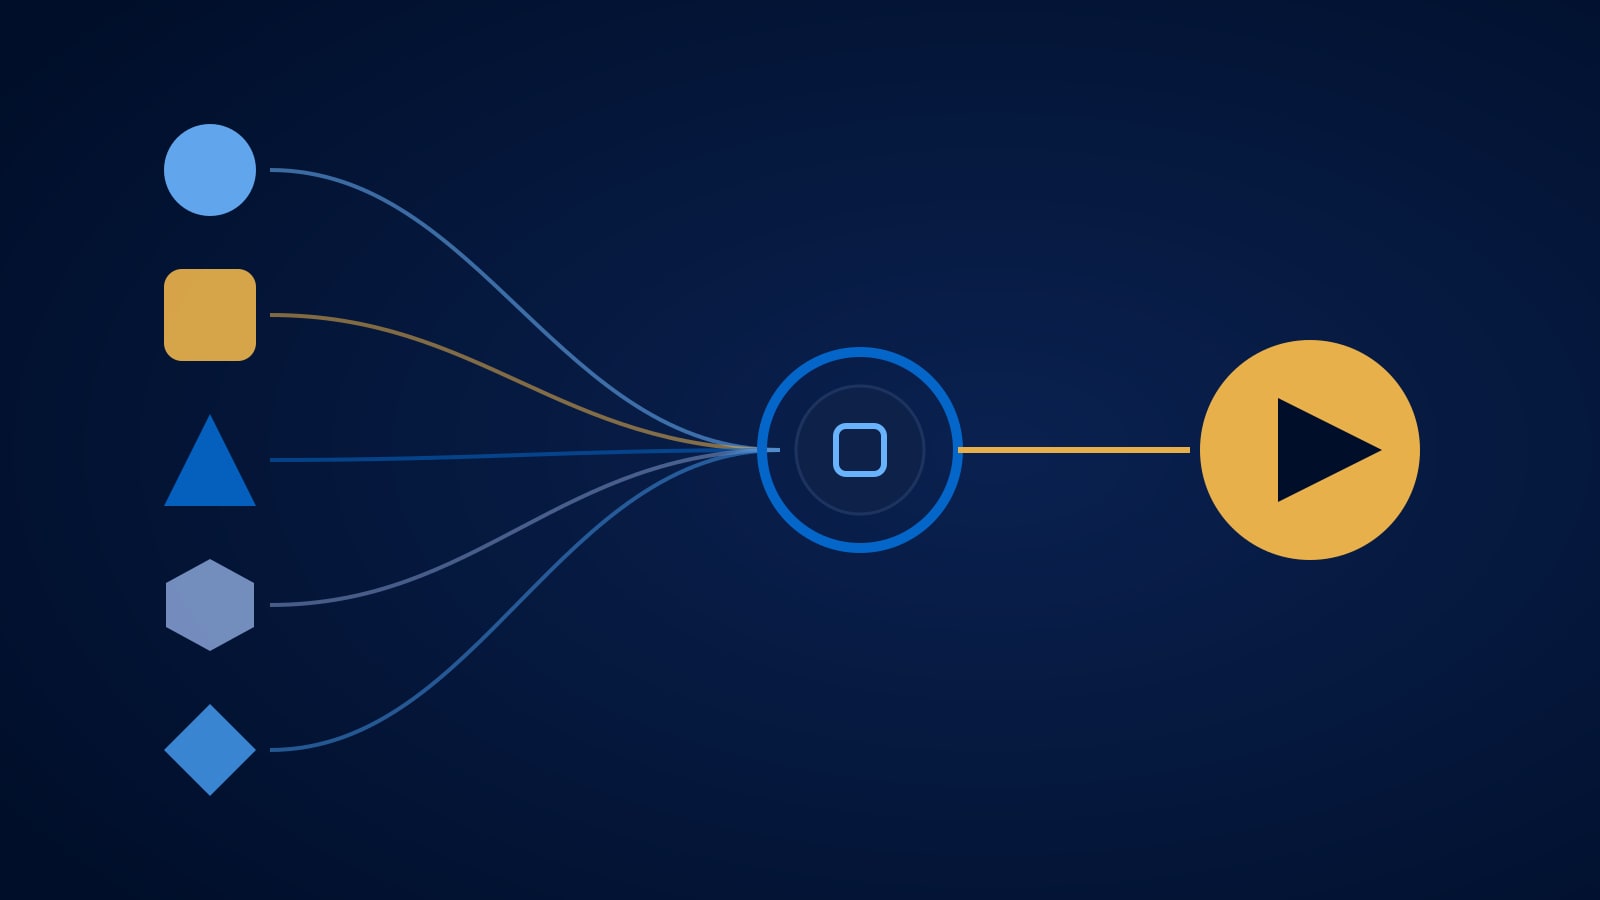
Ein potenzieller Kunde bat mich kürzlich, den Umfang einer KI-Musikgenerierung für sein Produkt abzustecken. Zwei Generatoren, der Nutzer wählt einen Stil, ein Song kommt heraus. An der Oberfläche ist das ein POST-Request an einen Anbieter und ein Play-Button. Um seine Fragen zu beantworten, habe ich am Ende einen Großteil des Marktes kartiert, und die Landschaft erwies sich als interessant genug, dass ich die Integration gleich fünfmal gebaut habe, gegen fünf verschiedene Engines, um zu zeigen, was wirklich dazugehört. Das Ergebnis ist ein kleiner funktionierender Proof of Concept: eine Adapterschicht, fünf Anbieter, eine CLI und eine dockerisierte Studio-UI, in der der Wechsel der Engine ein Dropdown ist.
Hier ist, was diese Übung lehrt.
Der API-Aufruf ist der einfache Teil
Musikgenerierung ist nicht Request und Response. Ein Track braucht 30 Sekunden bis einige Minuten zum Rendern, das eigentliche Engineering ist also alles rund um den Aufruf: ein Job-Modell, Webhooks oder Polling mit Backoff, Retries, die einen unzuverlässigen Status-Endpunkt tolerieren, Timeouts, die laut fehlschlagen, und Storage. Vor allem Storage. Anbieter-URLs laufen ab: Einer löscht Dateien nach 14 Tagen, ein anderer nach einer Woche, ein dritter kappt den Link nach 24 Stunden. Wenn dein Produkt die URL des Anbieters statt des Audios speichert, verrottet die Bibliothek deiner Nutzer still und leise. Die erste Regel beim Bauen auf diesen APIs lautet: Lade die Datei in dem Moment herunter, in dem ein Job erfolgreich abschließt, und leg sie in Storage ab, der dir gehört.
Fünf Anbieter, fünf verschiedene Formen
Die fünf Engines, die ich integriert habe, und die Form, die jede von ihnen am Ende hatte:
- Suno, weiterverkauft. Suno hat keine öffentliche First-Party-API, der Lieblingssound des Marktes kommt also über inoffizielle Reseller. Der, den ich integriert habe, verlangt eine Callback-URL, selbst wenn du pollst, beantwortet Polls in camelCase und Webhooks in snake_case für dieselben Daten und liefert zwei Track-Varianten pro Request.
- MiniMax. Offiziell unterstützt und, überraschend, synchron: Die HTTP-Antwort des Create-Aufrufs enthält bereits den fertigen Track. Die einfachste denkbare Integration, und der zurückgegebene Link stirbt innerhalb von 24 Stunden.
- ACE-Step. Ein Apache-lizenziertes Open-Weights-Modell, ausgeliefert über eine Queue-API. Das Wort im Auth-Schema lautet buchstäblich "Key" statt "Bearer", und es gibt kein Prompt-Feld: Es will Style-Tags und Lyrics, wobei "[inst]" für instrumental steht.
- Treblo. Eine First-Party-API, deren Status-Endpunkt einen nackten JSON-String zurückgibt, deren Standard-Ausgabeformat ogg ist und die sichtbare Attribution in jedem nutzerseitigen Produkt verlangt. Sie hat außerdem mitten in meiner Recherche das Rebranding von Sonauto vollzogen und Endpunkte verschoben, was sich anfühlte, als würde das Universum die Pointe dieses Artikels unterstreichen.
- Eleven Music. Synchron wie MiniMax, aber der Response-Body sind die rohen Audio-Bytes. Keine Job-ID, keine URL, nichts zu pollen. Fang die Bytes ab oder verlier sie.
Fünf Anbieter, fünf Auth-Schemata, drei Async-Modelle, zwei Response-Schreibweisen und ein Rebranding in einer einzigen Woche. Nichts davon gehört auch nur in die Nähe deines Produktcodes.
Der Adapter ist die Produktentscheidung
Die Lösung ist alt und langweilig und funktioniert: Stell jede Engine hinter einen einzigen Vertrag. Meiner besteht aus zwei Funktionen, Job anlegen und Job aktualisieren, beide geben dieselbe normalisierte Form zurück. Die Orchestrierung, der Storage, die UI und das Billing erfahren nie, welche Engine gelaufen ist. Einen Anbieter hinzuzufügen ist eine Datei; Anbieter zu tauschen ist ein Config-String; und wenn ein Reseller über Nacht stirbt, umfirmiert oder endlich eine offizielle API erscheint, konfigurierst du um, statt neu zu schreiben.
Der letzte Satz ist nicht hypothetisch. Inoffizielle Wrapper stehen auf rechtlich umkämpftem Boden, während die Klagen der Labels gegen die Modellhersteller ihren Lauf nehmen, und der Wrapper, den du heute integrierst, existiert im nächsten Quartal vielleicht nicht mehr unter demselben Namen. Ich habe es mitten im Projekt passieren sehen. Der Adapter ist keine Architektur-Verzierung, er ist die Versicherungspolice.
Was die Anwälte fragen werden
Die Fragen, die tatsächlich entscheiden, welche Engine du einsetzen kannst, haben nichts mit Klangqualität zu tun:
- Kommerzielle Rechte. Ein Anbieter überträgt dir in seinen Bedingungen das Eigentum an den Outputs. Ein anderer gewährt kommerzielle Nutzung nur über Marketingtexte, ohne vertragliche Lizenz dahinter. Ein dritter schweigt gegenüber API-Kunden vollständig. Das sind drei sehr unterschiedliche Risikopositionen, die in einer Feature-Demo alle identisch aussehen.
- Wasserzeichen. Eine Engine behält sich das Recht vor, nach eigenem Ermessen Wasserzeichen zu setzen. Eine andere bietet Content Credentials per Opt-in. Das Open-Weights-Modell hat keine. Wenn die Marke deines Kunden kein Wasserzeichen tragen kann, ist das ein Filter, keine Präferenz.
- Attribution. Eine Engine verlangt einen sichtbaren "Powered by"-Hinweis in deiner UI. Das ist eine Produktdesign-Einschränkung, die sich auf einer Bedingungsseite versteckt.
- Haftungsfreistellung. Keiner der fünf verteidigt dich, wenn ein generierter Track zu nah an jemandes Song landet. Dieses Risiko bleibt bei dir, was in der Praxis heißt, dass deine Nutzungsbedingungen es an deine Nutzer weiterreichen. Das ist eine Anwaltsstunde wert, vor dem Launch, nicht danach.
All das halte ich in einer Vergleichstabelle im Repo fest, direkt neben dem Code, denn die Tabelle ändert weit öfter als jeder Benchmark, welchen Adapter du aktivierst.
Hör selbst
Ein Prompt, direkt durch den Adapter: ein Lied über ein Ehepaar in Banff, beim Spaziergang am Ufer des Lake Louise, Schnee auf den Gipfeln, frisch verliebt wie am Anfang. Was folgt, ist genau das, was zurückkam, eine einzige Generierung, nicht die beste aus mehreren.
Treblo (Melodia v3), 2 Minuten 50:
Eine Fußnote zu diesen beiden Generierungen: Der Prompt verlangte warmen männlichen Gesang, und Treblo ließ den ersten Versuch von einer Frau singen. Der zweite, unten, stellte die Männerstimme an die allerersten Worte des Prompts, und auch den sang eine Frau. Diese Engine bietet keinen Parameter für das Stimmgeschlecht (Suno über kie.ai hat ein wörtliches vocalGender-Flag), was aus einer Ein-Wort-Anforderung ein Lotteriespiel macht. Diese Lektion ist die Credits wert: Wenn eine Einstellung für dein Produkt zählt, wähl eine Engine, die sie als Parameter anbietet, nicht als Hoffnung im Prompt.
Dieser Abschnitt wächst, während ich denselben Prompt durch die anderen Engines laufen lasse; ihre Versionen erscheinen hier nebeneinander. Jede Ausgabe ist KI-generiert, und die Rechte daran richten sich nach den Bedingungen des Anbieters.
So sieht es im Einsatz aus
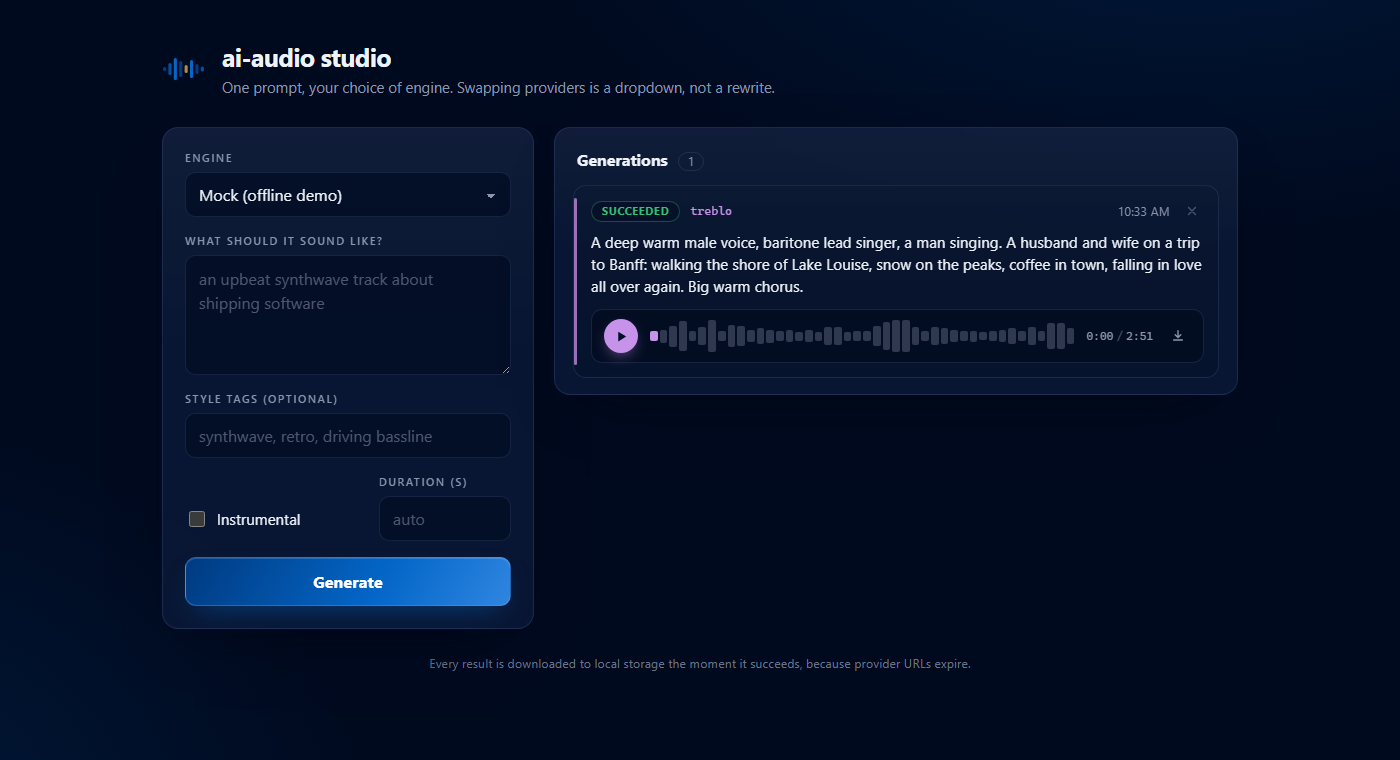
Was hinter diesem Artikel steht, ist real und läuft: eine Node-CLI-Fassung des Adapters ohne Abhängigkeiten und ein dockerisiertes Studio aus FastAPI plus React, in dem die Engines und ihre Modelle Dropdowns sind, eine Mock-Engine die gesamte Pipeline ganz ohne API-Keys vorführt und jeder fertige Track im Moment seines Abschlusses in lokalem Storage landet, denn inzwischen weißt du, warum. Ich halte es als privaten, funktionierenden Bauplan, und der Sinn eines Bauplans ist, dass der nächste, deiner, deutlich schneller entsteht.
Wenn du Musikgenerierung scopst, oder irgendein generatives Feature, das auf dem Modell von jemand anderem läuft, hat die Antwort dieselbe Form: Der Anbieter ist ein Plugin, der Vertrag gehört dir, und die langweiligen Teile, die Queue, der Storage, die Bedingungen, sind der Ort, an dem das Projekt wirklich lebt. Genau diese Art von Build helfe ich Teams auszuliefern.
Fragen, die dieser Artikel beantwortet
Warum ein Adapter, statt die API des Anbieters direkt aufzurufen?
Weil der Anbieter der Teil ist, der sich am ehesten unter dir verändert. Suno hat keine öffentliche First-Party-API, sein Sound kommt also über inoffizielle Reseller, die auf rechtlich umkämpftem Boden stehen, während die Klagen der Labels gegen die Modellhersteller ihren Lauf nehmen, und Treblo hat mitten in dieser Recherche das Rebranding von Sonauto vollzogen und Endpunkte verschoben. Hinter einem einzigen Vertrag ist das ein Config-String; direkt in den Produktcode verdrahtet, ist es eine Neuentwicklung.
Wie lange bleiben generierte Tracks unter der URL des Anbieters verfügbar?
Nicht lange genug, um darauf eine Bibliothek zu bauen. Ein Anbieter löscht Dateien nach 14 Tagen, ein anderer nach einer Woche, ein dritter kappt den Link nach 24 Stunden, und Eleven Music gibt die rohen Audio-Bytes ganz ohne URL zurück. Lade die Datei in dem Moment herunter, in dem ein Job erfolgreich abschließt, und leg sie in Storage ab, der dir gehört, sonst verrottet die Bibliothek deiner Nutzer still und leise.
Darf ich KI-generierte Musik kommerziell in meinem Produkt nutzen?
Das hängt vollständig davon ab, welche Engine du gewählt hast, und die fünf unterscheiden sich. Eine überträgt dir in ihren Bedingungen das Eigentum an den Outputs, eine andere gewährt kommerzielle Nutzung nur über Marketingtexte ohne vertragliche Lizenz dahinter, eine dritte schweigt gegenüber API-Kunden. Dazu behält sich eine das Setzen von Wasserzeichen nach eigenem Ermessen vor und eine verlangt einen sichtbaren Hinweis in deiner UI, und keine der fünf verteidigt dich, wenn ein generierter Track zu nah an jemandes Song landet.
Warum ignoriert die Engine den Prompt und singt den Song mit der falschen Stimme?
Weil ein Prompt ein Hinweis ist und keine Einstellung. Der Prompt für den Banff-Song verlangte warmen männlichen Gesang, und Treblo ließ den ersten Versuch von einer Frau singen; die Männerstimme an die allerersten Worte des Prompts zu stellen, brachte einen zweiten Versuch, den ebenfalls eine Frau sang. Treblo bietet keinen Parameter für das Stimmgeschlecht, Suno über kie.ai dagegen ein wörtliches vocalGender-Flag, also wähl eine Engine, die die Einstellung als Parameter anbietet, wenn sie für dein Produkt zählt.
Weiterlesen
 AI
Wenn die KI ihr eigenes Review filmen muss
Wenn ein Pull Request aufgemacht wird, mein eigener oder einer, den ich reviewen muss, bitte ich den Agenten inzwischen, ihn auf meinem Rechner laufen zu lassen, zu versuchen, ihn kaputtzumachen, und sich dabei zu filmen. Ein Absatz kann behaupten, dass ein Test stattgefunden hat. Eine Aufnahme muss es zeigen, und zu entscheiden, was das bedeutet, bleibt meine Aufgabe. AI
Jev antwortet in Wahrscheinlichkeiten. Die Frage bleibt deine.
Jev von TypeSafe schreibt keinen einzigen Satz. Du gibst ihm einen Zustand und typisierte Fragen, und es gibt eine Wahl, einen Score oder eine Ja/Nein-Wahrscheinlichkeit zurück, für vier Tausendstel Cent pro Entscheidung bei tausend Tokens Eingabe. Das Neue ist die Form, die die Autorität zurück in deinen Code legt, und die Falle ist, dass eine Wahrscheinlichkeit nach Absicherung aussieht und keine ist. Ich habe den Pilotversuch gefahren, den ich verlangen würde, bevor ich irgendeiner Zahl glaube, auf meinen eigenen Essays mit dem offenen Modell, das für Jev eingesprungen ist, und die Antwort war Nein.