
Orquestrar Modelos, Não Apenas Contentores: Kubernetes na Era da IA
Ouvir o artigo (experimental) · 17:49
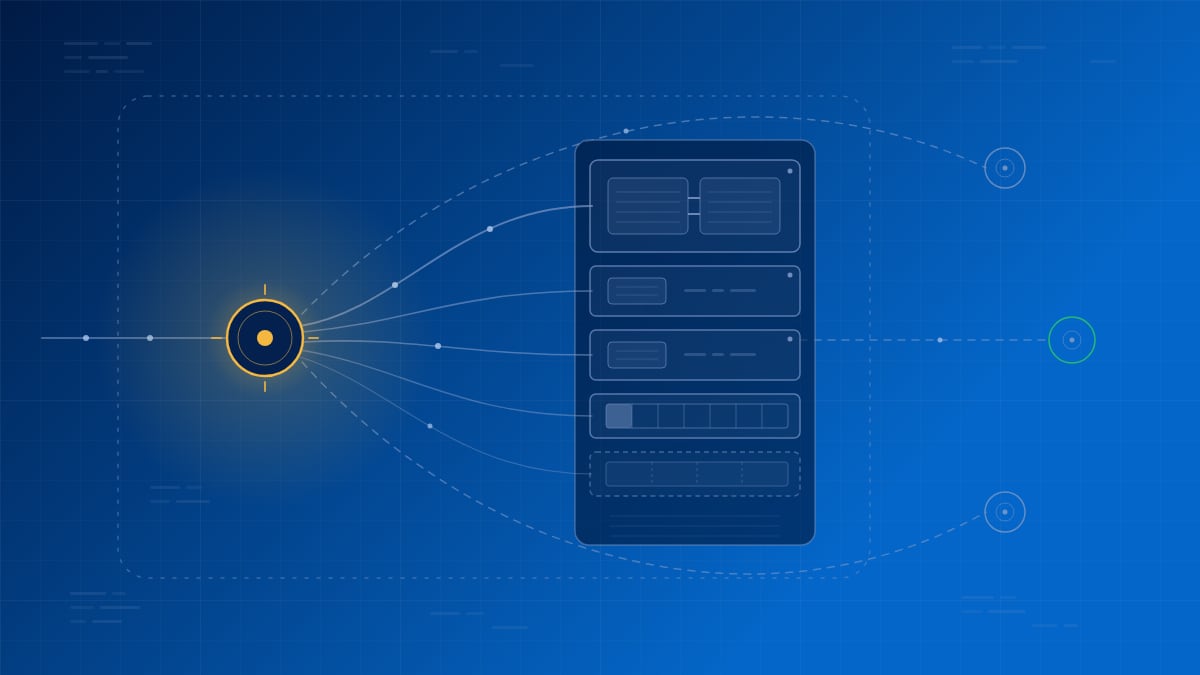
A maior parte do meu trabalho vive na camada aplicacional. É onde os produtos se ganham: os fluxos, as APIs, as partes para as quais os utilizadores conseguem apontar. Muitos produtos assentam diretamente num único fornecedor, um modelo da OpenAI ou da Anthropic atrás de uma única chave, e são perfeitamente bem servidos por isso. Mas quando um produto cresce para lá de um modelo, ou começa a tocar no seu próprio hardware, passa a assentar numa camada de que os seus utilizadores nunca ouviram falar: a que decide, no instante depois de carregarem em enter, que modelo lhes responde, em que peça de hardware, e o que acontece se esse hardware estiver saturado ou desaparecer. Ninguém agradece a essa camada quando ela funciona. Tem exatamente um requisito, e é inegociável: não pode falhar às pessoas que nem sabem que a estão a usar.
E já não se trata só dos produtos que lançamos; é também de como os construímos. As ferramentas de código na minha máquina fazem os mesmos movimentos de que este artigo trata: o Claude Code entrega subtarefas leves a um modelo pequeno e rápido e mantém o raciocínio difícil num grande, o Cursor encaminha entre os seus próprios modelos e APIs de fronteira conforme a ação, e o relato da Anthropic sobre o seu sistema de investigação multi-agente descreve exatamente esta forma: um agente líder Opus a orquestrar subagentes Sonnet mais baratos. O routing modelo-por-tarefa está discretamente a tornar-se a forma como o software se faz, não só como se serve.
Entretanto, por todo o lado há equipas a assinar com fornecedores de APIs de fronteira (OpenAI, Anthropic, Google, xAI, MiniMax) enquanto alojam também famílias de pesos abertos como Llama, Qwen, DeepSeek ou Mistral nas GPUs que conseguiram arranjar, e alguém tem de orquestrar todos esses modelos com o hardware disponível. "Quão bem conheces Kubernetes" é uma pergunta de 2019. A pergunta de 2026 é: dado um conjunto fixo de GPUs, um conjunto de modelos de pesos abertos que queres alojar e um conjunto de modelos de fronteira que só podes alugar através de uma API, consegues fazer com que tudo isso pareça um único endpoint aborrecido? Construí uma prova de conceito funcional que responde à pergunta: um router de modelos, um conjunto de deployments conscientes das GPUs e uma demo que corre num portátil. Este post é o raciocínio por trás dela.
A economia grita utilização
Algum contexto sobre porque é que esta competência específica importa de repente. A Friday Charts da Blockworks fez as contas esta semana: os hyperscalers e as neoclouds terão gasto cerca de 2 biliões de dólares em capex até ao fim do ano, um único armário de GPUs nos novos pods Vera Rubin da Nvidia está estimado em 9 milhões de dólares, e a newsletter abre com Jensen Huang a declarar que "o data center é a nova unidade de computação". A mesma edição nota que um gigawatt de capacidade de data center produz agora perto de 500 biliões de tokens, contra aproximadamente zero em 2023.
Provavelmente não és um hyperscaler, mas os números continuam a doer ao nível da rua: uma única placa topo de gama pode custar bem mais de 40.000€ antes de existir um servidor onde a colocar, e decidir como dividir essa placa (inteira, ao meio, fatiada em sétimos) é um exercício de planeamento por direito próprio, razão pela qual os fabricantes de GPUs publicam guias de dimensionamento e matrizes de configuração para acompanhar os compradores pelas opções.
Para ser claro, nem todas as equipas precisam de se importar, e não é uma escolha binária entre uma API e o teu próprio cluster. É uma escada, e cada degrau a descer dá-te mais controlo sobre o que está por baixo do endpoint:
- Totalmente em APIs. Um modelo da OpenAI ou da Anthropic atrás de uma chave, ou um deployment de Azure OpenAI com o seu catálogo fixo de modelos e quotas de tokens por minuto. As tuas alavancas são quotas, caching e escolher o tier de modelo certo para cada tarefa.
- Inferência alugada. Os Hugging Face Inference Endpoints, a RunPod e os seus pares, vários dos quais já usei. Escolhes o modelo e a placa, outra pessoa gere as máquinas, e o contador cobra à GPU-hora quer estejas ocupado quer parado.
- GPUs na cloud geridas por ti. VMs com GPU faturadas à hora na GCP, na AWS ou no Azure (depois de o fornecedor te conceder quota, porque a escassez é real), ou node pools de GPU ligadas a um cluster Kubernetes gerido como o GKE, o EKS ou o AKS, muitas vezes a preços spot se a tua carga tolerar despejo. O contador parece o do degrau acima; a diferença é que a orquestração por baixo do endpoint passa a ser tua.
- Metal que possuis. Placas compradas e montadas on-prem ou em colocation: a placa de 40.000€ de há pouco, amortizada em vez de medida ao contador. Compensa com utilização sustentada ou restrições duras de residência de dados, e o Kubernetes também corre em bare metal, por isso os mesmos manifestos seguem contigo para lá.
Do segundo degrau para baixo o contador nunca para, e a maior alavanca que uma equipa normal controla totalmente passa a ser a fração ociosa da GPU-hora que já paga. Orquestração não é um luxo de plataforma; é a diferença entre uma frota que ganha o seu custo e um aquecedor muito caro. O Kubernetes não é a única forma de lá chegar: o Slurm continua dono do mundo HPC, o Ray traz o seu próprio scheduler, e qualquer cloud te vende de bom grado um endpoint gerido que esconde o problema atrás de uma margem. Mas se o teu produto já corre em Kubernetes, o movimento pragmático é deixar a mesma plataforma fazer bin-packing dos modelos também: cargas heterogéneas em máquinas heterogéneas, de forma declarativa, ao lado das cargas que ela já corre.
Três forças, um design
Todas as configurações multi-modelo que já vi são puxadas em direções opostas pelas mesmas três forças:
- Os modelos são heterogéneos. Alguns correm nas tuas GPUs (Qwen, Llama, e o resto do mundo de pesos abertos), outros só existem atrás de uma API (os tiers de fronteira, seja com quem for que assines). Diferem em janela de contexto, suporte de ferramentas, custo, latência e implicações de residência de dados.
- O hardware é heterogéneo e finito. Uma frota real é o que conseguiste arranjar: umas A100, um pool de L4, H100 no próximo trimestre se os deuses das encomendas sorrirem. Cada modelo tem uma ou duas colocações que fazem sentido económico, e o resto é desperdício.
- O código de produto não quer saber de nada disto. Quer um endpoint compatível com a OpenAI e um nome de modelo, e deve continuar a funcionar quando um fornecedor é trocado, um contrato é assinado ou uma placa avaria.
A PoC divide a responsabilidade segundo estas linhas. O Kubernetes é dono da colocação: que pod aterra em que GPU, expresso na linguagem que ele já fala (resource requests, node selectors, taints). Um pequeno router é dono da seleção: que backend serve este pedido, com failover. Um registo é dono da política: o que existe, o que consegue fazer, quanto custa. É um ConfigMap, recarregado a quente, para que "assinámos com um novo fornecedor" seja um kubectl apply, não um deploy de produto.
A colocação é onde está o dinheiro
A parte da PoC que eu defenderia com mais força é o seu GPU playbook, porque é aqui que o conhecimento de Kubernetes e o conhecimento de GPUs têm de se encontrar:
| Carga | Hardware | Técnica |
|---|---|---|
| Qwen3-32B | 2x A100-80GB | Paralelismo de tensores, TP=2, NVLink num só nó |
| Qwen3-8B | 1x L4-24GB | Quantização AWQ 4-bit para caber na placa barata |
| Embeddings | Um sétimo de uma A100 | Fatia MIG, 1g.10gb, isolada em hardware |
| Experiências dev | GPUs partilhadas | Time-slicing, quatro cargas por placa |
| Modelos de fronteira | GPUs de ninguém | API externa atrás do mesmo endpoint |
Cada linha é um pequeno argumento. O modelo de 32B não cabe numa placa de 80GB com espaço para respirar (só os pesos são ~64GB em bf16), por isso é fatiado por duas, e o manifesto fixa o produto de GPU exato via nodeSelector, porque "duas GPUs algures no cluster" e "duas A100 com NVLink no mesmo nó" são máquinas radicalmente diferentes. O modelo de 8B vai no sentido oposto: quantizar até caber na placa que consegues realmente comprar, e depois escalar horizontalmente. A memória libertada pela quantização não é só encaixe, é KV cache, e KV cache é concorrência: a quantização compra-te muitas vezes débito, não só pesos mais pequenos.
A linha dos embeddings é a minha favorita, porque é onde o dinheiro morre em silêncio na maioria dos clusters. Um modelo de embeddings precisa de cerca de 2GB, e a mesma matemática aplica-se a rerankers, classificadores de guardrails e modelos de transcrição da classe do Whisper, os pequenos serviços sempre ligados que todos os produtos de IA acumulam. Dá a qualquer um deles uma A100 inteira e ~97% de uma placa muito cara fica ociosa para sempre. O MIG, Multi-Instance GPU, corta o silício em sete fatias isoladas; o Deployment pede nvidia.com/mig-1g.10gb: 1 como qualquer outro recurso, e uma placa serve sete deles, cada um isolado em hardware dos vizinhos. O time-slicing faz algo parecido para clusters de dev, sem isolamento nenhum (um processo guloso pode causar OOM aos restantes), e é exatamente por isso que essa configuração na PoC está marcada como só-para-dev.
Nada disto é exótico. É Kubernetes vulgar (resource requests, labels, probes, disruption budgets) apontado a um recurso pouco familiar. É esse o verdadeiro significado de "tirar partido do Kubernetes na era da IA": a plataforma não mudou, a carga de trabalho é que mudou.
O motor de serving também é uma escolha
Tudo o que corre no cluster é servido pelo vLLM, e isso é uma preferência testada, não um default. A propriedade que o vende é contraintuitiva: fica melhor sob pressão. O continuous batching faz com que, quantos mais pedidos concorrentes lhe atirares, mais tokens por GPU-hora produz; o tráfego baixo é o caso patológico, não a hora de ponta. Também experimentei o Ollama pelo caminho, e a comparação ensinou a mesma lição da tabela de colocação: as ferramentas codificam suposições sobre a sua carga de trabalho. O Ollama é excelente para aquilo para que foi construído (uma pessoa, uma máquina), mas sob carga concorrente foi claramente mais lento nos meus testes, e alternar depressa entre modelos diferentes deu-lhe problemas reais, porque cada troca descarrega um modelo e carrega outro. Uma instância de vLLM nunca tem esse problema porque nunca muda de roupa: um modelo por servidor durante toda a sua vida, e o router por cima decide que servidor cada pedido merece.
Routing é uma política, não um if
O router fala /v1/chat/completions e resolve nomes em dois modos deliberadamente diferentes. Um nome de modelo exato (qwen3-32b) segue uma cadeia de failover explícita, escrita pelo operador: o vLLM no cluster primeiro, uma API de fronteira como transbordo. Sem esperteza. Um alias (chat-default, chat-long-context) é, em vez disso, um conjunto de requisitos (janela de contexto mínima, suporte de ferramentas) mais uma estratégia: cheapest-healthy ordena todos os backends qualificados por custo combinado; prefer-cluster mantém o tráfego no hardware que possuis a menos que nada no cluster qualifique, o que serve também de botão de residência de dados.
Os aliases são a metade que muda a forma de trabalhar de uma equipa. O código de produto pede um resultado, não um vendor, por isso "o 8B já aguenta este tráfego" ou "encaminha contexto longo para o fornecedor que der melhor preço" tornam-se edições ao registo que saem em segundos. Um circuit breaker por backend salta backends doentes, cada resposta transporta um header x-router-backend para saberes sempre quem respondeu, e o streaming só faz failover antes do primeiro byte: com tokens a fluir, repetir a geração nas costas do utilizador duplicaria o custo e colaria duas respostas diferentes.
Uma coisa que o router se recusa a fazer: fila. O vLLM já mantém a fila honesta, e escondê-la atrás de uma segunda destruiria o melhor sinal de autoscaling do sistema. O que me leva à armadilha.
A armadilha da utilização de GPU
Se levares um detalhe operacional deste post, leva este: a utilização de GPU é um sinal de autoscaling enganador para serving de LLMs. O continuous batching mantém a placa ocupada quer esteja a servir dois pedidos confortavelmente quer esteja a afogar-se com duzentos: ambos leem ~100%. Escala com base na utilização e estarás a escalar com base em ruído.
O número que acompanha o que os utilizadores sentem é a profundidade da fila: o num_requests_waiting do vLLM, pedidos admitidos mas ainda não agendados para o batch. A PoC escala o tier de trabalho de 8B exatamente com essa métrica via KEDA: para cima depressa, porque as filas acumulam-se; para baixo devagar e um pod de cada vez, porque cada réplica nova paga minutos de carregamento de modelo e o flapping é caro. E quando o pool de L4 inteiro se esgota? Isso já não é um problema de autoscaling. A cadeia de failover transborda para as APIs externas, o tier elástico que alugas precisamente porque não o possuis.
E a camada aplicacional também não pode fingir que nada disto existe. Um gargalo de GPU acaba por aparecer no produto, e as respostas certas vivem lá: backpressure, timeouts, um modo degradado. Um modelo mais pequeno com um rótulo honesto vale mais do que um spinner que morre aos sessenta segundos.
O que a PoC prova, e o que não prova
A coisa toda corre sem uma única GPU: um overlay local troca cada Deployment de vLLM por um mock que fala a mesma API e exporta as mesmas métricas, para que o routing, o failover e os sinais de escala possam ser demonstrados num cluster kind num portátil. Mata o deployment do 32B a meio da demo e vê o mesmo pedido voltar respondido pelo tier "externo". A lógica de routing é pura e testada com testes unitários; os manifestos renderizam via kustomize em CI.
Continua a ser uma PoC, e prefiro dizê-lo a que o descubras: não há autenticação, nem rate limiting, nem orçamentos por tenant, e as chaves externas são Secrets simples. Essa é a primeira iteração de produção, e nada disso muda a arquitetura. Os conceitos da plataforma transferem-se quase inalterados entre distribuições e clouds; o que decide o sucesso é se a economia da carga de trabalho foi compreendida antes de o YAML ser escrito.
A camada aplicacional continua a ser onde passo a maior parte dos meus dias, e continua a ser onde os produtos se ganham. Mas por baixo dos produtos de IA que crescem para lá de um modelo existe agora uma camada a fazer o trabalho de infraestrutura mais difícil da década: pegar numa restrição da era dos 2 biliões de capex, num zoo de modelos e numa pilha fixa de hardware, e fazê-los comportar-se como um endpoint fiável, substituível e aborrecido, para pessoas que nunca saberão que ela existe. Tem de funcionar. Não lhes pode falhar. A PoC é a minha forma de mostrar que não tem de falhar.
Perguntas a que este artigo responde
Preciso de GPUs próprias para ter um produto de IA, ou basta uma chave de API?
Uma chave chega para muitos produtos, e a escolha não é binária. É uma escada de quatro degraus: totalmente em APIs atrás de um único fornecedor, inferência alugada em serviços como os Hugging Face Inference Endpoints ou a RunPod, GPUs na cloud geridas por ti, e metal que possuis e montas em rack. Cada degrau a descer dá mais controlo sobre o que está por baixo do endpoint, e a partir do segundo degrau pagas à GPU-hora quer estejas ocupado quer parado.
Kubernetes não é exagero só para servir uns quantos modelos?
Não é a única forma, e as alternativas são reais: o Slurm continua dono do mundo HPC, o Ray traz o seu próprio scheduler, e qualquer cloud te vende um endpoint gerido que esconde o problema atrás de uma margem. O argumento pragmático a favor do Kubernetes é mais estreito do que o entusiasmo sugere: se o teu produto já corre nele, deixa a mesma plataforma fazer bin-packing dos modelos ao lado das cargas que já corre. O que a PoC usa é Kubernetes vulgar, ou seja resource requests, labels, probes e disruption budgets, apontado a um recurso pouco familiar.
Porquê correr vLLM no cluster em vez de Ollama?
O vLLM fica melhor sob pressão, e é essa a propriedade que o vende. O continuous batching faz com que mais pedidos concorrentes produzam mais tokens por GPU-hora, por isso o tráfego baixo é o caso patológico, não a hora de ponta. O Ollama é excelente para uma pessoa e uma máquina, mas sob carga concorrente foi claramente mais lento nos meus testes, e alternar entre modelos deu-lhe problemas reais, porque cada troca descarrega um modelo e carrega outro. Um servidor vLLM mantém um modelo durante toda a sua vida, e o router por cima decide para que servidor vai cada pedido.
O que acontece quando todas as GPUs já estão ocupadas?
Isso deixa de ser um problema de autoscaling e passa a ser de failover: a cadeia transborda para as APIs externas, o tier elástico que alugas precisamente porque não o possuis. Abaixo desse ponto, a PoC escala o tier de 8B com o num_requests_waiting do vLLM via KEDA, para cima depressa porque as filas acumulam-se e para baixo devagar porque cada réplica nova paga minutos de carregamento de modelo. A camada aplicacional ainda tem de responder pelo resto com backpressure, timeouts e um modo degradado, porque um modelo mais pequeno com um rótulo honesto vale mais do que um spinner que morre aos sessenta segundos.
Ler a seguir
 AI
Quando a IA tem de filmar a sua própria revisão
Quando é aberto um pull request, meu ou um que tenho de rever, passei a pedir ao agente que o corra na minha máquina, que tente parti-lo e que se filme a fazê-lo. Um parágrafo pode afirmar que houve um teste. Uma gravação tem de o mostrar, e decidir o que isso significa continua a ser trabalho meu. AI
O Jev responde em probabilidades. A pergunta continua a ser tua.
O Jev, da TypeSafe, não escreve uma frase. Entregas-lhe um estado e perguntas tipadas, e ele devolve uma escolha, uma pontuação ou uma probabilidade de sim ou não, por quatro milésimos de cêntimo numa decisão de mil tokens. A novidade é a forma, que devolve a autoridade ao teu código, e a armadilha é que uma probabilidade parece recurso e não é. Corri o piloto que eu quereria ver antes de acreditar em qualquer número, nos meus próprios ensaios com o modelo aberto que fez as vezes do Jev, e a resposta foi não.